Anthropic이 말한 메모리 'dreaming', 저희 Claude Code 메모 165개에 돌려 봤습니다
Anthropic이 세션 사이에 에이전트 메모리를 다시 쓰는 단계를 소개했습니다. 저희 Claude Code 메모 165개에 한 번 돌려 보니 인덱스가 46% 줄었습니다. 인덱스를 짧게 잘랐을 때 인덱스 아래쪽 메모에 관한 질문 정답률은 92%에서 77%로 떨어졌고, 정리본에서는 93%로 돌아왔으며 답 하나에 읽은 입력 토큰은 자르기 전 원본보다 35% 적었습니다. 사실 하나하나를 대조해 보니 커밋 해시와 정확한 체크포인트 이름처럼 질문으로는 못 잡은 손실도 나왔습니다.

Anthropic이 말한 메모리 'dreaming', 저희 Claude Code 메모 165개에 돌려 봤습니다
Claude Code 세션은 매번 새 컨텍스트 창에서 시작합니다. 어제 나눈 대화는 이어지지 않습니다. 세션을 넘어 이어지는 것은 두 가지입니다. 사용자가 직접 쓰는 CLAUDE.md 파일, 그리고 에이전트가 스스로 적는 메모인 자동 메모리(auto memory)입니다. 자동 메모리는 짧은 마크다운 파일이 모인 폴더와, 메모마다 한 줄씩 적힌 인덱스 파일로 되어 있습니다. 인덱스는 세션을 시작할 때마다 불러옵니다. 이 글은 그중 자동 메모리를 다룹니다. CLAUDE.md는 사람이 손으로 고치지만, 에이전트의 메모는 몇 주 동안 아무도 정리하지 않은 채 계속 늘어납니다.
Anthropic은 2026년 11월 6일 The components of agent memory(Lance Martin, Anthropic Engineering)라는 글을 냈습니다. 요지는 이런 메모를 쌓아 두기만 하면 안 된다는 것입니다. 세션과 세션 사이에 모델이 메모를 다시 훑어보고, 틀린 것은 고치고, 겹치는 것은 합치고, 가장 먼저 불러올 부분을 새로 써야 한다고 합니다. 글은 이 오프라인 단계를 잠자는 동안 뇌가 기억을 정리하는 방식에 빗대어 설명하고, 흔히 dreaming이라고 부른다고 적었습니다.
저희에게는 이걸 시험해 볼 메모리가 있습니다. 저희 Claude Code 에이전트는 8월 말부터 A100에서 모델 실험을 돌리고, 코드를 고치고, 결과를 글과 영상으로 내보내 왔습니다. 그동안 스스로 적은 메모가 165개이고, 절반 넘게 실측 실행을 다룹니다. 인덱스는 이제 Claude Code가 불러오는 한도에 거의 닿았습니다. 그래서 복사본에 dreaming 방식의 재작성을 한 번 돌리고, 전과 후에 같은 질문을 던져 봤습니다.
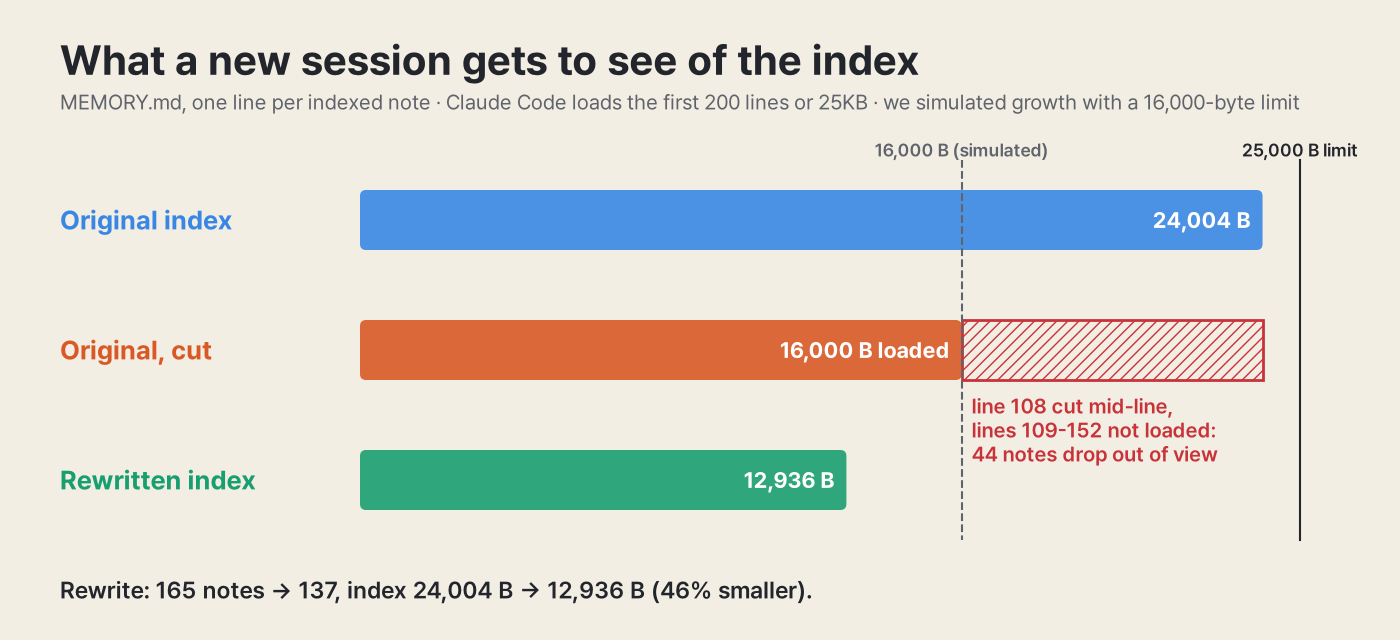
재작성은 메모 48개를 21개로 합치고 하나를 지웠으며, 인덱스를 46% 줄였습니다. 메모리가 더 커졌을 때처럼 인덱스를 짧게 자르자, 인덱스 아래쪽 메모에 관한 질문의 정답률이 92%에서 77%로 떨어졌습니다. 정리한 인덱스에서는 93%로 돌아왔고, 답 하나에 읽은 입력 토큰은 자르기 전 원본보다 평균 35% 적었습니다. 다만 손실이 없지는 않았습니다. 파일마다 대조해 보니 커밋 해시 하나와 정확한 체크포인트 이름이 사라졌고, 없는 메모를 가리키는 링크 대상이 9개 늘었습니다.
Anthropic이 말하는 메모리와 dreaming
Anthropic 글은 세션을 넘어 이어지는 것을 네 층으로 나눕니다. 맨 아래는 지난 작업의 대화 기록(transcript)입니다. 그 위에 에이전트가 세션 중에 적는 메모, 메모를 서로 이어 주는 위키 같은 구조, 맨 위에 세션마다 처음 넣어 주는 컨텍스트가 있습니다. Claude Code로 옮기면 메모는 메모리 폴더의 파일이고, 처음 넣어 주는 컨텍스트는 인덱스입니다.
dreaming은 작업 도중이 아니라 세션 사이에 돌아갑니다. 모델이 대화 기록과 메모, 위키를 읽고, 메모를 대화 기록과 맞춰 보고, 고치거나 합친 뒤 맨 위 층을 새로 씁니다. 글은 자기 과제에서 얻은 효과도 보여 줍니다. 예를 들어 dreaming 세션을 2회에서 128회까지 돌리며 키운 위키만 보고 답하게 했더니, 질문 25개의 정답률이 13%에서 48%로 올랐습니다. 위험도 스스로 적었습니다. 처음부터 틀렸거나 조금씩 어긋난 메모를 이후 세션이 그대로 믿게 되고, 위키가 원자료보다 커질 수도 있습니다(한 위키는 원자료의 1.77배가 됐습니다).
저희 메모리에 지금 필요한 이유
Claude Code 문서에는 이렇게 적혀 있습니다. "The first 200 lines of MEMORY.md, or the first 25KB, whichever comes first, are loaded at the start of every conversation." MEMORY.md의 앞 200줄과 앞 25KB 가운데 먼저 닿는 쪽까지만 대화를 시작할 때 불러온다는 뜻입니다. 메모 본문은 필요할 때 읽습니다. 그러니 인덱스는 책의 목차와 같습니다. 한도 뒤로 밀려난 메모는 디스크에 그대로 있지만, 새 세션의 목차에는 보이지 않습니다. 에이전트가 직접 찾아볼 생각을 해야만 찾을 수 있습니다. 인덱스가 한도에 가까워지면 Claude Code가 Claude에게 줄이라고 알려 주고, 한도를 넘은 부분은 다음에 불러올 때 빠집니다.
저희 인덱스는 152줄, 24,004바이트로 25,000바이트 한도의 96%입니다. 새 메모는 대개 맨 아래에 붙기 때문에, 먼저 빠지는 것은 주로 나중에 더해진 메모입니다. 인덱스를 줄이라는 요청은 곧 올 것이고, 그때 하는 재작성이 곧 작은 규모의 dreaming입니다. 저희가 시험한 것이 바로 그것입니다.
어떻게 시험했나
에이전트가 할 일은 간단합니다. 저희 작업 규칙이나 프로젝트에 관한 질문에 메모리만 보고 답하는 것입니다. 예를 들면 "글을 올리기 전에 무엇을 해야 하나?" 같은 질문입니다.
- 질문. Opus 5.5가 메모 하나당 질문 하나를 만들고, 답과 메모 속 근거 문장을 함께 적었습니다. 근거 문장이 메모에 글자 그대로 없으면 그 질문은 버렸습니다. Q1은 무작위로 고른 메모 20개에서 나온 질문 20개입니다(시드 7). Q2는 인덱스 아래쪽, 그러니까 가장 먼저 잘려 나갈 메모에서 나온 질문 20개입니다(시드 8).
- 답하는 에이전트. Opus 5.5에 Claude Code가 넣어 주는 방식 그대로 인덱스를 주고, 도구 두 개를 줬습니다. 메모 하나 읽기와 메모리 폴더 목록 보기입니다. 도구는 최대 여덟 번까지 부를 수 있습니다.
- 채점. 별도의 Opus 5.5 호출이 답을 기준 답·근거 문장과 비교해 정답, 부분 정답, 오답으로 매겼습니다.
- 재작성. Opus 5.5 호출 한 번이 메모 165개와 인덱스를 모두 읽고, 합치기·고치기·지우기 작업 목록과 새 인덱스를 돌려줍니다. 이 작업은 복사본에만 적용했고, 실제로 쓰는 메모리는 건드리지 않았습니다. Anthropic의 방식은 메모를 대화 기록과도 맞춰 보지만, 저희 재작성은 메모만 봤습니다.
메모리가 커진 상황은 불러오는 한도를 25,000바이트에서 16,000바이트로 낮춰 흉내 냈습니다. 메모 약 50개가 더 늘어난 셈입니다. 16,000바이트에서 원래 인덱스는 107줄까지만 보이고, 끝쪽 메모 44개가 빠집니다. 정리한 인덱스는 12,936바이트라 통째로 들어갑니다. 조건마다 세 번씩 돌렸습니다.
결과
회차별 정답 수(20문항 중)와 답 하나당 평균 입력 토큰입니다.
| 질문 | 원래 인덱스, 25KB | 원래 인덱스, 16KB에서 자름 | 정리한 인덱스, 16KB |
|---|---|---|---|
| Q1 (무작위 메모) | 20, 19, 19 (29,910토큰) | 19, 19, 20 (25,968) | 18, 18, 19 (16,336) |
| Q2 (인덱스 아래쪽 메모) | 19, 18, 18 (26,157) | 15, 16, 15 (43,066) | 19, 18, 19 (17,070) |
세 열은 질문, 도구, 채점자가 모두 같고, 인덱스와 한도만 다릅니다.
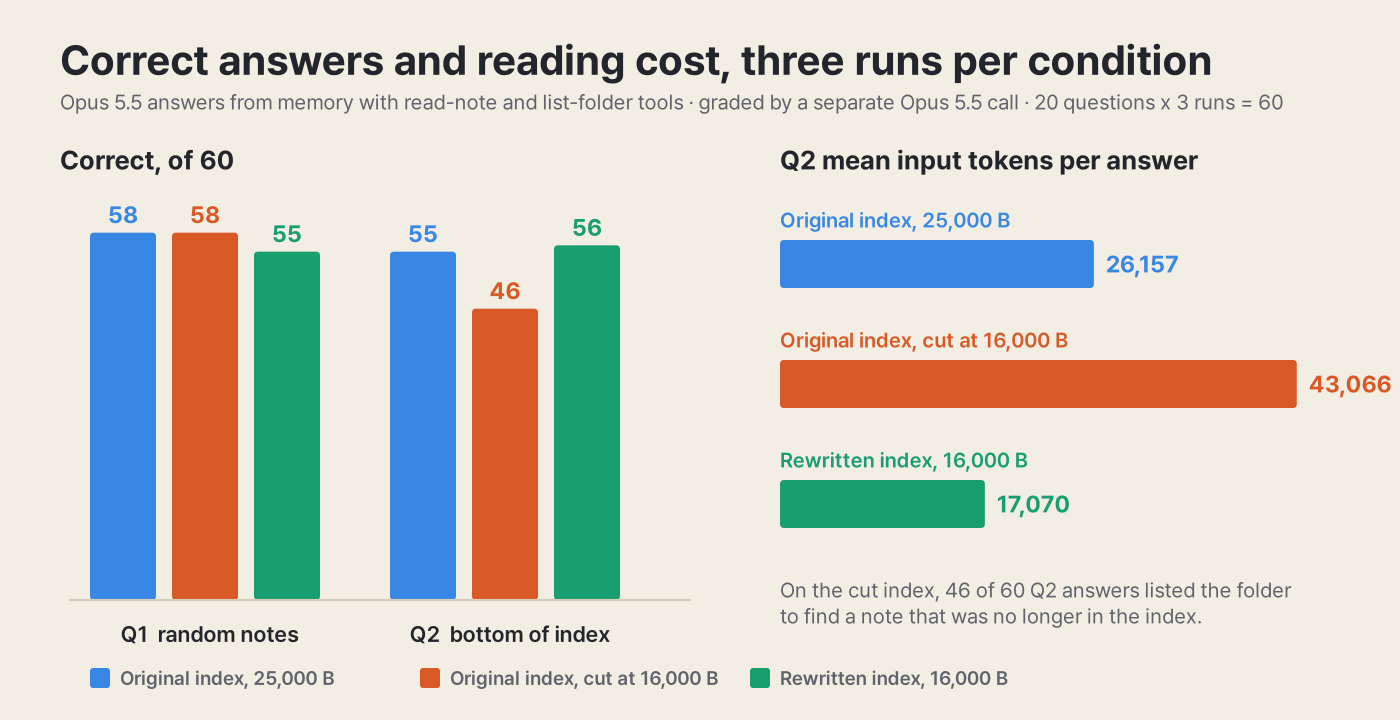
Q2에서 인덱스를 자르자 정답이 60개 중 55개에서 46개로, 15%포인트 줄었습니다. 에이전트는 인덱스에 메모가 없다고 포기하지는 않았습니다. 잘린 인덱스로 답한 Q2 60개 중 46개에서 폴더 목록을 열었고, 그중 41개는 파일 이름으로 맞는 메모를 찾아 정답을 냈습니다. 대신 폴더를 뒤지는 데 토큰이 많이 듭니다. 잘린 인덱스의 Q2 답은 평균 43,066토큰을 읽었는데, 자르지 않은 인덱스의 1.6배입니다. 인덱스가 잘려도 에이전트가 메모를 아예 못 찾게 되지는 않습니다. 다만 도구 호출이 약 세 배로 늘고(답 하나에 1.3회에서 3.9회), 그만큼 비싸지고, 조금 덜 정확해집니다.
정리한 인덱스에서는 Q2가 60개 중 56개로 돌아와 원래 인덱스와 같은 수준이 됐고, 답 하나에 17,070토큰을 읽었습니다. 폴더 목록을 열 필요는 한 번도 없었습니다.
Q1은 근거 메모 20개 중 16개가 잘리는 지점보다 위에 있어서, 세 조건 모두 5%포인트 안에 머물렀습니다(60개 중 58, 58, 55개). 비교 기준으로, 메모리가 전혀 없는 같은 에이전트는 20개 중 1개를 맞혔습니다.
Q2 질문 하나는 어느 인덱스에서도 틀렸습니다. 9번 중 8번 오답, 나머지 한 번은 부분 정답이었습니다. 근거 메모에는 이미 끝난 단계가 여전히 다음 할 일로 적혀 있었고, 끝났다는 기록은 다른 메모에만 있었습니다. 재작성도 이 낡은 메모를 고치지 못했습니다. 이 질문을 빼고 계산해도 결론은 같습니다(96.5%, 80.7%, 98.2%).
재작성이 잃은 것
질문은 누군가 물어볼 생각을 한 것만 확인합니다. 그래서 정리된 파일을 하나하나 직접 대조했습니다. 합쳐진 파일 21개와 고쳐진 파일 1개마다 Opus 5.5가 원래 메모에 있는 규칙, 숫자, 날짜를 모두 뽑고, 각각이 새 파일에 그대로 있는지, 빠졌는지, 바뀌었는지 표시했습니다.
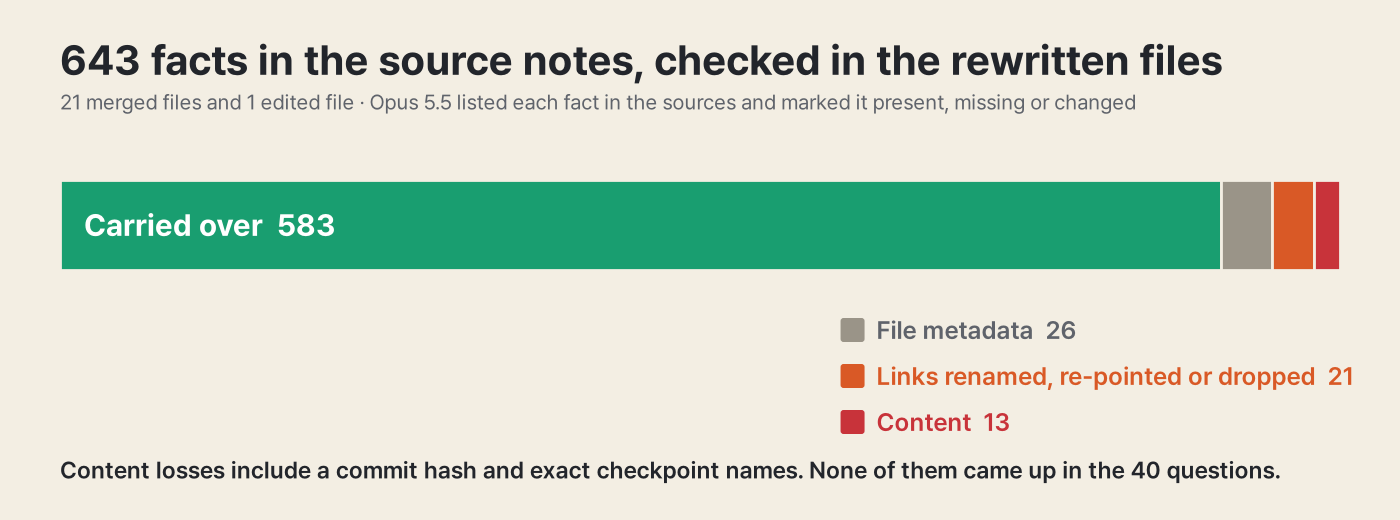
사실 643개 중 583개가 그대로 옮겨졌습니다. 나머지 60개 가운데 26개는 세션 ID나 수정 시각 같은 파일 메타데이터였고, 21개는 이름이 바뀌었거나 다른 곳을 가리키게 됐거나 사라진 링크였습니다. 남은 13개가 내용의 변화입니다. 이 13개는 원래 파일과 손으로 대조했고, 가장 분명한 것은 그냥 잃어버린 정보였습니다.
- 스테이징된 파일을 확인하라는 규칙이 왜 생겼는지 알려 주던 커밋 해시.
- 한 연재 메모에 있던 모델의 정확한 체크포인트 이름. 짧은 모델 이름은 남았지만, 어떤 체크포인트를 쟀는지 알려 주는 전체 이름은 사라졌습니다(하나는 다른 메모에 아직 남아 있습니다).
- 짧은 영상은 글보다 나중에 올린다는 순서 메모. 그 영상은 이미 올라간 뒤라 이번에는 해가 없었지만, 이 구절은 흔적 없이 빠졌습니다.
이와 별도로, 어떤 메모 파일과도 맞지 않는 [[...]] 링크 대상을 셌습니다(.md 유무, 대소문자, -와 _의 차이는 무시). 원래 메모리에는 19개, 정리한 메모리에는 28개였습니다. 합치면서 파일 이름이 바뀌었는데, 그 파일을 가리키던 링크가 다 고쳐지지는 않았습니다. 재작성 결과에 붙은 설명에도 이 점이 적혀 있었습니다. 옛 이름을 합친 파일 안에 남겨 두어 검색으로는 계속 찾을 수 있게 했다는 것입니다.
이 가운데 어느 것도 질문 40개에는 걸리지 않습니다. 모두 누군가 그 정보가 필요한 날에야 중요해지는 세부 사항입니다.
틀렸지만 손실은 아니었던 답
정리한 인덱스는 Q1 질문 두 개에서 틀렸습니다. 하나는 다운로드 패키지를 다시 만드는 방법을 묻는 질문이었습니다. 세 번 모두 에이전트가 합쳐진 연재 메모만 열고 거기서 링크된 패키지 메모는 열지 않았고, 그중 두 번은 이유와 명령이 빠진 답을 냈습니다. 다른 하나는 세 번 모두 정답을 받지 못한 질문으로, 유명 저자의 논문을 다룬 글을 어떻게 시작해야 하느냐고 물었습니다. 한 번은 오답, 두 번은 부분 정답이었습니다.
처음에는 재작성이 규칙을 바꾼 것처럼 보였습니다. 그렇지 않았습니다. 저희 원래 메모 두 개가 글 첫머리의 순서를 두고 이미 서로 다른 말을 하고 있었습니다. 한 메모는 저자의 주장으로 시작하라고 했고, 다른 메모는 과제를 쉽게 설명하기 전에 주장을 먼저 꺼내지 말라고 했습니다. 파일이 따로 있을 때 에이전트는 첫 번째 메모만 열었고, 같은 메모로 만든 기준 답과 일치했습니다. 두 번째 메모에는 어느 규칙이 우선인지가 이미 적혀 있었지만, 파일이 따로 있으니 에이전트가 열어 보지 않았습니다. 합친 뒤에는 그 문장이 첫 번째 규칙과 같은 파일에 들어갔고, 에이전트는 그 문장을 따랐습니다.
재작성이 없던 충돌을 만든 것이 아닙니다. 원래 있던 충돌을 눈앞에 드러냈고, 메모 하나씩을 기준으로 만든 채점이 그것을 오답으로 매긴 것입니다. 합치기의 좋은 면이기도 하고, 메모 하나씩을 기준으로 채점하는 방식의 한계이기도 합니다.
재작성을 받아들이기 전에 확인할 것
- 질문만 보지 말고 사실 단위로 대조합니다. 원래 메모마다 사실 목록을 뽑아 있음과 없음을 표시하니 커밋 해시와 체크포인트 이름이 잡혔습니다. 질문으로는 못 잡았습니다.
- 끊긴 링크를 전후로 셉니다. 어떤 파일과도 맞지 않는
[[...]]대상을 나열하는 짧은 스크립트면 충분합니다. - 재작성이 해결한 충돌은 모두 읽습니다. 저희 프롬프트는 서로 어긋나는 내용이 있으면 더 최근 것을 남기라고 했고, 재작성은 해결한 충돌을 하나하나 설명에 적었습니다. 하나하나가 여러분의 규칙에 관한 결정이니 그 목록을 읽어야 합니다.
- 확인이 끝날 때까지 옛 파일을 남겨 둡니다. 저희는 복사본에 적용했고, 실제 메모리는 그대로입니다.
한계
- 메모리 하나에 재작성 한 번입니다. 한 번만 돌렸기 때문에, 다시 돌리면 결과가 얼마나 달라질지 모릅니다.
- 질문을 만들고, 답하고, 채점한 모델이 모두 같습니다. 채점자 자신의 해석과 맞는 답이 후하게 매겨졌을 수 있습니다.
- 잘림은 한도를 16,000바이트로 낮춰 흉내 낸 것입니다. 실제로는 잘리기 전에 Claude Code가 인덱스를 줄이라고 요청하므로, 이만큼 잘리는 것은 그 요청을 무시했을 때뿐입니다.
- 답하는 에이전트는 도구 두 개를 가진 작은 루프이지 Claude Code 자체가 아닙니다. 인덱스는 Claude Code가 넣어 주는 방식대로 보지만, Claude Code의 다른 컨텍스트는 없습니다.
- 저희 재작성은 메모만 읽었습니다. Anthropic의 dreaming은 메모를 대화 기록과도 맞춰 보므로, 위에서 본 손실 일부를 잡았을 수도 있습니다.
비용
재작성, 질문 40개 생성, 채점한 답 420개, 사실 대조까지 모두 합쳐 Opus 5.5에서 입력 약 300만 토큰, 출력 48만 토큰, 캐시 읽기 810만 토큰, 캐시 쓰기 14만 토큰을 썼습니다. 입력 100만 토큰당 4달러, 출력 20달러, 캐시 읽기 0.20달러, 캐시 쓰기 5달러로 계산하면 약 24달러입니다. 재작성 하나만 보면 약 2.40달러였습니다.
Claude Code 메모리를 쓰고 있다면 오늘 MEMORY.md 크기를 한번 확인해 보세요. 한도에 가깝다면 재작성은 어차피 하게 됩니다. 그때는 질문 몇 개로 끝내지 말고 사실 하나하나를 대조해 보시길 권합니다.