Attention Sink: Qwen3-8B는 왜 첫 단어에 attention을 최대 77%나 줄까 (바나나로 바꿔도 비슷합니다)
Qwen3-8B가 어디를 보는지 재 보니 7층부터 attention의 26-77%가 첫 토큰으로 갔고, 그 토큰을 ' banana'로 바꿔도 거의 그대로였습니다(0.4588 대 0.4577). 왜 그런지 논문 다섯 편으로 차례대로 풀고(마지막 편은 attention 출력에 게이트를 달아 논문이 분석한 모델의 첫 토큰 몫을 46.7%에서 4.8%로 줄였습니다), 같은 측정을 돌려 볼 수 있는 노트북도 함께 드립니다.
Attention Sink: Qwen3-8B는 왜 첫 단어에 attention을 최대 77%나 줄까 (바나나로 바꿔도 비슷합니다)
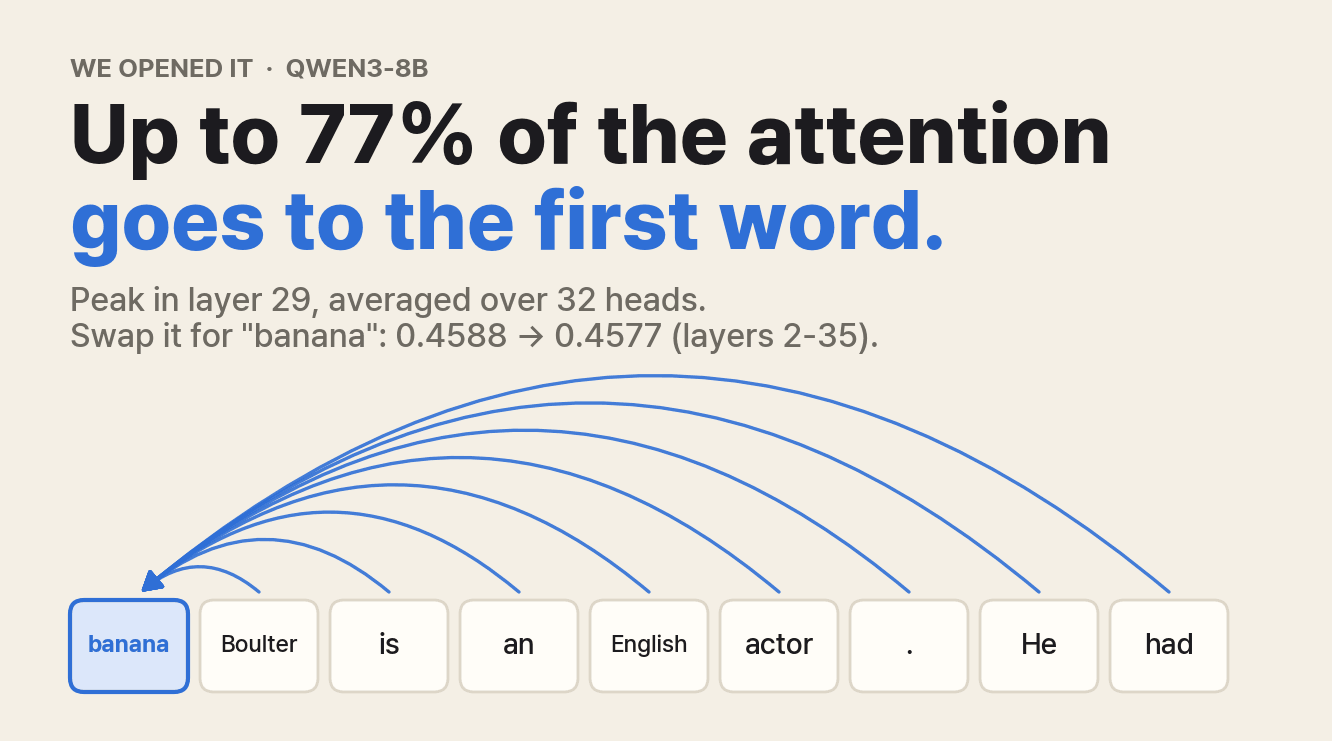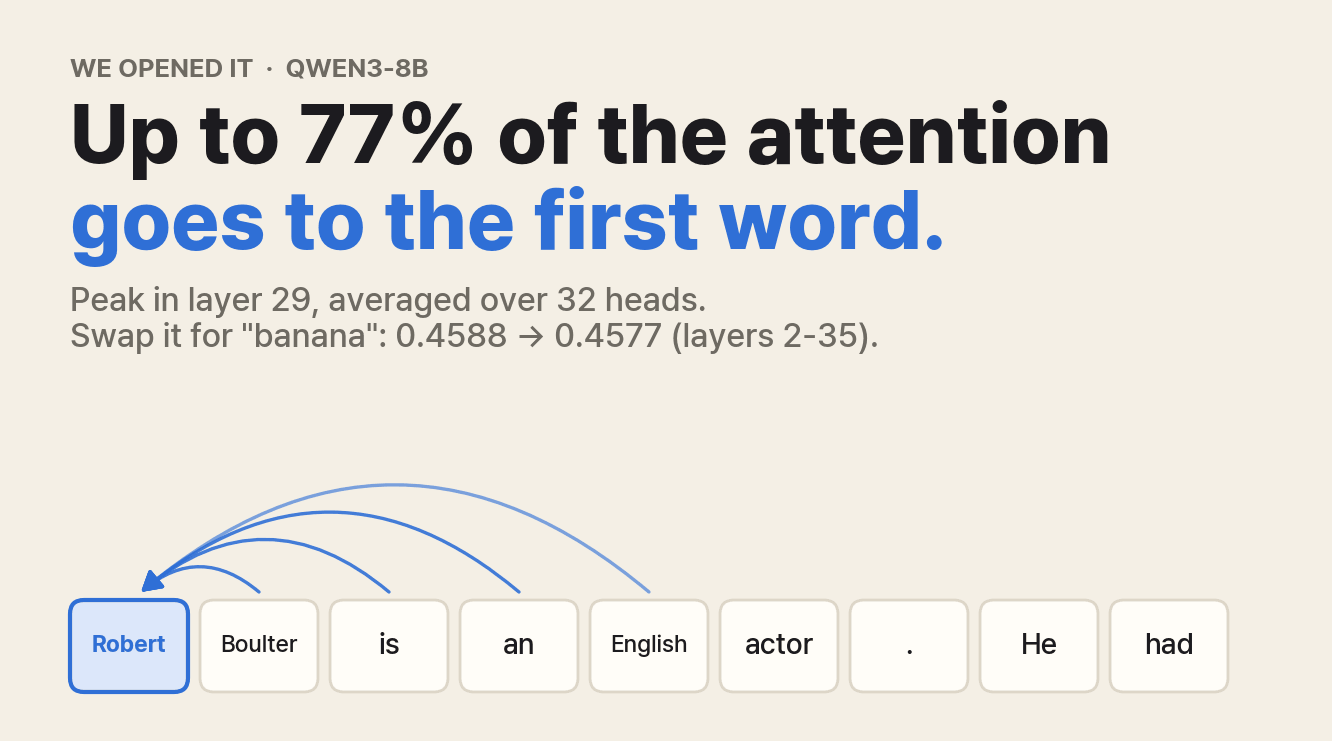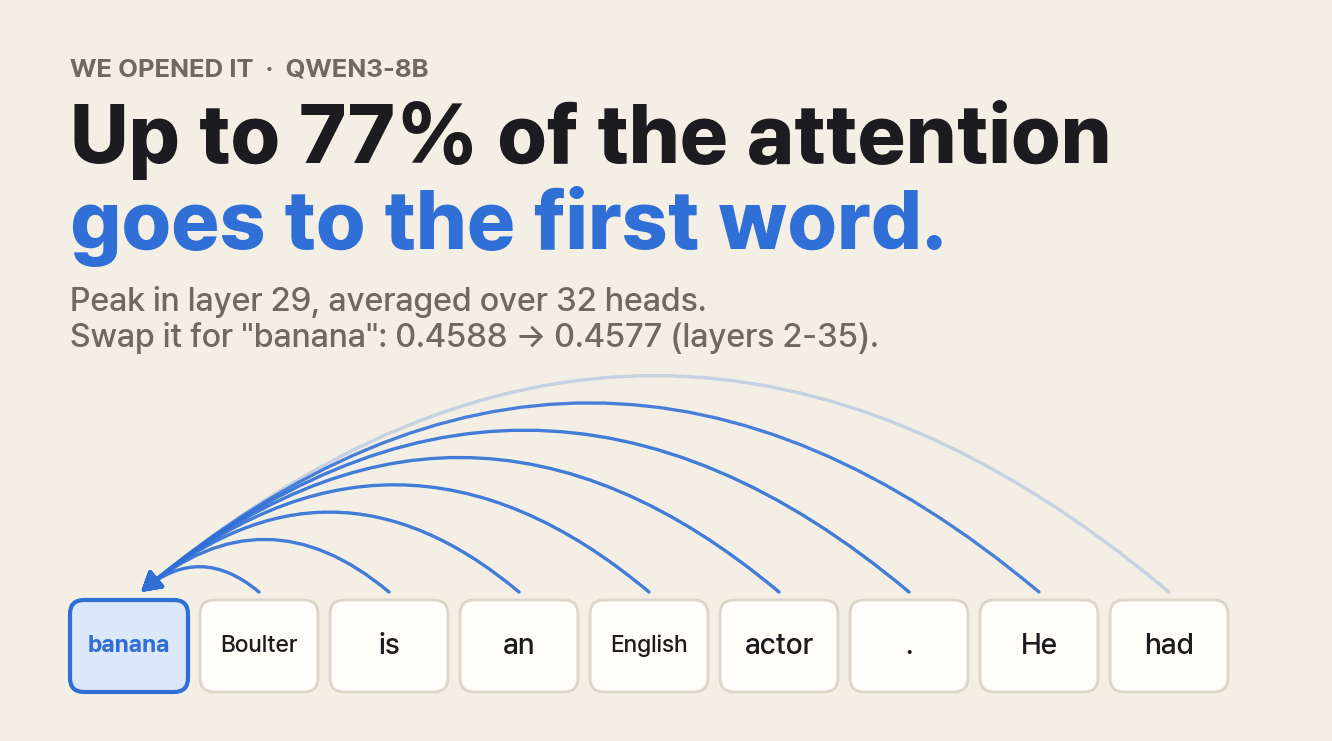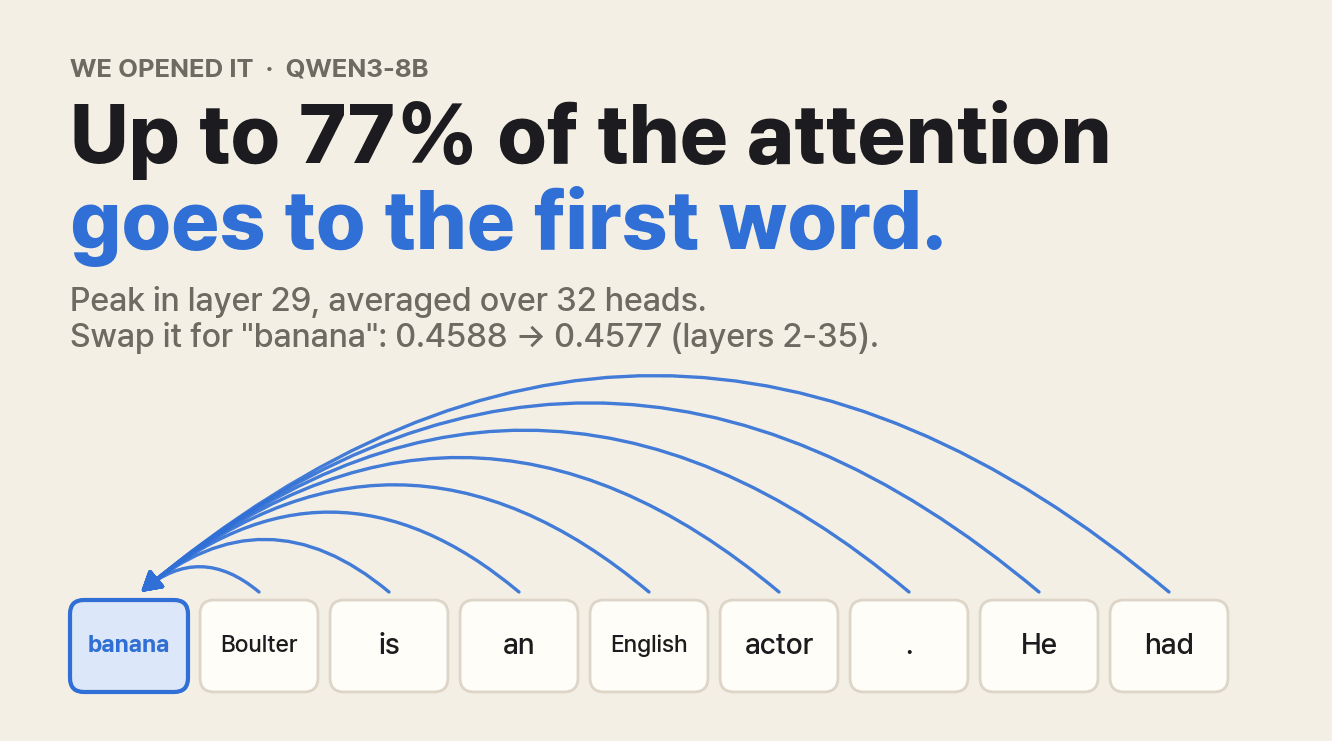
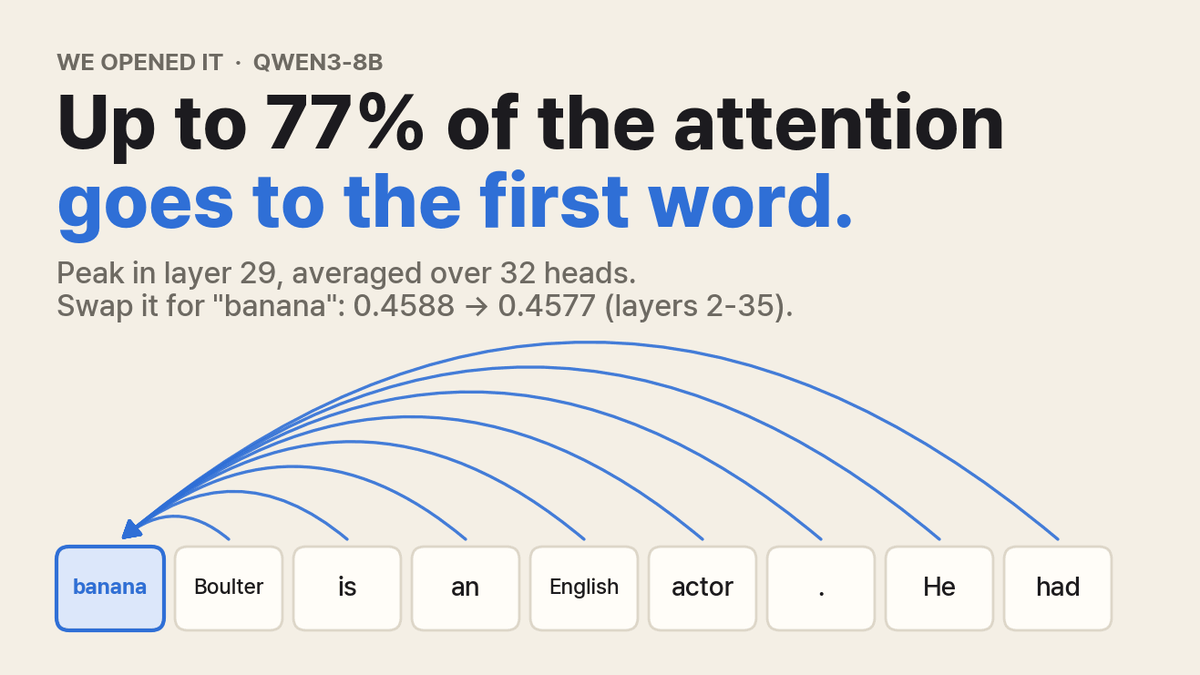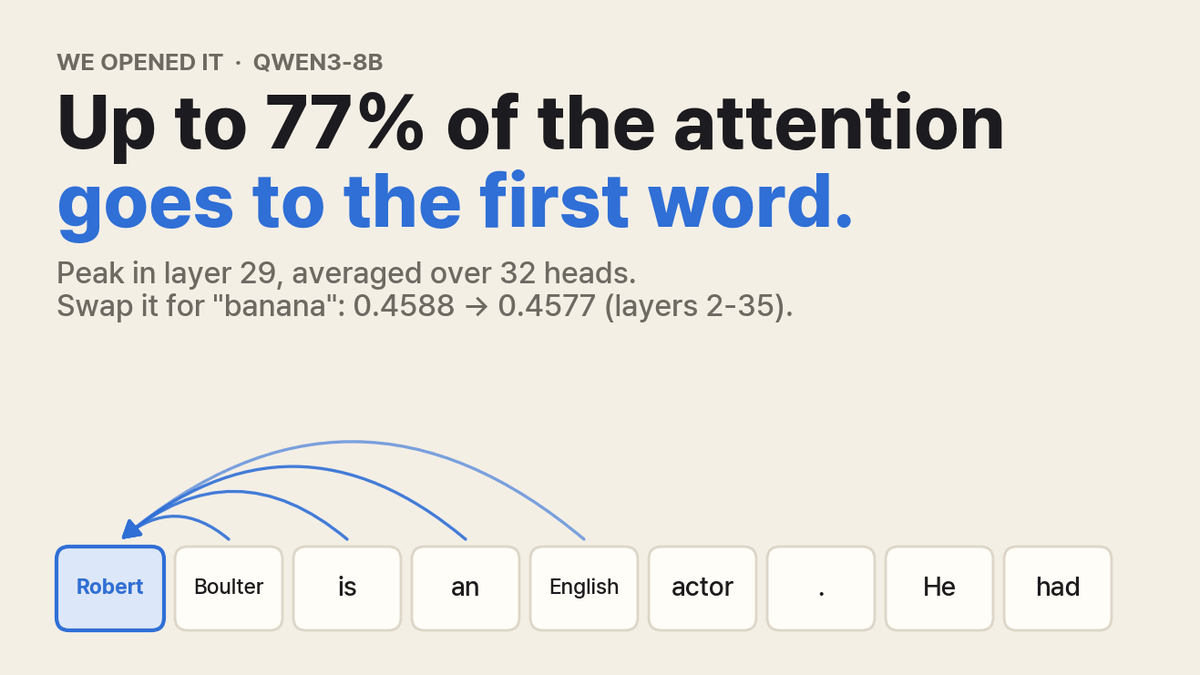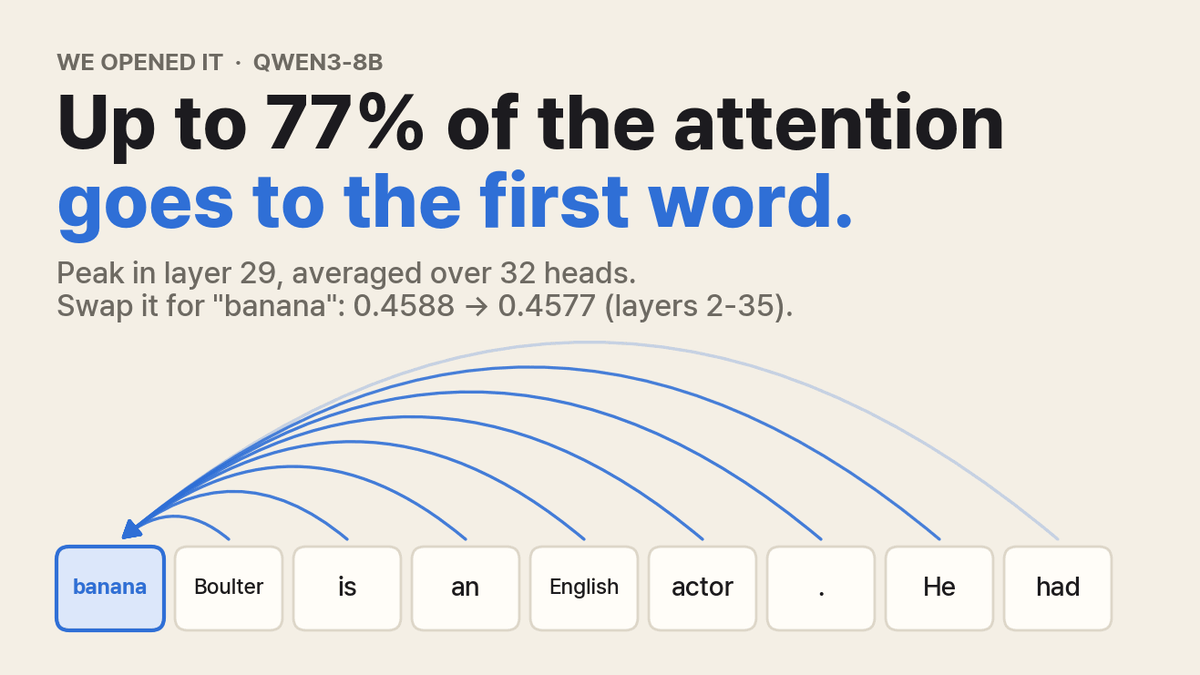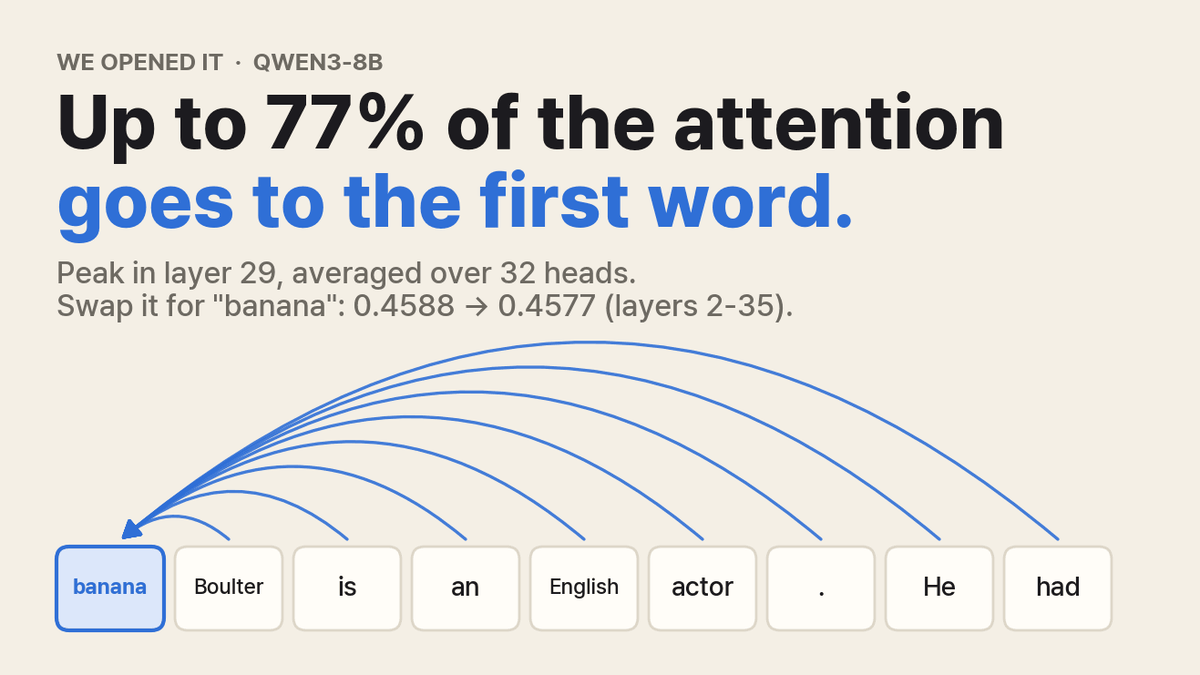
Qwen3-8B에 위키백과 글 20토막을 읽히고 한 가지를 물었습니다. 글 중간의 단어가 앞 단어들을 돌아볼 때 어디를 가장 많이 볼까요? 29층에서는 답이 "맨 앞 단어"였습니다. 볼 수 있는 앞 단어가 256-511개나 되는데, 맨 앞 한 단어가 attention의 77%를 가져갔습니다. 그 단어가 특별하지도 않았습니다. 어떤 토막은 " Robert"로 시작했고, 어떤 토막은 단어가 잘려 "oul"로 시작했습니다. 이 첫 단어를 " banana"로 바꿔도 비율은 거의 움직이지 않았습니다(2-35층 평균 0.4588 대 0.4577).
이 현상을 attention sink라고 부르고, 2023년부터 연구가 이어지고 있습니다. 이 글은 세 부분으로 되어 있습니다. 저희가 Qwen3-8B에서 무엇을 어떻게 쟀는지, 이 현상이 왜 생기고 무슨 일을 하는지 설명하는 논문 다섯 편, 그리고 같은 측정을 직접 돌려 볼 수 있는 노트북입니다.
먼저, 여기서 말하는 attention
언어 모델은 단어 하나를 읽을 때 층마다 앞에 나온 단어들을 돌아보고, 각 단어에서 얼마씩 정보를 가져올지 정합니다. 이 "얼마씩"은 앞 단어마다 하나씩 붙는 가중치이고, 가중치를 다 더하면 항상 1입니다. 이 합을 1로 만들어주는 도구가 softmax인데, 이 글의 이야기는 전부 이 softmax 결과의 "합이 1" 규칙에서 나옵니다.
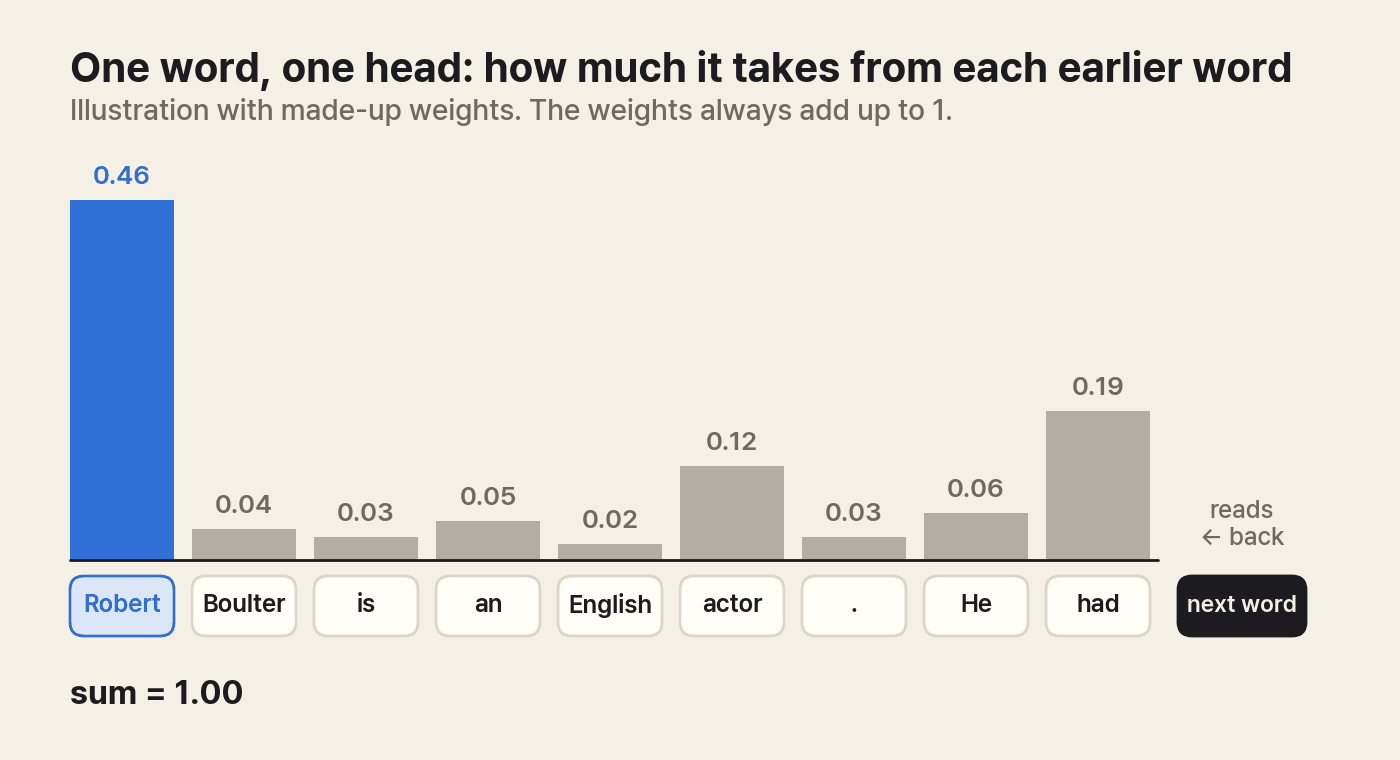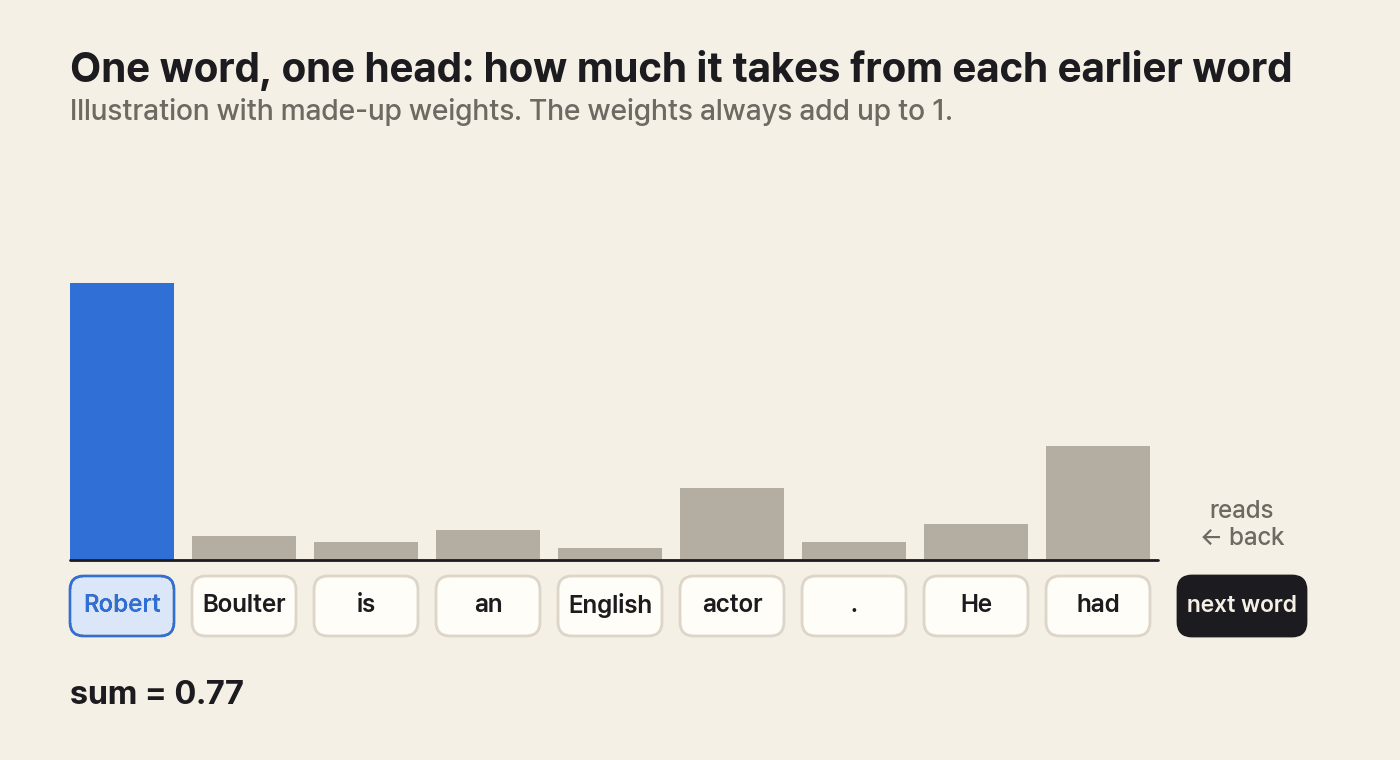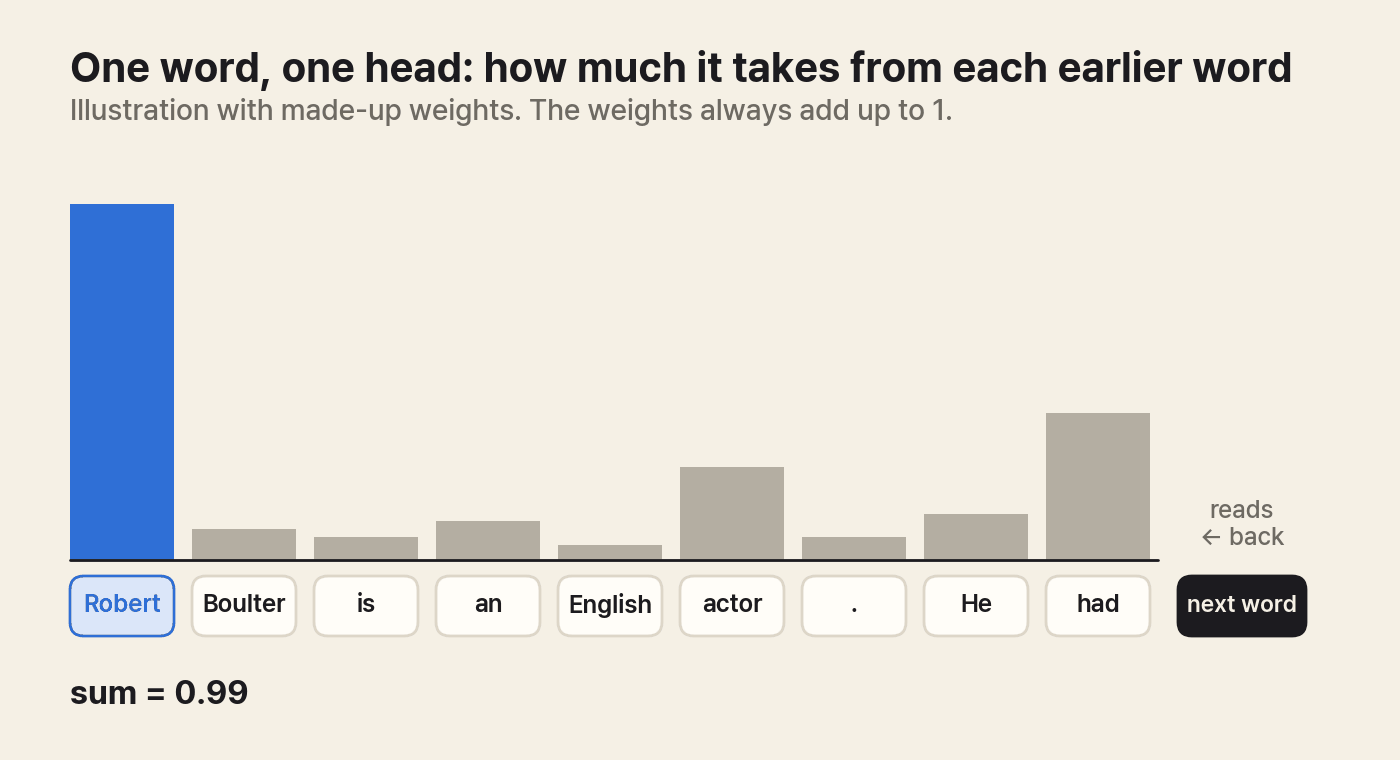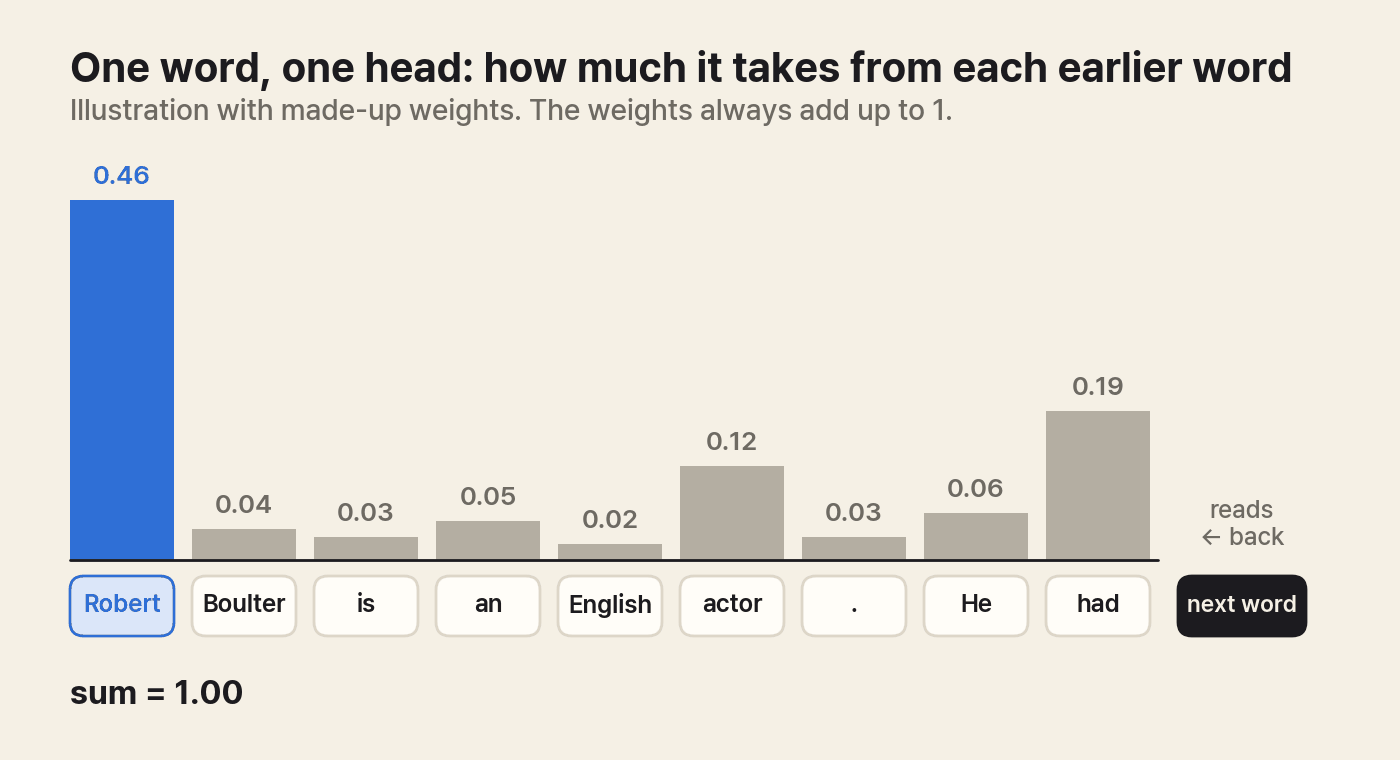
한 층은 이 계산을 여러 갈래로 나눠 동시에 합니다. 그 한 갈래를 head(헤드)라고 부르고, Qwen3-8B는 36개 층마다 헤드가 32개 있습니다. 헤드마다 가중치 목록을 따로 만듭니다.
그래서 "attention의 77%가 첫 단어로 간다"는 말은 이런 뜻입니다. 20토막 각각의 256-511번 자리 단어들과 헤드 32개 전부에 대해, 0번 자리가 받은 가중치를 평균했더니 29층에서 0.77이었습니다.
왜 쟀고, 어떻게 쟀나
attention sink는 Llama 2 같은 2023년 모델에서 처음 보고됐습니다. 저희는 지금 많이 쓰는 모델에서도 같은지 직접 보고 싶었고, 질문은 세 가지였습니다.
- Qwen3-8B에도 있나, 있다면 얼마나 센가? 확신하지 못했습니다. attention은 단어 사이 관련도를 두 벡터(query와 key)를 비교해 매기는데, Qwen3는 비교하기 전에 두 벡터의 크기를 맞추는 정규화(QK-norm) 과정이 있습니다. 그러면 한 자리가 attention을 독차지하기 어려울 수도 있습니다.
- 자리 때문인가, 단어 때문인가? 모델이 그 단어의 뜻을 보고 몰려가는 것이라면 단어를 바꾸면 달라져야 합니다. 자리 때문이라면 무슨 단어든 상관없어야 합니다.
- 모델이 그 토큰을 꼭 봐야 하나? 그 토큰을 가리면 다음 단어를 맞히는 실력이 떨어질까요?
설정과 각각의 설정값을 고른 이유는 이렇습니다.
- Qwen3-8B, bf16. 지금 쓰이는 공개 모델이고 GPU 한 장에 올라갑니다. 게다가 글 앞에 특수한 시작 토큰(⟨bos⟩ 등)을 붙이지 않아서 0번 자리가 평범한 단어 조각입니다. 그래서 위의 질문 2(자리 때문인가, 단어 때문인가?)를 깔끔하게 시험할 수 있습니다. 늘 시작 토큰을 맨 앞에 붙이는 모델에서는 "첫 자리"와 "그 특수 토큰"을 떼어 볼 수 없기 때문입니다.
- WikiText-2 테스트 세트, 1,024토큰짜리 20토막. 누구나 내려받을 수 있는 평범한 백과사전 글입니다. 빈 줄과 소제목 줄을 빼고 이어 붙인 뒤 겹치지 않게 잘랐습니다. 그래서 토막마다 글 중간 아무 데서나 시작합니다.
- 각 토막의 256-511번 자리 단어. 이 단어들은 모두 앞 단어를 256개 이상 볼 수 있습니다. 고르게 나눠 본다면 첫 단어 몫은 약 0.27%밖에 안 됩니다. 그러니 0번 자리에 큰 몫이 가면 우연과 쉽게 구별됩니다.
- transformers의 "eager" attention. 빠른 attention 커널은 가중치를 밖으로 출력하지 않습니다. 기본 구현은
output_attentions=True로 요청하면 볼 수 있습니다.
측정의 핵심은 코드 세 줄입니다.
att = model(input_ids, output_attentions=True).attentions   # 층마다 텐서 하나
# att[층]의 모양은 [batch, head, query, key]; key 0이 첫 토큰
share = [a[0, :, 256:512, 0].mean().item() for a in att]     # 층마다: 헤드와 query 위치에 대해 평균
질문 3은 attention 마스크를 직접 만들어 넘겨서 확인했습니다. 보통 마스크는 각 단어가 자기 자신과 앞의 모든 단어를 보게 합니다. 0번 자리를 가리려면 그 뒤 모든 단어에게 0번 자리를 막습니다. 토큰은 글 안에 그대로 있고 위치 번호도 그대로입니다. 뒤 단어 누구도 그 토큰을 볼 수 없을 뿐입니다.
m = torch.full((n, n), NEG).triu(1)   # NEG = bf16에서 가장 작은 음수, 곧 "볼 수 없음"
m[1:, 0] = NEG                        # 0번 뒤의 단어는 아무도 0번을 못 봄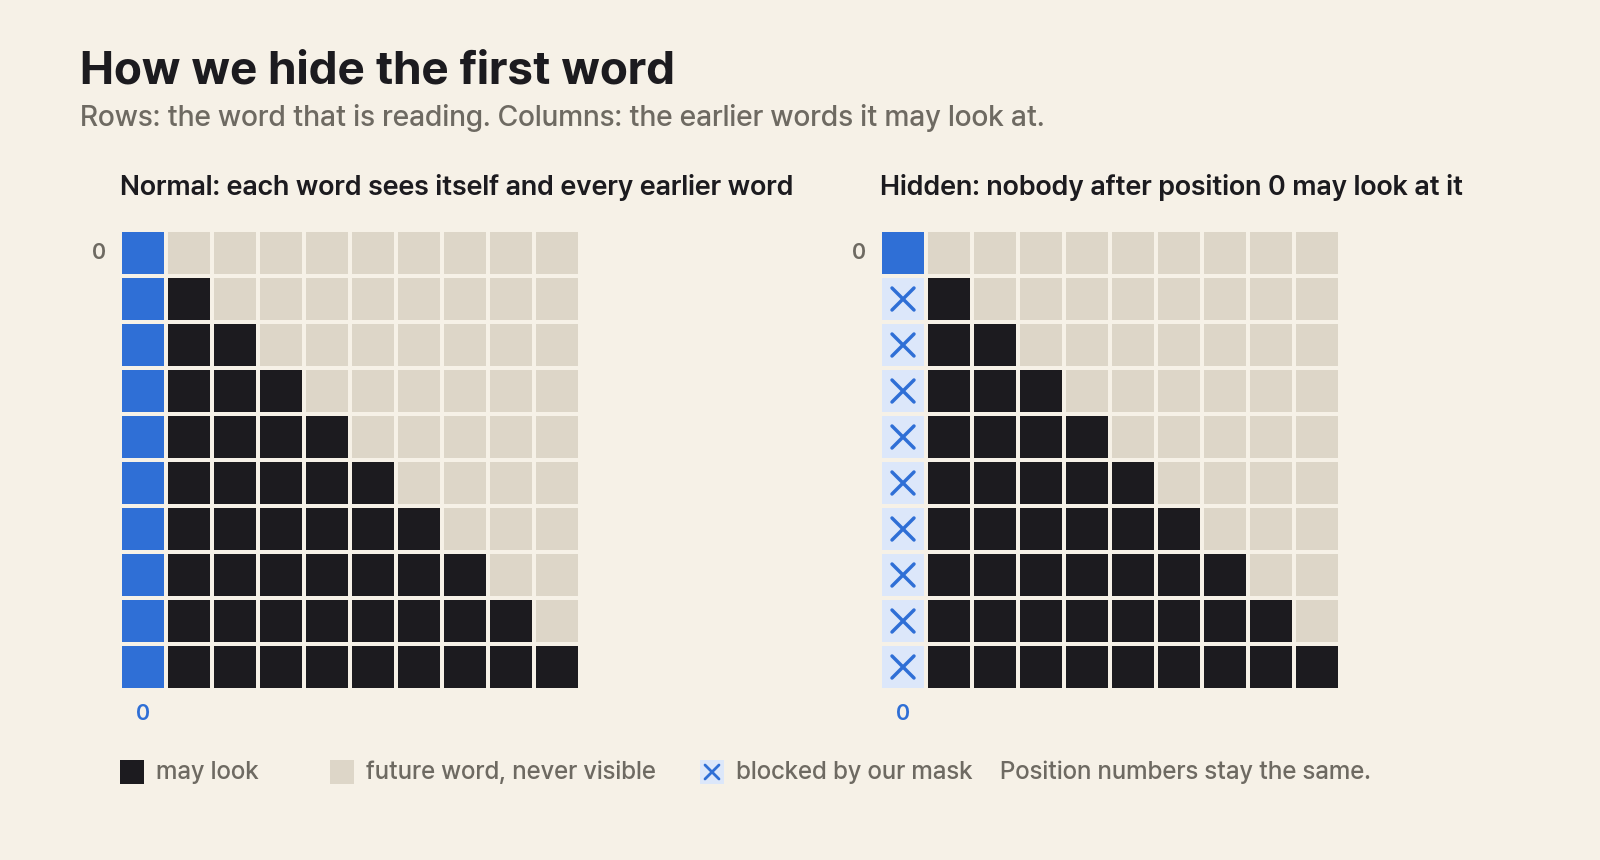
이 마스크를 믿기 전에 확인부터 했습니다. 각 단어가 자기와 앞 단어만 보게 하는 보통 마스크를 causal 마스크라고 부릅니다. 이 causal 마스크를 직접 넘겼을 때 마스크를 안 넘긴 것과 출력이 똑같아야 합니다. 실제로 똑같았습니다(가장 큰 차이 0.0).
저희는 실험을 돌리기 전에 예측과 측정 방법을 시각이 찍히는 기록으로 먼저 적어 두었습니다. 그중 예측 하나는 36개 층 중 30개 층 이상에서 첫 토큰이 attention의 20% 이상을 받는다였습니다. 풀어 쓰면, 한 단어가 나눠 주는 가중치 합 1 가운데 0.2 이상이 0번 자리로 간다는 뜻입니다. 이 값은 헤드 32개와 256-511번 자리에 대해 평균한 값입니다. 20%는 고르게 나눌 때의 몫(0.27%)의 약 74배이니, 이만큼 몰리면 우연으로 보기 어렵습니다. 확신은 65% 정도로 적었습니다. 앞에서 말한 QK-norm 때문입니다.
예측은 모두 여덟 개였고, 맞고 틀린 결과를 아래에 전부 적었습니다. 세 가지 측정은 모두 글 끝의 노트북에서 다시 돌려 볼 수 있습니다.
측정 결과
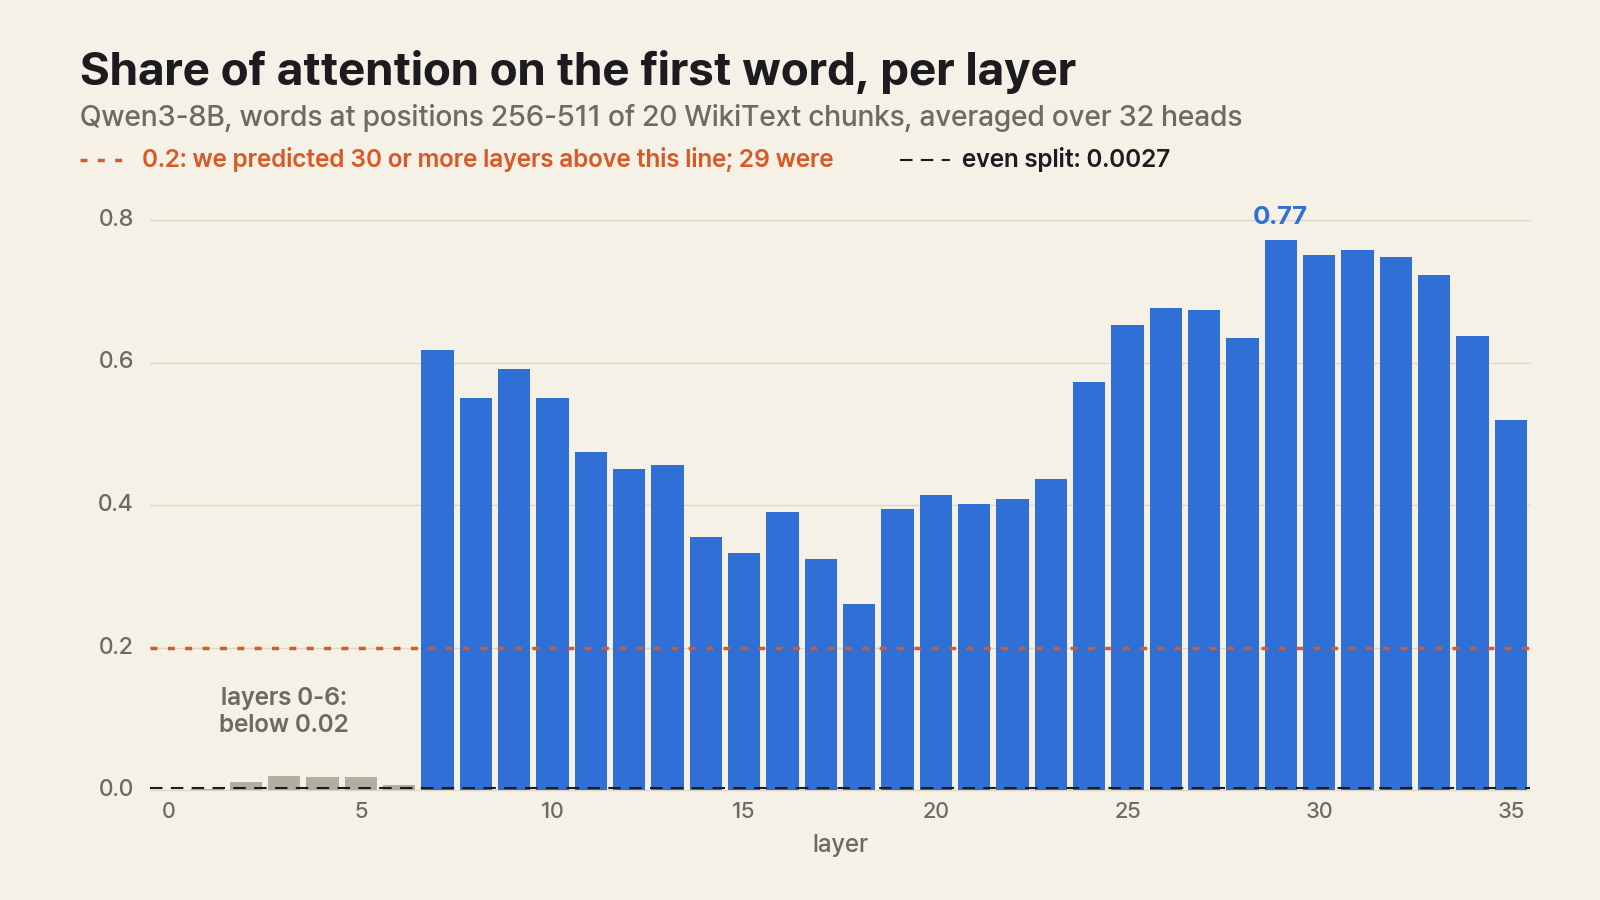
- 0-6층: 거의 없습니다. 첫 단어 몫이 0.04%에서 1.9% 사이입니다.
- 7층: 62%로 뛰어오릅니다.
- 7-35층: 모든 층이 26%에서 77% 사이입니다. 가장 높은 층은 29층, 77%입니다.
0.2를 넘은 층은 29개로, 예측한 30개에 하나가 모자랐습니다. 한 층 차이지만 틀린 예측으로 셉니다. 대신 쏠림 자체는 예상보다 셌습니다. 29층에서 첫 단어는 고르게 나눌 때의 약 285배를 받았습니다(0.7714 ÷ 0.00270, 저희 계산).
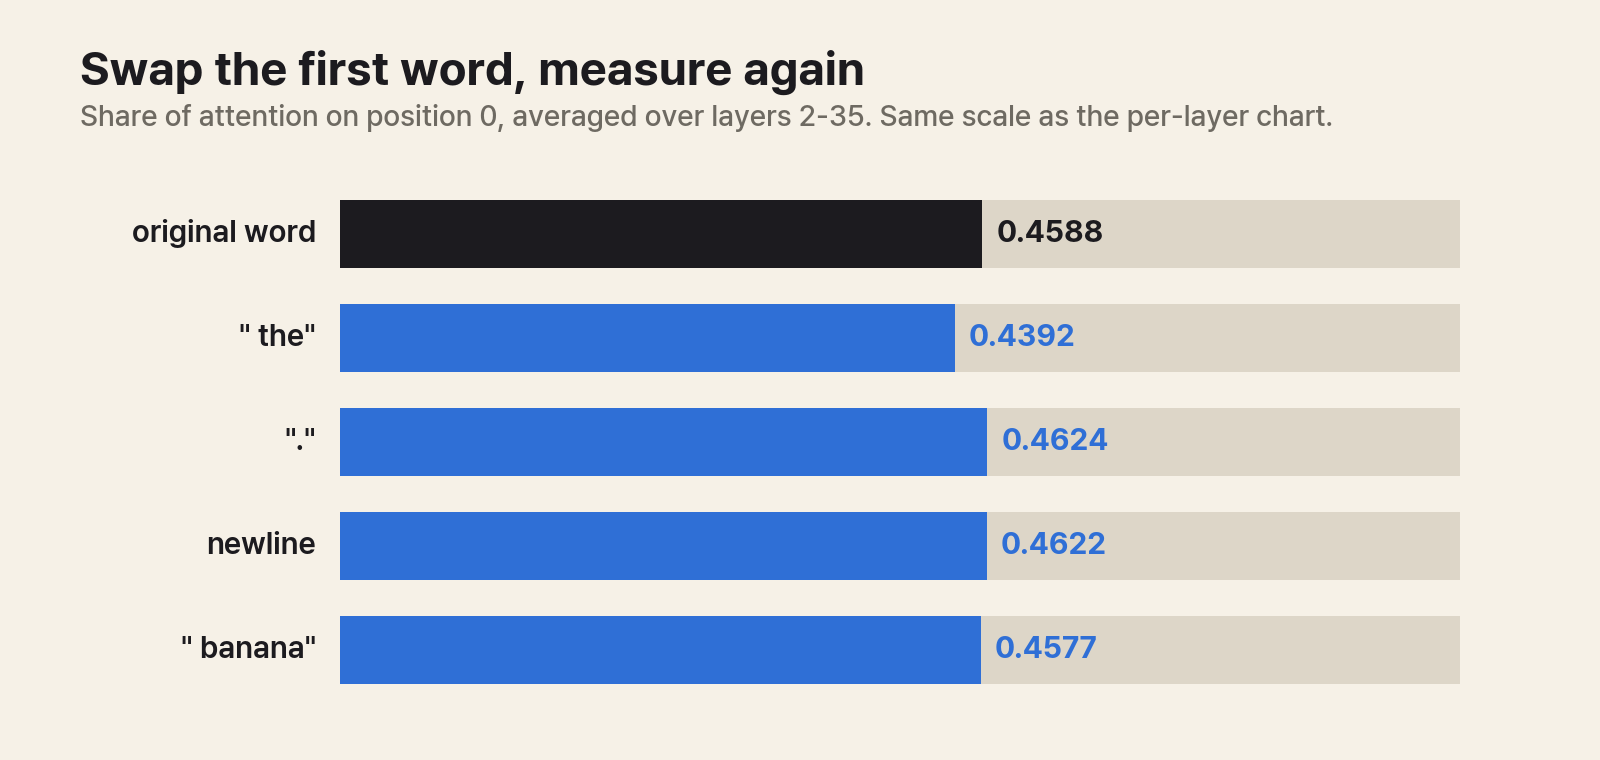
다음으로 첫 토큰을 바꿔봤습니다. 토막의 나머지는 그대로 두고 첫 토큰만 " the", ".", 줄바꿈, " banana"로 바꿨습니다. 2-35층 평균은 이렇습니다.
| 첫 토큰 | 0번 자리가 받은 attention 비율 (2-35층 평균) |
|---|---|
| 원래 단어 | 0.4588 |
| " the" | 0.4392 |
| "." | 0.4624 |
| 줄바꿈 | 0.4622 |
| " banana" | 0.4577 |
단어는 상관이 없었고 자리가 중요했습니다. 이건 예측대로였습니다.
그렇다면 모델은 왜 맨 앞에 우연히 놓인 단어에 attention을 이렇게 많이 줄까요? 논문 다섯 편이 한 단계씩 답합니다.
1단계: softmax는 attention을 어딘가에 줘야 합니다
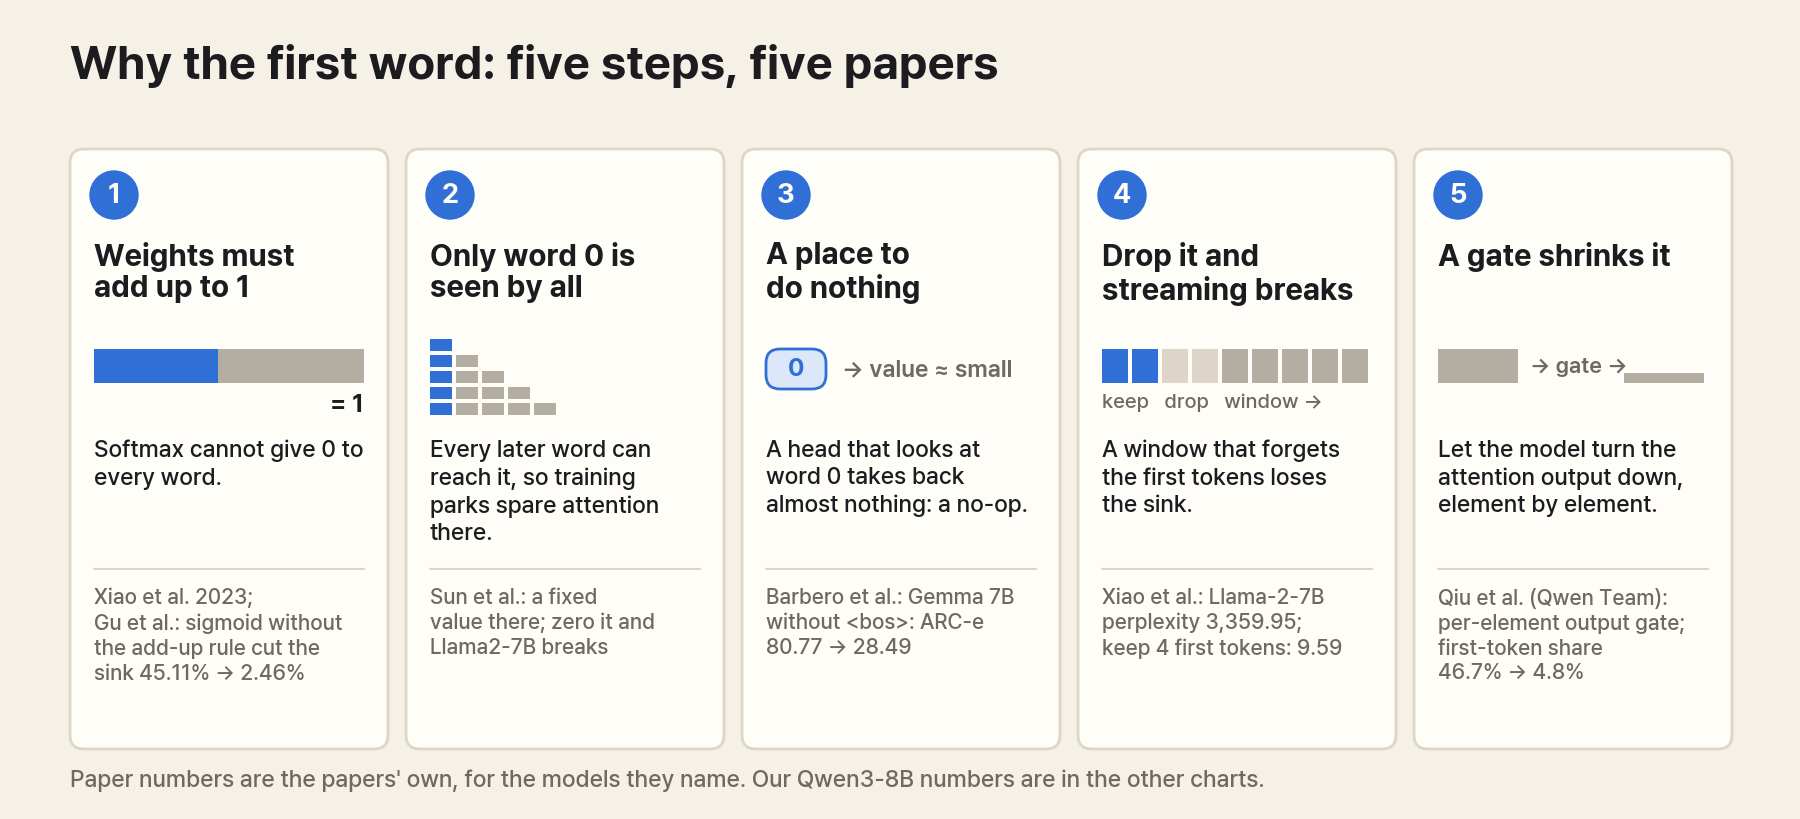
논문: Xiao 외, "Efficient Streaming Language Models with Attention Sinks" (MIT, Meta AI, CMU, NVIDIA; ICLR 2024, arXiv 2309.17453). attention sink라는 이름을 붙인 논문입니다.
질문. Llama 2 같은 모델에서 왜 그렇게 많은 헤드가 지금 단어와 아무 관계 없는 맨 앞 몇 토큰에 큰 가중치를 줄까요?
설명. 가중치는 softmax에서 나옵니다. softmax는 단어마다 계산된 점수를 합이 1인 몫으로 바꾸는 함수입니다. 그래서 "쓸 만한 단어가 하나도 없으니 전부 0을 주겠다"고 말할 방법이 없습니다. 논문은 이렇게 씁니다. 지금 query와 잘 맞는 앞 토큰이 별로 없어도 "모델은 이 필요 없는 attention 값을 합이 1이 되도록 어딘가에 배정해야 한다".
여기까지는 설명이고, 시험은 1년 뒤에 나왔습니다.
논문: Gu 외, "When Attention Sink Emerges in Language Models: An Empirical View" (Sea AI Lab, NUS; ICLR 2025, arXiv 2410.10781).
질문. 학습에서 무엇이 sink를 만드나요? 옵티마이저, 데이터, 손실 함수, 아니면 attention 자체일까요?
방법. 먼저 GPT-2, OPT, Pythia, Llama 2, Llama 3, Mistral 등을 측정했습니다. 이들의 지표는 첫 토큰에 전체 attention의 30% 넘게 주는 헤드가 전체 헤드 중 몇 개인지를 셉니다. 여섯 계열 모두에서 sink가 나왔고, 파라미터가 1,400만 개뿐인 Pythia-14M에서도 나왔습니다. 그다음에는 Llama 구조의 작은 모델(약 6,000만 파라미터, 큰 실험은 10억까지)을 처음부터 학습시키며 한 번에 하나씩 바꿨습니다.
결과. sink는 충분한 데이터로 학습이 잘 된 뒤에야 나타났습니다. 학습 데이터를 50억 토큰에서 5,000만 토큰으로 줄이면 생기지 않았습니다. 결정적인 실험은 softmax를 sigmoid로 바꾼 것입니다. sigmoid는 단어마다 따로 점수를 매기고 합을 1로 맞추지 않습니다. 10억 파라미터 모델에서 sink 지표가 softmax일 때 45.11%에서 정규화 없는 sigmoid일 때 2.46%로 떨어졌고, 검증 손실은 3.07과 3.10으로 비슷했습니다. sigmoid 가중치는 합이 1인 몫이 아니라서, 2.46%는 비교할 수 있도록 따로 정한 점수로 잰 값입니다. sigmoid에 합을 1로 맞추는 정규화를 다시 넣자 sink가 돌아왔습니다.
저희 결과에 주는 의미. Gu 외의 설명대로라면 sink는 합이 1이라는 규칙과 충분한 학습에서 나옵니다. Qwen3-8B는 둘 다 갖췄고, sink도 있었습니다. 저희 결과는 이 설명과 맞습니다.
2단계: 왜 하필 첫 단어인가
남는 attention을 둘 곳이 필요하다면, 모든 단어가 닿을 수 있는 곳이어야 합니다. 왼쪽에서 오른쪽으로 읽는 모델에서 각 단어는 자기 앞 단어만 봅니다. 뒤에 오는 모든 단어가 볼 수 있는 단어는 첫 단어 하나뿐입니다. Xiao 외의 표현으로는 첫 토큰들이 "거의 모든 뒤 토큰에게 보이기 때문에 attention sink 역할을 하도록 학습되기 더 쉽다"고 합니다.
이 논문에는 저희 바나나 실험의 이른 형태도 있습니다. Llama-2-13B에서 맨 앞 토큰 네 개를 줄바꿈 네 개로 바꿨습니다. 모델이 글을 얼마나 뜻밖이라고 느끼는지 재는 perplexity(낮을수록 좋음)가 원래 토큰일 때 5.40, 줄바꿈일 때 5.60이었습니다. PG19 모음집의 책 한 권에서, 맨 앞 토큰 4개와 최근 토큰 1,020개만 남긴 상태로 잰 값입니다. 최근 토큰만 남기면 5,158.07이었으니, 무엇이 놓였든 맨 앞 자리를 남기는 것이 중요했습니다. 결론은 "첫 토큰들의 의미보다 절대 위치가 더 중요하다"였습니다.
그 자리는 무엇으로 attention을 그렇게 세게 끌어당길까요? 세 번째 논문이 모델 안의 숫자를 들여다봤습니다.
논문: Sun 외, "Massive Activations in Large Language Models" (CMU, Meta AI, Bosch Center for AI; arXiv 2402.17762).
결과. 모델 안에서 단어 하나를 나타내는 숫자 수천 개 가운데 몇 개가 엄청나게 큽니다. Llama2-7B에서 가장 큰 값은 약 2,000으로, 보통 값(중앙값 약 0.2)의 약 10,000배입니다. Llama2-13B, Mixtral-8x7B, Phi-2에서도 같은 것을 찾았습니다. 이 massive activation은 시작 단어에, 모델에 따라서는 첫 마침표나 줄바꿈에도 생깁니다. 입력이 달라도 "대체로 일정하게 유지되기" 때문에 저자들은 이것을 고정된 bias로 봅니다. 모델이 그 자리에 상수를 두도록 학습했다는 뜻입니다.
bias라는 생각을 시험한 방법. Llama2-7B에서 그 몇 개 값만 0으로 바꿨더니 WikiText, C4, PG-19에서 perplexity가 무한대가 됐습니다. 모델이 완전히 망가진 것입니다. 같은 값을 0 대신 평균값으로 바꾸자 perplexity는 움직이지 않았습니다(WikiText에서 둘 다 5.47). 모델에게는 그 값이 있어야 하지만, 그 값이 글에 따라 달라질 필요는 없습니다.
저자들은 이 값과 attention도 연결했습니다. Llama2-7B에서는 3층부터 attention이 "massive activation이 있는 두 토큰에 주로 몰린다"고 합니다.
Gu 외는 attention 쪽에서 출발해 같은 결론에 이릅니다. sink는 "key bias처럼 작동하며, 여분의 attention 점수를 담아 두되 그 점수는 아무 정보도 없을 수 있고 value 계산에 기여하지 않는다"고 씁니다. 쉽게 말하면 0번 자리는 attention을 빨아들이고 돌려주는 것은 거의 없는 고정된 자리가 됩니다.
3단계: sink는 무엇에 쓰이나
남는 attention을 받아 두는 자리가 있다는 설명은 attention이 어디로 가는지만 말해 줍니다. 모델이 애초에 왜 남는 attention을 원하는지는 설명하지 않습니다.
논문: Barbero 외, "Why do LLMs attend to the first token?" (Oxford, Google DeepMind 등; COLM 2025, arXiv 2504.02732).
답. attention은 층마다 단어 사이에 정보를 섞습니다. 긴 글을 읽는 깊은 모델에서 층마다 너무 많이 섞으면 단어마다의 표현이 서로 비슷해져서, 모델이 어느 단어가 어느 단어인지 놓칩니다. 저자들은 이것을 over-mixing이라고 부릅니다. 첫 단어로 attention을 보내는 헤드는 지금 처리하는 단어에 거의 아무것도 더하지 않습니다. 그 자리에 담긴 value(attention을 준 단어에게 넘겨주는 정보)가 작기 때문입니다(Gemma 7B의 헤드 하나로 보여 줍니다). 논문의 표현으로 attention sink는 "근사적인 no-op을 만드는 데 도움이 된다". no-op은 아무 일도 하지 않는 연산입니다. 헤드가 한 차례 쉬어 갈 방법이 생기는 셈입니다.
측정. Gemma 7B는 0번 자리에 특수한 시작 토큰(⟨bos⟩)을 둡니다. 추론할 때 이것을 빼자 초등 과학 문제(ARC-e) 정확도가 80.77에서 28.49로, 문장 이어 쓰기 상식 문제(HellaSwag)가 80.61에서 27.35로, 4,096토큰 긴 글에서 정보를 찾는 RULER 점수가 82.57에서 0.00으로 떨어졌습니다. sink는 Llama 3.1 계열에서 모델이 클수록 셌습니다. 이들의 지표로 8B 45.97, 70B 73.49, 405B 78.29였습니다. 저자들은 이를 더 크고 깊은 모델일수록 쉬어 갈 헤드가 더 많이 필요하다는 뜻으로 해석합니다.
저희 실험과 맞닿는 실험. 저자들은 작은 모델도 직접 학습시켰습니다. 늘 ⟨bos⟩를 앞에 두고 학습한 모델은 그것에 의존했고, ⟨bos⟩를 빼면 sink가 사라졌습니다. ⟨bos⟩ 없이 학습한 모델은 "어쨌든 첫 토큰에 sink가 생기지만 조금 약했다"고 합니다. Qwen3-8B는 시작 토큰을 붙이지 않고, sink는 무엇이든 맨 앞에 온 단어에 자리 잡았습니다. 같은 행동입니다.
4단계: sink가 사라지면 무엇이 깨지나
sink가 널리 알려진 것은 실용적인 문제 때문입니다. 메모리가 한정된 상태로 긴 대화를 이어 가려면 흔히 KV 캐시(앞 단어들의 key와 value를 저장해 둔 것)에 최근 토큰만 남기고, 새 토큰이 들어올 때마다 가장 오래된 토큰을 버립니다. 그러다 보면 언젠가 첫 토큰이 버려지고, sink도 함께 사라집니다.
Xiao 외는 PG19 글 40만 토큰에서 이때 무슨 일이 생기는지 쟀습니다. 마지막 4,096토큰만 남기는 창에서 Llama-2-7B의 perplexity는 3,359.95였습니다. 출력을 쓸 수 없게 됐다는 뜻입니다. 첫 토큰 4개와 마지막 4,092토큰을 남기자 9.59로 내려왔습니다. 첫 토큰을 1개만 남기면 11.88, 2개면 10.51이었고, 저자들은 "첫 토큰 네 개면 대체로 충분하다"고 결론지었습니다. MPT-7B도 2,048토큰 캐시에서 같은 방법으로 460.29에서 14.99가 됐고, Falcon-7B와 Pythia-12B도 좋아졌습니다.
이들의 해법 StreamingLLM이 바로 이것입니다. sink 토큰 몇 개는 끝까지 남기고 나머지에만 창을 밀어 갑니다. 400만 토큰 넘게 안정적으로 생성했고, 창을 매번 처음부터 다시 계산하는 방식보다 최대 22.2배 빨랐다고 보고합니다. 학습 샘플마다 맨 앞에 학습 가능한 토큰 하나를 더 붙여 sink 전용 자리를 만든 모델도 학습했는데, 이 모델은 그 토큰 하나만 남겨도 문제없이 스트리밍했습니다.
5단계: 설계로 줄이기
attention에 "여기엔 볼 게 없다"고 말할 방법이 없어서 sink가 생긴다면, 해법은 그 방법을 주는 것입니다.
논문: Qiu 외, "Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free" (Alibaba Group Qwen 팀과 대학 공저자; arXiv 2505.06708).
바꾼 것. attention 출력 뒤에 작은 sigmoid 게이트를 붙여, 헤드마다 자기 출력을 0 가까이까지 줄일 수 있게 했습니다. 보탤 것이 없는 헤드는 이제 attention을 어딘가에 맡겨 둘 필요 없이 게이트를 닫으면 됩니다. 30가지가 넘는 변형을 비교했고, 15B mixture-of-experts 모델(단어마다 일부 부품만 쓰는 구조)과 1.7B dense 모델(모든 부품을 쓰는 보통 구조)을 최대 3.5조 토큰으로 학습했습니다.
결과. attention 출력의 숫자 하나하나에 따로 게이트를 걸자(그러니 헤드마다 게이트가 다릅니다), 논문이 분석한 모델에서 첫 토큰이 받는 attention이 층 평균 46.7%에서 4.8%로 떨어졌습니다. 헤드마다 게이트 값을 하나만 두면 7.3%였습니다. 같은 자리라도 모든 헤드가 게이트 하나를 나눠 쓰면 30.1%, 게이트를 value 쪽에 달면 29.7%로, 줄기는 해도 훨씬 덜 줄었습니다. 한 층에서는 83%에서 4%로 떨어졌습니다. 가장 큰 activation도 평균 1,053에서 94로 줄었습니다. 2단계 설명을 너무 단순하게 받아들이면 안 된다는 결과도 하나 있습니다. "massive activation이 attention sink의 전제 조건은 아니다". 어떤 게이트 변형은 activation은 크게 줄였지만 sink는 훨씬 덜 줄였습니다.
저희가 잰 Qwen3-8B는 attention 뒤에 이런 게이트가 없는 구조이고, sink가 있었습니다.
다른 모델에서도 보일까
저희가 직접 잰 모델은 Qwen3-8B 하나입니다. 다만 위 논문들이 잰 모델 가운데 출력 게이트가 없는 계열에서는 예외 없이 sink가 나왔습니다. GPT-2, OPT, Pythia(1,400만 파라미터까지), Llama 2, Llama 3과 3.1, Mistral, MPT, Falcon, Phi-2, Gemma입니다. 모두 왼쪽에서 오른쪽으로 읽고, 표준 softmax attention을 쓰고, attention 뒤에 게이트가 없는 모델입니다. 이 논문들을 근거로 하면, 이런 구조의 모델에서는 비슷한 쏠림을 볼 가능성이 높습니다. Gu 외는 채팅 모델에서도 기반 모델만큼 세게 나타나고, 입력이 무작위 토큰이어도 나타난다고 보고했습니다.
같은 구조라도 달라지는 부분과 예외는 이렇습니다.
- 어디에 생기나. Gemma나 Llama처럼 늘 특수 시작 토큰을 앞에 두는 모델은 그 토큰에 sink를 둡니다. Qwen3처럼 시작 토큰이 없는 모델은 무엇이든 맨 앞에 온 것에 둡니다. Barbero 외가 직접 학습한 작은 모델에서는 시작 토큰 없이 학습한 쪽의 sink가 조금 약했습니다.
- 얼마나 세고, 어느 층인가. Qwen3-8B는 앞쪽 7개 층에 거의 없었습니다. 다른 모델은 다른 모양일 것입니다.
- 최근 몇천 토큰만 보는 층(sliding window). Gu 외에 따르면 진짜 첫 토큰이 창 밖으로 밀려나면, 창 안에 남은 가장 앞 토큰이 새 sink가 되지는 않았습니다. Mistral-7B에서도 같았고, 창이 작으면 sink가 아예 생기지 않았습니다.
- sink 자리를 따로 둔 모델. key 쪽에 학습 가능한 bias를 두거나 학습 가능한 sink 토큰을 앞에 붙인 모델은 sink가 첫 단어가 아니라 그 자리로 옮겨 갑니다(Gu 외).
- 게이트가 있는 모델. 5단계처럼 헤드마다 attention 출력 뒤에 게이트(원소마다 또는 헤드마다)가 있는 모델은 훨씬 약할 것입니다.
- 같은 토큰만 반복한 입력. Gu 외는 이런 입력에서 Mistral과 Llama 모델의 sink가 사라진다고 보고했습니다.
노트북은 모델 이름을 설정값으로 받습니다. 다만 Qwen3처럼 시작 토큰을 붙이지 않는 토크나이저에 맞춰 짰으므로, Llama나 Gemma처럼 시작 토큰을 붙이는 모델은 2번 측정이 멈춥니다. 1번 측정은 그대로 돌아갑니다.
논문에 없는 것 하나를 해 봤습니다
질문 3에서는 다른 것은 모두 그대로 두고 첫 토큰만 뒤 단어 모두에게 가렸습니다. 같은 20토막에서 512-1023번 자리의 다음 단어를 맞히는 손실(낮을수록 잘 맞힘)을 평균했습니다.
| 가린 것 | 평균 손실 |
|---|---|
| 없음 | 2.1372 |
| 0번 토큰 | 2.1370 |
| 256번 토큰 (비교용) | 2.1339 |
| 0-3번 토큰 | 2.1358 |
| 256-259번 토큰 (비교용) | 2.1351 |
다섯 값은 가장 크게 벌어져도 0.0033 차이입니다. 저희는 첫 토큰을 가리면 0.5 이상 오를 것이라고 예측했으니 이 예측은 틀렸습니다. 앞 네 토큰을 가리면 하나만 가렸을 때보다 같거나 높을 것이라는 예측도 틀렸습니다(2.1358은 2.1370보다 낮습니다). 비교용 256번은 차이가 0.05 미만일 것이라고 예측했고, 맞았습니다.
글을 이어 쓰게 해 보기도 했습니다. 요청 20개를 채팅 형식으로 넣고, 가장 확률이 높은 단어만 골라 64토큰씩 쓰게 했습니다. 0번 토큰(채팅 형식의 시작 표시)을 가리자 20개 중 15개가 원래 답과 어딘가에서 갈라졌습니다. 그런데 비교용으로 2번 토큰(줄바꿈)을 가려도 14개가 갈라졌습니다. 두 경우 모두 갈라진 답은 답이 끝나는 표시 앞까지 읽어 보면 멀쩡한 문장이었고, 표현만 달라졌습니다. 반복되는 구절의 비율도 쟀는데, 차이는 대부분 답이 끝난 표시 뒤에 이어 쓴 부분에서 나왔습니다. 결과를 본 뒤에 따로 해 본 계산으로 답 부분만 세면, 아무것도 가리지 않았을 때 0.0049, 0번을 가린 쪽과 2번을 가린 쪽은 둘 다 0.0082였습니다. 그래서 첫 토큰을 가리면 글이 흔들린다고 말할 수 없고, 아무 토큰 하나를 가려도 생기는 정도의 흔들림으로 봅니다.
이 결과가 3단계나 4단계와 어긋나는 것은 아닙니다. 4단계의 창은 앞쪽 토큰 수천 개를 한꺼번에 버립니다. 저희는 하나, 또는 넷을 가렸습니다. 3단계는 Gemma가 학습 내내 늘 본 특수 토큰 ⟨bos⟩를 입력에서 뺀 실험이고, 저희는 토큰을 그대로 두고 가리기만 했습니다. 손실 실험에서는 Qwen3-8B에 시작 토큰이 없으니 저희가 가린 0번 자리가 평범한 단어 조각이었습니다. 이어 쓰기 실험의 0번 토큰은 채팅 형식의 시작 표시라 3단계의 ⟨bos⟩에 더 가깝습니다. 이 토큰이 attention을 얼마나 받았는지는 재지 않았고, 가렸을 때 답이 흔들린 정도는 줄바꿈을 가렸을 때와 비슷했습니다. 0번 자리가 가려진 뒤 attention이 어디로 갔는지는 재지 않았으니, 왜 아무것도 바뀌지 않았는지는 모릅니다.
예측 여덟 개, 맞고 틀린 결과
| 예측 | 결과 | 판정 |
|---|---|---|
| 36개 층 중 30개 층 이상에서 첫 토큰 몫 20% 이상 | 29개 층 | 틀림 |
| 첫 토큰을 바꿔도 몫이 원래의 0.5-2배 안 | 0.4392-0.4624 (원래 0.4588) | 맞음 |
| 0번을 가리면 손실 0.5 이상 증가 | 2.1372에서 2.1370 | 틀림 |
| 256번을 가리면 차이 0.05 미만 | 2.1339 | 맞음 |
| 0-3번 가림이 0번 가림보다 손실이 같거나 높음 | 2.1358 대 2.1370 | 틀림 |
| 0번을 가리면 이어 쓴 글 20개 중 15개 이상이 갈라짐 | 15개 | 맞음(딱 경계) |
| 0번을 가리면 반복 구절 비율 증가 | 0.0467에서 0.0672 | 숫자로는 맞음, 차이는 답이 끝난 뒤 부분에서 나옴 |
| 2번을 가리면 0번보다 덜 갈라짐 | 14개 대 15개 | 맞음, 차이 1개 |
직접 돌려 보기
노트북은 이 글 맨 아래 "이 글의 자료" 상자의 zip 파일에 들어 있습니다. 측정에 쓴 스크립트, 실행 전에 적어 둔 예측, 이 글의 숫자 전체(results.json)도 같이 넣었습니다.
노트북은 위 설정 그대로 세 가지 측정을 돌리고, 여러분의 숫자 옆에 저희 숫자를 함께 출력합니다. 이어 쓰기 실험은 넣지 않았습니다. bf16 Qwen3-8B는 가중치만 약 16.4GB이고, 그 위에 attention 가중치를 담을 메모리가 조금 더 필요합니다. 저희는 A100 80GB 한 장에서 돌렸습니다. 더 작은 카드라면 모델 이름을 Qwen3-0.6B나 Qwen3-1.7B로 바꿀 수 있지만, 이 두 모델은 저희가 돌려 보지 않았습니다.
한계
- 저희 숫자는 모델 하나(Qwen3-8B, bf16, transformers 4.56.2)와 글 출처 하나(WikiText-2 20토막)에서 나왔고, attention 비율은 256-511번 자리에서 측정한 값입니다.
- 비율은 헤드 32개의 평균입니다. 헤드 하나하나는 평균보다 훨씬 들쭉날쭉합니다.
- 논문 숫자는 모두 논문이 밝힌 모델과 데이터에 대한 논문 자체의 값이고, 저희가 다시 돌리지 않았습니다.
- attention 비율은 처음부터 기본 방식(eager)으로 쟀습니다. 질문 3과 이어 쓰기 실험에는 더 빠른 계산 방식을 쓰려고 했는데, 앞에서 말한 마스크 확인에서 가장 큰 차이가 0.0이 아니라 9.05가 나와 통과하지 못했습니다. 그래서 그 결과들을 보기 전에 기본 방식으로 바꾼다고 먼저 기록하고, 전부 다시 돌렸습니다. 첫 단어가 받은 비율은 두 번 모두 똑같았습니다.
이 연재의 다음 편에서는 모델의 다른 부분을 열고, 저희 예측을 안에 든 것과 맞춰 봅니다. 메일로 받아 보시려면 아래 뉴스레터를 구독해 주세요.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
attention-sink-repro.zip · 49 KB