역전파 없이 학습하는 Dust, 비교 조건을 바꾸면 어떻게 될까: 1M 토큰에서 다시 재 봤습니다
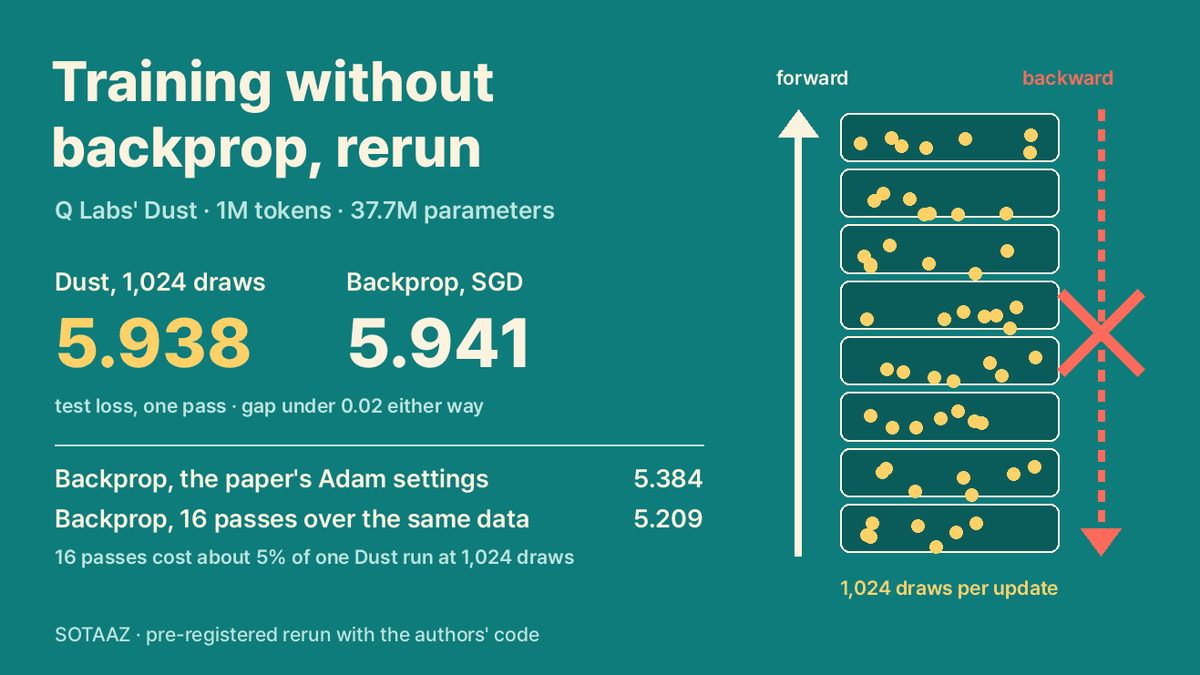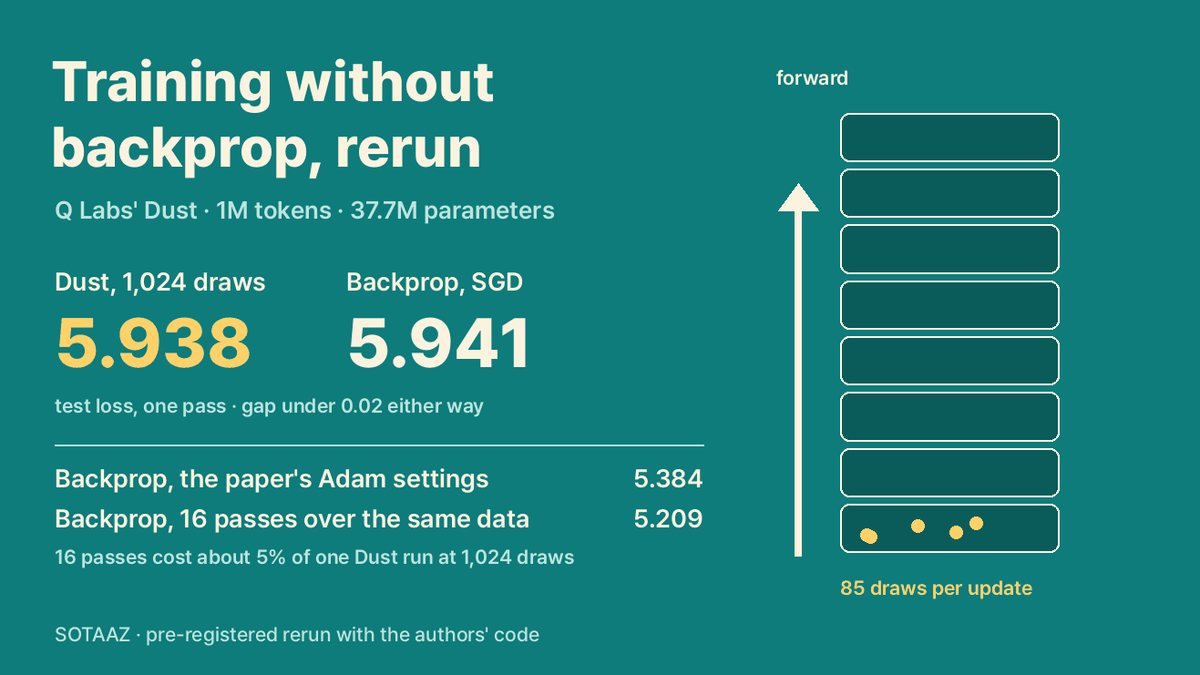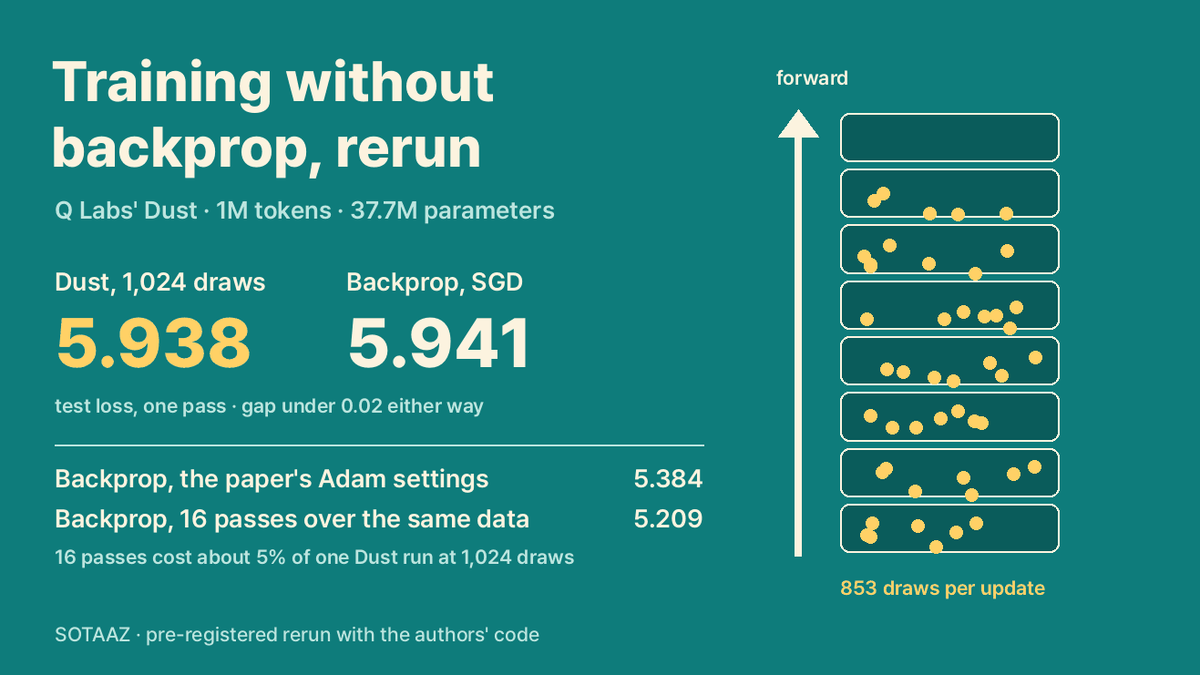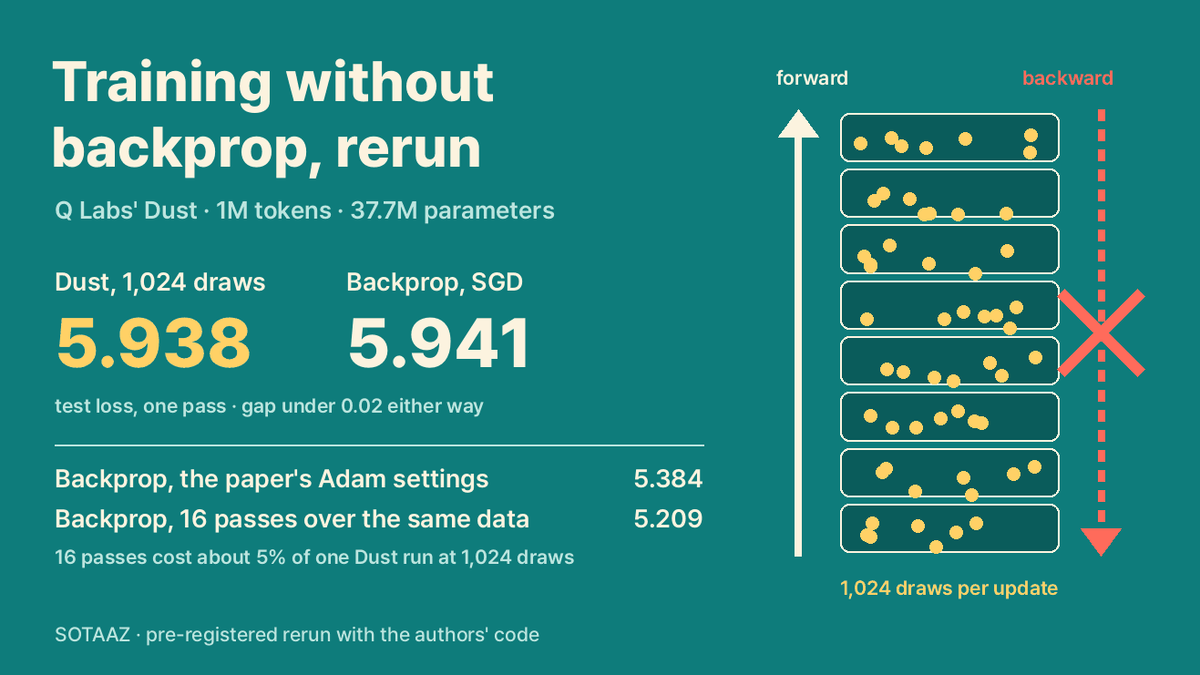
Q Labs가 공개한 역전파 없는 학습 방법 Dust를 저자가 공개한 코드로 다시 돌렸습니다. 논문과 같은 조건(데이터 1M 토큰, 한 번만 보기, SGD)에서 숫자는 논문과 거의 같았고, 역전파를 시드 20개로 늘려 보니 두 방법의 차이는 0.02 안쪽이었습니다. 논문이 보고한 0.025 차이는 나오지 않았습니다. 역전파에 논문이 쓴 Adam 설정을 주거나 같은 데이터를 16번 보게 하면 역전파 쪽 loss가 훨씬 낮았고, 16번 볼 때 든 계산량은 Dust의 약 5%였습니다.
역전파 없이 학습하는 Dust, 비교 조건을 바꾸면 어떻게 될까: 1M 토큰에서 다시 재 봤습니다
지금 쓰이는 신경망은 거의 모두 역전파로 학습합니다. 모델이 틀린 정도를 출력 쪽에서 입력 쪽으로 거꾸로 전달하면서, 가중치 하나하나를 얼마나 고칠지 계산하는 방법입니다. Q Labs가 10월에 공개한 논문 「Dust: Pretraining Transformers Without Backpropagation」(Dahal, Mandal, Gülbahar, Vegesna)은 이 과정 없이 트랜스포머 언어 모델을 학습하는 방법을 내놓았습니다.
Dust는 모델 안의 값(활성값)을 토큰마다 조금씩 흔들어 보고, 그때 loss가 오르는지 내리는지를 보고 가중치를 고칩니다. loss는 모델이 다음 토큰을 얼마나 잘못 맞히는지 나타내는 값이고, 낮을수록 좋습니다. 한 번 고칠 때 이렇게 흔들어 보는 횟수를 draw라고 부릅니다. draw가 많을수록 고칠 방향이 정확해지지만 계산이 늘어납니다.
논문의 핵심 결과는 이렇습니다. 학습 데이터가 100만 토큰(1M)일 때 draw를 천 개 이상 쓰면, 학습을 마친 Dust 모델의 테스트 loss가 역전파로 학습한 모델보다 낮게 나왔다는 것입니다. 대신 계산이 많이 듭니다. 저희가 재 보니 draw 1,024개짜리 Dust는 한 번 고칠 때마다 역전파의 약 350배를 계산합니다. 저자들도 지금 역전파를 대체할 만큼 효율을 높이려는 것은 아니라고 분명히 밝혔습니다. 이 논문이 보여 주려는 것은 효율이 아니라, 역전파 없이도 그만큼 좋은 방향을 찾을 수 있다는 점입니다.
왜 다시 쟀나
논문의 비교는 두 가지를 고정했습니다. 학습 데이터를 한 번만 보고(1 epoch), Dust와 역전파 모두 같은 최적화 방법(SGD)으로 가중치를 고칩니다. 두 방법이 찾은 방향의 질만 공정하게 비교하려는 선택입니다.
그런데 실제로 모델을 학습할 때는 사정이 다릅니다. 역전파에는 보통 SGD보다 Adam 계열을 쓰고, 데이터가 모자라면 같은 데이터를 여러 번 봅니다. 그래서 저희는 세 가지를 확인하기로 했습니다.
- 같은 조건: 저자가 공개한 코드로 논문과 같은 조건에서 돌리면, draw 1,024개의 Dust가 역전파보다 낮은 loss를 내는가?
- 역전파에 Adam을 주면: 데이터를 한 번만 보는 조건은 그대로 두고, 역전파를 Adam으로 학습하면 어느 쪽 loss가 낮은가?
- 같은 데이터를 여러 번 보면: 역전파가 같은 1M 토큰을 여러 번 보되 Dust보다 적은 계산만 쓰게 하면, 어느 쪽 loss가 낮은가?
2번과 3번은 논문이 다루지 않은 질문입니다. 여기서 역전파가 앞서도 논문이 틀렸다는 뜻은 아닙니다. 판정 기준과 결과별로 쓸 문장은 학습을 돌리기 전에 정해 두었습니다.
어떻게 쟀나
- 코드와 데이터: 저자가 공개한 저장소(qlabs-eng/dust, MIT 라이선스)를 고치지 않고 썼습니다. 저자들은 이 코드가 실제 실험에 쓴 속도 최적화를 뺀 최소 구현이라고 적었습니다. 데이터도 저장소 스크립트로 만든 FineWeb 1M 토큰을 썼습니다.
- 모델: 8층, 폭 512, 파라미터 3,770만 개의 작은 트랜스포머입니다. 한 번에 16k 토큰씩 보면 데이터 1M 토큰을 한 번 다 보는 동안 가중치를 61번 고칩니다.
- 비교 값: 논문과 같이, 검증 데이터에서 가장 좋았던 시점의 모델로 잰 테스트 loss입니다.
- 판정 기준: 같은 조건이라도 시드(학습을 시작할 때 정하는 무작위 값)만 바꾸면 결과가 조금씩 달라집니다. 그래서 조건마다 시드를 3개씩 돌리고(SGD 역전파는 나중에 20개로 늘렸습니다, 1절 참고), 두 조건의 차이가 시드만 바꿔서 생길 수 있는 폭(표준오차의 두 배)보다 클 때만 차이가 있다고 봤습니다.
- 계산량: PyTorch로 한 번 고칠 때의 계산량(FLOPs)을 쟀습니다. Dust는 draw 256개에서 역전파의 91배, 1,024개에서 347배입니다.
- 장비: A100 80GB 한 장을 다른 학습 작업과 같이 썼습니다. 그래서 걸린 시간은 싣지 않습니다.
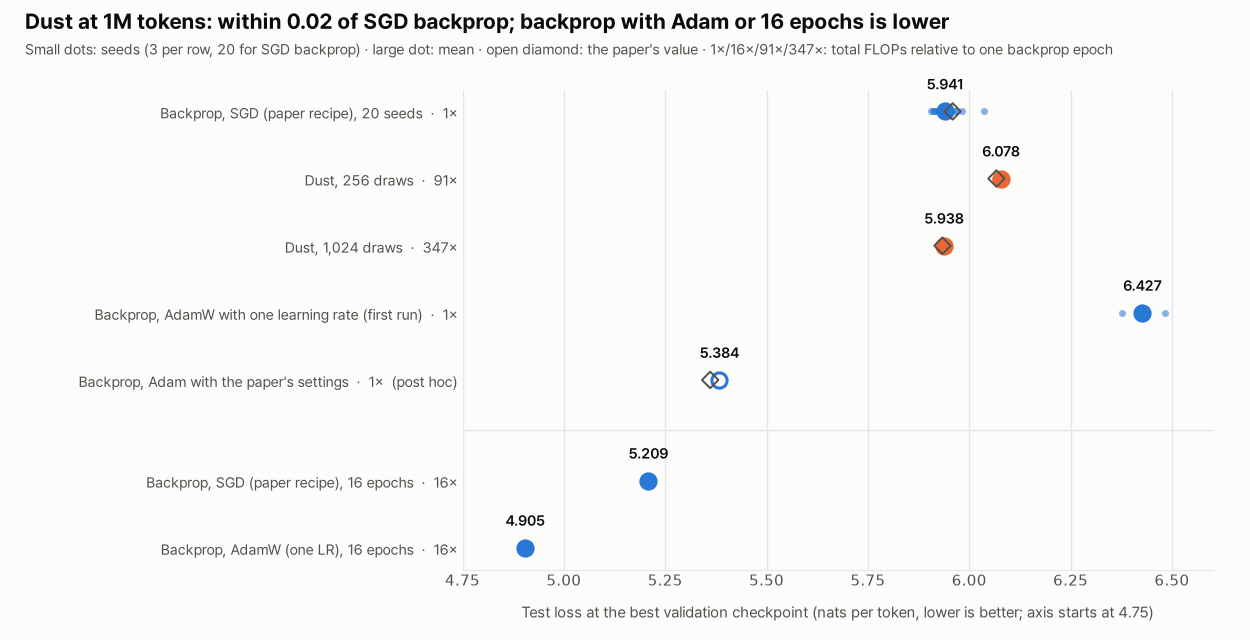
1. 같은 조건: 논문 숫자는 그대로 나왔고, 차이는 0.02 안쪽이었습니다
| 1M 토큰, 데이터 한 번 | 논문 | 저희 | 역전파 대비 계산량 |
|---|---|---|---|
| 역전파(SGD) | 5.959 | 5.941(시드 20개) | 1배 |
| Dust, draw 256개 | 6.067 | 6.078(시드 3개) | 91배 |
| Dust, draw 1,024개 | 5.934 | 5.938(시드 3개) | 347배 |
논문 값은 논문 그림 2에 쓰인 데이터에서 그대로 읽었습니다. 세 값 모두 저희 결과와 0.02 넘게 차이 나지 않습니다. 공개된 최소 구현 코드로도 논문 숫자가 거의 그대로 나온 셈입니다.
어느 쪽이 낮은지는 처음에 가리지 못했습니다. 시드 3개씩 돌렸을 때 draw 1,024개의 Dust는 역전파보다 0.004 낮았는데, 시드만 바꿔도 0.026까지 차이가 날 수 있는 상태였습니다. 들여다보니 시드에 따른 차이는 거의 역전파 쪽에서 나왔습니다. 역전파는 시드마다 결과가 크게 달랐고, Dust는 거의 같았습니다. 그래서 한 번에 3분 남짓 걸리는 역전파만 시드를 20개로 늘렸습니다. Dust는 한 번에 80분이 넘게 걸리고 시드에 따른 차이도 작아서 3개 그대로 두었습니다. 늘리기 전에 판정 기준을 미리 정해 두었습니다.
시드 20개로 보니 역전파 결과는 시드에 따라 5.905에서 6.035까지 달라졌고, 평균은 5.941이었습니다. Dust와의 차이는 0.003으로, 실제 차이가 있을 수 있는 범위는 Dust가 0.018 낮은 쪽부터 0.011 높은 쪽까지입니다. 1M 토큰에서 두 방법의 차이는 있더라도 0.02 안쪽이라는 뜻입니다.
논문이 보고한 차이(Dust가 0.025 낮음)는 이 범위 밖입니다. 저희 실행에서는 그만큼의 차이가 나오지 않았습니다. Dust 값은 논문과 거의 같았고(5.938 대 5.934), 다른 것은 역전파 쪽입니다. 역전파 결과가 시드에 따라 이만큼 달라지니, 시드 3개 평균끼리 비교하면 0.02 정도 차이는 쉽게 생길 수 있습니다.
draw 256개에서는 Dust가 역전파보다 0.136 높았습니다. 시드만 바꿔서 생길 수 있는 차이보다 훨씬 커서, 실제로 Dust 쪽이 높았다고 볼 수 있습니다. draw가 천 개는 넘어야 한다는 논문 설명과 같은 방향입니다.
2. 역전파에 Adam을 주면: 처음엔 결과가 이상했습니다
처음에는 역전파를 AdamW로 학습했습니다. 모든 가중치에 학습률 하나를 주고, weight decay와 학습률 스케줄을 붙인 흔한 설정입니다. 학습률은 검증 데이터로 골랐습니다(0.01).
결과는 6.427이었습니다. SGD 역전파(5.942)보다도, Dust보다도 나빴습니다. 보통 Adam은 SGD보다 학습이 잘 되는 편이라, 이 결과는 Adam이 나빠서라기보다 설정 어딘가가 맞지 않는다는 신호로 봤습니다.
의심한 곳은 임베딩 층입니다. 임베딩은 단어(토큰)를 숫자 벡터로 바꾸는 층인데, 이번 학습은 데이터를 한 번 보는 동안 가중치를 61번밖에 고치지 않습니다. 이렇게 짧은 학습에서 다른 가중치와 같은 작은 학습률을 주면, 임베딩이 거의 움직이지 못한 채 학습이 끝날 수 있습니다. 논문 설정을 다시 보니 실제로 그렇게 다루고 있었습니다. SGD 역전파도 임베딩에는 학습률을 따로 크게 주고, 부록 Table 7의 Adam 역전파 설정도 학습률을 세 묶음으로 나눕니다. 가중치 행렬과 출력 층은 0.002, 토큰·값 임베딩은 0.3, 잔차 연결의 스칼라 값은 0.2이고, β₁은 0.8, weight decay는 쓰지 않습니다.
그래서 논문에 적힌 이 설정을 그대로 가져와 다시 돌렸습니다. 학습률 스케줄은 논문에 없어서 SGD 쪽처럼 고정했습니다. 결과는 시드 3개 평균 5.384로, 논문이 보고한 5.361과 거의 같았습니다. 설정을 바로잡자 Adam이 제 성능을 냈습니다. 다만 학습률 묶음, β₁, weight decay, 스케줄을 한꺼번에 바꿨기 때문에, 이 차이가 전부 임베딩 학습률 때문이라고 단정할 수는 없습니다. 임베딩이 실제로 얼마나 움직였는지도 따로 재지 않았습니다. 가장 유력한 원인이라는 정도입니다.
직접 학습할 때도 확인해 볼 만한 부분입니다. 학습 스텝이 짧거나 데이터가 적을 때는 모든 가중치에 학습률 하나를 주는 흔한 설정이 임베딩을 제대로 학습시키지 못할 수 있습니다. 결과가 예상보다 나쁘면 최적화기를 바꾸기 전에 층별 학습률부터 보는 편이 좋습니다.
이렇게 바로잡은 역전파는 draw 1,024개의 Dust(5.938)보다 0.554 낮았습니다. 시드만 바꿔서 생길 수 있는 차이(0.015)보다 훨씬 큽니다. 다만 Dust는 SGD로, 역전파는 Adam으로 학습한 비교라는 점을 같이 봐야 합니다. 둘 다 Adam으로 학습한 비교는 논문에 있습니다. 1M 토큰에서 draw 1,024개의 Dust는 5.594, 역전파는 5.361입니다. 논문에서 Dust가 역전파보다 낮아지는 값(5.248)은 draw를 끝없이 늘린다고 가정해 늘려 잡은 추정이고, 실제로 잰 값은 아닙니다. 저희는 Adam으로 Dust를 돌리지는 않았습니다.
3. 같은 데이터를 여러 번 보면: 역전파가 훨씬 적은 계산으로 앞섰습니다
데이터는 1M 토큰밖에 없는데 계산은 더 쓸 수 있다면, 역전파는 같은 데이터를 여러 번 보면 됩니다. 4번, 16번, 32번을 시험해 보고 횟수는 검증 데이터로 골랐습니다. 테스트 데이터는 고르는 데 쓰지 않았습니다. SGD와 AdamW 모두 16번이 가장 좋았습니다.
논문의 SGD 설정으로 16번 본 역전파는 5.209로, draw 1,024개의 Dust보다 0.729 낮았습니다. 시드만 바꿔서 생길 수 있는 차이(0.009)보다 훨씬 큽니다. 이때 든 계산량은 데이터를 한 번 보는 역전파의 16배인데, Dust 한 번 학습의 약 4.6%에 불과합니다.
처음 쓴 학습률 하나짜리 AdamW도 16번 보면 4.905까지 내려갔습니다. 16번 보면 가중치를 976번 고치니, 같은 학습률로도 훨씬 많이 학습되는 셈입니다. 다만 2절에서 본 그 설정이라, Adam으로 최소한 여기까지는 내려간다는 정도로만 읽어 주세요.
정리하면
- 논문 숫자는 논문 조건에서 다시 나왔습니다. 공개된 최소 구현 코드로 돌려도 draw 1,024개의 Dust가 논문 값과 0.004 차이로 맞았습니다. 역전파 없이 이만큼 학습한다는 것 자체는 눈여겨볼 결과입니다.
- 1M 토큰에서 Dust와 역전파의 차이는 0.02 안쪽이었습니다. 역전파를 시드 20개로 늘려 보니 Dust가 많아야 0.018 낮거나 0.011 높은 범위였고, 논문이 보고한 0.025 차이는 나오지 않았습니다.
- 비교 조건을 실제 학습에 가깝게 바꾸면 역전파가 앞섰습니다. 역전파에 논문의 Adam 설정을 주거나, 같은 데이터를 여러 번 보게 하면 loss가 훨씬 낮았고, 여러 번 볼 때의 계산량은 Dust의 몇 퍼센트였습니다. 논문이 비교하려던 조건은 아니고, 저자들도 Dust가 지금 역전파를 대신하려는 방법은 아니라고 밝혔습니다.
- 새로운 계열의 방법은 아닙니다. 논문은 Dust를 노드 섭동(node perturbation) 방법이라고 소개하고, 이 계열의 앞선 연구로 Widrow와 Lehr(1990), Werfel 등(2003)을 인용합니다. 논문의 주장은 이 오래된 방법을 트랜스포머 사전학습에서 통하게 만들었다는 데 있습니다.
다루지 못한 것
- 1M 토큰만 쟀습니다. 논문의 더 흥미로운 결과는 10M, 20M 토큰에서 draw를 늘릴수록 역전파와의 차이가 줄어든다는 부분인데, 그쪽은 돌리지 않았습니다.
- 공개 코드는 최소 구현입니다. 저자들의 실험은 최적화된 코드로 돌렸고, draw가 많을 때는 그 차이가 결과에 영향을 줄 수 있습니다.
- SGD 역전파는 시드 20개, 나머지 조건은 시드 3개입니다. 시드 3개인 비교에서는 0.03보다 작은 차이를 가릴 수 없습니다.
- 논문 설정의 Adam 실행은 처음 결과를 본 뒤에 더한 것입니다. 값은 저희가 결과를 보며 맞춘 것이 아니라 논문에서 그대로 가져왔습니다.
- Dust를 Adam으로 돌리지 않아서, 둘 다 Adam인 비교는 논문 숫자뿐입니다.
계획서, 스크립트, 실행별 기록과 결과는 재현 패키지로 정리해 이 글 아래에 붙입니다. 다음 재측정 글은 뉴스레터로 먼저 알려 드립니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
dust-backprop-free-rerun-repro.zip · 1,221 KB