GPT-2의 LayerNorm을 파라미터 없는 RMSNorm으로 바꾸니 loss가 0.038 올랐고, QK norm은 0.012를 되찾았습니다
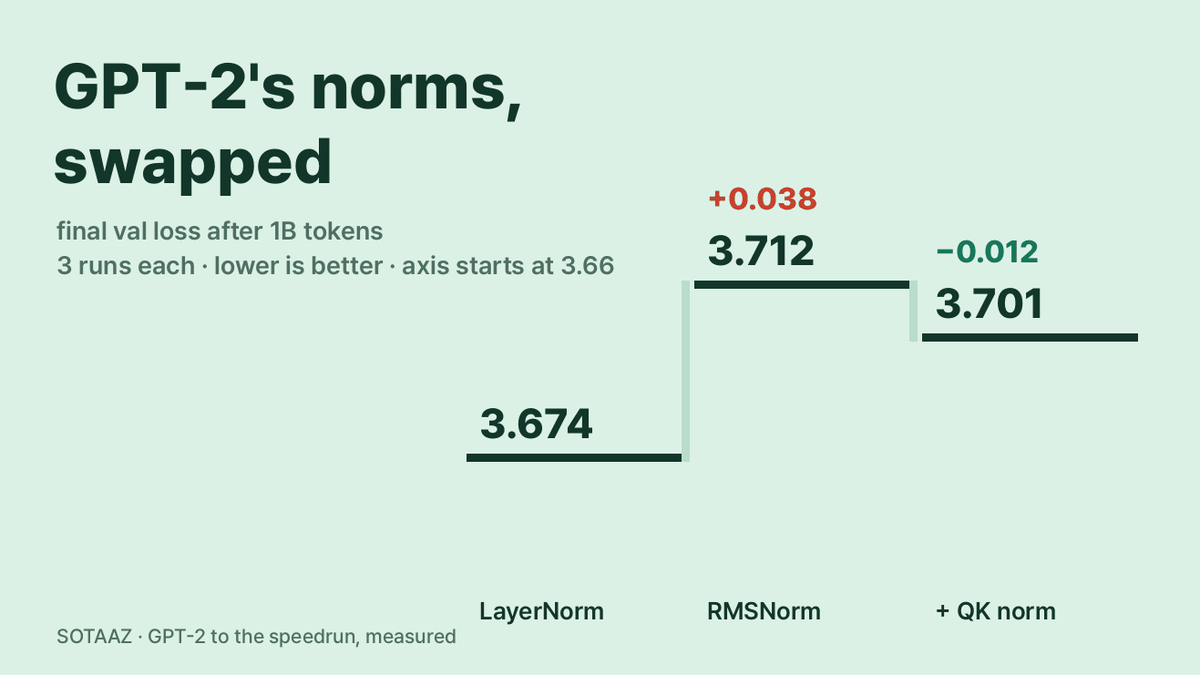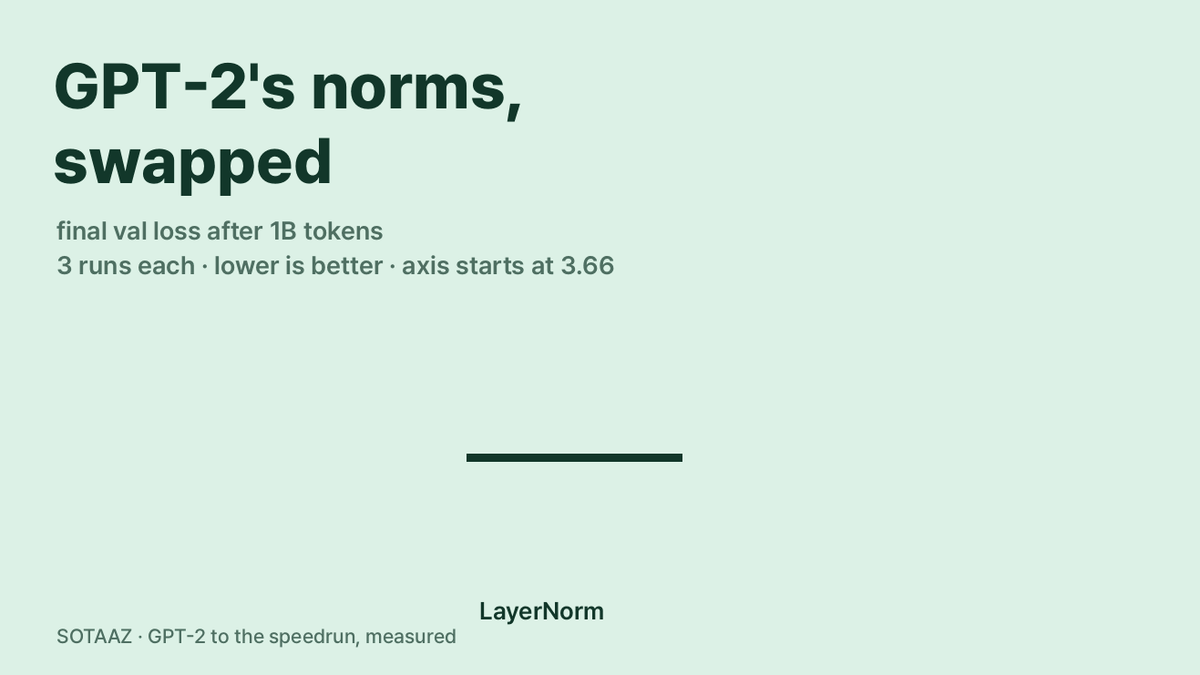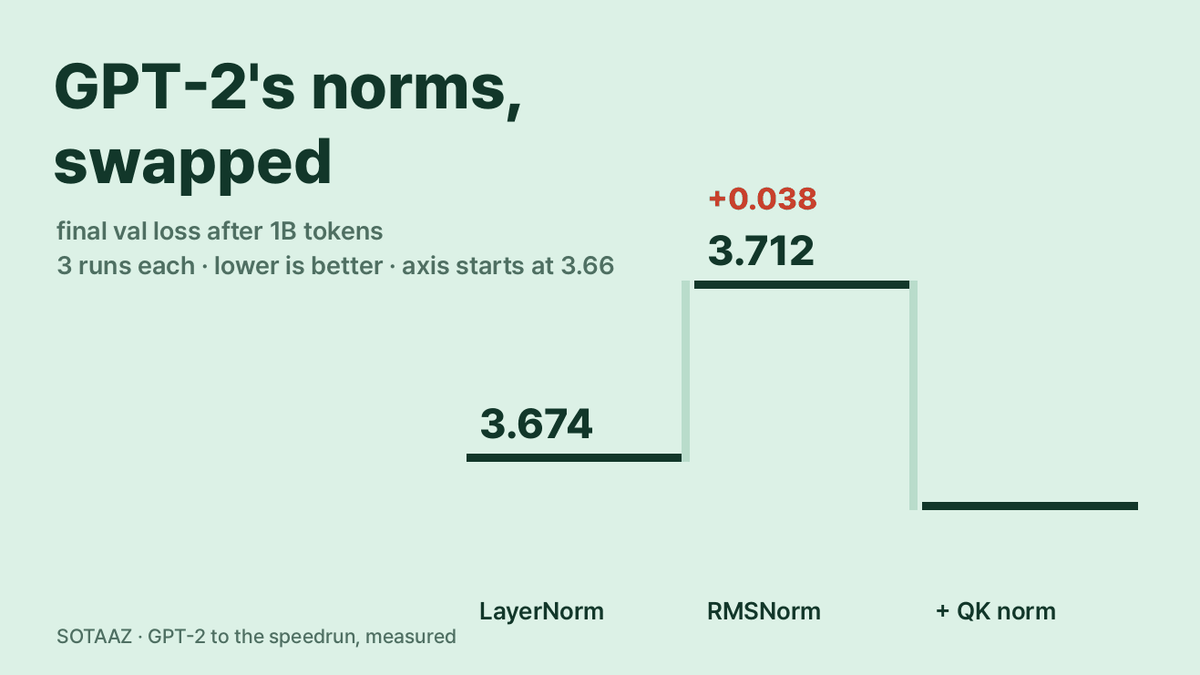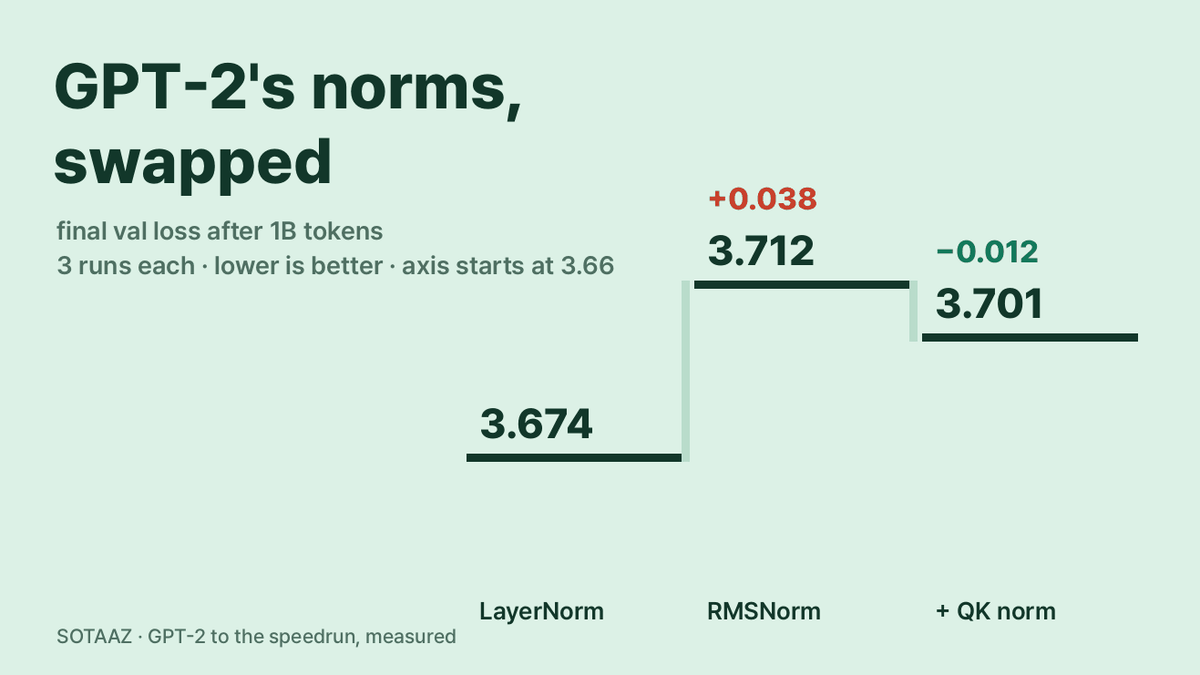
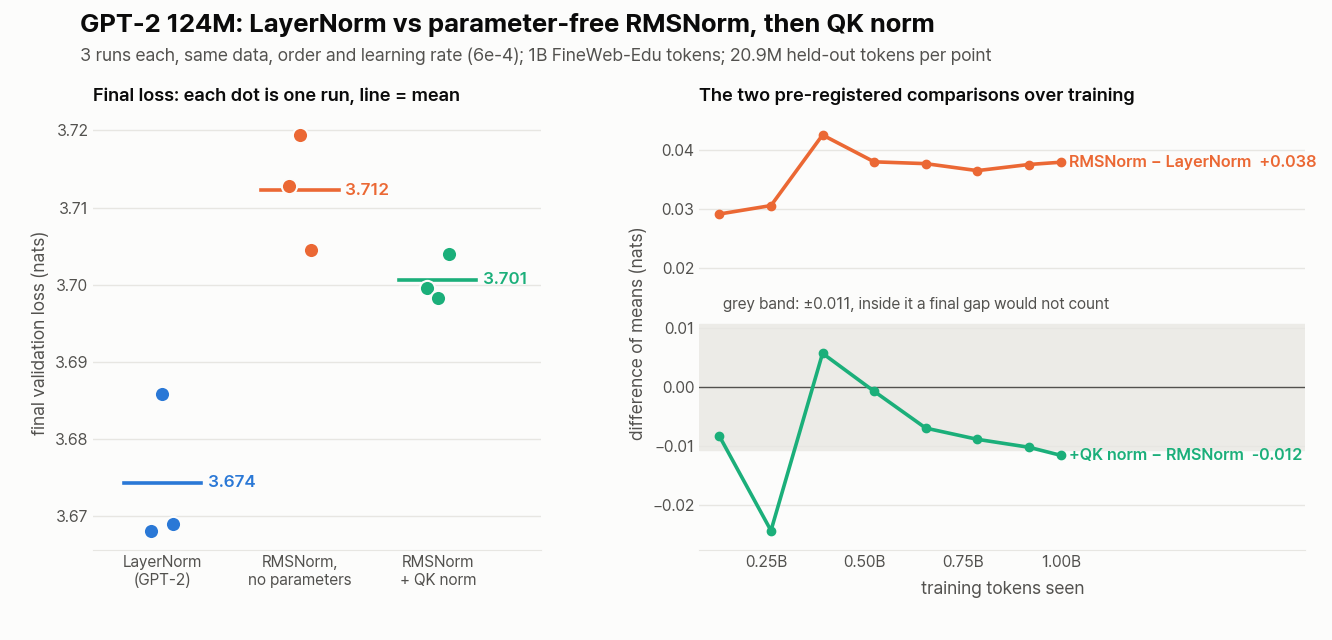
GPT-2(124M)의 LayerNorm을 모두 파라미터 없는 RMSNorm으로 바꾸자 FineWeb-Edu 10억 토큰 뒤 평균 검증 loss가 3.674에서 3.712로 올랐습니다(조건마다 3회, GPT-2 학습률). 그 위에 QK norm을 더하면 3.701로, 0.012 낮아졌습니다. 미리 정한 기준(0.011)을 0.001 차이로 넘은 근소한 결과입니다. 처리량 변화는 +1.4%와 −0.4%로 작았고, 잡아야 할 학습 불안정성도 없었습니다.
GPT-2의 LayerNorm을 파라미터 없는 RMSNorm으로 바꾸니 loss가 0.038 올랐고, QK norm은 0.012를 되찾았습니다
GPT-2(124M)에 들어 있는 LayerNorm을 모두 학습 파라미터가 없는 RMSNorm으로 바꿨습니다. modded-nanogpt 스피드런과 nanochat이 쓰는 형태입니다. 같은 10억 토큰을 같은 순서로, 같은 학습률로 세 번 학습했더니 평균 검증 loss가 3.674에서 3.712로 올라갔습니다.
이어서 그 위에 QK norm을 더했습니다. 어텐션 헤드마다 쿼리와 키를 곱하기 전에 정규화하는 장치입니다. loss는 3.701로 0.012 내려갔습니다. 이 비교에서 차이로 인정하는 기준은 미리 정한 규칙으로 0.011이었으니 차이로 세기는 하지만, 기준을 넘은 폭은 0.001뿐입니다.
이 연재는 GPT-2에서 출발해 이후 학습 레시피들이 바꾼 것을 하나씩 재고 있고, 이번이 세 번째 글입니다. 앞 글에서는 학습되는 위치 임베딩을 RoPE로 바꿔 0.122 낮아지는 것을 확인했습니다. 이번 결과는 성격이 다릅니다. 한 변경은 혼자서는 오히려 나빠졌고, 다른 하나는 기준을 겨우 넘었습니다.
요약
- 파라미터 없는 RMSNorm은 GPT-2의 LayerNorm보다 0.038 높게 끝났습니다(3.712와 3.674, 조건마다 3회). 기준이 0.011이니 차이가 맞고, 방향은 나빠지는 쪽입니다. 2.6억 토큰부터는 모든 평가 지점에서 RMSNorm 세 실행이 모두 LayerNorm 세 실행보다 높았습니다.
- 그 위에 QK norm을 더하면 RMSNorm만 쓸 때보다 0.012 낮게 끝났습니다(3.701과 3.712). 기준을 0.001 넘었습니다. 학습 도중에는 방향이 한 번 바뀌어, 3.9억 토큰 지점에서는 QK norm 쪽이 뒤처져 있었습니다. 규칙대로 차이로 세지만, 이 결과에 기대어 판단하지는 않겠습니다.
- 둘을 함께 써도 GPT-2의 LayerNorm보다 0.026 높았습니다.
- 속도와 안정성은 거의 달라지지 않았습니다. 처리량 변화는 +1.4%(RMSNorm)와 −0.4%(QK norm 추가)였고, 세 조건의 어느 실행에도 잡아야 할 기울기 급증이 없었습니다.
바꾼 것
모델은 앞 글들과 같은 GPT-2 small입니다. 12층, 폭 768, 헤드 12개, 문맥 1,024토큰이고, 입력 임베딩과 출력층이 행렬을 같이 쓰며, 위치 임베딩은 학습되는 표입니다. 코드는 GELU를 GPT-2와 같은 tanh 근사로 바꾼 nanoGPT입니다.
| LayerNorm(GPT-2) | 파라미터 없는 RMSNorm | QK norm 추가 | |
|---|---|---|---|
| 정규화 방식 | 평균을 빼고 표준편차로 나눈 뒤, 채널마다 학습되는 배율과 편향을 적용 | 제곱평균제곱근으로 나누기만 함. 평균 빼기, 배율, 편향 없음 | 같음 |
| 위치 | 25곳: 12개 블록마다 두 곳, 출력층 앞 한 곳 | 같은 25곳 | 같은 25곳에 더해, 모든 어텐션 층에서 쿼리와 키를 헤드마다 정규화 |
| 파라미터 수 | 124,475,904 | 124,437,504 (정규화 층의 배율·편향 38,400개가 빠짐) | 124,437,504 |
나머지는 앞 글들과 같습니다. FineWeb-Edu 샤드를 같은 순서로 읽고, 524,288토큰짜리 스텝을 1,907번(10억 토큰) 돌렸습니다. 옵티마이저는 AdamW, 최대 학습률 6e-4, 워밍업 100스텝 뒤 코사인으로 10%까지 줄였고, bfloat16으로 A100 80GB 두 장에서 학습했습니다. QK norm을 넣어도 어텐션 스케일은 1/√64 그대로이고, QK norm에 학습되는 배율은 없습니다. 실행 기록을 보면 비교하는 짝마다 다른 설정은 이름 붙인 스위치 하나뿐이고, 아홉 실행 모두 첫 배치가 같았습니다. LayerNorm 쪽은 계획대로 첫 측정 글의 시드 세 실행을 그대로 썼습니다.
실행 전에 CPU에서 세 버전이 같은 지점에서 출발하는지 확인했습니다. 같은 4,096토큰에서 시드 0의 초기 loss는 LayerNorm 10.940, RMSNorm 10.938, QK norm 추가 10.944였습니다. 아래 차이는 출발점이 달라서 생긴 것이 아닙니다.
여기서 RMSNorm은 두 가지를 한꺼번에 바꿉니다. 평균 빼기를 없애고, 학습되는 배율과 편향도 없앱니다. 이번 실행으로는 둘 중 어느 쪽이 loss를 올렸는지 가릴 수 없습니다. 학습되는 배율이 있는 RMSNorm을 돌리면 나눠 볼 수 있는데, 그것은 돌리지 않았습니다.
실행 전에 정한 판정 규칙
비교는 두 개이고, 둘 다 13시 7분에 적어 커밋했습니다. 이 글의 첫 실행은 15시 26분에 시작했습니다. 규칙을 계산하는 스크립트도 13시 55분에 커밋해서, 첫 실행보다 앞섰습니다.
- (a) RMSNorm과 LayerNorm 비교
- (b) RMSNorm에 QK norm을 더한 것과 RMSNorm만 쓴 것 비교
평균 차이가 2 × σ × √(1/3 + 1/3)보다 클 때만 차이로 셉니다. σ는 지금까지 돌린 모든 설정(LayerNorm, RoPE, RMSNorm, QK norm 추가)의 시드 간 분산을 합쳐서 구합니다. 비교를 두 번 하면 그중 하나가 우연히 기준을 넘을 가능성이 한 번일 때보다 커진다는 점도 미리 적어 두었습니다. 이 주의는 (b)에 해당합니다.
| 최종 검증 loss, 시드 0 / 1 / 2 | 평균 | 표준편차 | |
|---|---|---|---|
| LayerNorm | 3.6681, 3.6858, 3.6690 | 3.6743 | 0.0100 |
| RMSNorm | 3.7128, 3.7194, 3.7045 | 3.7122 | 0.0075 |
| RMSNorm + QK norm | 3.6996, 3.6983, 3.7040 | 3.7006 | 0.0030 |
합친 σ는 0.00653(자유도 8)이고, 기준은 2 × 0.00653 × √(2/3) = 0.0107입니다.
| 비교 | 차이 | 기준 | 판정 |
|---|---|---|---|
| (a) RMSNorm − LayerNorm | +0.0379 | 0.0107 | 차이 있음: RMSNorm이 높음 |
| (b) QK norm 추가 − RMSNorm | −0.0116 | 0.0107 | 차이 있음: QK norm 쪽이 낮음 |
| 참고: QK norm 추가 − LayerNorm | +0.0264 | 0.0107 | 차이 있음: 높음 |
학습 전체에서 본 차이
| 학습 토큰 | LayerNorm | RMSNorm | QK norm 추가 | (a) RMSNorm − LayerNorm | (b) QK norm − RMSNorm |
|---|---|---|---|---|---|
| 1.3억 | 5.5714 | 5.6006 | 5.5922 | +0.0292 | −0.0083 |
| 2.6억 | 4.7146 | 4.7452 | 4.7209 | +0.0306 | −0.0243 |
| 3.9억 | 4.1726 | 4.2152 | 4.2208 | +0.0425 | +0.0057 |
| 5.2억 | 3.9468 | 3.9848 | 3.9841 | +0.0380 | −0.0008 |
| 6.6억 | 3.8211 | 3.8588 | 3.8518 | +0.0377 | −0.0070 |
| 7.9억 | 3.7389 | 3.7754 | 3.7666 | +0.0365 | −0.0089 |
| 9.2억 | 3.6918 | 3.7294 | 3.7192 | +0.0376 | −0.0102 |
| 10억 | 3.6743 | 3.7122 | 3.7006 | +0.0379 | −0.0116 |
(각 세 실행의 평균입니다. 판정은 기준이 최종 loss에 대해 정해져 있으므로 마지막 행으로만 했습니다.)
두 비교는 전혀 다르게 움직였습니다. RMSNorm의 손해는 첫 평가 지점부터 보이고, 5.2억 토큰 이후에는 0.037에서 0.038 언저리에 자리 잡았습니다. 1.3억 토큰 지점을 빼면 두 조건의 실행이 한 번도 겹치지 않았습니다. QK norm의 효과는 일정하지 않았습니다. 2.6억 토큰에서는 도움이 됐고, 3.9억 토큰에서는 손해였고, 5.2억 토큰에서는 거의 0이었다가, 그 뒤로 끝까지 조금씩 커졌습니다. 마지막 지점에서는 QK norm 세 실행이 모두 RMSNorm 세 실행보다 낮았지만, 3.9억부터 9.2억 토큰 사이에서는 서로 겹쳤습니다.
마지막 지점까지 커지던 차이는 더 학습하면 더 커질 수도 있고 아닐 수도 있습니다. 이렇게 움직였고 기준을 넘은 폭이 0.001뿐이니, (b)는 "작은 이득일 가능성이 높지만 확인되지는 않았다"로 읽겠습니다. 조건마다 시드를 더 돌리면 범위를 좁힐 수 있는데, 계획에는 없습니다.
그렇다면 왜 이 둘을 쓸까요
두 변경 모두 학습률이 낮은 124M 모델의 loss를 낮추려고 나온 것이 아닙니다. 이 글을 "RMSNorm은 나쁘다"로 읽기 전에 짚어 둘 점입니다.
- RMSNorm은 주로 비용 때문에 씁니다. 평균과 파라미터를 건너뛰니 계산이 가볍습니다. 이 코드에서는 처리량이 1.4% 늘었는데(초당 366,346토큰과 361,190토큰), 비교 결과를 바꿀 만큼은 아닙니다.
- QK norm은 주로 안정성 때문에 씁니다. Wortsman 외(2023)는 큰 모델에서 QK 정규화로 막던 불안정성 가운데 하나인 어텐션 logit 증가(Dehghani 외, 2023)가 작은 모델에서도 학습률이 높으면 나타나고, 큰 규모에서 쓰던 완화책이 거기서도 통한다고 보고했습니다. 학습률 6e-4에서는 안정시킬 것이 없었습니다. 워밍업이 끝난 뒤 아홉 실행 전체에서 기울기 크기의 최댓값은 1.23이었고, 실행마다 평균은 0.39에서 0.45였습니다. QK norm은 처리량을 0.4% 낮췄습니다.
modded-nanogpt 스피드런을 보면, 파라미터 없는 RMSNorm은 저장소에 코드가 남아 있는 가장 이른 기록(4번, 2024년 10월)에 이미 Muon 옵티마이저와 함께 들어 있고, 이것을 변경 사항으로 내세운 기록은 없습니다. QK norm은 5번 기록에 ReLU², 0으로 초기화한 투영, 임베딩 패딩과 함께 들어갔습니다. 어느 쪽도 GPT-2 학습률에서 혼자 잰 적은 없고, 이 글이 잰 것이 그 부분입니다. 5편에서는 옵티마이저와 학습률을 바꾸고 마지막 편에서는 모두를 합칩니다. 그 조합 안에서도 RMSNorm의 손해가 남는지는 따로 확인할 문제입니다.
한계
- 학습률은 하나만 썼습니다. 모든 실행이 6e-4입니다. QK norm은 주로 높은 학습률에서 학습을 안정시키려고 쓰는데, 이번에는 그것을 시험하지 않았습니다.
- RMSNorm의 어느 쪽이 손해인지 모릅니다. 평균 빼기를 없앤 것과 배율을 없앤 것을 함께 바꿨습니다.
- 예산 하나, 모델 크기 하나입니다. GPT-2 small을 10억 토큰 학습했습니다.
- (b) 비교는 경계선에 있습니다. 기준을 0.001 넘었고, 같은 실행으로 한 두 비교 가운데 하나입니다.
- 처리량 숫자는 이 구현의 숫자입니다(
torch.compile아래의 PyTorchrms_norm).
다음 글
계획상 다음은 MLP의 GELU를 ReLU²로 바꾸는 비교이고, 이번에도 같은 GPT-2 세 실행과 견줍니다. 그 실행은 아직 시작하지 않았습니다.
계획서, 스크립트, 아홉 실행의 원시 로그는 아래 재현 패키지에 있고 로그인 없이 받을 수 있습니다. README에 GPU 없이 그 로그에서 이 글의 숫자를 모두 다시 계산하는 명령이 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
gpt2-norm-repro.zip · 289 KB