LLM은 왜 배운 것을 잊을까: 구글 Sleep은 덮어쓰기 전에 새 slot으로 옮겨 둡니다
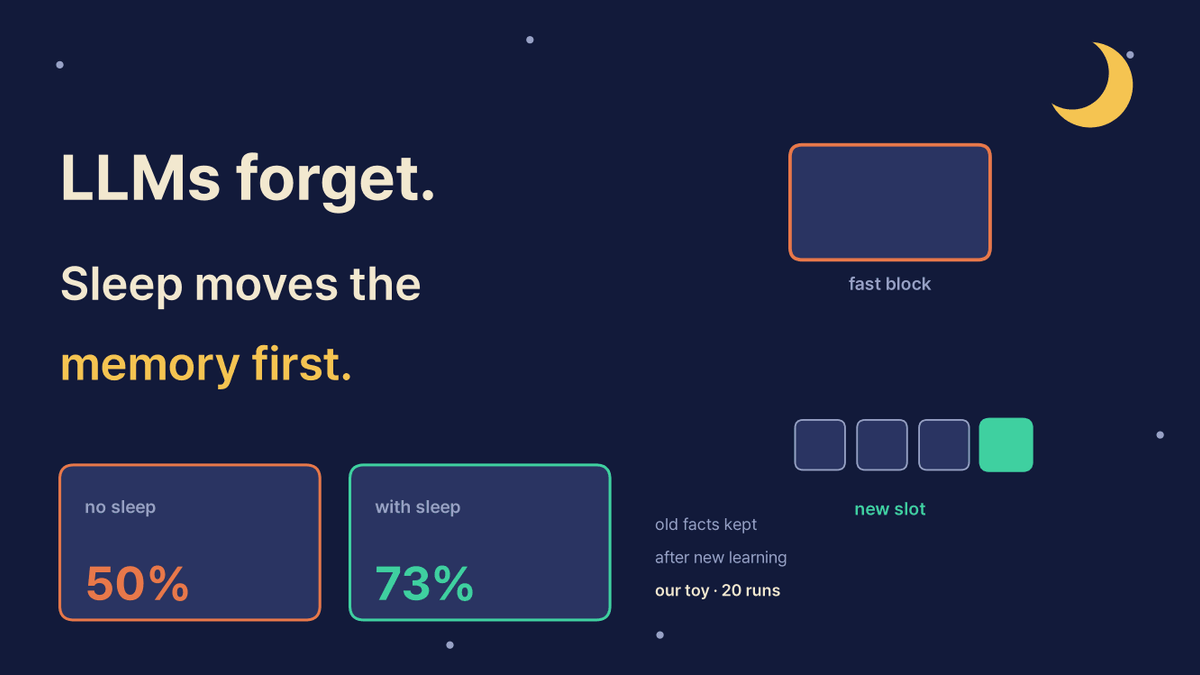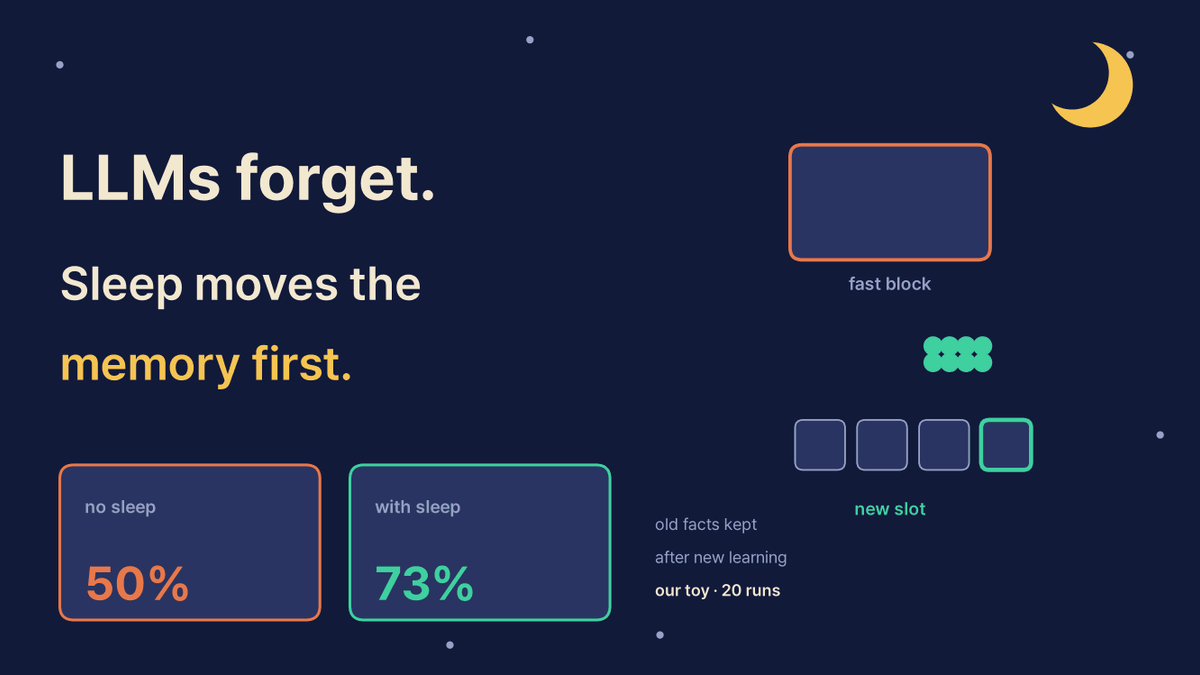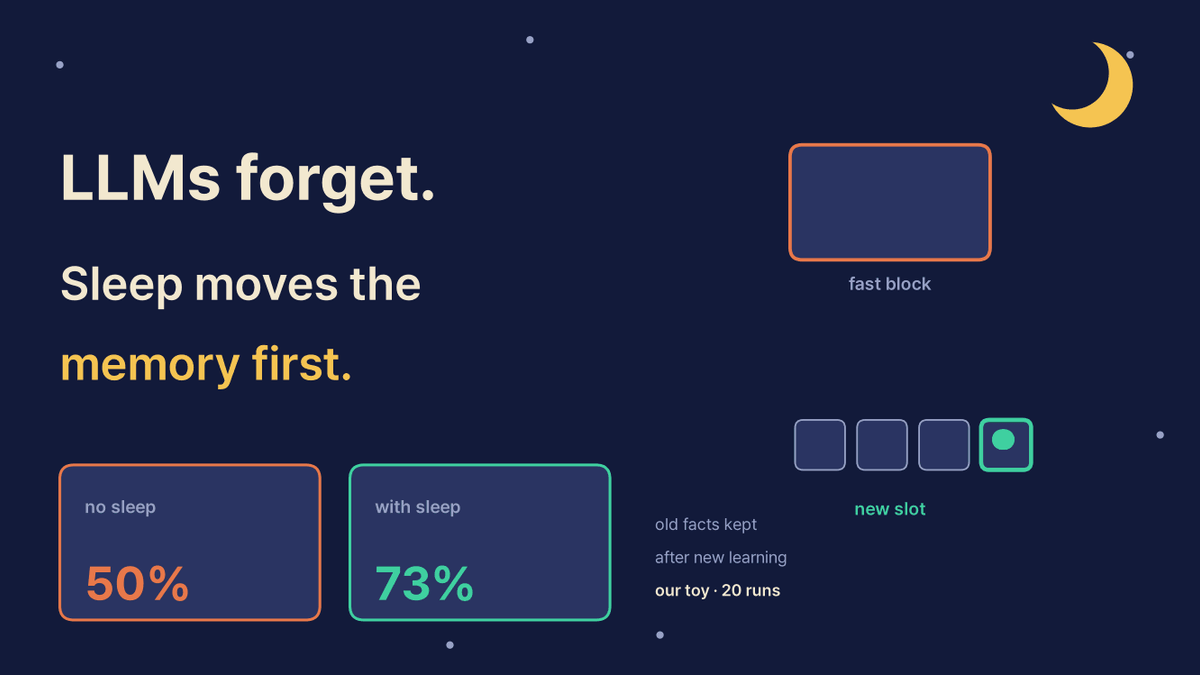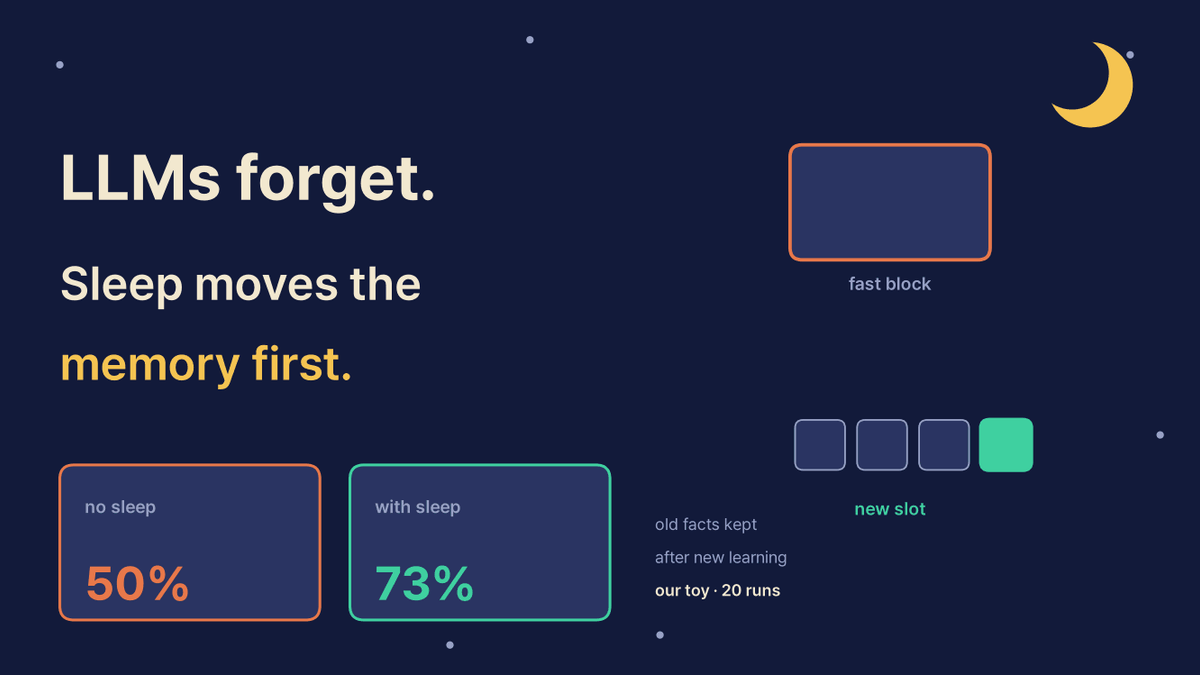
새 사실을 학습시키면 모델은 앞서 배운 것을 잊습니다. 구글의 Sleep 논문은 fast block이 덮어쓰이기 전에 내용을 작은 새 slot으로 옮기고, 스스로 만든 예제로 연습합니다. 저희 toy 모델(사실 100개)에서는 sleep 단계를 넣으면 옛 사실을 평균 73.2% 지켰고, 넣지 않으면 50.1%였습니다(20회 모두 우세). 다만 첫 시도에서는 오히려 더 잊었습니다. 논문은 Qwen3-8B AIME 2024에서 기본 모델 73.8 대비 79.2를 보고했고 코드는 공개하지 않았습니다.
LLM은 왜 배운 것을 잊을까: 구글 Sleep은 덮어쓰기 전에 새 slot으로 옮겨 둡니다
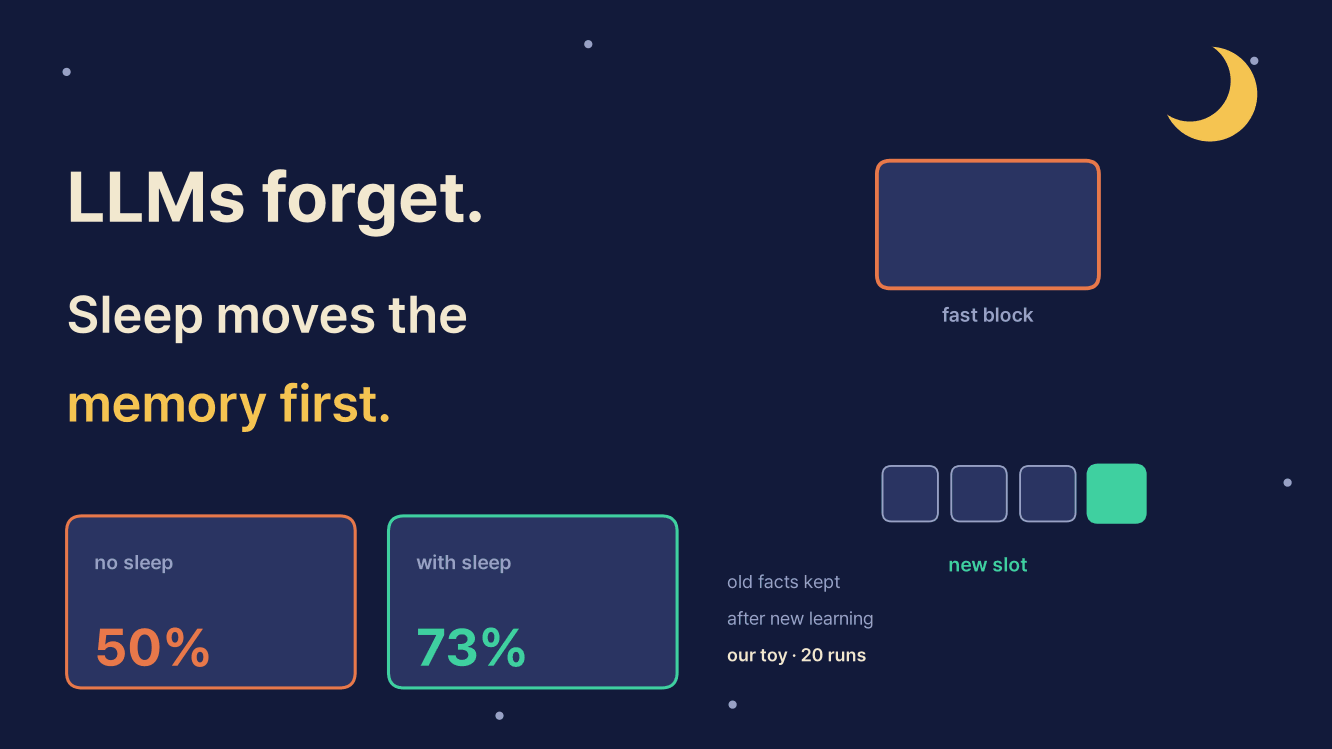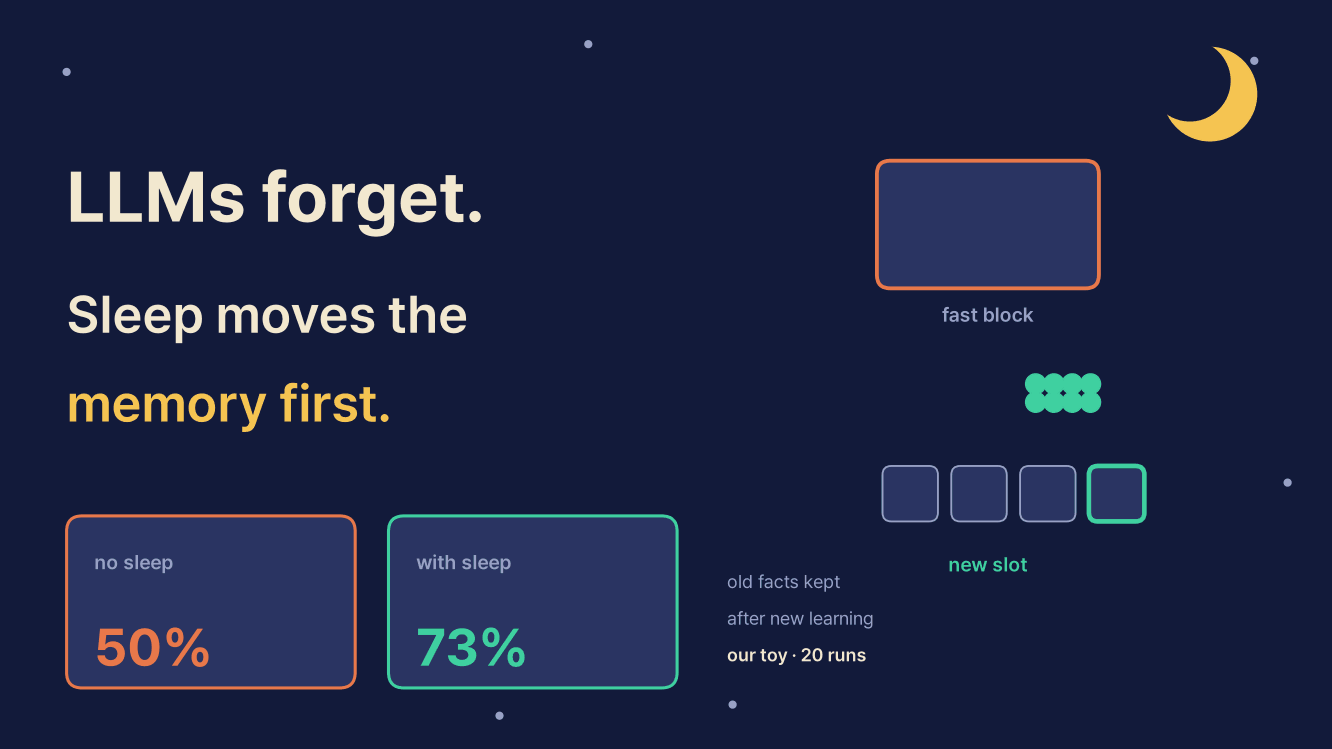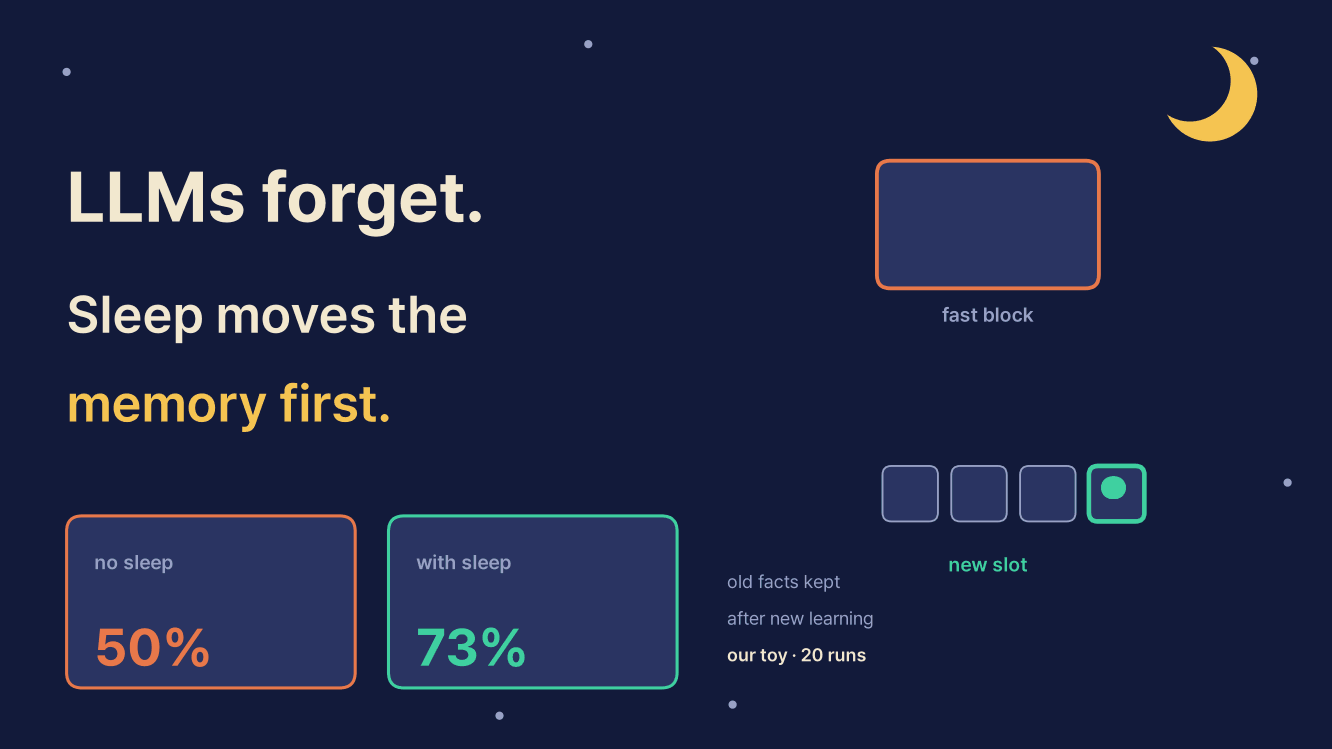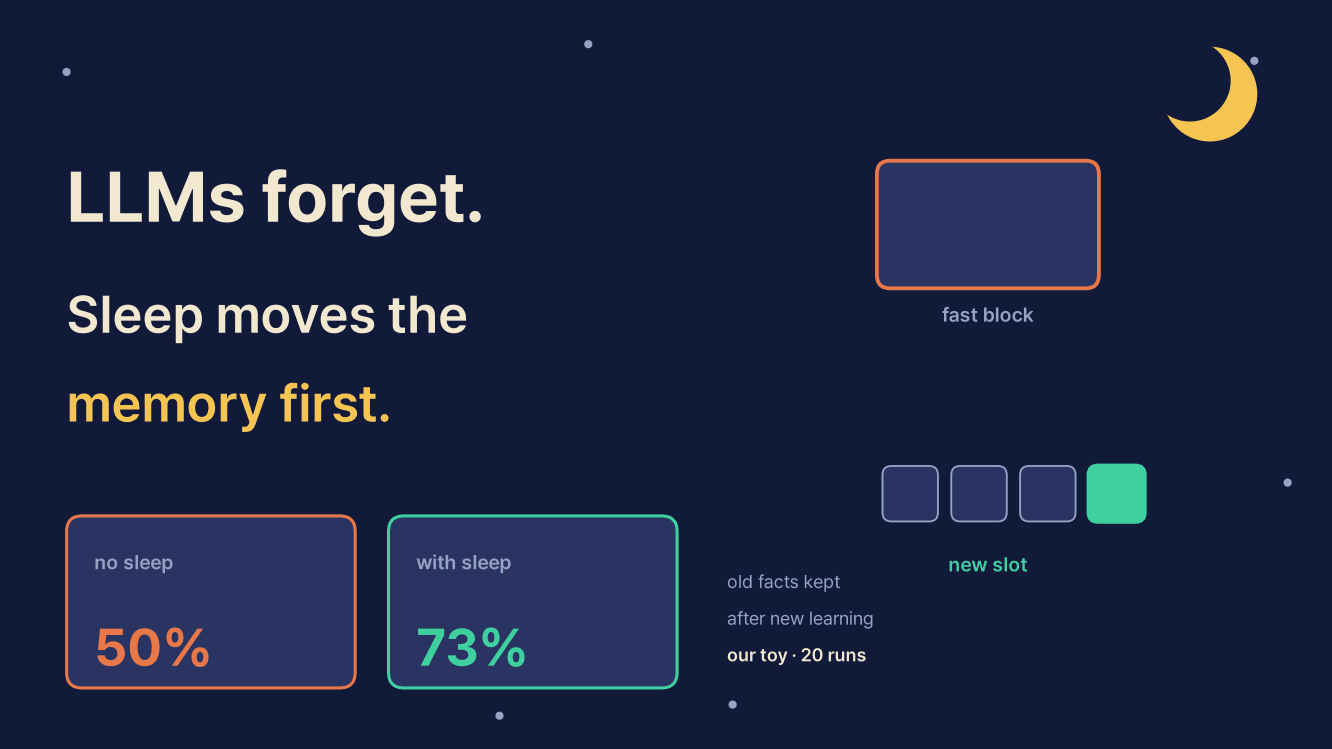
구글이 새로 낸 Sleep 논문의 핵심 생각을 작은 모델로 먼저 시험해 봤습니다. 새것을 배우기 전에, 이미 아는 것을 모델 안에 새로 붙인 작은 저장 공간(slot)에 옮겨 담고, 그 slot을 더는 바뀌지 않게 얼려 두는 방식입니다. 저희는 이 slot이 옛 지식을 지켜 줄 거라고 예상했습니다. 그런데 첫 버전은 반대로 움직였습니다. 다섯 번 돌려 보니 sleep 단계를 넣었을 때 옛 사실을 27-37%만 기억했고, 넣지 않았을 때는 38-53%였습니다. 학습 방식을 바꾸고 나서야(학습률을 낮추고, 새 사실을 전부 맞히는 순간 멈추게 함) sleep 단계가 효과를 냈습니다. 새로 고른 20번의 실행에서 옛 사실을 평균 73.2% 지켰고, sleep 없이는 50.1%였으며, 20번 모두 sleep 쪽이 앞섰습니다.
이 실패가 논문을 이해하는 데 오히려 좋은 출발점이었습니다. 새 slot을 만드는 일은 논문이 말하는 sleep의 앞부분일 뿐이기 때문입니다. 이 글에서는 방법을 한 단계씩 따라가면서 논문이 보고한 숫자를 붙이고, 도움이 되는 곳에는 저희 toy 실험을 함께 놓습니다. 논문은 Ali Behrouz, Farnoosh Hashemi, Adel Javanmard, Vahab Mirrokni의 "Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories"(구글·코넬, arXiv 2606.03979)이고, 구글 리서치가 10월 27일 블로그에 소개했습니다.
망각을 가장 직접 보여 주는 결과는 번역입니다. 사전학습 데이터에 없던 두 언어를 차례로 배우게 하자, 보통 방식(in-context learning)은 두 번역 점수가 모두 떨어졌습니다. ChRF 기준으로 대략 21과 36에서 대략 10과 15로 내려갔습니다. Sleep을 쓴 모델은 그래프에서 각 언어를 따로 배웠을 때와 가까운 자리에 남았고, 논문은 기억 층이 셋인 변형이 그 점수를 "거의 회복"했다고 씁니다. ChRF 값은 논문의 그래프(그림 5)에서 저희가 읽은 것입니다. 모델은 왜 잊는지, 모델이 잔다는 건 무슨 뜻인지부터 차례로 보겠습니다.
모델이 잊어버리는 이유
이미 꽉 찬 화이트보드를 떠올려 보세요. 새로 쓰려면 무언가를 지워야 합니다. 이것이 파국적 망각(catastrophic forgetting)입니다. 언어 모델은 아는 것을 가중치라는 한 묶음의 숫자에 담아 둡니다. 새것을 학습시키면 바로 그 숫자들이 다시 바뀌고, 그러면서 예전 답 일부가 지워집니다.
toy 모델로 보면 바로 드러납니다. 작은 신경망에 지어낸 사실 100개(A 묶음: 무작위 키와 0부터 9까지의 답)를 가르치면 전부 맞힙니다. 이어서 같은 가중치로 두 번째 묶음 B를 가르치면 B는 100%가 되는데, A는 100%에서 54%로 떨어집니다(시드 100).
그럼 새 사실을 프롬프트에 넣어 두면 되지 않을까요? 실제로 통하지만 대화가 끝나면 사라집니다. 손등에 적은 메모가 씻으면 지워지는 것과 같습니다. 프롬프트는 토큰마다 바뀌는 단기 기억이고, 가중치는 장기 기억인데 사전학습이 끝나면 더 바뀌지 않습니다. 논문은 지금의 모델을 선행성 기억상실증 환자에 빗댑니다. 과거는 기억하고 지금 일도 처리하지만, 지금 겪은 일이 오래 가는 기억으로 넘어가지 않습니다. Sleep은 이 둘 사이에 지식을 옮기는 단계를 만들려는 시도입니다.
속도가 다른 기억 여러 개
매일 바뀌는 메모, 일주일에 한 번 정리하는 노트, 일 년에 한 번 만드는 앨범을 생각해 보세요. 논문이 바탕으로 삼은 Hope라는 구조(같은 연구진의 앞선 연구)가 이렇게 생겼습니다. 블록마다 갱신 주기가 따로 있어서, 논문의 예로는 한 블록은 1,000스텝마다, 다음 블록은 5,000스텝마다, 가장 느린 블록은 10,000스텝마다 바뀝니다.
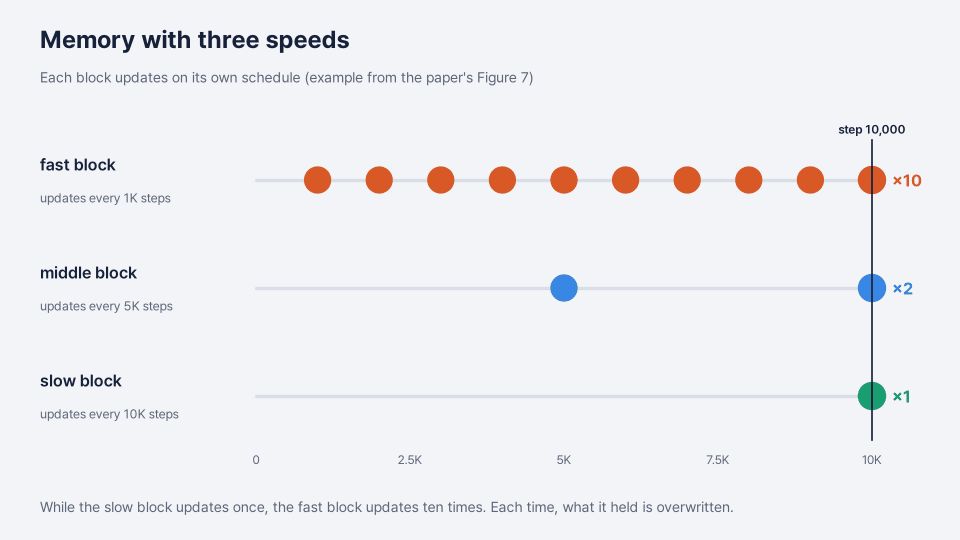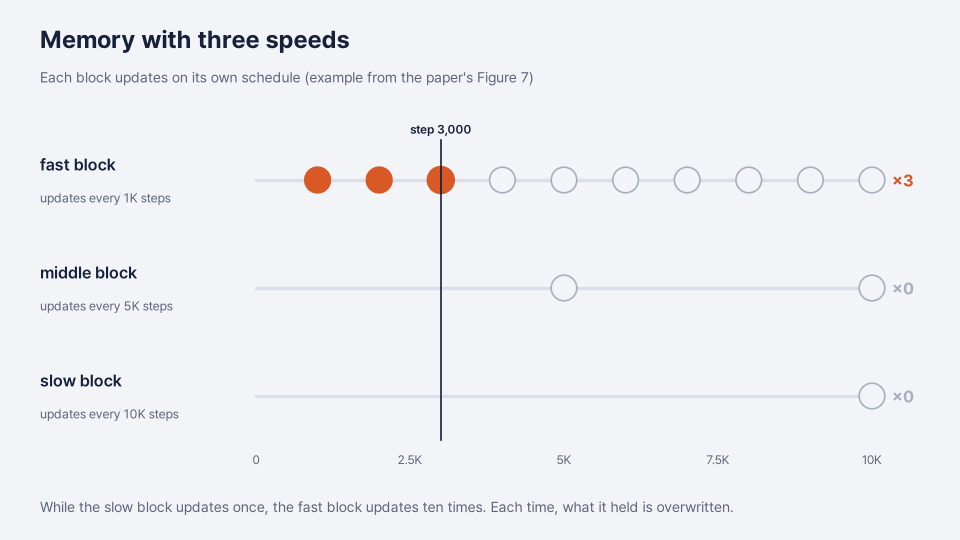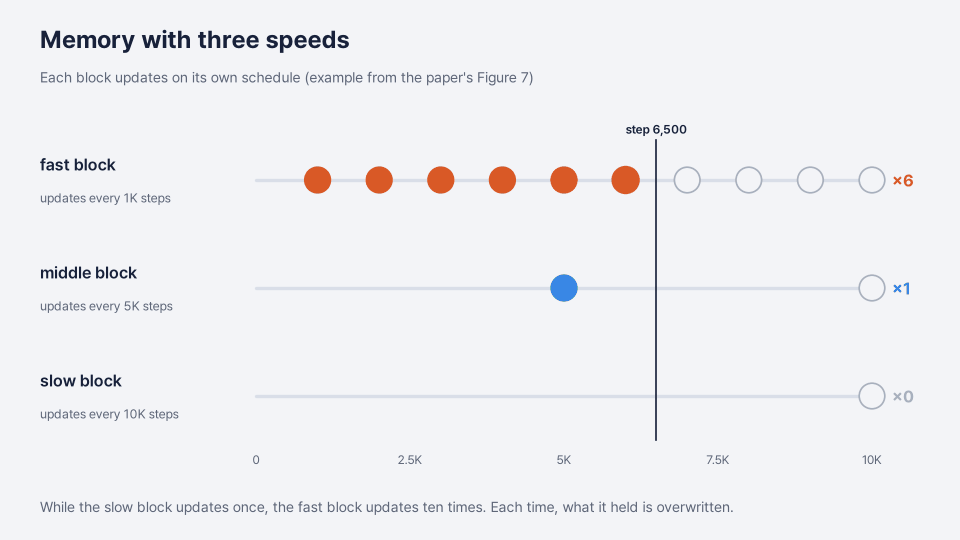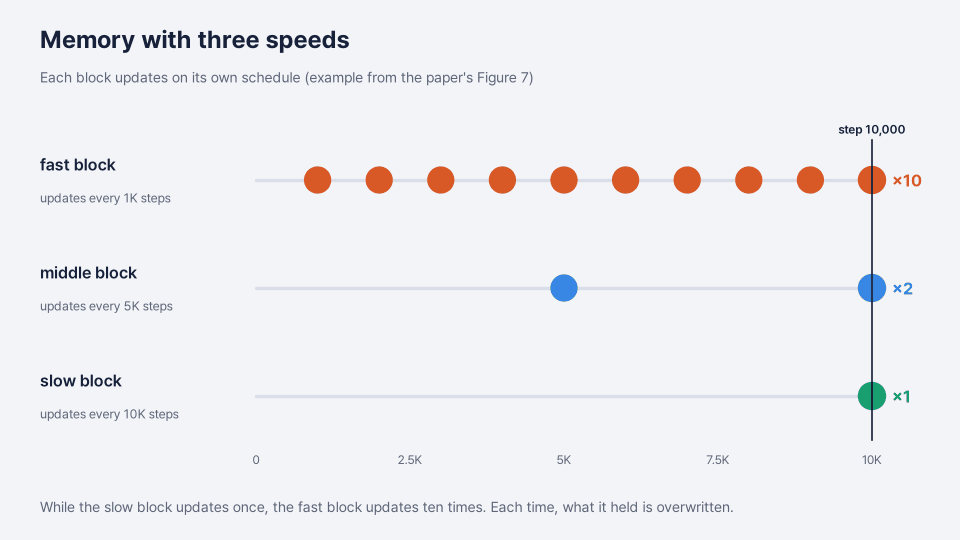
속도만 나눈다고 망각이 멈추지는 않습니다. fast block의 차례가 오면 갱신이 그 블록에 있던 내용을 덮어쓰기 때문입니다. 그래서 갱신 직전에 지식을 더 느린 블록으로 옮겨야 하고, 논문은 이 옮기는 과정을 sleep이라고 부릅니다. 모델은 두 상태를 오갑니다. 깨어 있을 때는 새 입력을 받아들이고, sleep 상태에서는 입력을 거의 받지 않은 채 이미 가진 것을 정리합니다.
Sleep은 두 단계로 나뉩니다. 논문은 사람의 수면 연구에서 컨셉과 용어를 빌려왔습니다(기억 공고화, 그리고 꿈 등). 뇌가 실제로 이렇게 움직인다고 주장하는 것이 아니라 영감으로 빌려 쓴 것입니다. 깊은 잠을 자는 동안 그날의 기억이 장기 저장소로 옮겨진다고 여겨지는데, 논문이 가져온 생각이 이것입니다.
1단계: 지식을 새 slot으로 옮기기 (Memory Consolidation)
기억 공고화는 세 걸음으로 진행됩니다(논문 7-8쪽).
- Compute. fast block의 다음 갱신을 계산만 해 두고 아직 적용하지 않습니다.
- Consolidate. 갱신 전 모델이 teacher가 됩니다. fast block에 최근 지식이 아직 남아 있기 때문입니다. student는 갱신을 적용한 모델에 느린 블록의 새 slot 하나를 더한 모델입니다. 나머지는 모두 얼리고 새 slot만 학습시켜, student가 teacher처럼 답하게 만듭니다.
- Update. fast block에 갱신을 적용하고, 그 블록이 쓰던 예전 자리는 비웁니다.
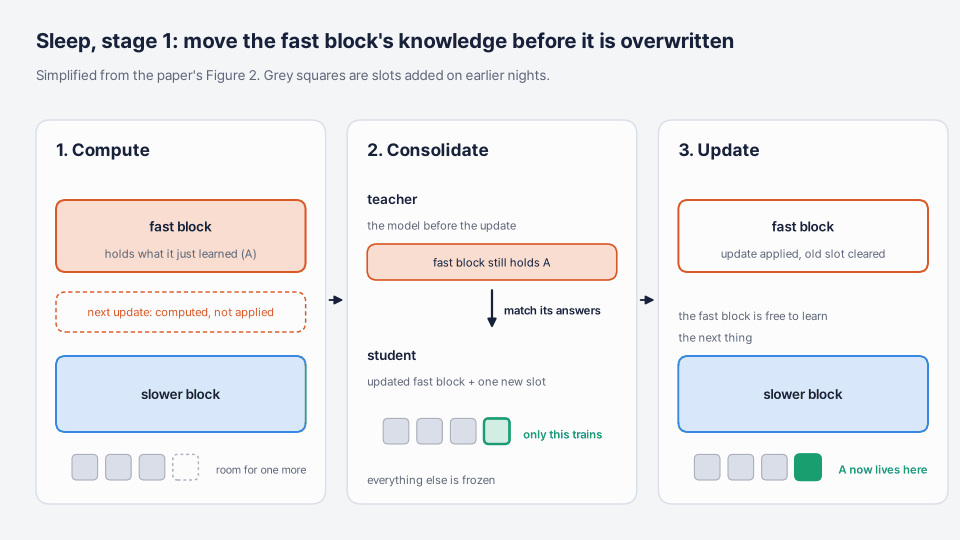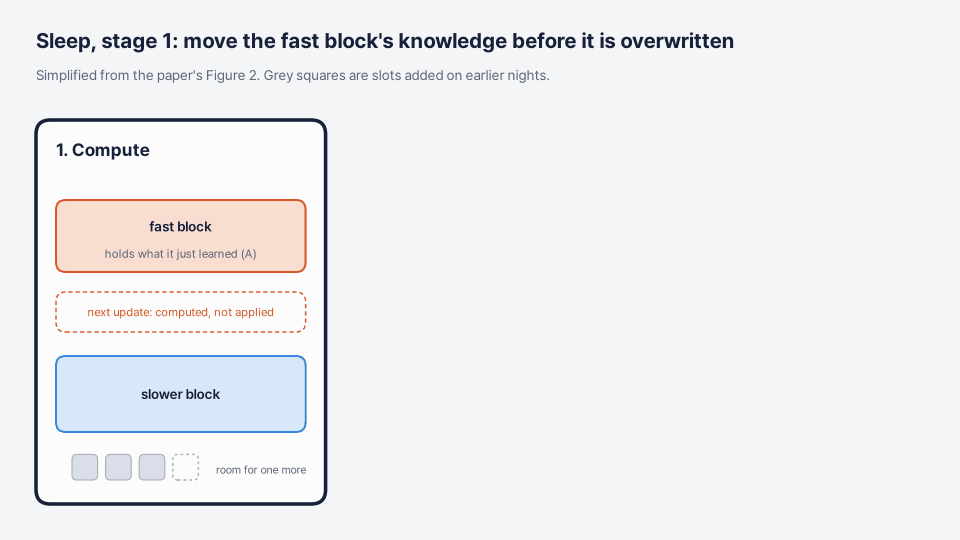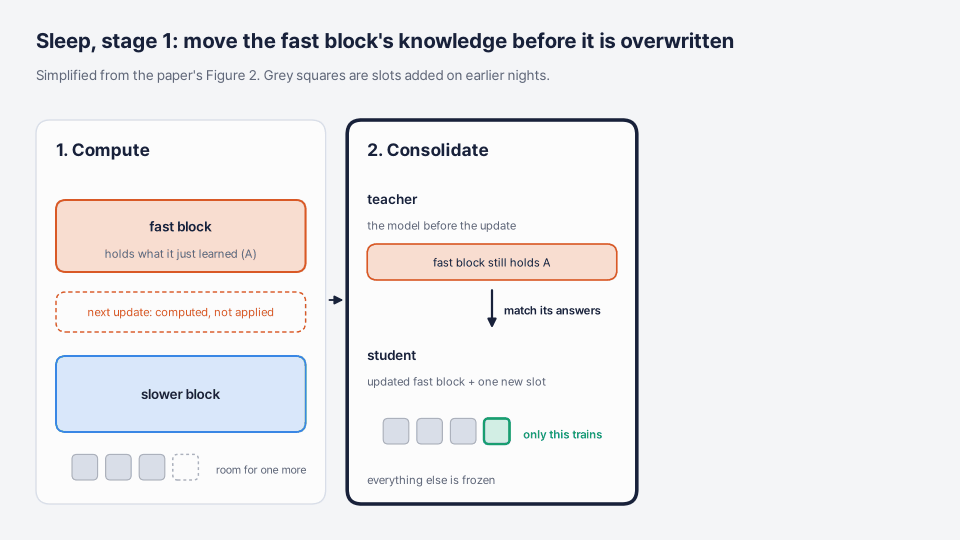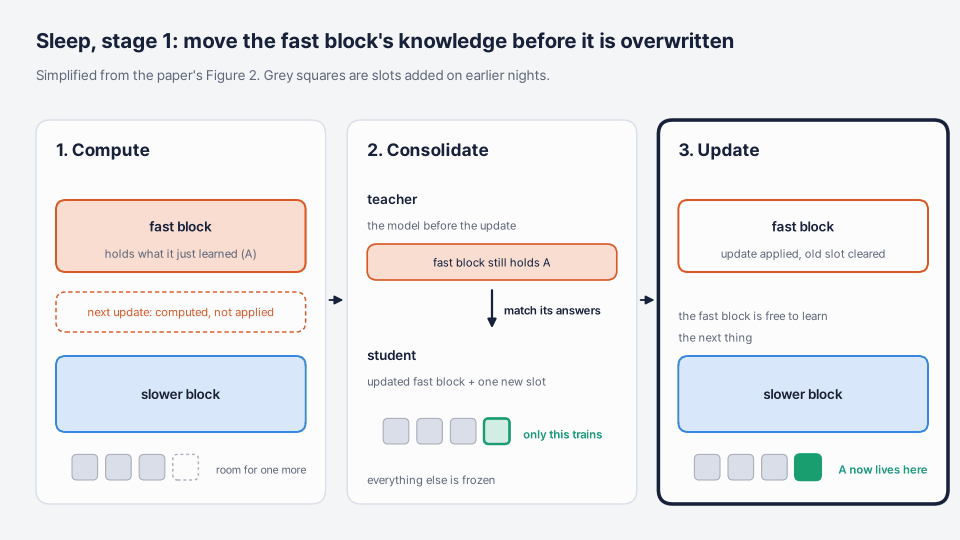
새 slot은 low-rank expert입니다. 얇은 행렬 두 개, A(d × d_low)와 B(d_low × d)로 이루어지고 d_low는 d보다 훨씬 작습니다. 블록들은 MoE(mixture-of-experts) 층이라서 router가 입력마다 어떤 expert를 쓸지 고르는데, 덕분에 새 expert를 다른 expert를 건드리지 않고 끼워 넣을 수 있습니다. 구현을 쉽게 하려고, 논문은 slot을 미리 만들어 가려 두었다가 sleep 때 켜는 방법을 제안합니다. 논문 실험에서 추가된 slot은 모두 합쳐 크기 64짜리 블록 다섯 개이고, 실제로 계산에 쓰이는 가중치 수는 원래 모델과 같습니다(25쪽).
저희 toy 모델로 돌려 보기
toy 모델은 이 단계의 뼈대만 남겼습니다. 얼려 둔 기본 층 위에 fast block(가중치 17,098개)이 있고, 이 블록이 A를 배웁니다. 그다음 sleep 단계입니다. A에 대한 모델의 답을 기록해 두고, 새 slot(가중치 4,256개, fast block의 약 4분의 1)을 붙인 뒤 그 slot만 같은 답을 내도록 학습시킵니다. slot을 얼리고, fast block을 새로 만들어 B를 배우게 합니다.
def sleep(model, facts, steps=500):
    x, _ = facts
    with torch.no_grad():
        teacher_answers = model(x).argmax(-1)      # 깨어 있는 모델이 A에 내는 답
    slot = new_slot()                              # 256 -> 16 -> 10, bias 없음
    old_slots = list(model.slots)
    opt = torch.optim.Adam(slot.parameters(), lr=1e-2)
    for _ in range(steps):
        h = model.base(x)
        out = slot(h) + sum(s(h) for s in old_slots)
        loss = F.cross_entropy(out, teacher_answers)
        opt.zero_grad(); loss.backward(); opt.step()
    slot.requires_grad_(False)                     # 이후로 slot은 얼려 둠
    model.slots.append(slot)
    model.fast = fast_block()                      # 다음 묶음을 배울 새 fast block
논문과 다른 점이 여럿 있습니다.
- 논문의 student는 갱신된 fast block을 그대로 갖고 있지만, 저희 student는 slot을 학습하는 동안 fast block이 아예 없습니다.
- sleep 동안 slot에 A의 원래 키를 다시 넣어 줍니다. 논문의 설정에는 sleep 동안 바깥 데이터가 없고, 다음 절의 방법이 바로 그 문제를 풀려고 나온 것입니다. 저희 toy는 가장 어려운 부분을 건너뛴 셈입니다.
- sleep이 끝나면 fast block 전체를 새것으로 바꿉니다. 논문은 계산해 둔 갱신을 적용하고, 예전 sleep 때 fast block에 붙였던 low-rank 부분만 초기화합니다(9쪽).
- router가 없고, slot의 출력을 그냥 더합니다.
- teacher의 확률이 아니라 가장 높은 답 하나만 따라 하게 했습니다. 그리고 2단계가 없습니다.
아까와 같은 시드 100에서 A와 B 사이에 sleep 단계를 넣으면, B를 배운 뒤 A가 54%가 아니라 76%에 머뭅니다. 한 번은 운일 수 있으니, 설정을 고를 때 쓰지 않은 새 시드 20개(100-119)로 다시 돌렸습니다. B를 배운 뒤 A는 sleep 없이 평균 50.1%, sleep을 넣으면 평균 73.2%였고, 20번 모두 sleep 쪽이 높았습니다. B는 두 조건 모두 매번 100%였습니다.
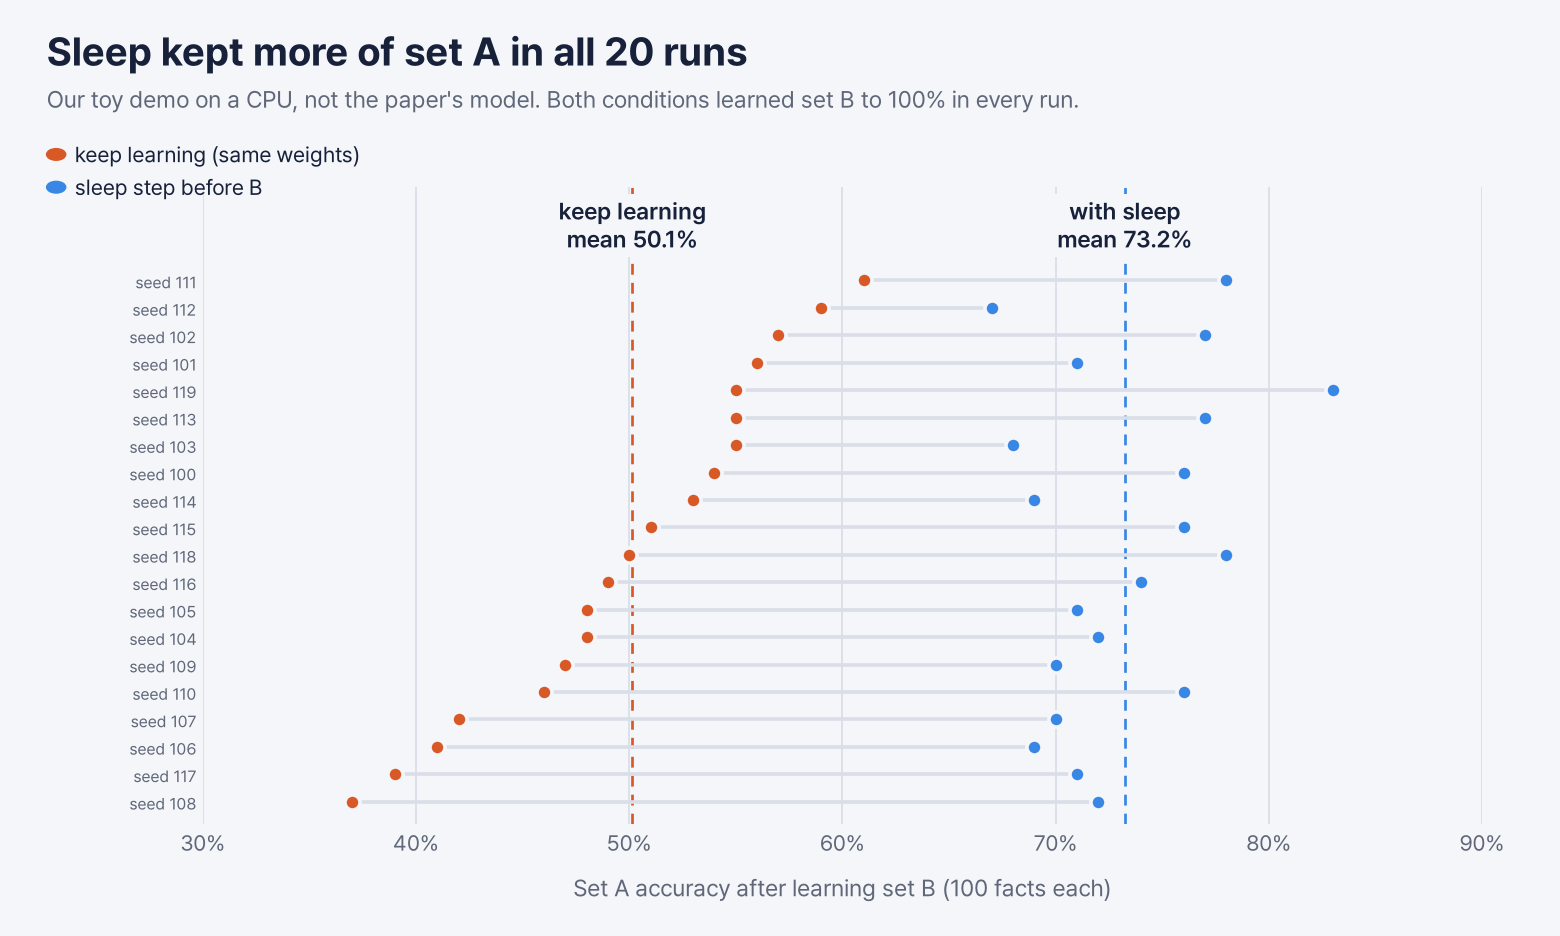
이 설정에 이르기까지 한 번 실패했습니다. 첫 버전에서는 fast block이 큰 학습률(1e-2)로 300스텝을 고정해서 B를 학습했고, slot은 teacher의 확률 분포를 따라 했습니다. 시드 0-4에서 sleep 단계를 넣으면 A가 27-37%로, 넣지 않았을 때의 38-53%보다 낮았습니다. 저희 해석으로는 새 fast block이 B를 너무 세게 배워서, slot의 답과 그냥 더해지는 fast block의 출력이 A의 키에서도 slot의 답을 눌러 버린 것으로 보입니다. A와 B의 입력 영역을 나누거나 fast block 마지막 층을 0에서 시작하게 해 봤지만 뚜렷한 도움이 없었습니다. 효과가 있었던 것은 학습률 1e-3, B를 100% 맞히는 순간 멈추기, 그리고 확률 대신 답 하나를 따라 하게 한 것이었습니다.
그래도 toy 모델은 A의 약 4분의 1을 잃습니다. 새 fast block이 B를 배우면서 A의 키에 대한 답도 여전히 흔들기 때문입니다. 세 번째 묶음도 시험했습니다. A, B, C 순서로 배우게 하자 C를 배운 뒤 A는 시드 0-4에서 두 조건 모두 32-48%였습니다. 두 번째 sleep은 B를 지켰을 뿐 A를 지키지 못했습니다. slot은 도움이 되지만 그것만으로 방법이 완성되지는 않습니다. 논문은 이 단계 위에 두 가지를 더 얹었습니다.
작은 쪽이 큰 쪽을 가르치는 방법 (Knowledge Seeding)
보통 distillation에서는 큰 모델이 작은 모델을 가르칩니다. 여기서는 방향이 반대입니다. 새 데이터를 본 작은 부분이 더 큰 쪽을 가르쳐야 합니다. teacher는 새 지식을 작고 빠른 기억에만 담고 있는 모델이고, student는 새 slot 덕분에 공간이 더 많습니다. 논문은 이것을 knowledge seeding이라고 부르며 문제 두 가지를 짚습니다. student가 teacher보다 표현할 수 있는 게 많으니 teacher의 출력만 베끼면 새 공간이 낭비됩니다. 그리고 sleep 동안에는 바깥에서 들어오는 학습 데이터가 없습니다.
그래서 논문은 두 가지 학습 과정을 섞습니다.
- student가 쓴 글로 하는 distillation. student가 글을 쓰고, 토큰마다 student의 확률을 teacher의 확률과 비교합니다.
- Imitation. teacher가 글을 쓰면 student는 앞부분만 받아서 이어 씁니다. 보상은 두 가지 검사를 섞습니다. 고정된 보상 모델이 뜻이 같은지를 1 또는 0으로 판정하고, 글자 단위로 얼마나 가까운지를 잽니다(1에서 편집 거리를 더 긴 쪽 길이로 나눈 값을 뺌). 가중치 γ 하나가 둘의 비율을 정합니다.
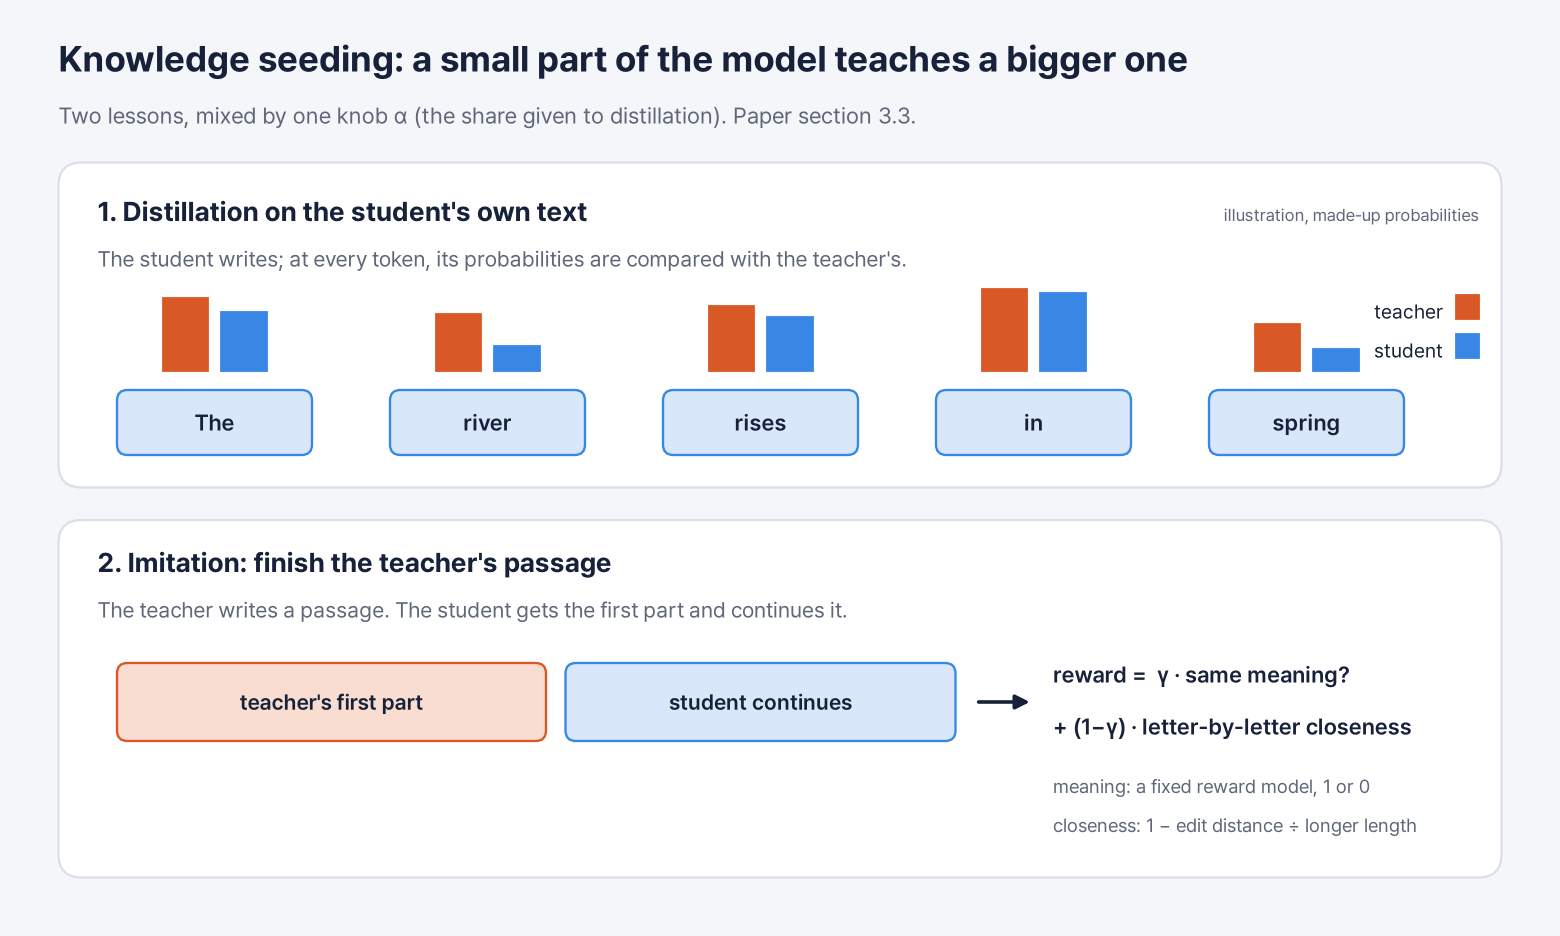
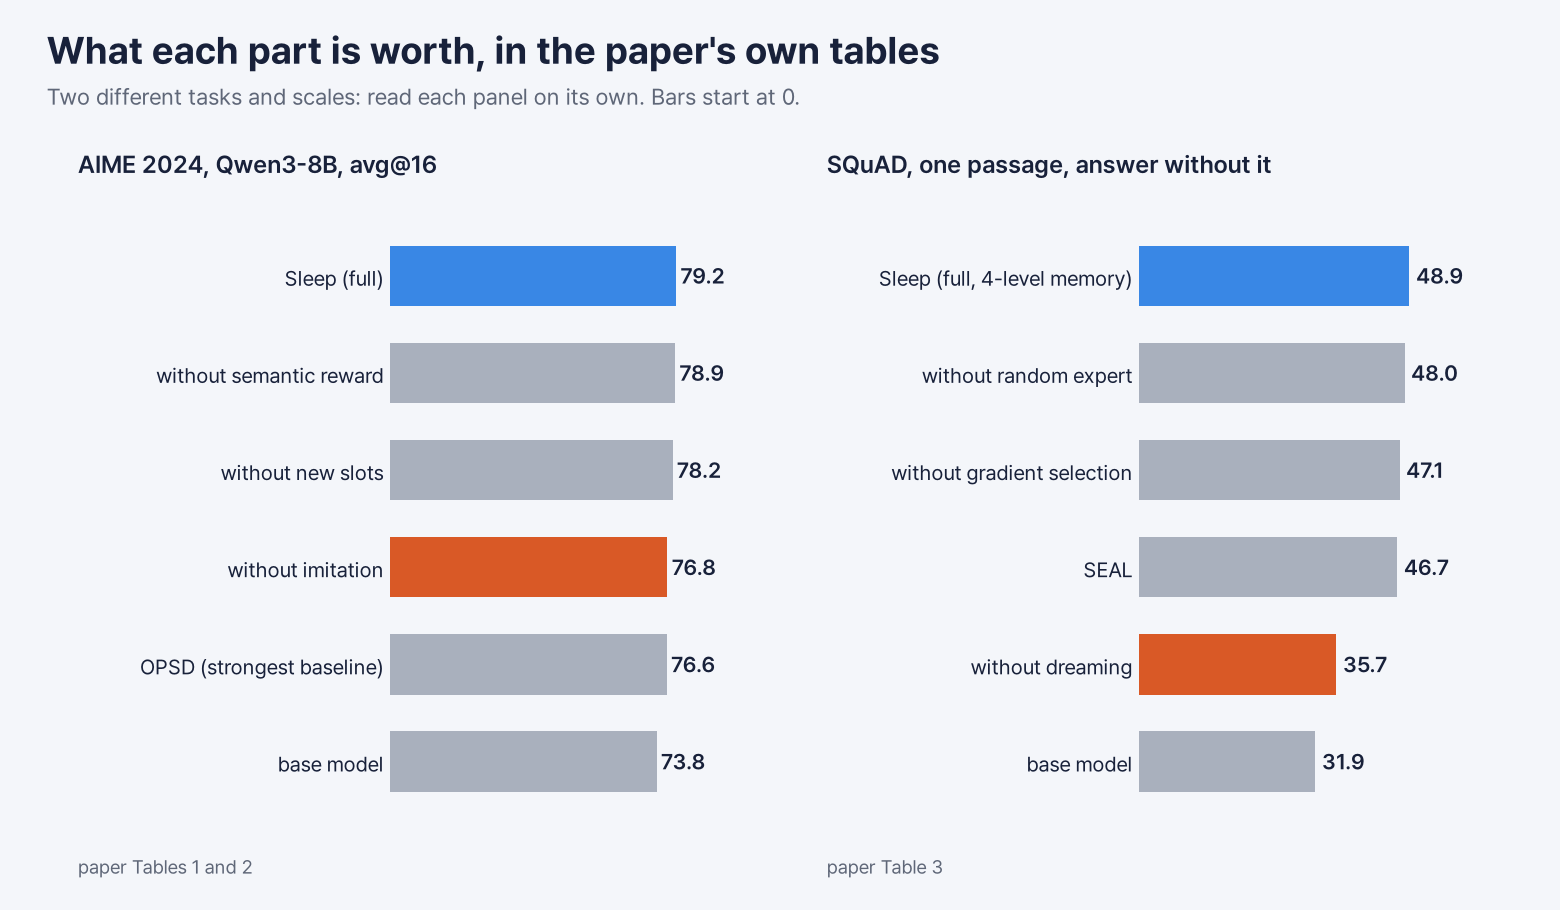
최종 로스 함수는 또 하나의 가중치 α로 두 과정의 비중을 맞춥니다. α는 distillation 쪽 비중을 정하는 하이퍼파라미터입니다. 왜 둘 다 필요할까요? 논문에 따르면 distillation만 하면 student가 지식을 갖고는 있어도 쓰는 법을 배우지 못했고, teacher를 따라 하는 정도도 약했습니다. 논문 표 1의 제거 실험(Qwen3-8B, AIME 2024, 16회 샘플 평균)이 이를 숫자로 보여 줍니다. imitation을 빼면 79.2에서 76.8로 떨어집니다. 새 slot을 빼면 78.2, 뜻 검사를 빼면 78.9입니다.
2단계: 꿈꾸기 (Dreaming)
두 번째 단계는 시험 전날 밤 스스로 연습 문제를 만들어 풀어 보는 것에 가깝습니다. 모델이 자기 학습 데이터를 직접 쓰는 기존 방법 SEAL(Zweiger et al., 2025)을 바탕으로 합니다.
- 모델이 과제에 맞는 연습 예제, 즉 dream을 씁니다. 쓰는 동안 router가 무작위 expert 하나를 더 끼워 넣어서, 겉보기에 관계없는 지식이 섞여 들어가게 합니다.
- dream마다 gradient로 중요도 점수를 매깁니다. 점수가 높은 dream을 남기고, 다양성을 위해 무작위로 몇 개를 더 남깁니다.
- 남은 dream 하나하나로 모델 복사본을 학습시킵니다(LoRA 사용). 복사본의 과제 점수가 오르면 그 dream은 보상 1을, 아니면 0을 받습니다.
- 모델은 보상을 받은 dream과 비슷한 dream을 더 쓰도록 배웁니다.
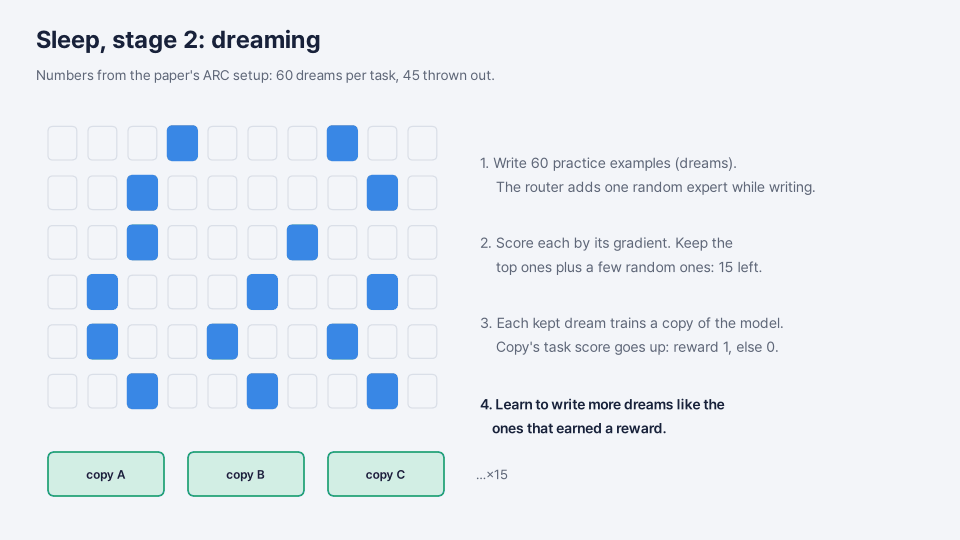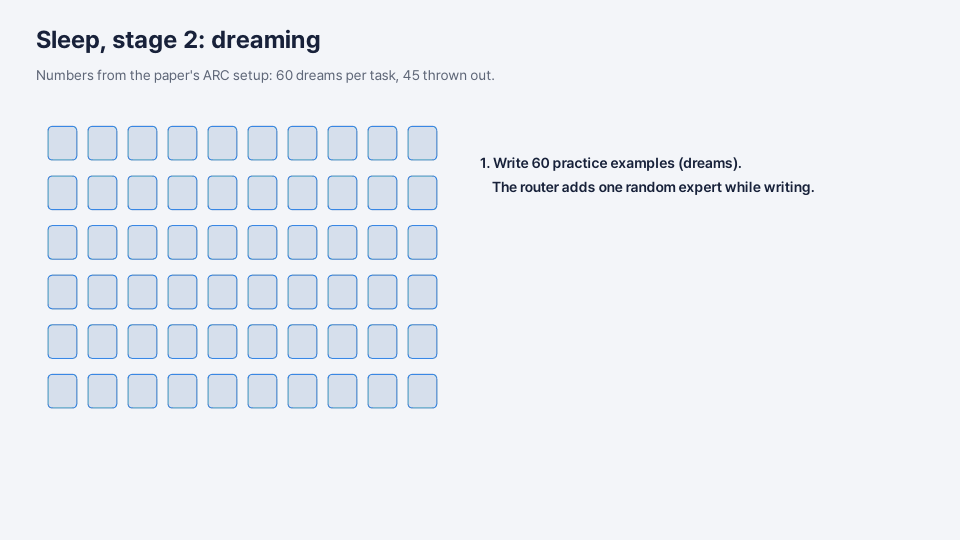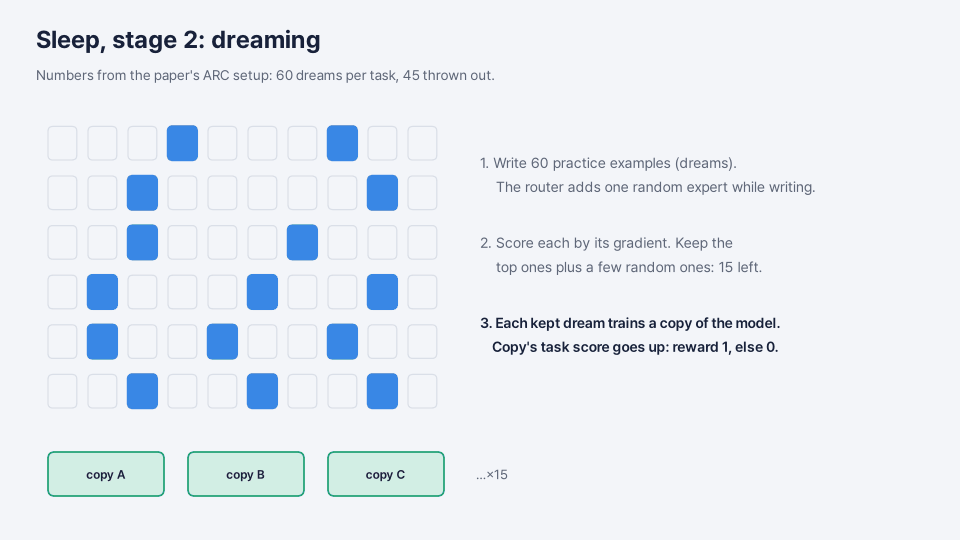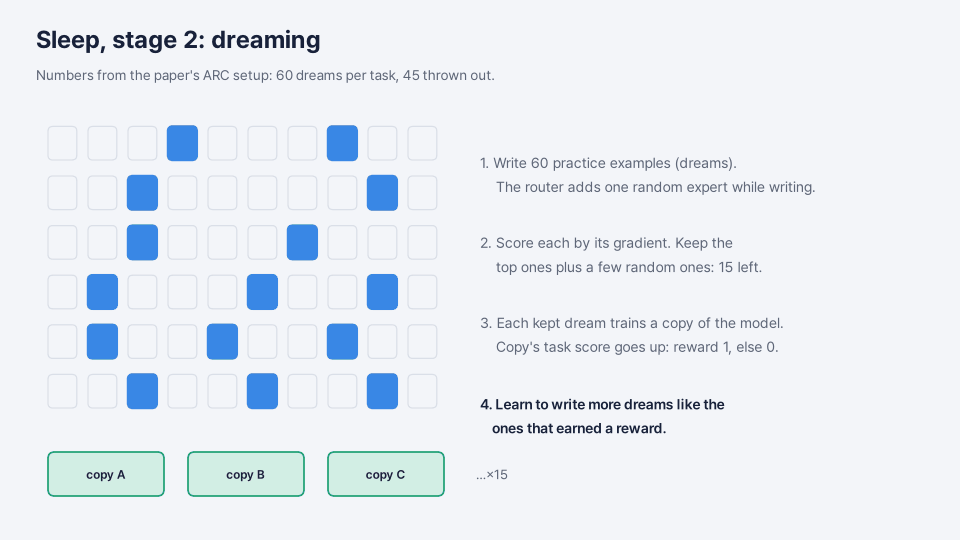
논문의 ARC 설정에서는 과제 하나당 dream 60개를 쓰고 그중 45개를 버립니다(26쪽). 두 단계의 순서에도 이유가 있습니다. 먼저 기억 공고화가 새 지식을 새 slot에 자리 잡게 하고, 그다음에야 꿈꾸기가 모델을 바꿉니다. 논문은 이 순서 덕분에 자기 개선을 거듭하다가 예전 능력을 덮어쓸 위험이 줄어든다고 설명합니다.
논문이 SQuAD에서 하나씩 빼 본 부품 가운데서는 꿈꾸기가 가장 크게 작용합니다. 지문을 보지 않고 지문에 관한 질문에 답하는 SQuAD 과제에서 전체 방법은 48.9점이었습니다. 꿈꾸기를 빼면 35.7로 떨어져, 기본 모델의 31.9에 가까워졌습니다(표 3).
논문이 보고한 결과
아래 내용은 논문에 게시된 숫자를 근거로 작성하였습니다. 저희가 다시 돌린 것은 없습니다.
수학 추론(표 2, 16회 샘플 평균):
| Qwen3-8B | AIME 2024 | AIME 2025 | HMMT 2025 |
|---|---|---|---|
| 기본 (Instruct) | 73.8 | 68.1 | 42.4 |
| SFT | 75.5 | 66.4 | 43.7 |
| GRPO | 76.4 | 68.1 | 44.9 |
| On-policy self-distillation (OPSD) | 76.6 | 67.4 | 45.1 |
| Sleep | 79.2 | 69.0 | 46.1 |
열은 벤치마크, 행은 같은 모델을 학습시킨 방법입니다. 표에서 가장 강한 비교 대상인 OPSD가 76.6이고, Sleep은 79.2입니다. Qwen3-1.7B에서도 Sleep이 세 벤치마크 모두에서 가장 높았습니다(AIME 2024에서 Sleep 53.2, 기본 모델 49.8).
새 사실 익히기(표 3, 지문 없이 푸는 SQuAD, SEAL과 같은 모델·설정): 지문 하나일 때 기본 31.9, SEAL 46.7, Sleep 48.9입니다. 지문 200개를 한꺼번에 넣으면 SEAL 43.2, Sleep 46.2입니다.
예시 몇 개로 푸는 퍼즐(ARC, Llama-3.2-1B): Sleep 80%, SEAL 72.5%입니다. 이 점수는 dream이 정답으로 이어진 비율이고, 평가 과제 8개에서 과제마다 dream 5개씩을 썼습니다(26쪽).
두 가지 새 언어를 차례로 배우기(그림 5): 처음에 소개한 만주어와 칼라망어 번역입니다. 한 언어씩 따로 배울 때는 Sleep의 모든 변형이 in-context learning과 같거나 더 높았습니다. 차례로 배우면 기억 층이 셋인 변형이 논문 표현으로 "한 언어만 배웠을 때의 성능을 거의 회복"했습니다(12쪽). 구글 블로그는 같은 결과를 "성능 저하가 거의 0"이라고 소개했는데, 논문의 표현보다 강한 말입니다. Cartridges와 일반 파인튜닝은 두 언어 가운데 적어도 하나를 잊었고, 적어도 한 과제에서 in-context learning보다 낮았습니다.
긴 문맥(BABILong, 그림 6): Sleep은 1,000만 토큰까지 버텼고, GPT-4와 GPT-4o-mini는 128K-256K 토큰을 넘으면 무너졌습니다. 다만 이 그림의 작은 모델들은 Sleep을 포함해 모두 이 과제로 파인튜닝한 모델이고, 논문은 파인튜닝 없이는 Sleep도 크게 떨어진다고 밝혔습니다(26쪽).
비용
학습 스텝 하나만 보면 일반 파인튜닝(SFT)이 Sleep보다 약 4배 빠릅니다. 그런데 같은 점수에 도달하기까지 SFT는 실제 걸린 시간이 AIME 2024에서 4.3배, AIME 2025에서 3.6배, HMMT 2025에서 4.8배 더 길었습니다(부록 B.5). 표 5의 학습 설정은 SFT와 Sleep이 100스텝, GRPO가 500스텝입니다. 서비스 중인 모델이 얼마나 자주 sleep 해야 하는지, 그때 비용이 얼마인지는 논문에 나오지 않습니다.
이 숫자를 믿기 전에 볼 것
- 코드가 없습니다. 논문에서 코드 링크를 찾지 못했으므로 논문의 숫자는 아직 따로 확인할 수 없습니다.
- 그래프에서 읽은 값. 번역 점수는 저희가 그림 5에서 읽은 값입니다. 번역과 긴 문맥 결과는 둘 다 표가 없습니다.
- 작은 시험. ARC 결과는 과제 8개에 기대고 있습니다.
- 저희 toy 모델은 원리를 보여 주는 실험이지 재현이 아닙니다. 과제는 두 개뿐이고, 세 개로 늘리면 첫 과제는 지켜지지 않았습니다.
정리와 남은 질문
모델이 잊는 이유는 새 학습이 같은 가중치를 덮어쓰기 때문입니다. Sleep은 먼저 fast block이 담고 있던 것을 작은 새 slot으로 옮기고, 그다음 스스로 쓴 예제로 연습합니다.
그렇다면 모델이 밤마다 새 slot을 하나씩 늘릴 때, 몇 밤을 자고 나면 자리가 바닥날까요? 논문 실험은 slot을 정해진 수만큼 쓰고(실험에서는 크기 64짜리 블록 다섯 개), slot이 다 찼을 때 무슨 일이 생기는지는 시험하지 않았습니다.
참고 자료
- Behrouz, Hashemi, Javanmard, Mirrokni, "Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories", arXiv 2606.03979 (v2, 2026년 7월).
- Google Research 블로그, "The SLEEP framework: A new way for LLMs to retain knowledge in continual learning", 2026년 10월 27일.
- Zweiger et al., "Self-Adapting Language Models"(SEAL), 2025.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
llm-sleep-continual-learning-repro.zip · 11 KB