MCP 서버 8개를 붙였더니 질문도 하기 전에 47,800토큰이 사라졌습니다: 실측과 91% 다이어트
인기 MCP 서버 8종(134개 툴)을 Anthropic 공식 count_tokens와 Claude Haiku 4.5로 실측했습니다. Notion 하나만 24,441토큰, 전체 47,800토큰이 매 턴 붙었고, Allowlist는 토큰을 81.8% 줄이며 정확도를 12/12로 올렸습니다. 지연 로딩은 총 입력 토큰을 91.3% 줄였습니다.

코딩 에이전트에 MCP 서버를 몇 개 붙이면 첫 질문을 보내기도 전에 컨텍스트가 수만 토큰씩 빠져나갑니다. 많이들 "서버 5개면 2만 토큰쯤 쓴다"고 말하지만, 막상 어느 서버가 얼마나 차지하는지, 또 OpenAI 기준 tiktoken으로 잰 숫자와 실제 Claude API가 과금하는 토큰 수가 얼마나 다른지는 직접 재 보지 않으면 알기 어렵습니다.
인기 MCP 서버 8종(GitHub, Playwright, Chrome DevTools, Notion, Filesystem, Memory, Postgres, Context7)을 로컬 stdio로 띄워 실제 tools/list 응답 134개 툴을 수집했습니다. 그 스키마를 tiktoken과 Anthropic 공식 /v1/messages/count_tokens API로 각각 잰 뒤, claude-haiku-4-5-20251001에 15개 개발 태스크를 던져 다이어트 기법 세 가지의 실제 과금 토큰, 응답 시간, 툴 선택 정확도를 비교했습니다.
가장 먼저 드러난 사실은 tiktoken 추정치가 실제 Claude 과금 토큰을 36%나 적게 잡는다는 점입니다. tiktoken(o200k_base)으로는 8개 서버 134개 툴이 35,136토큰이었지만, Anthropic 공식 API는 같은 페이로드에 47,800토큰을 청구했습니다. Notion MCP 하나만 붙여도 24,441토큰이 빠져나갔습니다. 반대로 134개 툴을 전부 올려 두었다고 정확도가 높지도 않았습니다. Playwright와 Chrome DevTools의 브라우저 툴 이름이 겹치면서 전체 로딩의 범위 내 정확도는 12개 중 10개에 그쳤고, 핵심 25개만 남긴 Allowlist는 입력 토큰을 81.8% 줄이면서도 12개 중 12개를 모두 맞혔습니다.
아래에서는 서버별 실제 토큰 소모량과 숨은 누수 지점을 먼저 보고, 이어서 다이어트 기법 세 가지의 15문제 실측 결과, 20턴 세션 비용 비교, 그리고 바로 적용할 수 있는 필터·지연 로딩 코드를 정리합니다.
MCP 서버 8종 실측: Notion 하나가 절반을 먹었습니다
각 서버를 npx -y로 띄워 initialize와 tools/list JSON-RPC 응답을 그대로 저장했습니다. 외부 쓰기 없이 스키마만 받았고, 8개 서버 모두 에러 없이 응답했습니다.
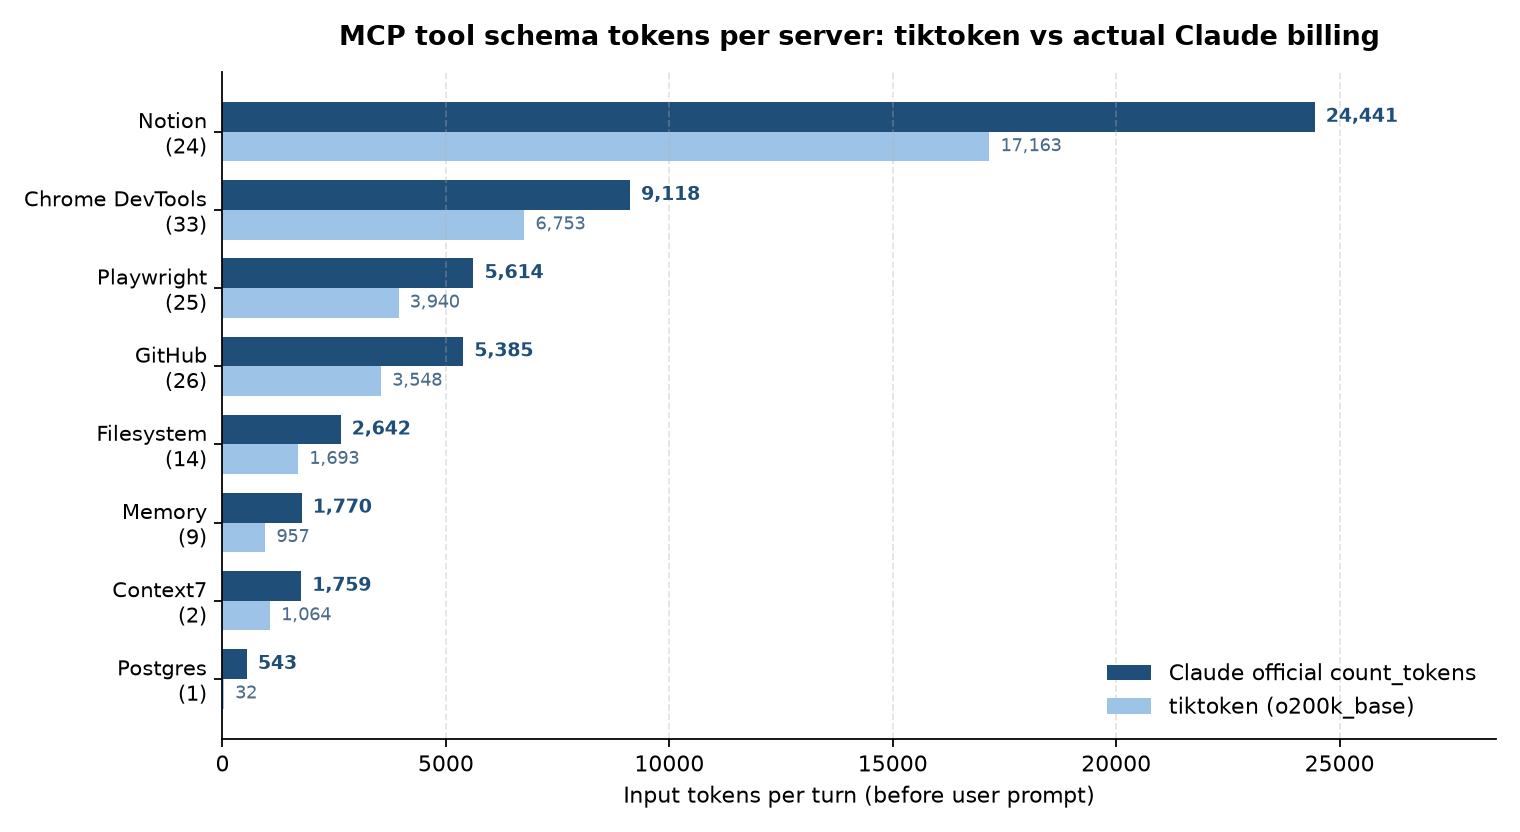
| MCP 서버 | 툴 수 | Raw MCP JSON (o200k) | API 변환 후 (o200k) | Claude 공식 과금 토큰 | 툴 1개당 Claude 토큰 |
|---|---|---|---|---|---|
| Notion (@notionhq/notion-mcp-server) | 24 | 17,500 | 17,163 | 24,441 | 1,018 |
| Chrome DevTools (chrome-devtools-mcp) | 33 | 7,173 | 6,753 | 9,118 | 276 |
| Playwright (@playwright/mcp) | 25 | 4,589 | 3,940 | 5,614 | 225 |
| GitHub (@modelcontextprotocol/server-github) | 26 | 3,548 | 3,548 | 5,385 | 207 |
| Filesystem (@modelcontextprotocol/server-filesystem) | 14 | 2,879 | 1,693 | 2,642 | 189 |
| Memory (@modelcontextprotocol/server-memory) | 9 | 2,448 | 957 | 1,770 | 197 |
| Context7 (@upstash/context7-mcp) | 2 | 1,131 | 1,064 | 1,759 | 880 |
| Postgres (@modelcontextprotocol/server-postgres) | 1 | 32 | 32 | 543 | 543 |
| 8개 전체 합계 | 134 | 39,286 | 35,136 | 47,800 | 357 |
Claude 공식 토큰은 빈 메시지(8토큰)를 뺀 순수 툴 정의 증가분입니다. 개별 서버 합(51,272)이 8개 전체 합계(47,800)보다 큰 이유는 Anthropic API가 tools 배열이 비어 있지 않을 때 툴 호출용 기본 시스템 프롬프트(약 500토큰)를 한 번만 덧붙이기 때문입니다. 툴이 딱 1개(32토큰)뿐인 Postgres 서버가 Claude에서 543토큰으로 잡힌 것도 이 고정 비용 때문입니다.
표에서 눈에 띄는 지점이 세 가지입니다.
- Notion 하나가 24,441토큰입니다. 툴 수는 24개로 GitHub(26개)나 Playwright(25개)보다 적은데 토큰은 네 배 넘게 씁니다. OpenAPI 명세에서 자동 생성된 중첩 JSON 스키마가 블록·속성 타입 정의를 통째로 끌고 들어오기 때문입니다. 툴 1개당 평균 1,018토큰입니다.
- 툴이 적어도 스키마가 비대하면 무겁습니다. Context7은 툴이 2개뿐인데 Claude 기준 1,759토큰을 씁니다. 툴당 880토큰으로, Memory(9개, 1,770토큰)와 맞먹습니다.
- 하네스가
outputSchema와annotations를 걸러 내지 않으면 추가 누수가 생깁니다. Filesystem은 Raw MCP JSON(2,879토큰)에서name·description·inputSchema만 추려 API 형식으로 바꾸자 1,693토큰으로 41% 줄었고, Memory는 2,448토큰에서 957토큰으로 61% 줄었습니다. 8개 서버 전체로 보면 4,150토큰이 모델 호출에 필요 없는 부가 필드에 묶여 있었습니다.
Notion을 빼더라도 나머지 7개 서버(110개 툴)만으로 Claude 기준 약 23,360토큰이 매 턴 앞단에 붙습니다. "MCP 몇 개 붙였더니 2만 토큰이 사라졌다"는 현장 체감이 과장이 아니었습니다.
다이어트 3종 비교: 설명만 줄여서는 15.6%가 한계입니다
같은 134개 툴에 다이어트 기법 세 가지를 적용해 Claude 공식 토큰 수를 다시 쟀습니다.
| 방식 | 상주 툴 수 | Claude 공식 토큰 | Baseline 대비 절감률 |
|---|---|---|---|
| Baseline (전체 로딩) | 134 | 47,800 | — |
| 기법 3 — 설명·메타 압축만 (134개 유지) | 134 | 40,329 | -15.6% |
| 기법 1 — Allowlist 스코프 축소 | 25 | 8,653 | -81.9% |
| 기법 2 — 지연 로딩 (메타 툴 2개 + 이름 인덱스) | 2 | 1,379 | -97.1% |
가장 의외였던 결과는 기법 3(설명 압축)입니다. 모든 툴의 description을 첫 줄 80자로 자르고, 속성 설명을 60자로 줄였으며, $schema와 additionalProperties도 걷어냈습니다. 그래도 47,800토큰이 40,329토큰으로 15.6% 줄어드는 데 그쳤습니다. Notion처럼 inputSchema의 중첩 구조 자체가 거대한 서버 앞에서는 설명 문구를 아무리 다듬어도 본체가 남기 때문입니다.
70% 이상 줄이려면 기법 1(Allowlist)처럼 애초에 쓰는 툴만 남기거나, 기법 2(지연 로딩)처럼 search_tools와 call_tool 메타 툴 두 개만 띄워 두고 필요할 때만 해당 툴의 스키마를 불러와야 합니다.
Claude Haiku 4.5 15문제 실측: 툴을 덜어내니 정확도가 올랐습니다
토큰을 줄였을 때 정작 툴을 잘못 고르면 의미가 없습니다. 8개 서버를 아우르는 개발 태스크 15개를 만들어 claude-haiku-4-5-20251001(temperature 0)에 세 조건으로 돌렸습니다.
공정한 비교를 위해 15개 중 12개는 Allowlist 안에 있는 핵심 작업, 3개는 Allowlist 밖의 작업(Lighthouse 감사, PR 머지, Notion 댓글 작성)으로 구성했습니다.
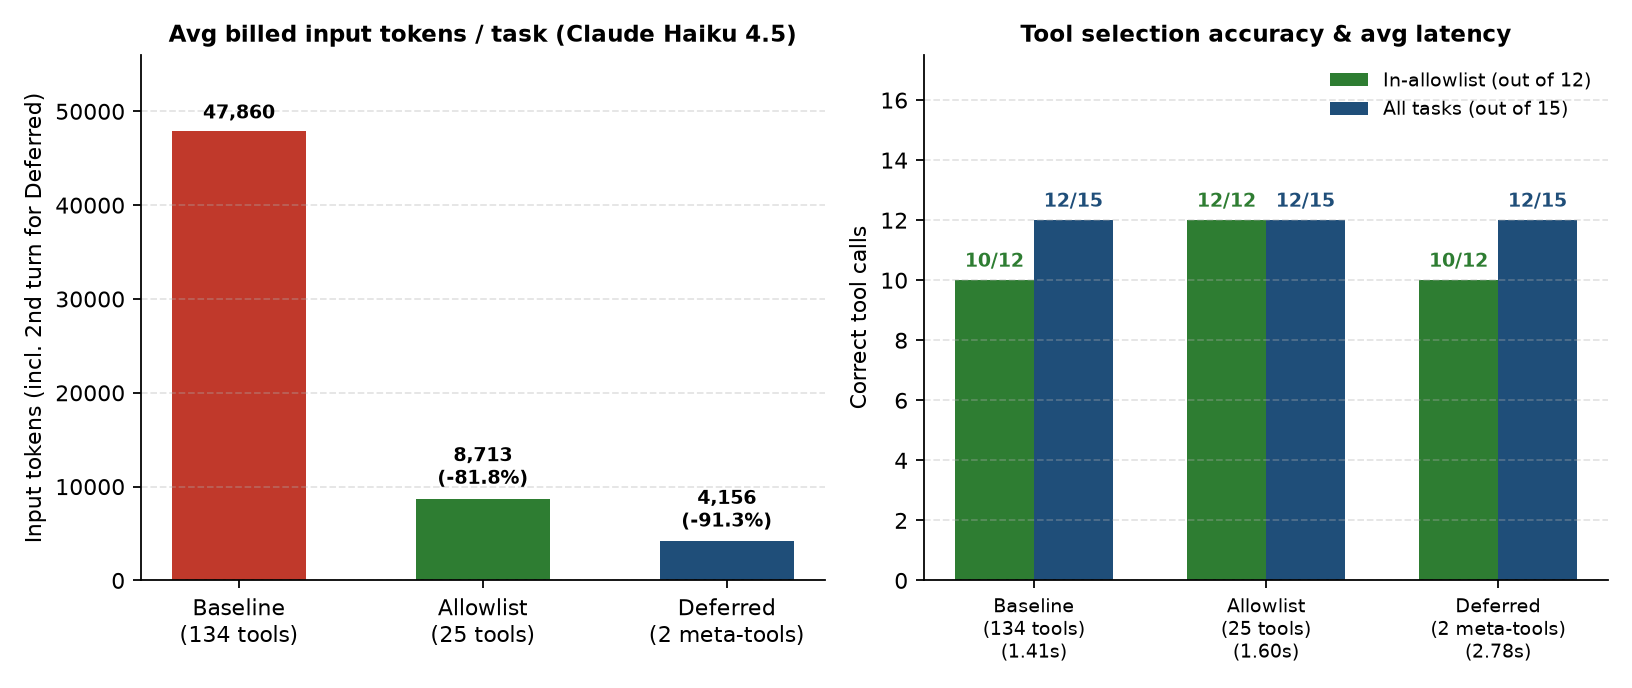
| 조건 | 평균 과금 입력 토큰 | 15문제 총 입력 토큰 | 범위 내 정확도 (12개) | 범위 외 정확도 (3개) | 전체 정확도 (15개) | 평균 응답 시간 | 평균 턴 수 |
|---|---|---|---|---|---|---|---|
| Baseline (134개) | 47,860 | 717,902 | 10 / 12 | 2 / 3 | 12 / 15 | 1.41초 | 1.0 |
| Allowlist (25개) | 8,713 (-81.8%) | 130,697 | 12 / 12 | 0 / 3 | 12 / 15 | 1.60초 | 1.0 |
| Deferred (지연 로딩) | 4,156 (-91.3%) | 62,346 | 10 / 12 | 2 / 3 | 12 / 15 | 2.78초 | 1.8 |
숫자만 보면 세 조건의 전체 정답 수는 12/15로 같지만, 틀린 이유가 완전히 다릅니다.
- Baseline이 틀린 3건은 '과적재 혼선'이었습니다. Playwright로 접근성 스냅샷을 찍으라는 질문(T05)에서, 함께 올라와 있던 Chrome DevTools의
take_snapshot을 대신 호출했습니다. 콘솔 로그 조회(T06)와 Lighthouse 감사(T13)에서도 33개 Chrome DevTools 툴 사이에서list_pages를 먼저 불렀습니다. 134개 툴을 한꺼번에 얹은 비용(47,860토큰)을 치르고도, 오히려 비슷한 이름의 툴끼리 간섭을 일으킨 셈입니다. - Allowlist는 범위 내 12개를 100% 맞혔습니다. 중복·미사용 툴을 걷어내자 T05·T06 혼선이 사라졌고, 15문제 총 입력 토큰도 717,902에서 130,697로 81.8% 줄었습니다. 대신 허용 목록에 없는 3개 작업(T13~T15)에서는 엉뚱한 툴을 지어내지 않고 깔끔하게 호출을 포기(
None)했습니다. Allowlist의 한계가 그대로 드러난 지점입니다. - 지연 로딩은 2턴 왕복을 포함하고도 총 입력 토큰을 91.3% 줄였습니다. 초기 인덱스는 1,379토큰이고,
search_tools로 후보 5개 스키마를 받아온 뒤call_tool을 부르는 두 번째 턴까지 합쳐 작업당 평균 4,156토큰이었습니다. Allowlist 밖 작업인merge_pull_request(T14)와API-create-a-comment(T15)도 찾아내어 맞혔습니다. 다만 대가가 분명합니다. 왕복이 한 번 더 생겨 평균 응답 시간이 1.41초에서 2.78초로 두 배 가까이 늘었고, 단순 키워드 검색이 상위 5개 안에 정답 스키마를 못 넣거나 모델이 검색을 건너뛴 3건(T06, T11, T13)은 실패했습니다.
20턴 코딩 세션에서 실제 청구액 차이
툴 스키마는 매 턴 입력에 반복해서 실립니다. Claude Sonnet 4.5 입력 단가(기본 $3.00/1M, 프롬프트 캐시 쓰기 $3.75/1M, 캐시 읽기 $0.30/1M) 기준으로 20턴 세션 하나에서 오직 빈 툴 스키마 때문에 나가는 비용만 계산하면 다음과 같습니다.
| 방식 | 턴당 스키마 토큰 | 20턴 누적 토큰 | 캐시 미스 시 (세션당) | 캐시 적중 시 (세션당) | 월 100세션 (캐시 미스 / 적중) |
|---|---|---|---|---|---|
| Baseline (134개) | 47,800 | 956,000 | $2.87 | $0.45 | $287 / $45 |
| Compacted (134개) | 40,329 | 806,580 | $2.42 | $0.38 | $242 / $38 |
| Allowlist (25개) | 8,653 | 173,060 | $0.52 | $0.08 | $52 / $8 |
| Deferred 인덱스 (2개) | 1,379 | 27,580 | $0.08 | $0.01 | $8 / $1 |
프롬프트 캐시가 매 턴 완벽히 적중하더라도, Baseline은 사용자 코드나 대화 내용 없이 툴 정의만으로 월 $45를 씁니다. 더 큰 문제는 캐시가 깨지는 순간입니다. 5분 TTL을 넘기거나, 세션 도중 툴 목록이 바뀌거나, 컨텍스트 트리밍이 일어나면 캐시 할인이 풀리면서 세션당 $2.87(월 100세션 기준 $287)을 그대로 물게 됩니다.
바로 적용하는 실전 코드 패턴
실무 하네스에서는 세 단계를 순서대로 적용하는 편이 가장 안전합니다.
1단계: outputSchema·annotations 제거 + 서버별 Allowlist 필터
MCP tools/list 응답을 모델 API로 넘기기 전에 불필요한 필드를 떼어내고, 프로젝트에서 실제로 쓰는 툴만 남깁니다. 이 15줄만으로 이번 실험에서 입력 토큰이 81.8% 줄었고 범위 내 정확도가 12/12로 올랐습니다.
ALLOWLIST = {
    "get_file_contents", "create_or_update_file", "create_pull_request", "list_issues",
    "browser_navigate", "browser_snapshot", "browser_click", "browser_type",
    "read_file", "write_file", "edit_file", "list_directory",
    "query", "API-post-search", "API-retrieve-a-page",
}

def to_lean_anthropic_tools(mcp_tools: list[dict], allow: set[str]) -> list[dict]:
    lean = []
    for t in mcp_tools:
        if t["name"] not in allow:
            continue
        lean.append({
            "name": t["name"],
            "description": t.get("description", ""),
            "input_schema": t.get("inputSchema", {"type": "object", "properties": {}}),
        })
    return lean
2단계: 툴이 30개를 넘어가면 지연 로딩(Deferred Tool Loading)
Allowlist로 못 줄이는 범용 에이전트라면 메타 툴 두 개만 상주시킵니다. 이번 실험에서 키워드 검색만 썼을 때 3건이 빠졌으므로, 실무에서는 server_name.tool_name처럼 서버 접두사를 이름 인덱스에 같이 넣고 상위 5~8개를 돌려주면 검색 누락을 크게 줄일 수 있습니다.
def build_deferred_tools(all_mcp_tools: list[dict]) -> list[dict]:
    index = ", ".join(f"{t['_server']}.{t['name']}" for t in all_mcp_tools)
    return [
        {
            "name": "search_tools",
            "description": f"Load full JSON schemas by keyword. Available: {index}",
            "input_schema": {
                "type": "object",
                "properties": {"query": {"type": "string"}},
                "required": ["query"],
            },
        },
        {
            "name": "call_tool",
            "description": "Call a loaded tool by exact name and JSON arguments.",
            "input_schema": {
                "type": "object",
                "properties": {
                    "name": {"type": "string"},
                    "arguments": {"type": "object"},
                },
                "required": ["name", "arguments"],
            },
        },
    ]
이렇게 적용하겠습니다
- 먼저 내 하네스의 실제 과금 토큰을 잽니다.
tiktoken으로만 어림잡으면 Claude 기준 30% 넘게 과소 추정합니다. Anthropic의 무료/v1/messages/count_tokens로 서버별 비중을 먼저 뽑아 보면, 대부분 1~2개 서버(예: Notion, Chrome DevTools)가 전체의 70% 이상을 차지합니다. - 작업 범위가 정해진 코딩·운영 에이전트는 Allowlist가 최선입니다. 이번 실측에서 1턴 응답 속도(1.60초)를 유지하면서 입력 토큰을 81.8% 줄였고, 중복 툴 간섭까지 없애 정확도(12/12)를 올렸습니다. 특히 Playwright와 Chrome DevTools처럼 기능이 겹치는 MCP는 한 세션에 동시에 올리지 않는 편이 좋습니다.
- 수십 개 서버를 넘나드는 범용 에이전트는 지연 로딩을 씁니다. 총 입력 토큰을 91.3%까지 줄이고 Allowlist 밖 작업도 처리할 수 있지만, 왕복 지연(+1.37초)과 검색 정확도 관리가 따라옵니다. 자주 쓰는 핵심 툴 5~10개는 기본 상주시키고 나머지만 지연 로딩으로 빼는 혼합형이 실무에서는 가장 균형이 좋습니다.
- 설명 압축만 믿지 않습니다. OpenAPI로 자동 생성된 거대 스키마 앞에서는 설명을 잘라내도 15.6%밖에 줄지 않습니다. 툴 수 자체를 줄이거나, 아예
gh·psql같은 경량 CLI 래퍼 하나로 묶는 쪽이 훨씬 효과적입니다.