MoE expert를 절반만 켜는 정수 하나 — batch 1에서는 공짜가 아니었습니다
arXiv:2609.04575의 표 5를 A100 한 장으로 재현하고, 논문에 없는 처리량을 쟀습니다. HF transformers에서는 이득이 없고, 순정 vLLM의 batch 1에서도 없고, batch 8에서 1.35배입니다.
Xing Chen, Hengshuai Yao, arXiv:2609.04575, 2026-09-04 제출. 코드 미공개. 아래 저자 수치는 논문 표 5와 서론에서 가져왔고, 나머지는 모두 2026-09-08에 저희가 직접 돌린 값입니다.
요즘 MoE 모델은 expert가 256개씩 있고 토큰마다 그중 8개만 씁니다. 8개를 고른 다음에는 라우터 확률을 8개 합으로 나눠 1이 되게 만듭니다. 이 재정규화가 이번 논문의 주인공입니다. 저자들의 주장은 이렇습니다. 학습 내내 이 나눗셈이 돌아가기 때문에, 모델은 expert 브랜치의 출력 크기를 "8개로 나눈 값"에 맞춰 익혀 버린다는 것입니다. 그래서 추론 때 8개를 4개로 줄이면 어떤 expert가 켜지는지만 바뀌는 게 아니라 브랜치 전체의 세기까지 달라집니다. 고치는 방법은 정수 하나를 더하는 것입니다. 계산은 상위 k₁개만 하되, 나눌 때는 상위 k₂개의 확률 합으로 나눕니다. 논문 Eq. 2를 그대로 쓰면 i ∈ Top-k₁에 대해 w_i = p_i / Σ_{j ∈ Top-k₂} p_j 이고, 보통의 재정규화는 k₂ = k₁, 재정규화 없음은 k₂ = E(expert 전부)입니다. k₁이 연산량을, k₂가 세기를 정합니다.
이 논문에는 빠진 것이 둘 있습니다. 코드가 없고, 속도를 전혀 재지 않았습니다. 둘 다 우리가 하루면 직접 채울 수 있는 것이었습니다. "routed-expert 연산 절반"은 FLOP 이야기이지 벤치 결과가 아닙니다. 그래서 패치를 직접 쓰고, 정확도 표를 재현하고, 시간을 쟀습니다.
무엇을 돌렸나
모델은 Qwen3.6-35B-A3B입니다. expert 256개, 학습 k=8, 공유 expert 하나는 이 방법과 무관하게 그대로 둡니다. bf16으로 A100 80GB 한 장에 올리면 65.4 GiB를 차지합니다. 저자들은 98GB 가속기를 썼지만 방법 자체가 그걸 요구하지는 않습니다.
패치는 HF transformers 5.16.1의 Qwen3_5MoeTopKRouter에서 메서드 하나를 바꾸는 것이 전부입니다. 상위 k₂개 확률을 뽑고, 그중 앞 k₁개를 활성 집합으로 삼고, k₂개 합으로 나눕니다. k₁=k₂=8이면 원본 라우터와 비트 단위로 같은 값이 나오는 것을 자체 검사로 확인했습니다. k₂=E(256 전부)면 softmax 확률을 그대로 쓰는 "재정규화 없음" 조건이 됩니다.
정확도는 MMLU 5-shot 2,000문항(테스트셋 14,042문항에서 시드를 고정해 추출. 논문도 n=2,000이지만 어떻게 뽑았는지는 적혀 있지 않습니다)과 GSM8K 0-shot 50문항(chat template, thinking 끔, greedy, #### 뒤의 숫자로 채점)입니다. 문항별 정오를 저장해서 저자들과 같은 paired exact McNemar 검정을 돌렸습니다.
속도는 HF transformers에서 batch 1 디코딩을 먼저 재고, 그다음 vLLM 0.28에서 같은 라우팅 규칙을 FusedTopKRouter에 몽키패치해서 쟀습니다. vLLM 쪽은 모델을 만들 때 num_experts_per_tok=k₁로 넣어 커널 버퍼가 작은 k에 맞게 잡히도록 했습니다.
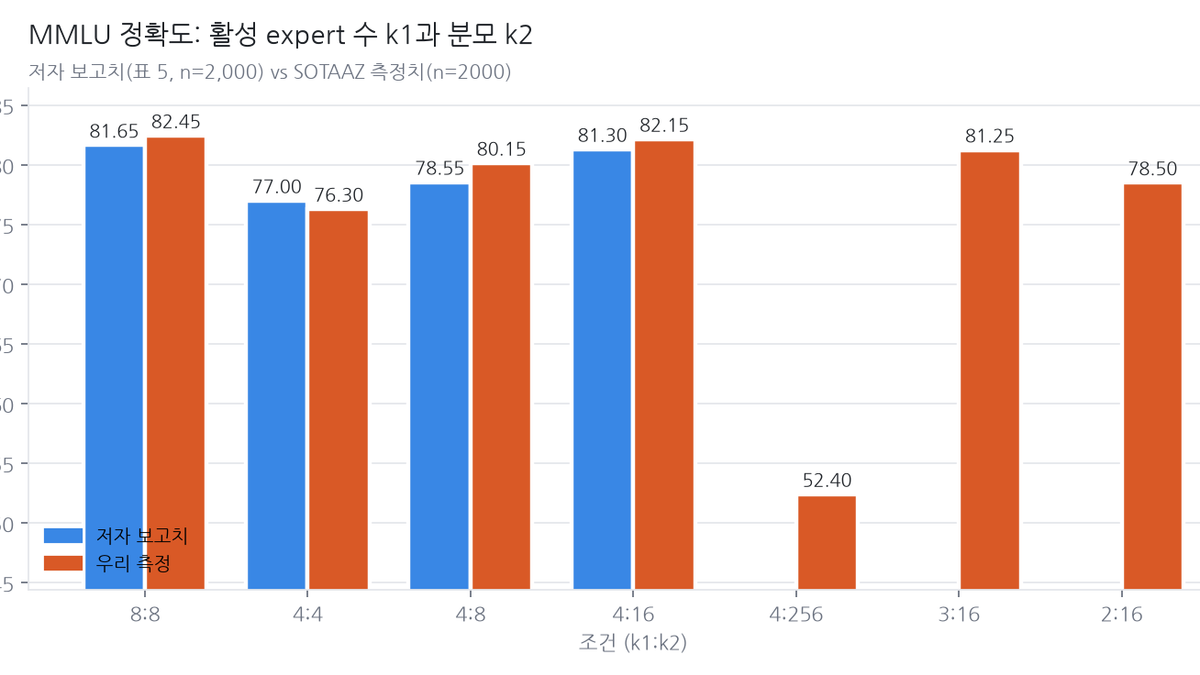
정확도 표는 그대로 재현됩니다
| k₁:k₂ | 저자 MMLU | 우리 MMLU | 8:8 대비 | McNemar p | 우리 GSM8K (n=50) |
|---|---|---|---|---|---|
| 8:8 (원본) | 81.65 | 82.45 | — | — | 84 |
| 4:4 | 77.00 | 76.30 | −6.15 | 2.5e-16 | 78 |
| 4:8 | 78.55 | 80.15 | −2.30 | 9.9e-05 | 82 |
| 4:16 | 81.30 | 82.15 | −0.30 | 0.73 | 86 |
| 4:256 | — | 52.40 | −30.05 | 3.0e-119 | 16 |
저자 수치는 표 5의 Qwen3.6-35B-A3B 행입니다. 문항 집합이 다르므로 절대 수준은 1점 안팎 차이가 나고, 봐야 할 것은 패턴입니다.
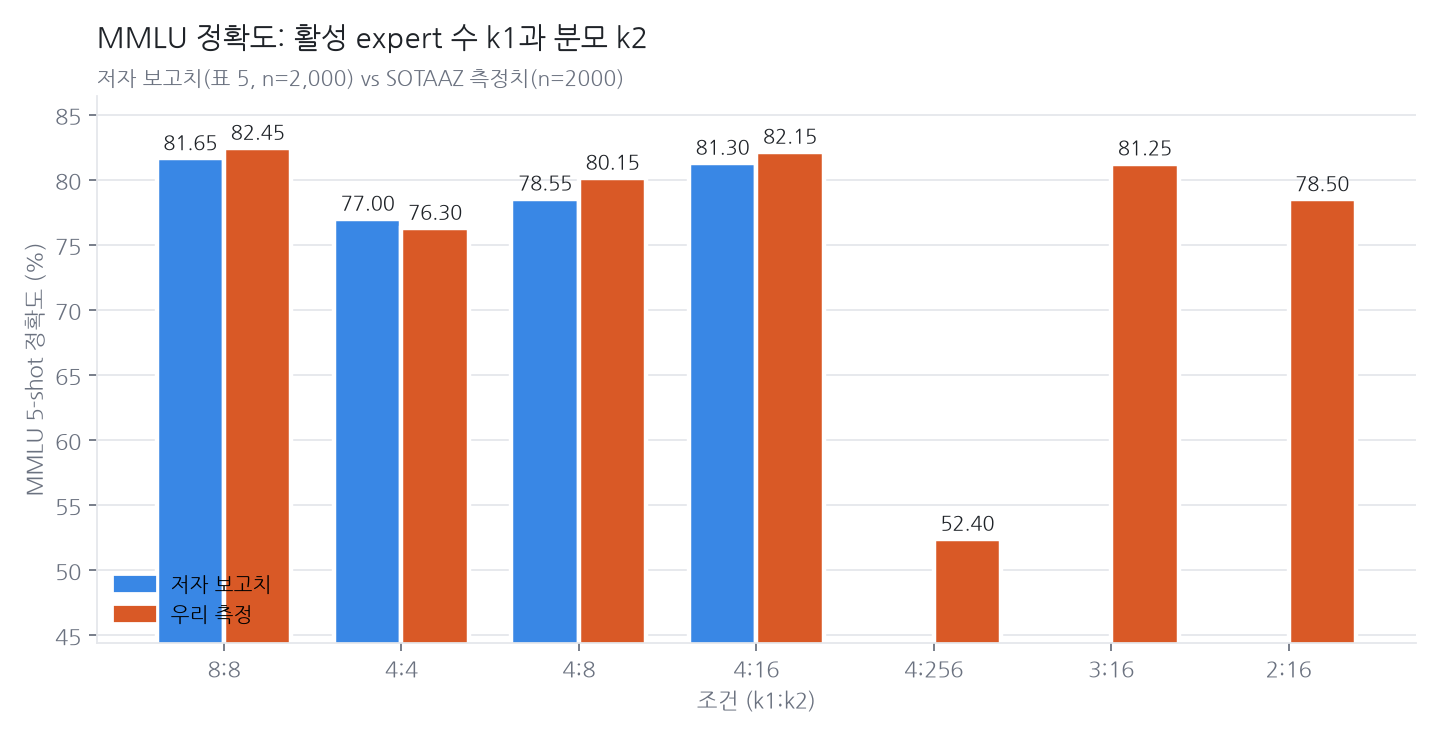
expert를 절반으로 줄이고 보통 방식으로 재정규화하면 우리 문항에서 6.15점이 빠집니다(저자 보고는 4.65점). 분모를 16개 합으로 넓히면 0.30점 차이까지 돌아오고, paired 검정은 둘을 구분하지 못합니다(p=0.73, 저자 보고는 p=0.66). 재정규화를 아예 빼면 30점이 날아갑니다. 저자들도 이 경우를 catastrophic이라 부르며 k₁=6에서 27.45점 하락을 보고했습니다. 모든 행이 논문 수치와 같은 방향, 비슷한 크기로 나왔습니다.
GSM8K는 n=50이라 "k₂=16에서는 무너지지 않고 k₂=256에서는 진짜 무너진다"(기준 정답이던 34문항이 오답으로, 반대는 0건, p=1.2e-10) 이상을 말하기 어렵습니다.
논문이 안 잰 속도
여기가 놀란 지점입니다.
HF transformers에서는 expert를 절반으로 줄여도 아무것도 안 빨라집니다. 조건은 아래 vLLM과 같습니다(512토큰 랜덤 프롬프트, 128토큰 생성, 5회 중앙값). 8개일 때 14.9 tok/s, 4개일 때 15.4 tok/s이고, 그 사이 모든 조건이 14.5에서 15.4 사이에 들어옵니다. batch 1에서 병목은 expert 루프가 아닙니다. Gated DeltaNet 층, 파이썬 디스패치, expert가 아닌 모든 것의 메모리 트래픽이 병목입니다. transformers로 이 방법을 재면 "지연에는 효과 없음"이라는 결론이 나옵니다. 그 결론은 틀렸습니다. 방법이 아니라 런타임 때문에 그렇게 보이는 것입니다.
vLLM에서는 batch 8에 이득이 있고, batch 1에는 없습니다. A100 한 장, 512토큰 랜덤 프롬프트, 128토큰 생성, 7회 중앙값의 디코딩 처리량입니다. 기준이 둘입니다. 지금 실제로 쓰는 순정 vLLM, 그리고 같은 라우팅 규칙을 k=8 그대로 파이썬 패치로 돌린 것. 후자는 패치 자체의 비용을 빼고 방법만 보기 위한 기준입니다.
| k₁:k₂ | batch 1 | batch 8 | batch 32 | 순정 대비 (b1 / b8 / b32) | 패치 8:8 대비 |
|---|---|---|---|---|---|
| 순정 vLLM (패치 없음) | 148.6 | 523 | 1,387 | 1.00 / 1.00 / 1.00 | — |
| 8:8 패치 | 134.5 | 487 | 1,342 | 0.90 / 0.93 / 0.97 | 1.00 / 1.00 / 1.00 |
| 4:4 | 149.0 | 672 | 1,651 | 1.00 / 1.29 / 1.19 | 1.11 / 1.38 / 1.23 |
| 4:16 | 147.7 | 706 | 1,938 | 0.99 / 1.35 / 1.40 | 1.10 / 1.45 / 1.44 |
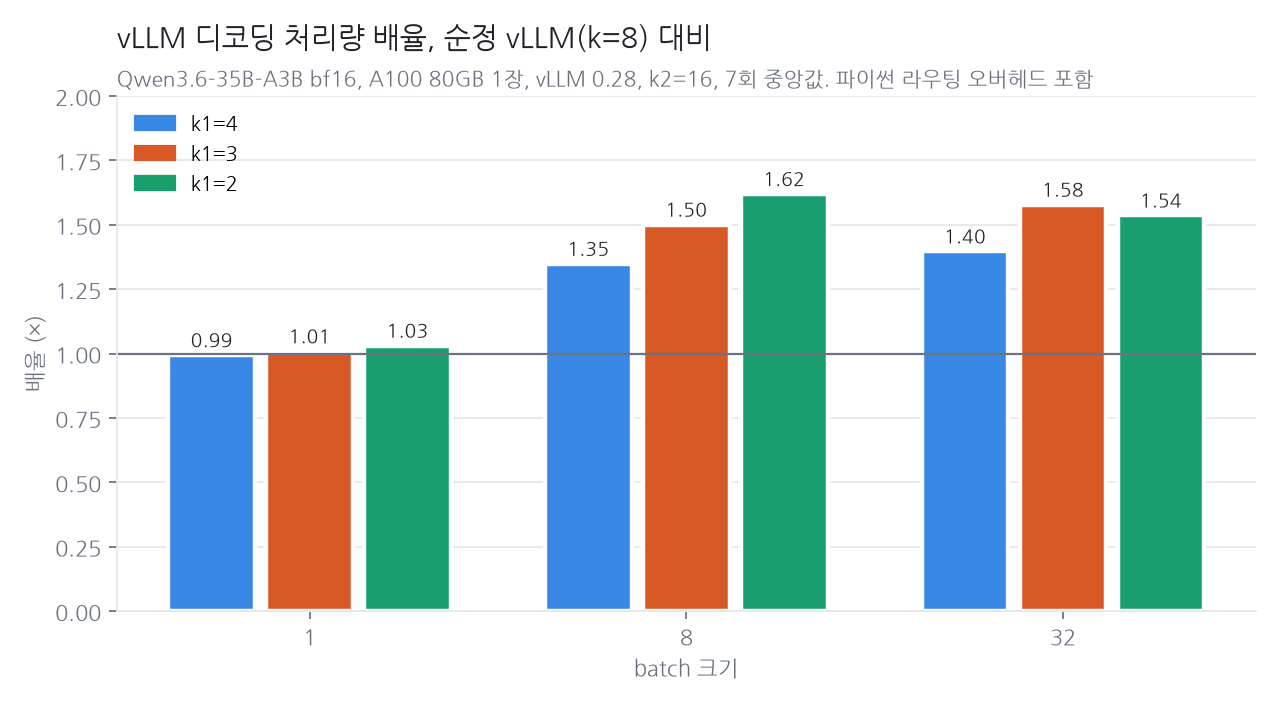
두 배율 열을 같이 읽으셔야 합니다. 패치 기준으로는 expert 절반이 batch 1에서 1.10배입니다. 구현 비용을 빼고 본 방법 자체의 값입니다. 그런데 실제로 쓰는 vLLM 기준으로는 0.99배입니다. 우리 라우팅은 vLLM의 fused top-k 커널이 아니라 파이썬에서 돌고, 그 비용이 batch 1에서 9.5%인데, expert를 절반으로 줄여 버는 것이 딱 그만큼입니다. batch 1 디코딩은 메모리 대역폭에 묶여 있고 이 하이브리드 구조에서 expert 가중치는 토큰당 읽는 양의 일부라, 애초에 얻을 것이 많지 않았습니다. 임시 코드의 오버헤드는 배치가 커질수록 줄어들어(batch 1, 8, 32에서 9.5%, 7.0%, 3.2%), batch 8에서는 순정 대비 1.35배, 패치 대비 1.45배가 나옵니다. 두 숫자가 가까운 것은 이제 expert 행렬곱이 비중을 갖기 때문입니다.
표에는 예상 못 한 것이 하나 더 있습니다. batch 32에서 4:4와 4:16이 같은 커널을 돌리는데도 17% 차이가 납니다(1,651 대 1,938 tok/s). 상위 k₁ 선택은 k₂와 전혀 무관하고 가중치만 달라지므로, 같은 입력이면 라우팅도 같습니다. prefill 시간이 그걸 확인해 줍니다(638 대 639 ms). 디코딩 차이는 생성된 텍스트가 갈라지는 데서만 올 수 있고, fused MoE 커널의 비용은 배치 안의 토큰이 expert에 얼마나 퍼지는지에 따라 달라집니다. 이 교란은 batch 32만이 아니라 batch 8에도 있고 크기만 작으니, 두 열 모두 대략의 범위로 보셔야 합니다. 깔끔한 해결은 모든 조건에 같은 토큰 열을 강제로 먹이는 것인데, 아직 안 했습니다.
vLLM 수치를 검산하는 방법이 하나 있습니다. k₂는 분모만 바꾸니 텍스트 발산이 거의 없는 batch 1에서는 4:4, 4:16, 4:256의 속도가 같아야 합니다. 실제로 1% 안에서 같았습니다(147.7 대 149.0 tok/s). k₂=256 칸만 136.4로 느린데, 임시 코드가 그 조건에서는 256개 확률을 전부 정렬하기 때문입니다.
예상 밖 지점
돌리기 전에 예상을 적어 두었습니다. batch 1 이득은 2배 미만, 1.2에서 1.7배 사이라고 썼는데 실측은 패치 기준 1.10배, 순정 기준 0.99배로 어느 쪽이든 예상 범위보다 낮았습니다. GSM8K가 MMLU보다 더 떨어질 것이라고 썼는데 n=50에서는 보이지 않았습니다. k₂=16인 모든 조건이 기준과 같았습니다. 양자화와 k₂의 간섭은 돌리기 전에 가설에서 뺐습니다. 모델이 bf16으로 80GB 카드에 들어가는데 교란 변수를 일부러 넣을 이유가 없었습니다. 진짜 놀란 것은 transformers 결과였습니다. 이득이 0이었습니다. 프레임워크가 FLOP 절감의 일부라도 보여 줄 거라고 생각했는데 전혀 보여 주지 않았습니다.
월요일에 바꿀 것
Qwen3.6-35B-A3B를 vLLM으로 서빙하면서 배치 구간에서 처리량에 묶여 있다면, k₁=4에 k₂=16은 순정 vLLM 대비 batch 8에서 1.35배(패치 기준 1.45배)를 줍니다. MMLU에서 paired 검정이 원본과 구분하지 못하는 변경입니다. batch 1에서는 파이썬 라우터로는 아무것도 얻지 못하고, 아직 없는 fused 커널이 있어야 10%쯤 얻습니다. 안 해 본 것이 둘 있습니다. 긴 생성(저자들도 미검증으로 적었습니다)과 Qwen3.x 밖의 모델입니다. 두 번째는 다음 날 바로 돌렸는데, 결과가 꽤 다르게 나옵니다. 다음 글에 적었습니다.
약점
MMLU는 시드 하나로 뽑은 부분집합이고 저자의 집합이 아닙니다. GSM8K는 n=50, 프롬프트 형식은 우리 것이고 thinking을 껐습니다. 논문은 GSM8K 형식을 명시하지 않았습니다. 속도는 512토큰 랜덤 프롬프트에 128토큰 생성, 7회 중앙값으로 쟀고 실제 프롬프트는 KV 트래픽이 다릅니다. vLLM 패치는 fused 커널이 아니라 연구용 임시 코드이고, 그 비용이 보이도록 순정 엔진과 패치 기준 두 배율을 다 적었습니다. GPU 한 장, 모델 한 계열이며, batch 8·32의 조건별 생성 텍스트 발산은 해결하지 않았습니다.
패치, 평가 스크립트, vLLM 스크립트, 원시 결과 JSONL, 차트 스크립트는 리포의 drafts/moe-k2-*에 있습니다. 시드는 전부 0입니다.
다음 글을 메일로 받으시려면 아래 폼을 쓰시면 됩니다.