로컬 GPU 하나에 OpenMausBot 봇 여러 개: 메시지가 기다리는 세 곳
로컬 Qwen 서버 하나(슬롯 2개)에 OpenMausBot 봇을 최대 8개까지 붙여 보았습니다. 봇은 Local VM 봇이 턴 내내 잡는 공유 데스크톱을 기다리고, 프롬프트를 하나씩 읽는 엔진을 기다리며, 봇이 셋 이상이면 메시지마다 약 32,000토큰을 다시 읽습니다.
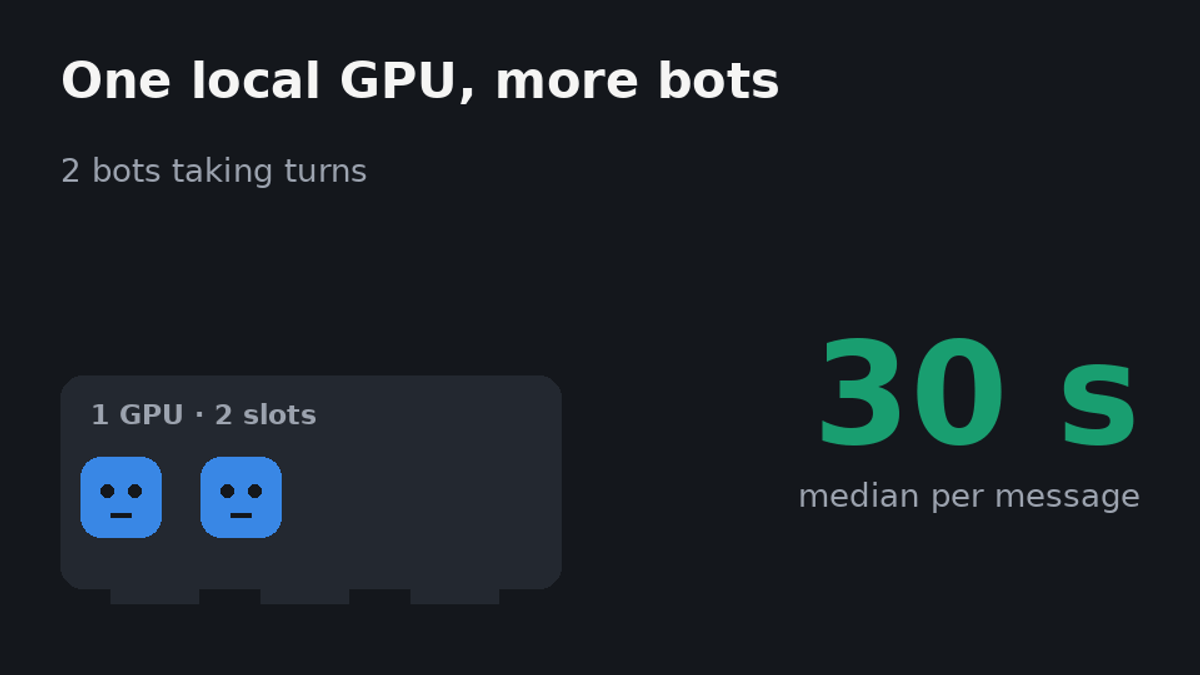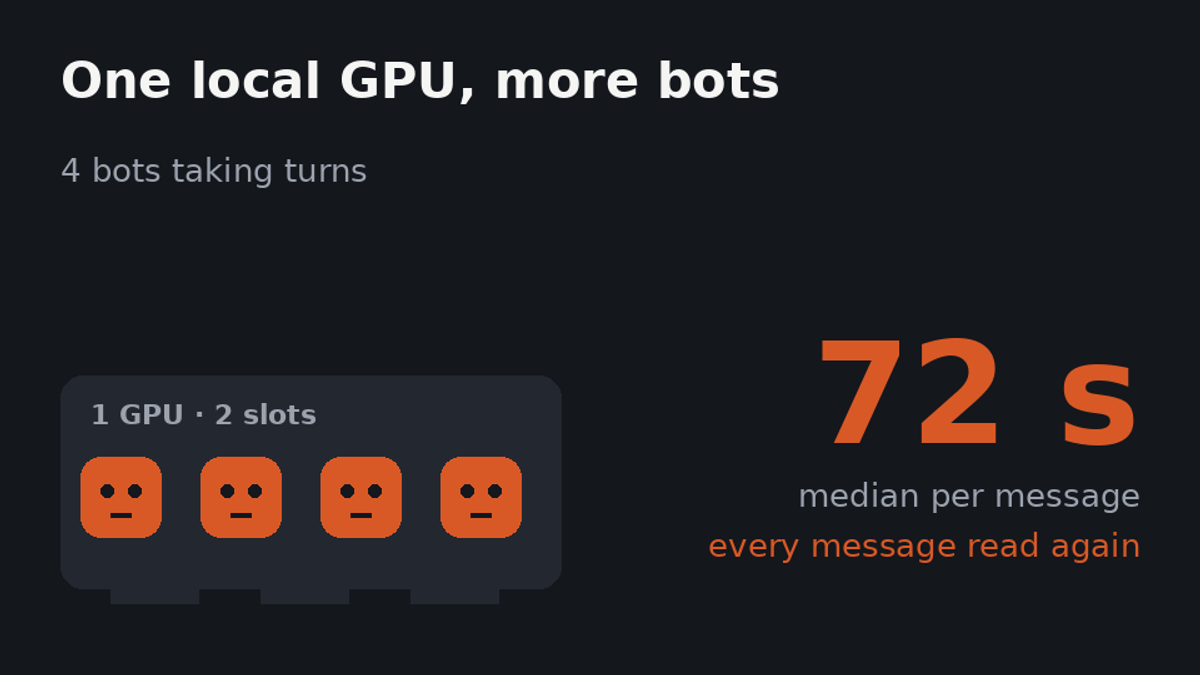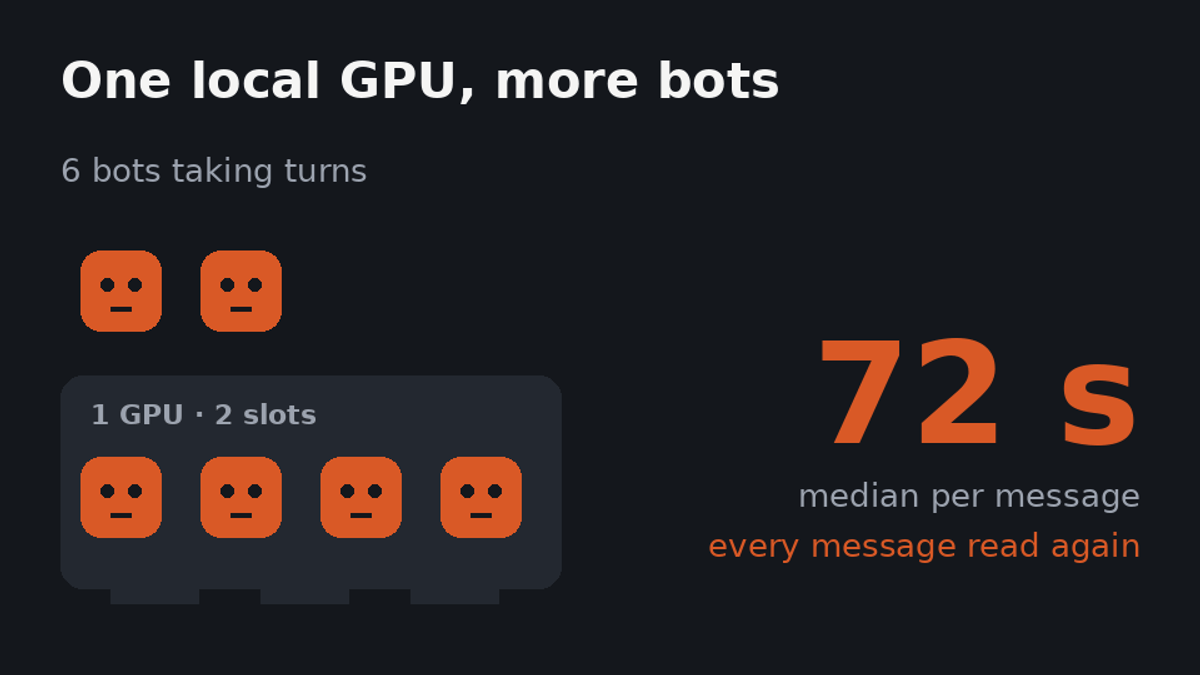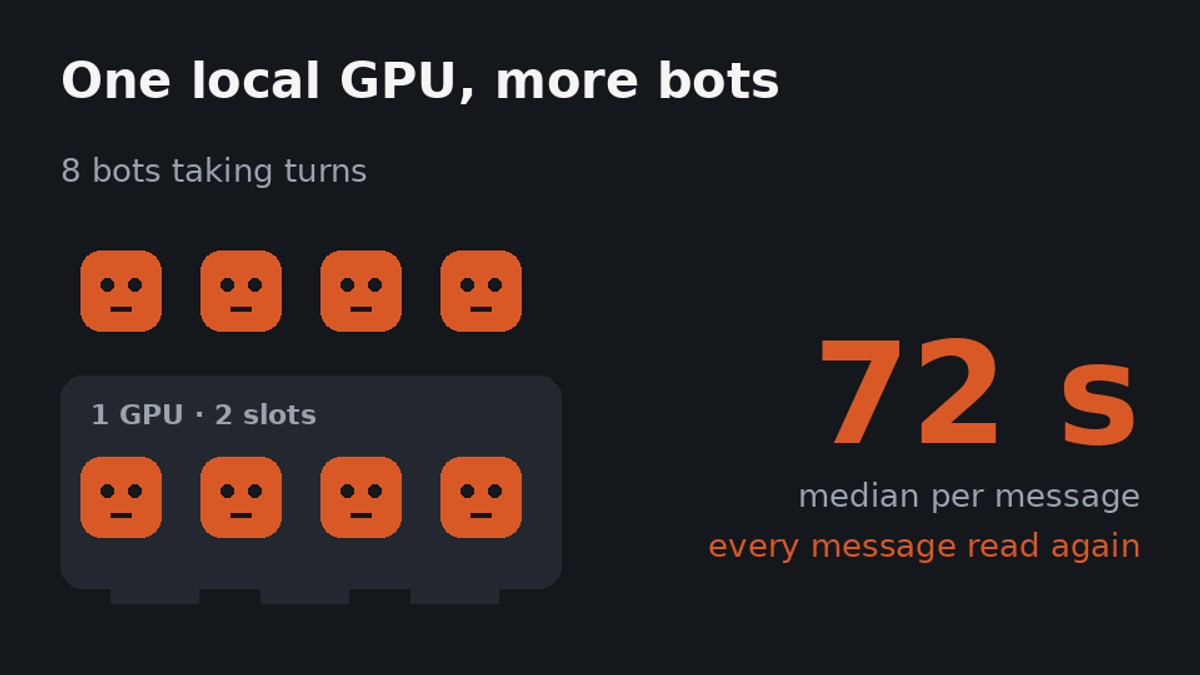
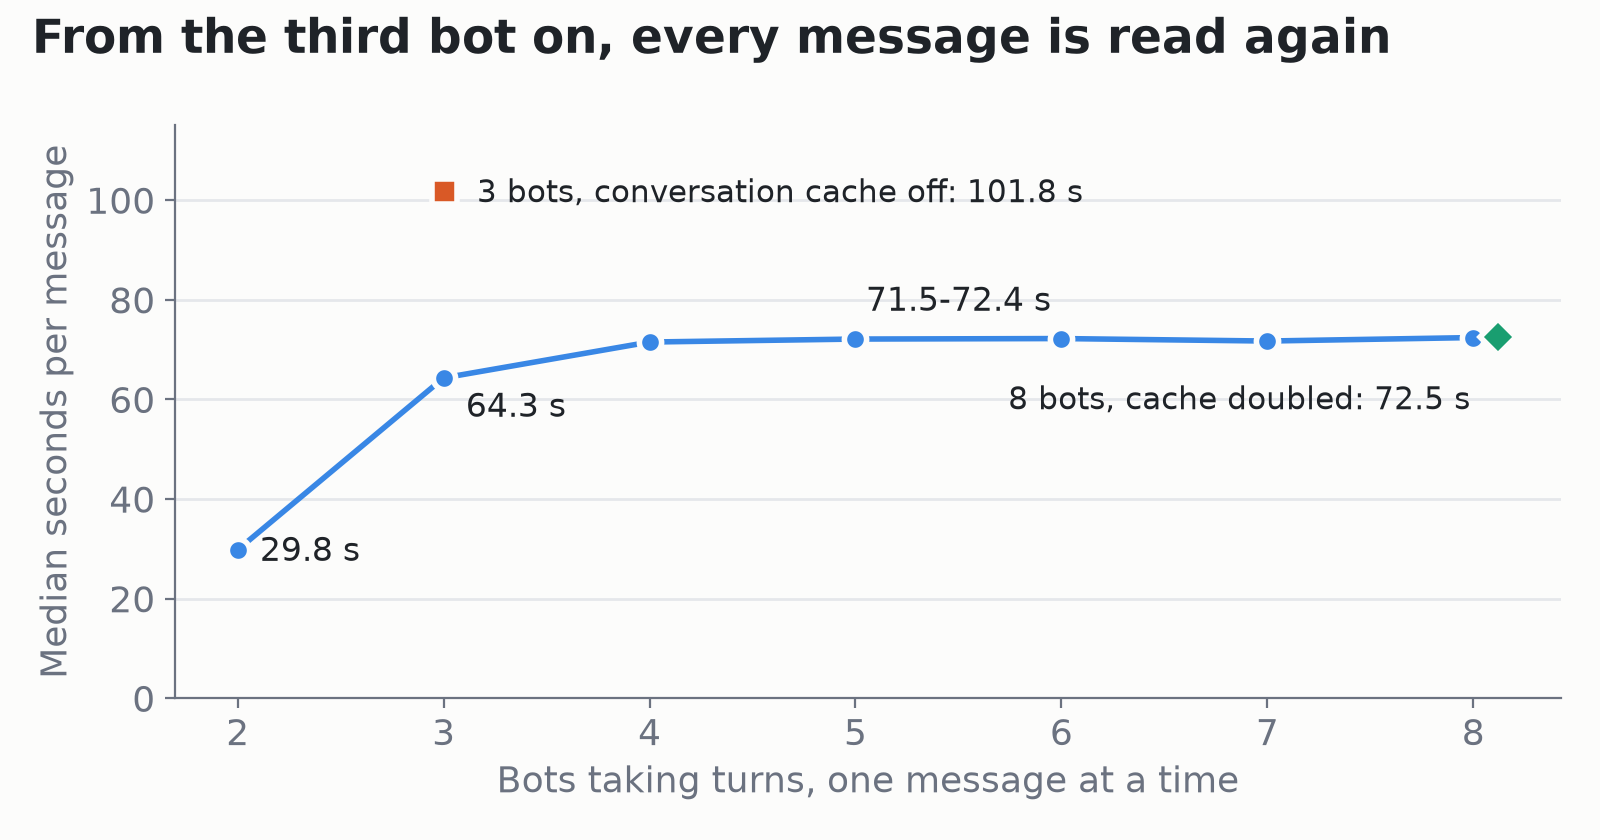
로컬 Qwen 서버 하나에서 봇 둘이 번갈아 한 줄짜리 질문에 답할 때는 메시지 하나에 중앙값 29.8초가 걸렸습니다. 봇을 하나 더 넣자 같은 질문이 64.3초로 늘었습니다. 봇이 넷에서 여덟일 때는 약 72초에서 멈췄고, 대화 캐시를 두 배로 늘려도 내려오지 않았습니다. 질문은 그대로였습니다. 달라진 것은 셋째 봇부터 엔진이 메시지마다 봇 프롬프트의 약 32,000토큰을 다시 읽었다는 점입니다.
이것이 OpenMausBot 봇 여러 개가 GPU 하나를 나눠 쓸 때 저희가 찾은 대기 세 가지 가운데 가장 큰 것입니다. 1편에서는 봇 둘에게 동시에 메시지를 보냈더니 66.0초와 131.2초에 답이 왔고, 저희는 앱이 줄을 세운다고 짐작했습니다. 앱 전체에 대기열이 있지는 않았습니다. 컴퓨터를 지정하지 않은 봇들은 모두 1-3초 안에 턴을 시작했습니다. 봇이 기다린 곳은 세 군데였습니다. Local VM 봇이 턴 내내 붙잡는 공유 데스크톱(1편의 두 봇이 줄을 선 곳), 긴 프롬프트를 한 번에 하나씩 읽는 엔진, 봇이 셋 이상 번갈아 말하면 소용이 없어지는 대화 캐시입니다.
실험 환경
환경은 1편과 같습니다.
- OpenMausBot 0.1.138을 npm으로 호스트에 설치했습니다.
- Strata 0.1.55를 Docker로 띄워 Qwen3.8-Flash-Next IQ2_XS를 128K 컨텍스트로 서빙했습니다. GPU는 A100 80GB 한 장이고, 메모리 설정은 1편과 같습니다(
vram-reserve-mib=71300, Strata에 약 10.4GiB를 남김). Strata 프로세스가 실제로 쓴 GPU 메모리는 약 10GiB였습니다. 아래 시간은 모두 A100에서 잰 값입니다. PARALLEL=2로 슬롯을 두 개 두었습니다. 대화 두 개가 GPU 메모리에 함께 올라가 같이 답을 생성할 수 있다는 뜻입니다.- 대화 캐시는 8,192MiB에 자리 4개입니다. 끝난 대화를 시스템 RAM에 보관해 두고, 다음 턴에서 전부 다시 읽지 않게 하는 장치입니다.
뒤의 결과를 이해하려면 숫자 하나를 먼저 알아야 합니다. 봇이 한마디라도 하기 전에 OpenMausBot은 모델에 약 51,000토큰을 보냅니다. 봇 설명과 도구 설명이 들어 있고, Local VM이 켜져 있어서 데스크톱 도구 설명까지 붙습니다. 저희 질문의 답은 한 문장입니다. 그러니 메시지 하나에 드는 일은 거의 전부 엔진이 프롬프트를 읽는 일이고, 가장 빠른 메시지는 엔진이 이미 읽어 둔 프롬프트로 시작하는 메시지입니다.
실험은 네 가지이고, 모두 세 번씩 반복했습니다.
- 동시에 보내기. 봇 1-4개에게 "Reply with one short sentence: what is 7 times 4?" 같은 한 줄 질문(숫자는 매번 다름)을 한꺼번에 보냈습니다.
- 번갈아 보내기. 봇 2-8개에게 같은 질문을 한 봇씩 차례로 세 바퀴 보냈습니다. 사람이 채팅방 몇 개를 돌며 말을 거는 상황입니다. 첫 바퀴는 준비 단계로 보고 둘째·셋째 바퀴만 셉니다.
- 공유 데스크톱. Local VM이 지정된 봇 둘에게 같은 순간 파일 과제를 주었습니다. 과제는 "home 폴더에 v1_shared_r1.txt 파일을 만들고 hello from v1_shared_r1, 391 한 줄만 넣으라"는 것입니다. 모든 봇이 데스크톱 하나를 함께 쓰는 설정과 봇마다 데스크톱을 따로 두는 설정에서 각각 돌렸고, 성공 여부는 봇의 답이 아니라 컨테이너 안 파일을 저희가 직접 열어 판정했습니다.
- 데스크톱 봇에게 한 줄 질문. 실험 1의 한 줄 질문을 실험 3의 두 봇에게 보냈습니다.
실험 1·2의 봇에는 컴퓨터를 따로 지정하지 않았습니다. 그래도 OpenMausBot이 켜져 있는 Local VM의 도구를 붙였기 때문에 프롬프트가 51,000토큰이 되었습니다. 다만 한 줄 질문에는 데스크톱을 건드리지 않았습니다.
첫째 대기: 봇 하나가 턴 내내 공유 데스크톱을 잡습니다
기본 설정에서는 Local VM을 쓰는 봇이 모두 데스크톱 하나를 함께 씁니다. 이런 봇 둘에게 같은 순간 파일 과제를 주자, 둘째 봇은 첫째 봇의 턴이 끝날 때까지 일을 시작하지 않았습니다. 앱 화면에는 "Waiting for its turn on this computer — 1st in queue — V2 is running"이 떴다가 "Computer free — continuing after waiting"으로 바뀌었습니다.
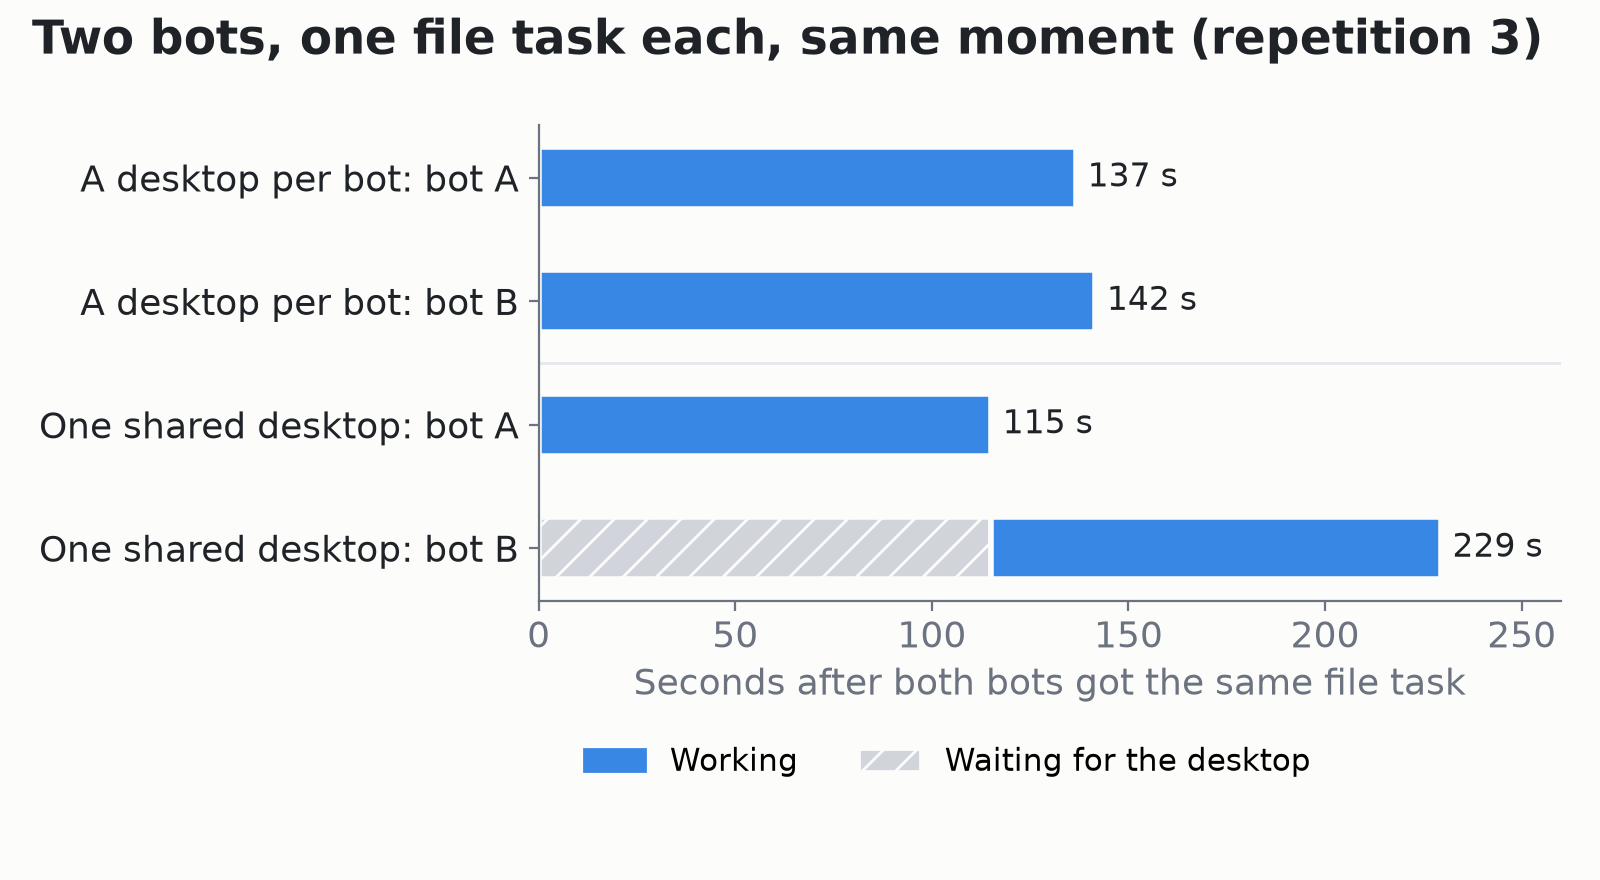
세 번 모두 기다린 봇은 상대 봇의 턴 전체만큼 기다렸습니다. 106초, 17초, 115초였습니다. 파일은 매번 둘 다 정확했고, 서로의 파일을 덮어쓰지도 않았습니다. 봇마다 데스크톱을 따로 두었을 때는 두 봇이 나란히 일했고, 둘째·셋째 반복에서 10초 안팎 차이로 함께 끝났습니다. 봇별 데스크톱 컨테이너 하나가 이 과제에서 쓴 RAM은 최대 약 0.2GiB였습니다.
이 대기는 앱이 데스크톱을 잡는 방식에서 나옵니다. 0.1.138의 dist-server/server/index.js를 읽어 보면, 컴퓨터를 Local VM으로 지정한 봇은 메시지에 데스크톱이 필요하든 아니든 턴을 시작할 때 데스크톱을 잡고 턴이 끝나야 놓습니다. 컴퓨터를 지정하지 않은 봇은 처음 화면 도구를 부를 때 잡습니다. 1편의 두 봇 Flash와 Flash2는 둘 다 Local VM이 지정되어 있었으므로, 둘째 턴이 첫째 턴이 끝나고 1.3초 뒤에 시작한 모습과 맞습니다.
실험 1의 한 줄 질문을 이 두 봇에게 같은 순간 보내 직접 확인했습니다. 데스크톱이 전혀 필요 없는 질문인데도, 세 번 모두 둘째 봇에게 같은 "Waiting for its turn on this computer" 문구가 떴습니다. 둘째 봇은 상대 봇의 턴 전체(95초, 35초, 44초)를 기다린 뒤 159초, 44초, 52초에 답했습니다.
봇마다 데스크톱을 두는 설정에서는 실패가 한 번 있었습니다. 첫 반복에서는 두 봇 모두 아직 데스크톱이 없었는데, 앱은 새 데스크톱을 한 번에 하나만 만듭니다. 둘째 봇은 기다리지 않고 3초 만에 "Create the Local VM (App Settings → Computers)"라는 오류로 끝났습니다. 코드도 이 동작과 맞습니다(데스크톱 만들기를 플래그 하나로 막고, 플래그를 못 잡은 턴은 "missing" 상태를 받습니다). 다음 반복에서 둘째 봇의 데스크톱이 만들어졌고 두 봇 모두 성공했습니다.
둘째 대기: 엔진은 프롬프트를 하나씩 읽습니다
데스크톱을 잡지 않는 봇끼리는 앱에서 서로 기다리지 않습니다. 메시지를 보내고 1-3초 안에 모든 봇의 턴이 시작했습니다. 그래서 슬롯이 둘이면 봇 둘도 봇 하나만큼 빨리 끝날 것이라고 예상했는데, 그렇지 않았습니다.
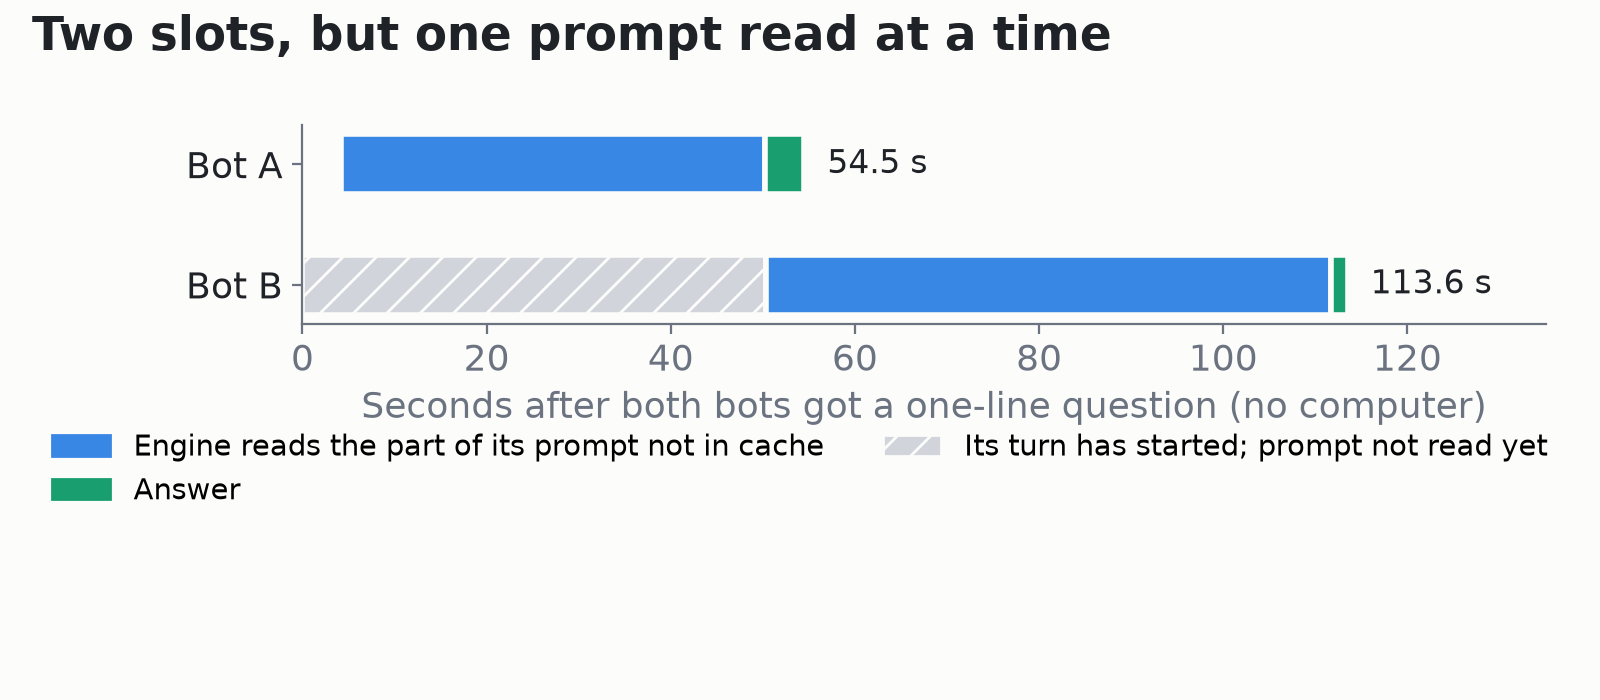
봇 하나에게만 보냈을 때는 46-74초가 걸렸습니다. 둘을 동시에 보냈을 때 늦게 끝난 봇은 세 반복에서 42.8초부터 113.6초까지였고, 매번 전체 시간의 88-95%를 엔진이 프롬프트 읽기에 썼습니다. 봇이 셋, 넷일 때도 83-94%였습니다. 답을 만드는 데는 몇 초면 충분했습니다.
Strata의 배칭 문서가 이 모양을 설명합니다. 새로 들어온 긴 프롬프트는 한 번에 하나씩 받아서 차례로 읽습니다. 슬롯 두 개 덕분에 두 대화가 답을 함께 생성할 수 있고, 엔진은 긴 프롬프트를 읽다가 더 짧은 요청이 기다리면 잠시 비켜 주기도 합니다. 하지만 답이 한 문장이면 함께 생성할 것이 거의 없습니다. 일의 대부분이 긴 프롬프트를 읽는 일이면, 슬롯이 둘이어도 봇 둘이 봇 하나를 두 번 돌리는 것보다 빨라지지 않습니다.
셋째 대기: 셋째 봇부터 메시지마다 다시 읽습니다
이 환경에서 51,000토큰을 처음부터 읽으면 약 90초가 걸리므로, 대화 캐시가 가장 중요합니다. 봇 둘이 번갈아 말할 때는 캐시가 제대로 작동했습니다. 매 메시지가 약 37,000토큰 지점에 저장해 둔 상태에서 이어졌고, 엔진은 새 토큰 14,000-15,000개만 읽었습니다.
| 번갈아 말하는 봇 | 프롬프트를 다시 읽은 메시지 | 메시지당 중앙값 |
|---|---|---|
| 2 | 12개 중 0개 | 29.8초 |
| 3 | 18개 중 18개 | 64.3초 |
| 4-8 | 전부 | 71.5-72.4초 |
| 3, 캐시 끔 | 18개 중 18개 | 101.8초 |
| 8, 캐시 16,384MiB·자리 8개 | 48개 중 48개 | 72.5초 |
봇이 셋 이상이면 메시지마다 약 32,000토큰을 다시 읽었습니다. 그래도 캐시가 조금은 도왔습니다. 프롬프트 앞부분은 모든 봇이 같아서, 엔진이 보관된 다른 대화에서 앞 17,000-19,000토큰을 빌려 왔기 때문입니다. 봇 셋일 때 캐시를 켜면 64.3초, 끄면 101.8초였던 차이가 여기서 나옵니다.
캐시가 소용없어진 것은 다음 차례 봇의 대화가 먼저 밀려나기 때문으로 보입니다. 봇의 요청은 메시지 하나로 끝나지 않습니다. OpenMausBot은 턴마다 작은 부가 요청도 보내고, 이것들도 하나하나 캐시에 보관됩니다. 같은 봇의 두 턴 사이에 보관된 대화 수의 중앙값은 봇 둘일 때 1개, 셋일 때 6개, 넷일 때 9개, 여덟일 때 42개였습니다. 자리는 4개이고 가장 오래된 것부터 밀려나므로, 다음 차례인 봇의 대화가 가장 먼저 밀려나는 쪽에 들게 됩니다. 봇 여덟에서 자리를 8개로 늘려도 두 턴 사이에 21개가 보관되었고, 메시지는 전부 다시 읽혔습니다.
메시지당 시간을 가장 크게 좌우하는 것은 프롬프트 길이입니다. 데스크톱을 봇별로 둔 봇 여섯 개 실행에서는, 컴퓨터를 지정하지 않은 봇에게 데스크톱 도구가 붙지 않았고 프롬프트가 약 20,000토큰으로 줄었습니다. 이때도 메시지마다 다시 읽었지만 중앙값은 약 72초가 아니라 약 41초였습니다.
GPU 하나에 봇 여러 개를 둔다면
GPU 하나에서 데스크톱이 필요한 봇이 여럿이라면, 저희는 봇마다 데스크톱을 따로 주고 일을 맡기기 전에 하나씩 미리 만들어 두겠습니다. 저희 실행에서는 이렇게 하면 가장 긴 대기, 즉 다른 봇의 턴 전체를 가만히 기다리는 시간이 사라졌고, 비용은 데스크톱 하나에 RAM 약 0.2GiB였습니다. 미리 만들어 두면 저희가 본 한 번의 실패도 피할 수 있습니다.
다음 편에서는 OpenMausBot을 인터넷에서 끊고 어떤 일이 여전히 되는지 보겠습니다. 글이 나오면 아래 뉴스레터로 알려 드립니다.
주간 뉴스레터에 새 글 링크를 담아 보냅니다. 메일은 영어로 발송됩니다.