실험 기록을 넣으면 논문이 나올까요? PaperOrchestra로 직접 만들어 봤습니다
공식 논문 작성 코드를 로컬 모델에 연결해 PDF를 만들었습니다. 파일은 완성됐지만 숫자 하나가 바뀌고 참고문헌 두 곳이 연결되지 않았습니다. 입력 기록과 실제 원고를 대조했습니다.
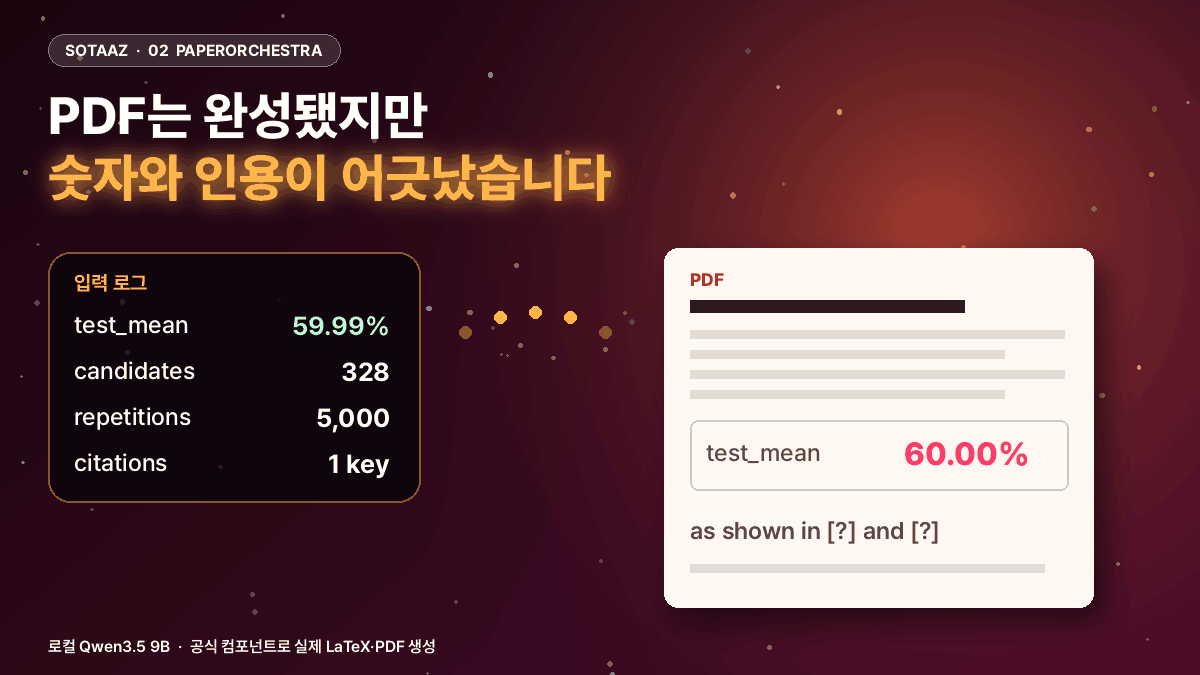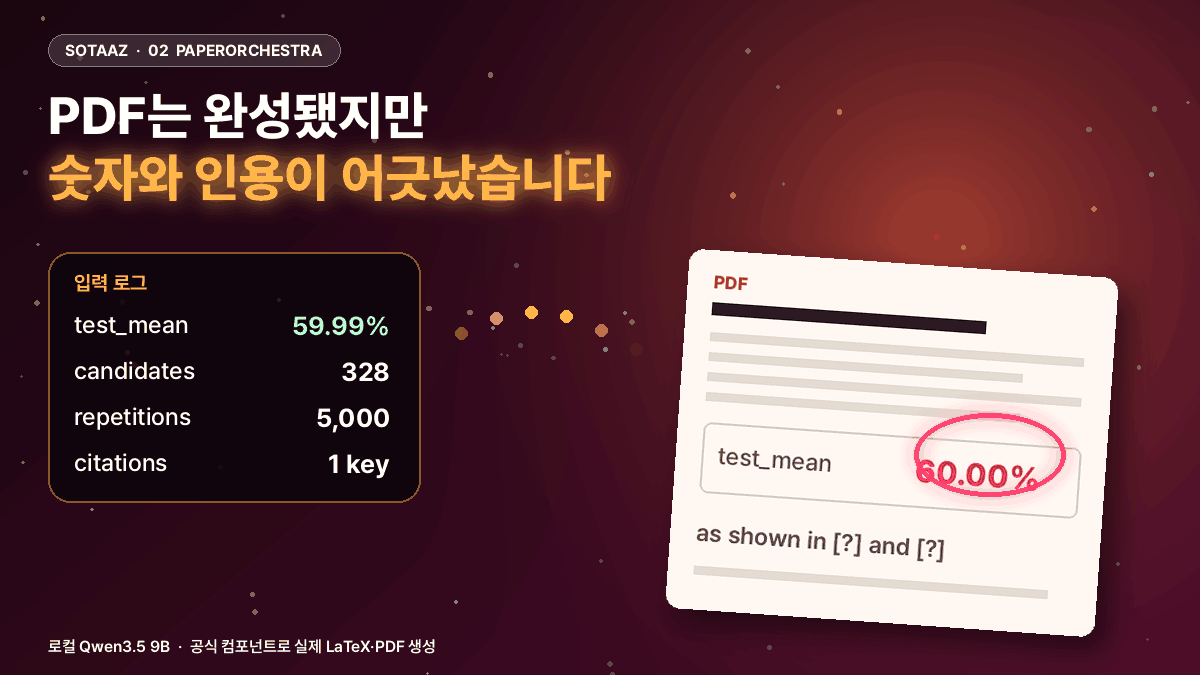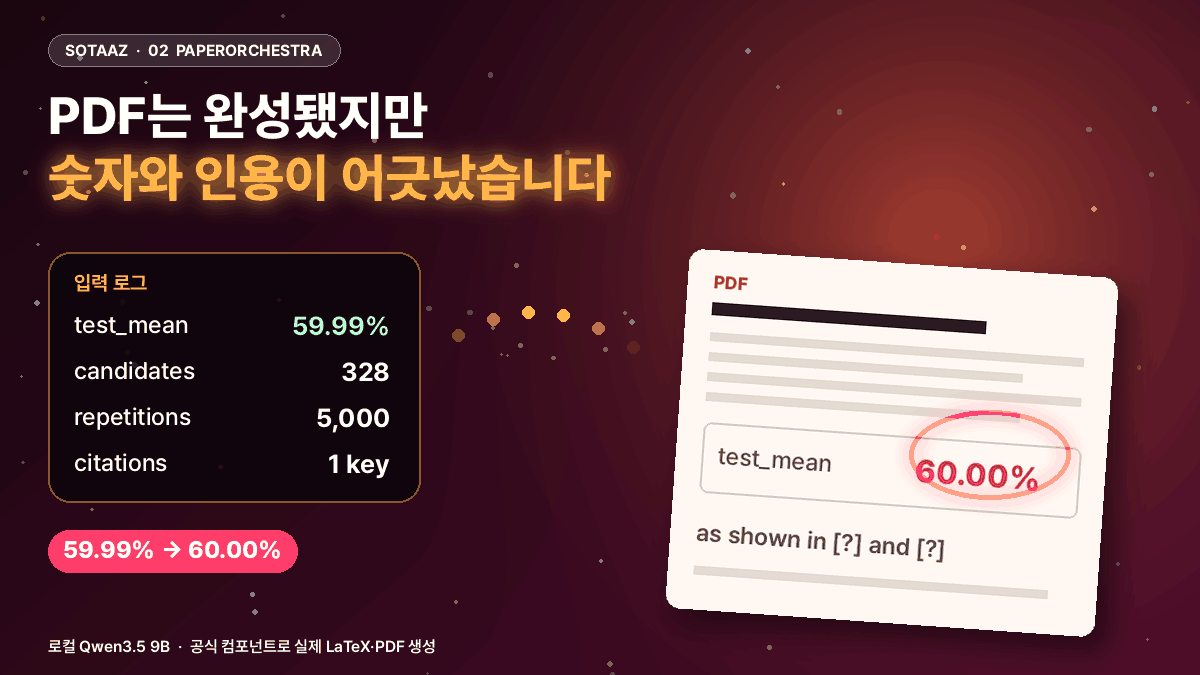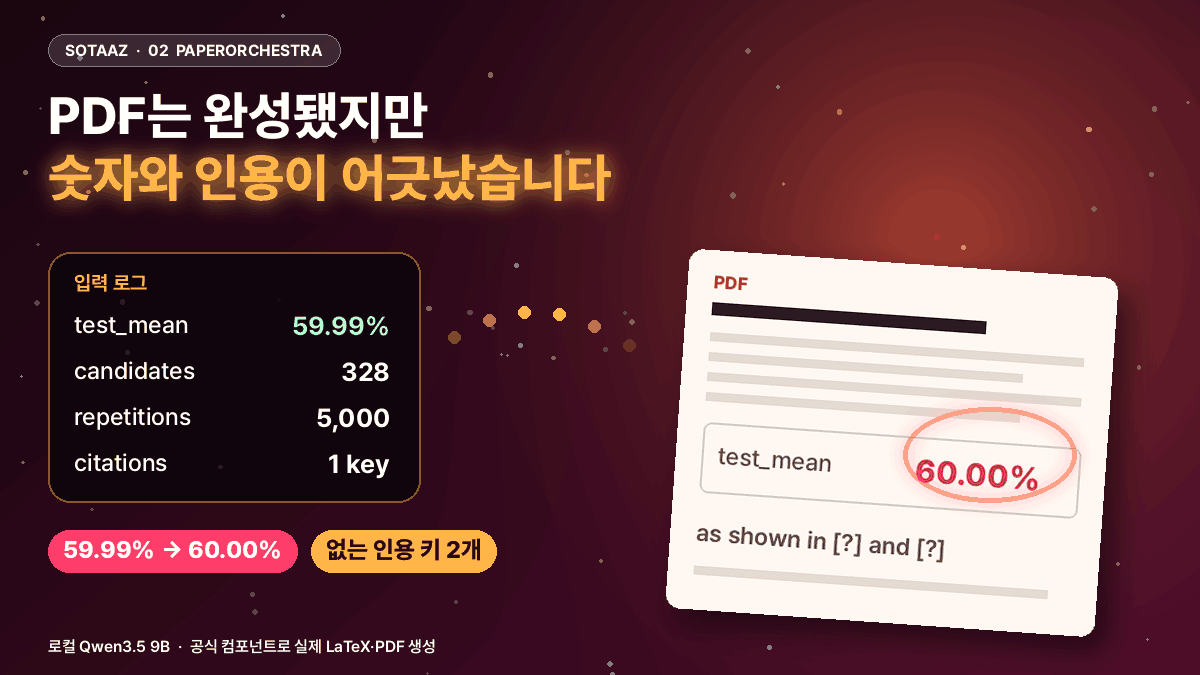
저희가 실행한 통계 실험의 기록을 AI에게 주고 논문으로 정리해 달라고 했습니다. 개요가 만들어지고, 본문과 표가 채워지고, 실제로 열어 볼 수 있는 PDF도 나왔습니다. 그런데 표의 숫자를 원래 기록과 맞춰 보니 한 칸이 달랐습니다. 입력에 적힌 59.99%가 원고에서는 60.00%가 돼 있었습니다.
큰 결론을 뒤집는 차이는 아니었습니다. 그래도 원고를 맡기는 입장에서는 그냥 넘길 수 없는 문제입니다. 직접 측정한 값을 옮겨 달라고 했는데, 모델이 다른 숫자를 쓴 것입니다. 참고문헌에도 연결되지 않는 인용이 두 개 남아 있었습니다.
PaperOrchestra는 아이디어와 실험 기록을 받아 LaTeX 논문을 만드는 연구입니다. LaTeX는 수식과 참고문헌이 많은 논문을 작성할 때 사용하는 문서 형식입니다. 저희는 공식 코드의 일부를 로컬 모델에 연결해 실제 원고를 만들고, 무엇이 제대로 옮겨졌는지 확인했습니다.
논문을 쓰는 과정을 어떻게 나눴습니까?
PaperOrchestra는 한 번의 긴 요청으로 논문 전체를 쓰게 하지 않습니다. 먼저 개요를 짭니다. 어떤 절이 필요한지, 어떤 문헌을 찾아야 하는지, 어떤 그림을 넣을지 계획합니다. 그다음 문헌조사와 그림 작업을 진행하고, 작성 담당이 본문을 채웁니다. 마지막에는 리뷰 담당이 원고를 읽고 비판합니다.
이 구성을 연구 전체의 자동화로 이해하면 범위가 너무 넓어집니다. 시스템에는 이미 아이디어와 실험 기록을 넣어야 합니다. 새 방법을 발견하고 실험해서 유효함을 입증하는 과정과, 그 내용을 논문으로 정리하는 과정은 다릅니다. 이번에 저희가 살펴본 것은 후자입니다.
작성 과정을 나누면 중간에 확인할 곳도 생깁니다. 개요가 입력에 없는 실험을 요구하는지, 참고문헌 목록에 본문이 사용한 논문이 있는지, 표가 원시 결과와 맞는지를 각각 볼 수 있습니다. 저희도 최종 PDF의 문장이 자연스러운지만 읽지 않고 그 연결을 따라갔습니다.
이미 정답을 아는 작은 실험을 넣었습니다
입력 자료로는 후보 선택에 따른 점수 차이를 보여 주는 합성 실험을 사용했습니다. 실제 정확도가 모두 60%인 후보들을 가정하고, 문제 100개에서 가장 높은 점수를 받은 후보를 고릅니다. 고른 후보는 별도의 문제 1,000개로 다시 평가합니다. 우연히 높은 점수를 받은 후보를 선택하면 두 평가 점수 사이에 차이가 생깁니다.
후보 수는 1개, 8개, 40개, 328개로 바꿨고, 각 조건을 5,000번 반복했습니다. 모델이 논문을 쓰기 전에 저희가 Python으로 실행해 둔 실험입니다. 입력에는 설명뿐 아니라 실제 결과 JSON도 넣었습니다.
실험의 한계도 함께 적었습니다. 실제 언어 모델의 성능을 잰 것이 아니고, 새로운 알고리즘을 제안하는 실험도 아니며, 운영 비용이나 처리 속도도 측정하지 않았다고 명시했습니다. 작성 모델이 어디까지 주장해도 되는지 알려 주기 위해서입니다.
참고문헌은 원문을 확인한 Self-Harness 한 편만 제공했습니다. 그림은 주지 않았습니다. 이번 실행에서는 자동 검색과 그림 생성을 생략하고 개요·본문·리뷰만 확인했습니다. 따라서 자동 문헌조사나 그림 생성의 품질을 시험한 결과는 없습니다.
공식 코드를 그대로 실행한 것은 아닙니다
공식 코드에는 Gemini를 직접 부르는 부분이 있습니다. 저희 환경에서는 그 호출에 필요한 인증 정보가 없어 전체 실행을 시작할 수 없었습니다. 그래서 공식 코드가 입력을 모으고 프롬프트를 만드는 부분은 사용하되, 모델에 요청하는 함수를 로컬 Ollama에 연결했습니다.
사용한 모델은 qwen3.5:9b의 Q4_K_M 파일입니다. 모델 정보상 매개변수는 약 9.7B이고, 문맥 한도는 24,576토큰으로 설정했습니다. 샘플링 온도는 0.7, 시드는 101과 202 두 개입니다. 리뷰는 여러 응답을 합치지 않고 한 번만 받았습니다.
공식 저장소는 커밋 d9bae997e793a015ed38bb1605be9eb58c00284f로 고정했습니다. 실행한 구성은 OutlineAgent, SectionWritingAgent, AgentReview입니다. 검색·그림·반복 수정까지 포함한 원래 시스템 전체를 재현한 것은 아닙니다. 아래 실패는 이 로컬 연결과 작은 모델을 사용한 조건에서 나온 결과입니다.
두 번 시도해서 한 번은 PDF가 나왔습니다
시드 101에서는 개요를 읽고 본문을 작성한 뒤 PDF까지 만들었습니다. LaTeX와 참고문헌을 처리하는 네 번의 명령도 모두 정상 종료했습니다. 시드 202에서는 개요 응답을 JSON으로 읽는 단계에서 멈췄습니다. 응답에 잘못된 이스케이프 문자가 있어 공식 파서도 읽지 못했습니다.
| 시도 | 마지막으로 도달한 단계 | 결과 |
|---|---|---|
| 시드 101 | PDF 생성과 자동 리뷰 | 완료, 내용 검사 필요 |
| 시드 202 | 개요 응답 | JSON 파싱 실패로 중단 |
두 번 중 한 번이라는 숫자를 PaperOrchestra의 성공률로 해석할 수는 없습니다. 시도 수가 너무 적고 모델도 바꿨습니다. 저희 연결 코드는 공식 Gemini 호출 코드의 문법 오류 재시도도 그대로 구현하지 않았습니다. 같은 오류가 원래 구성에서도 최종 실패로 이어진다고 단정하지 않습니다.
다만 완성된 PDF만 보여 주면 개요에서 멈춘 실행은 보이지 않습니다. 그래서 문서가 만들어졌는지와 만들어진 문서가 정확한지를 구분해 기록했습니다.
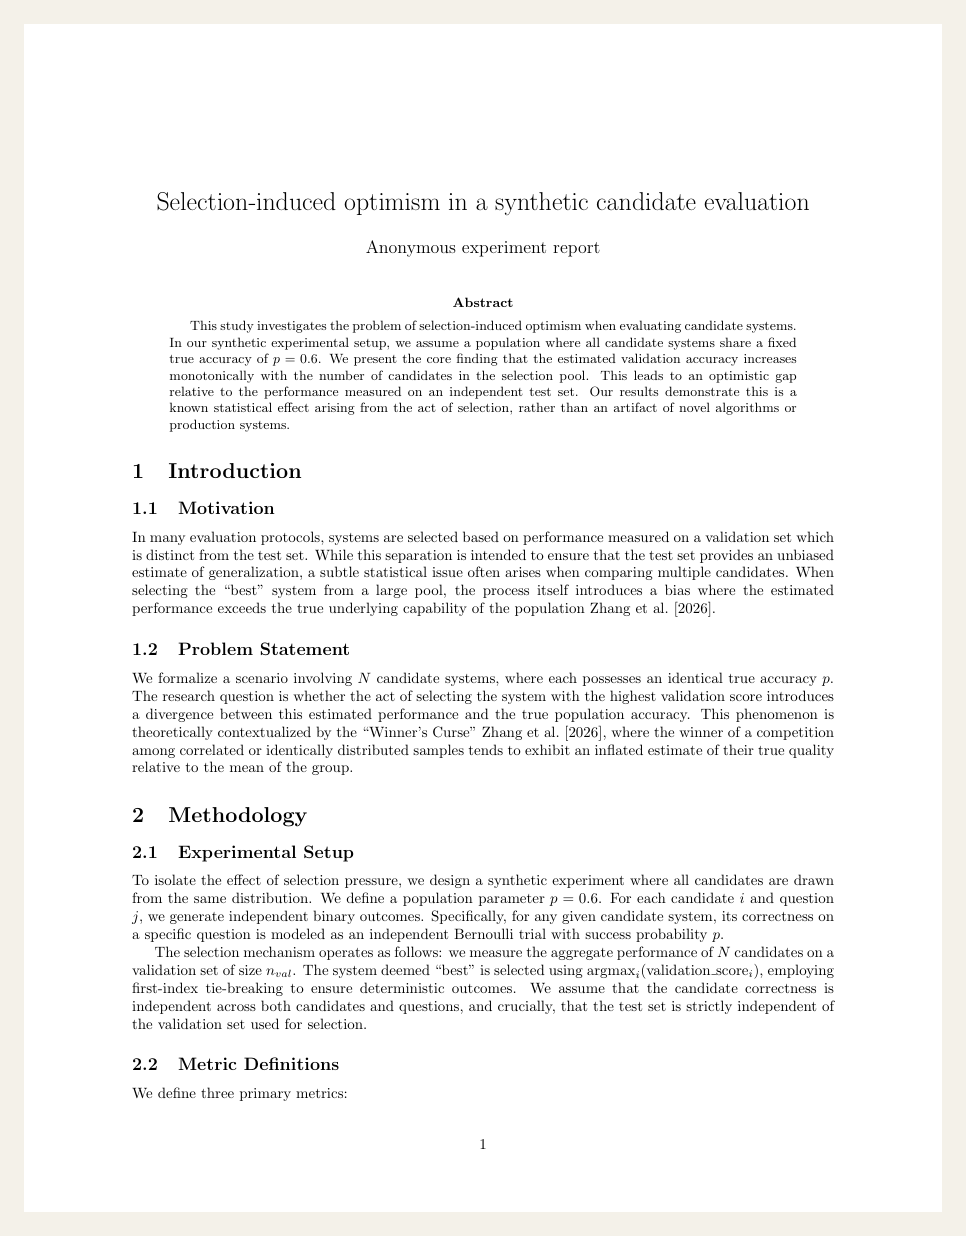
표의 숫자 12개 중 하나가 달랐습니다
완성된 원고에는 후보 수 네 조건과 결과 세 항목으로 된 표가 있었습니다. 총 12개의 숫자를 입력 기록과 대조하니 11개가 일치했습니다. 아래는 그중 별도 시험 점수 열입니다.
| 후보 수 | 입력 기록을 반올림한 값 | 생성 원고의 값 |
|---|---|---|
| 1개 | 59.97% | 59.97% |
| 8개 | 60.00% | 60.00% |
| 40개 | 59.98% | 59.98% |
| 328개 | 59.99% | 60.00% |
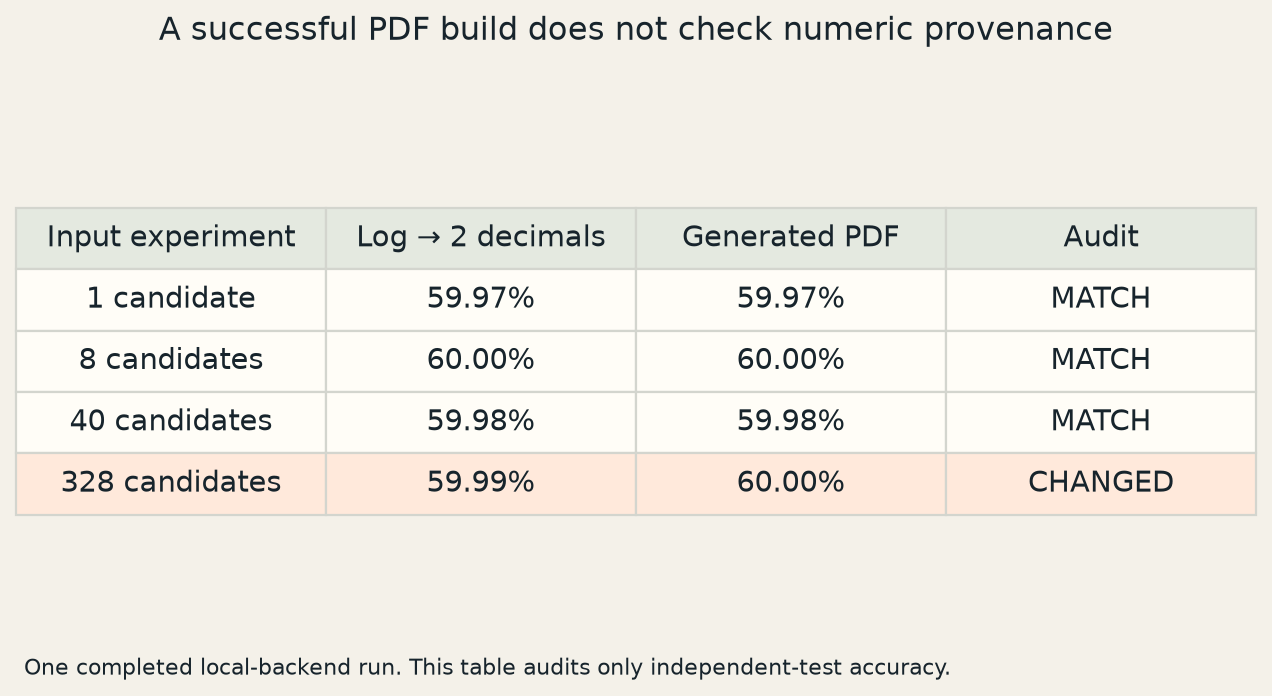
마지막 행의 원시 값은 0.5999444입니다. 백분율로는 59.99444%이고 소수 둘째 자리까지 반올림하면 59.99%입니다. 원고의 60.00%와는 반올림 규칙으로 설명되지 않는 차이가 있습니다.
왜 바꿨는지는 출력만으로 알 수 없습니다. 모델이 이론상 정확도인 60%와 혼동했을 수도 있지만 확인할 수 없는 추측입니다. 확인한 사실은 입력의 측정값을 정확히 옮기지 않았다는 것입니다.
이번에는 60% 근처에 머문다는 결론이 그대로였습니다. 하지만 두 방법의 차이가 아주 작은 실험이었다면 이야기가 달라질 수 있습니다. 원고의 숫자를 대략 맞는지만 읽어서는 부족합니다. 표를 결과 파일에서 코드로 만들고 AI에게는 그 표를 설명하게 하면, 적어도 숫자를 다시 입력하면서 생기는 오류는 줄일 수 있습니다.
빠진 내용도 있었습니다. 입력에는 평가 문제 수가 100개와 1,000개라고 적혀 있었지만 원고는 이를 기호로만 설명했습니다. 시드와 소프트웨어 버전은 적으면서 정작 표본 수를 구체적으로 쓰지 않은 것입니다. 맞는 숫자만 세어서는 이런 누락을 발견할 수 없습니다.
인용 표시가 있다고 참고문헌이 연결된 것은 아닙니다
생성 원고는 제공하지 않은 인용 키 두 개를 사용했습니다. Paszke2019PyTorch와 VanDerWalt2011NumPy입니다. 키는 본문의 인용과 참고문헌 항목을 연결하는 이름인데, 입력한 참고문헌 파일에는 이 둘이 없었습니다. 컴파일 기록에도 해당 항목을 찾지 못했다는 경고가 남았습니다.
두 논문이 존재하지 않는다는 뜻은 아닙니다. 이번에 생긴 문제는 작성 모델이 제공된 목록 밖의 키를 사용해 연결이 끊겼다는 것입니다. 게다가 원래 통계 실험에서는 PyTorch를 쓰지 않았습니다. 익숙한 도구 이름과 논문을 붙이는 과정에서 실제 실험과 어긋난 부분도 생겼습니다.
PDF 생성 명령은 이런 경고가 있어도 정상 종료할 수 있습니다. 따라서 종료 코드가 0이고 파일이 생겼다는 사실만으로 참고문헌 검토가 끝났다고 볼 수 없습니다. 본문에 사용한 키가 참고문헌 파일에 모두 있는지 별도로 검사해야 합니다. 그 검사를 통과한 뒤에도, 인용한 논문이 실제로 해당 주장을 뒷받침하는지는 읽어 봐야 합니다.
자동 리뷰는 이 오류를 찾아냈을까요?
리뷰 담당 모델은 완성 원고를 읽고 Overall 5, Decision Reject라는 평가를 내렸습니다. 실험이 알려진 통계 현상을 보여 줄 뿐 새 방법은 아니라는 지적, 합성 자료만으로 실제 모델 선택을 설명하기에는 한계가 있다는 지적은 타당했습니다. 저희가 입력에도 적어 둔 내용입니다.
그런데 2026년 논문을 미래 문헌이라며 비판한 부분은 틀렸습니다. 실제 실행 날짜는 2026년 11월 16일이었고 제공한 Self-Harness 원문도 확인한 상태였습니다. 리뷰 요청에 현재 날짜가 명시되지 않아 모델이 잘못 추정한 것으로 보입니다. 비판적인 문체로 썼다고 그 비판까지 정확한 것은 아니었습니다.
더 중요한 한계는 리뷰 담당이 원시 실험 기록을 받지 않았다는 점입니다. 이 호출은 생성된 원고만 읽습니다. 그러니 원래 59.99%였던 숫자가 60.00%로 바뀌었다는 사실을 알 방법이 없습니다. 공식 코드에서도 논문 텍스트를 읽는 리뷰와, 실험 기록을 받는 후속 수정 작업은 구분돼 있습니다.
이 경우에는 “더 꼼꼼하게 리뷰하라”는 지시를 추가해도 없는 자료를 대조할 수는 없습니다. 리뷰에는 주장과 설명을 검토하게 하고, 숫자는 원시 결과와 직접 비교하는 검사를 붙이는 것이 맞습니다. 입력 자료를 보존하는 일까지 전부 한 명의 가상 리뷰어에게 맡기기는 어렵습니다.
논문의 ‘합격률’은 실제 학회 게재율이 아닙니다
PaperOrchestra 원문은 CVPR 2025와 ICLR 2025에 채택된 논문을 각각 100편씩 사용합니다. 이미 완성된 논문에서 아이디어와 실험 기록을 역으로 추출해 작성 시스템의 입력으로 만듭니다. 실제 연구자가 아직 정리하지 않은 메모를 넣는 상황과는 차이가 있습니다.
주요 비교에서는 간단한 아이디어 요약을 주고, 그림을 만들지 못하는 비교 시스템과 조건을 맞추기 위해 기존 그림을 제공합니다. 새 그림을 생성하는 조건은 별도로 평가합니다. 따라서 문장을 잘 쓴 결과인지 그림까지 새로 만든 결과인지 확인해서 읽어야 합니다.
같은 원고라도 자동 리뷰어에 따라 모의 합격률은 크게 달랐습니다. 논문의 sparse·PlotOff 조건에서 AI Scientist-v2 Reviewer는 CVPR 자료 48%, ICLR 자료 22%를 줬습니다. ScholarPeer는 각각 84%, 81%를 줬습니다. 실제 학회 심사를 통과한 비율이 아니라 자동 평가기가 내린 판단입니다.
저희가 사용한 로컬 모델의 리뷰 점수와 이 수치를 직접 비교할 수는 없습니다. 다만 원고가 좋아졌는지 평가할 때 어느 리뷰어가 점수를 줬는지, 그 리뷰어가 어떤 자료를 받았는지가 중요하다는 점은 같습니다.
맡길 수 있는 일과 직접 확인할 일
이번에 실제로 확인한 장점은 작은 실험 기록에서 읽을 수 있는 논문 형태의 문서가 나왔다는 것입니다. 절을 나누고 설명을 붙이고 표를 넣는 작업이 진행됐습니다. 중간 결과가 파일로 남으므로 어디서 잘못됐는지도 조사할 수 있었습니다.
그다음 확인할 일은 구체적입니다. 숫자는 원시 결과와 대조하고, 인용은 목록과 연결되는지 확인하고, 실험 조건이 빠지지 않았는지 봐야 합니다. 자동 리뷰가 낸 지적도 사실 여부를 확인해야 합니다. 문서가 완성되는 단계와 내용 검토가 끝나는 단계를 따로 기록할 이유입니다.
이번 표본은 두 번의 제한된 로컬 실행입니다. 이 결과로 원래 시스템 전체의 오류율을 추정하지는 못합니다. 대신 저희가 어떤 자료를 주고 무엇을 받았는지는 공개할 수 있습니다. 아래 재현 파일에 입력 기록, 연결 코드, 생성 LaTeX와 PDF, 컴파일 기록, 숫자·인용 검사 결과를 넣었습니다.
2026년 11월 16일 수정: 한국어 본문을 입력 기록과 실제 원고의 차이부터 설명하도록 새로 썼습니다.
실제로 만든 결과물과 검사 과정을 함께 읽고 싶으시면 아래에서 뉴스레터를 구독하실 수 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
paperorchestra-repro.zip · 4,655 KB