당신의 에이전트 90%는 그냥 Python 스크립트여야 한다: 제곱으로 터지는 토큰 비용 해부
일일 거래 파일 10개(180건) 이상치 점검 작업을 Claude Haiku 4.5로 실측했습니다. 런타임 에이전트 루프는 12턴 동안 입력 토큰 102,546개와 20.7초를 태우고도 마지막 합산에서 실패했습니다. 같은 모델로 Python 스크립트를 한 번 짜서 30번 돌리자 379토큰, 회당 38.8ms에 30/30 정확히 통과했습니다. 프롬프트 캐시를 100% 적중시켜도 시간당 운영 기준 7,569배 차이가 납니다.

반복되는 사내 운영 작업에 AI 에이전트를 붙였다가 한 달 뒤 API 청구서를 보고 놀라는 팀이 많습니다. 파일 10개쯤 읽고 이상한 행만 추려 합계를 내는 단순한 일인데도, 매번 에이전트 루프를 돌리면 비용이 데이터 크기와 비례하지 않고 턴 수의 제곱($O(N^2)$)으로 불어납니다.
이 구조가 실제로 얼마나 빨리 터지는지, 그리고 "프롬프트 캐시를 켜면 괜찮지 않나?"라는 반론이 어디까지 맞는지 직접 쟀습니다. 같은 모델(claude-haiku-4-5-20251001, temperature 0)에 똑같은 일일 거래 점검 작업을 주고 두 가지 방식으로 실측했습니다.
- 데이터셋: 결정론적 시드(
20261121)로 생성한 일일 거래 로그 10개(batch_01.json~batch_10.json, 파일당 18건 = 총 180건). 숨긴 이상치 3건(중복tx_idTX-0042, 음수 금액TX-0100, 빈customer_idTX-0155)을 넣고, 정상 177건의 정확한 합계(21,848.68)와 이상치 3건 추출을 목표로 잡았습니다. - 방식 A (런타임 에이전트 루프):
list_files,read_file,write_report도구 3개를 주고 에이전트가 매번 파일을 하나씩 읽어 점검합니다. - 방식 B (코딩 에이전트로 1회 생성 + 일반 Python 실행): 같은 모델에게 샘플 2행의 JSON 구조와 규칙 3줄만 주고 파이썬 스크립트를 딱 한 번 짜게 한 뒤, 그 스크립트를 30번(30일치) 실행합니다.
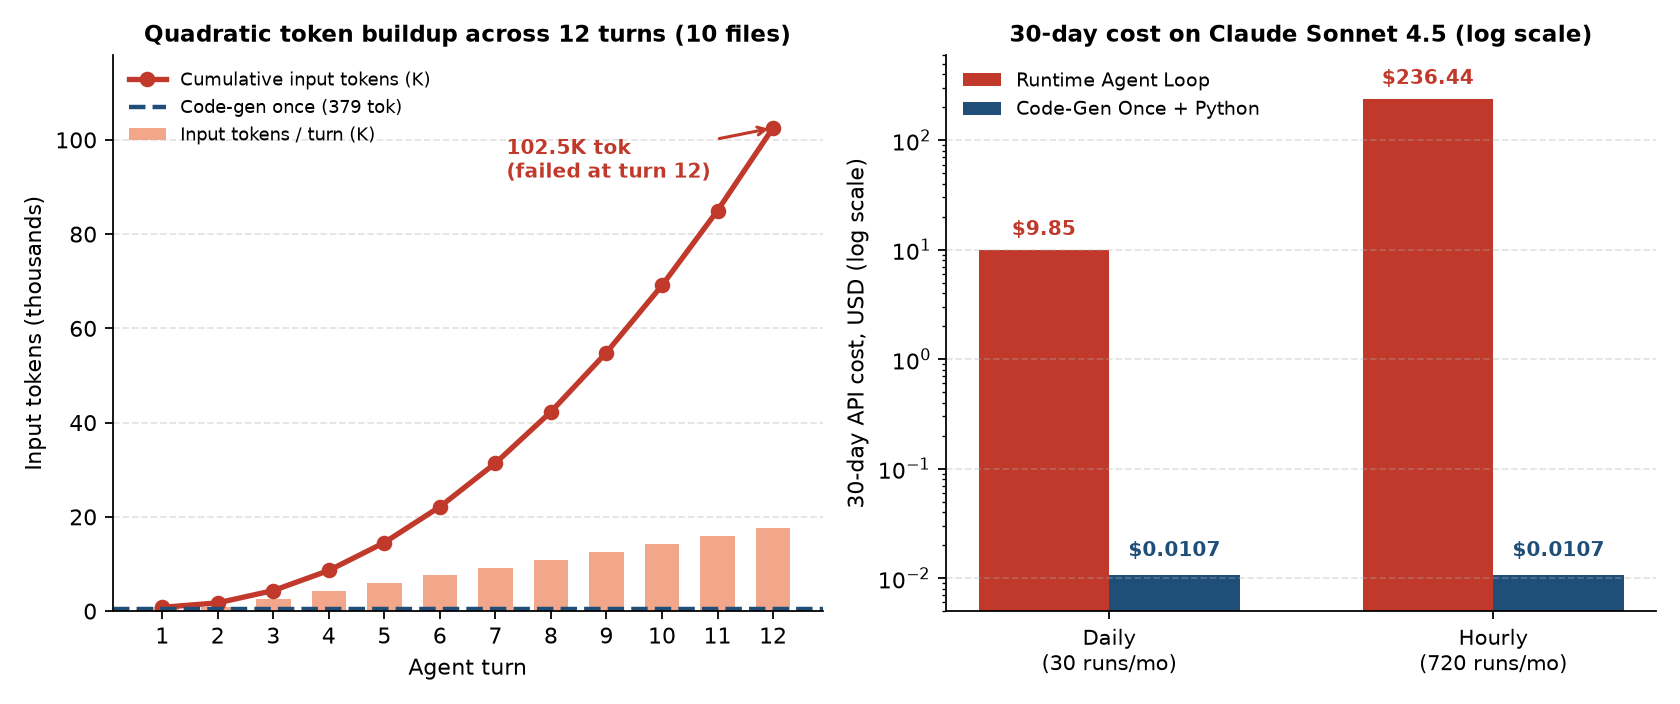
결과는 극단적이었습니다. 런타임 에이전트는 단 1회 실행에 입력 토큰 102,546개와 20.71초를 쓰고도 12번째 턴에서 출력 한도에 걸려 리포트를 끝내 제출하지 못했습니다. 반면 같은 모델이 379 입력 토큰(5.15초)으로 한 번 짜 준 파이썬 스크립트는 30번 실행 모두 38.8ms 만에 소수점 둘째 자리까지 정확히 맞혔습니다. 프롬프트 캐시를 100% 적중시켜도 시간당 운영(월 720회) 기준 비용 차이는 여전히 7,569배였습니다.
아래에서는 12턴 동안 입력 토큰이 제곱으로 불어난 실제 로그와 수식, 프롬프트 캐시의 실제 절감 한계, 흔한 반론 두 가지(max_tokens 확장·run_python 도구 추가)에 대한 검증, 그리고 프로덕션에서 "어디까지를 코드로 두고 어디부터를 에이전트로 둘지" 나누는 3단계 기준과 하이브리드 폴백 코드를 정리합니다.
12턴 동안 토큰이 제곱으로 터진 실제 로그
LLM API는 무상태(stateless)입니다. 2번 턴에 읽은 batch_01.json은 3번 턴에도, 4번 턴에도, 12번 턴에도 대화 이력에 실려 매번 다시 전송됩니다. 원본 파일 10개의 총 크기는 약 16,500토큰에 불과하지만, 12턴을 도는 동안 모델이 실제로 과금한 입력 토큰 합계는 원본의 6배가 넘는 102,546토큰이었습니다.
| 턴 | 호출 도구 | 해당 턴 입력 토큰 | 직전 대비 증가분 | 누적 입력 토큰 | 지연 시간 |
|---|---|---|---|---|---|
| 1 | list_files | 804 | — | 804 | 1.22초 |
| 2 | read_file (batch_01) | 948 | +144 | 1,752 | 1.25초 |
| 3 | read_file (batch_02) | 2,610 | +1,662 | 4,362 | 1.30초 |
| 4 | read_file (batch_03) | 4,265 | +1,655 | 8,627 | 1.26초 |
| 5 | read_file (batch_04) | 5,919 | +1,654 | 14,546 | 1.68초 |
| 6 | read_file (batch_05) | 7,597 | +1,678 | 22,143 | 1.31초 |
| 7 | read_file (batch_06) | 9,251 | +1,654 | 31,394 | 1.27초 |
| 8 | read_file (batch_07) | 10,905 | +1,654 | 42,299 | 1.58초 |
| 9 | read_file (batch_08) | 12,580 | +1,675 | 54,879 | 1.28초 |
| 10 | read_file (batch_09) | 14,234 | +1,654 | 69,113 | 1.25초 |
| 11 | read_file (batch_10) | 15,882 | +1,648 | 84,995 | 1.68초 |
| 12 | *(합산 중 잘림, 호출 없음)* | 17,551 | +1,669 | 102,546 | 5.62초 |
표의 세 번째 열을 보면 구조가 한눈에 들어옵니다. 파일 하나를 읽을 때마다 매 턴 입력이 약 1,655토큰씩 계단처럼 늘어납니다. 고정 시스템 프롬프트·도구 스키마를 $S$, 매 턴 늘어나는 도구 출력 크기를 $\Delta$, 총 턴 수를 $N$이라 하면 전체 입력 토큰은 등차수열의 합이 됩니다.
$$\text{Total Input} \approx N \cdot S + \Delta \cdot \frac{N(N-1)}{2}$$
파일 수가 2배, 5배로 늘어나면 토큰 비용은 2배, 5배가 아니라 4배, 22배로 뜁니다. 같은 파일 크기($\Delta \approx 1,655$) 기준으로 파일 수만 늘려 보면 이렇습니다.
| 파일 수 | 턴 수 ($N$) | 마지막 턴 입력 토큰 | 1회 실행 총 입력 토큰 | Sonnet 4.5 1회 비용 (캐시 미스) |
|---|---|---|---|---|
| 10개 (실측) | 12턴 | 17,551 | 102,546 | $0.33 |
| 20개 (추정) | 22턴 | ~35,559 | ~399,993 | $1.20 |
| 50개 (추정) | 52턴 | ~85,209 | ~2,236,338 | $6.71 |
개발 단계에서 샘플 파일 3~5개로 데모를 돌릴 때는 한 번에 몇 센트밖에 안 나와 문제가 전혀 안 보입니다. 그러다 프로덕션에 올려 파일이 50개로 늘어나면 단 한 번의 실행이 220만 입력 토큰을 먹어 치우며 청구서가 폭탄으로 돌아옵니다.
비용보다 더 아픈 결과: 12번째 턴의 실패
이번 실측에서 런타임 에이전트는 102,546 입력 토큰과 20.71초를 쓰고도 실패했습니다. 파일 10개를 전부 읽은 12번째 턴에서 177개 부동소수점 숫자를 텍스트로 일일이 더하다가 max_tokens=512 출력 한도에 걸려 write_report 도구를 끝내 호출하지 못했기 때문입니다.
같은 모델로 스크립트를 한 번 짜서 30번 돌린 결과
이번에는 같은 claude-haiku-4-5-20251001에게 파일 10개를 읽히는 대신, 샘플 2행의 JSON 구조와 이상치 규칙 3줄만 주고 독립 실행 파이썬 스크립트를 한 번 짜게 했습니다. 그리고 생성된 스크립트를 30번 연속 실행했습니다.
| 지표 | 방식 A: 런타임 에이전트 (1회) | 방식 B: 1회 코드 생성 + Python (30회) | 차이 |
|---|---|---|---|
| 입력 토큰 | 102,546 (1회당) | 379 (최초 1회만) | 1회 기준 270배 |
| 출력 토큰 | 1,383 (1회당) | 635 (최초 1회만) | — |
| 실행 시간 | 20.71초 / 회 | 38.8ms / 회 (생성 5.15초) | 534배 빠름 |
| 정확도 | 실패 (0 / 1) | 30 / 30 (100% 일치) | 완전 결정론 |
"프롬프트 캐시를 켜면 괜찮지 않나요?" — 직접 계산해 봤습니다
실무에서 가장 많이 나오는 반론은 프롬프트 캐시입니다. 이번 12턴 실측 로그에 Claude Sonnet 4.5의 공식 캐시 단가(캐시 쓰기 $3.75/1M, 캐시 읽기 $0.30/1M, 출력 $15.00/1M)를 정확히 대입해 봤습니다. 12턴 전체에서 새로 캐시에 쓰는 토큰은 17,551개, 이전 턴에서 재사용해 읽는 토큰은 84,995개, 출력 토큰은 1,383개입니다.
| 운영 빈도 (30일, Sonnet 4.5) | 런타임 에이전트 (캐시 미스) | 런타임 에이전트 (캐시 100% 적중) | 1회 생성 + Python 크론 | 캐시 적중 대비 격차 |
|---|---|---|---|---|
| 1회 실행 | $0.3284 | $0.1121 (-65.9%) | $0.0107 | 10.5배 |
| 일 1회 (월 30회) | $9.85 | $3.36 | $0.0107 | 315배 |
| 시간당 1회 (월 720회) | $236.44 | $80.68 | $0.0107 | 7,569배 |
프롬프트 캐시가 매 턴 100% 적중해도 입력 비용을 65.9% 낮출 뿐, 매시간 도는 작업 하나에 월 $80.68이 나갑니다. 게다가 실무에서는 5분 TTL 만료, 시스템 프롬프트 안의 현재 시각(now()) 주입, 컨텍스트 트리밍 때문에 캐시가 수시로 깨집니다. 무엇보다 캐시는 20.7초 지연과 확률적 계산 실패를 전혀 해결하지 못합니다.
흔한 반론 2가지에 대한 답
- "에이전트에
max_tokens=4096을 줬으면 12턴에서 안 잘렸을 텐데요?" 맞습니다. 출력 한도를 늘리면 합산 과정을 끝까지 적고write_report를 불렀을 가능성이 높습니다. 하지만 그 대가로 매 실행마다 출력 토큰 1,500~2,000개(Sonnet 기준 회당 약 $0.03 추가)를 더 태워야 하고, 177개 소수점 덧셈에서 단 한 자리만 틀려도 조용한 실패가 됩니다. - "에이전트에
run_python도구를 쥐여 주면 1턴에 끝나지 않나요?" 그것이 바로 방식 B로 가는 중간 단계입니다. 다만 런타임 에이전트가 매번 실행될 때마다 파이썬 코드를 새로 짜고 샌드박스에서 돌리면, 똑같은 코드를 하루 24번씩 다시 생성하느라 토큰과 지연 시간을 계속 쓰게 되고, 어느 날 갑자기 미묘하게 다른 코드를 짜서 장애를 낼 위험도 남습니다. 잘 돌아가는 스크립트가 나왔다면 그 코드를 Git에 커밋하고 크론으로 돌리는 것이 프로덕션 엔지니어링입니다.
모델이 실제로 짜 준 스크립트와 하이브리드 폴백 패턴
379 입력 토큰으로 생성돼 30/30을 통과한 핵심 코드는 표준 라이브러리 25줄입니다.
import json, sys
from pathlib import Path

data_dir = Path(sys.argv[1])
seen: set[str] = set()
anomalies: set[str] = set()
valid_total = 0.0

for path in sorted(data_dir.glob("batch_*.json")):
    for row in json.loads(path.read_text(encoding="utf-8")):
        tx_id = row.get("tx_id", "")
        amount = float(row.get("amount", 0))
        cust = row.get("customer_id", "")
        is_dup = tx_id in seen
        seen.add(tx_id)
        if is_dup or amount <= 0 or not cust:
            anomalies.add(tx_id)
        else:
            valid_total += amount

print(json.dumps({
    "anomaly_tx_ids": sorted(anomalies),
    "valid_total": round(valid_total, 2),
}))
그렇다면 예외적인 비정형 데이터(예: 자유 형식 메모나 깨진 영수증 행)가 2~5% 섞여 들어오는 실무 파이프라인은 어떻게 설계해야 할까요? 전체를 에이전트 루프로 바꾸지 말고, 일반 코드가 95%를 처리하고 해석 불가능한 예외 행만 1턴 단발 LLM 호출로 넘기는 하이브리드 패턴을 씁니다.
def triage_with_bounded_fallback(rows: list[dict], llm_classify_once) -> dict:
    clean_total, anomalies, ambiguous = 0.0, [], []
    for row in rows:
        try:
            amt = float(row["amount"])
            if amt <= 0 or not row.get("customer_id"):
                anomalies.append(row["tx_id"])
            else:
                clean_total += amt
        except (KeyError, ValueError, TypeError):
            # 정형 파서가 못 읽는 2~5% 예외 행만 별도 수집
            ambiguous.append(row)

    # 루프 없이, 예외 행이 있을 때만 단 1턴 호출 (O(N^2) 원천 차단)
    if ambiguous:
        anomalies.extend(llm_classify_once(ambiguous))

    return {"valid_total": round(clean_total, 2), "anomaly_tx_ids": sorted(set(anomalies))}
이 구조에서는 파일이 500개로 늘어나도 루프가 돌지 않으므로 $O(N^2)$ 폭발이 원천적으로 발생하지 않고, 정상 행은 100% 결정론적으로 계산됩니다.
어디까지가 스크립트고, 어디부터가 에이전트인가
실무에서 에이전트를 도입하기 전에 아래 3단계 기준표에 먼저 대입해 보면 대부분 답이 바로 나옵니다.
| 구분 | 비중 | 적합한 작업 예시 | 권장 아키텍처 |
|---|---|---|---|
| 1. 정형·반복 작업 | ~75% | 로그·JSON·CSV 집계, 중복 검출, DB 동기화, 정해진 API 호출, 리포트 생성 | 빌드 타임 코딩 에이전트로 1회 생성 → Git 커밋 → 크론/워크플로우 실행 |
| 2. 반정형 + 예외 처리 | ~15% | 인보이스 파싱, 고객 문의 분류, 알림 트리아지(대부분 규칙 가능, 일부 모호함) | 일반 코드 95% 선처리 + 예외 행만 1턴 단발 LLM 폴백 |
| 3. 진짜 런타임 에이전트 | ~10% | 매번 경로가 달라지는 코드베이스 디버깅, 자유 형식 리서치, 다단계 탐색 | 상한 턴 수(Hard Cap) + Allowlist + 결정론적 종료 게이트 필수 |
직접 돌려 보려면
이번 실험의 데이터 생성기, 런타임 에이전트 루프, 1회 코드 생성기, 30회 실행 검증 코드는 모두 단일 파이썬 파일(drafts/agent-vs-python-script/bench_quadratic.py)로 작성했습니다.
- 모델:
claude-haiku-4-5-20251001,temperature=0 - 데이터셋:
random.Random(20261121)시드 고정, 10개 JSON 파일(180건), 이상치 3건(TX-0042,TX-0100,TX-0155), 정답 합계21,848.68 - 비용 계산: 실측된 1회 실행 토큰(
102,546입력 /1,383출력 vs379입력 /635출력)에 공식 Anthropic 단가 적용
요약하면 단순합니다. LLM은 개발 시점(Build Time)에 코드를 짜고 테스트를 통과시키는 데 쓰고, 운영 시점(Runtime)에는 그 코드를 돌립니다. 반복 작업을 런타임 에이전트 루프에 올려 두는 순간, 당신은 같은 추론을 매일 $O(N^2)$ 단가로 다시 결제하면서 정확도까지 포기하는 셈이 됩니다.