autoharness 코드 해부: "대화를 요약해 두었다가 다음에 불러 쓴다"는 간단한 아이디어가 왜 코드 3천 줄이 됐을까요
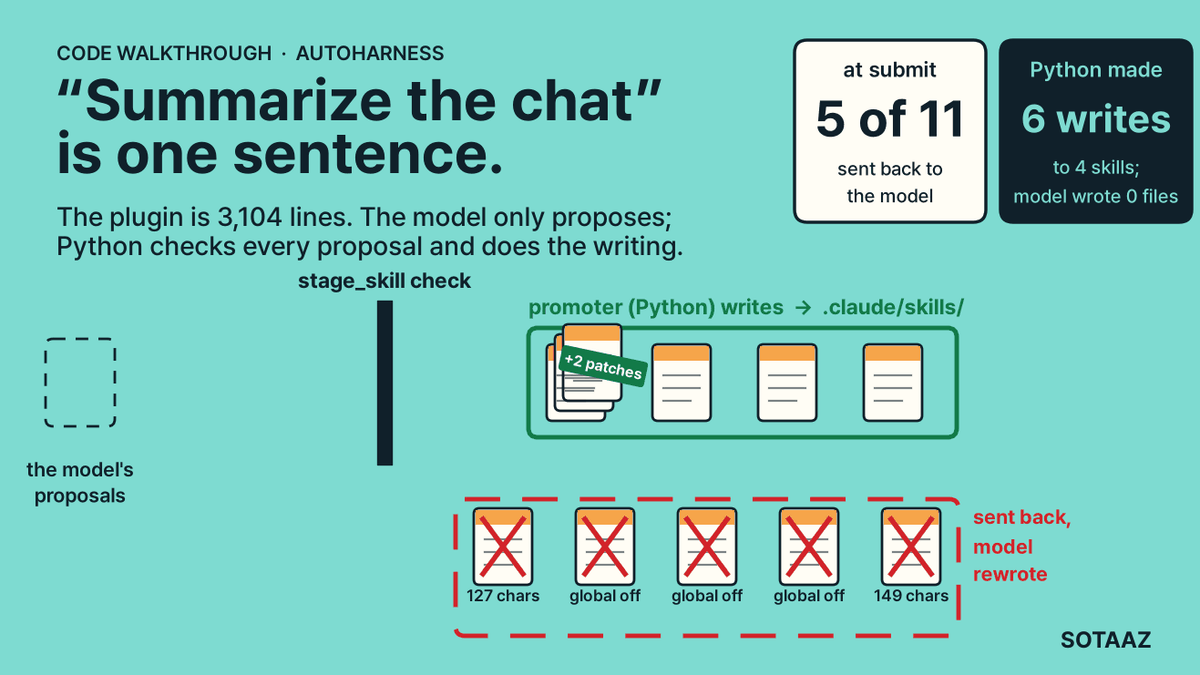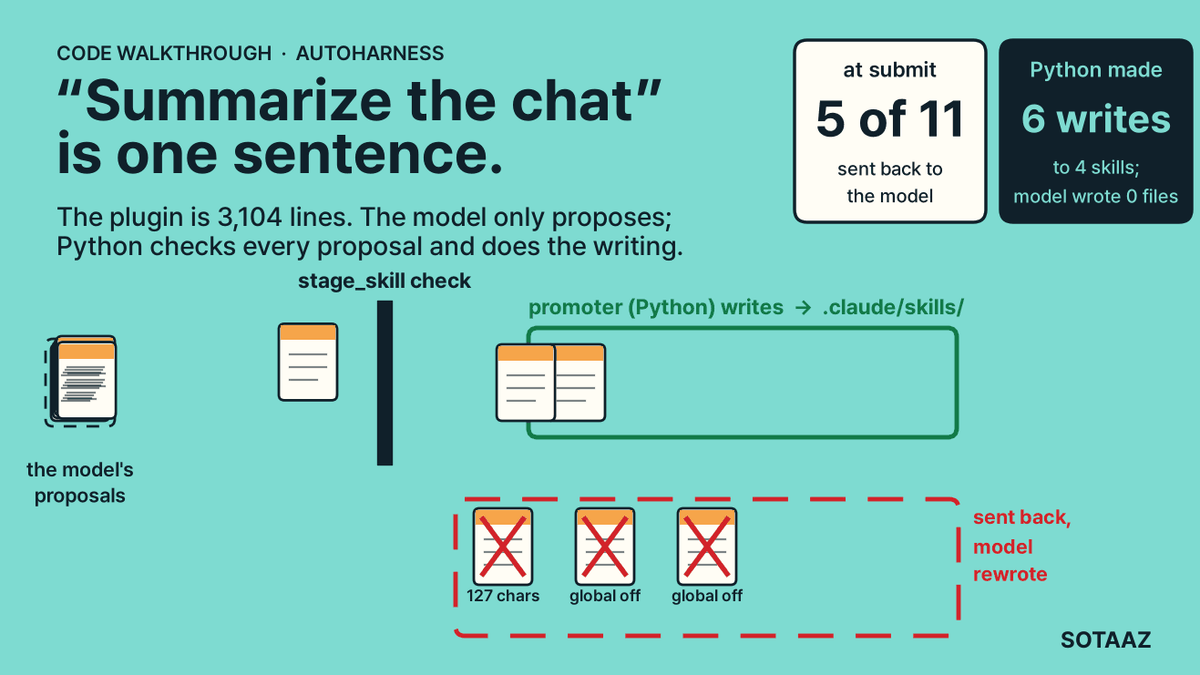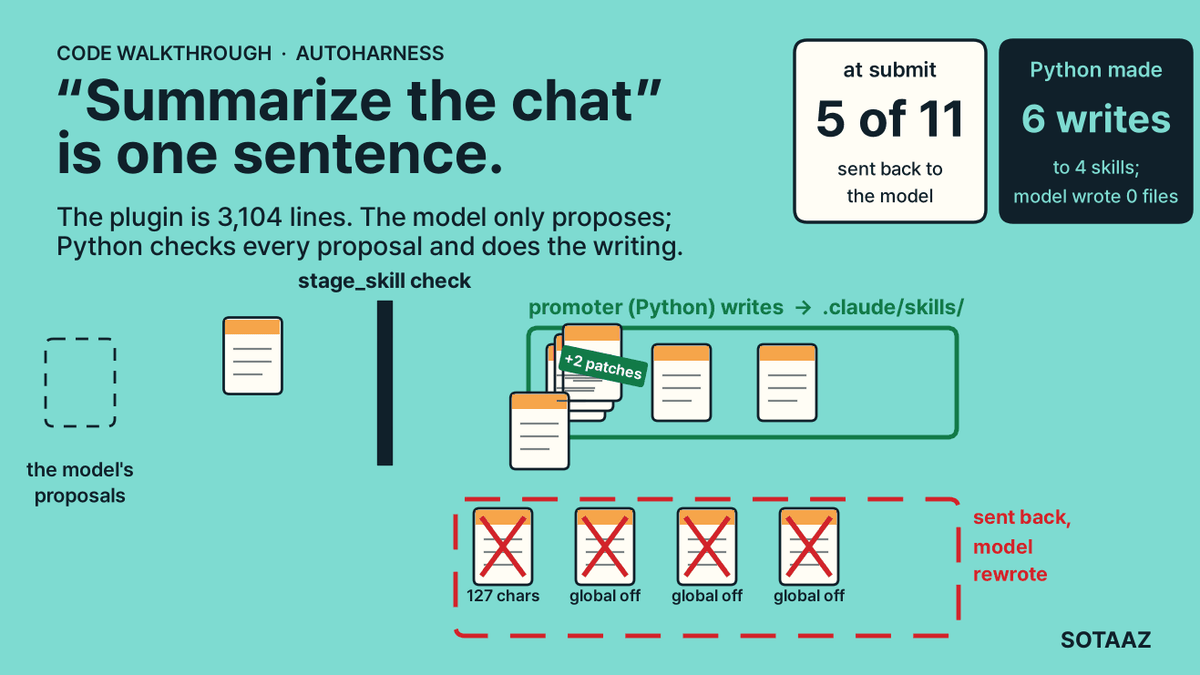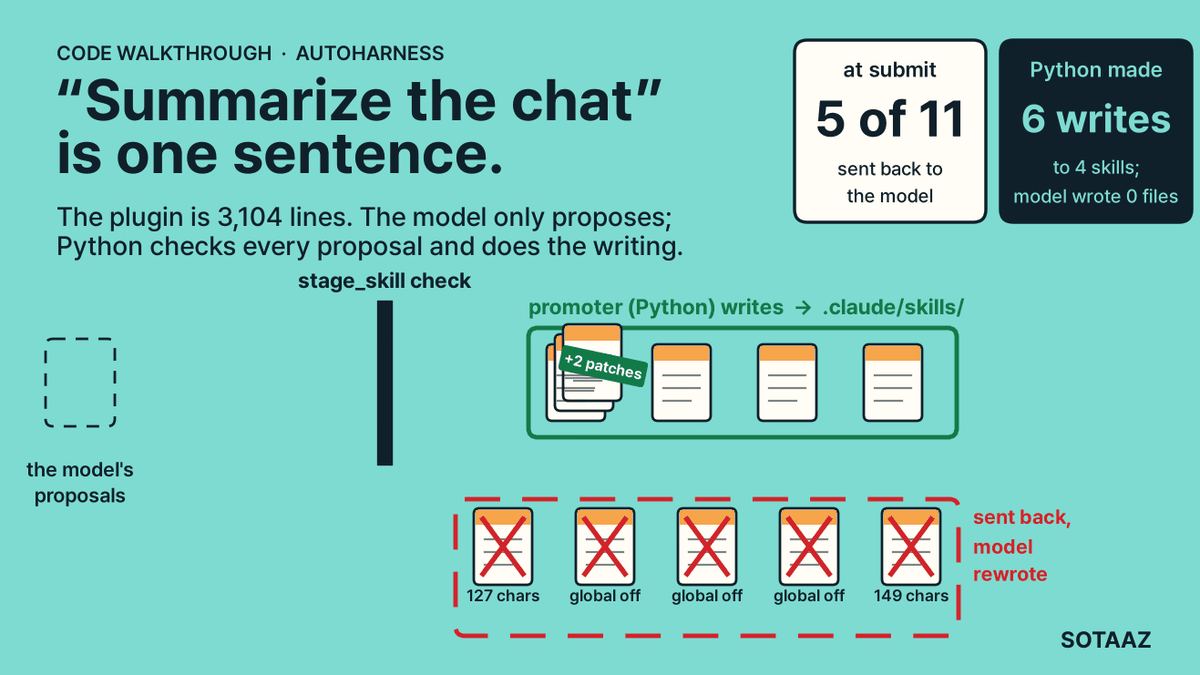
autoharness(파이썬 3,104줄)를 대화 한 토막이 다음 세션이 읽는 스킬이 되기까지 따라 읽고, 로컬 Qwen3.8 Flash Next(Strata)에 연결한 Claude Code에서 직접 돌렸습니다. 모델은 제안만 하고 검사와 쓰기는 파이썬이 합니다. 저희 실측에서 제안 11번 중 5번이 제출 즉시 돌려보내졌고, 나머지 6번은 promoter가 썼으며, reflection 프롬프트 하나가 65,536토큰 중 64,655토큰을 썼습니다.
autoharness 코드 해부: "대화를 요약해 두었다가 다음에 불러 쓴다"는 간단한 아이디어가 왜 코드 3천 줄이 됐을까요
autoharness 소개 글을 처음 읽었을 때 저희 반응은 이랬습니다. 대화를 다른 세션에 넘겨 요약시키고, 다음 세션에서 그 요약을 불러 쓰는 것 아닌가요? 이 간단한 아이디어가 어떻게 작동하는지 알아보기 위해 코드를 분석해 봤습니다. 이 플러그인의 파이썬 코드는 3,104줄이고, 테스트 코드는 7,064줄입니다. (2026-10-29 4f2a358 커밋 기준)
코드를 한줄 한줄 따라가며 어떤 일을 하는지를 살펴봤습니다. 생각했던대로, 대화가 차면 해당 대화를 요약해서 다른 세션에 넘기는 일을 했습니다. 하지만 대부분의 코드는 세션에 넘어간 내용이 망가지지 않게 막는데 사용됩니다.
아래 줄 번호는 tigerless-labs/autoharness(v0.5.3, MIT 라이선스)의 2026년 10월 29일 main 브랜치(4f2a358) 기준입니다. 1단계부터 5단계까지의 설명은 모두 코드나 README에서 직접 읽은 내용이고, 저희가 돌려서 얻은 숫자는 글에서 밝혀뒀습니다. 마지막 부분에서는 저희 GPU에 띄운 Qwen3.8 Flash Next에 Claude Code를 연결하고, 이 플러그인이 한 바퀴 도는 과정을 실제로 지켜봤습니다.
어떤 플러그인인가요
autoharness는 Claude Code 플러그인입니다. 도구 호출이 50번 쌓일 때마다 뒤에서 Claude 세션을 하나 더 띄워 최근 대화를 읽히고, 다음 세션이 알아 두면 좋을 것이 있는지 묻습니다. 답은 스킬 제안으로 돌아옵니다. 스킬은 .claude/skills/ 아래에 두는 짧은 지시문 파일입니다. [우리 글중에 스킬, 하네스 설명한 글로 링크 추가] 제안을 실제로 디스크에 쓸지는 따로 떨어진 파이썬 코드가 정합니다. 다음 세션은 스킬 목록을 보고 지금 일에 맞는 것을 골라 엽니다.
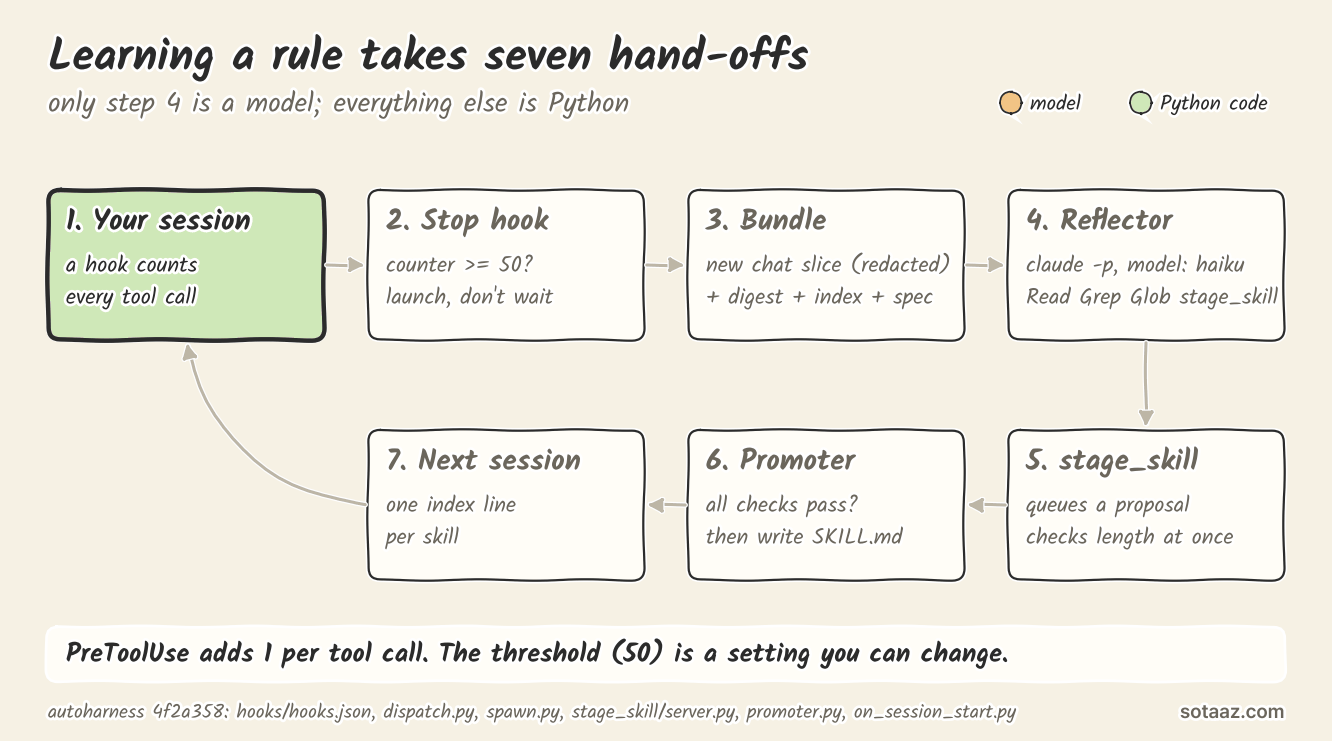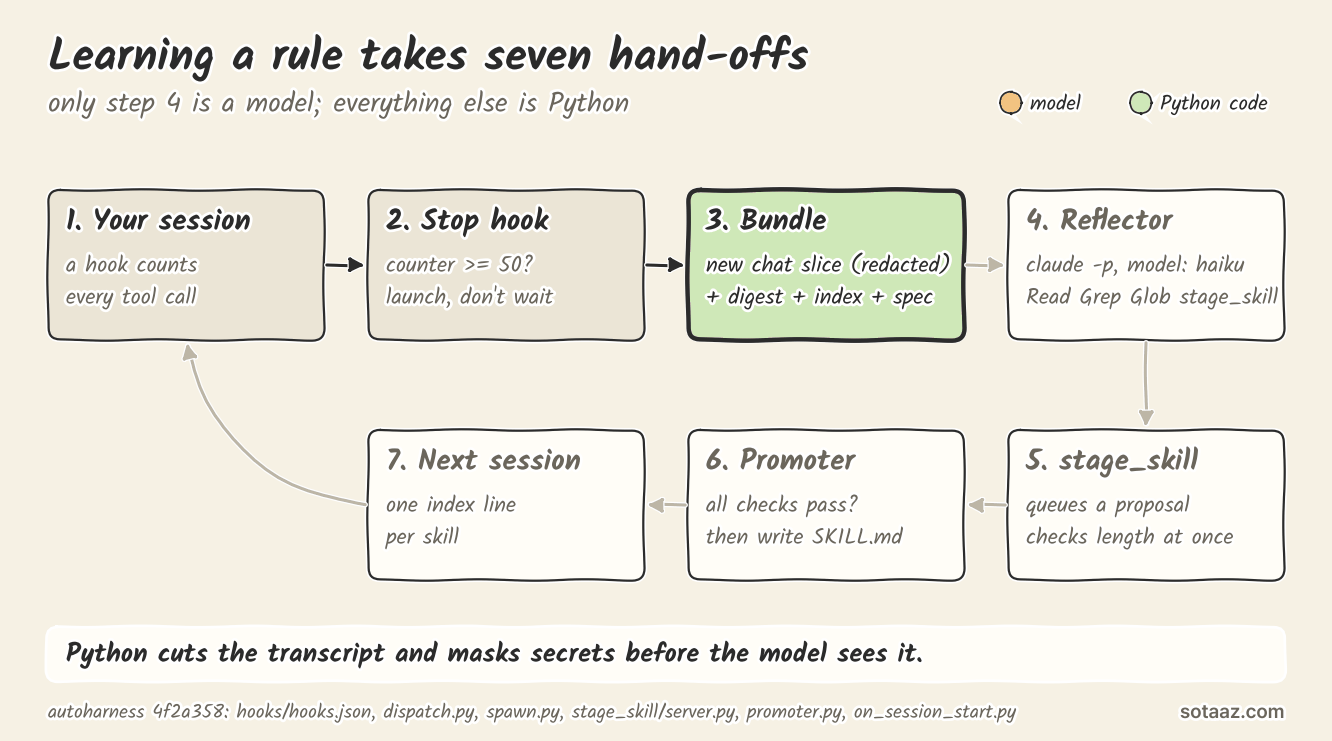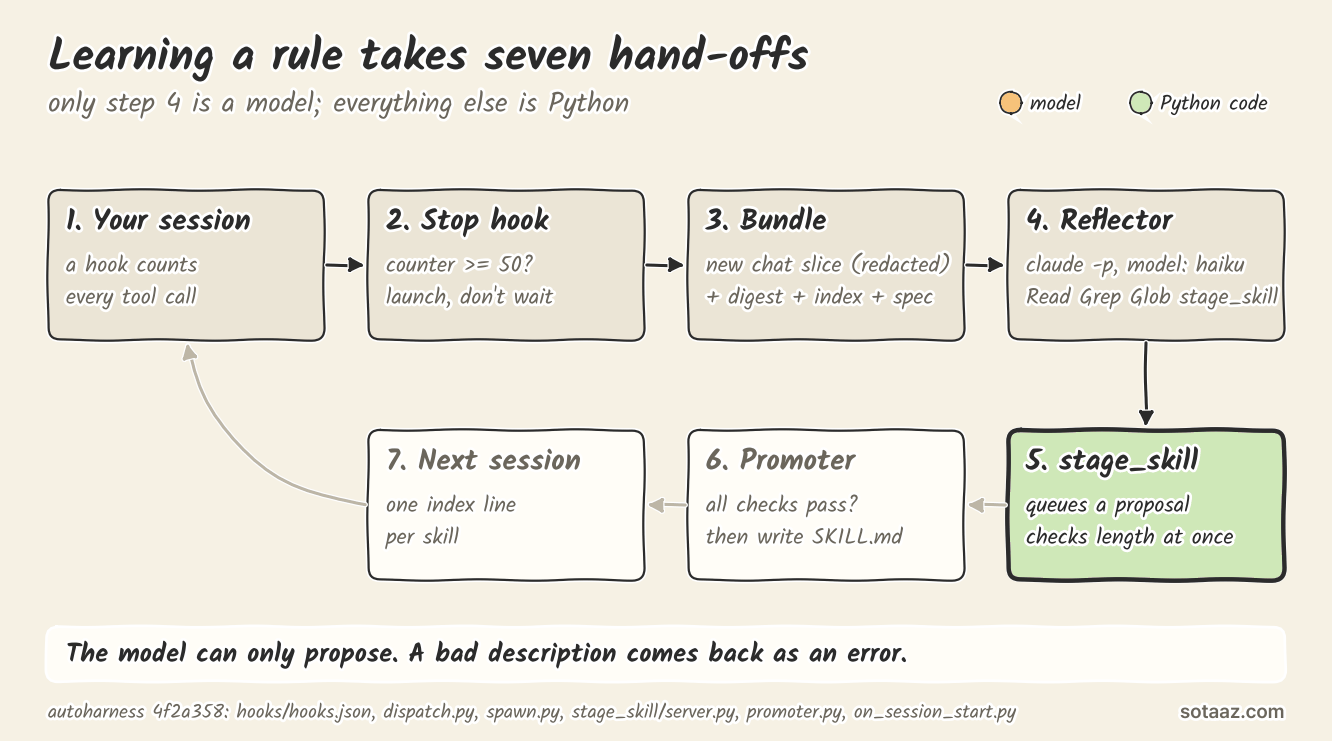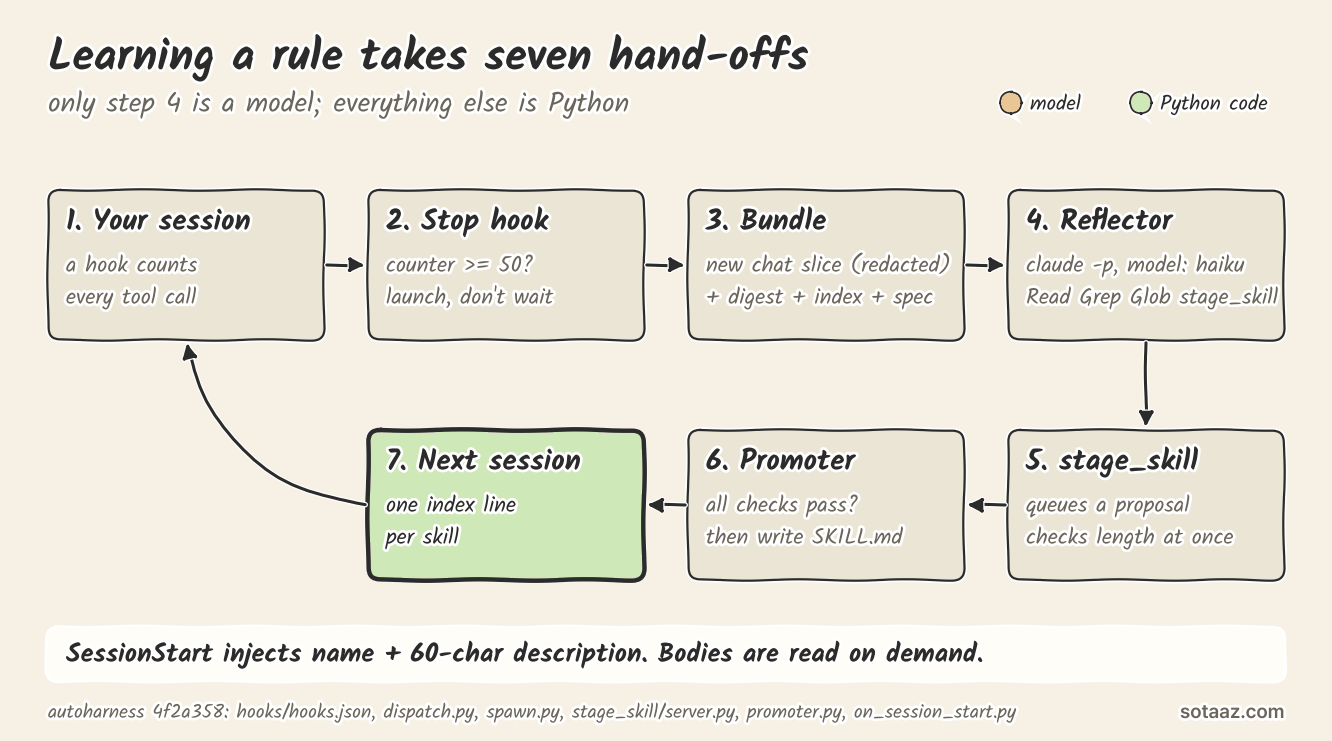
1단계. 훅 하나가 모든 이벤트를 받습니다
훅은 Claude Code가 정해진 순간마다 불러 주는 외부 명령입니다. hooks/hooks.json은 네 가지 순간에 훅을 겁니다. 세션 시작(SessionStart), 한 턴의 끝(Stop), 도구 실행 직전(PreToolUse), 세션 종료(SessionEnd)입니다. 넷 모두 같은 파이썬 모듈 autoharness.hook.dispatch를 부르고, 이 모듈이 사건 이름을 보고 갈래를 나눕니다.
횟수는 PreToolUse에서 셉니다. 본 세션이 도구를 한 번 쓸 때마다 세션별 카운터가 1 올라갑니다(dispatch.py:153-157). 턴이 끝날 때마다 on_stop이 이 카운터를 보고, 50(REFLECT_EVERY_N, config.py:32)에 닿으면 카운터를 비우고 되돌아보기를 시작합니다. 이 플러그인은 이 과정을 reflection이라고 부릅니다. 세션을 닫을 때도 도구를 한 번이라도 썼다면 남은 부분으로 한 번 더 돌립니다.
2단계. 두 번째 세션을 띄우고 기다리지 않습니다
사용자는 기다리지 않습니다. dispatch.py:87-98이 subprocess.Popen(..., start_new_session=True)로 작업을 따로 띄우고, 입출력은 모두 /dev/null로 버립니다. 사용자의 턴은 평소처럼 끝나고 작업은 혼자 돕니다.
이 작업은 네 가지를 묶어 넘깁니다(spawn.py:56-66).
- 지난번 reflection 뒤로 쌓인 대화. 대화 기록 파일에서 지난번에 읽은 위치 다음부터 잘라 냅니다(
capture.window). - 그 앞 20번의 주고받음을 줄인 요약. 글과 도구 이름만 남기고 "근거로 쓰지 말 것"이라고 표시합니다.
- 이미 있는 스킬 전부의 한 줄 목록.
- 새 스킬이 지켜야 할 형식 명세.
넘기기 전에 대화 토막은 lib/redact.py를 거칩니다. redaction_rules.toml의 규칙(비밀값 13개, 개인정보 4개)으로 API 키나 이메일 같은 값을 가립니다.
그다음 Claude Code를 새로 하나 실행합니다(spawn.py:103-109).
claude -p --agent autoharness:reflector --dangerously-skip-permissions묶음은 표준 입력으로 들어갑니다. reflector 에이전트는 agents/reflector.md에 정의되어 있습니다. 쓸 수 있는 도구는 Read, Grep, Glob, 그리고 stage_skill 하나뿐입니다. Write도 Edit도 Bash도 없습니다. 모델은 haiku로 지정되어 있습니다. 승인을 눌러 줄 사람이 없으니 권한 질문은 끕니다. 대신 도구 목록을 좁히고, 파일 쓰기를 막는 훅을 하나 더 둬서 할 수 있는 일을 묶어 둡니다.
뒤의 실측과 이어지는 부분이 하나 있습니다. child_env(spawn.py:112-117)는 사용자의 환경 변수를 통째로 복사하고 표시용 변수 세 개만 더합니다. 그러니 ANTHROPIC_BASE_URL로 Claude Code를 다른 서버에 연결해 두었다면 reflector도 그 서버로 갑니다.
3단계. 모델은 제안만 합니다
"요약해 두고 불러 쓴다"와 갈라지는 첫 지점입니다.
stage_skill은 스킬을 쓰지 않습니다. 제안 하나를 큐 파일 끝에 덧붙일 뿐입니다(stage_skill/server.py). 코드에서는 이 제안을 intent라고 부릅니다. intent에는 할 일(create, update, patch, remove_file, delete 중 하나), 내용, 이유(reason), 근거(evidence)가 들어갑니다. reflector는 근거를 대화에서 글자 그대로 따오라는 지시를 받습니다.
자식 세션이 끝나면 promoter.drain이 큐를 읽습니다(spawn.py:179). 스킬 폴더에 쓰는 코드는 promoter 하나뿐입니다. 파일 첫 줄 설명에도 "호스트 스킬 트리를 쓰는 유일한 결정론적 코드"라고 적혀 있습니다. promoter는 intent마다 최종 파일을 메모리에서 만들고, 검사를 돌리고, 모두 통과해야만 씁니다(promoter.py:161-237).
lib/validate.py의 검사에는 언어 모델이 끼지 않습니다. 이런 항목이 있습니다.
- safety:
skills_guard.py의 정규식으로 외부 유출, 프롬프트 인젝션, 파괴적인 명령을 찾습니다. - secret: 가리기 규칙을 최종 글에 한 번 더 돌립니다.
- structure: 앞머리 정보(frontmatter)가 읽히고
name과description이 있어야 합니다. - completeness: 본문이 비어 있으면 안 되고, TODO 같은 자리 표시 글도 안 됩니다.
- description: 한 문장, 60자 이하여야 합니다. 이 설명이 그대로 목록의 한 줄이 되기 때문입니다.
- global: 모든 프로젝트에 쓰일 스킬에는 절대 경로나 이 리포 이름이 들어가면 안 됩니다.
- evidence:
reason과evidence가 있어야 합니다. - self-produced:
update,patch,delete는 autoharness가 직접 만든 스킬에만 쓸 수 있고,create도 autoharness가 만들지 않은 스킬을 덮어쓸 수 없습니다(validate.py:336-339).
마지막 검사 덕분에 사용자가 손으로 쓴 스킬은 건드리지 않습니다. 검사를 통과한 새 스킬 옆에는 created_by: agent라고 적힌 작은 기록 파일이 붙습니다. 이 표시가 없는 스킬은 고치지도, 지우지도, 덮어쓰지도 못합니다.
검사 하나라도 실패하면 아무것도 쓰지 않습니다. 모두 통과하면 딸린 파일을 먼저 쓰고 SKILL.md를 맨 마지막에 한 번에 바꿔 끼웁니다. 그래서 아직 없는 파일을 가리키는 스킬이 읽히는 순간이 생기지 않습니다. 따온 근거는 스킬 옆 references/evidence-<hash>.md에 남으니, 어떤 규칙이 어느 대화의 어느 부분에서 나왔는지 언제든 볼 수 있습니다.
4단계. 다음 세션은 요약이 아니라 목록을 봅니다
"요약을 불러 쓴다"와 갈라지는 두 번째 지점입니다.
세션이 시작되면 recall_index(on_session_start.py:58-85)가 스킬마다 이름 [층]: 설명 한 줄을 만들어 분류별로 묶고, 추가 맥락으로 넣어 줍니다. 여기서 층은 스킬이 이 프로젝트용(project)인지 모든 프로젝트용(global)인지를 뜻합니다. 목록에는 autoharness가 만든 스킬만 오릅니다. 목록 머리말은 지금 일과 맞는 스킬이 있으면 열어 보라고 모델에게 말합니다.
전체 지시문은 각 SKILL.md에 남아 있고, 모델이 필요하다고 판단할 때만 읽습니다. 저희 실측(아래)에서 목록 한 줄은 92-95자였습니다. 이름, 층, 그리고 60자로 묶인 설명이 전부입니다. 이 폭이면 스킬이 50개여도 세션 시작에 약 4,700자만 더해지고, 스킬 본문이 얼마나 길든 늘지 않습니다. 저희 실측에서 저장된 SKILL.md 네 개를 통째로 넣는다면 하나에 약 750자로 여덟 배입니다. 요약에는 아예 상한이 없어서, 배운 것이 쌓이는 만큼 계속 길어집니다.
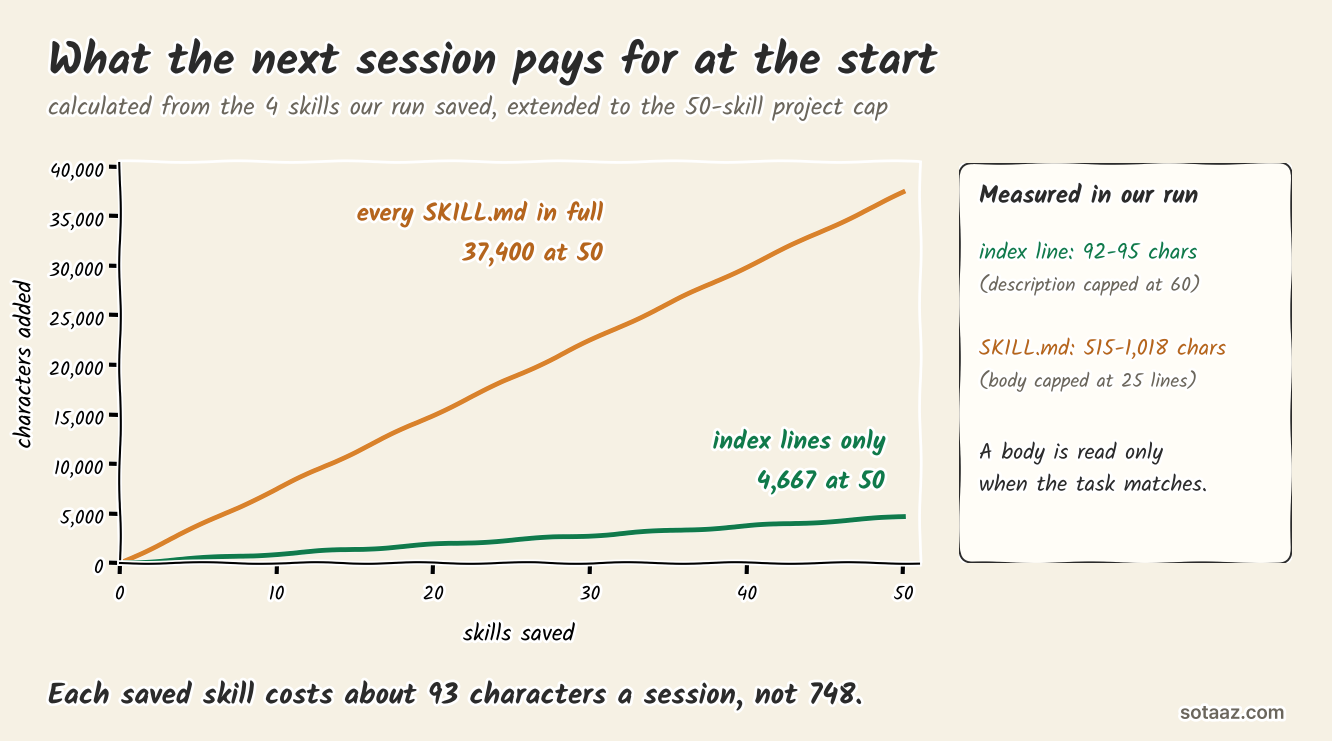
형식 명세도 내용을 짧게 쓰도록 이끕니다. 스킬 본문은 25줄까지이고(SKILL_BODY_MAX_LINES), reflector는 "이번 일을 다시 이야기하지 말라"는 지시를 받습니다. 이야기 대신 규칙을 쓰라는 뜻입니다. 자세한 내용은 필요할 때만 읽는 references/ 파일로 보냅니다.
5단계. 아무도 쓰지 않는 스킬은 치웁니다
저희가 가장 흥미롭게 본 부분입니다. 저희가 평소에 손으로 하는 일이기 때문입니다.
autoharness는 스킬을 쓸 때 그 프로젝트가 지금까지 몇 턴을 지났는지 적어 둡니다. 그 뒤로 on_skill_call.py가 스킬마다 숫자 두 개를 셉니다. 모델이 Skill 도구로 스킬을 부르면 use가, 본 세션이 스킬 폴더 안의 파일을 읽으면 view가 올라갑니다. 파일 설명에는 저자들의 실험에서 모델이 Skill 도구를 부르기보다 거의 언제나 SKILL.md를 직접 읽었다고 적혀 있습니다.
세션이 시작될 때마다 lifecycle.evaluate(lib/lifecycle.py:23-45)가 무엇을 치울지 정합니다.
- 수습 기간. 프로젝트 스킬은 100턴이 지나기 전까지 건드리지 않습니다.
- 졸업 심사. 100턴이 되었을 때
use도view도 0이면 보관함으로 옮깁니다. 읽히기만 하고 불린 적 없는 스킬은 남깁니다. - 정원.
use가 한 번이라도 있는 스킬은 프로젝트당 50자리를 두고 겨룹니다. 50을 넘으면 턴당use가 가장 낮은 것부터 나갑니다. 이 비율에는view를 절대 넣지 않습니다(tests/test_lifecycle.py의test_view_never_feeds_the_rate).
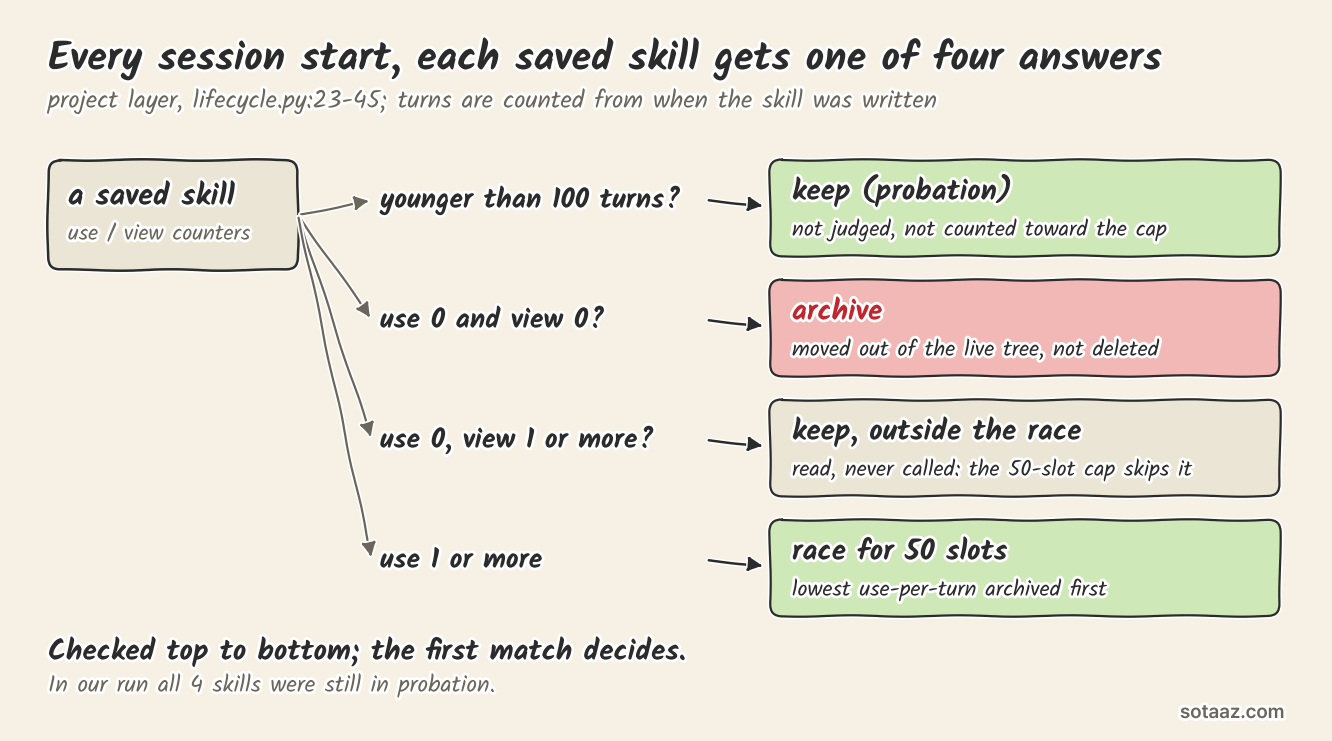
보관은 폴더를 살아 있는 스킬 폴더 밖으로 옮기는 것이고, 지우지는 않습니다.
여기에 더해 250턴마다 curator라는 두 번째 에이전트가 autoharness가 만든 스킬만 훑어서, 범위가 좁은 스킬을 넓은 스킬에 합칩니다(agents/curator.md). curator가 돌기 전에 스킬 전체를 압축 파일로 떠 두고, 층마다 다섯 개까지 남깁니다(spawn.py:184-197).
그래서 그냥 "요약해 두고 불러 쓰기"인가요?
생각 자체는 맞습니다. 3,104줄이 더하는 것은, 사람 없이 몇 주를 돌려야 드러나는 문제 세 가지에 대한 답입니다.
- 크기. 다음 세션은 지금까지 배운 것 전부가 아니라 스킬당 한 줄만 읽습니다.
- 누가 쓰는가. 모델은 제안하고, 정해진 규칙대로 도는 코드가 검사하고 씁니다. 사용자가 쓴 것은 고치지 않습니다.
- 낡음. 쓰이지 않는 것은 치우니, 오래된 규칙이 끝없이 쌓이지 않습니다.
저희도 이 블로그 작업의 기억을 손으로 같은 방식으로 관리합니다. 한 줄짜리 목록을 두고, 규칙마다 파일을 따로 쓰고, 틀린 것으로 드러나면 지웁니다. autoharness는 이 일을 도구 호출 50번마다, 따로 시키지 않아도 합니다.
코드만 읽어서는 모르는 것
코드를 읽으면 고리가 어떻게 짜여 있는지는 압니다. 그 고리가 좋은 스킬을 만드는지는 모릅니다.
- reflector는 "넉넉하게 남기라"는 지시를 받습니다. 치우는 것은 싸고 잊는 것은 비싸다는 이유입니다. 그러면 약한 규칙이 잔뜩 쌓여 100턴 동안 수습 기간에 머물 수 있습니다.
- 읽히기만 하고
Skill도구로 불린 적 없는 스킬은 졸업 심사에서 살아남고, 정원 경쟁에는 들어가지 않습니다. 그러니 50자리 상한이 적용되지 않습니다. 저자들 말대로 모델이 대부분 스킬을 직접 읽는다면 이런 스킬이 많아질 수 있습니다. 실제로 얼마나 되는지는 아직 모릅니다. - reflection 한 번은 Claude 세션 하나를 통째로 더 돌리는 일인데, README에는 한 번에 얼마가 드는지가 없습니다.
그래서 직접 돌려 봤습니다.
로컬 모델에 연결해 돌리기
이번 실측에는 Anthropic API를 전혀 쓰지 않았습니다. Claude Code도, 그 Claude Code가 띄우는 reflector도 저희 연구실 80 GB GPU 한 장에서 Strata로 띄운 Qwen3.8 Flash Next(IQ2_XS 양자화, 컨텍스트 65,536토큰)와 이야기했습니다. Strata는 Anthropic과 같은 /v1/messages API를 열어 주므로, Claude Code는 환경 변수만 바꾸면 붙습니다. 12 GB 카드에서 하는 방법까지 포함한 전체 과정은 Claude Code를 로컬 모델에 연결한 앞 글에 있습니다. 줄이면 이렇습니다.
export ANTHROPIC_BASE_URL=http://127.0.0.1:8090
export ANTHROPIC_AUTH_TOKEN=local
export ANTHROPIC_MODEL=claude-sonnet-4-5
export ANTHROPIC_SMALL_FAST_MODEL=claude-haiku-4-5
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1
export API_TIMEOUT_MS=1800000
export CLAUDE_CODE_MAX_OUTPUT_TOKENS=8192
모델 이름은 이름표일 뿐이고, Strata는 어떤 요청이든 올려 둔 모델 하나로 답합니다. 가장 중요한 것은 마지막 줄입니다. Claude Code는 기본으로 출력 32,000토큰을 요구합니다. Strata는 프롬프트와 출력 예산을 더한 값이 컨텍스트를 넘는 요청을 거절하므로, 세션이 길어지면 400 오류로 멈춥니다. 8,192로 낮추면 들어갑니다.
autoharness 때문에 따로 챙긴 것이 둘 있습니다.
- 플러그인 설치 위치. Claude Code에는
--plugin-dir옵션이 있지만, reflector는 새로 뜨는claude -p프로세스라 이 옵션을 받지 못합니다. 그래서claude plugin install로 별도 설정 폴더(CLAUDE_CONFIG_DIR)에 설치했습니다. 이 폴더 위치는 환경 변수라서 자식 세션에도 그대로 넘어갑니다. 덕분에 저희가 평소 쓰는 Claude Code 설정도 건드리지 않았습니다. - reflector의 모델.
reflector.md는haiku를 요구합니다. 하지만 자식 세션이 부모의 환경 변수를 그대로 받으므로(2단계), 요청은 같은 로컬 서버로 갔습니다. 대화 기록 네 개에 남은 응답은 모두qwen3.8-flash-next-iq2_xs가 보낸 것이었습니다.
블로그 코드 밖에 빈 git 리포를 만들고 이렇게 설정했습니다.
- autoharness는 10월 28일 버전(
697cf5e)으로 돌렸습니다. 위 줄 번호의 기준인 10월 29일 버전과의 사이에 커밋 19개(병합 4개 포함)가 있습니다. 가리기 규칙이 늘었고, 빈 본문 검사와 덮어쓰기 검사가 생겼고, 잠금, 대기열 복구, 남은 파일 청소가 고쳐졌습니다. 이 변경들은 저희 결과를 바꾸지 않았을 것입니다. reflector는 Read, Glob,stage_skill만 썼고, 대기열에 오른 제안은 모두 저장되었습니다. 새 가리기 규칙에 걸리는 내용은 저장된 스킬에 없었습니다. 스킬은 모두 새로 만든 것이고 본문이 있었으며, 리포에 사람이 쓴 스킬도 없었습니다. - reflection을 도구 호출 50번이 아니라 10번마다 돌게 했습니다(
AUTOHARNESS_REFLECT_EVERY_N=10). 짧은 세션 하나로 한 바퀴를 보기 위해서입니다. - 모든 프로젝트용(global) 스킬은 껐습니다(
AUTOHARNESS_DISABLE_GLOBAL=1). 모든 결과가 이 빈 리포 안에만 남게 하려는 것입니다. - 세션 A:
count_words(path)가 있는wordcount.py와 테스트를 쓰게 했습니다. 그리고 이 리포만의 규칙을 한 번만 말했습니다. 테스트는tests/가 아니라checks/에check_*.py로 둔다는 규칙입니다. - 세션 B: 같은 리포에서 새 세션을 열어
count_lines(path)와 테스트를 더하게 했습니다. 규칙은 다시 말하지 않았습니다.
첫 실행 전에 예측 다섯 개를 적어 두었습니다.
예측과 결과
표의 각 행은 예측 하나입니다. 가운데 열이 실행 전에 적은 예측이고, 오른쪽 열이 실제 결과입니다.
| 예측 | 결과 | |
|---|---|---|
| P1 | reflector의 요청이 로컬 서버에 닿음 | 맞음. reflector 요청 10개가 모두 Strata 로그에 있습니다 |
| P2 | Flash Next가 스킬을 글로 설명하는 데 그치지 않고 stage_skill을 실제로 부름 | 맞음. 세션 A 뒤 6번, 세션 B 뒤 5번 불렀습니다 |
| P3 | promoter가 제안을 하나 이상 거절함. 가장 유력한 이유는 60자를 넘는 설명 | 틀림. promoter는 6개 중 하나도 거절하지 않았습니다 |
| P4 | 세션 B가 저장된 스킬을 엶 | 열지 않는다고 예측했고, 맞음. 모든 스킬이 view 0, use 0이었습니다 |
| P5 | reflection 한 번에 1-5분 걸림 | 맞음. reflector 시작부터 쓰기 단계 끝까지 세션 A 뒤 90초, 세션 B 뒤 70초 |
P3는 틀렸고, 틀린 이유가 이 플러그인을 잘 보여 줍니다. 긴 설명은 실제로 나왔습니다. 새 스킬의 첫 설명은 모두 126-151자였습니다. 그런데 그중 하나도 promoter까지 가지 못했습니다. stage_skill이 제안을 받는 순간 구조 검사와 설명 검사를 먼저 돌리고(stage_skill/server.py:123-145), 실패하면 그 내용을 도구 결과로 돌려주기 때문입니다. 두 번의 reflection에서 stage_skill 호출 11번 중 5번이 이렇게 돌아왔습니다. 2번은 길이 때문이었고, 3번은 저희가 꺼 둔 global 층을 겨냥했기 때문이었습니다(층 검사가 길이 검사보다 먼저 돕니다). reflector는 오류를 읽고 다시 제출했고, 새 스킬의 설명은 모두 59자나 60자로 끝났습니다. promoter가 돌 때는 이미 모든 제안이 검사를 통과할 상태였습니다.
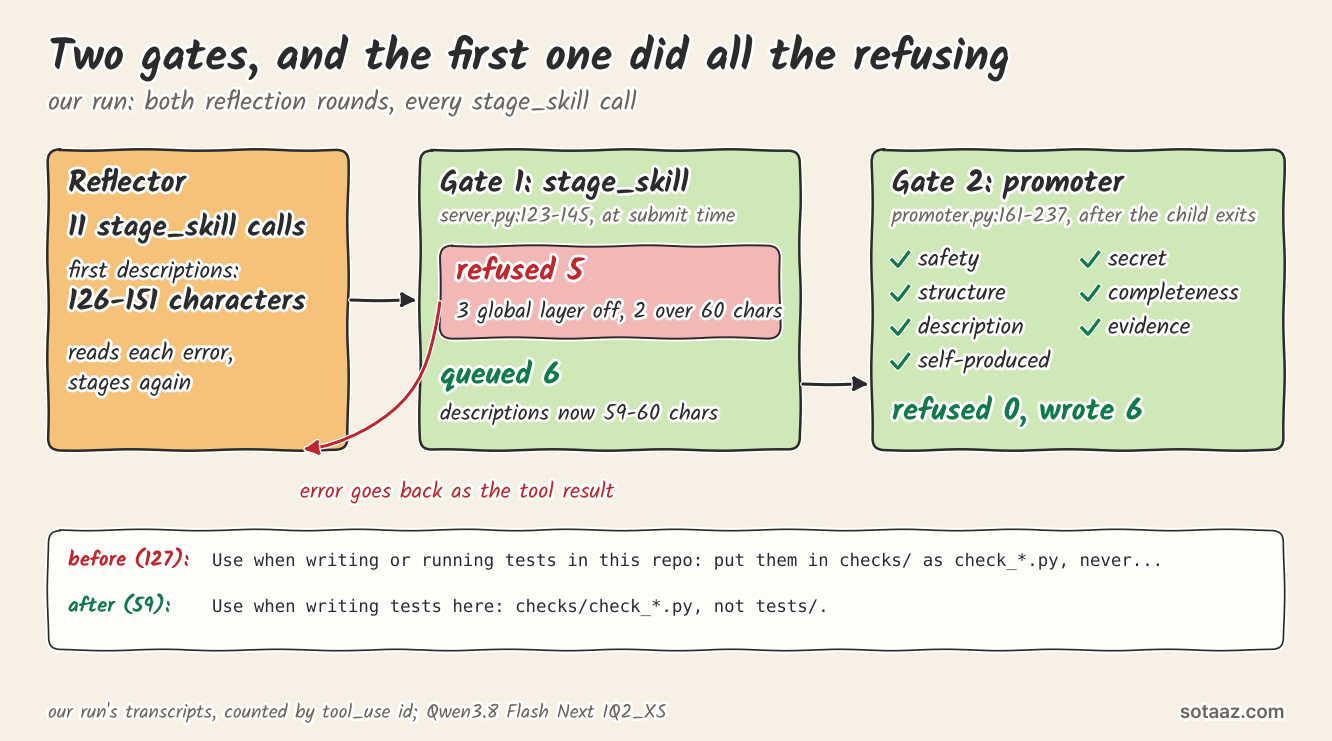
그러니 60자 규칙은 걸러 내는 체라기보다 고쳐 쓰게 만드는 편집자에 가깝습니다. 세션 A 뒤에 저장된 스킬 하나를 그대로 옮깁니다.
---
name: test-location-checks
description: "Use when writing tests here: checks/check_*.py, not tests/."
category: testing
---

Tests in this repo go in `checks/` as `check_*.py` — never a `tests/` directory, never `test_*.py` files. Run them with `python -m pytest -q` from the project root and confirm they pass before reporting the work done.

Collection depends on the pytest config in `pyproject.toml`; if that file is missing, start from `templates/pyproject-pytest.toml`. Use pytest's `tmp_path` fixture for test data rather than writing files into the repo.
테스트는 checks/에 check_*.py로 두고, 프로젝트 루트에서 python -m pytest -q로 돌려 통과를 확인한 뒤에 일을 마쳤다고 보고하라는 내용입니다.
38초짜리 세션 A에서 스킬이 두 개 더 나왔습니다. pytest-import-path는 세션이 시험해 보지 않은 규칙을 적었습니다. 그냥 pytest로 돌리면 리포 맨 위 모듈을 못 불러온다는 내용인데, 세션 A는 과제가 시킨 대로 python -m pytest만 돌렸습니다. 세 번째 memory-file-placement는 저희도 예상하지 못했습니다. 세션 A에서 본 모델이 자기 기억 메모를 처음에 리포 안에 썼다가, 실수를 알아채고 제자리에 다시 쓰고 잘못 둔 사본을 지웠습니다. reflector는 이 실수를 규칙으로 바꿨습니다. 세션 B 뒤에는 네 번째 스킬(text-unit-counting)이 저장되었고, test-location-checks가 두 번 고쳐졌습니다. 실제 코딩 약 1분에 쓰기가 여섯 번 일어난 셈입니다. "넉넉하게 남기라"는 지시가 실제로는 이런 모습입니다.
한 번 도는 데 드는 양. 세션 A 뒤의 reflection은 서버에 요청 3개를 보냈고, 입력은 모두 154,032토큰, 출력은 8,732토큰이었습니다. 정작 그 reflection이 되돌아본 코딩 세션의 출력은 2,732토큰이었습니다. reflector 프롬프트 하나가 가장 클 때 56,463토큰이었고, 여기에 출력 예산 8,192토큰을 더하면 65,536토큰 중 64,655토큰을 씁니다. 대화 토막이 조금만 더 길었다면 이 reflection은 위에서 말한 400 오류로 실패했을 것입니다.
세션 B와 목록. 세션 B가 시작될 때 세 줄짜리 스킬 목록이 들어간 것은 대화 기록에서 확인했습니다. 하지만 세션 B는 스킬을 한 번도 열지 않았습니다. 새 테스트를 checks/에 두기는 했는데, 이것을 autoharness 덕분으로 볼 수는 없습니다. 이유는 셋입니다. 기존 테스트 파일이 이미 그 폴더에 있었고, 모델이 먼저 폴더 목록을 봤고, Claude Code 자체의 기억 기능도 세션 A에서 같은 규칙을 저장해 두었습니다. 같은 규칙이 Claude Code 쪽에 한 번, autoharness 쪽에 한 번, 두 번 저장된 것입니다.
세션마다 한 번씩 돌린 결과이고, reflection 간격은 50번이 아니라 10번이었고, 로컬 모델 하나로만 했습니다. 이 결과로 알 수 있는 것은 로컬 모델에서도 고리가 끝까지 돈다는 점과 어디가 빠듯한지입니다. 몇 주에 걸쳐 스킬이 도움이 되는지는 알 수 없습니다.
직접 설치한다면
첫 reflection이 끝나면 .claude/skills/를 열어 새로 생긴 SKILL.md를 모두 읽어 보세요. 하나하나가 25줄 이하이고 근거가 된 대화가 references/에 같이 있으니, 몇 분이면 됩니다. 저희 실측에서는 코딩 약 1분에 스킬 네 개가 생겼고, 그중 하나는 모델이 스스로 고친 실수에서 나왔습니다. 그중 무엇을 남길지는 여전히 사용자가 정할 일입니다. 수습 기간이 100턴이라 한동안은 아무것도 자동으로 치워지지 않습니다.
저희는 앞으로도 이런 도구를 열어서, 코드가 실제로 하는 일과 소개하는 말을 대조해 보겠습니다. 다음 편을 메일로 받고 싶으시면 아래에서 뉴스레터를 구독해 주세요.