GPU 메모리 12GB 안에서 Claude Code를 로컬 Qwen3.8-Flash-Next로 돌리기: llama.cpp와 Strata 따라 하기
Claude Code를 환경변수만 바꿔 12GB로 묶어 둔 로컬 Qwen3.8-Flash-Next에 붙이는 방법을 llama.cpp와 Strata 두 가지로 따라 합니다. Claude Code가 처음 보내는 약 28K토큰을 읽는 데 llama.cpp는 139-161초, Strata는 약 12초가 걸렸습니다. Strata는 대화가 약 33,500토큰을 넘으면 출력 상한 32,000 때문에 요청을 거절하므로 CLAUDE_CODE_MAX_OUTPUT_TOKENS=8192를 함께 넣습니다.
GPU 메모리 12GB 안에서 Claude Code를 로컬 Qwen3.8-Flash-Next로 돌리기: llama.cpp와 Strata 따라 하기
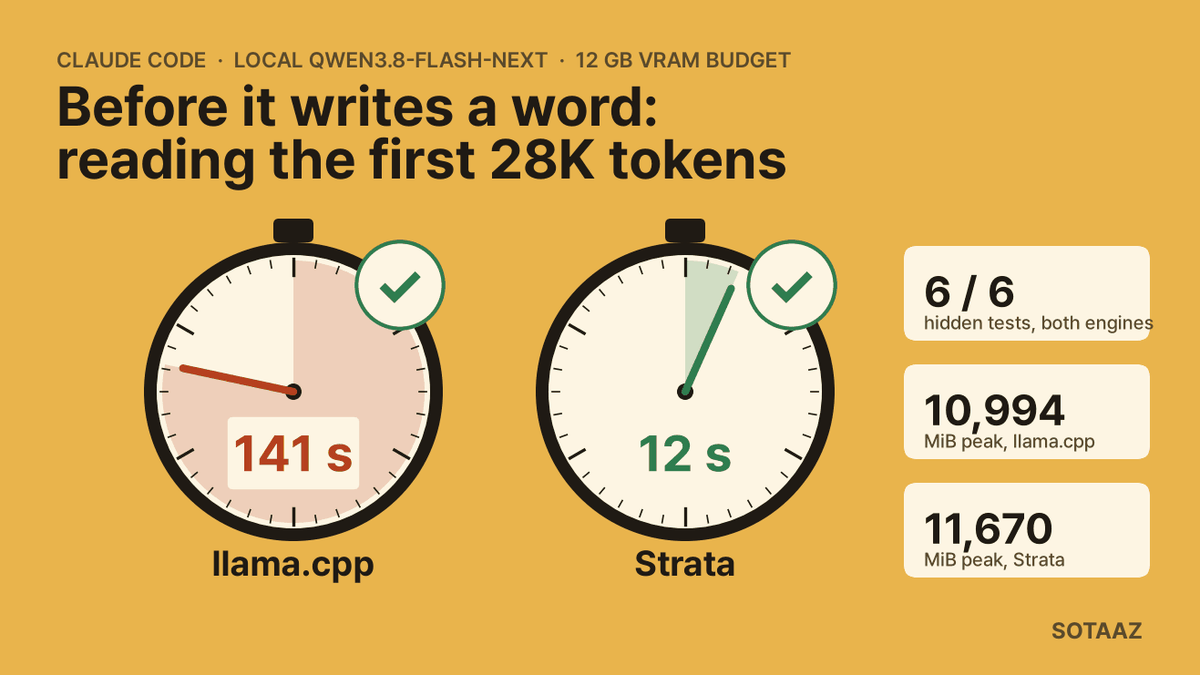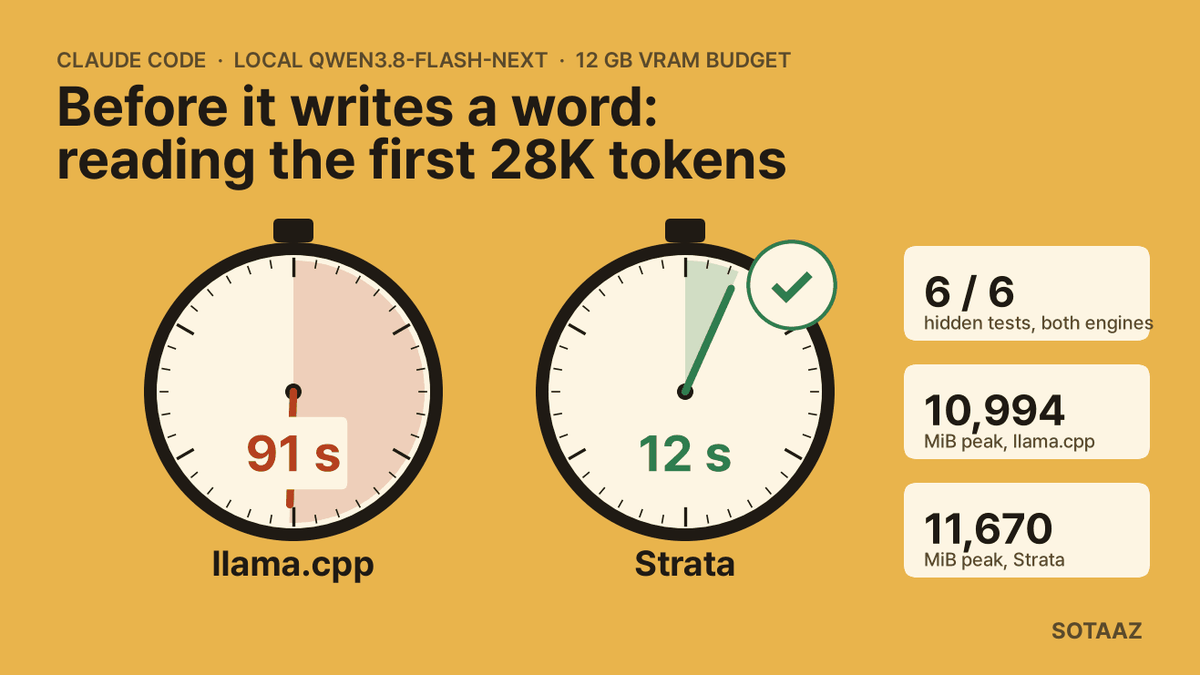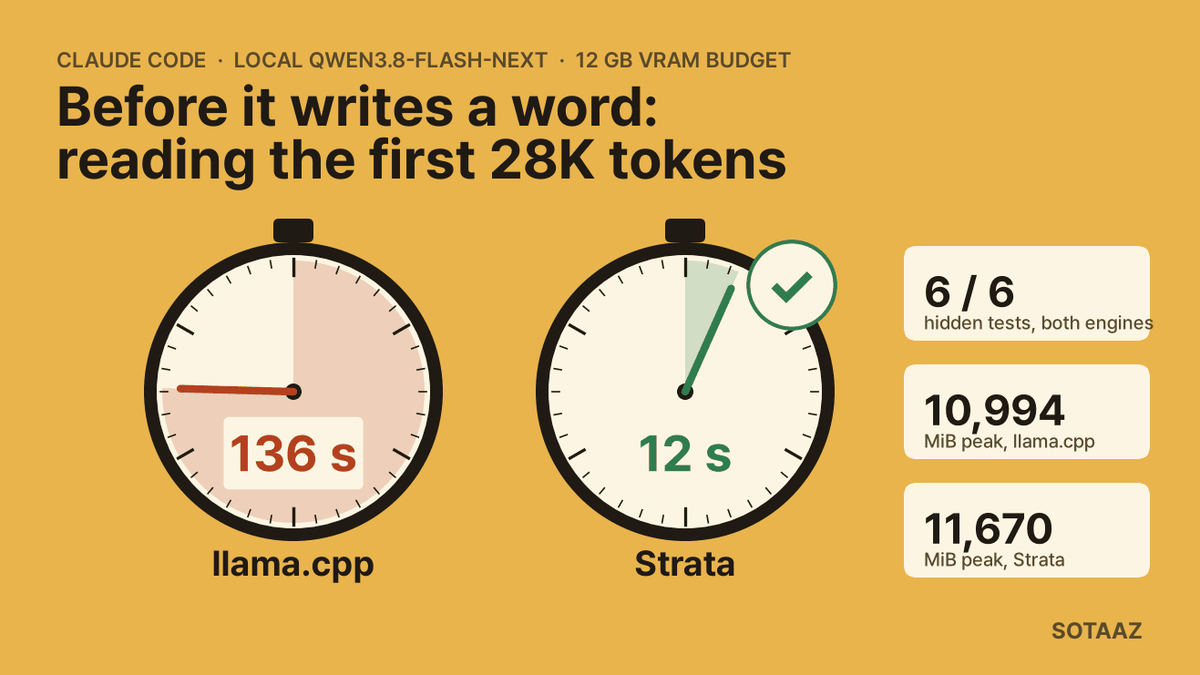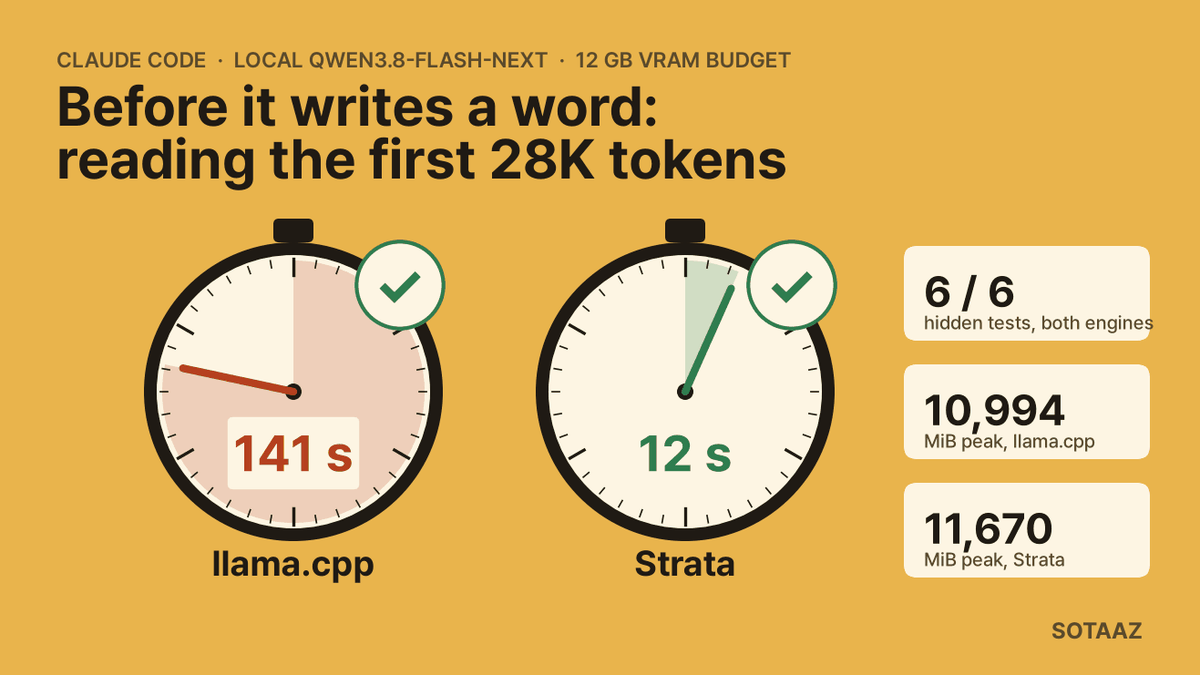
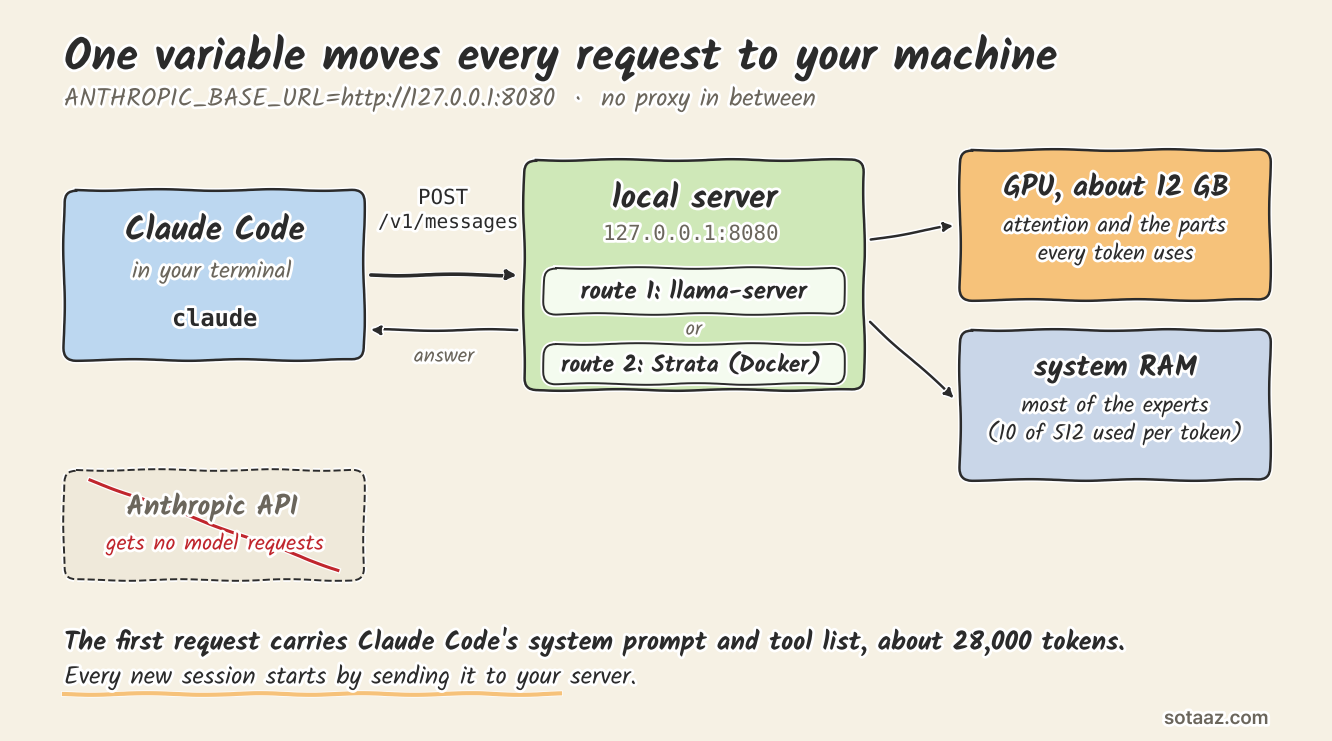
Claude Code는 프로젝트 파일을 열기 전에 모델에게 약 28,000토큰을 먼저 보냅니다. 자기 시스템 프롬프트와 쓸 수 있는 도구 설명입니다. 저희는 이 요청을 12GB 안에서 돌아가는 로컬 Qwen3.8-Flash-Next로 보내봤습니다. llama.cpp는 이 첫 요청을 읽는 데만 139-161초가 걸렸고, 그동안 모델은 한 글자도 쓰지 않았습니다. 같은 요청을 Strata는 약 12초에 읽었습니다. 그 뒤에도 차이는 줄지 않았습니다. 답을 쓰는 속도가 llama.cpp는 초당 약 7토큰, Strata는 약 35토큰이었기 때문입니다. Strata는 기본값인 추측 디코딩(speculative decoding)을 켠 상태였고, 이 속도는 실행이 끝난 뒤 두 엔진이 각자 남긴 로그 줄로 계산했습니다.
이 글은 두 방법을 처음부터 따라 할 수 있게 저희가 실제로 사용한 명령을 바탕으로 정리했습니다. 측정용 스크립트와 다른 점은 글 끝 측정 환경에 적었습니다. 방법마다 시작 시간, 기다리는 시간, 메모리가 얼마나 드는지도 함께 적습니다. 둘 중 하나만 고르면 됩니다. Strata를 고른다면 변수 하나를 꼭 더 넣어야 합니다. 저희는 처음에 그 변수 없이 돌렸다가 작은 기능 추가 두 번이 모두 오류로 끝났습니다(6절).
0. 무엇을 할 수 있나
Claude Code는 Anthropic이 만든 터미널용 코딩 에이전트입니다. 모델과는 /v1/messages라는 HTTP 주소 하나로 대화합니다. llama.cpp의 llama-server와 Strata는 둘 다 이 주소를 직접 열어 주기 때문에, 중간에 LiteLLM 같은 변환기를 두지 않아도 됩니다. 환경변수 몇 개만 바꾸고 평소처럼 claude를 실행하면 됩니다.
llama-server와 Strata에 대한 설명은 Strata와 llama.cpp 비교 글을 참고해 주세요.
같은 기계, 같은 모델 파일, 같은 과제로 잰 두 방법의 차이입니다.
| ① llama.cpp | ② Strata | |
|---|---|---|
| 설치 | 실행 파일 하나 빌드 | Docker 이미지 빌드 |
| 서버 시작 | 9-20초 | 정상적으로 뜬 11번 중 6번은 약 30-50초, 5번은 4-10분(원인 확인 못 함) |
| 첫 요청(약 28K토큰) | 139-161초 | 약 12초 |
| 작은 버그 수정 전체 | 280-370초(3회) | 46-58초(3회) |
| 작은 기능 추가, 숨긴 테스트 통과 | 2회 모두 6/6, 1,136초·1,417초 | 출력 상한을 넣은 2회 모두 6/6, 184초·190초 |
| GPU 메모리 최고치 | 10,994MiB | 11,670MiB |
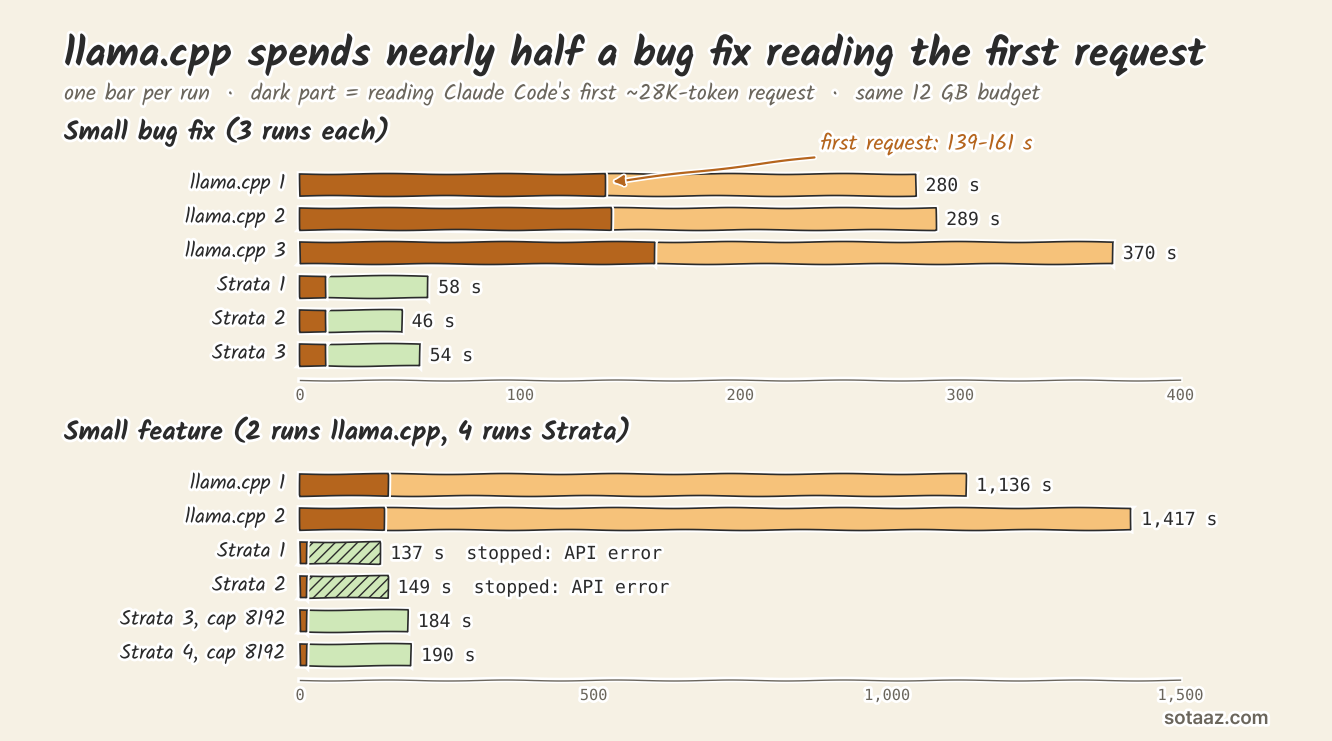
숫자를 보기 전에 알아 둘 점이 있습니다. 저희에게는 12GB 카드가 없어 A100 80GB에서 각 엔진이 약 12GB만 쓰도록 묶어 두고 쟀습니다. 앞서 쓴 Strata와 llama.cpp 비교 글도 같은 방식이었습니다. 이 GPU는 게임용 그래픽 카드보다 계산이 빠르고, 서버 CPU 8코어(2.25GHz)는 데스크톱 CPU보다 느릴 수 있습니다. 그래서 여러분 기계에서 측정하면 이 글과는 차이가 있을 수 있습니다. 수행 시간보다는 12GB 안에서 돌아가는지에 초점을 맞춰 읽어 주세요. 참고로 Strata README에는 첫 메시지를 읽는 데 "30,000토큰에 약 1분"이 걸린다고 적혀 있습니다(저희는 약 12초). CPU는 최대한 데스크톱과 비슷하게 맞추기 위해 AMD EPYC 7742의 8코어만 썼습니다. 다른 작업과 같이 쓰는 기계라 실행마다 1분 부하 중앙값이 23-49였습니다. 가장 느린 llama.cpp 실행(370초)과 Strata 실행 한 번은 다른 프로그램(9,920MiB)이 같은 GPU를 쓰는 동안 돌았습니다. Strata 기능 추가 실행 한 번에도 다른 414MiB 프로세스가 같은 GPU에 있었습니다.
1. 공통 준비
- 12GB NVIDIA GPU. 엔진 프로세스 기준 최고치는 llama.cpp 10,994MiB, Strata 11,670MiB였습니다. 12GB는 12,288MiB이므로 Strata는 엔진 프로세스 기준 약 600MiB, GPU 전체 최고치(11,753MiB) 기준 535MiB가 남습니다. 실제 12GB 카드는 화면 출력과 드라이버가 따로 메모리를 쓰고, 저희는 그 카드에서 시험하지 않았습니다.
- 시스템 RAM 64GB. llama.cpp 프로세스는 실행이 끝날 때 47.0-50.4GiB였고, 대부분은 메모리에 매핑한 모델 파일이었습니다. Strata 컨테이너는 약 37-40GiB를 썼습니다. RAM이 더 적은 기계는 시험하지 않았습니다.
- 디스크는 llama.cpp에 약 70GB, Strata에 약 90GB가 필요합니다. Strata는 모델과 설정 데이터를 따로 받고 Docker 이미지도 있어서 둘 다 해 보려면 약 160GB입니다. 모델은 ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF의
IQ2_XS폴더, 파일 두 개입니다. - Claude Code. 저희는 2.1.302를 썼습니다.
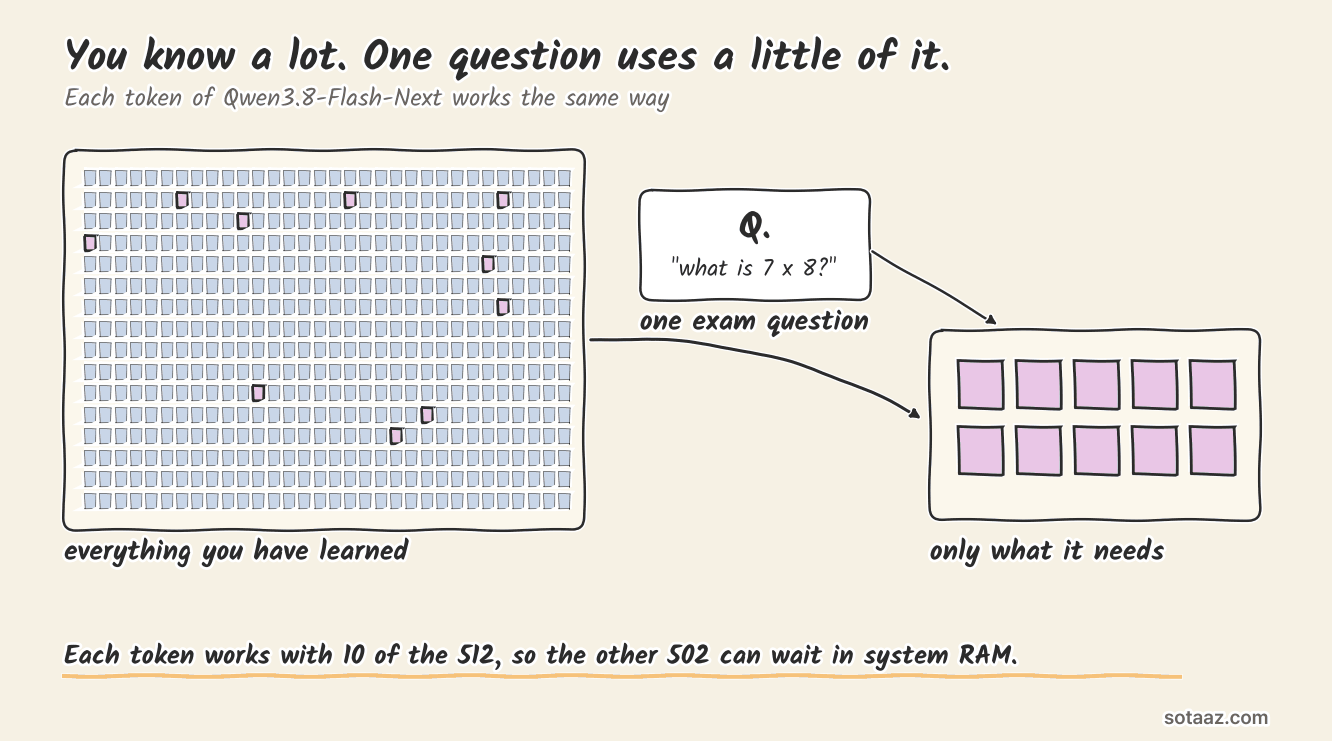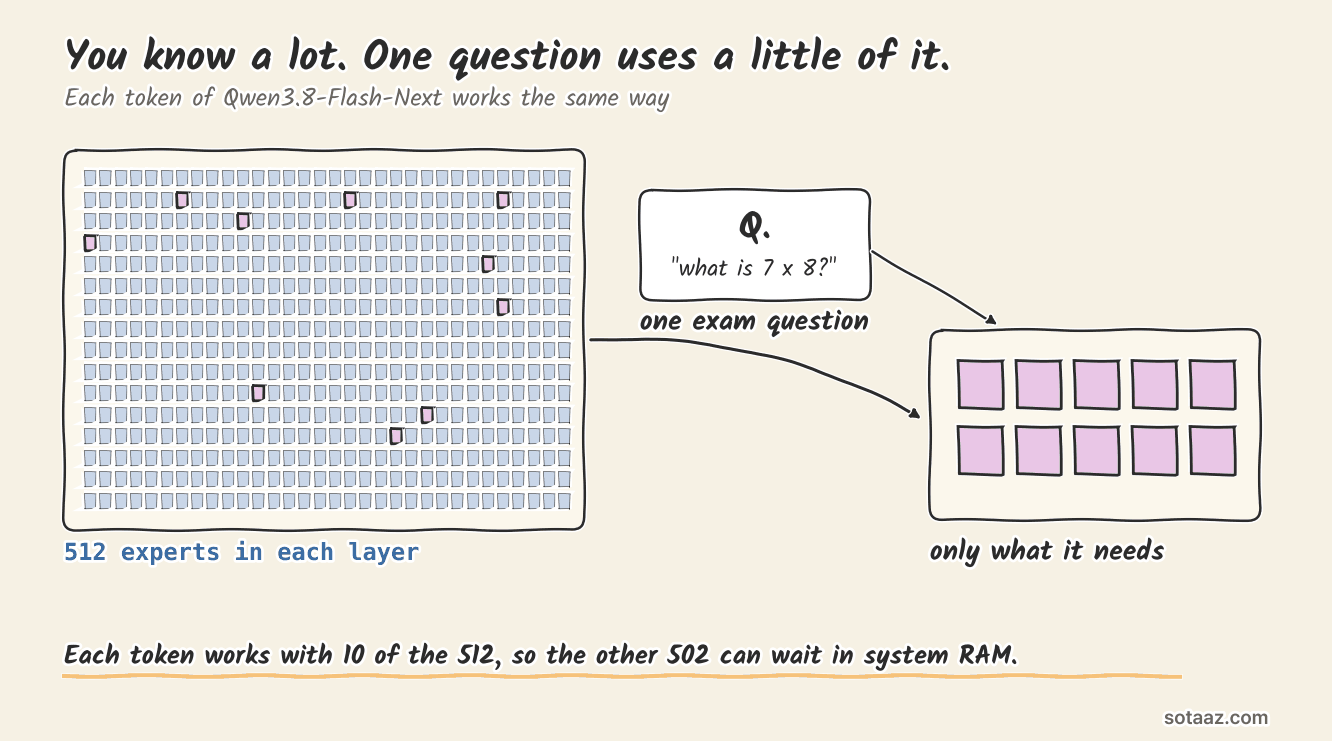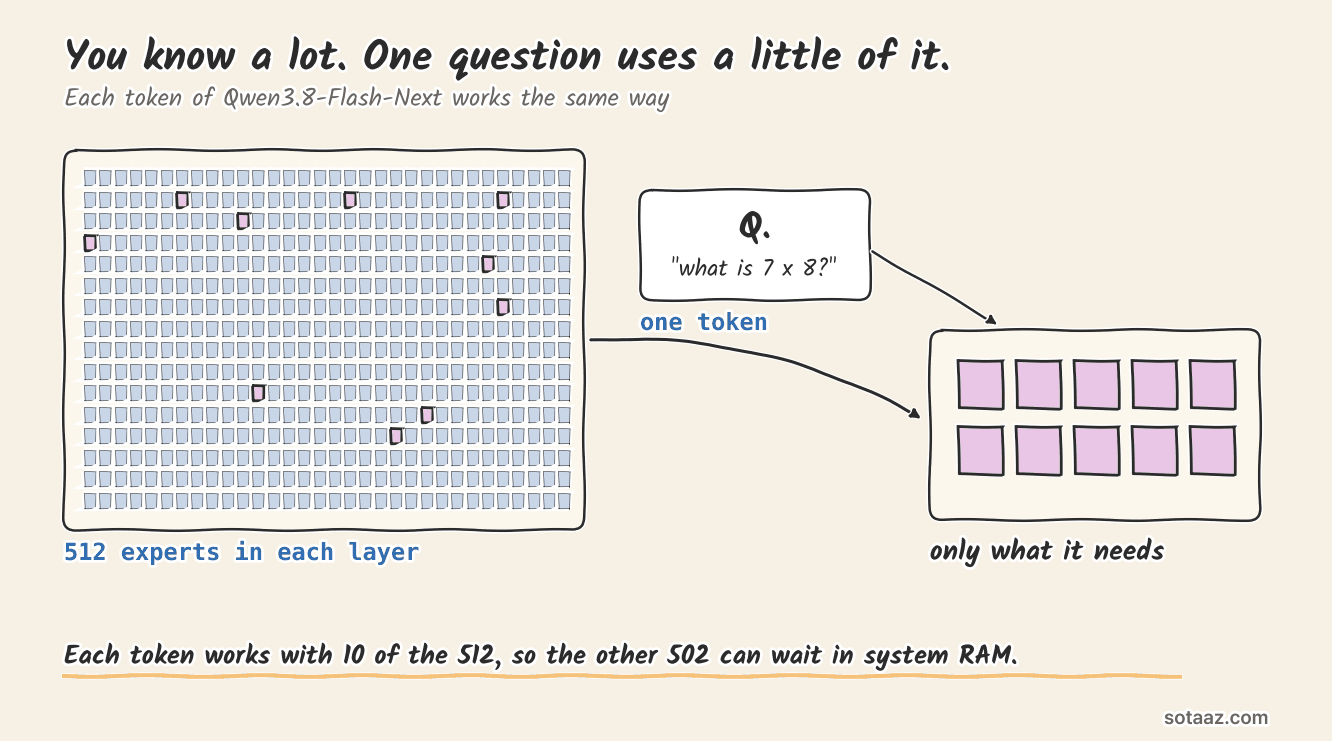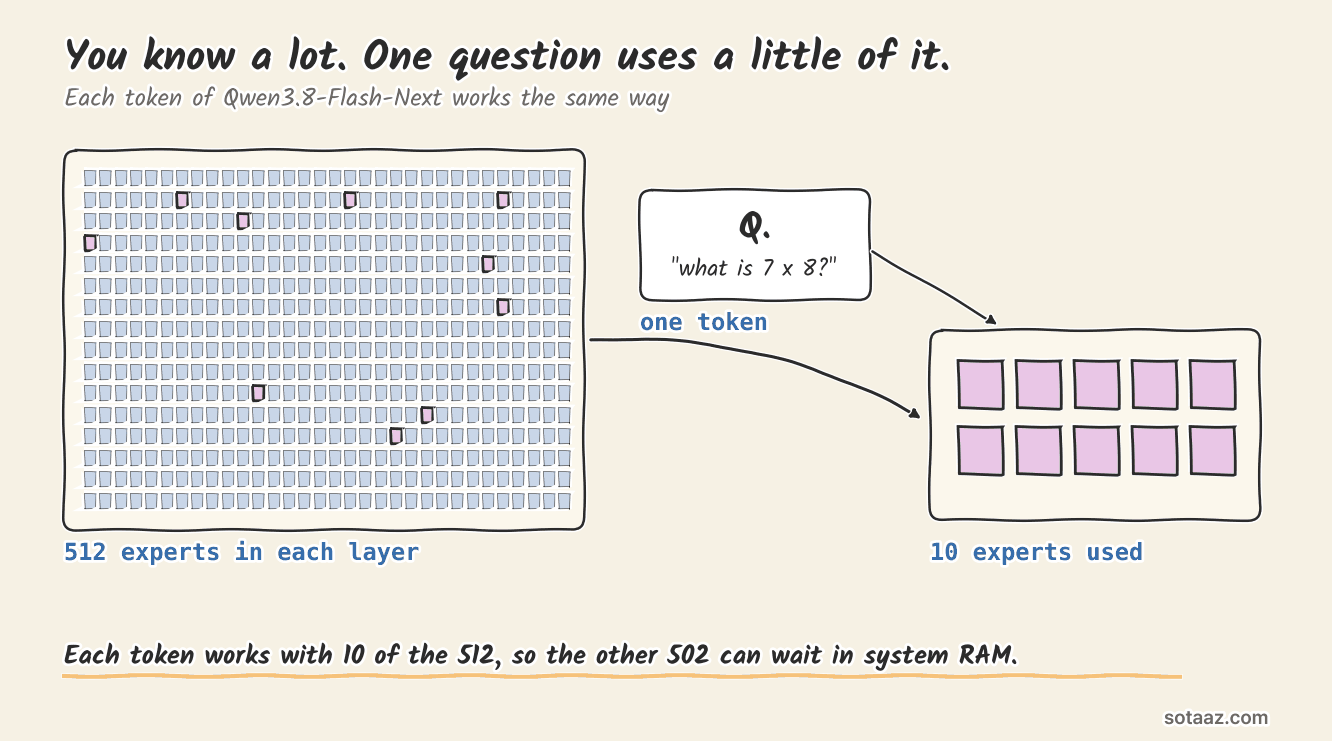
125B짜리 모델이 12GB에 들어가는 이유는 이렇습니다. Qwen3.8-Flash-Next는 48개 층마다 전문가(expert)가 512개 있는데, 토큰 하나는 그중 10개만 씁니다. 그래서 전체 전문가 가중치는 시스템 RAM에 두고, 모든 토큰이 거치는 부분만 GPU에 올려도 돌아갑니다. 비유하면, 사람이 배운 것은 전부 머릿속에 있지만 시험 문제 하나를 풀 때는 그 문제에 필요한 내용만 꺼내 쓰는 것과 같습니다. 두 방법 모두 이 원리를 씁니다.
방법 ①에 쓸 모델을 받습니다. 방법 ②는 Docker 볼륨에 따로 받습니다(3-2절).
아래 명령어를 그대로 활용하면 됩니다.
pip install -U huggingface_hub
hf download ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF --include "IQ2_XS/*" --local-dir ~/models/qwen38
2. 방법 ① llama.cpp
장점: 실행 파일 하나라 간단합니다. 저희 실행에서는 매번 9-20초 만에 떴고, 껐다 켜기 쉽습니다. 다른 모델에 이미 쓰고 있다면 같은 도구입니다.
단점: 전문가 대부분이 CPU에 있어서 28K토큰짜리 첫 요청을 8코어로 초당 약 200토큰씩 읽습니다. 서버를 띄운 뒤 처음 여는 Claude Code 세션은 139-161초를 기다려야 일이 시작됩니다. 서버를 켜 둔 채 세션을 다시 열면 llama-server가 앞부분이 같은 프롬프트를 재사용할 수 있는데, 이 경우는 재지 않았습니다.
2-1. 빌드
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
git checkout d89651a          # 저희가 잰 커밋
cmake -B build -DGGML_CUDA=ON
cmake --build build -j --target llama-server
2-2. 서버 띄우기
./build/bin/llama-server \
  -m ~/models/qwen38/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf \
  -c 65536 -np 1 -fa on -ngl 99 --n-cpu-moe 42 --port 8080
옵션마다 하는 역할입니다.
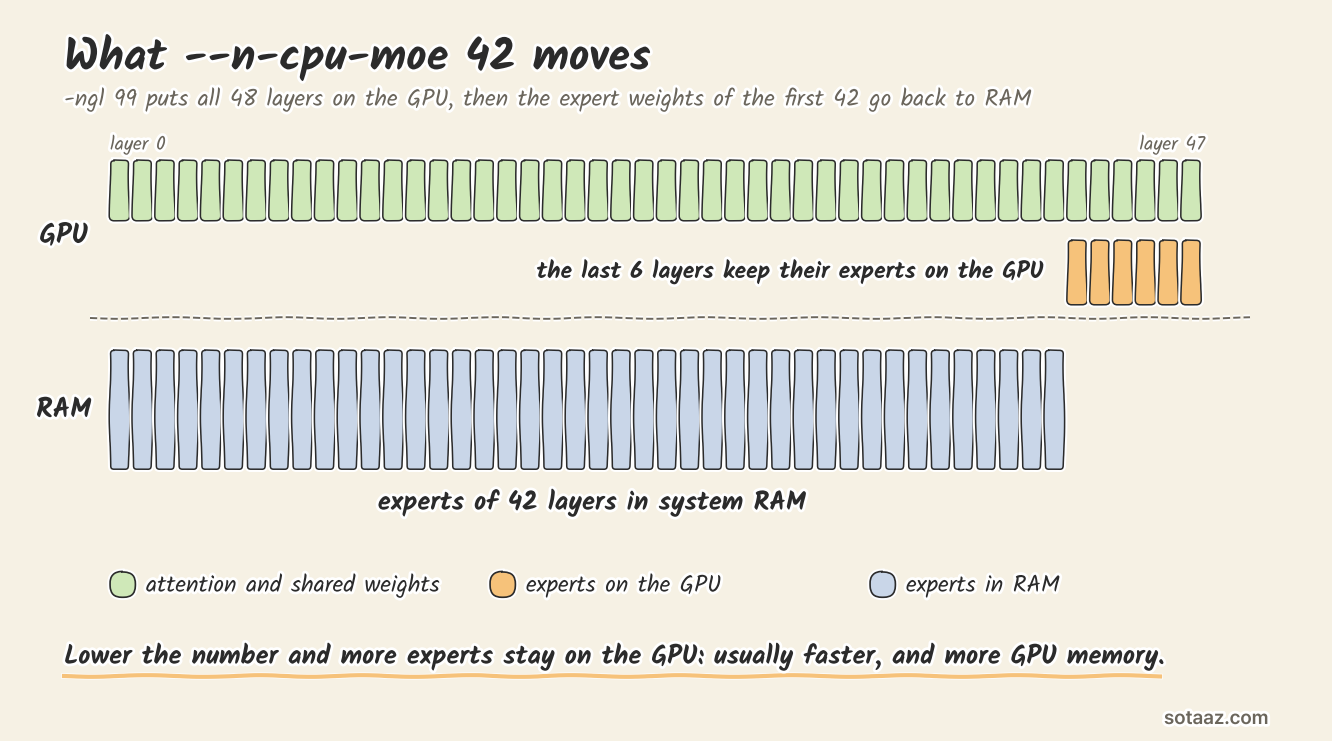
-ngl 99 --n-cpu-moe 42: 모든 층을 GPU에 올린 다음, 48개 층 중 앞쪽 42개 층의 전문가만 CPU로 되돌립니다. GPU 메모리를 정하는 손잡이가 이것입니다. 숫자를 줄이면 GPU에 남는 전문가가 늘어 보통 빨라지고 메모리를 더 씁니다. 42일 때 저희 최고치는 10,994MiB였습니다.-c 65536 -np 1: 컨텍스트 64K, 슬롯 하나입니다. 슬롯이 여러 개면 llama.cpp가 컨텍스트를 나눠 주기 때문에, 28K토큰으로 시작하는 Claude Code에는 남는 자리가 별로 없습니다.-fa on: flash attention을 켜서 어텐션 버퍼를 작게 유지합니다.
로그에 listening on http://127.0.0.1:8080이 나오면 4절로 넘어갑니다.
3. 방법 ② Strata
Strata는 Qwen3.8-Flash-Next 모델 계열 하나만을 위해 만든 MoE(Mixture-of-Experts) 추론 엔진입니다. 어떤 전문가를 GPU에 둘지 스스로 정하고, 돌리는 동안 바꿔 넣습니다.
장점: 저희 실행에서는 첫 요청을 읽는 시간이 139-161초가 아니라 약 12초였고, 과제 전체도 평균으로 작은 버그 수정은 5.9배, 작은 기능 추가는 6.8배 빨리 끝났습니다(기능 추가는 출력 상한을 넣은 실행 기준).
단점: Docker와 이미지 빌드가 필요합니다. 시작 시간도 크게 흔들렸습니다. 정상적으로 뜬 11번 중 6번은 약 30-50초, 5번은 4-10분이었고 원인은 확인하지 못했습니다(llama.cpp는 매번 9-20초였고, Strata 시간은 측정 스크립트의 10초 대기를 뺀 값입니다). 시작할 때 남은 GPU 메모리를 모두 가져가므로 같은 카드를 다른 프로그램과 나눠 쓰면 문제가 생깁니다.
3-1. 이미지 빌드
Docker, NVIDIA Container Toolkit, 드라이버 580 이상이 필요합니다.
git clone https://github.com/Niko1221/Strata
cd Strata
git checkout 6f32ec0          # 저희가 잰 커밋
docker build -t strata .
3-2. 서버 띄우기
docker run --rm --gpus all -p 8080:8080 --ulimit memlock=-1 \
  -v strata-data:/data -e MODEL=IQ2_XS -e FAMILY=qwen -e CONTEXT=65536 strata
처음 띄울 때는 모델(약 70GB)을 strata-data 볼륨에 받고, 카드에 맞는 설정을 고르는 setup을 돌립니다. 다음부터는 둘 다 건너뜁니다. 볼륨은 지우지 마십시오. Strata는 설정 파일을 볼륨에서 찾고, 없으면 setup을 다시 돌려 모델을 또 받습니다. 저희도 설정을 손으로 옮기다가 이 일을 겪었습니다.
위 명령처럼 VISION을 지정하지 않으면 이미지 입력은 꺼진 채(no)로 설치되고, Claude Code는 이미지를 보내지 않으니 그대로 두면 됩니다. 다만 저희 볼륨은 앞 글에서 이미지 입력을 켜고 설치한 것이라, 이 글의 Strata 숫자는 이미지 입력을 켠 상태에서 잰 것입니다. 끈 상태의 GPU 메모리는 따로 측정하지 않았습니다.
로그에 ready: http://127.0.0.1:8080/v1 (… Anthropic: /v1/messages …)가 나오면 준비가 끝난 것입니다.
4. Claude Code 연결(두 방법 공통)
새 터미널을 열고 변수 여섯 개(Strata는 하나 더)를 넣은 뒤 claude를 실행합니다.
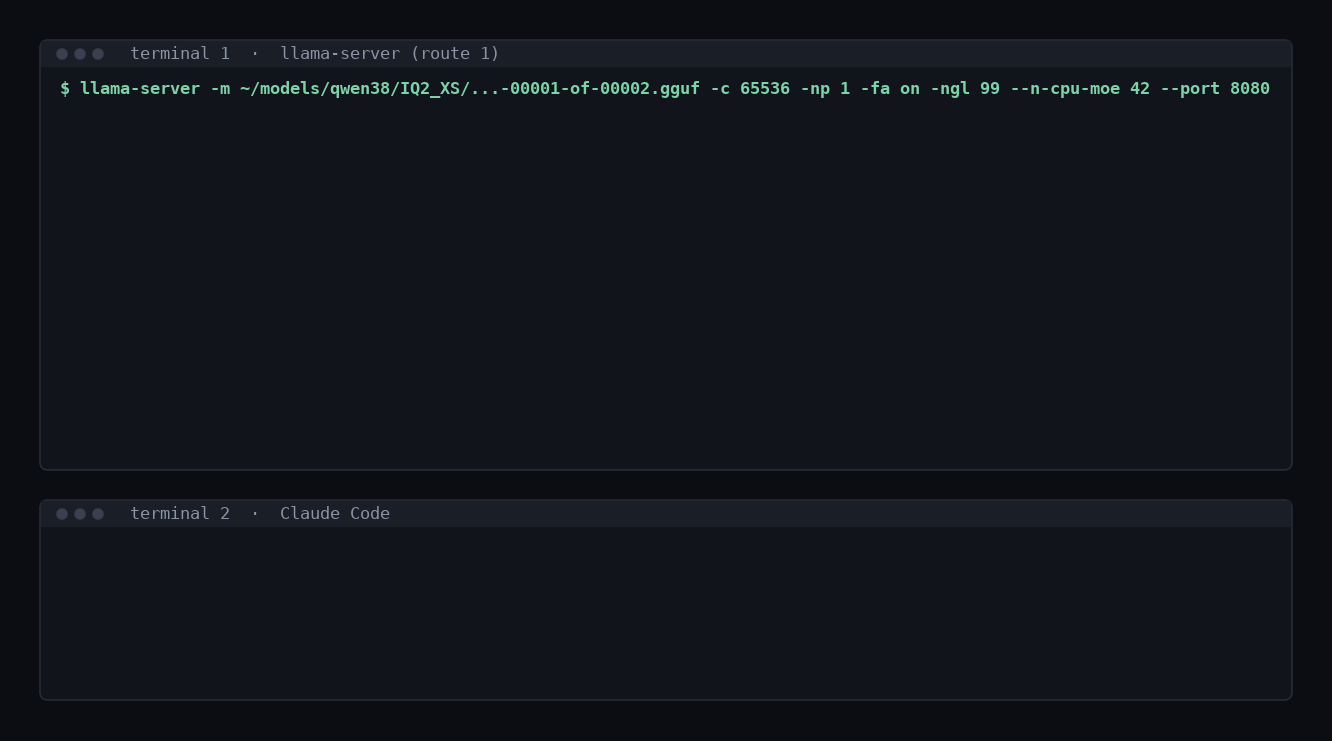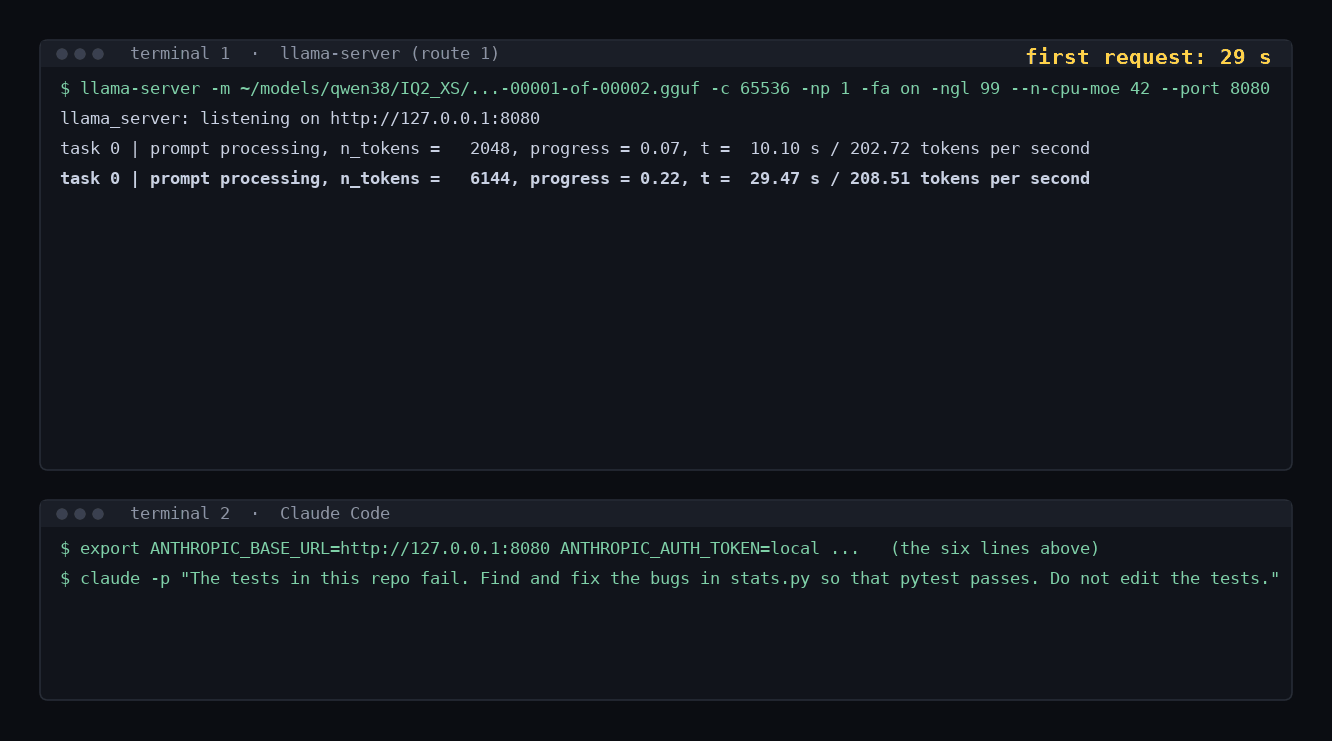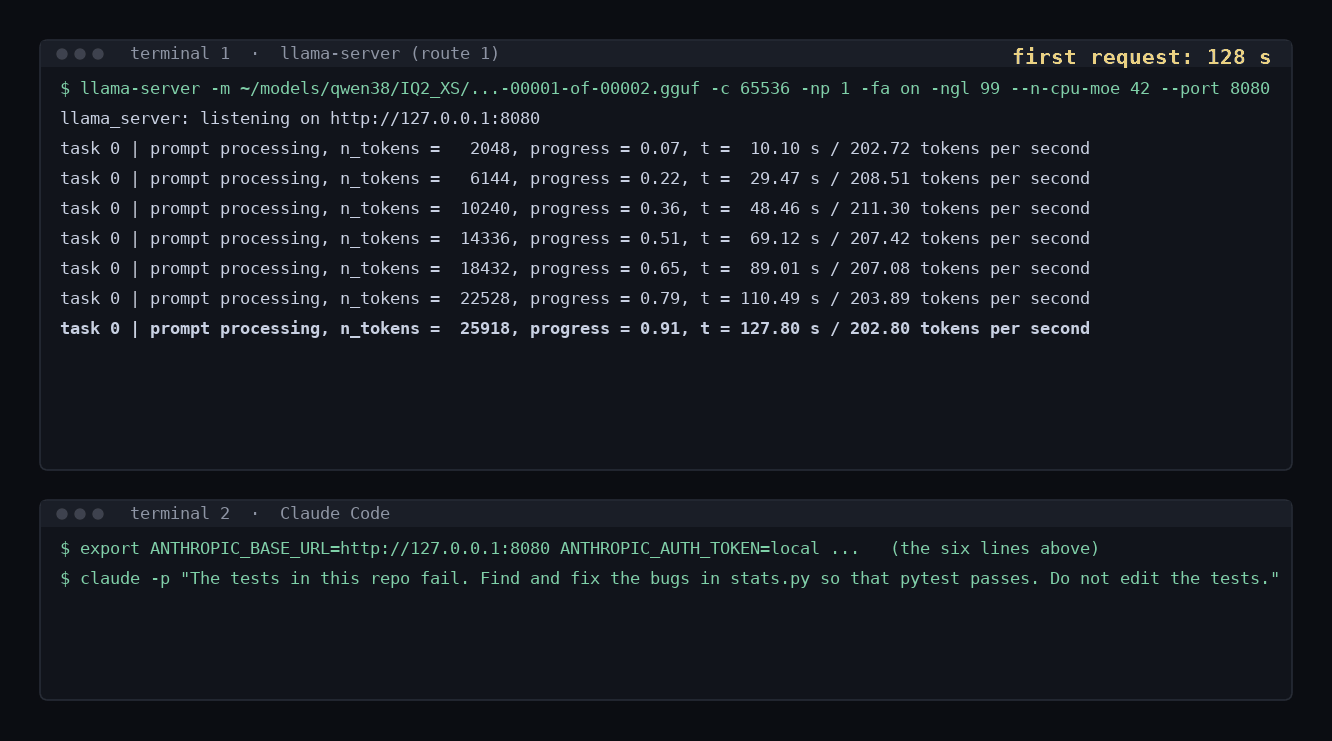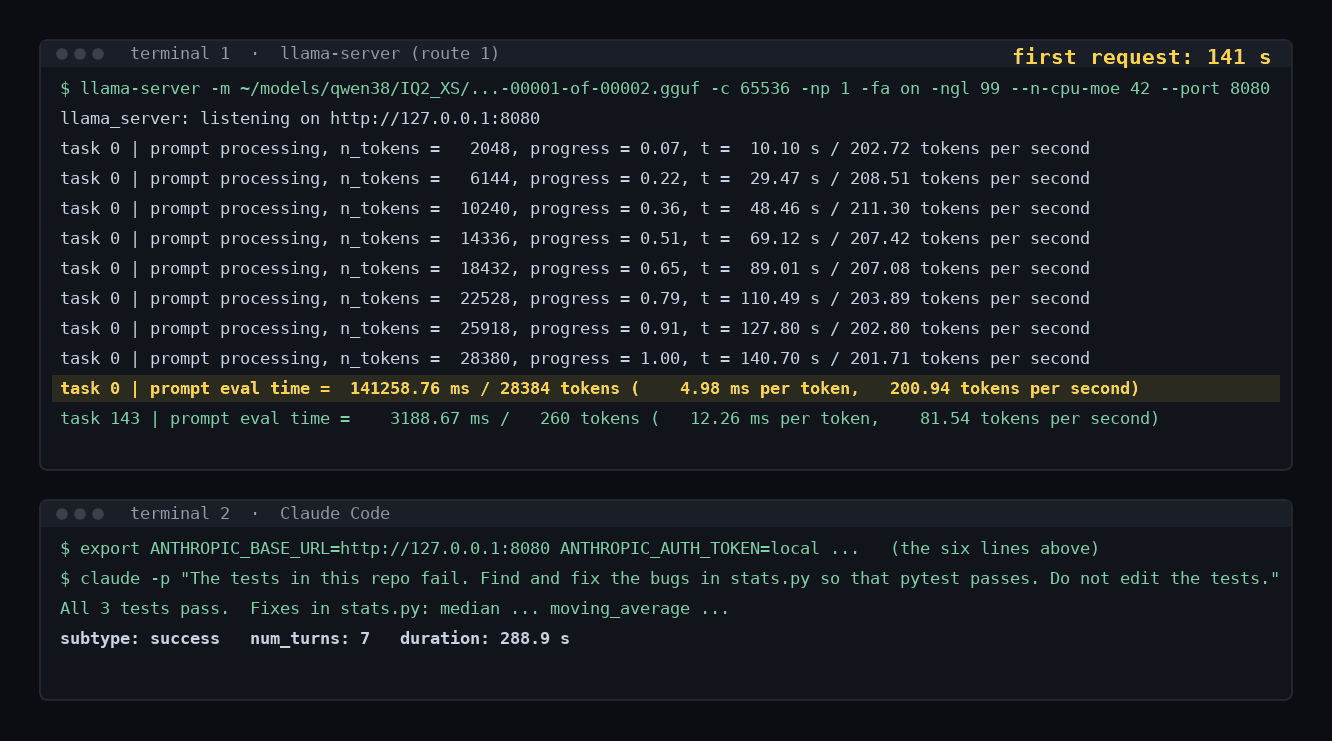
위 화면은 저희가 llama.cpp로 버그 수정 과제를 돌린 실행 하나의 실제 로그에서 일부 줄만 골라 보인 것입니다. 실제 실행은 포트 18093을 썼고, 비대화형 모드라 Claude Code 쪽은 결과만 찍힙니다.
export ANTHROPIC_BASE_URL=http://127.0.0.1:8080
export ANTHROPIC_AUTH_TOKEN=local
export ANTHROPIC_MODEL=claude-sonnet-4-5
export ANTHROPIC_SMALL_FAST_MODEL=claude-haiku-4-5
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1
export API_TIMEOUT_MS=1800000
cd ~/your-project
claude
방법 ② Strata라면 아래 줄을 꼭 함께 넣습니다. 이유는 바로 아래 설명과 7절에 있습니다.
export CLAUDE_CODE_MAX_OUTPUT_TOKENS=8192ANTHROPIC_BASE_URL: 모든 요청을 Anthropic 대신 내 서버로 보냅니다.ANTHROPIC_AUTH_TOKEN: 아무 글자나 넣어도 됩니다. 직접 키를 설정하지 않으면 두 서버 모두 확인하지 않습니다. 이 값을 넣자 비대화형 모드에서 Claude Code가 로그인을 요구하지 않았습니다.ANTHROPIC_MODEL,ANTHROPIC_SMALL_FAST_MODEL: 이름일 뿐입니다. 두 서버 모두 어떤 이름이 오든 띄워 둔 모델 하나로 답합니다. Claude Code는 일부 뒷작업에 작은 모델을 따로 부르는데, 저희는 혹시 몰라 그 이름도 넣어 두었습니다.CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1: 사용 통계, 오류 보고, 업데이트 확인을 끕니다.API_TIMEOUT_MS=1800000: 요청 하나에 30분을 줍니다. 방법 ①은 첫 요청에 몇 분이 걸리므로, 느린 요청이 중간에 끊기지 않게 넉넉히 잡았습니다.CLAUDE_CODE_MAX_OUTPUT_TOKENS=8192(방법 ②): Claude Code는 요청마다 답을 최대 32,000토큰까지 쓰겠다고 요구합니다. Strata는 대화와 이 상한을 합친 값이 컨텍스트(64K)를 넘으면 요청을 자르지 않고 거절하므로, 대화가 약 33,500토큰을 넘는 순간부터 모든 요청이 실패합니다. 상한을 8192로 낮추면 대화가 약 57,000토큰까지 늘어날 수 있습니다. llama.cpp 실행은 이 변수 없이 쟀고 오류도 없었습니다.
저희는 모든 실행에 같은 지시를 주려고 Claude Code를 비대화형 모드(claude -p "…")로 돌렸습니다. 대화형 화면에서도 같은 변수로 동작할 것으로 보지만, 저희가 잰 것은 비대화형 실행뿐입니다.
Claude Code 대화형 화면이 처음이라면 무료 강의 첫 세션: 묻고, 맡기고, 검토하기를 참고하세요. 첫 질문부터 수정한 내용을 검토하기까지 세션 하나를 그대로 보여 줍니다. 약 7분이고 로그인 없이 볼 수 있습니다. 강의는 영어로 진행합니다.
5. 정말 로컬 모델이 답하는지 확인하기
첫 요청을 보내는 동안 세 군데를 봅니다.
- 서버 로그가 움직입니다. llama.cpp는
prompt processing, n_tokens = 2048, progress = 0.07처럼 찍으며 약 28,000까지 올라갑니다. Strata는reading the prompt: 6,912 of 28,155 tokens, 3 s so far처럼 찍습니다. Claude Code가 생각 중인데 로그가 조용하다면 요청이 다른 곳으로 간 것입니다. - GPU가 쓰이고 있습니다.
nvidia-smi에llama-server나 Strata 프로세스가 약 11GB를 잡고 있는 것이 보입니다. - 두 번째 요청부터 빠릅니다. 서버는 한 번 읽은 부분을 기억하고 새로 붙은 부분만 읽습니다. llama.cpp 실행 하나를 보면 첫 요청 뒤의 요청들은 각각 65-813토큰이었고 1.7-5.4초 걸렸습니다.
Claude Code의 결과 요약에는 여전히 금액이 나옵니다(작은 버그 수정 한 번에 total_cost_usd 약 0.14-0.16달러). 실제로 청구된 것은 없습니다. ANTHROPIC_MODEL에 넣은 모델 이름의 정가로 토큰 수를 곱해 보여 줄 뿐입니다.
6. 실제 일 하나 시켜 보기: 작은 기능 추가
버그 두 개를 고치는 장난감 과제로는 부족해서, 93줄짜리 할 일 관리 CLI(todo.py, 테스트 3개)에 기능을 붙이는 일을 시켰습니다. 지시는 여섯 가지입니다.
add에--due YYYY-MM-DD를 받아 항목에 저장합니다.list가 제목 뒤에(due YYYY-MM-DD)를 찍습니다.- 끝나지 않았고 마감일이 오늘 이전인 항목만 보이는
list --overdue를 추가합니다. - 시험할 수 있도록 오늘 날짜를 인자로 넘길 수 있게 합니다.
- 잘못된 날짜는 argparse 오류(종료 코드 2)로 처리합니다.
- 마감일이 없던 예전 파일도 그대로 읽혀야 합니다.
채점은 모델에게 보여 주지 않은 테스트 6개로 했습니다. 저장, 출력 형식, 기한 지남 필터, 잘못된 날짜, 예전 파일 읽기, 기존 동작 유지를 하나씩 봅니다. 원래 코드에서는 6개 중 2개만 통과하고, 저희가 직접 짠 답안은 모두 통과합니다.
| 실행 | 턴 수 | 걸린 시간 | 끝난 상태 | 숨긴 테스트 |
|---|---|---|---|---|
| llama.cpp 1 | 16 | 1,136초 | 정상 종료 | 6/6 |
| llama.cpp 2 | 20 | 1,417초 | 정상 종료 | 6/6 |
| Strata 1, 상한 없음 | 9 | 137초 | API 오류 | 6/6 |
| Strata 2, 상한 없음 | 9 | 149초 | API 오류 | 6/6 |
| Strata 3, 상한 8192 | 14 | 184초 | 정상 종료 | 6/6 |
| Strata 4, 상한 8192 | 14 | 190초 | 정상 종료 | 6/6 |
Strata 처음 두 번이 오류로 끝난 이유
Strata 처음 두 번은 9턴째에 Claude Code가 아래 오류를 받고 멈췄습니다.
API Error: 400 prompt (34835 tokens) + max tokens (32000) exceeds the context (65536); requests are never truncated.원인은 Claude Code가 요청마다 붙이는 출력 상한입니다. Claude Code는 매번 "답을 최대 32,000토큰까지 쓰겠다"(max_tokens: 32000)고 요청합니다. Strata 로그에도 모든 답이 of max 32000으로 찍혀 있습니다. Strata는 요청을 받으면 지금까지의 대화와 이 상한을 더해 컨텍스트 64K(65,536토큰)와 비교하고, 넘으면 요청을 줄이지 않고 그대로 거절합니다. 그러니 대화가 65,536에서 32,000을 뺀 약 33,500토큰을 넘는 순간부터는 답이 실제로 몇 토큰이든 요청이 들어가지 않습니다.
두 번 모두 그 선을 넘는 지점에서 멈췄습니다. 첫 번째는 로그에 마지막으로 크기가 찍힌 요청이 30,104토큰이었고, 그 뒤 짧은 요청 다섯 번을 더 받은 다음 34,835토큰 요청을 거절했습니다. 두 번째는 33,108토큰까지 받아 주고 35,037토큰에서 거절했습니다. 이번 실행은 비대화형(claude -p)이라 여기서 끝났습니다. 대화형이었다면 대화는 줄지 않고 계속 쌓이므로, 이 시점부터는 무엇을 입력해도 같은 오류가 났을 것입니다. 코드는 그 전에 이미 고쳐져 있어서 숨긴 테스트는 통과했지만, 쓸 수 있는 상태로 끝난 것은 아닙니다.
llama.cpp는 같은 Claude Code 설정에서 같은 상한을 받았지만 거절하지 않았습니다. 두 실행에서 대화가 37,391토큰과 40,465토큰까지 커졌는데도 오류 없이 끝났습니다. 그래서 llama.cpp에서만 따라 해 본 분은 이 문제를 모르고 지나가기 쉽습니다.
해결은 Claude Code가 요청하는 상한 자체를 낮추는 것입니다. CLAUDE_CODE_MAX_OUTPUT_TOKENS=8192를 넣으면 상한이 8,192토큰이 되어, 대화가 65,536에서 8,192를 뺀 약 57,300토큰까지 늘어날 수 있습니다. 정확한 선은 이보다 8토큰 낮습니다. 첫 번째 오류에서 Strata가 "이번에는 상한을 30,693까지만 보내라"고 했는데, 34,835에 30,693을 더하면 65,528이기 때문입니다. 다시 돌리기 전에 예측(두 번 모두 정상 종료, 6/6, 100-300초 안, Strata GPU 메모리 11,800MiB 이하)을 먼저 커밋했고, 네 가지 모두 맞았습니다. 이 두 번은 대화가 35,946토큰과 35,970토큰까지 커졌으니, 상한이 없었다면 같은 오류가 났을 크기입니다.
상한을 낮춰서 잃은 것은 이번 과제에서는 없었습니다. 가장 긴 답이 1,899토큰이라 8,192에 한참 못 미쳤습니다. 다만 한 번에 8,192토큰이 넘는 파일을 쓰게 하는 일은 시험하지 않았습니다. 다른 방법으로는 Strata 오류 메시지가 안내하는 "fit_max_tokens": true가 있습니다. 모델 설정 파일(strata-<모델>.json)에 넣으면 Strata가 상한을 남은 자리만큼 줄여 받는다고 하는데, 이것은 시험하지 않았습니다.
정상 종료한 네 번 모두 숨긴 테스트를 전부 통과했고, 모델이 스스로 테스트를 4-6개 더 써서 보이는 테스트도 통과시켰습니다. 시간은 llama.cpp가 19-24분, Strata가 3분 남짓이었습니다. llama.cpp 쪽은 턴도 더 많았는데, 왜 그런지는 저희가 따로 분석하지 않았습니다. 정상 종료한 실행이 엔진마다 두 번이라 이 표는 "이 정도 일은 끝낸다"까지만 말해 줍니다.
7. 이번 측정에서 걸린 함정
명령대로 했는데도 안 되면 아래 표를 봅니다. 다섯 줄 중 네 줄은 저희가 이번 측정에서 직접 걸린 함정이고, 도구 호출 줄은 저희는 겪지 않았지만 모델을 바꾸면 생길 수 있는 증상입니다. 모두 오류 메시지만 보고는 원인을 짐작하기 어렵습니다. 특히 첫 줄은 몇 턴 동안 멀쩡히 돌다가 갑자기 터지기 때문에, 설정이 아니라 모델 문제로 오해하기 쉽습니다.
| 증상 | 해결 |
|---|---|
Strata로 몇 턴 잘 돌다가 API Error: 400 prompt (… tokens) + max tokens (32000) exceeds the context (65536)가 나오고, 그 뒤로 모든 요청이 실패합니다 | Claude Code를 띄우기 전에 export CLAUDE_CODE_MAX_OUTPUT_TOKENS=8192를 넣습니다. 저희는 이 설정으로 두 번 다시 돌려 둘 다 정상 종료했습니다. Strata 오류 메시지는 모델 설정 파일(strata-<모델>.json)에 "fit_max_tokens": true를 넣는 방법도 안내하는데, 이것은 시험하지 않았습니다 |
| 첫 요청이 예상보다 수백 토큰 길고, 준 적 없는 규칙을 에이전트가 따릅니다 | Claude Code는 작업 폴더 위쪽의 CLAUDE.md도 읽습니다. 다른 저장소 안이 아닌 폴더에서 작업하거나, 위쪽 폴더에 어떤 CLAUDE.md가 있는지 확인합니다. 저희 실행에서는 이것 때문에 첫 요청이 28,383토큰에서 29,306토큰으로 늘었습니다 |
| Strata가 시작하다가 "no VRAM is left for the expert cache"로 멈춥니다 | Strata는 시작하는 순간 비어 있는 GPU 메모리로 전문가 캐시 크기를 정합니다. 먼저 GPU를 쓰는 다른 프로그램을 닫습니다. 그래도 모자라면 설정을 줄여 다시 설치합니다. 이미 설치한 볼륨에는 -e REINSTALL=1을 붙여야 설정이 바뀝니다(받아 둔 모델은 다시 받지 않습니다). 엔진 오류 메시지가 제시하는 방법 중 Docker 이미지로 바꿀 수 있는 것은 -e KV=q4_0(KV 캐시를 4비트로), -e VISION=cpu(이미지 인코더를 CPU로) 또는 no입니다. 메시지는 컨텍스트를 줄이는 방법(-e CONTEXT=…)도 권하지만, Claude Code에는 컨텍스트가 적어도 약 36,500토큰 필요합니다. 첫 요청이 약 28,300토큰이고 출력 상한을 8,192로 낮춰도 그만큼을 더하므로, 32K 컨텍스트는 첫 요청에서 실패합니다. 나머지 두 방법은 12GB에서 따로 시험하지 않았습니다 |
| 연결 확인은 되는데, 일을 시키면 파일을 고치지 않고 고칠 코드를 말로만 보여 주거나 도구 호출처럼 생긴 글자를 그대로 출력합니다 | Claude Code는 파일 읽기, 수정, 명령 실행을 전부 도구 호출로 합니다. 그래서 짧은 인사에 답이 오는 것으로는 연결만 확인될 뿐, 일을 할 수 있는지는 알 수 없습니다. 도구 목록은 요청에 글자로 들어가므로 하네스마다 모델을 학습시킬 필요는 없습니다. 다만 모델이 정해진 틀(예: <tool_call>{...}</tool_call>)로 호출을 쓰고 결과를 기다리는 습관을 갖고 있어야 하고, 서버가 그 틀을 알아봐야 합니다. 요즘 instruct 모델은 대부분 이 습관을 튜닝 단계에서 익혔지만, 베이스 모델이나 오래된 모델은 틀을 자주 어깁니다. llama.cpp 서버는 이 글의 빌드에서 모델 파일에 든 채팅 템플릿을 기본으로 쓰고(--jinja가 기본값), 도구 호출도 이 템플릿 형식으로 주고받습니다. 이 글의 Qwen3.8-Flash-Next는 두 엔진에서 모두 도구 호출이 됐고, 저희는 이 증상을 겪지 않았습니다. 다른 모델은 시험하지 않았으므로, 모델을 바꾸면 5절 확인 다음에 파일 하나를 고치는 작은 과제부터 시켜 봅니다 |
| 실행할 때마다 시간이 들쭉날쭉합니다 | 전문가가 CPU에 있으면 다른 작업이 코어를 쓸 때 두 엔진 모두 느려집니다. 재기 전에 uptime이나 htop으로 부하를 봅니다. 저희 기계는 여럿이 같이 써서 실행마다 1분 부하 평균의 중앙값이 23-49였습니다 |
8. 무엇을 고를까
llama.cpp는 시킨 일 5개를 모두 정상 종료했습니다. Strata는 작은 버그 수정 3개는 그대로, 작은 기능 추가는 출력 상한을 넣은 뒤에 정상 종료했습니다. 고르는 기준은 기다림과 여유 메모리입니다.
- Claude Code를 켜 두고 여러 일을 시킨다면 ② Strata에
CLAUDE_CODE_MAX_OUTPUT_TOKENS=8192입니다. 서버 시작은 가장 빠를 때도 llama.cpp보다 약 10-20초 느립니다(정상적으로 뜬 Strata 시작 11번 중 5번은 4-10분이 걸렸고, 원인은 확인하지 못했습니다). 그래도 첫 요청 하나에서만 2분 넘게 아낍니다. 과제 전체로는 5.9-6.8배 빨랐습니다. 다만 저희가 잰 가장 긴 대화가 약 36,000토큰이라, 그보다 훨씬 긴 세션은 시험하지 않았습니다. 실제 12GB 카드도 시험하지 않았습니다. 80GB 카드에서 Strata 최고치는 11,753MiB(여유 535MiB)였고, Strata는 시작할 때 비어 있는 메모리로 캐시 크기를 정하므로 실제 카드에서는 캐시가 줄어 속도가 달라질 수 있습니다. - Docker를 쓸 수 없거나, 카드 메모리 여유가 걱정된다면 ① llama.cpp입니다. 12,288MiB 중 약 1,300MiB가 남고, 일은 느려도 끝냈습니다. 작은 기능 하나에 20분 안팎을 기다릴 수 있는지가 관건입니다.
다음에 볼 글 하나를 고른다면, 내 카드에 컨텍스트를 얼마나 잡을 수 있는지 -c를 두 번 띄워 정하는 글입니다.
한 화면 요약(방법 ①)
hf download ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF --include "IQ2_XS/*" --local-dir ~/models/qwen38
git clone https://github.com/ggml-org/llama.cpp && cd llama.cpp && git checkout d89651a
cmake -B build -DGGML_CUDA=ON && cmake --build build -j --target llama-server
./build/bin/llama-server -m ~/models/qwen38/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf \
  -c 65536 -np 1 -fa on -ngl 99 --n-cpu-moe 42 --port 8080
# 새 터미널
export ANTHROPIC_BASE_URL=http://127.0.0.1:8080 ANTHROPIC_AUTH_TOKEN=local \
  ANTHROPIC_MODEL=claude-sonnet-4-5 ANTHROPIC_SMALL_FAST_MODEL=claude-haiku-4-5 \
  CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1 API_TIMEOUT_MS=1800000
cd ~/your-project && claude
측정 환경: A100 80GB 한 장(드라이버 580.178.04), 각 엔진이 약 12GB만 쓰도록 제한(llama.cpp --n-cpu-moe 42, Strata --vram-reserve-mib 69800으로 80GB 중 그만큼을 비워 둠), AMD EPYC 7742 8코어로 제한(taskset -c 0-7 … -t 8 / --cpuset-cpus 0-7), RAM 251GB, 모델 파일은 회전식 디스크, 다른 작업과 같이 쓰는 기계. Claude Code 2.1.302, 새 홈 폴더, 비대화형 모드, 도구는 Read·Edit·Write·Glob·Grep과 Bash의 python·pytest만 허용. llama.cpp d89651a, Strata 6f32ec0 Docker 이미지. 예측 7개는 실행 전에 커밋했고, 6개가 맞았습니다(P5·P6은 API 오류로 끝난 Strata 실행 두 번을 포함해 판정했고, P6은 깨끗한 재실행 기준으로도 맞습니다. P4 메모리 한도는 엔진 프로세스 기준으로 판정했고, GPU 전체로 보면 llama.cpp 한 번이 11,003MiB로 한도 11,000MiB를 조금 넘었습니다). Strata의 버그 수정 시간 한 번(46.2초)이 예측 범위(50-120초)보다 빨랐습니다. 출력 상한 재실행의 예측 4개도 실행 전에 따로 커밋했고 모두 맞았습니다. 위 따라 하기 명령과 측정 스크립트의 차이: Claude Code는 env -i, DISABLE_TELEMETRY=1, --permission-mode acceptEdits, timeout을 붙여 돌렸고, llama.cpp는 -t 8 --no-webui와 다른 포트를 썼고, Strata는 앞 글의 볼륨과 모델 폴더(-v …:/models)를 재사용했으며 GPU 한 장(--gpus device=0), 이미지 입력 켬, 설정 파일에 이미 들어 있던 64K 컨텍스트로 돌렸습니다. Strata는 포트도 달랐고, 이름 붙인 백그라운드 컨테이너(-d --name)로 띄웠으며, 실행마다 기본 설정 파일을 복사해 --vram-reserve-mib 값을 넣었습니다. 2026-10-23 시험(5절의 Strata 로그 줄과 7절의 VRAM 시작 실패는 이때 나왔습니다), 2026-10-24 측정(터미널 GIF, 5절의 llama.cpp 로그 줄, 6절과 7절의 400 오류는 이때 나왔습니다).