8GB 그래픽카드에는 컨텍스트가 얼마나 들어갈까: Qwen3.5-9B를 8K부터 256K까지 재고 실제 작업 다섯 가지와 맞춰 봤습니다
Qwen3.5-9B Q4_K_M의 GPU 메모리를 컨텍스트 8K부터 256K까지 재고, 자주 하는 작업이 몇 토큰인지 셌습니다. 8GB 카드에서 대화 하나에 쓸 수 있는 컨텍스트는 기본 KV 캐시로 32K, 8비트 캐시로 64K였습니다. 코딩 질문 20턴은 36,736토큰, 76쪽 논문은 77,800토큰이었고, 코딩 에이전트는 첫 요청부터 648토큰에서 15,970토큰을 보냈습니다. 모든 층에 캐시를 두는 Qwen3-8B는 32K에서 이미 9.5GiB였습니다.
8GB 그래픽카드에는 컨텍스트가 얼마나 들어갈까: Qwen3.5-9B를 8K부터 256K까지 재고 실제 작업 다섯 가지와 맞춰 봤습니다
로컬 모델 안내 글은 보통 컨텍스트 길이 하나에서 잰 메모리만 알려 줍니다. 저희 Qwen 로컬 실행 가이드도 그랬습니다. Qwen3.5-9B Q4_K_M이 8K에서 5.8GiB, 32K에서 6.5GiB를 써서 8GB 카드에 들어간다고 적었습니다. 그런데 유튜브 영상에 "8K면 30초면 다 차겠네"라는 댓글이 달렸습니다. 맞는 지적입니다. 독자에게 필요한 것은 숫자 두 개를 나란히 놓는 일입니다. 내 작업이 몇 토큰인지, 그리고 그만큼의 컨텍스트에 메모리가 얼마나 드는지입니다.
그래서 둘 다 재 봤습니다. 같은 9B 파일로 컨텍스트 8K부터 256K까지 GPU 메모리를 재고, 로컬 모델로 흔히 하는 일 다섯 가지가 몇 토큰인지 셌습니다. 긴 대화, PDF, 코딩 에이전트, 코드 묶음, 같은 글의 한국어판과 영어판입니다. 측정 계획과 예상치, 카드별 판정 기준은 재기 전에 정해 두었습니다.
어떻게 쟀나
- 실행 환경: 앞 가이드와 같은 llama.cpp
4da6337빌드에llama-server -ngl 99 -fa on --parallel 1 -c <길이>를 썼습니다. 슬롯이 하나라 컨텍스트 전체를 대화 하나가 씁니다. - 모델: Qwen3.5-9B Q4_K_M(앞 가이드와 같은 Unsloth 파일)입니다. 비교용으로 크기가 비슷하지만 모든 층이 전체 어텐션을 쓰는 Qwen3-8B Q4_K_M도 쟀습니다.
- KV 캐시: 기본값 f16과 8비트(
-ctk q8_0 -ctv q8_0) 두 가지입니다. - 메모리: 컨텍스트의 90%를 채우는 프롬프트를 처리하는 동안 서버 프로세스의 GPU 메모리를 0.2초마다 읽어 최댓값을 적었습니다. 조건마다 두 번 쟀는데 두 값이 모두 같았습니다.
- 토큰 수: 9B 모델 자체의 토크나이저로 셌습니다.
- 카드 기준: 8GB로 파는 카드는 7.45GiB입니다. 화면 출력과 드라이버 몫으로 0.5GiB를 남겨 6.95GiB 이하면 "들어감", 7.45GiB까지는 "빠듯함"으로 봤습니다. 같은 방식으로 12GB 카드는 10.68GiB, 16GB 카드는 14.40GiB가 기준입니다.
메모리는 모두 A100에서 잰 값이고, 8GB 카드에서 직접 돌려 본 것은 아닙니다. 빌드와 설정이 같으면 모델이 차지하는 메모리는 NVIDIA GPU 어디서나 같습니다. 다만 화면 출력이 얼마를 차지하는지는 각자 환경마다 다릅니다.
컨텍스트 길이별 메모리
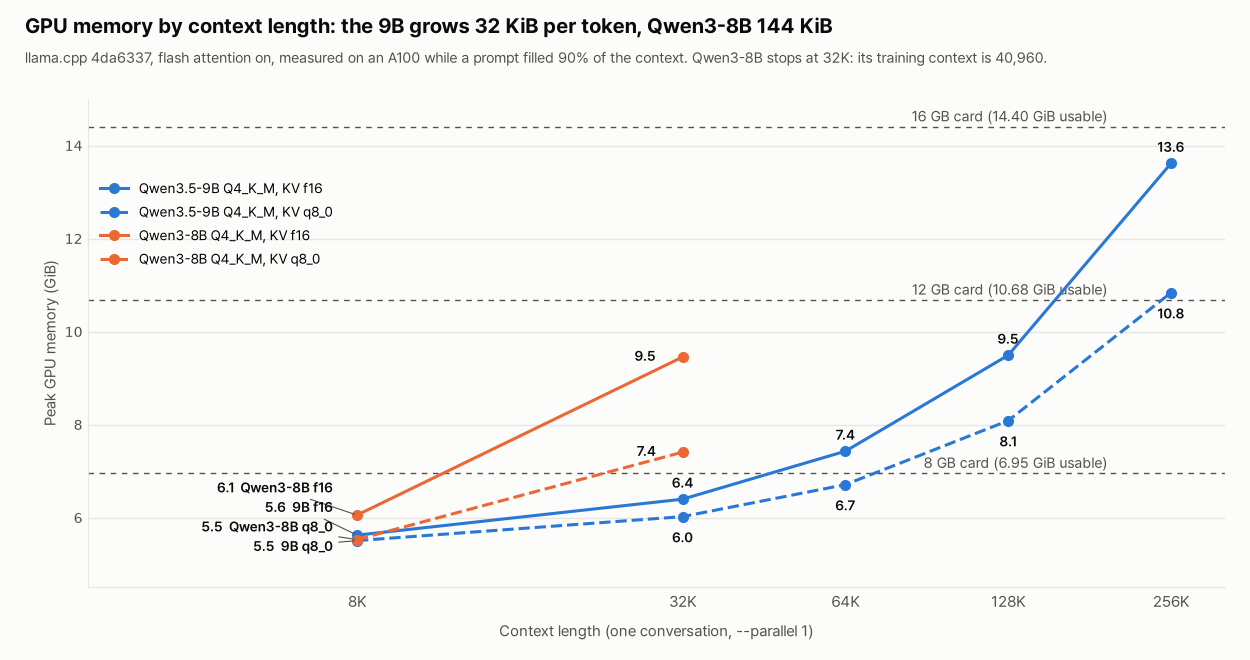
| 컨텍스트 | 9B, f16 KV | 9B, q8_0 KV | Qwen3-8B, f16 KV | Qwen3-8B, q8_0 KV |
|---|---|---|---|---|
| 8K | 5.62GiB | 5.51 | 6.05 | 5.53 |
| 32K | 6.40 | 6.02 | 9.45 | 7.41 |
| 64K | 7.43 | 6.71 | 모델 범위 밖 | 모델 범위 밖 |
| 128K | 9.49 | 8.08 | 모델 범위 밖 | 모델 범위 밖 |
| 256K | 13.62 | 10.83 | 모델 범위 밖 | 모델 범위 밖 |
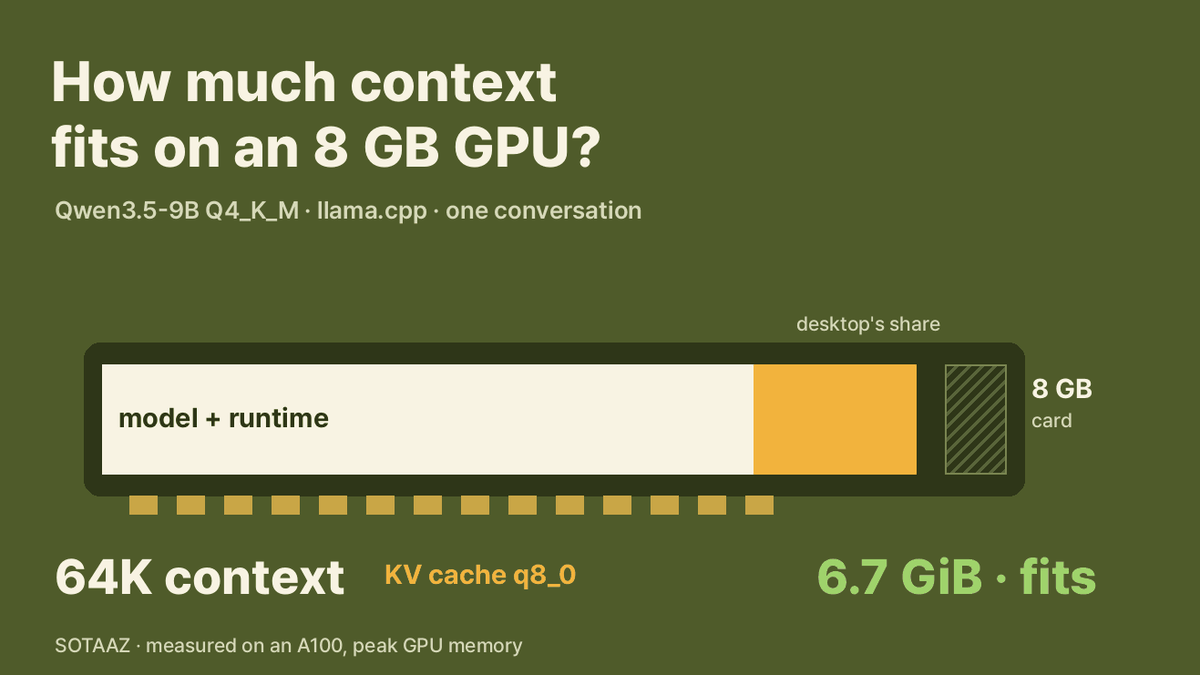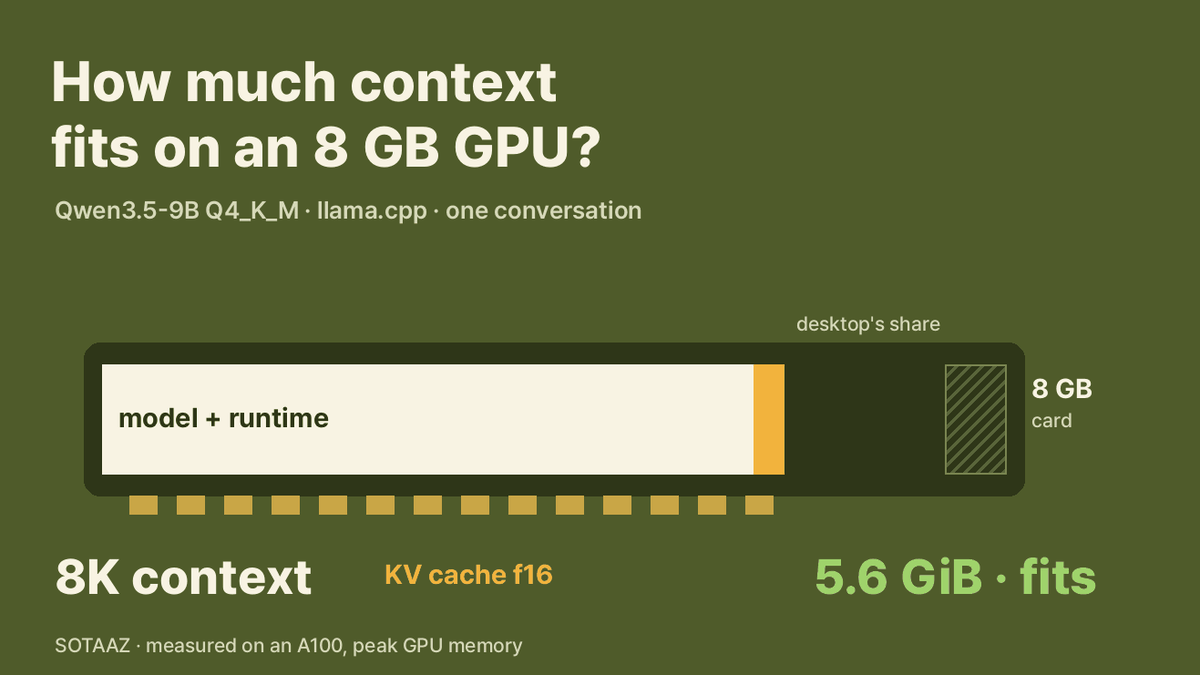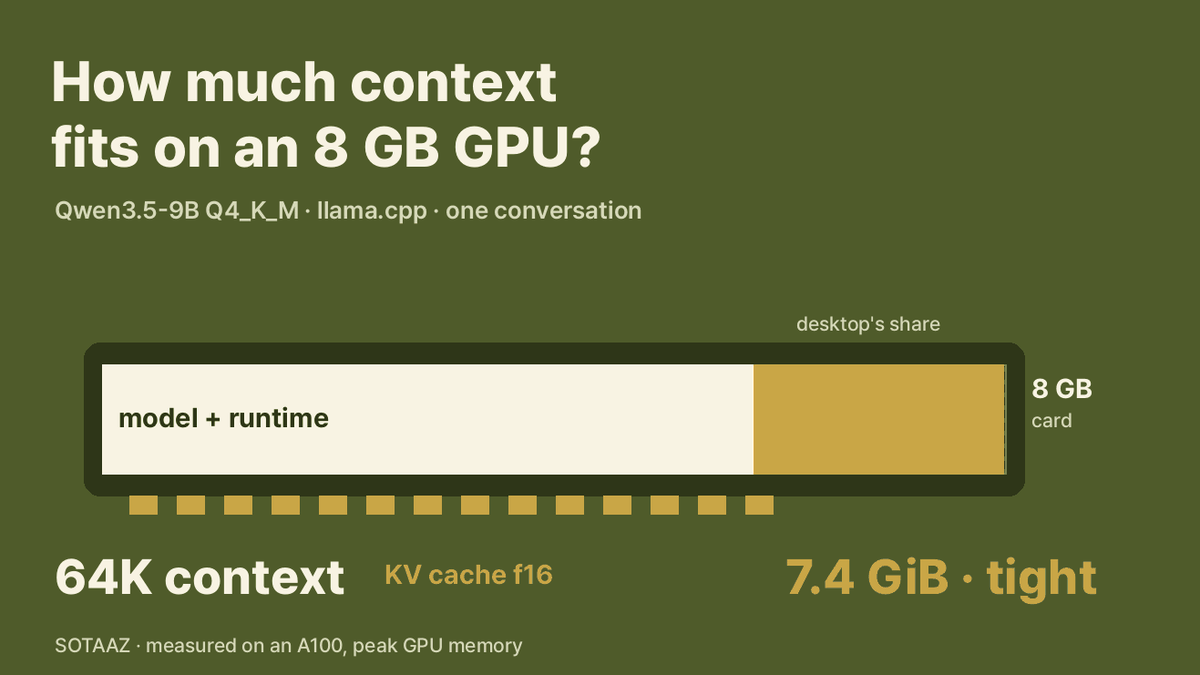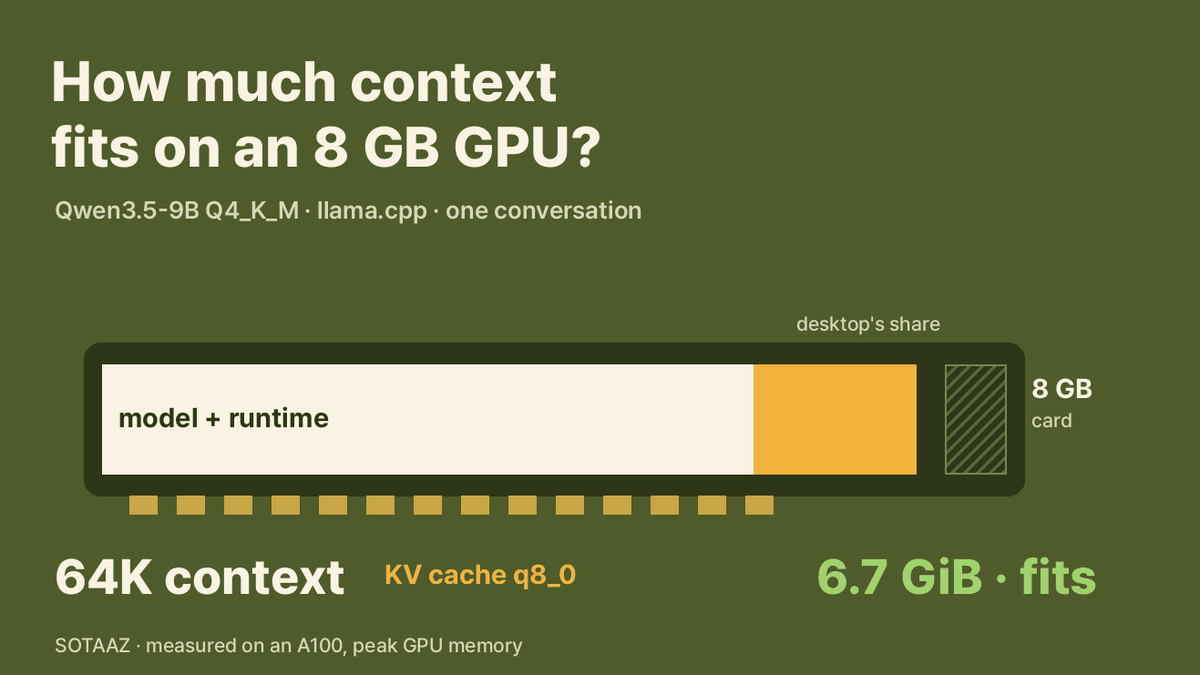
8GB 카드에서 9B로 대화 하나에 쓸 수 있는 컨텍스트는 기본 캐시로 32K, 8비트 캐시로 64K입니다. f16으로 64K를 잡으면 7.43GiB라 카드 전체 7.45GiB에 거의 닿고, 화면 출력에 남는 몫이 없습니다. 12GB 카드는 두 방식 모두 128K까지, 16GB 카드는 모델이 받는 최대치인 256K까지 들어갑니다.
8K와 32K 값은 앞 가이드의 5.8GiB, 6.5GiB보다 조금 낮습니다. 그때는 서버 기본값인 슬롯 4개로 쟀고, 이번에는 하나로 쟀기 때문입니다.
9B는 왜 천천히 늘어나나
컨텍스트에 따라 늘어나는 메모리는 KV 캐시입니다. 어텐션 층마다 토큰 하나당 키와 값을 하나씩 저장해 두는 공간입니다. Qwen3.5-9B는 32층 중 8층만 전체 어텐션을 쓰고, 나머지 24층은 입력이 아무리 길어도 크기가 그대로인 상태값만 들고 있습니다. 모델 파일에 적힌 값으로 계산하면 8층 × KV 헤드 4개 × (256 + 256) × 2바이트로 토큰 하나에 32KiB입니다. Qwen3-8B는 36층 모두 캐시를 두므로 36 × 8 × (128 + 128) × 2바이트, 토큰 하나에 144KiB로 4.5배입니다.
이 두 숫자는 재기 전에 예상치로 계획에 적어 두었습니다. f16에서 8K 대비 늘어난 양은 모든 길이에서 예상과 0.25GiB 안으로 맞았습니다(계획의 허용 폭은 0.3GiB). 8K에서 32K로 늘릴 때 9B는 0.77GiB, Qwen3-8B는 3.40GiB가 늘었습니다. 8비트 캐시를 쓸 때 같은 8GB 카드가 한 모델에는 64K까지 들어가고 다른 모델에는 8K만 들어가는 이유가 이것입니다(Qwen3-8B는 8비트 캐시로도 32K가 빠듯합니다).
Qwen3-8B에서 하나 더 알게 된 것이 있습니다. 이 모델의 학습 컨텍스트는 40,960토큰입니다. 64K를 요청했더니 llama-server는 오류를 내지 않았습니다. 경고만 찍고 컨텍스트를 40,960으로 줄인 뒤, 5만 9천 토큰짜리 프롬프트를 거절했습니다. -c를 모델의 학습 길이보다 크게 줬다면, 시작 로그에서 실제로 잡힌 컨텍스트가 얼마인지 확인해 보세요.
8비트 캐시는 절반보다 덜 줄여 줍니다
8비트 KV 캐시는 값 하나를 2바이트 대신 1바이트 남짓으로 저장합니다. 캐시 자체는 계산대로 줄었습니다. 128K에서 4,096MiB가 2,176MiB가 됐습니다. 그런데 전체 메모리는 1.9GiB가 아니라 1.4GiB만 줄었습니다. 나머지는 llama.cpp의 계산 버퍼가 가져갔습니다. 8비트 캐시를 쓰면 이 버퍼가 컨텍스트에 비례해 커져서 8K 96MiB, 128K 696MiB, 256K 1,336MiB가 됩니다. f16에서는 같은 길이에서 96, 216, 344MiB였습니다. 8비트 결과가 예상보다 크게 나온 뒤 서버 상세 로그를 열어 찾은 설명이라 사후 분석입니다. 다만 버퍼 크기를 더하면 측정한 전체 값과 맞습니다.
저희 KV 캐시 양자화 실측에서는 Qwen3-8B로 q8_0의 품질 손실이 측정되지 않았고, 64K에서 생성 속도는 f16의 55%였습니다. 정리하면 8비트 캐시는 8GB 카드에서 32K를 64K로 늘려 주는 방법입니다. 다만 속도 손해는 Qwen3-8B에서 잰 값(64K에서 f16의 55%)이고, 9B에서는 속도를 재지 않았습니다. 9B는 32층 중 8층에만 캐시를 두므로 손해 폭이 다를 수 있습니다.
실제 작업은 몇 토큰인가
| 작업 | 토큰 | 담을 수 있는 최소 컨텍스트* | 8GB, 9B f16 | 8GB, 9B q8_0 | 8GB, Qwen3-8B f16 | 8GB, Qwen3-8B q8_0 |
|---|---|---|---|---|---|---|
| 코딩 질문 대화 10턴 | 15,499 | 32K | 들어감 | 들어감 | 안 들어감 | 빠듯함 |
| 코딩 질문 대화 20턴 | 36,736 | 64K | 빠듯함 | 들어감 | 모델 범위 밖 | 모델 범위 밖 |
| 같은 대화를 추론을 켜고 10턴 | 34,675 | 64K | 빠듯함 | 들어감 | 모델 범위 밖 | 모델 범위 밖 |
| 「Attention Is All You Need」 PDF(15쪽) | 10,392 | 32K | 들어감 | 들어감 | 안 들어감 | 빠듯함 |
| LoRA 논문 PDF(20쪽) | 19,845 | 32K | 들어감 | 들어감 | 안 들어감 | 빠듯함 |
| Llama 2 논문 PDF(76쪽) | 77,800 | 128K | 안 들어감 | 안 들어감 | 모델 범위 밖 | 모델 범위 밖 |
nanoGPT model.py(331줄) | 4,403 | 8K | 들어감 | 들어감 | 들어감 | 들어감 |
| nanoGPT 파이썬 파일 15개 전체 | 14,426 | 32K | 들어감 | 들어감 | 안 들어감 | 빠듯함 |
requests 라이브러리 src/requests 19개 파일 | 53,407 | 64K | 빠듯함 | 들어감 | 모델 범위 밖 | 모델 범위 밖 |
\* 토큰 수에 답할 자리 2,048토큰을 더하고, 잰 길이 중 다음 단계로 올린 값입니다.
대화. 파이썬으로 작은 가계부 앱을 만드는 질문 20개를 미리 정해 두고 순서대로 물었습니다(temperature 0, 추론 끔). 답이 코드를 포함해 720토큰에서 4,096토큰까지 나와서 대화가 빠르게 길어졌습니다. 5턴 뒤 5,733토큰, 10턴 뒤 15,499토큰, 15턴 뒤 28,254토큰, 20턴 뒤 36,736토큰이었습니다. 이런 대화라면 8K는 일곱 번째 턴에서 찹니다. 유튜브 댓글이 틀린 말이 아니었습니다.
추론을 켰을 때는 채팅 앱처럼 답만 대화 기록에 넘겼기 때문에 추론 내용 자체는 쌓이지 않았습니다. 대신 답이 길어져서 10턴 뒤 34,675토큰으로, 추론을 끈 경우의 2.2배였습니다. 열 번 중 여섯 번은 답 길이 한도(4,096토큰)에 닿아서, 이 실행은 10턴에서 멈췄습니다.
PDF. 저희가 잰 15쪽과 20쪽 논문은 각각 1만 토큰과 2만 토큰 안팎이었습니다. 76쪽짜리 Llama 2 논문은 77,800토큰이었는데, PDF 읽기 도구가 그림 안의 글자 일부를 건너뛰었으니 실제로는 이보다 조금 많습니다.
코드. 331줄짜리 파일 하나가 4,403토큰입니다. 파일 15개짜리 작은 프로젝트는 32K에 들어가고, requests 정도 크기의 라이브러리는 64K가 필요합니다.
코딩 에이전트는 첫 요청부터 많이 보냅니다
코딩 에이전트는 요청할 때마다 시스템 프롬프트와 도구 설명을 같이 보냅니다. 에이전트 네 개를 로컬 서버에 연결하고, 빈 폴더에서 같은 한 줄짜리 과제를 줬습니다. 그리고 에이전트가 도구 설명을 실어 보낸 첫 요청의 토큰을 셌습니다.
| 에이전트 | 첫 요청 토큰 | 도구 설명 수 |
|---|---|---|
| aider 0.86.2 | 648 | 없음(수정을 글로 씀) |
| Cline CLI 3.0.70 | 3,121 | 4 |
| OpenCode 1.18.35 | 7,400 | 10 |
| Qwen Code 0.25.0 | 15,970 | 14 |
이 값은 작업을 시작할 때의 기본 비용일 뿐입니다. 에이전트가 읽는 파일과 도구 실행 결과가 그 위에 계속 쌓입니다. 보조 요청을 보낸 에이전트도 있었습니다. OpenCode는 작업 전에 대화 제목을 만드는 요청을 따로 보냈고, Qwen Code는 끝에 메모리를 저장하는 단계를 돌렸습니다. Qwen Code의 첫 요청에서는 도구 설명만 35,697자로, 시스템 프롬프트 24,120자보다 길었습니다. Qwen Code를 32K로 쓰면 첫 메시지에서 이미 절반을 씁니다. 이 값은 에이전트 버전과 설정에 따라 달라지고, 에이전트의 우열을 뜻하지도 않습니다. aider가 적게 쓰는 데는 모델에게 부를 도구를 주지 않는 방식이라는 이유도 있습니다.
한국어는 5분의 1쯤 더 듭니다
저희 블로그 글은 모두 한국어판과 영어판이 있습니다. 발행된 185쌍에서 한국어판 토큰은 영어판의 중앙값 1.19배였습니다(하위 10%와 상위 10% 경계는 1.10배, 1.28배). 저희 한국어판은 번역이 아니라 따로 쓴 글이라 길이 차이도 섞여 있고, 토크나이저 차이만은 아닙니다. 그래도 이 모델로 같은 내용을 한국어로 넣는다면 컨텍스트를 20%쯤 더 잡아 두는 편이 안전합니다.
이렇게 설정하면 됩니다
- 8GB 카드에서 Qwen3.5-9B: 평소에는
-c 32768로 씁니다. 긴 대화나 코딩 에이전트, 중간 크기 코드 묶음에는-ctk q8_0 -ctv q8_0을 더해-c 65536까지 올릴 수 있습니다. - 혼자 쓴다면 슬롯은 하나(
--parallel 1)로 두세요. 그래야 컨텍스트 전체를 내 대화가 씁니다. - 76쪽 Llama 2 논문처럼 긴 PDF는 128K가 필요해서 12GB 카드를 쓰거나 문서를 나눠 넣어야 합니다.
- Qwen3-8B처럼 모든 층에 캐시를 두는 모델은 토큰당 메모리가 네 배 넘게 듭니다. 8GB 카드에서는 8K가 편하고, 32K는 8비트 캐시로 7.41GiB라 빠듯합니다.
다루지 못한 것
- 메모리는 A100에서 쟀고, 8GB 카드에서 직접 돌려 본 것은 아닙니다. 화면 출력 몫은 각자 남겨 두세요.
- 컨텍스트가 들어가는지만 쟀고, 그 길이에서 답이 얼마나 좋은지는 재지 않았습니다.
- 대화는 저희가 쓴 질문 20개, 모델 하나, temperature 0으로 한 번 돌린 결과입니다. 대화마다 늘어나는 속도는 다릅니다.
- 에이전트 숫자는 과제 하나의 첫 요청만이고, 각 에이전트의 기본 설정입니다.
- Qwen3-8B는 학습 컨텍스트 때문에 32K까지만 잴 수 있어서, 그 위로는 비교가 없습니다.
- 8비트 캐시의 계산 버퍼 설명은 결과를 본 뒤 로그에서 찾은 것입니다.
계획, 스크립트, 실행별 로그와 결과는 아래 재현 패키지에 있습니다. 8비트 캐시가 품질과 속도에 미치는 영향은 KV 캐시 양자화 실측에서 볼 수 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
ctx-budget-8gb-repro.zip · 279 KB