Qwen 로컬 실행: 내 GPU(8·12·16·24GB)에 맞는 파일 고르기, 실측
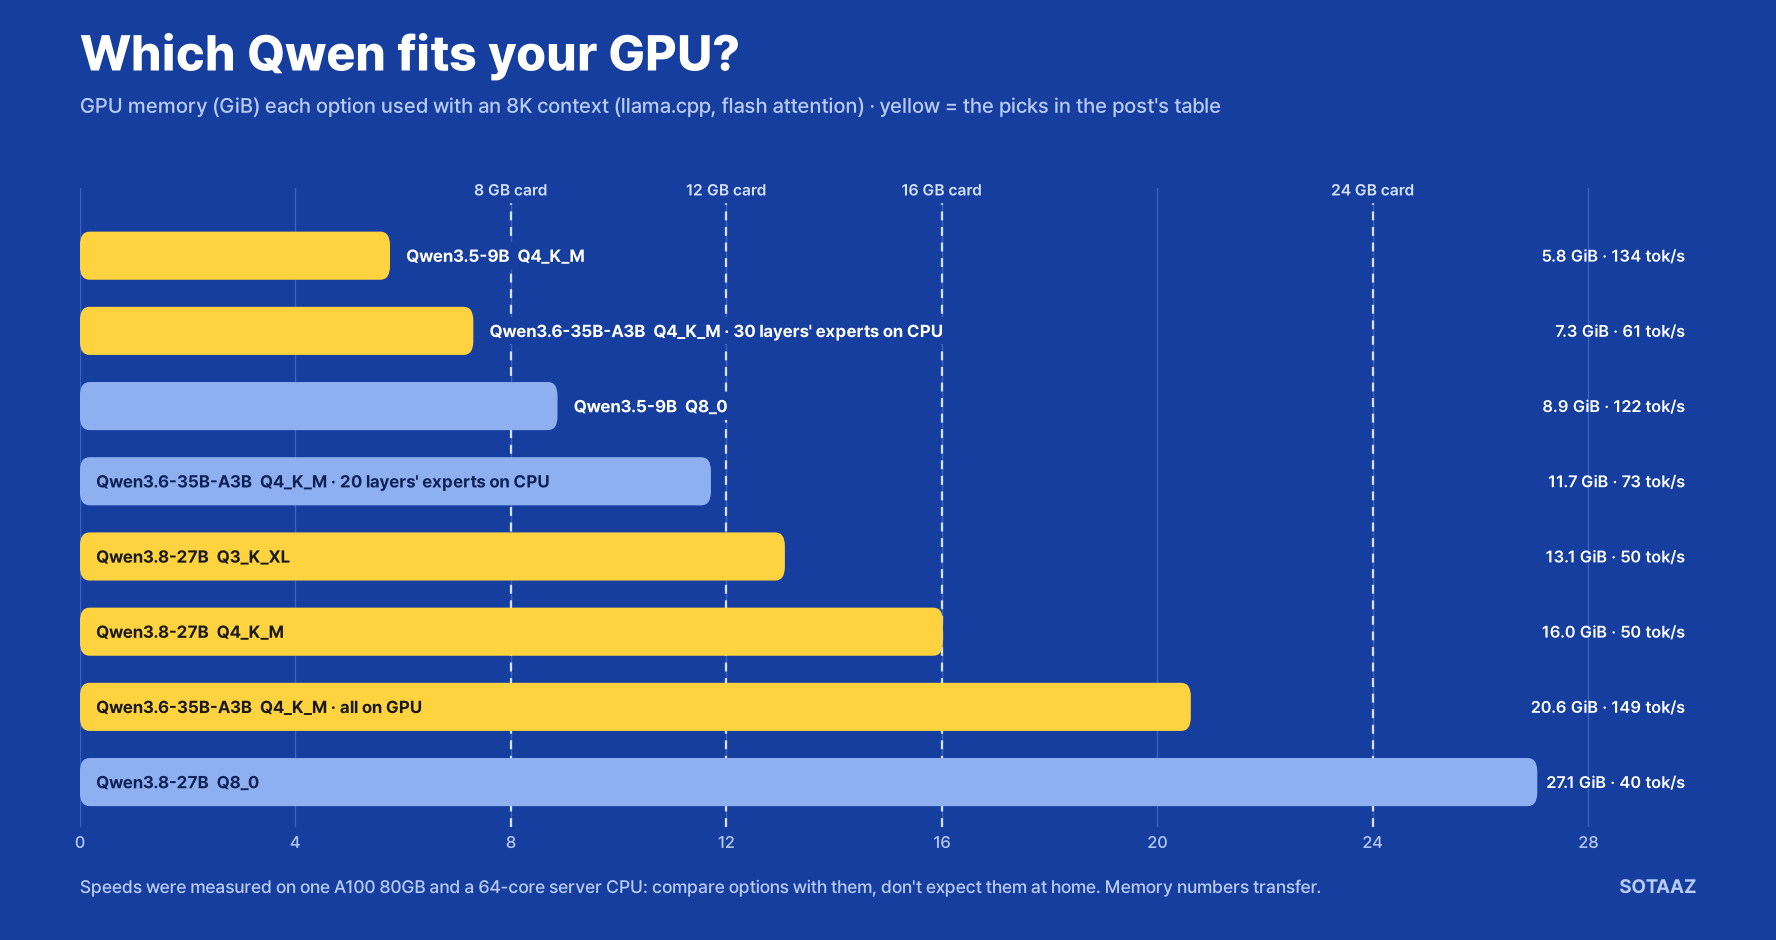
8·12·16·24GB 그래픽카드별로 받을 Qwen GGUF 파일을 실측 메모리로 골랐습니다. 9B Q4_K_M 5.8GiB, 27B Q3_K_XL 13.1GiB, 35B-A3B는 30개 층의 전문가를 CPU에 두면 7.3GiB로 돌아갑니다.
Qwen 로컬 실행: 내 GPU(8·12·16·24GB)에 맞는 파일 고르기, 실측
내 컴퓨터에서 Qwen을 돌리는 일은 두 단계면 끝납니다. GGUF 파일 하나를 받고, llama.cpp나 Ollama로 실행하면 됩니다. 어려운 건 파일 고르기입니다. 모델 하나에 양자화 버전이 열 개 넘게 있고, 무엇이 맞는지는 그래픽카드 메모리에 따라 달라집니다.
그래서 많이 받는 버전들을 직접 받아 하나씩 띄워 봤습니다. 파일마다 GPU 메모리를 실제로 얼마나 쓰는지, 얼마나 빠른지, 8비트 버전과 비교해 답이 얼마나 달라지는지를 쟀습니다. 모델은 지금 로컬에서 많이 돌리는 셋입니다. 작은 그래픽카드용 Qwen3.5-9B, Unsloth 페이지에서 올해 나온 Qwen GGUF 중 가장 많이 받은 Qwen3.8-27B, 그리고 토큰마다 약 3B만 계산하는 전문가 혼합(MoE) 모델 Qwen3.6-35B-A3B입니다.
먼저 결론
| 그래픽카드 메모리 | 받을 파일 | 실제 GPU 메모리 사용량 (8K / 32K 컨텍스트) | 테스트 GPU에서 생성 속도 |
|---|---|---|---|
| 8GB | Qwen3.5-9B Q4_K_M | 5.8 / 6.5GiB | 초당 134토큰 |
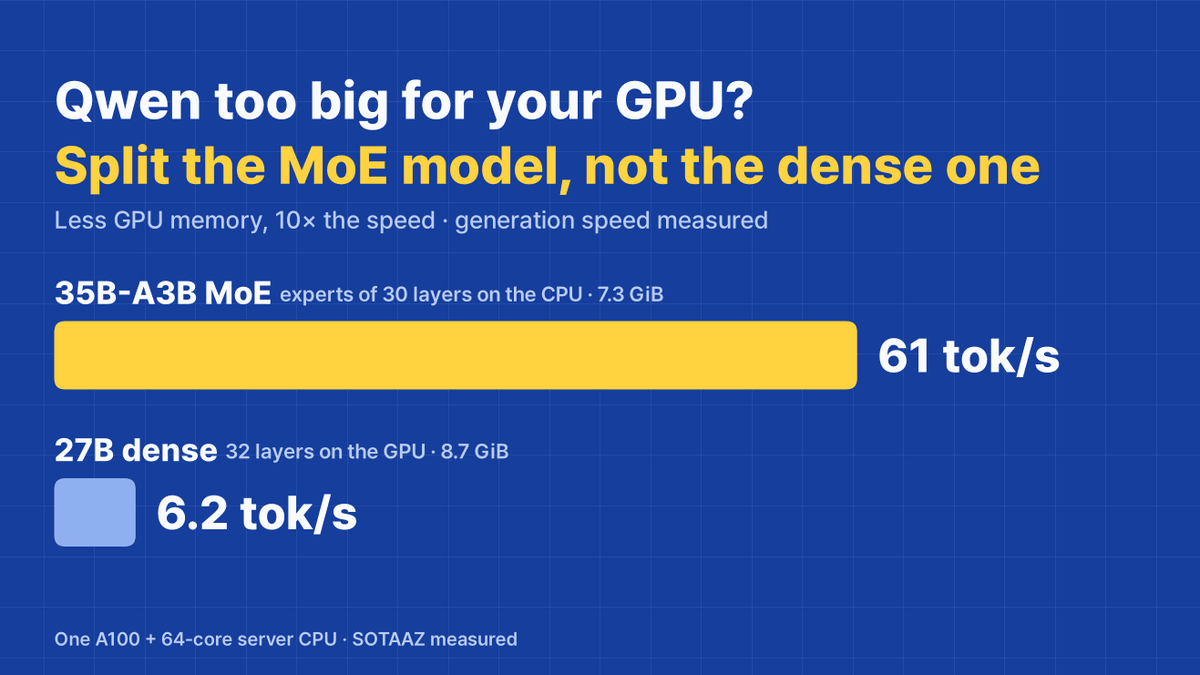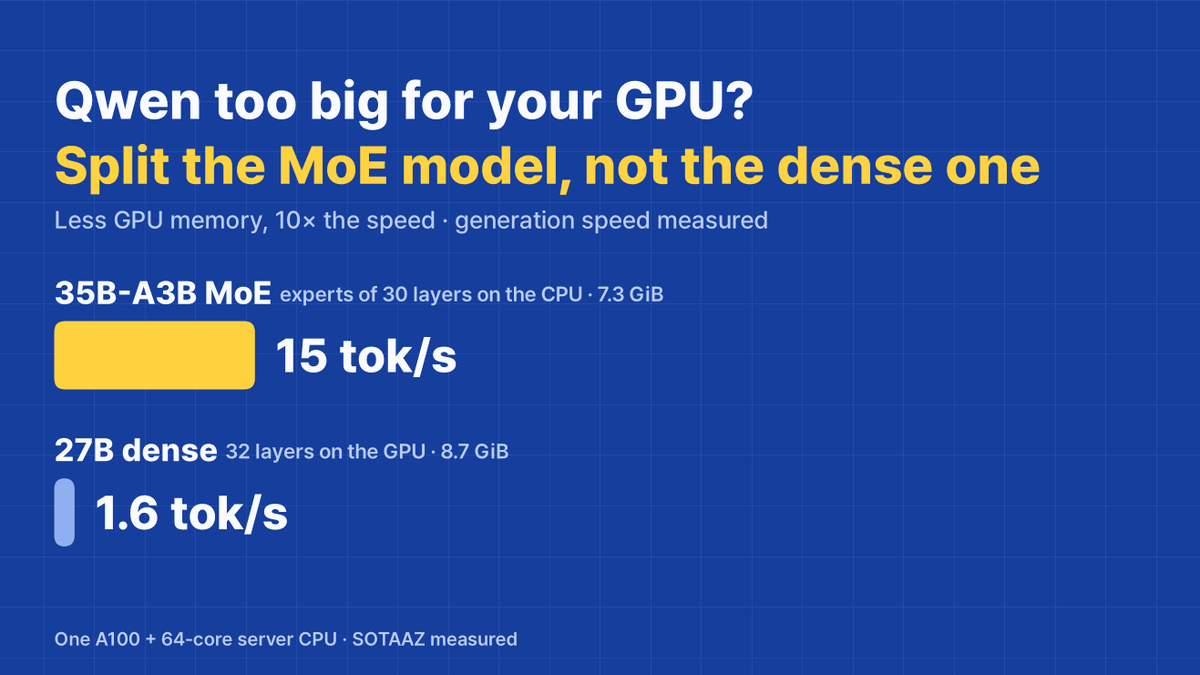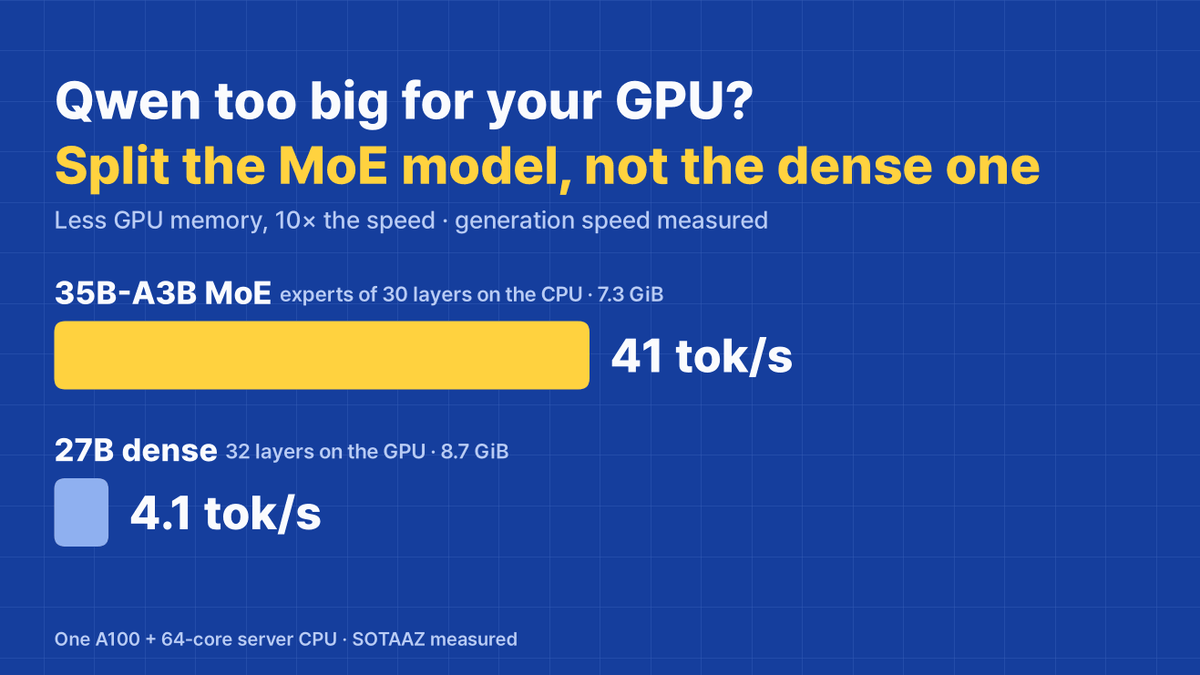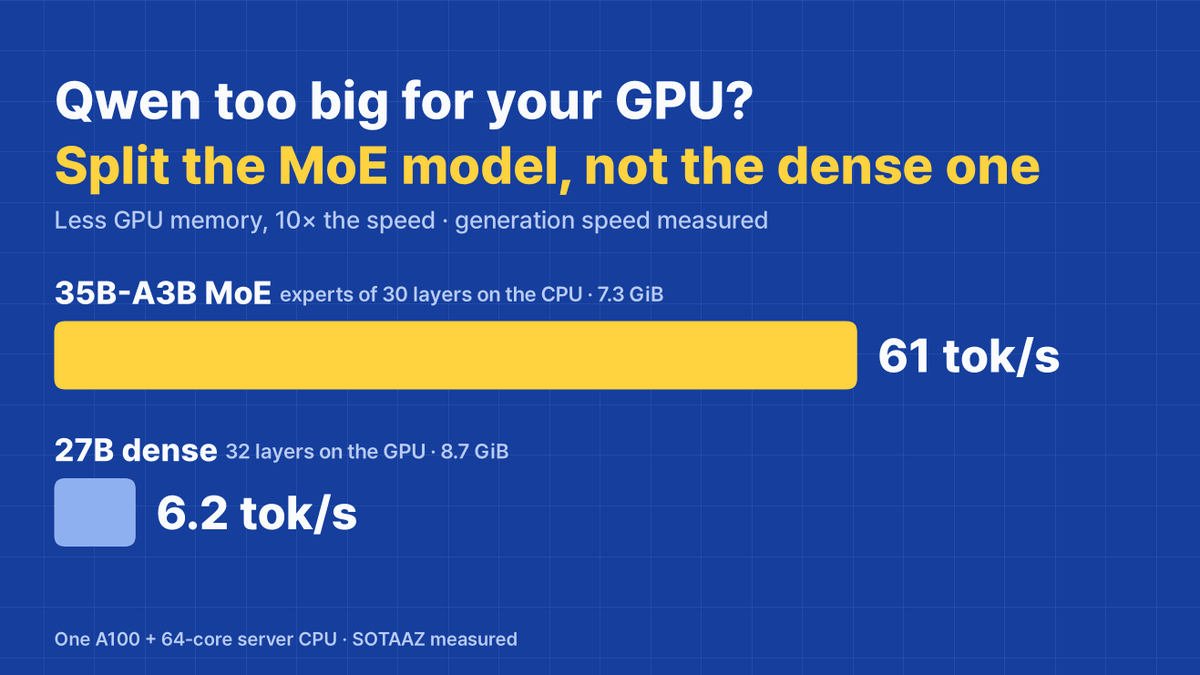
| 12GB | Qwen3.6-35B-A3B Q4_K_M, 30개 층의 전문가를 CPU에 | 7.3GiB (8K) | 초당 61토큰 |
| 16GB | Qwen3.8-27B Q3_K_XL | 13.1 / 14.6GiB | 초당 50토큰 |
| 24GB | Qwen3.8-27B Q4_K_M 또는 Qwen3.6-35B-A3B Q4_K_M | 16.0 / 17.5GiB 또는 20.6 / 21.1GiB | 초당 50 또는 149토큰 |
| GPU 없음 | Qwen3.5-9B Q4_K_M을 CPU로 | GPU 대신 시스템 메모리 | 초당 약 10토큰 |
속도는 A100 80GB 한 장과 64코어 서버 CPU에서 잰 값이라, 대부분의 집 컴퓨터에서는 더 느립니다. 선택지끼리 비교하는 데 쓰고, 내 컴퓨터의 속도를 예상하는 데는 쓰지 마세요.
반면 메모리 숫자는 서버를 띄운 상태에서 그래픽카드에 실제로 잡힌 양이라, 다른 GPU에서도 거의 그대로 통합니다. 단위는 GiB입니다. 그래픽카드의 '12GB'는 사실상 12GiB라서 그대로 비교하면 되고, 화면 출력용으로 0.5~1GB는 남겨 두세요. 12GB 칸을 20개 층이 아니라 30개 층의 전문가를 CPU에 두는 설정(7.3GiB)으로 적은 이유가 여기 있습니다. 20개 층 설정은 11.7GiB에 초당 73토큰으로 더 빨랐지만, 12GB 카드에서는 0.3GiB밖에 남지 않아 화면을 연결하지 않은 카드에서만 권합니다. 30개 층 설정은 8GB 카드에도 들어갑니다.
16GB 칸이 27B Q3_K_XL인 이유는 Q4_K_M이 8K에서 이미 16.0GiB를 썼기 때문입니다. 이 서버에서는 35B-A3B를 나눠 올린 쪽이 더 빨랐지만, 그 속도는 시스템 메모리에 좌우되고 이 서버는 메모리 채널이 8개입니다(데스크톱은 보통 2개). 27B는 전부 GPU에 올라가서, 집 컴퓨터에서도 잰 값에 더 가깝게 나올 가능성이 큽니다.
컨텍스트를 8K에서 32K로 늘려도 메모리는 0.5~1.5GiB만 늘었습니다. 이 Qwen 모델들은 네 층 중 한 층에서만 전체 어텐션을 써서, 컨텍스트와 함께 커지는 캐시가 작게 유지되기 때문입니다. 그래도 더 긴 컨텍스트를 쓰려고 메모리가 모자라면, llama.cpp에서 -ctk q8_0 -ctv q8_0으로 이 캐시를 8비트로 저장할 수 있습니다. 속도를 얼마나 잃는지는 llama.cpp KV 캐시 양자화 실측에서 쟀습니다.
실행 방법
llama.cpp는 파일을 받아서 서버를 띄우면 됩니다.
hf download unsloth/Qwen3.8-27B-GGUF Qwen3.8-27B-UD-Q4_K_M.gguf --local-dir models
llama-server -m models/Qwen3.8-27B-UD-Q4_K_M.gguf -ngl 99 -fa on -c 8192
-ngl 99는 모든 층을 GPU에 올리라는 뜻이고, -fa on은 플래시 어텐션을 켜고, -c는 컨텍스트 길이입니다. 서버가 뜨면 http://127.0.0.1:8080에서 OpenAI 호환 API와 브라우저 채팅 화면을 함께 쓸 수 있습니다.
Ollama는 Ollama 목록에 있는 모델이라면 한 줄이면 됩니다.
ollama run qwen3.5:9bOllama는 Hugging Face의 GGUF 파일을 바로 받아 쓸 수도 있습니다(ollama run hf.co/<저장소>:<양자화>). 이 방법의 속도는 재지 않았습니다. Ollama, llama.cpp, vLLM 설치 과정을 단계별로 보려면 Qwen 3.5 로컬 설치 가이드를 참고하세요.
속도: 이번에는 Ollama의 생성 속도가 23%가량 느렸습니다
서버 부하가 낮을 때 연달아 잰 결과, Qwen3.5-9B Q4_K_M의 생성 속도는 Ollama가 초당 102토큰, 그 바로 앞뒤에 돌린 llama.cpp가 초당 131토큰과 134토큰이었습니다. 프롬프트 처리는 차이가 작았습니다. Ollama는 약 620토큰짜리 서로 다른 프롬프트 다섯 개에서 초당 3,560토큰, llama.cpp는 512토큰 프롬프트에서 초당 3,906~4,027토큰이었습니다. 프롬프트 길이가 달라서 이 쌍은 정확한 비교가 아닙니다.
Ollama는 자기 Q4_K_M 파일(6.6GB, Unsloth 파일은 5.7GB)과 자기가 묶어 둔 llama.cpp를 씁니다. 그래서 이 차이는 엔진 자체의 차이가 아니라, 각자 설치했을 때 그대로의 비교입니다. 속도가 중요하면 llama.cpp를 따로 설치하는 수고를 들일 만했고, 명령 한 줄이 편하다면 Ollama도 초당 100토큰은 냈습니다.
품질: 파일을 줄이면 무엇을 잃나
파일마다 다음 토큰 예측이 같은 모델의 Q8_0 파일과 얼마나 달라지는지를 WikiText-2 80개 구간에서 쟀습니다. 원래 정밀도 파일을 기준으로 삼아야 하지만, 서버 회선으로는 받는 데 너무 오래 걸려 Q8_0을 기준으로 썼습니다. 그래서 아래 숫자는 8비트보다 더 줄였을 때 추가로 잃는 양이고, 전체 손실은 아닙니다.
| 파일 | 파일 크기 | Q8_0과 1순위 토큰이 같은 비율 | KL divergence | Q8_0 대비 perplexity |
|---|---|---|---|---|
| Qwen3.5-9B Q4_K_M | 5.7GB | 92.8% | 0.030 | +0.9% |
| Qwen3.5-9B Q3_K_XL | 5.0GB | 90.6% | 0.043 | +2.2% |
| Qwen3.8-27B Q4_K_M | 16.5GB | 95.9% | 0.009 | +0.2% |
| Qwen3.8-27B Q3_K_XL | 13.1GB | 93.1% | 0.025 | +1.6% |
큰 모델이 압축을 조금 더 잘 견뎠습니다. 3비트로 줄인 27B(1순위 일치 93.1%, KL divergence 0.025)가 4비트로 줄인 9B(92.8%, 0.030)보다 자기 8비트 버전에 약간 더 가까웠습니다. A100에서 27B의 생성 속도는 Q3_K_XL과 Q4_K_M 모두 초당 50토큰이라, Q3_K_XL로 내려도 속도 손해가 거의 없었습니다. 이 측정은 백과사전 문장에서 8비트 모델과 얼마나 같은 답을 내는지를 본 것이지, 내 과제에서의 정확도는 아닙니다.
GPU에 다 안 들어갈 때: 밀집 모델이 아니라 MoE 모델을 나눠 올리세요
모델이 GPU에 다 안 들어가면 llama.cpp는 일부를 시스템 메모리에 둘 수 있습니다. 그런데 어떻게 나누느냐가 모델 크기보다 속도를 훨씬 크게 좌우했습니다.
Qwen3.6-35B-A3B는 층마다 전문가가 256개 있지만 토큰마다 8개만 씁니다. --n-cpu-moe N은 앞쪽 N개 층의 전문가 가중치만 시스템 메모리에 두고 나머지는 GPU에 둡니다.
| Qwen3.6-35B-A3B Q4_K_M | GPU 메모리 (8K) | 생성 속도 |
|---|---|---|
| 전부 GPU | 20.6GiB | 초당 149토큰 |
| 10개 층의 전문가를 CPU에 | 16.2GiB | 초당 105토큰 |
| 20개 층의 전문가를 CPU에 | 11.7GiB | 초당 73토큰 |
| 30개 층의 전문가를 CPU에 | 7.3GiB | 초당 61토큰 |
| 전문가를 모두 CPU에 | 2.6GiB | 초당 52토큰 |
밀집(dense) 모델인 27B는 이렇게 나눌 수 없어서, 보통 -ngl로 GPU에 올리는 층 수를 줄입니다.
| Qwen3.8-27B Q4_K_M | GPU 메모리 (8K) | 생성 속도 |
|---|---|---|
| 모든 층을 GPU | 16.0GiB | 초당 50토큰 |
| 48개 층만 GPU | 12.3GiB | 초당 10.7토큰 |
| 32개 층만 GPU | 8.7GiB | 초당 6.2토큰 |
표에 적은 설정끼리 보면, 35B MoE 모델은 7.3GiB를 쓰고 초당 61토큰을 냈습니다. 27B 밀집 모델은 32개 층만 GPU에 올려 오히려 더 많은 8.7GiB를 쓰고도 초당 6.2토큰으로 약 10분의 1이었습니다. 12GiB 안팎(11.7 대 12.3)에서도 초당 73토큰 대 10.7토큰으로 격차가 비슷했습니다. 토큰 하나를 만들 때 시스템 메모리에서 끌어와야 하는 양이 다르기 때문입니다. 밀집 모델은 CPU 쪽에 둔 가중치를 전부 읽어야 하고, MoE 모델은 고른 전문가 8개만 읽으면 됩니다.
다만 이 서버의 CPU는 64코어에 메모리 채널이 8개라, 두 경우 모두 CPU 쪽 속도가 일반 데스크톱보다 높게 나옵니다. 그러니 절대 속도보다는 두 방식의 격차를 결론으로 가져가세요. llama.cpp 스레드를 8개로 제한해도 속도는 10% 안쪽으로만 바뀌었습니다. 코어 수보다 메모리 대역폭이 병목이라는 뜻으로 보입니다.
GPU가 아예 없다면
Qwen3.5-9B Q4_K_M을 CPU로만 돌리면 생성은 초당 9.6~10.4토큰이었습니다. 프롬프트는 스레드 8개로 초당 41토큰, 64코어를 모두 쓰면 초당 162토큰으로 읽었습니다. 채팅에는 쓸 만하지만 긴 문서를 넣기에는 느립니다. 메모리 채널이 두 개인 데스크톱에서는 이보다 느리다고 보는 편이 맞습니다.
측정 범위
GPU 한 장(A100 80GB PCIe)과 서버 CPU 하나에서 쟀기 때문에, 내 컴퓨터로 그대로 가져갈 수 있는 것은 메모리 숫자뿐입니다. 품질은 WikiText-2에서 각 모델의 8비트 파일과 비교한 것이고, 원래 가중치와 비교한 것도, 특정 과제의 정확도도 아닙니다. 35B-A3B 파일은 bartowski 판 Q4_K_M이고 나머지는 Unsloth 판입니다. Apple Silicon, LM Studio, 32K보다 긴 컨텍스트는 시험하지 않았습니다.
실험 환경: A100 80GB PCIe 한 장(드라이버 580.178.04), AMD EPYC 7742(64코어). llama.cpp 4da6337을 CUDA 12.1로 빌드했습니다. 속도는 llama-bench -ngl 99 -fa 1 -p 512 -n 128 -r 3으로 쟀고, GPU 메모리는 llama-server -ngl 99 -fa on -c 8192(또는 32768)를 기본 슬롯 4개로 띄운 상태에서 nvidia-smi로 읽었습니다(MiB 값을 GiB로 표기). 파일은 unsloth/Qwen3.5-9B-GGUF(Q4_K_M, UD-Q3_K_XL, Q8_0), unsloth/Qwen3.8-27B-GGUF(UD-Q4_K_M, UD-Q3_K_XL, Q8_0), bartowski/Qwen_Qwen3.6-35B-A3B-GGUF(Qwen_Qwen3.6-35B-A3B-Q4_K_M.gguf, 리비전 5c2410d)입니다. 품질은 llama-perplexity --kl-divergence로 WikiText-2 test의 512토큰 구간 80개에서 각 모델의 Q8_0과 비교했습니다. Ollama는 0.34.0(snap)의 qwen3.5:9b(Q4_K_M)에 약 620토큰짜리 서로 다른 프롬프트 다섯 개를 보내 각각 128토큰을 생성했고, 적재용 첫 호출을 뺀 중앙값을 썼습니다. llama.cpp는 그 바로 앞뒤에 돌렸습니다. Ollama와 CPU 전용 수치는 모든 단계를 1분 부하 평균 4 미만에서 시작한 두 번째 측정(scripts/qwen-local/paired-rerun.sh)의 값입니다. 첫 측정은 다른 작업 때문에 부하가 30을 넘을 때 돌았습니다. CPU 전용은 -ngl 0입니다. 2026-09-28 측정.
이 글과 이어지는 강좌
SOTAAZ 강좌
강좌는 하나씩 살 수 있습니다. 13개 전체가 필요하면 $199 평생 번들도 있습니다.
이메일로 받아보기
관련 포스트
llama.cpp KV 캐시 양자화, A100 한 장에서 실측 — q8_0은 4K에서 공짜이고 64K에서는 디코드 속도 절반을 냅니다
본류 llama.cpp, Qwen3-8B, A100 한 장. -ctk q8_0 -ctv q8_0은 퍼플렉시티가 f16과 같고 32K 캐시를 2.11 GiB 줄이지만, 64K 깊이 디코드는 f16의 55%로 떨어집니다(q4_0은 50%). q5_1과 K q8_0/V q4_0 혼합은 프리필이 초당 43·63토큰으로 조용히 CPU에서 돌았습니다.
Qwen 3.5 파인튜닝 실전 가이드 — LoRA로 나만의 모델 만들기
Qwen 3.5를 LoRA/QLoRA로 파인튜닝하는 전 과정을 다룹니다. 8GB GPU에서도 가능한 QLoRA 설정부터 Unsloth 최적화, GGUF 변환, Ollama 배포까지.
llama.cpp의 -ctk·-ctv, 기본 CUDA 빌드에서 쓸 수 있는 값은 넷입니다
llama-bench는 KV 캐시 타입 여덟 개를, llama-server는 아홉 개를 받습니다. 그런데 기본 CUDA 빌드는 FlashAttention 커널을 f16·bf16·q8_0·q4_0 네 타입에만, 그것도 K와 V가 같을 때만 컴파일합니다. 나머지 설정은 커널이 없어 프리필이 초당 4,600토큰에서 83~284토큰으로 떨어집니다. llama.cpp 69320fe, A100 실측입니다.