llama.cpp의 -ctk·-ctv, 기본 CUDA 빌드에서 쓸 수 있는 값은 넷입니다
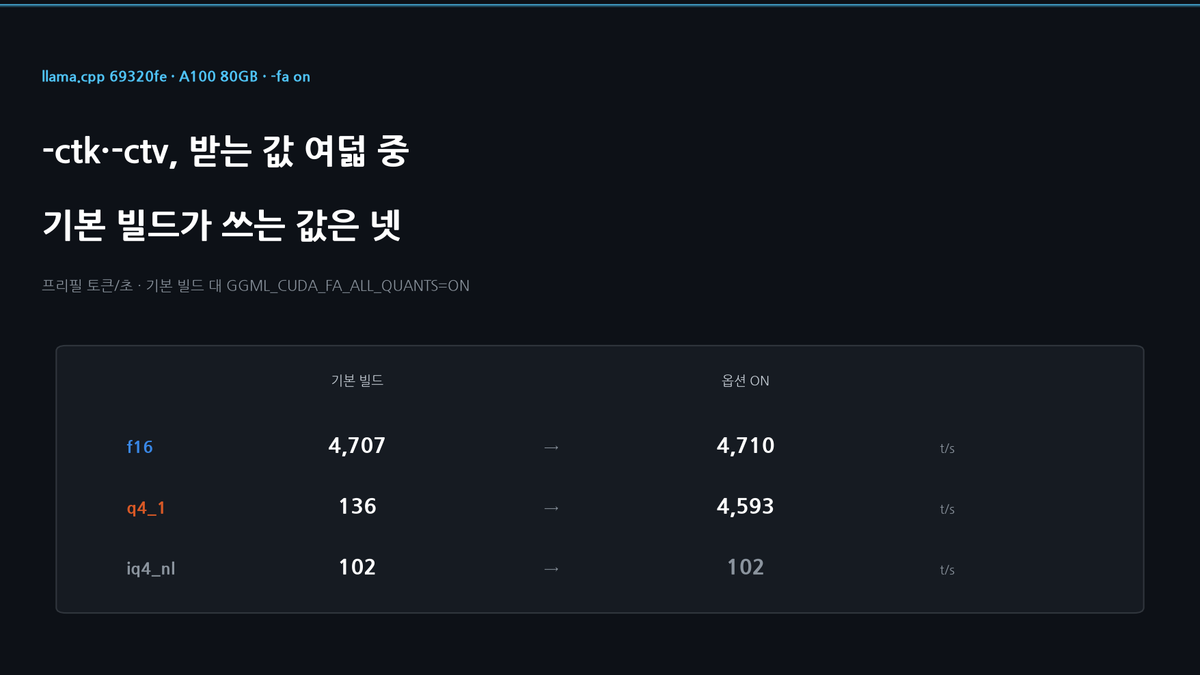
llama-bench는 KV 캐시 타입 여덟 개를, llama-server는 아홉 개를 받습니다. 그런데 기본 CUDA 빌드는 FlashAttention 커널을 f16·bf16·q8_0·q4_0 네 타입에만, 그것도 K와 V가 같을 때만 컴파일합니다. 나머지 설정은 커널이 없어 프리필이 초당 4,600토큰에서 83~284토큰으로 떨어집니다. llama.cpp 69320fe, A100 실측입니다.
llama.cpp의 -ctk·-ctv, 기본 CUDA 빌드에서 쓸 수 있는 값은 넷입니다
-ctk와 -ctv는 KV 캐시를 어떤 자료형으로 담을지 정합니다. llama-bench 도움말은 기본값만 찍어 주고 끝납니다. llama-server 쪽은 허용값 아홉 개를 나열해 주지만, 각각이 얼마를 내야 하는지는 어느 쪽에도 없습니다. A100 한 장에서 받는 값을 전부 재 봤습니다.
결론부터 적습니다. 받는 값 목록은 실행하는 바이너리에 따라 다릅니다. 그리고 기본 CUDA 빌드는 그중 네 타입에만 FlashAttention 커널을 컴파일하고, K와 V가 다르면 아예 커널을 고르지 않습니다. 컴파일 시점에 정해지는 일이라 실행할 때는 경고도 없습니다.
| 타입 | llama-bench | llama-server·llama-cli | 32K 캐시 | 프리필(4,096토큰) |
|---|---|---|---|---|
| f32 | 안 받음 | 받음 | 9.00 GiB | 측정 안 함 |
| f16 | 받음 | 받음 | 4.50 GiB | 4,707 t/s |
| bf16 | 받음 | 받음 | 4.50 GiB | 4,652 t/s |
| q8_0 | 받음 | 받음 | 2.39 GiB | 4,584 t/s |
| q5_1 | 받음 | 받음 | 1.69 GiB | 83 t/s |
| q5_0 | 받음 | 받음 | 1.55 GiB | 88 t/s |
| q4_1 | 받음 | 받음 | 1.41 GiB | 140 t/s |
| q4_0 | 받음 | 받음 | 1.27 GiB | 4,594 t/s |
| iq4_nl | 받음 | 받음 | 1.27 GiB | 88 t/s |
목록이 두 개입니다
llama-bench는 이 플래그를 직접 해석합니다. tools/llama-bench/llama-bench.cpp의 ggml_type_from_name이 이름 여덟 개를 압니다. 나머지 실행 파일은 common/arg.cpp를 거치는데, 그쪽 kv_cache_types에는 아홉 개가 들어 있습니다. 같은 여덟 개에 f32가 더해진 목록입니다.
그래서 llama-server -ctk f32는 뜨고 llama-bench -ctk f32는 error: invalid parameter for argument: -ctk로 끝납니다. 같은 저장소, 같은 커밋인데 갈리고, 도움말에는 이 이야기가 없습니다.
llama-bench에서는 두 플래그 모두 쉼표로 여러 값을 받습니다. 한 번에 훑을 때 씁니다.
llama-bench -m model.gguf -fa on -ngl 99 -ctk f16,q8_0,q4_0 -ctv f16,q8_0,q4_0 -p 4096 -n 128 -d 0 -d 8192여덟 중 넷은 CUDA FlashAttention 경로에서 떨어집니다
Qwen3-8B Q4_K_M, A100 80GB 한 장, -fa on -ngl 99, K와 V를 같은 타입으로 두고 쟀습니다.
| 타입 | 프리필 4,096 | 프리필 @8K | 디코드 128 | 디코드 @8K | 디코드 @32K |
|---|---|---|---|---|---|
| f16 | 4,707 | 3,950 | 152.0 | 134.6 | 104.6 |
| bf16 | 4,652 | 3,822 | 144.9 | 91.4 | 44.3 |
| q8_0 | 4,584 | 3,797 | 142.3 | 110.1 | 67.4 |
| q4_0 | 4,594 | 3,788 | 141.9 | 107.2 | 63.4 |
| q4_1 | 140.2 | 25.1 | 93.6 | 7.2 | — |
| q5_0 | 88.2 | 17.8 | 90.6 | 6.1 | — |
| q5_1 | 83.2 | 18.1 | 94.0 | 7.2 | — |
| iq4_nl | 88.0 | 18.7 | 82.9 | 6.6 | — |
단위는 초당 토큰이고 설정마다 2회 반복입니다. 아래 네 타입의 @32K 칸이 빈 것은 설정당 15분 상한에 걸려 그 구간을 시작하지 못했기 때문입니다. 느린 쪽이 얼마나 느린지는 @8K 칸이 보여 줍니다. 이미 8K가 쌓인 상태에서 4,096토큰을 넣는 데 초당 18.7토큰이면 3분 39초가 걸립니다.
두 무리의 차이는 세금이 아니라 절벽입니다. 느린 네 타입은 32K 캐시로 1.27~1.69 GiB를 쓰면서 프리필이 q4_0보다 33~55배 느립니다. 특히 iq4_nl과 q4_0은 토큰당 40.5 KiB로 저장량이 정확히 같은데 프리필 속도가 52배 차이입니다. 생성도 깊이가 쌓이면 무너집니다. 8K 깊이 디코드에서 느린 넷은 초당 6.1~7.2토큰이고, q4_0은 107.2입니다.
원인은 빌드 옵션에 적혀 있습니다
이번에는 추측하지 않아도 됩니다. ggml/src/ggml-cuda/fattn.cu가 커널을 고르기 전에 두 가지를 검사합니다.
#ifndef GGML_CUDA_FA_ALL_QUANTS
    if (K->type != V->type) {
        return BEST_FATTN_KERNEL_NONE;
    }
#endif
그리고 같은 파일의 ggml_cuda_fattn_kv_type_supported는 f32·f16·bf16·q8_0·q4_0에 true를 돌려주고, q4_1·q5_0·q5_1은 GGML_CUDA_FA_ALL_QUANTS가 켜져 있을 때만 true입니다. iq4_nl은 어느 쪽에도 없어 항상 false입니다.
이 옵션의 CMake 기본값은 OFF입니다(ggml/CMakeLists.txt). 제가 쓴 빌드도 CMakeCache.txt 기준 OFF였습니다. 즉 느린 네 타입과 모든 불일치 조합은 FlashAttention 커널이 아예 컴파일되지 않아 커널 선택이 BEST_FATTN_KERNEL_NONE으로 떨어지고, 느린 일반 경로로 갑니다. -fa on을 줬는데도 그렇습니다.
정리하면 이건 GPU의 한계가 아니라 빌드 구성입니다. 모든 조합이 필요하면 -DGGML_CUDA_FA_ALL_QUANTS=ON으로 다시 빌드해야 하고, 그러면 컴파일 시간과 바이너리 크기를 더 냅니다. iq4_nl은 그래도 안 됩니다. 다음 절에서 실제로 얼마나 회복되는지 쟀습니다.
K와 V를 다르게 줘도 무너집니다
-ctk와 -ctv는 별개 플래그라서 V만 더 세게 양자화하는 설정이 가능합니다. 이 빌드에서는 둘이 다르기만 하면 빠른 경로에서 떨어집니다. 각각은 빠른 타입인 조합도 마찬가지입니다.
| K / V | 프리필 4,096 | 디코드 128 |
|---|---|---|
| f16 / f16 | 4,707 | 152.0 |
| q8_0 / q8_0 | 4,584 | 142.3 |
| q8_0 / f16 | 283.8 | 89.3 |
| f16 / q8_0 | 213.0 | 89.7 |
| q8_0 / q4_0 | 125.9 | 92.9 |
| f16 / q4_0 | 122.1 | 91.3 |
기본 빌드에서 남는 규칙은 하나입니다. 두 플래그에 같은 값을 넣으십시오. 앞선 글에서 q8_0/q4_0 혼합이 느리다고 적으면서 그 쌍이 문제인 것처럼 다뤘는데, 쌍의 문제가 아니라 다르다는 것 자체가 문제였습니다.
옵션을 켜면 어디까지 살아나는지
원인이 빌드 옵션이라면 켜 보면 됩니다. 같은 커밋을 -DGGML_CUDA_FA_ALL_QUANTS=ON으로 다시 빌드해 같은 조건으로 쟀습니다. 두 빌드 모두 CMAKE_BUILD_TYPE=Release, sm80입니다.
| K / V | 기본 빌드 프리필 | ALL_QUANTS 프리필 | 기본 디코드 | ALL_QUANTS 디코드 |
|---|---|---|---|---|
| f16 / f16 (대조군) | 4,708 | 4,710 | 153.8 | 153.8 |
| q8_0 / q8_0 (대조군) | 4,587 | 4,588 | 144.3 | 144.3 |
| q4_1 / q4_1 | 136.2 | 4,593 | 93.1 | 144.6 |
| q5_0 / q5_0 | 100.7 | 4,582 | 91.4 | 140.2 |
| q5_1 / q5_1 | 94.8 | 4,589 | 93.5 | 143.5 |
| q8_0 / q4_0 | 143.9 | 4,591 | 93.0 | 143.7 |
| iq4_nl / iq4_nl | 102.1 | 101.6 | 82.6 | 83.4 |
대조군 두 줄이 소수점까지 같으니 두 빌드를 맞대 볼 수 있습니다. 옵션을 켜면 느리던 세 타입과 혼합 조합이 전부 제 속도를 냅니다. 프리필 4,582~4,593은 q4_0의 4,599와 사실상 같습니다.
iq4_nl만 그대로입니다. 소스의 지원 목록에 아예 없다는 예측과 맞습니다. 이 타입을 KV 캐시로 쓰는 길은 이 커밋에 없습니다.
내야 하는 값은 컴파일 시간과 바이너리 크기입니다. 커널 조합을 훨씬 많이 찍어 내기 때문입니다. 긴 컨텍스트에서 q5_1의 메모리(32K에 1.69 GiB)가 꼭 필요한 경우가 아니라면, 기본 빌드에서 q8_0이나 q4_0을 쓰는 편이 간단합니다.
안전해 보이는데 아닌 값은 bf16입니다
bf16은 메모리를 f16과 똑같이 토큰당 144 KiB 씁니다. 프리필도 빠른 경로에 남아 있습니다. 그래서 바꿔도 손해가 없어 보입니다. 그런데 깊은 컨텍스트에서는 쓸 수 있는 넷 중 가장 느립니다. 32K에서 초당 44.3토큰이고, f16은 104.6입니다. 양자화한 두 타입보다도 낮습니다. 어차피 4.5 GiB를 들고 있을 것이라면 f16이 그 깊이에서 2.4배 빠릅니다.
무엇을 넣을까
- 캐시가 VRAM에 들어간다면 f16을 그대로 두십시오. 측정한 모든 깊이에서 가장 빠릅니다.
- 메모리를 돌려받아야 한다면
-ctk q8_0 -ctv q8_0이 32K 캐시를 2.39 GiB로 줄이고, 그 깊이의 디코드 처리량을 36% 내놓습니다.q4_0은 1.27 GiB에 39%입니다. - 목록의 나머지 값이나 K·V를 다르게 주는 설정은 기본 빌드에서 FlashAttention 커널이 없습니다. 꼭 써야 한다면
-DGGML_CUDA_FA_ALL_QUANTS=ON으로 다시 빌드하고 직접 재십시오. 실패가 조용합니다. 모델은 뜨고 답도 맞습니다. 긴 프롬프트만 걸어 다니는 속도로 들어갑니다.
메모리 칸은 측정이 아니라 계산입니다. 층 36개 × KV 헤드 8개 × 차원 128 × 2(K와 V) × 원소당 바이트 수에 컨텍스트 길이를 곱했습니다. Qwen3-8B는 KV 헤드가 8개인 grouped-query attention이라 32K f16 캐시가 수십 기가가 아니라 4.5 GiB입니다.
이 표를 한 번 날린 함정
첫 스윕에서는 f16 프리필이 초당 1,976토큰으로 나왔습니다. 진짜 값은 4,707입니다. 멈춘 줄 알았던 실행이 같은 GPU에 남아 있어서 두 프로세스가 카드를 나눠 쓰고 있었습니다. 출력만 봐서는 알 수 없습니다. 두 프로세스가 고르게 느려졌기 때문에 llama-bench는 표준편차가 작은 깨끗한 평균을 찍어 줍니다.
공용 장비에서 벤치마크를 돌린다면 숫자를 믿기 전에 nvidia-smi --query-compute-apps=pid,used_memory --format=csv부터 보고, 스윕은 한 번에 하나만 돌리십시오. 하네스 킷의 스윕 스크립트는 이제 다른 llama-bench가 살아 있으면 시작을 거부합니다. 다만 그것으로 막히는 것은 제 실행뿐이고, 공용 카드에 올라온 남의 프로세스는 못 막습니다.
하네스와 원시 결과: 스윕 스크립트와 설정별 JSON은 KV 캐시 벤치마크 하네스 킷에 함께 넣어 두었습니다(무료).
측정 환경: llama.cpp 69320fe(CUDA, sm80, CMAKE_BUILD_TYPE=Release), Qwen3-8B Q4_K_M, A100 80GB PCIe 한 장. 본문 표는 GGML_CUDA_FA_ALL_QUANTS=OFF인 기본 빌드이고, 비교 절만 같은 커밋을 ON 으로 다시 빌드해 같은 카드에서 쟀습니다. 설정은 -fa on -ngl 99 -p 4096 -n 128 -d 0 -d 8192 -d 32768 -r 2, 한 번에 한 프로세스. K·V 혼합 조합은 깊이 0에서 -r 1로 쟀습니다. 받는 값 목록은 같은 커밋의 tools/llama-bench/llama-bench.cpp(ggml_type_from_name)와 common/arg.cpp(kv_cache_types)에서 읽었습니다. 측정일 2026-09-21.
같은 측정을 당신 모델로 받아 보시겠습니까
모델과 조건을 알려 주시면 저희가 조건을 설계해 돌리고, 어떤 선택을 해야 하는지까지 적어 드립니다. 기본 장비는 A100 80GB이고 다른 GPU도 가능합니다.
이메일로 받아보기
관련 포스트
llama.cpp KV 캐시 양자화: q8_0 처리량 손실이 9%에서 22%로 커지는 이유
본류 llama.cpp, A100 한 장, Qwen3-8B Q4_K_M, llama-server 동시 슬롯 1~32. 32K 프롬프트에서 q8_0은 요청당 128토큰을 생성할 때 서버 처리량의 9%를 잃었고, 1,024토큰을 생성할 때는 22%를 잃었습니다. 짧은 쪽은 프리필이 벽시계를 지배하는데 프리필은 KV 타입을 타지 않기 때문입니다. 토큰당 디코드는 34% 느렸고 이는 llama-bench 결과와 일치합니다. 시작 직후 VRAM 사용량은 64K 슬롯 4개에서 41.0 GiB에서 25.1 GiB로 내려갔습니다.
llama.cpp KV 캐시 양자화, A100 한 장에서 실측 — q8_0은 4K에서 공짜이고 64K에서는 디코드 속도 절반을 냅니다
본류 llama.cpp, Qwen3-8B, A100 한 장. -ctk q8_0 -ctv q8_0은 퍼플렉시티가 f16과 같고 32K 캐시를 2.11 GiB 줄이지만, 64K 깊이 디코드는 f16의 55%로 떨어집니다(q4_0은 50%). q5_1과 K q8_0/V q4_0 혼합은 프리필이 초당 43·63토큰으로 조용히 CPU에서 돌았습니다.
Jev의 속도 주장, 라벨만 필요한 분류에도 적용될까? BANKING77 기준선 실측
BANKING77 테스트셋에서 라벨만 출력하는 네 가지 분류 방식을 같은 메시지 154건으로 비교했습니다. MiniLM 임베딩과 로지스틱 회귀는 CPU에서 정확도 90.3%, 지연 중앙값 6.8ms를 기록했습니다. Jev 자체는 아직 측정하지 않았습니다.