llama.cpp KV 캐시 양자화: q8_0 처리량 손실이 9%에서 22%로 커지는 이유
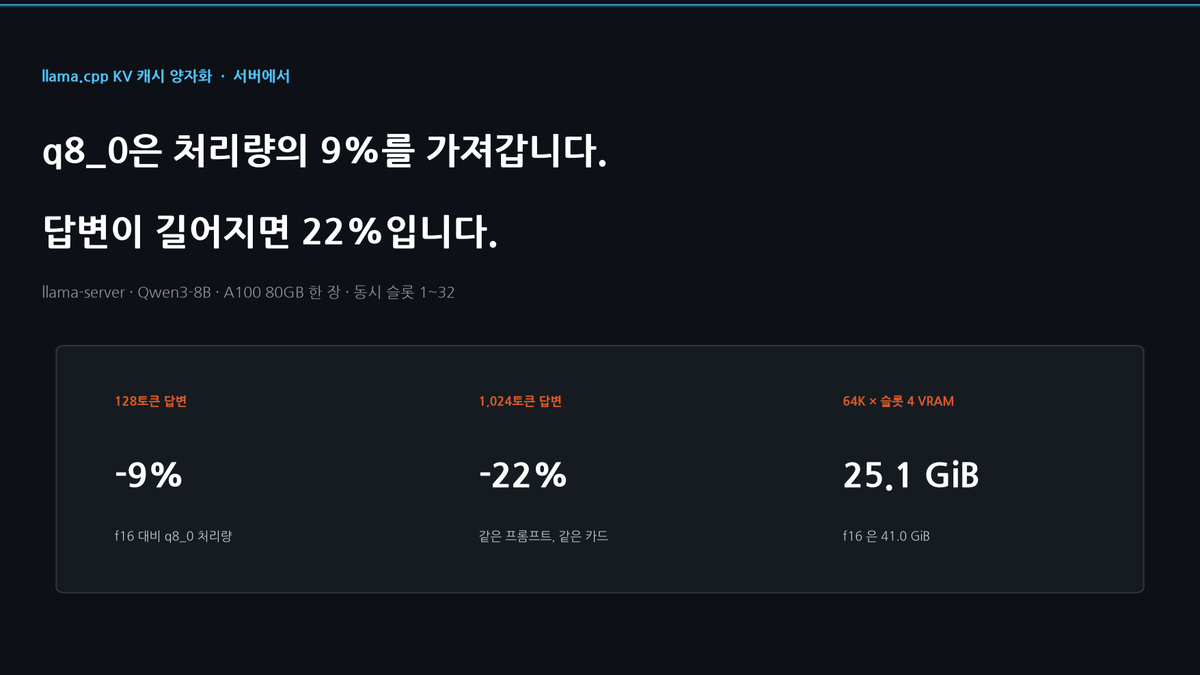
본류 llama.cpp, A100 한 장, Qwen3-8B Q4_K_M, llama-server 동시 슬롯 1~32. 32K 프롬프트에서 q8_0은 요청당 128토큰을 생성할 때 서버 처리량의 9%를 잃었고, 1,024토큰을 생성할 때는 22%를 잃었습니다. 짧은 쪽은 프리필이 벽시계를 지배하는데 프리필은 KV 타입을 타지 않기 때문입니다. 토큰당 디코드는 34% 느렸고 이는 llama-bench 결과와 일치합니다. 시작 직후 VRAM 사용량은 64K 슬롯 4개에서 41.0 GiB에서 25.1 GiB로 내려갔습니다.
llama.cpp KV 캐시 양자화: q8_0 처리량 손실이 9%에서 22%로 커지는 이유
앞 글은 llama-bench로 쟀고, 마지막에 제가 직접 적어 둔 한계가 있었습니다. 배치 1에 단일 스트림이라 동시 요청을 받는 서버는 대역폭 그림이 다르다는 것이었습니다. 그 문장이 이 글의 질문입니다.
llama.cpp kv cache quantization을 검색해 들어오시는 분들은 대개 llama-bench를 돌리는 게 아닙니다. 동시 슬롯을 가진 llama-server를 띄워 두고 -ctk q8_0 -ctv q8_0이 거기서 얼마를 가져가는지 알고 싶은 상황입니다. 답은 숫자 하나가 아니었습니다. 같은 카드에서 같은 설정이 어떤 워크로드에서는 처리량의 9%를, 다른 워크로드에서는 22%를 가져갔습니다. 차이를 만든 것은 요청마다 생성하는 토큰 수였습니다.
앞 글과 같은 카드, 같은 모델, 같은 빌드라서 두 글의 숫자를 나란히 놓을 수 있습니다.
측정 환경
A100 80GB PCIe 한 장, 드라이버 535. llama.cpp 본류 ggml-org master 69320fe(2026-09-02), sm80 CUDA 빌드로 앞 글과 같은 커밋입니다. 모델은 Qwen3-8B Q4_K_M. 모든 서버는 -fa 1 -ngl 99 --no-context-shift로 띄우고 -np로 슬롯 수를, -c로 슬롯 수 곱하기 슬롯당 컨텍스트를 줬습니다. 프롬프트는 같은 문장을 반복한 합성 텍스트이고, 서버 토크나이저로 길이를 재서 잘랐기 때문에 모든 KV 타입이 같은 프롬프트 길이를 받습니다.
부하는 직접 만든 asyncio 클라이언트가 겁니다. -np개의 스트리밍 요청을 동시에 열고 temperature 0에 cache_prompt false라서 요청마다 프리필을 전부 치릅니다. 워밍업 라운드는 한 번 돌리고 버립니다.
세 지표는 서로 바꿔 쓸 수 없어서 정의를 적어 둡니다.
- TTFT는 요청을 보낸 시각부터 content가 실린 첫 SSE 메시지가 도착한 시각까지입니다.
- 스트림당 속도는 요청마다 첫 content 메시지부터 마지막 content 메시지까지의 시간을 메시지 수에서 1을 뺀 값으로 나눠 구합니다. 그렇게 나온 요청별 값의 중앙값을 역수로 바꾼 것입니다. 요청별 속도의 중앙값이 아닙니다.
- 처리량은 모든 요청의 생성 토큰 합을 벽시계 시간으로 나눈 값이라, 아직 아무것도 생성되지 않는 프리필 구간을 포함합니다.
토큰 수는 서버가 종료 메시지에 싣는 timings.predicted_n을 씁니다. 여기 실린 33개 설정 전부에서 클라이언트가 센 content 메시지 수가 이 값과 정확히 일치했으므로, 둘이 같은 것을 토큰으로 세고 있습니다. 서버는 predicted_per_second도 함께 보고하는데 이 값에는 네트워크와 클라이언트 스케줄링이 빠져 있습니다. 동시 1개일 때는 클라이언트 값과 0.1 tok/s 안에서 만나고, 슬롯 4개일 때는 4~9% 높게 나옵니다. 클라이언트가 떠안은 스케줄링 지연을 서버는 세지 않기 때문입니다.
타입은 f16, q8_0, q4_0 셋만 다룹니다. 앞 글에서 q5_1과 K q8_0 / V q4_0 혼합은 8K 프리필이 초당 43토큰과 63토큰으로 나왔고 f16은 4,539토큰이었습니다. 그동안 GPU 사용률은 2~4%에 머물렀습니다. 그때도 원인을 밝히지 못했고 이번에도 밝히지 못했습니다.
토큰당 디코드는 llama-bench와 같습니다
두 도구가 서로 다른 경로로 재기 때문에 이것부터 맞춰 봤습니다. 동시 요청 1개일 때 스트림당 생성 속도입니다.
- 프롬프트 8K: f16 129.3, q8_0 107.7(83%), q4_0 104.8 tok/s(81%)
- 프롬프트 32K: f16 101.3, q8_0 66.7(66%), q4_0 62.6 tok/s(62%)
앞 글의 llama-bench 디코드는 같은 깊이에서 8K일 때 134.4 / 110.2(82%) / 107.2(80%), 32K일 때 105.0 / 68.0(65%) / 63.6(61%)이었습니다. 비율이 1퍼센트포인트 안에서 겹칩니다. 서로 다른 바이너리를 서로 다른 하네스로 쟀는데 같은 값이 나왔습니다. 어느 쪽 수치를 근거로 삼아도 된다는 뜻입니다.
단위를 한 번 짚고 가겠습니다. 32K에서 q8_0은 f16 속도의 66%로 도는데, 이것을 시간으로 바꾸면 같은 토큰 수를 만드는 데 약 52% 더 걸린다는 뜻입니다. 34%가 아닙니다. 속도와 소요 시간은 서로 역수라서, 두 숫자는 같은 사실을 다르게 말한 것입니다.
서버가 잃는 것은 그보다 훨씬 적습니다
같은 실행을 서버 관점으로 보면 다릅니다. 총 생성 토큰을 벽시계로 나눈 값, 그러니까 이 장비가 시간당 몇 건을 처리하느냐입니다. f16 대비 q8_0의 비율입니다.
- 프롬프트 2,048에 출력 128: 슬롯 1개에서 92%, 4개에서 94%, 16개에서 91%, 32개에서 90%
- 프롬프트 8,192에 출력 128: 각각 92%, 94%, 92%
- 프롬프트 32,768에 출력 128: 각각 91%, 94%
시간으로 52%까지 벌어지는 토큰당 페널티가 처리량에서는 6~9%로 나타납니다. 이유는 시계에 그대로 있습니다. 32K 프롬프트에 출력 128토큰, 슬롯 1개에서 f16은 첫 토큰까지 10.04초, 나머지를 만드는 데 1.26초를 썼습니다. q8_0은 10.49초와 1.90초였습니다. 프리필이 0.45초, 생성이 0.64초 늘어 요청 전체가 11.3초에서 12.4초가 됐습니다. 프리필이 더 큰 몫인데 가장 적게 움직입니다. 캐시를 쌓아 가며 읽지, 매 스텝마다 전체를 다시 읽지 않기 때문입니다.
여기서 잰 출력 128토큰 설정, 그러니까 2K 프롬프트에서 슬롯 1~32개, 8K에서 1~16개, 32K에서 1~4개 전 범위에서 비율은 90~94%에 머물렀고 동시성에 따른 추세가 없었습니다. 다만 이것은 잰 범위 안에서 효과가 보이지 않았다는 뜻이지, 더 높은 동시성이나 더 긴 프롬프트에서도 없다는 증거는 아닙니다. 슬롯 32개는 2K 프롬프트에서만 쟀습니다.
TTFT는 가깝지만 같지는 않습니다. 동시 1개일 때는 모든 프롬프트 길이에서 세 타입이 0.5초 안에 들어옵니다. 8K 프롬프트에 슬롯 16개가 되면 더 벌어져서 f16 17.60초, q8_0 17.94초로 0.34초 차이가 납니다.
출력 길이가 숫자를 움직입니다
위 계산대로라면 생성이 요청에서 차지하는 몫이 커질수록 페널티도 커져야 합니다. 그래서 추정하지 않고 돌렸습니다. 같은 32K 프롬프트에 출력만 128에서 1,024토큰으로 올린 결과입니다.
- 슬롯 1개: f16 50.7, q8_0 39.4(78%), q4_0 38.0 tok/s(75%)
- 슬롯 4개: f16 60.6, q8_0 46.3(76%), q4_0 44.6 tok/s(74%)
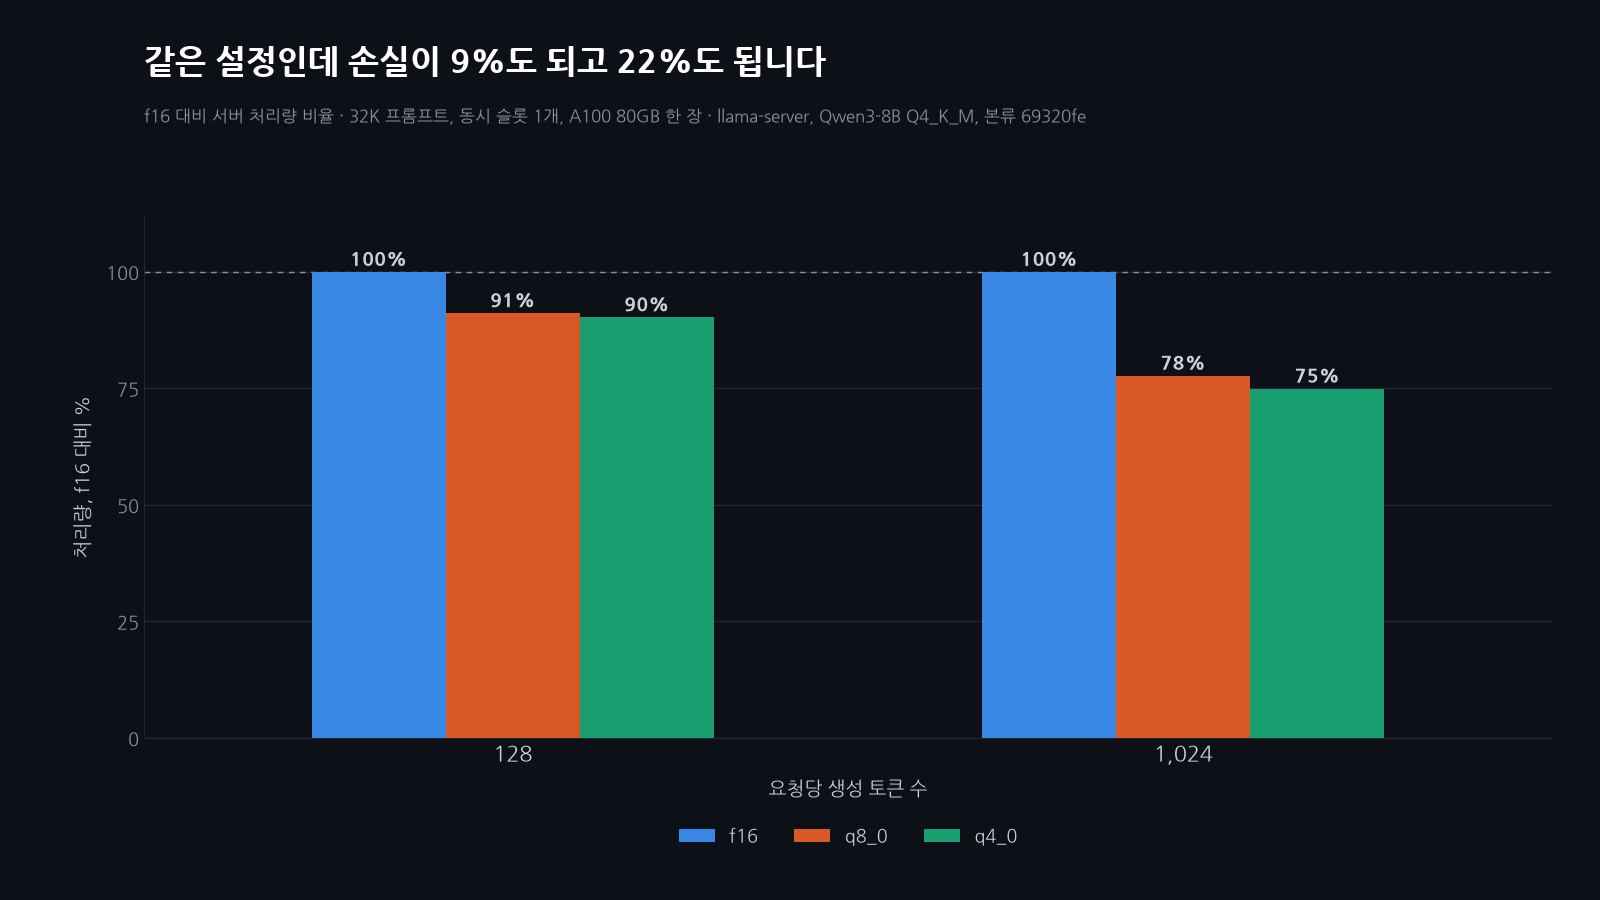
같은 32K 입력에서 답변을 128토큰에서 1,024토큰으로 늘리자 처리량 손실이 6~9%에서 22~26%로 커졌습니다. 이 곡선 위에서 제가 가진 것은 점 두 개이지 임계점이 아닙니다. 출력 대 입력이 1대256일 때 9% 안팎이고 1대32일 때 22% 안팎이라는 것까지입니다. 어느 지점에서 감당 한도를 넘는지는 각자의 비율로 재 보셔야 합니다.
스트림당 수치는 두 경우에서 다르게 움직입니다. 출력 128토큰에 슬롯 4개나 16개면 84~88%로 읽히는데, 같은 설정을 슬롯 1개로 돌리면 62~66%입니다. 출력 1,024토큰에서는 슬롯 1개와 4개 모두 62~66%입니다. 짧은 출력 실행은 슬롯마다 프리필이 어긋나 있는 동안 1~2초만 생성하므로, 재는 구간 자체가 짧고 다른 슬롯의 프리필과 겹칩니다. 반복 실행이나 스케줄러 추적을 하지 않았으므로 차이를 기술할 수는 있어도 원인을 지목할 수는 없습니다.
차이가 큰 쪽은 메모리입니다
서버가 정상 응답을 시작한 직후, 부하를 걸기 전에 카드에서 읽은 VRAM 사용량입니다. 가중치 4.68 GiB를 포함합니다. 부하가 도는 동안 0.5초 간격으로 표본을 떠도 이 값들이 14 MiB 넘게 움직이지 않았습니다. llama.cpp가 캐시를 시작할 때 전부 할당하므로 예상되는 결과입니다.
- 슬롯당 4,096에 슬롯 32개: f16 23.0 GiB, q8_0 15.0, q4_0 10.5
- 슬롯당 16,384에 슬롯 16개: f16 41.0 GiB, q8_0 25.1, q4_0 16.1
- 슬롯당 65,536에 슬롯 4개: f16 41.0 GiB, q8_0 25.1, q4_0 16.1
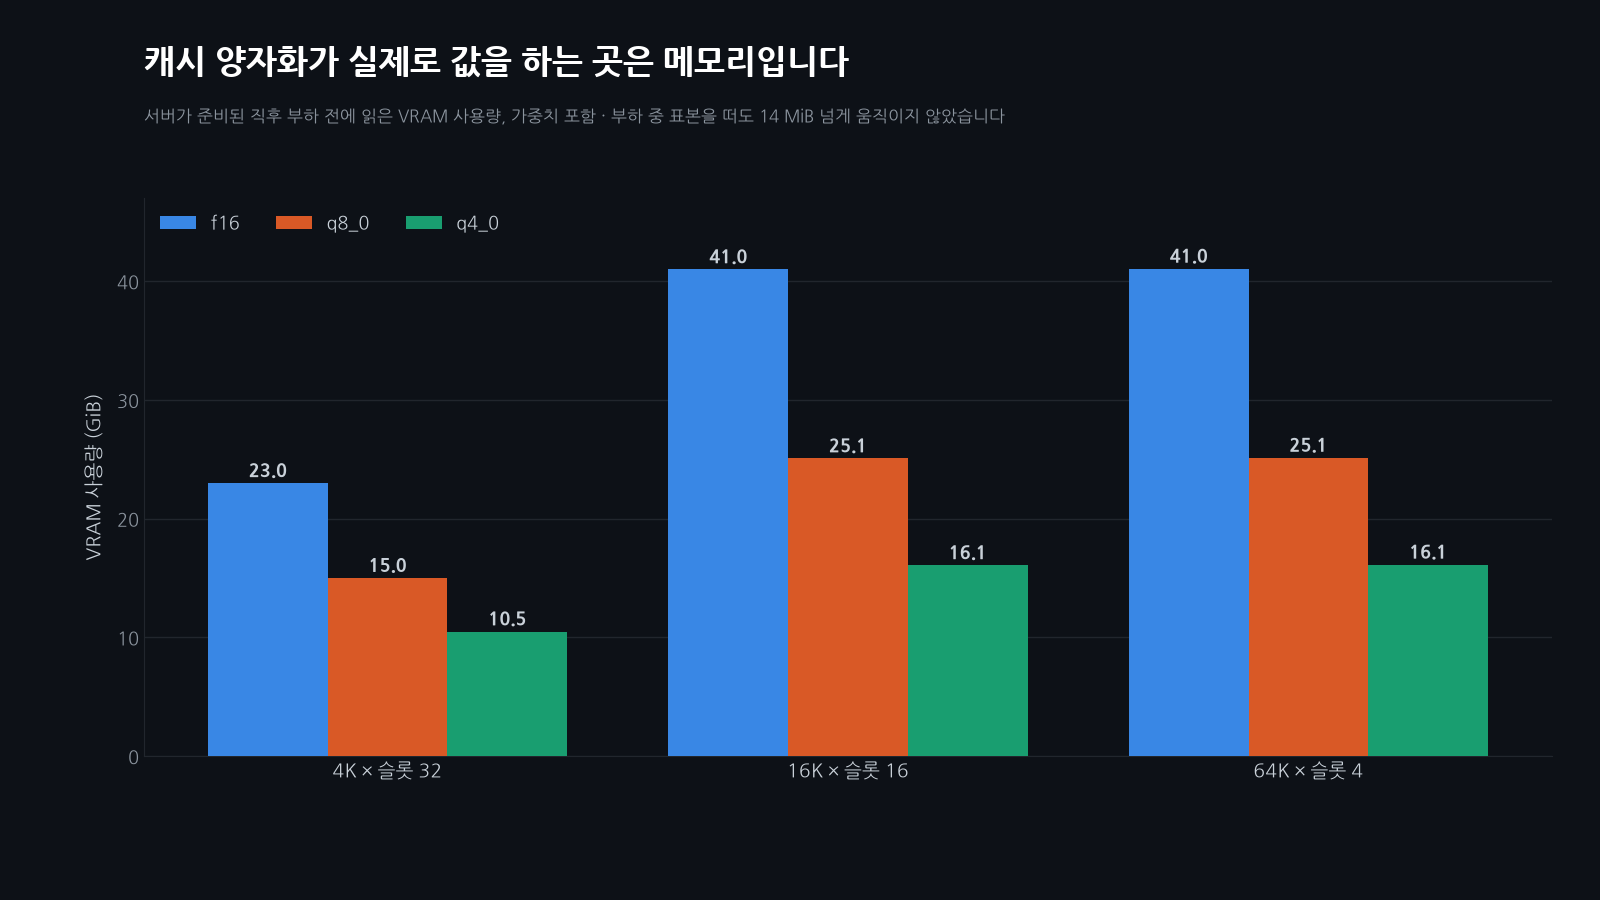
절감은 슬롯 수 곱하기 컨텍스트, 그러니까 총 캐시 크기에 비례합니다. 64K 슬롯 4개에서 q8_0은 f16보다 15.9 GiB를, q4_0은 24.9 GiB를 덜 잡습니다. A100 80GB로 8B 모델을 서빙하는 한 위 세 줄 중 어느 것도 한도 근처가 아닙니다. f16으로 슬롯 32개를 띄워도 23.0 GiB입니다. 이 장비에서는 메모리가 제약이 아니라는 뜻입니다. 41 GiB가 들어가지 않는 카드라면 같은 세 줄은 속도 문제가 아니라 수용량 문제가 됩니다. 다만 저는 이 카드에서만 쟀습니다.
2026년 10월 4일 업데이트: 위의 q5_1과 혼합 조합 이야기는 b10753 (69320fe) 기준이고, 현재 빌드에서는 프리필이 제 속도로 돕니다. 이 글의 서버 수치는 f16, q8_0, q4_0만 썼고, 32K에서 q8_0 한 요청 디코드는 10월 4일 빌드에서 초당 66.6토큰으로, 이 커밋의 llama-bench 글(68.0)보다 2% 정도 낮았습니다. 가이드를 참고하세요.
무엇을 켤 것인가
f16 캐시가 여유 있게 들어가면 f16을 그대로 두십시오. 부족하지도 않은 메모리를 얻자고 출력 길이에 따라 처리량 6~26%를 내는 셈입니다.
들어가지 않으면 -ctk q8_0 -ctv q8_0부터 시도하십시오. 앞 글에서 측정한 모든 컨텍스트 길이에서 퍼플렉시티가 f16 오차 범위 안에 있었고, 여기서 처리량도 어느 설정에서나 q4_0과 1퍼센트포인트 안에서 같습니다. q4_0은 64K 슬롯 4개에서 9.0 GiB를 더 덜어내고 앞 글에서 퍼플렉시티를 0.5~1.1% 냈습니다. 그 9 GiB가 설정이 올라가느냐 마느냐를 가를 때만 고를 이유가 있습니다.
요청이 긴 답변을 생성한다면 자기 워크로드의 출력 대 입력 비율을 먼저 재 보십시오. 9%라는 값은 32K 프롬프트에 128토큰 답변의 것입니다.
이 측정이 보여주지 못하는 것
카드 한 장, 모델 하나, 가중치 양자화 하나입니다. Qwen3-8B는 KV 헤드 8개의 4대1 GQA를 쓰는데, KV 헤드가 많은 모델은 토큰당 캐시가 크니 페널티도 함께 커질 법합니다. 다만 재 보지 않았습니다. 프롬프트는 슬롯마다 똑같은 합성 텍스트라 실제 트래픽과 다르고, cache_prompt false로 접두사 재사용도 껐는데 진짜 서버라면 그 이득을 받습니다. 모든 실행이 -np개 요청을 한 번에 몰아넣는 방식이라 대기열 동작이 없고 인용할 만한 p99도 없습니다. 각 설정은 워밍업을 버린 뒤 한 번씩만 돌렸으므로 인접한 행 사이의 작은 차이는 구분할 수 없습니다.
그리고 이것은 sm80에서의 커밋 69320fe 이야기입니다. 양자화 KV 디코드 경로는 두 글 전에 잰 포크와 이 커밋 사이에 두 배쯤 빨라졌습니다. 이 비율도 또 움직일 겁니다.
위에서 인용한 하네스와 원시 결과 전부를 회원 무료 다운로드로 묶어 두었습니다: KV 캐시 벤치마크 하네스. 벤치 스크립트 두 개, 부하 클라이언트, 파서, 33개 설정의 요청별 JSON, 그리고 제 시간을 잡아먹은 네 가지를 적은 메모가 들어 있습니다.
새 실측은 Paper of the Week와 함께 매주 나갑니다. 다음 편을 받고 싶으시면 아래에서 구독해 주십시오.
환경: A100 80GB PCIe 1장(두 번째 카드는 유휴), 드라이버 535. llama.cpp 69320fe(ggml-org master, 2026-09-02), sm80 CUDA 빌드. Qwen3-8B Q4_K_M, llama-server -fa 1 -ngl 99 --no-context-shift. 하네스는 scripts/bench-llamacpp-server.sh와 scripts/bench-server-client.py, 요청별 원시 JSON과 서버 timings, VRAM 표본은 drafts/llamacpp-server-kv-bench/에 있습니다. 2026-09-17 검증.
같은 측정을 당신 모델로 받아 보시겠습니까
모델과 조건을 알려 주시면 측정 조건표 초안과 견적을 1영업일 안에 무료로 보내 드립니다. 값은 후보 수와 과제 수에 따라 정합니다. 기본 장비는 A100 80GB이고 다른 GPU도 가능합니다.