llama.cpp KV 캐시 양자화, A100 한 장에서 실측 — q8_0은 4K에서 공짜이고 64K에서는 디코드 속도 절반을 냅니다
본류 llama.cpp, Qwen3-8B, A100 한 장. -ctk q8_0 -ctv q8_0은 퍼플렉시티가 f16과 같고 32K 캐시를 2.11 GiB 줄이지만, 64K 깊이 디코드는 f16의 55%로 떨어집니다(q4_0은 50%). q5_1과 K q8_0/V q4_0 혼합은 프리필이 초당 43·63토큰으로 조용히 CPU에서 돌았습니다.
llama.cpp KV 캐시 양자화, A100 한 장에서 실측 — q8_0은 4K에서 공짜이고 64K에서는 디코드 속도 절반을 냅니다
Search Console을 보니 TurboQuant 실전에 들어오는 분들 대부분은 TurboQuant를 찾는 게 아니었습니다. 검색어가 llama.cpp kv cache quantization, llama.cpp ctk ctv, cache-type-k입니다. 지금 본류 llama.cpp에 들어 있는 기능, 그러니까 -fa on 뒤에 붙이는 -ctk q8_0 -ctv q8_0이나 q4_0을 찾는 분들입니다. 그 글은 업스트림이 끝내 머지하지 않은 포크 이야기라서, 맞는 질문에 엉뚱한 답을 하고 있었습니다.
이 글이 그 질문의 답입니다. 같은 카드, 같은 모델, 포크 글에서 돌린 것과 같은 네 가지 측정이라 두 결과가 마지막에 한 표에 들어갑니다.
무엇으로 쟀는지
A100 80GB PCIe 한 장, 드라이버 535. llama.cpp 본류(ggml-org master 69320fe, 2026년 9월 2일)를 sm80용으로 -DGGML_CUDA=ON 빌드했습니다. 모델은 Qwen3-8B Q4_K_M(가중치 4.68 GiB)입니다. 모든 실행에 -fa 1 -ngl 99를 붙였습니다. llama.cpp에서 양자화된 V 캐시는 플래시 어텐션이 있어야 돌아가므로 플래시 어텐션 없는 비교는 애초에 성립하지 않습니다. llama-bench 값은 2회 평균이고, 퍼플렉시티는 wikitext-2를 4K 컨텍스트에서 40청크, 8K·16K·32K에서 3청크씩 쟀습니다.
KV 타입은 다섯 가지입니다. 기본값 f16, q8_0, q4_0, q5_1, 그리고 포럼에서 자주 권하는 K q8_0/V q4_0 혼합입니다. 이 중 둘은 하드웨어에 올리자마자 탈락했고, 그게 첫 번째 결과입니다.
다섯 설정 중 둘은 프리필을 CPU에서 돌립니다
| KV | 프리필 8K | 프리필 32K | 생성 128 |
|---|---|---|---|
| f16 | 4,539 tok/s | 3,362 | 151.2 |
| q8_0 | 4,411 (−3%) | 3,228 (−4%) | 142.0 (−6%) |
| q4_0 | 4,422 (−3%) | 3,229 (−4%) | 142.1 (−6%) |
| q5_1 | 43 | 10.9 | 91.6 |
| K q8_0 / V q4_0 | 62.7 | 측정 중단 | 측정 중단 |
q8_0과 q4_0은 프리필에서 3~4%, 생성에서 6%를 냅니다. q5_1은 8K 토큰 프리필이 초당 43토큰으로 f16의 100분의 1이고, 혼합은 63입니다. 다른 타입은 1분이면 끝나는 측정을 q5_1 하나가 2시간 41분 끌었습니다. 혼합은 첫 행만 받고 중단했습니다.
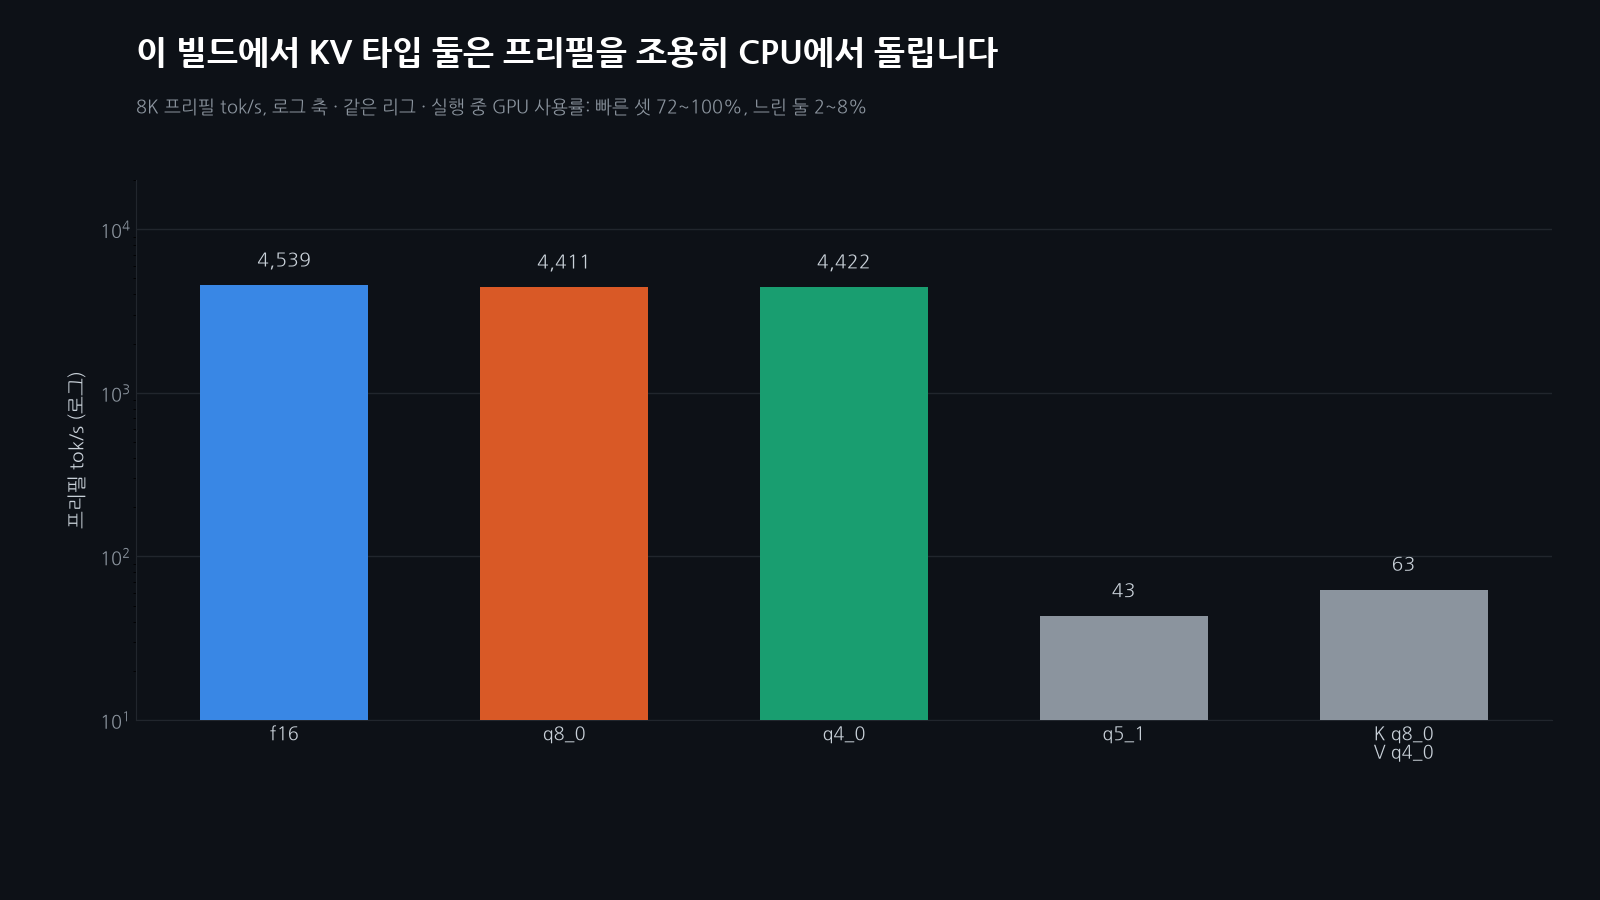
무슨 일인지 보려고 비어 있던 두 번째 A100에서 2K 프리필을 짧게 다시 돌리면서 GPU 사용률을 1초마다 찍었습니다. q4_0은 72~100%였습니다. q5_1은 2~4%, 혼합은 4~25%였습니다. GPU가 놀고 있었고, 어텐션 연산이 CPU에서 돌고 있었던 겁니다. 이럴 때 llama-bench는 경고를 한 줄도 찍지 않습니다. 생성은 여전히 GPU에서 돌기 때문에(q5_1 생성 91.6 tok/s) 대화형으로 쓰면 그냥 좀 굼뜬 정도로 느껴지고, 긴 프롬프트를 넣어 몇 분이 걸릴 때에야 알아차리게 됩니다.
정정(2026-09-21): 이 글은 K q8_0/V q4_0 혼합을 특정한 나쁜 조합처럼 다뤘습니다. 이후 타입 여덟 가지를 전부 재 보니 원인은 조합이 아니라 K와 V가 다르다는 것 자체였습니다. 기본 CUDA 빌드는 두 타입이 다르면 FlashAttention 커널을 아예 고르지 않습니다. f16과 q8_0처럼 각각은 빠른 조합도 마찬가지입니다. 자세한 내용은 llama.cpp의 -ctk·-ctv, 기본 CUDA 빌드에서 쓸 수 있는 값은 넷입니다에 있습니다.
이유를 ggml-cuda/fattn.cu에서 찾아봤습니다. 프리필에 쓰이는 배치 플래시 어텐션 커널은 f16 K/V로 동작하면서 캐시를 들어오는 길에 역양자화하고, 토큰 하나짜리 벡터 커널은 양자화 타입마다 전용 경로가 있습니다. 그런데 q8_0/q8_0과 q4_0/q4_0은 빠른 배치 경로를 타고 q5_1/q5_1과 q8_0/q4_0은 떨어지는 이유가 정확히 어디서 갈리는지는 제가 쓴 시간 안에서 특정하지 못했고, 추측으로 채우지는 않겠습니다. 측정 결과만으로 결론은 충분합니다. 이 빌드와 이 카드에서 저 두 설정은 프롬프트가 조금이라도 긴 작업에는 쓸 수 없습니다.
아래는 전부 살아남은 세 설정 이야기입니다.
메모리: 줄어든 만큼이 정확히 명목 비트 수입니다
32K 컨텍스트에서 퍼플렉시티 한 청크를 돌리는 동안 nvidia-smi로 찍은 최대 VRAM입니다.
| KV | 최대 VRAM | f16 대비 |
|---|---|---|
| f16 | 9.63 GiB | — |
| q8_0 | 7.52 GiB | −2.11 GiB |
| q4_0 | 6.39 GiB | −3.23 GiB |
최대치에는 가중치 4.68 GiB와 연산 버퍼가 들어 있으니 차이가 곧 캐시입니다. 32,768토큰의 f16 캐시는 레이어 36 × KV 헤드 8 × 128 × (K+V) × 2바이트 × 32,768 = 4.50 GiB로 계산됩니다. q8_0은 값 하나에 8.5비트를 쓰니 2.39 GiB, 절약 2.11 GiB가 나와야 하고, q4_0은 4.5비트라 1.27 GiB, 절약 3.23 GiB가 나와야 합니다. 측정한 차이가 둘 다 소수점 둘째 자리까지 맞습니다. 포크 글에서 같은 타입으로 나온 숫자와도 같은데, 캐시 배치는 커널이 아니라 타입이 정하니 당연한 결과입니다.
이 공식의 일반형과 다른 모델의 값, 검산 스크립트는 KV Cache 완전 정복에 있습니다.
품질: q8_0은 손실이 없고 q4_0은 1% 안팎을 냅니다
| KV | ctx 4K | ctx 8K | ctx 16K | ctx 32K |
|---|---|---|---|---|
| f16 | 8.319 ± 0.084 | 7.901 ± 0.201 | 7.596 ± 0.134 | 9.089 ± 0.118 |
| q8_0 | 8.318 (−0.0%) | 7.905 (+0.0%) | 7.600 (+0.0%) | 9.096 (+0.1%) |
| q4_0 | 8.374 (+0.7%) | 7.958 (+0.7%) | 7.683 (+1.1%) | 9.133 (+0.5%) |
q8_0은 모든 컨텍스트 길이에서 오차 범위 안입니다. q4_0은 f16보다 0.5~1.1% 위에 있고 컨텍스트가 길어져도 벌어지지 않습니다. 포크의 turbo3(4K에서는 멀쩡하다가 16K에서 +210%)과 갈리는 지점이 바로 이 성질입니다. 8K 이상은 3청크라 표본이 얇습니다. 저 표에서는 ± 열을 같이 읽어야 합니다.
깊이에서의 속도: 실제로 달라지는 숫자는 이것입니다
프리필과 빈 캐시 생성은 거의 안 변합니다. 변하는 건 캐시가 이미 차 있을 때의 디코드입니다. 그때는 매 스텝마다 캐시 전체를 읽기 때문입니다.
| KV | 디코드 @8K | @32K | @64K | @64K f16 대비 |
|---|---|---|---|---|
| f16 | 134.4 tok/s | 105.0 | 81.6 | 100% |
| q8_0 | 110.2 | 68.0 | 44.7 | 55% |
| q4_0 | 107.2 | 63.6 | 41.2 | 50% |
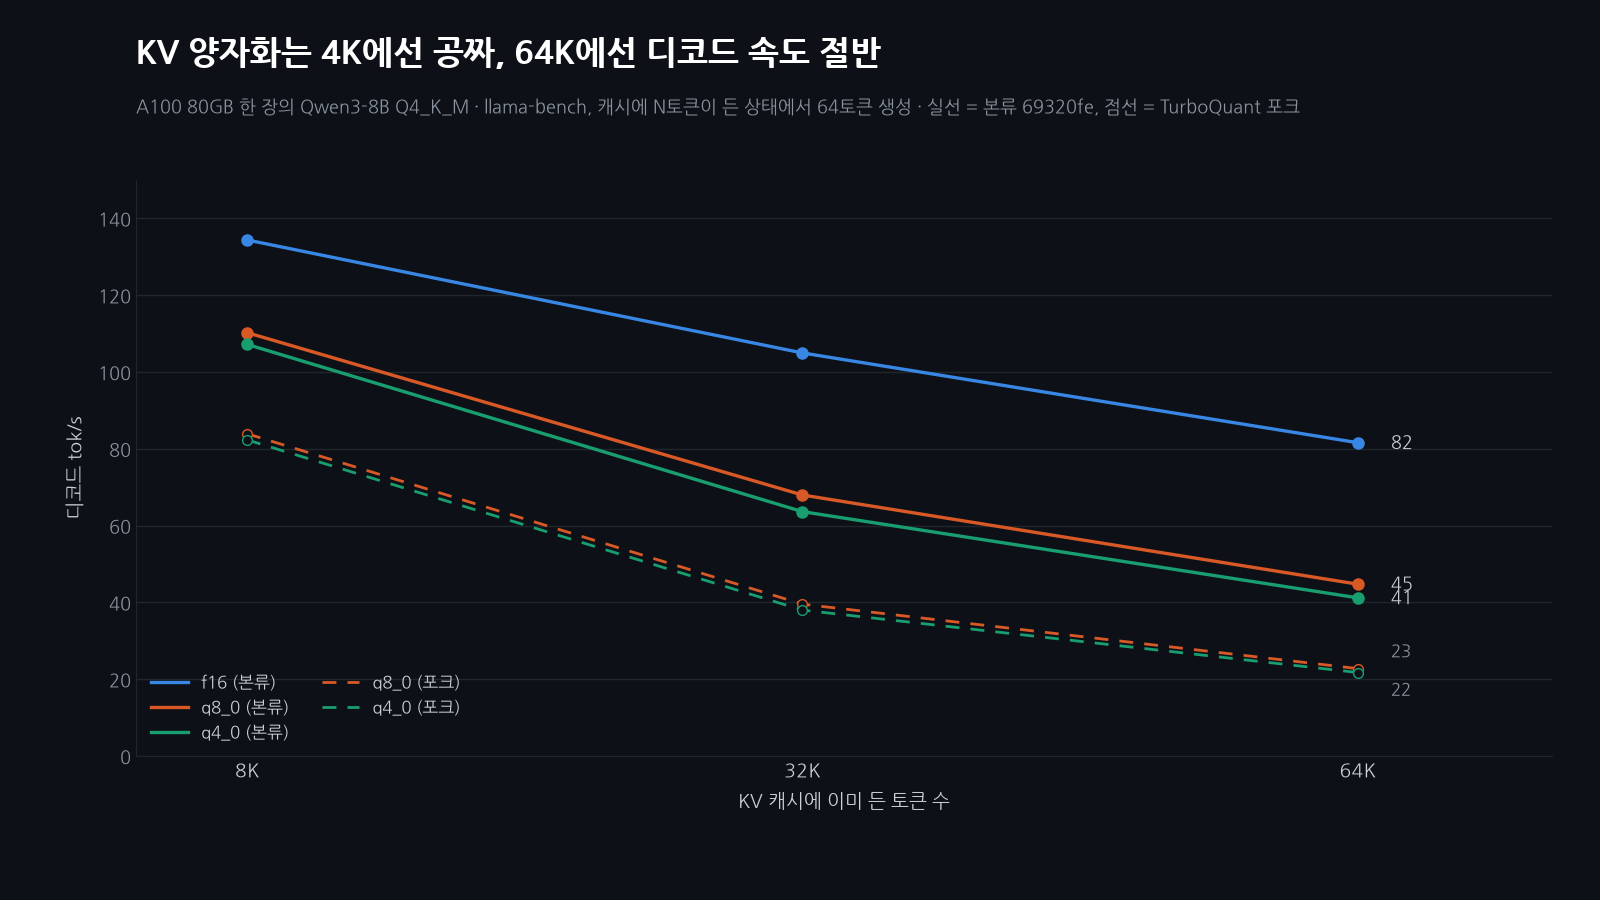
캐시에 8K가 들어 있을 때 양자화 KV의 비용은 20% 정도입니다. 64K가 들어 있으면 절반입니다. 양자화된 캐시를 읽는다는 것은 디코드 스텝마다 역양자화를 한다는 뜻이고, 그 일은 컨텍스트에 비례해 늘어나는 반면 f16 경로는 바이트를 그냥 흘려보냅니다. 긴 컨텍스트를 메모리에 들어가게 해 준 그 절약을, 바로 그 긴 컨텍스트에서 시간으로 다시 내는 구조입니다.
포크 글에서는 같은 두 타입이 64K에서 f16의 27~29%였습니다. 본류는 50~55%입니다. 포크의 base 커밋과 이 커밋 사이에 양자화 KV 디코드 경로가 대략 두 배 빨라진 셈인데, 그래도 여전히 절반입니다.
2026년 10월 4일 업데이트: 프리필이 CPU로 넘어간 두 행(q5_1, q8_0 / q4_0 혼합)은 b10753 (69320fe)에서의 사실입니다. 10월 4일 빌드에서는 둘 다 프리필이 제 속도로 돌지만, 깊은 문맥 디코드는 여전히 q4_0보다 느립니다. q8_0과 q4_0 행은 새 빌드에서도 같았습니다(64K에서 f16의 56%, 53%). 가이드를 참고하세요.
그래서 무엇을 켤 것인가
| 상황 | 설정 | 이유 |
|---|---|---|
| f16으로도 캐시가 VRAM에 들어감 | f16 그대로 | 양자화해서 얻는 건 없고 생성 6%만 냄 |
| 32K에서 2 GiB쯤 돌려받아야 하고 프롬프트·답이 대체로 짧음 | -ctk q8_0 -ctv q8_0 -fa on | 손실 없음. 깊이 비용은 캐시에 16K쯤 쌓여야 체감됨 |
| 3 GiB를 돌려받아야 하고 문서가 길며 품질이 중요함 | 그래도 -ctk q8_0 -ctv q8_0 | q4_0은 1 GiB 더 아끼는 대가로 PPL +1%, 디코드 비용은 같음 |
| 긴 컨텍스트 디코드 처리량이 중요함 | f16, 아니면 더 작은 모델 | 64K에서는 어떤 양자화 캐시든 절반 속도 |
q5_1, 또는 K/V 타입 섞기 | 이 빌드에서는 금지 | 프리필이 CPU로 감 |
q8_0과 q4_0 사이의 선택은 결국 메모리만의 문제로 드러났습니다. 어느 깊이에서든 디코드 속도가 같으니, q4_0이 값을 하는 경우는 1.1 GiB 차이가 들어가고 못 들어가고를 가를 때뿐입니다.
이 양자화기들을 플래그로 켜는 데서 그치지 않고 GPTQ, AWQ, GGUF, KV 캐시 포맷까지 직접 만들어 보고 싶다면 LLM Quantization and Compression Hands-On 강의에 24강 분량으로 정리해뒀습니다. 3강까지는 무료입니다.
확인하지 못한 범위
모델 하나, 가중치 양자화 하나입니다. Qwen3-8B은 KV 헤드 8개의 4:1 GQA라서, KV 헤드가 더 많은 모델은 캐시도 크고 깊이 비용도 아마 더 클 겁니다. 배치 크기는 내내 1입니다. llama-bench의 디코드는 스트림 하나이고, 배치 서빙은 대역폭 그림이 달라집니다. 8K 이상 퍼플렉시티는 3청크입니다. 그리고 CPU 폴백은 sm80에서 69320fe 커밋에 대한 사실이라, 이후 커밋이나 Hopper 카드는 다르게 동작할 수 있고 둘 다 확인하지 않았습니다.
가중치 양자화 자체는 뒤에 쓴 글에서 따로 쟀습니다. 출력이 확률인 결정 모델 decider-4b를 llama.cpp에서 BF16부터 Q2_K까지 줄여 가며 GPU 메모리, 로그 손실, 답이 바뀐 수를 단계마다 비교했습니다. 결정 모델은 얼마나 줄여도 될까
포크 비교는 TurboQuant llama.cpp 실측에 있고, 어떤 KV 기법이 어떤 단위로 값을 치르는지는 KV 시리즈 1편에 있습니다. 이 글은 그 표의 양자화 행이 됩니다.
새 측정은 Paper of the Week로 매주 나갑니다. 다음 편을 받으시려면 아래에서 구독하세요.
이 네 가지 측정을 직접 돌려보고 싶으시면, 이 글의 하네스와 원시 JSON을 회원 무료 다운로드로 묶어 두었습니다: KV 캐시 벤치마크 하네스.
리그: A100 80GB PCIe × 1, 드라이버 535. 두 번째 A100은 사용률 프로브에만 썼습니다. llama.cpp 69320fe(ggml-org master, 2026-09-02), sm80 CUDA 빌드. Qwen3-8B Q4_K_M, -fa 1 -ngl 99. 하네스 scripts/bench-llamacpp-main.sh, 원시 JSON과 로그는 drafts/llamacpp-kv-bench/, 표는 scripts/parse-llamacpp-kv-bench.py로 뽑았습니다. 2026-09-15 확인.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
llamacpp-kv-cache-quantization-bench-repro.zip · 34 KB
같은 측정을 당신 모델로 받아 보시겠습니까
모델과 조건을 알려 주시면 측정 조건표 초안과 견적을 1영업일 안에 무료로 보내 드립니다. 값은 후보 수와 과제 수에 따라 정합니다. 기본 장비는 A100 80GB이고 다른 GPU도 가능합니다.