맥락은 네 배인데 캐시는 더 적게: 모델 여섯 개가 KV 캐시를 담는 네 가지 방식, llama.cpp와 vLLM 실측
llama.cpp에서 Qwen3.5-9B는 128K 맥락에 KV 캐시 4,146 MiB를 잡았고, Qwen3-8B는 32K에 4,608 MiB를 잡았습니다. 캐시 구조가 네 종류(full attention, sliding window, MLA, 선형 어텐션 혼합)인 모델 여섯 개의 캐시 크기를 config.json으로 계산하고 llama.cpp와 vLLM에서 쟀습니다. 모델마다 무엇을 기준으로 메모리를 계획해야 하는지도 정리했습니다.
맥락은 네 배인데 캐시는 더 적게
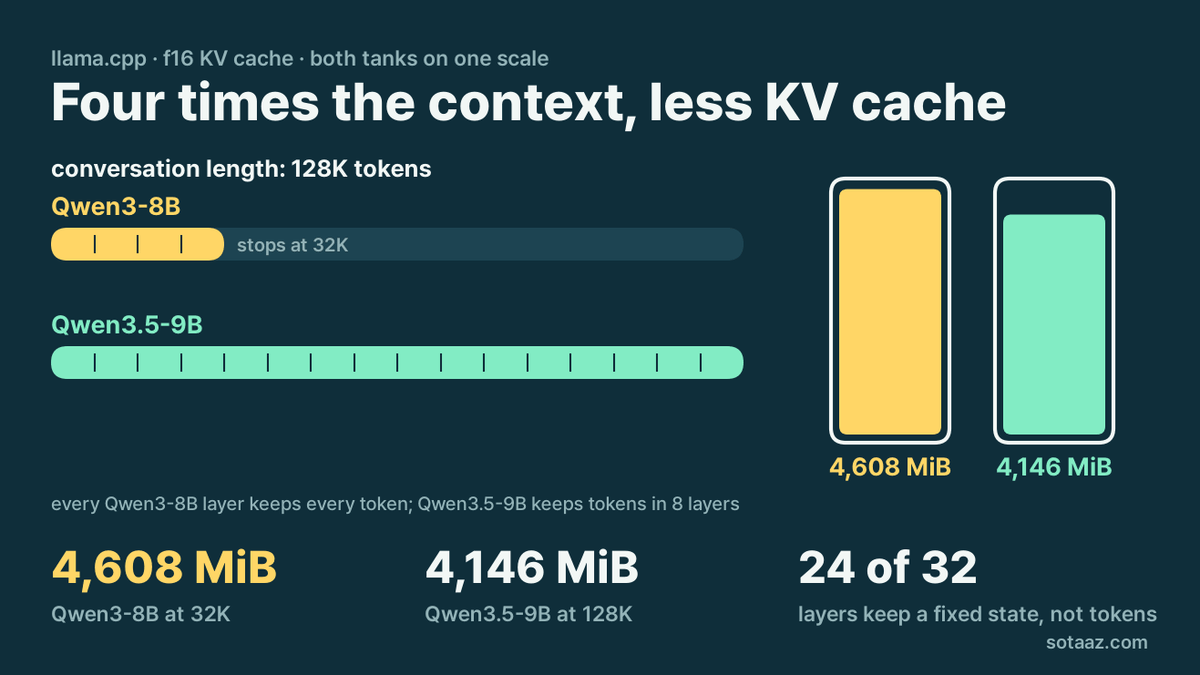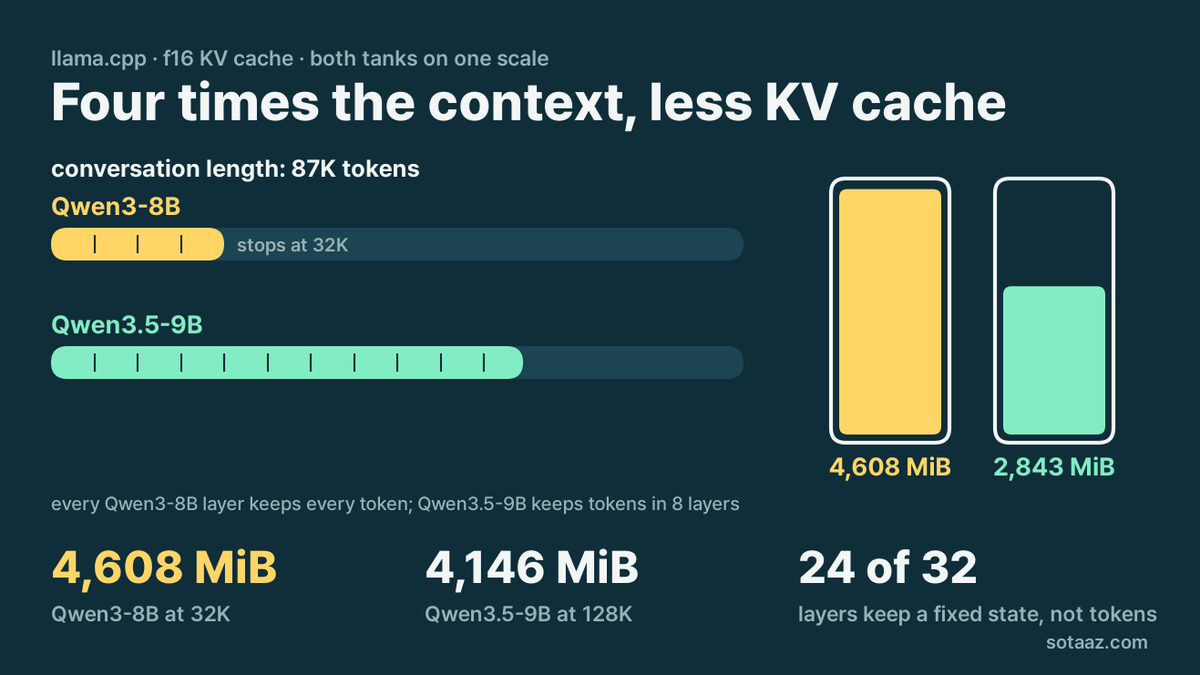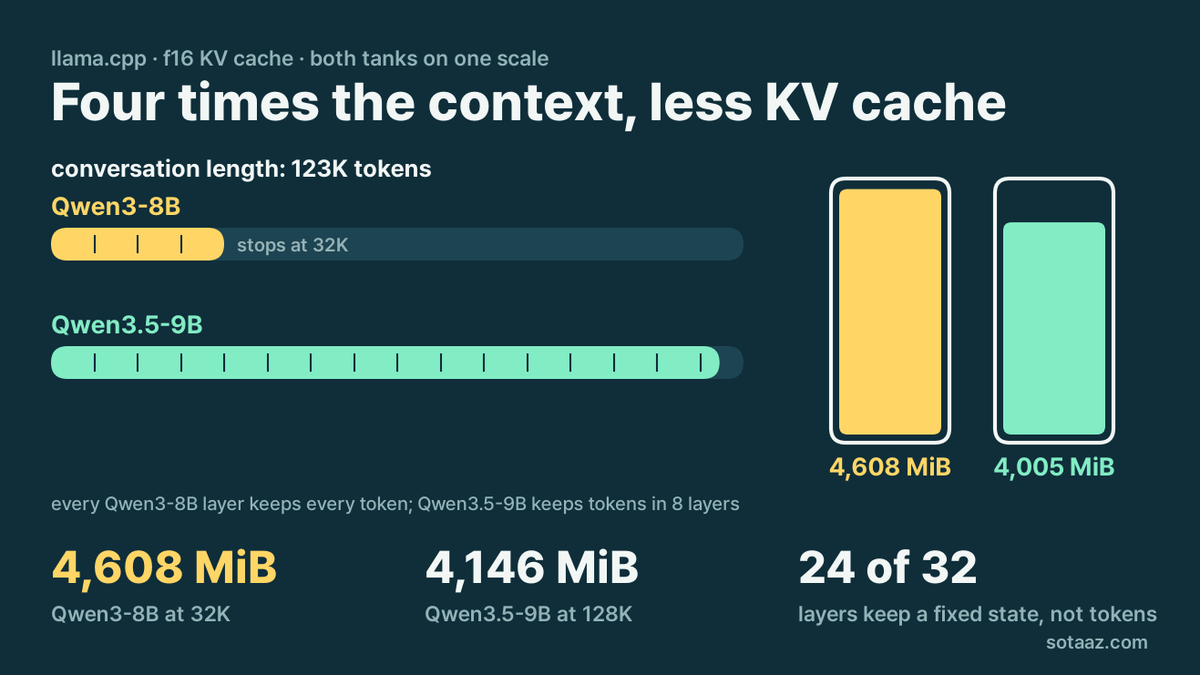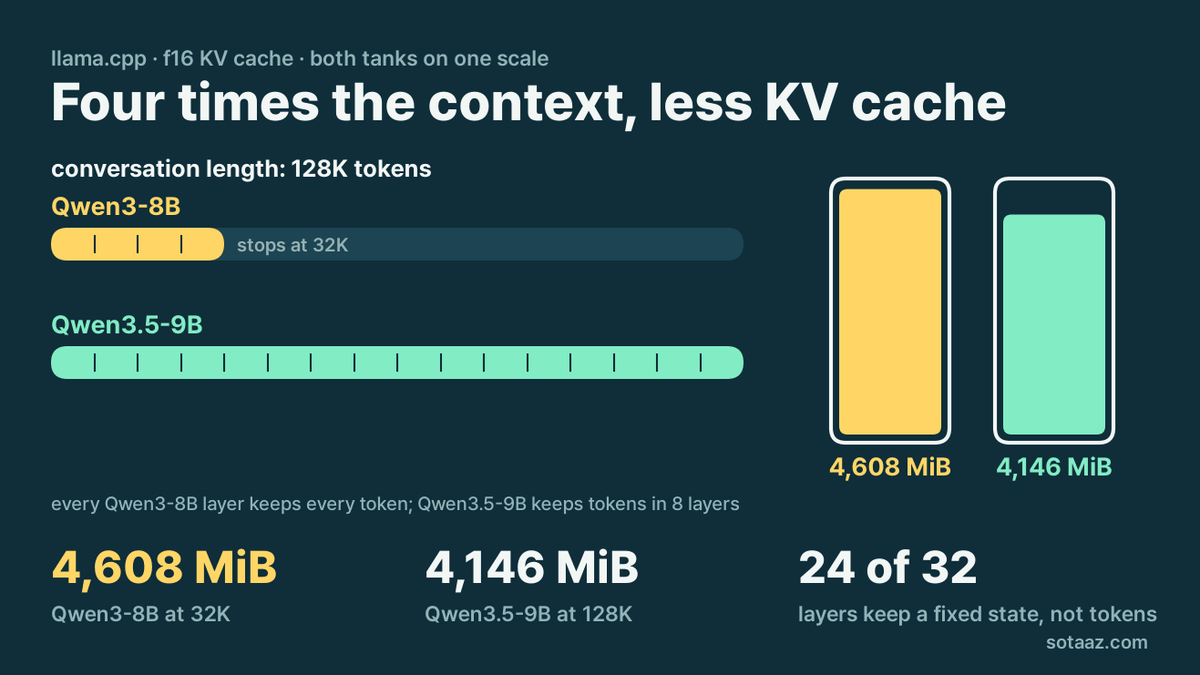
llama.cpp에서 Qwen3.5-9B를 128K 맥락으로 띄우자 KV 캐시로 4,146 MiB가 잡혔습니다. 같은 연구소의 한 세대 앞 모델이고 크기도 더 작은 Qwen3-8B는 32K 맥락에 4,608 MiB를 잡았습니다. 맥락은 네 배 길고 모델도 더 큰데, 캐시는 오히려 적게 들었습니다.
파라미터 수로는 이 차이가 설명되지 않습니다. 층 종류가 다르기 때문입니다. Qwen3-8B는 36개 층 모두가 지나온 토큰을 하나도 빼지 않고 남깁니다. Qwen3.5-9B는 32개 층 가운데 8개만 토큰을 남기고, 나머지 24개 층은 토큰 대신 크기가 정해진 작은 상태를 들고 있습니다. 두 숫자 모두 각 모델의 config.json으로 계산한 값과 정확히 같았습니다. 이 글은 KV 캐시를 네 가지 방식으로 담는 모델 여섯 개를 다룹니다. 방식마다 대화가 길어질 때 메모리가 어떻게 늘어나는지, 메모리를 계획할 때 무엇을 기준으로 삼아야 하는지 정리합니다. 글에 나오는 메모리 숫자는 config.json으로 계산한 값이거나 llama.cpp와 vLLM에서 잰 값이고, 어느 쪽인지 매번 밝힙니다.
어텐션 방식 자체(MQA, GQA, MLA, sparse, 선형 어텐션)를 모델 이름과 함께 먼저 보고 싶다면 LLM이 어텐션을 다루는 일곱 가지 방식을 먼저 읽으셔도 됩니다. 두 런타임이 늘 같은 값을 낸 것은 아닙니다. vLLM이 llama.cpp보다 많이 잡은 곳은 이 글에 숫자만 적고, 이유와 바꿀 설정은 다음 글에서 다룹니다.
층 종류가 다르면 캐시도 다릅니다
모델은 토큰을 하나 읽을 때마다 어텐션 층마다 그 토큰의 key와 value를 남겨 둡니다. 뒤에 오는 토큰이 앞을 돌아볼 때 쓰기 위해서입니다. 무엇을 남기는지는 층 종류가 정합니다.
- Full attention: 모든 토큰의 key와 value를 KV 헤드마다 남깁니다. 층 하나에서 토큰 하나가 2(K와 V) × KV 헤드 수 × 헤드 크기 × 2바이트를 씁니다. 대화가 길어지는 만큼 끝없이 늘어납니다.
- Sliding window: 최근 W개 토큰만 보므로 W개만 남기면 됩니다. 이 층이 차지하는 몫은 W에서 멈춰야 합니다.
- MLA(multi-head latent attention): DeepSeek이 쓰는 방식입니다. 토큰마다 압축한 벡터 하나만 저장하고, 필요할 때 거기서 헤드별 key와 value를 다시 만듭니다.
- 선형 어텐션: Qwen3.5의 Gated DeltaNet 층이 여기에 속합니다. 토큰을 전혀 남기지 않고, 크기가 정해진 상태를 토큰이 들어올 때마다 고쳐 씁니다.
요즘 모델은 대부분 이 가운데 몇 가지를 섞어 씁니다. config.json만 있으면 토큰 하나가 늘 때 드는 메모리와 대화마다 고정으로 드는 메모리를 계산할 수 있습니다.
| 모델 | 층 구성 | 토큰당 증가분 (f16) | 대화당 고정분 |
|---|---|---|---|
| Qwen3-8B | full 36층, KV 헤드 8 × 128 | 144 KiB | 없음 |
| Mistral-7B-v0.3 | full 32층, KV 헤드 8 × 128 | 128 KiB | 없음 |
| Gemma 3 4B | full 5층 + sliding 29층(창 1,024), 4 × 256 | 20 KiB | sliding 층 116 MiB |
| gpt-oss-20b | full 12층 + sliding 12층(창 128) 번갈아, 8 × 64 | 24 KiB | sliding 층 3 MiB |
| DeepSeek-V2-Lite | MLA 27층, 잠재 벡터 512 + RoPE 64 | 30.4 KiB | 없음 |
| Qwen3.5-9B | full 8층(4 × 256) + 선형 24층 | 32 KiB | f32 상태 50.25 MiB (bf16이었다면 25 MiB) |
표에 대해 두 가지를 덧붙입니다. Gemma 3 4B의 헤드 수와 층 배분은 앞서 말한 대로 transformers 기본값입니다. Qwen3.5의 상태에는 재귀 행렬과 짧은 합성곱 버퍼가 함께 들어 있습니다. llama.cpp는 이 상태를 f32로 들고 있고, 잰 값도 정확히 50.25 MiB였습니다.
여섯 모델은 크기가 같지 않습니다. 전체 파라미터가 4B부터 20B까지이고, 두 개는 MoE(mixture of experts)입니다. 그러니 이 비교는 어느 모델이 더 나은지가 아니라 맥락을 어떻게 담는지에 대한 것입니다. 메모리를 아끼는 방식마다 대가도 있습니다. sliding 층은 창 밖을 직접 보지 못하고, MLA는 헤드를 다시 만드는 데 계산을 씁니다. 이 대가는 저희가 재지 않았습니다.
측정 방법. llama.cpp는 빌드 4da6337에서 llama-server -ngl 99 -fa on --parallel 1 -c <길이>로 띄우고, 시작할 때 찍는 KV 캐시 크기를 읽었습니다. vLLM은 0.29.1rc1에서 max_model_len을 길이마다 바꾸고 A100 80GB의 85%를 쓰게 한 뒤, 로그에 찍히는 캐시 메모리와 토큰 용량을 읽었습니다. 길이는 4K, 32K, 128K이고 캐시는 f16/bf16입니다.
vLLM 실행은 대부분 엔진 준비 완료까지 가지 못했습니다. 29번 가운데 24번은 캐시 크기를 찍은 다음 샘플링 예열 단계(Ninja JIT 빌드)에서 실패했고, 2번은 128K가 모델 한도를 넘어 거절됐습니다(Qwen3-8B, Mistral). KV 캐시는 그 예열보다 먼저 할당되므로 찍힌 숫자를 그대로 썼습니다. 준비 완료까지 간 것은 DeepSeek 3번뿐입니다. vLLM에서는 글자를 하나도 생성하지 않았으니, 이 글은 vLLM 속도에 대해 아무것도 말하지 않습니다. 저희는 실행 전에 모델, 계산식, 예측 여덟 개를 먼저 커밋했고, 채점표는 글 끝에 있습니다.
vLLM 숫자를 읽기 전에 알아 둘 것이 하나 있습니다. vLLM은 토큰 용량을 "최대 길이 요청이 몇 개 들어가는가 × 그 길이"로 계산합니다. 그래서 메모리를 용량으로 나눈 값은 최대 길이 요청 하나에 예약한 메모리를 길이로 나눈 값이 됩니다. 평범한 모델이면 이 값이 토큰당 비용과 같습니다. 고정분이 있는 모델이면 그 고정분이 길이 전체에 나뉘어 얹힙니다.
1. Full attention: config.json이 전부입니다
Qwen3-8B는 36층 × 2 × 헤드 8 × 128 × 2바이트 = 147,456바이트, 토큰당 144 KiB입니다. 32K면 4,608 MiB입니다.
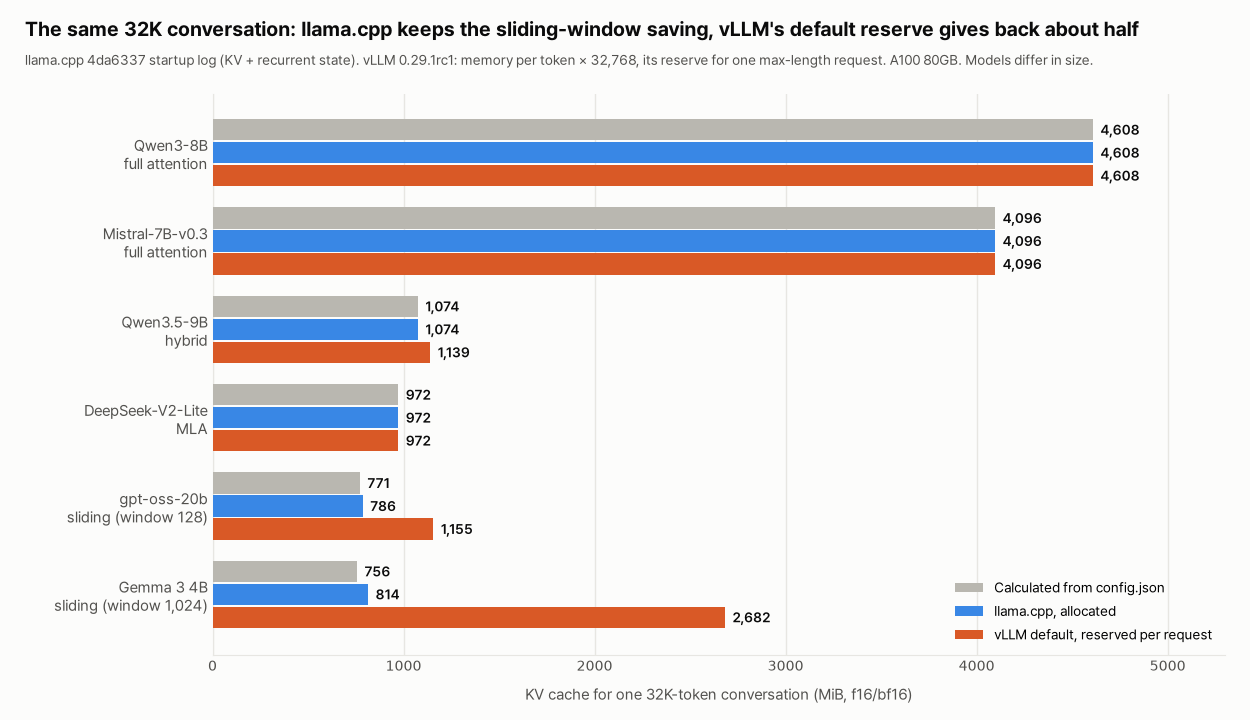
두 런타임 모두 계산과 정확히 맞았습니다. llama.cpp는 4K, 32K, 128K에서 576, 4,608, 18,432 MiB를 잡았고, Mistral-7B-v0.3은 512, 4,096, 16,384 MiB였습니다. vLLM의 토큰당 값은 147,456바이트, 131,072바이트와 0.01% 안쪽으로 같았습니다. 128K는 두 모델의 최대 위치(40,960과 32,768)를 넘습니다. vLLM은 아예 시작하지 않았습니다. llama.cpp는 128K 캐시를 다 잡은 뒤, 대화 하나가 쓸 수 있는 길이를 학습 길이로 제한한다고 로그에 찍었습니다. 늘어난 메모리가 대화 하나에 더 긴 자리를 주지는 못한 셈입니다. 자세한 내용은 다음 글에 있습니다.
계획할 때. 메모리를 바꾸는 설정은 맥락 길이와 캐시 숫자 형식, 두 가지뿐입니다. -c를 절반으로 줄이면 캐시도 절반이 됩니다. 8비트 캐시(llama.cpp에서 -ctk q8_0 -ctv q8_0)를 쓰면 Qwen3-8B 32K가 4,608 MiB에서 2,448 MiB, 53.1%가 됐습니다. 절반보다 조금 큰 것은 값 32개 묶음마다 배율을 따로 저장하기 때문입니다. 8비트 캐시가 답의 품질에 주는 영향은 llama.cpp KV 캐시 양자화 실측에서 쟀습니다. 이런 모델은 config.json만으로 계획을 세워도 됩니다.
2. Sliding window: 절약분은 런타임에 달렸습니다
Gemma 3 4B의 층 하나는 토큰당 2 × 4 × 256 × 2 = 4,096바이트를 씁니다. full 5층은 계속 늘어나서 토큰당 20 KiB입니다. sliding 29층이 1,024토큰에서 멈추면 116 MiB이고, 32K 합계는 756 MiB입니다. sliding 층이 전부 들고 있으면 4,352 MiB가 됩니다. gpt-oss-20b는 같은 계산으로 771 MiB와 1,536 MiB입니다.
llama.cpp는 창에 배치 하나를 더 들고 있습니다. 32K에서 Gemma는 814 MiB, gpt-oss는 786 MiB를 잡았습니다. sliding 층도 전부 들고 있게 하는 --swa-full을 켜면 정확히 4,352 MiB와 1,536 MiB가 나왔습니다. 기본값이 곧 절약입니다.
그런데 창 크기와 딱 맞지는 않았고, 여기서 예측이 하나 빗나갔습니다. 저희는 계산대로(771 대 756) gpt-oss가 Gemma보다 클 것이라고 예측했는데, 실제로는 더 작았습니다. sliding 층이 창에 micro-batch(-ub, 기본 512) 하나를 더한 만큼을 256 단위로 올려 잡기 때문입니다. Gemma는 1,024 + 512 = 1,536칸, gpt-oss는 128 + 512 = 640칸을 올려 768칸입니다. Gemma는 이런 층이 29개라서 덧붙는 양이 더 큽니다. 이 설명은 결과를 본 뒤에 -ub를 바꿔 가며 확인했습니다. -ub가 256, 512, 1024일 때 Gemma는 785, 814, 872 MiB, gpt-oss는 780, 786, 798 MiB였고, 모두 창 + ubatch 계산과 맞았습니다.
vLLM은 훨씬 많이 예약했습니다. Python LLM 클래스로 띄우고 max_num_batched_tokens를 A100에서의 기본값 8,192로 두었을 때, 같은 32K 요청 하나에 Gemma는 2,682 MiB, gpt-oss는 1,155 MiB였습니다. sliding 층이 더 늘어나지 않는 것은 같습니다. 다만 vLLM은 창 옆에, 스케줄러가 한 번에 처리하고 있을 수 있는 토큰 전부의 자리를 더 잡아 둡니다. 이 설정에서는 2 × 8,192, 곧 16,384토큰입니다. 그래서 이 설정에서는 sliding window로 아낄 수 있는 양의 절반가량만 실제로 아낍니다. max_num_batched_tokens를 낮추면 절약이 돌아옵니다(512에서 Gemma 32K 요청 하나에 882 MiB). 이 기본값은 GPU와 띄우는 방법에 따라 다릅니다(A100에서 vllm serve는 2,048). 예약 식과 그 식을 확인한 측정, 이 설정을 낮출 때의 대가는 다음 글에 정리했습니다.
계획할 때. sliding window 모델은 창 크기가 아니라 런타임이 실제로 예약하는 양을 기준으로 계획합니다. llama.cpp에서는 --swa-full을 끈 채로 둡니다(켜면 Gemma 32K가 814 MiB에서 4,352 MiB가 됩니다). 8비트 캐시를 쓰면 남은 양이 다시 절반 가까이 줄어듭니다(llama.cpp 32K에서 Gemma 432 MiB, gpt-oss 418 MiB).
3. MLA: 두 런타임 모두 절약을 지킵니다
DeepSeek-V2-Lite는 (512 + 64) × 2바이트 × 27층 = 31,104바이트, 토큰당 30.4 KiB입니다. 런타임이 잠재 벡터를 헤드 16개(key 폭 192, value 폭 128)로 풀어서 저장한다면 270 KiB, 거의 아홉 배가 됩니다. 32K로 치면 972 MiB 대 8,640 MiB입니다.
두 런타임 모두 잠재 벡터를 그대로 저장했습니다. llama.cpp는 4K, 32K, 128K에서 121.5, 972, 3,888 MiB로 계산과 정확히 같았습니다. vLLM은 토큰당 31,104, 31,102, 31,105바이트였습니다.
계획할 때. 메모리 때문에 따로 바꿀 것은 없고, 8비트 캐시로 다시 절반 가까이 줄일 수 있습니다(llama.cpp 32K에서 516 MiB). 손이 간 곳은 거기까지 가는 과정이었습니다. 같은 빌드의 변환기로 모델을 GGUF로 직접 바꿨는데, 토크나이저를 알아보지 못해 멈췄습니다. 어떤 토크나이저인지 직접 알려 주고서야 변환이 끝났습니다. DeepSeek 모델을 직접 변환한다면 llama.cpp가 찍는 캐시 크기가 잠재 벡터 계산과 맞는지 확인해 보시기 바랍니다. 헤드를 풀어 저장하는 파일도 돌아가기는 합니다. 메모리를 아홉 배 쓸 뿐입니다.
4. 선형 어텐션 혼합: 대화마다 고정 비용이 붙습니다
Qwen3.5-9B는 32층 가운데 8층만 토큰을 남깁니다. 2 × 4 × 256 × 2 × 8 = 토큰당 32 KiB입니다. 나머지 24층은 대화마다 크기가 정해진 상태를 하나씩 들고 있습니다.
llama.cpp는 두 부분을 따로 보여 줬습니다. KV는 4K, 32K, 128K에서 128, 1,024, 4,096 MiB(정확히 토큰당 32 KiB)였고, 여기에 "recurrent" 상태 50.25 MiB가 길이와 상관없이 붙었습니다.
vLLM의 토큰당 값은 59,145, 36,444, 33,668바이트로, 32 KiB보다 80.5%, 11.2%, 2.7% 컸습니다. 길이가 길수록 초과분이 줄어드는 것은 고정 비용이 더 많은 토큰에 나뉘기 때문입니다. vLLM의 캐시 블록 수로 거꾸로 계산하면 고정분은 요청 하나에 약 99 MiB로, llama.cpp 50 MiB의 두 배입니다. 기본으로 켜져 있는 prefix caching 때문에 vLLM이 선형 층 묶음마다 블록을 하나가 아니라 두 개씩 잡습니다. prefix caching을 끄자 약 49.5 MiB로 내려갔습니다(계산과 측정은 다음 글에 있습니다).
계획할 때.
- 이 글에 나온 모델 가운데 맥락 길이의 영향이 가장 작습니다. llama.cpp에서 32K가 1,074 MiB로 Qwen3-8B 4,608 MiB의 4분의 1이 안 되고, 128K도 4,146 MiB입니다.
- 고정 상태는 길이가 아니라 동시에 여는 대화 수만큼 곱해집니다.
- 8비트 캐시는 어텐션 8층만 줄입니다(32K에서 1,024 MiB가 544 MiB로). 50.25 MiB 상태는 그대로였습니다.
모델과 길이를 고를 때
| 모델에 이런 층이 있다면 | 이것으로 계획합니다 | 이것을 조심합니다 |
|---|---|---|
| full attention만 | config.json × 길이 | 캐시 형식 말고는 바꿀 것이 없습니다 |
| sliding 층 | 창이 아니라 런타임의 예약량 | vLLM max_num_batched_tokens, llama.cpp --swa-full |
| MLA | 잠재 벡터 크기 | 헤드를 풀어 저장하는 변환 |
| 선형 어텐션 층 | 어텐션 층 × 길이, 여기에 대화마다 고정 상태 | 동시 대화 수, vLLM prefix caching이 상태를 두 배로 잡음 |
사전 예측 채점
측정 전에 예측 여덟 개를 커밋했고, 여섯 개가 맞았습니다.
| 예측 | 결과 | |
|---|---|---|
| P1 | full attention 모델은 계산과 맞는다(llama.cpp ±3%, vLLM ±5%) | 맞음, 0% |
| P2 | Gemma 3의 sliding 절약이 llama.cpp에서 나타난다(32K가 756 MiB의 1.5배 안) | 맞음, 814 MiB |
| P3 | gpt-oss-20b도 마찬가지다(771 MiB의 1.5배 안) | 맞음, 786 MiB |
| P4 | vLLM은 DeepSeek의 잠재 벡터를 저장한다(30.4 KiB ±15%) | 맞음, 0.01% |
| P5 | 직접 변환한 파일로 llama.cpp도 그렇다(972 MiB의 1.5배 안) | 맞음, 972 MiB |
| P6 | vLLM의 Qwen3.5는 토큰당 32 KiB에서 20% 넘게 벗어난다 | 32K에서 틀림(+11.2%). 4K는 맞음(+80.5%), 128K는 틀림(+2.7%) |
| P7 | llama.cpp 32K의 크기 순서가 계산과 같다 | 틀림: gpt-oss 786 < Gemma 814 |
| P8 | 8비트 캐시는 f16의 45-55%다 | 맞음, 여섯 모델 모두 53.1% |
P6은 어느 길이로 채점할지 정해 두지 않았습니다. 이 글의 기준 길이인 32K로 채점하기로 한 것은 결과를 본 뒤였고, 그래서 세 길이를 모두 실었습니다. 2절의 -ub 실행은 P7의 원인을 확인하려고 본 결과가 나온 뒤에 더한 것이라 채점표에 넣지 않았습니다. 다음 글에 나오는 vLLM 추가 실행도 마찬가지입니다.
재지 않은 것
- 런타임마다 빌드 하나만 썼습니다. sliding window와 혼합 구조를 다루는 방식은 버전마다 바뀌고, 위의 예약 식도 이 빌드 기준입니다.
- 메모리만 쟀습니다. 메모리를 줄이려고 권장한 설정을 포함해 어떤 설정의 속도나 답 품질도 재지 않았습니다.
- vLLM 숫자는 최대 길이 요청 하나를 위한 예약량이고, 실제 작업에서 쓰게 되는 메모리가 아닙니다.
- 계획에는 기준 모델로 Llama 3.1 8B가 있었지만, 원본 저장소는 라이선스 동의 없이 config를 받을 수 없어 Qwen3-8B와 Mistral-7B-v0.3을 썼습니다.
- 128K는 Qwen3-8B와 Mistral-7B-v0.3의 학습 길이를 넘습니다.