llama.cpp, vLLM 배포 환경에 따른 배포 방법과 전략 (2) 속도와 동시 요청
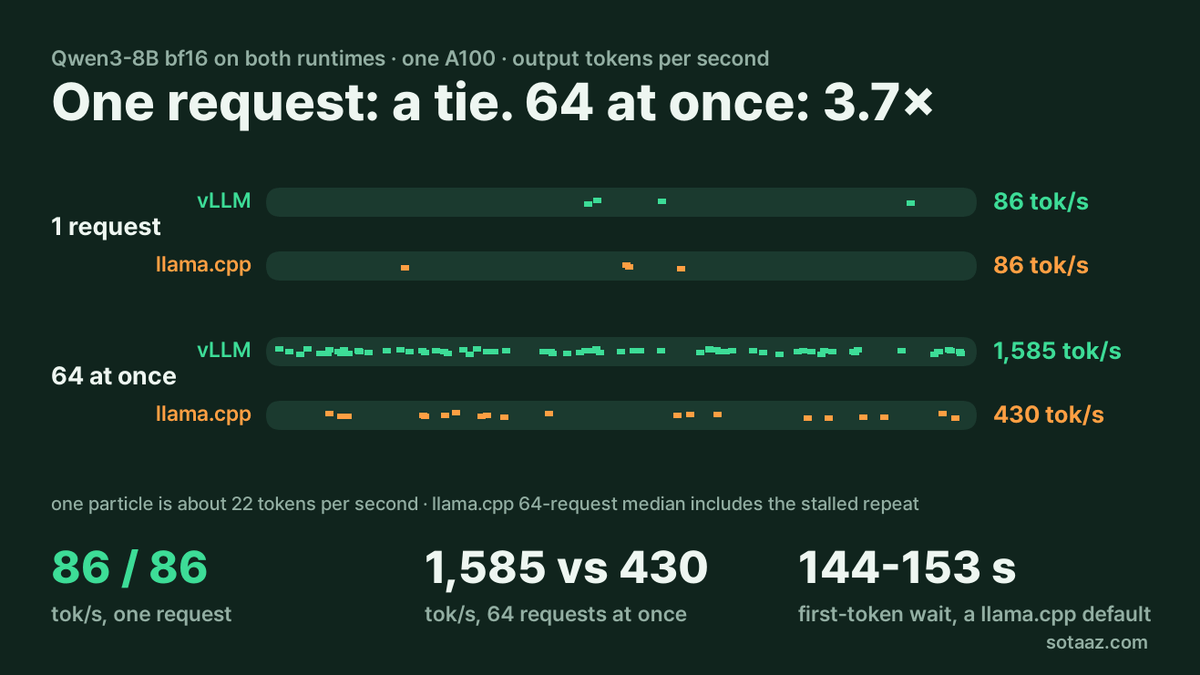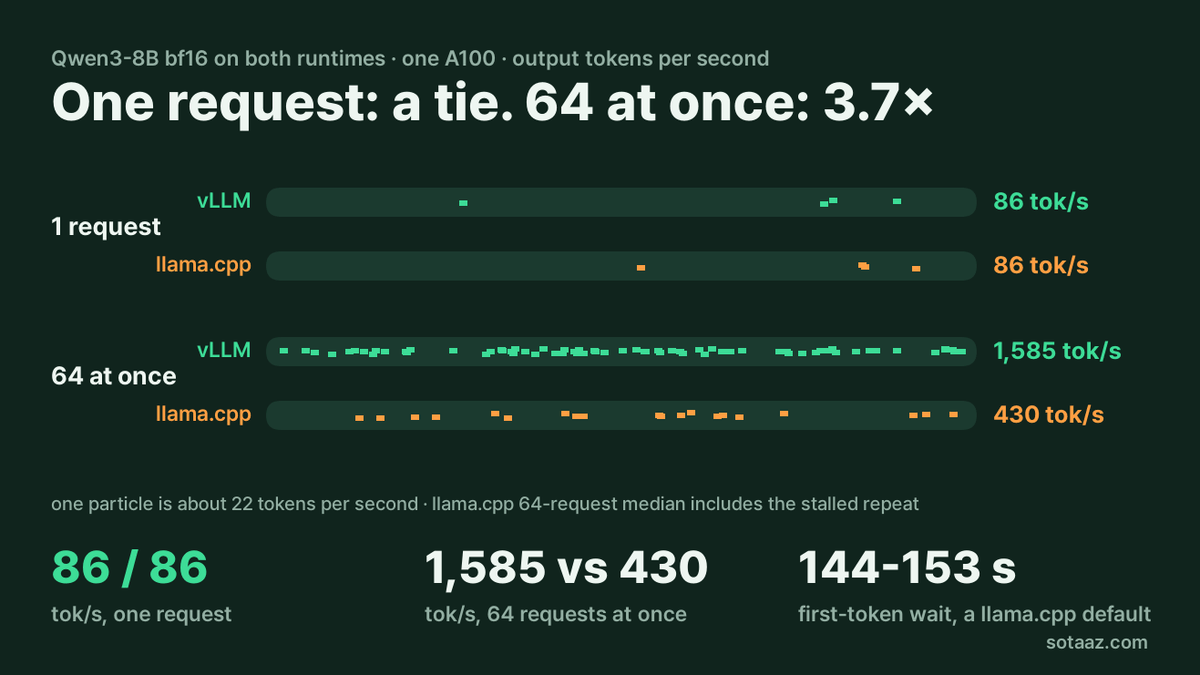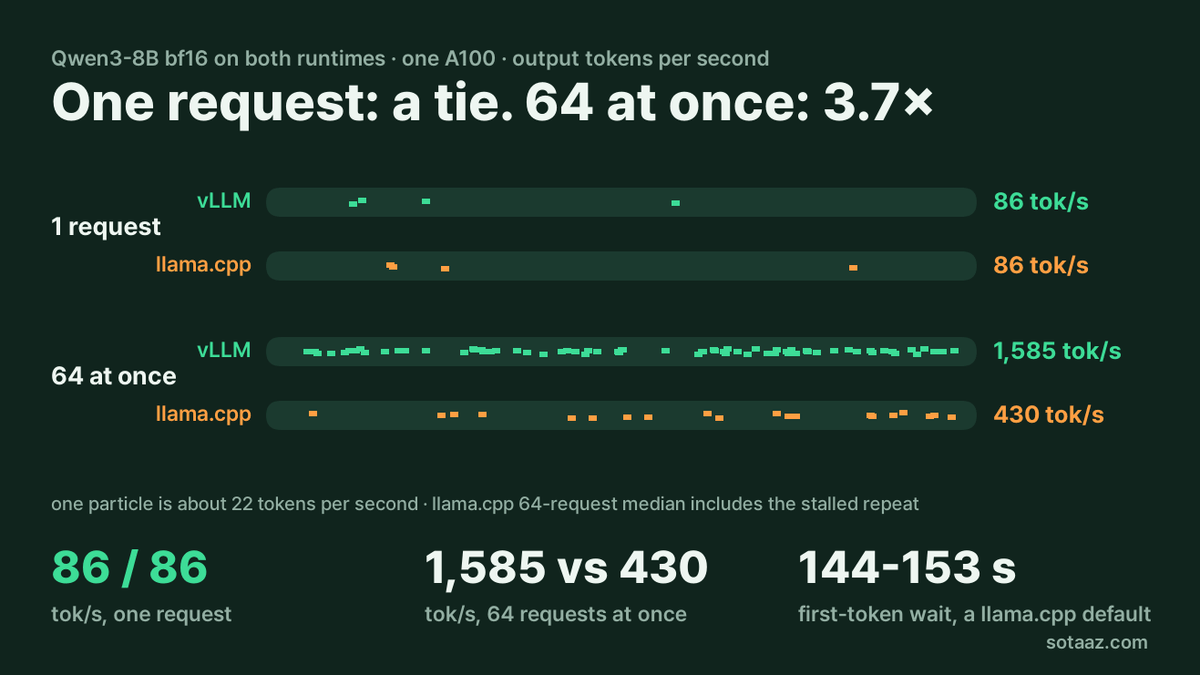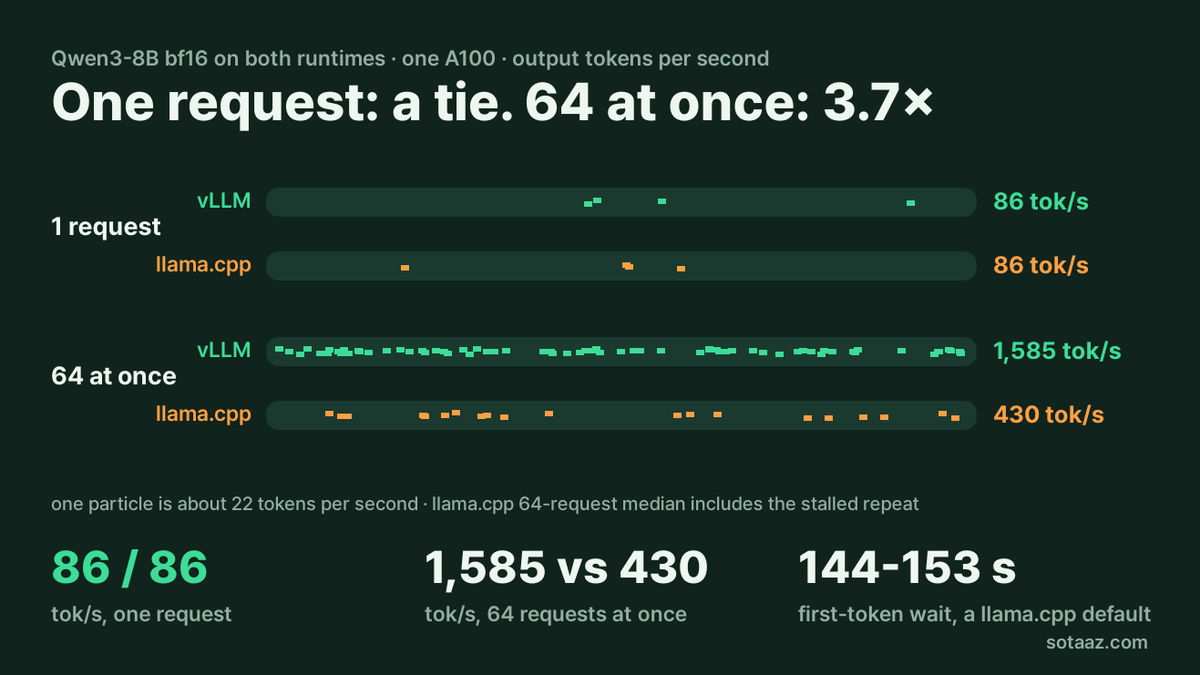
A100 한 장에서 Qwen3-8B를 두 런타임 모두 bf16으로 띄워 쟀습니다. 요청 하나의 생성 속도는 같았고(86 tok/s), 프롬프트는 vLLM이 빨리 읽었으며, 동시 요청 64개에서는 vLLM이 초당 1,585토큰, llama.cpp가 430토큰(프롬프트 캐시를 끄면 768토큰)을 냈습니다. llama.cpp 기본값 하나 때문에 요청 64개가 144초를 기다린 일, vLLM 예약량을 줄이는 비용, 미리 적어 둔 예측 일곱 개의 채점도 함께 정리했습니다.
llama.cpp, vLLM 배포 환경에 따른 배포 방법과 전략 (2) 속도와 동시 요청
1편은 메모리와 속도를 맞바꾸는 문제 하나를 남기고 끝났습니다. Gemma 3 4B에서 vLLM은 max_num_batched_tokens가 8,192일 때 32K 요청 하나에 2,682 MiB를 예약하고, 512일 때 882 MiB를 예약합니다. 이 값을 낮추면 vLLM은 프롬프트를 더 잘게 나눠 읽습니다. 그래서 저희는 메모리를 아끼는 대가로 프롬프트 처리가 느려질 거라고 봤습니다. 측정 전에 숫자도 적어 두었습니다. 512에서는 32,000토큰 프롬프트의 첫 토큰이 나오기까지 8,192일 때보다 1.5배 이상 걸린다고요.
실제로는 1.27배였습니다. 1.36초가 1.73초가 됐습니다. 요청 16개를 한꺼번에 보냈을 때의 처리량은 2% 움직였습니다. 아주 긴 프롬프트에서 0.37초를 더 쓰고 메모리 3분의 2를 돌려받은 셈입니다.
이것은 측정 스크립트를 쓰기 전에 커밋해 둔 예측 일곱 개 가운데 하나입니다. 이 글에서는 일곱 개를 모두 다룹니다. 요청 하나가 런타임마다 얼마나 빨리 도는지, 요청이 한꺼번에 들어오면 무엇이 달라지는지, prefix caching이 얼마나 아껴 주는지, llama.cpp에서 4비트 파일이 무엇을 바꾸는지입니다. 그리고 계획하지도 않았던 일이 하나 있습니다. llama.cpp의 기본값 하나 때문에 요청 64개가 첫 토큰을 144초 동안 기다렸습니다.
실행 환경. A100 80GB 한 장을 다른 프로세스 없이 썼습니다. llama.cpp는 빌드 4da6337에서 llama-server -ngl 99 -fa on, 캐시는 f16입니다. vLLM은 0.29.1rc1을 OpenAI 호환 서버로 띄우고 gpu_memory_utilization을 0.85로 두었습니다. CUDA graph와 컴파일은 켰습니다. 1편은 메모리를 eager 모드로 쟀지만, 이번에는 vLLM을 서비스할 때의 기본값 그대로 둔 것입니다. 런타임을 비교할 때는 두 쪽 모두 같은 bf16 가중치를 씁니다. vLLM은 Hugging Face 체크포인트를 그대로 읽고, llama.cpp는 같은 빌드의 변환기로 만든 bf16 GGUF를 읽습니다. 요청은 /v1/completions로 보냈고, 스트리밍을 켜고 temperature 0에 출력 길이를 고정했습니다. 프롬프트는 무작위 영어 단어입니다. 따로 말하지 않으면 요청마다 시작 부분이 달라서 재사용이 일어나지 않습니다. 조건마다 짧은 예열 요청을 하나 보내고 그 결과는 버렸습니다.
잰 것은 세 가지입니다. 첫 토큰 시간(TTFT)은 요청을 보낸 뒤 첫 토큰이 나올 때까지의 시간으로, 대부분 프롬프트를 읽는 시간입니다. 생성 속도는 요청 하나가 첫 토큰 다음부터 초당 몇 토큰을 내는지입니다. 처리량은 한꺼번에 보낸 요청 묶음이 낸 출력 토큰 전체를 묶음 전체에 걸린 시간으로 나눈 값입니다.
1. 요청 하나: 생성은 같고, 프롬프트 읽기가 다릅니다
Qwen3-8B에 요청을 하나씩 보내고 256토큰을 생성했습니다. 세 번 잰 중앙값입니다.
| Qwen3-8B bf16, 요청 하나 | llama.cpp | vLLM |
|---|---|---|
| 생성 속도, 프롬프트 4,096토큰 | 86.5 tok/s | 86.0 tok/s |
| 생성 속도, 프롬프트 32,000토큰 | 70.2 tok/s | 70.6 tok/s |
| TTFT, 프롬프트 4,096토큰 | 0.86초 | 0.33초 |
| TTFT, 프롬프트 32,000토큰 | 9.15초 | 4.13초 |
생성 속도는 두 길이 모두 1% 안쪽으로 같았습니다. 대화 하나에서 토큰 하나를 만들려면 가중치를 한 번씩 다 읽어야 하는데, 이 GPU에서는 그 읽는 속도가 두 런타임 모두 같았습니다. 32K에서는 토큰마다 더 긴 캐시를 읽어야 해서 느려지는데, 느려지는 정도도 같았습니다.
차이는 프롬프트를 읽는 데서 났습니다. vLLM은 첫 토큰까지 4K에서 llama.cpp의 0.38배, 32K에서 0.45배의 시간이 걸렸습니다. 다만 이 차이가 전부 프롬프트 처리 때문은 아닙니다. llama.cpp는 세 번 가운데 첫 요청만 빨랐습니다(4K 0.45초, 32K 6.1초). 두 번째와 세 번째는 0.86-0.88초, 9.1-10.3초였습니다. 이유는 3절에서 설명합니다. 그 원인이 된 설정을 끄면 llama.cpp는 매번 0.44초와 6.15초였고, vLLM의 TTFT는 그 0.75배와 0.67배였습니다. 어느 쪽이든 이 GPU에서는 vLLM이 긴 프롬프트를 더 빨리 읽습니다. 다만 4K에서의 차이는 llama.cpp 설정 하나에 따라 0.38배에서 0.75배까지 달라집니다.
2. 요청이 한꺼번에 들어올 때: 두 런타임이 갈리는 곳
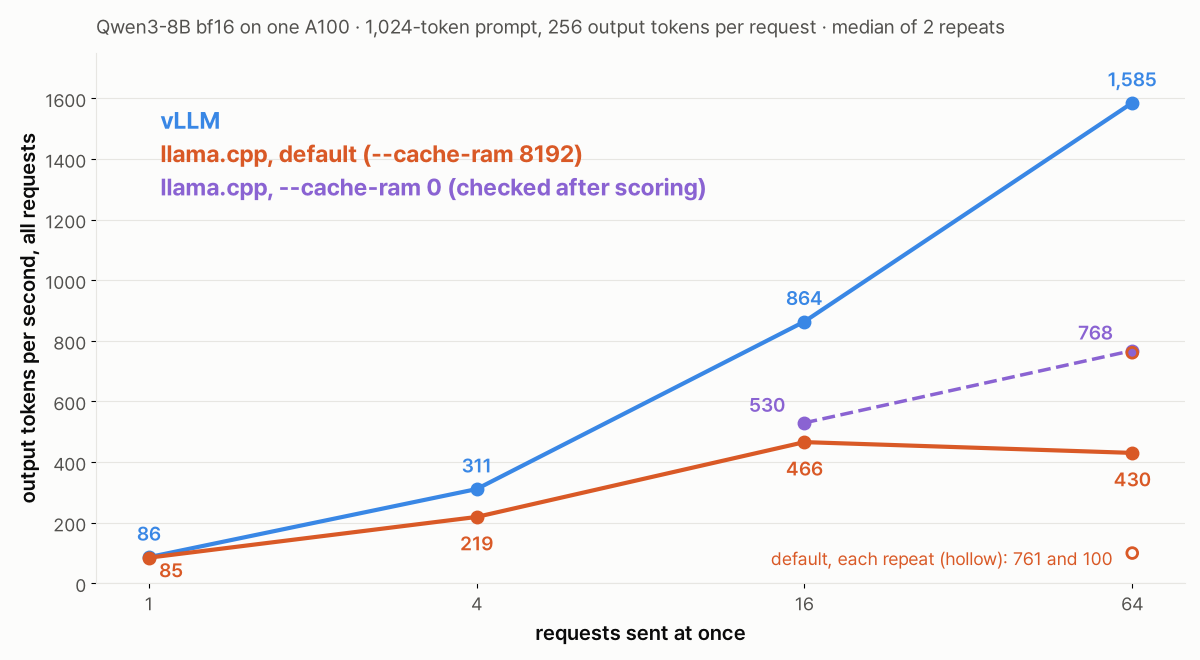
같은 모델에 요청 N개를 동시에 보냈습니다. 요청마다 프롬프트는 1,024토큰, 출력은 256토큰입니다. llama.cpp는 --parallel N에 슬롯마다 2,048토큰을 주었고, vLLM은 서버 하나에 N만 바꿨습니다.
| 동시 요청 수 | 1 | 4 | 16 | 64 |
|---|---|---|---|---|
| llama.cpp 처리량 | 85 tok/s | 219 tok/s | 466 tok/s | 430 tok/s |
llama.cpp --cache-ram 0 처리량 | 530 tok/s | 768 tok/s | ||
| vLLM 처리량 | 86 tok/s | 311 tok/s | 864 tok/s | 1,585 tok/s |
| llama.cpp 요청당 생성 속도 | 89 tok/s | 63 tok/s | 39 tok/s | 16 tok/s |
| vLLM 요청당 생성 속도 | 89 tok/s | 85 tok/s | 67 tok/s | 35 tok/s |
| llama.cpp TTFT 중앙값 | 0.17초 | 0.61초 | 2.19초 | 76.5초 |
llama.cpp --cache-ram 0 TTFT 중앙값 | 1.28초 | 4.65초 | ||
| vLLM TTFT 중앙값 | 0.09초 | 0.28초 | 0.90초 | 2.83초 |
두 런타임 모두 요청을 묶어서 처리합니다. llama.cpp도 16개일 때 하나일 때의 5.5배를 냈으니, 슬롯은 따로여도 계산은 한 번에 돌아간다는 뜻입니다. 그런데 vLLM은 64개까지 계속 올라가 하나일 때의 18배를 냈습니다. 64개에서 vLLM의 처리량은 llama.cpp의 프롬프트 캐시를 껐을 때와 비교하면 2.1배, 켰을 때와 비교하면 3.7배였습니다. 사용자 한 명 쪽에서 보면, 64개 묶음 안의 요청 하나가 vLLM에서는 초당 35토큰, llama.cpp에서는 16토큰을 받았습니다.
llama.cpp 행의 TTFT 76.5초는 오타가 아니고, 묶음 처리 때문도 아닙니다. 두 번 잰 것 가운데 첫 번째는 요청 64개를 21.5초에 다 끝냈습니다. 두 번째에서는 모든 요청이 첫 토큰을 144-153초 기다렸습니다. 처리량 430은 761과 100의 중앙값입니다.
메모리는 1편에서 설명한 대로 움직였습니다. 부하 중에 nvidia-smi로 본 llama.cpp의 GPU 사용량은 슬롯 수를 따라 늘었습니다. 슬롯 하나에서 15,337 MiB, 64개에서 33,491 MiB였습니다. vLLM은 N과 상관없이 69,585 MiB였습니다. 시작할 때 GPU의 0.85를 가져가서, 요청이 하나 오든 64개 오든 그 자리를 캐시용으로 잡아 두기 때문입니다.
3. llama.cpp가 RAM에 두는 프롬프트 캐시: 두 번째 묶음이 기다린 이유
64개 묶음 두 번 사이에 무슨 일이 있었는지는 서버 로그에 남아 있었습니다. 이전 대화를 아직 들고 있는 슬롯이 새 요청을 받으려면, 서버는 먼저 그 슬롯의 상태를 호스트 메모리의 프롬프트 캐시에 저장합니다. 항목 하나가 179.875 MiB였습니다. Qwen3-8B 캐시 1,279토큰을 담은 슬롯 하나의 크기입니다. 이 캐시에는 한도(--cache-ram, 기본 8,192 MiB)가 있는데, 이미 가득 차 있었습니다. 그래서 서버는 새 항목을 넣을 때마다 오래된 항목을 하나씩 지우고 그때마다 로그를 남긴 뒤에야 다음 슬롯으로 넘어갔습니다. 64개 슬롯이 모두 다시 돌기까지 지운 기록이 1,000줄이었고, 약 0.13초 간격으로 지웠습니다.
1절에서 본 차이도 같은 단계 때문입니다. 슬롯이 하나일 때는 새 요청이 올 때마다 직전의 4K나 32K 대화를 먼저 저장합니다. Qwen3-8B 캐시는 토큰당 144 KiB라서 32K 대화 하나가 약 4.4 GiB입니다. 두 번째와 세 번째 요청에만 붙은 시간(4K에서 약 0.4초, 32K에서 3-4초)은 아래처럼 이 캐시를 끄면 사라졌습니다.
원인은 숫자를 본 뒤에 확인했습니다. --cache-ram 0으로 프롬프트 캐시를 끄고 같은 요청을 다시 보냈고, 이 실행은 채점 밖의 확인으로 따로 등록했습니다. 그러자 회차 사이 차이가 사라졌습니다. 4K 요청 세 번이 모두 0.44초, 32K는 6.12-6.18초, 64개 묶음 두 번은 21.2초와 21.5초였습니다.
이 캐시에도 쓸모는 있습니다. 슬롯을 다른 사람에게 넘긴 뒤 같은 대화가 다시 오면, llama.cpp는 대화 기록을 처음부터 다시 읽는 대신 RAM에서 되살릴 수 있습니다. 그 이득은 재지 않았습니다. 저희가 말할 수 있는 것은 같은 대화가 한 번도 돌아오지 않는 이번 부하에서의 비용입니다. 슬롯 하나에서는 긴 요청마다 최대 4초가 더 걸렸고, 슬롯 64개를 한 번씩 다 쓴 뒤에는 모든 요청이 144초 넘게 멈췄습니다. 서로 관계없는 새 요청이 주로 들어오는 서버라면 --cache-ram 0이나 더 작은 한도로 바꿔서 비교해 보세요. 대화가 자주 돌아오고 슬롯이 적다면 켜 두고, 저장에 드는 시간과 되살려서 아끼는 시간을 재 보시면 됩니다.
4. vLLM의 예약량을 줄이는 비용
처음 질문으로 돌아갑니다. Gemma 3 4B bf16에서 max_num_batched_tokens를 세 값으로 바꿔 재고, 1편에서 잰 요청당 예약량을 옆에 붙였습니다.
max_num_batched_tokens | 32K 요청 하나의 KV 예약량(1편) | TTFT, 프롬프트 32,000토큰 | 처리량, 요청 16개 |
|---|---|---|---|
| 8,192 | 2,682 MiB | 1.36초 | 1,192 tok/s |
| 2,048 | 1,242 MiB | 1.46초 | 1,194 tok/s |
| 512 | 882 MiB | 1.73초 | 1,168 tok/s |
값을 낮추면 긴 프롬프트가 느려지기는 했지만 예측보다 덜했고, 짧은 프롬프트의 처리량은 거의 그대로였습니다. Gemma처럼 sliding window를 쓰는 모델이라면, 512로 내려서 1편에서 잰 메모리의 대부분을 돌려받고 32K 프롬프트에서 0.37초를 더 쓰는 셈입니다. 처리량이 거의 움직이지 않은 이유는 요청 16개 묶음의 시간 구성에서 보입니다. 3.3-3.6초 걸린 실행에서 첫 토큰 중앙값이 0.4-0.7초에 나왔습니다. 대부분의 시간이 생성에 쓰였고, 이 설정은 생성을 건드리지 않습니다. 참고로 llama.cpp에서는 Gemma 3 4B가 32,000토큰 프롬프트를 2.91초에 읽었습니다(프롬프트 캐시를 켠 중앙값이고, 첫 요청은 2.27초).
배포할 때 하나 더 볼 것이 있습니다. 1편의 2,682 MiB는 vLLM의 Python LLM 클래스로 잰 값이고, 이 클래스는 A100에서 기본값이 8,192입니다. 같은 GPU에서 vllm serve 서버의 기본값은 2,048입니다. 이 빌드의 소스를 보면 H100급 GPU에서는 각각 16,384와 8,192입니다. 그러니 A100에서 서버를 기본값으로 띄우면 이미 1,242 MiB 행에 있습니다. 실제 배포가 어느 값을 쓰는지 확인해 보세요. 이 빌드는 로그에 값을 바로 찍지 않지만, 컴파일 범위(compile range (1, 2048))로 알 수 있습니다.
5. Prefix caching: 혼합 구조 모델에서도 재사용됩니다
1편에서 prefix caching은 Qwen3.5-9B(어텐션 층과 Gated DeltaNet 층을 섞은 모델)에 대해 vLLM이 잡는 고정 상태를 두 배로 늘렸습니다. 남은 질문은 그렇게 더 쓴 메모리만큼 시간을 아껴 주느냐였습니다. 앞부분 8,000토큰이 같고 끝 64토큰만 다른 요청 여덟 개를 차례로 보내고, 각각 16토큰을 생성했습니다.
| Qwen3.5-9B | 첫 요청 TTFT | 2-8번째 요청 TTFT 중앙값 |
|---|---|---|
| vLLM bf16, prefix caching 켜짐 | 0.70초 | 0.089초 |
| vLLM bf16, prefix caching 꺼짐 | 0.66초 | 0.662초 |
| llama.cpp Q4_K_M, 슬롯 하나 | 2.03초 | 0.199초 |
켰을 때 두 번째부터는 첫 토큰이 껐을 때의 0.13배 시간에 나왔습니다. 같은 8,000토큰을 한 번만 읽고 다시 썼다는 뜻이고, 선형 어텐션 층의 상태도 다시 계산하지 않고 이어 받은 것입니다. vLLM 로그에는 상태 캐시가 "align" 모드로 찍혔는데, 1편에서 묶음마다 블록 하나를 더 잡게 만든 그 모드입니다. 시스템 프롬프트가 길게 고정돼 있거나 문서 하나를 두고 여러 번 묻는 작업이라면, 그 메모리로 이번 조건에서 요청마다 약 0.6초를 아낀 셈입니다.
llama.cpp도 앞부분 대부분을 재사용했습니다. 슬롯 하나가 직전 요청을 그대로 들고 있었고, 로그를 보면 8,064토큰 프롬프트마다 516토큰만 다시 읽었습니다. 새로 붙은 64토큰보다 많이 되돌아간 이유는 확인하지 못했습니다. 그리고 llama.cpp는 4비트 파일로 돌렸으니, llama.cpp 행은 그 행의 두 숫자끼리만 비교하고 vLLM 행과는 비교하지 마세요.
6. llama.cpp의 4비트 파일: 생성은 빨라지고 프롬프트는 느려집니다
llama.cpp 배포는 대부분 bf16이 아니라 양자화한 GGUF로 합니다. Qwen3-8B Q4_K_M과 bf16을 같은 서버 설정으로 비교했습니다.
| llama.cpp의 Qwen3-8B, 요청 하나 | bf16 | Q4_K_M |
|---|---|---|
| 생성 속도, 프롬프트 4,096토큰 | 86.5 tok/s | 129.6 tok/s |
| 생성 속도, 프롬프트 32,000토큰 | 70.2 tok/s | 98.5 tok/s |
| TTFT, 프롬프트 4,096토큰 | 0.86초 | 1.35초 |
| TTFT, 프롬프트 32,000토큰 | 9.15초 | 13.15초 |
4K에서 생성은 1.5배 빨라졌습니다. 저희는 1.8배 이상을 예측했습니다. 파일이 3분의 1 크기이니 토큰마다 읽는 양이 줄어 거의 세 배 가까이 빨라질 거라는 계산이었습니다. 프롬프트 처리는 오히려 느려졌습니다. 중앙값으로 4K에서 1.6배, 32K에서 1.4배 오래 걸렸고, 여섯 쌍의 회차 모두에서 Q4_K_M이 느렸습니다. 프롬프트를 읽는 일은 많은 토큰을 한꺼번에 곱하는 행렬 곱셈이고, 거기서는 4비트 가중치를 그냥 읽는 것이 아니라 풀어서 써야 합니다. 커널을 프로파일링하지는 않았으니 이것은 추정이고 확인한 원인은 아닙니다. 정리하면 이 GPU에서 4비트 파일은 메모리를 아끼고 생성을 빠르게 하지만, 긴 프롬프트를 빠르게 하지는 않았습니다.
예측 채점
측정 스크립트를 쓰기 전에 기준과 함께 커밋해 둔 예측입니다. 채점은 등록한 조건(llama.cpp 기본값, 프롬프트 캐시를 켜 둔 상태)으로 했습니다.
| 예측 | 결과 | ||
|---|---|---|---|
| Q1 | 요청 하나의 생성 속도는 두 런타임이 20% 안쪽(4K) | 86.5 대 86.0 tok/s, 0.6% 차이 | 맞음 |
| Q2 | vLLM TTFT가 llama.cpp의 0.75배 이하(4K, 32K 모두) | 0.38배, 0.45배 | 맞음 |
| Q3 | llama.cpp Q4_K_M 생성 속도가 bf16의 1.8배 이상(4K) | 1.50배 | 틀림 |
| Q4 | 동시 요청 64개에서 vLLM 처리량이 llama.cpp의 2.0배 이상 | 3.68배 | 맞음 |
| Q5 | llama.cpp 동시 요청 16개 처리량이 하나일 때의 4배 이상 | 5.50배 | 맞음 |
| Q6 | max_num_batched_tokens 512에서 32K TTFT가 8,192의 1.5배 이상이고, 요청 16개 처리량은 10% 안쪽 | 1.27배, 2% | 틀림(절반만 맞음) |
| Q7 | vLLM prefix caching을 켜면 2-8번째 요청 TTFT가 껐을 때의 0.3배 이하 | 0.13배 | 맞음 |
Q2와 Q4가 얼마나 여유 있게 맞았는지는 llama.cpp의 프롬프트 캐시에 달려 있습니다. --cache-ram 0(사후 확인이라 채점 밖)으로 보면 Q2는 4K에서 0.753배, 32K에서 0.67배라 4K에서 기준 0.75를 아슬아슬하게 넘겨 틀렸고, Q4는 2.06배로 겨우 맞았습니다.
고르고 설정할 때 볼 것
GPU 한 장, 모델 셋, 정해 둔 부하에서 나온 숫자입니다. 규칙처럼 받아들이기보다 직접 재 볼 방향으로 읽어 주세요.
- 사용자가 한 명이거나 몇 명일 때. 정밀도가 같으면 생성 속도는 두 런타임이 같습니다. 차이는 다른 데 있습니다. llama.cpp는 4비트 파일을 돌릴 수 있고(여기서는 생성 1.5배, 메모리도 적게), 슬롯에 필요한 만큼만 메모리를 잡습니다. vLLM은 긴 프롬프트를 더 빨리 읽습니다.
- 많은 사용자가 동시에 쓸 때. 두 런타임이 갈리는 곳입니다. 동시 요청 64개에서 vLLM은 2.1-3.7배를 냈고, 요청 하나가 받는 생성 속도도 두 배 넘게 유지했습니다. llama.cpp라면
--parallel을 실제 동시 사용 수에 맞추고,-c가 슬롯 수로 나뉜다는 점(1편)을 기억하세요. - llama.cpp에 관계없는 요청이 많이 들어올 때.
--cache-ram 0이나 더 작은 한도를 시험해 보세요. 이번 부하에서는 기본값이 반복 요청을 느리게 했고, 슬롯 64개에서는 144초 멈춤까지 갔습니다. - vLLM에서 sliding window 모델을 띄울 때.
max_num_batched_tokens를 낮추면 작은 비용으로 메모리 대부분을 돌려받습니다(Gemma 512: 32K 요청 하나에 2,682 대신 882 MiB, 32K 프롬프트에서 0.37초 더). 띄우는 방법마다 기본값이 다르다는 것도 확인하세요. - vLLM에서 프롬프트 앞부분이 길게 겹칠 때. 혼합 구조 모델이라도 prefix caching을 켜 두세요. 묶음마다 상태 블록을 하나 더 잡지만, 이번 조건에서는 다시 읽는 시간을 대부분 아꼈습니다.
확인하지 않은 것
- A100 80GB 한 장, 런타임마다 빌드 하나, vLLM은 CUDA graph를 켠 상태입니다. 묶음 처리, 커널, 프롬프트 캐시는 버전마다 바뀝니다.
- 모델은 셋(Qwen3-8B, Gemma 3 4B, Qwen3.5-9B)이고, 모델마다 측정 한두 가지에만 썼습니다. 반복은 요청 하나일 때 세 번, 묶음일 때 두 번입니다.
- 프롬프트는 무작위 단어, 출력 길이는 고정, 요청은 한꺼번에 또는 차례로 보냈습니다. 실제 트래픽은 시간에 흩어져 오고 길이도 제각각이며 대화가 다시 돌아옵니다. 그런 부하는 재지 않았고, llama.cpp 프롬프트 캐시의 이득도 재지 않았습니다.
- 답 품질은 재지 않았습니다. temperature 0과 고정 길이는 시간을 재기 위한 설정입니다.
--cache-ram 0실행은 결과를 본 뒤 추가한 것이고, 채점한 예측에는 들어가지 않습니다.- Q4_K_M의 프롬프트가 느린 이유는 프로파일링으로 확인하지 않았습니다.