DeepSeek config에는 KV 헤드가 16개인데 어떻게 캐시는 9분의 1만 쓸까: LLM이 어텐션을 다루는 일곱 가지 방식과 모델별 사용처
DeepSeek-V2-Lite의 config.json에 적힌 KV 헤드 16개로 계산하면 32K 캐시가 8,640 MiB인데, llama.cpp는 972 MiB를 잡았습니다. MHA, MQA, GQA, sliding window, MLA, sparse attention, 선형 어텐션 혼합 구조가 각각 무엇을 저장하는지, 어떤 모델이 쓰는지(모델별 config.json으로 확인), 무엇을 포기하는지 정리했습니다.
DeepSeek config에는 KV 헤드가 16개인데 캐시는 9분의 1
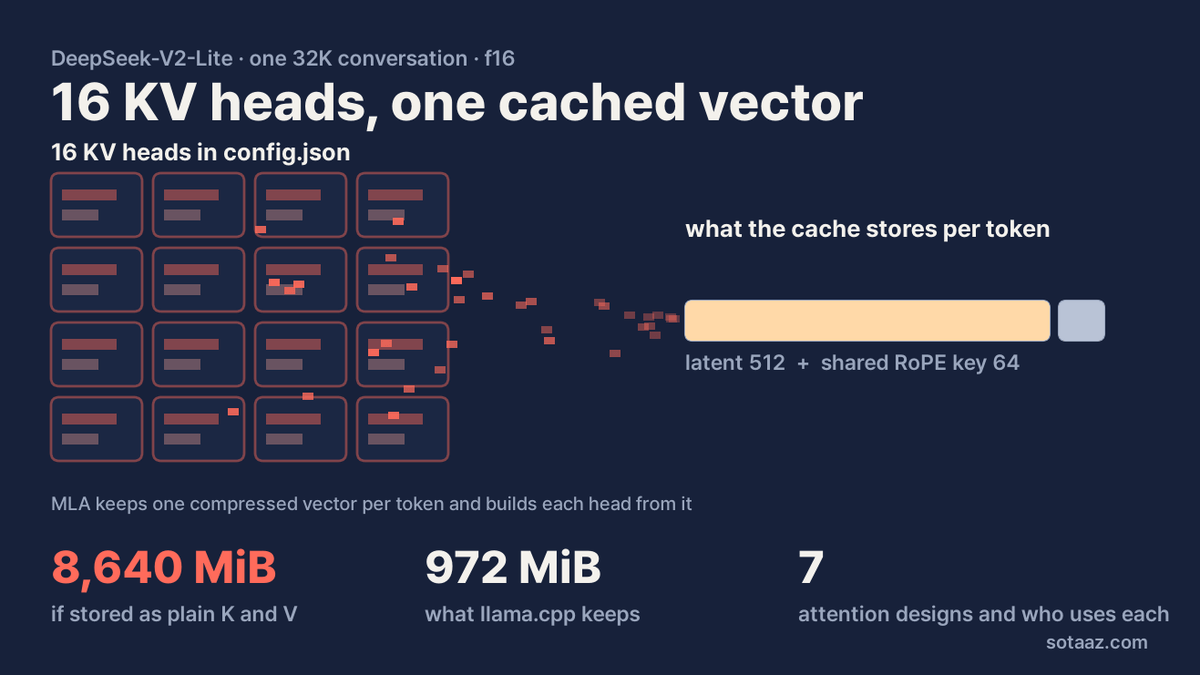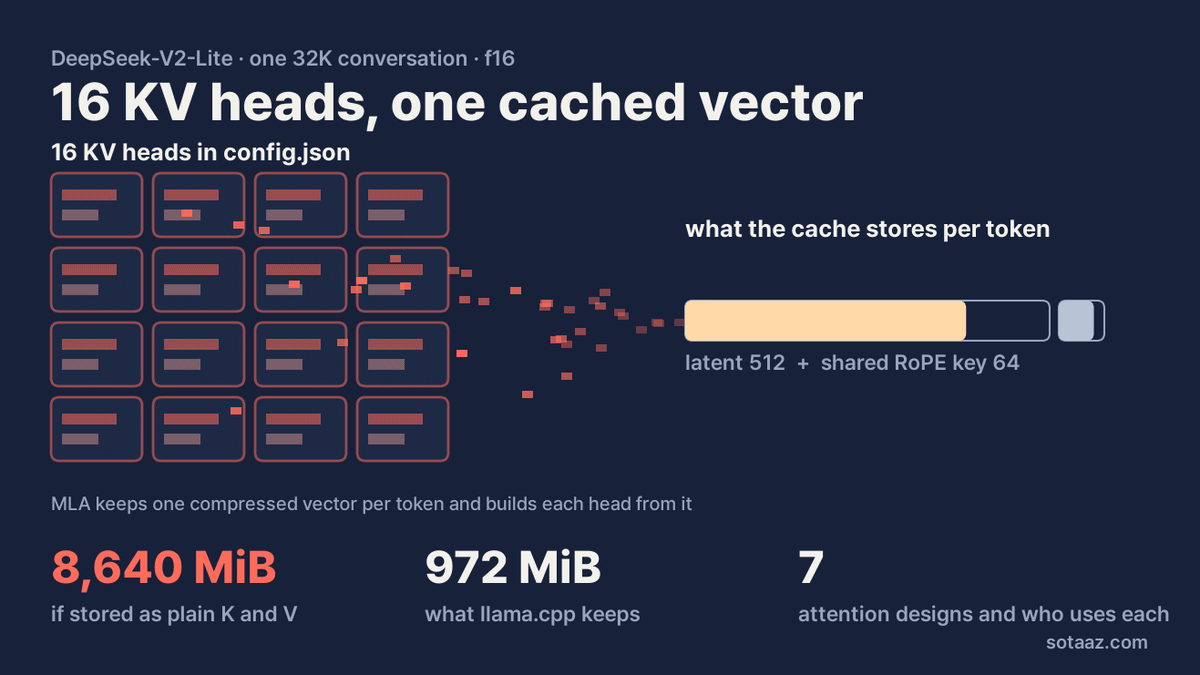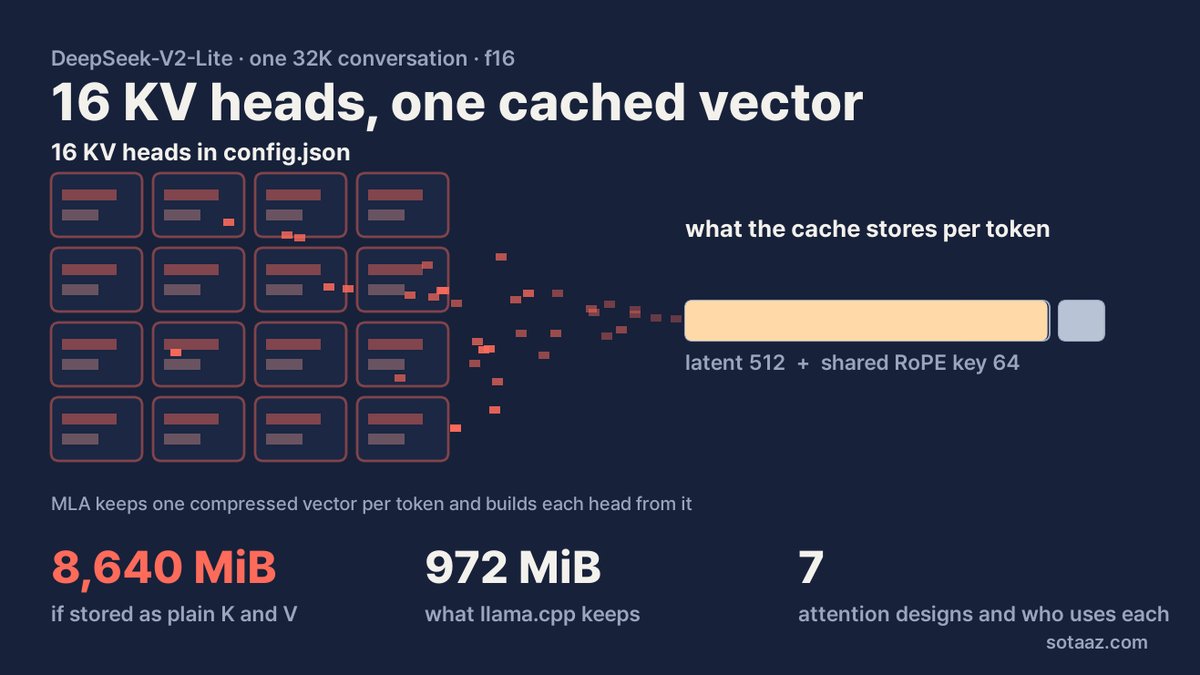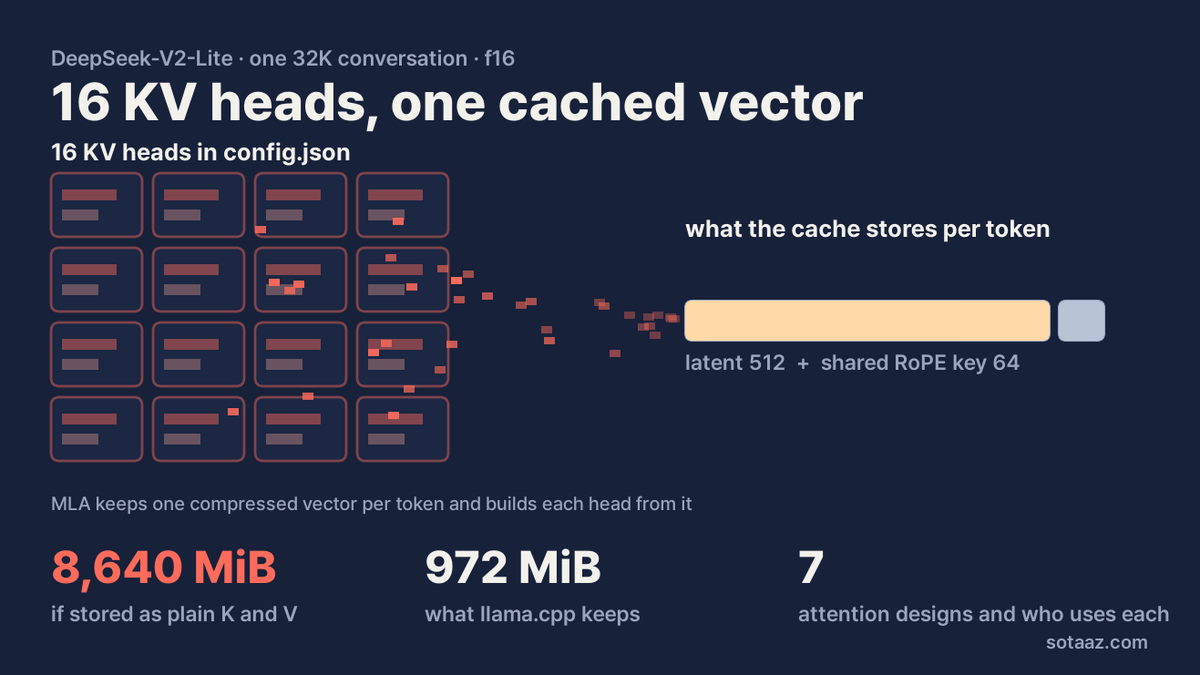
DeepSeek-V2-Lite의 config.json에는 27개 층마다 key-value 헤드가 16개 있다고 적혀 있습니다. KV 캐시 크기는 보통 토큰마다, 층마다 KV 헤드 수만큼 key와 value를 16비트(2바이트)로 저장한다고 보고 계산합니다. key와 value의 크기가 같은 모델이라면 2 × KV 헤드 수 × 헤드 크기 × 2바이트 × 층 수 × 토큰 수입니다(이 공식이 어디서 나오는지는 아래 첫 절에서 자세히 설명합니다). DeepSeek-V2-Lite는 헤드 하나의 key가 192차원(위치 정보용 64차원 포함), value가 128차원이라 (192 + 128) × 16 × 2바이트 × 27층 × 32,768토큰을 계산하면 32K 토큰 대화 하나에 8,640 MiB가 나옵니다. 그런데 llama.cpp로 모델을 띄우자 잡힌 캐시는 972 MiB였습니다. vLLM도 같은 양을 잡았습니다. 토큰당 31,102바이트였고, 32,768토큰을 곱하면 역시 972 MiB입니다. 두 런타임이 똑같이 계산값의 9분의 1만 쓴 것입니다. config의 헤드 수를 잘못 읽은 것은 아닙니다. 이 모델은 헤드를 아예 저장하지 않습니다. 층마다 토큰 하나에 숫자 576개짜리 압축 벡터 하나만 저장하고, 헤드 16개는 필요할 때마다 거기서 다시 만듭니다. 576개 × 2바이트 × 27층이 토큰당 31,104바이트이고, vLLM이 잡은 양과 0.01% 안쪽으로 같습니다.
이 차이를 따라가면 더 큰 사실이 보입니다. 2026년 공개 모델의 어텐션 레이어 설계는 한 가지 방법이 아닙니다. 헤드를 모두 저장하는 모델, 헤드를 나눠 쓰는 모델, 오래된 토큰을 잊도록 하는 모델, 토큰마다 압축해 두는 모델, 토큰을 아예 남기지 않는 모델 등 다양한 방법과 아키텍처들이 섞여 있습니다. 이 선택에 따라 긴 대화의 메모리 비용, 디코딩 속도, 먼 앞부분을 얼마나 정확히 기억하는지, 어떤 런타임과 최적화 기법이 통하는지가 결정됩니다.
이 글은 요즘 모델에서 만나는 일곱 가지 설계를 하나씩 다룹니다. multi-head, multi-query, grouped-query, sliding window(와 local-global 혼합), multi-head latent, sparse, 선형 어텐션 혼합 구조입니다. 설계마다 무엇을 저장하는지, 어떤 모델이 쓰는지, 무엇을 포기하는지를 봅니다.
모델과 설계의 짝은 모두 그 모델의 config.json으로 확인했습니다. Meta 모델 셋(Llama 3.1, Llama 3.3, Llama 4 Scout)은 라이선스 동의를 해야 받을 수 있어서, 같은 내용이 공개된 Unsloth 사본을 읽었습니다. 필드를 빼놓은 config도 있습니다. Gemma 3 4B가 그렇고, 이런 경우에는 Hugging Face transformers가 채워 넣는 기본값을 썼으며 숫자에 영향이 있는 곳마다 밝혔습니다. 메모리 숫자는 이 파일들로 32K 토큰 대화 하나를 16비트로 담는다고 보고 계산한 값입니다. 이 가운데 여섯 모델의 계산을 실제 런타임 할당량과 맞춰 본 결과는 이 연재의 뒤쪽 글 llama.cpp와 vLLM 실측에 있습니다.
어텐션이 남기는 것과 그 비용 두 가지
트랜스포머가 10,001번째 토큰을 만들 때, 어텐션 층마다 이 토큰의 query를 앞선 토큰 10,000개의 key와 하나씩 비교하고 그 결과로 value를 가중 평균합니다. 앞선 토큰의 key와 value를 매 단계 다시 계산하면 낭비이므로 런타임은 이것을 보관해 둡니다. 이것이 KV 캐시입니다. 기초는 KV 캐시 입문에서 코드와 함께 설명했습니다.
캐시에는 비용이 두 가지 듭니다.
- 메모리: 토큰이 하나 늘 때마다 층마다 KV 헤드 수만큼 key와 value가 늘어납니다. 평범한 층이면 2 × KV 헤드 수 × 헤드 크기 × 2바이트이고, 여기에 층 수와 대화 길이를 곱합니다.
- 대역폭과 계산: 새 토큰을 하나 만들 때마다 층마다 캐시 전체를 한 번 읽어야 합니다. 맥락이 길어지면 디코딩 속도는 연산 능력이 아니라 GPU가 메모리에서 바이트를 꺼내 오는 속도에 묶입니다.
아래 첫 번째 설계인 MHA(Multi-head Attention)가 기준선입니다. 나머지 여섯은 각각 다음 다섯 가지 가운데 하나를 줄입니다.
- 토큰마다 저장하는 KV 헤드 수(MQA, GQA)
- 남겨 두는 토큰 수(sliding window, chunked attention)
- 토큰 하나의 저장 크기(MLA)
- 단계마다 읽는 토큰 수(sparse attention)
- 토큰을 저장하는지 여부(선형 어텐션)
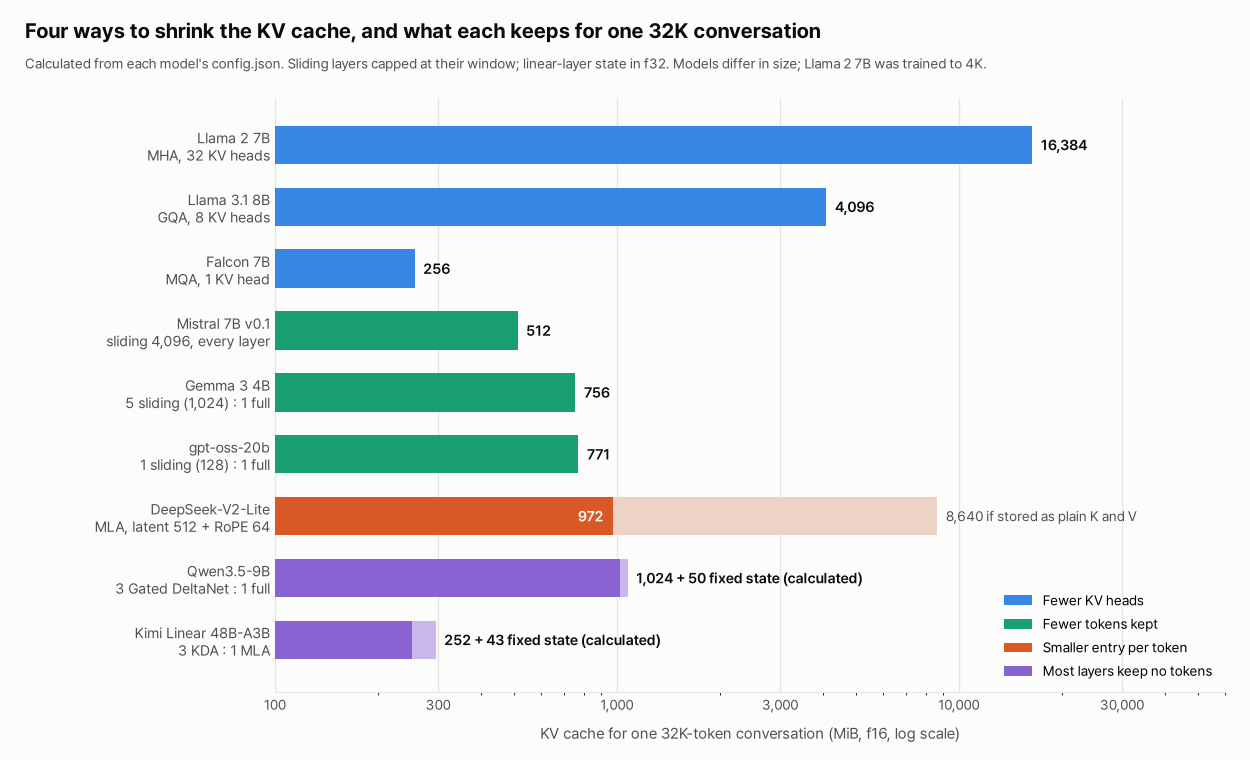
그림은 다섯 가지 가운데 메모리를 바꾸는 네 가지를 보여 줍니다. 네 번째인 sparse attention은 캐시를 전부 남기므로 막대가 없습니다. 계열마다 모델 하나씩을 같은 축에 놓았습니다. 모델 크기는 전체 파라미터 4B부터 48B까지 제각각이니, 어느 모델이 낫다는 그림이 아니라 설계마다 맥락을 어떻게 담는지 보여 주는 그림으로 읽어 주시기 바랍니다.
1. Multi-head attention(MHA): 헤드마다 key와 value를 따로 둡니다
처음 트랜스포머 논문의 아키텍처 그대로입니다. 헤드 H개가 저마다 query, key, value 투영을 갖고, 토큰마다 자기 key와 value를 따로 저장합니다.
쓰는 모델. 이제는 주로 오래된 모델이나 작은 모델입니다. Llama 2 7B(query 헤드 32개, KV 헤드 32개)와 Gemma 7B(16개와 16개)가 MHA입니다. 저희가 확인한 모델 가운데 2025-2026년에 나온 모델은 어텐션 층에 MHA를 그대로 쓰지 않았습니다.
비용. Llama 2 7B는 2 × 헤드 32 × 128차원 × 2바이트 × 32층 = 토큰당 512 KiB를 씁니다. 32K 대화라면 캐시가 16 GiB로, 16비트 가중치 12.6 GiB보다 큽니다. Llama 2는 4K까지만 학습했으니 이 계산은 가정일 뿐이지만, 이 크기에서 긴 맥락용 MHA 모델을 내놓지 않는 이유는 잘 보여 줍니다.
얻는 것. 헤드마다 자기 key로 어텐션을 할 수 있어 표현력이 가장 높고, 모든 런타임과 커널, 최적화 기법이 지원합니다. 다른 설계는 모두 이것과 비교됩니다.
2. Multi-query attention(MQA): 모든 헤드가 key와 value 하나를 함께 씁니다
Noam Shazeer가 2019년에 제안한 방식입니다. query 헤드는 여러 개 그대로 두고, key 헤드와 value 헤드는 하나씩만 두어 모든 query 헤드가 함께 씁니다. 캐시는 헤드 수만큼 줄어듭니다.
쓰는 모델. Falcon 7B(query 헤드 71개, multi_query: true, 헤드 크기 64), Google의 PaLM, Gemma 3 1B(query 헤드 4개, KV 헤드 1개), AI21 Jamba Reasoning 3B의 어텐션 층(query 헤드 20개, KV 헤드 1개)입니다.
비용. Falcon 7B는 토큰당 8 KiB, 32K에 256 MiB입니다. Llama 2 7B의 64분의 1입니다.
포기하는 것. 토큰마다 key 하나로 모든 헤드를 감당해야 하니, 헤드마다 서로 다른 것을 찾아보는 능력이 일부 줄어듭니다. Shazeer는 품질 손실이 작다고 보고했고 PaLM 저자들도 그 규모에서는 차이가 없었다고 했습니다. 반면 GQA 논문은 품질 저하와 학습 불안정을 보고합니다. 처음부터 MQA로 학습한 모델에서 loss가 자주 튀었다는 것입니다. 큰 규모에서는 실무상 비용도 있습니다. 헤드 단위로 모델을 여러 GPU에 나눌 때(tensor parallelism) KV 헤드 하나는 쪼갤 수 없으니, GPU마다 그 헤드를 통째로 복사해 들고 있어야 합니다.
3. Grouped-query attention(GQA): 절충안이 기본값이 됐습니다
Ainslie 등(2023)이 그 중간을 제안했습니다. query 헤드를 G개 묶음으로 나누고, 묶음마다 key 헤드와 value 헤드를 하나씩 둡니다. G = 1이면 MQA, G = H면 MHA입니다. 이 논문은 이미 학습한 MHA 체크포인트를 원래 사전 학습 계산량의 5% 정도를 더 들여 GQA로 바꿀 수 있다는 것도 보였습니다.
쓰는 모델. 2024년 이후 나온 dense 모델 거의 전부와, 아래 혼합 구조 대부분의 full attention 층입니다.
| 모델 | query 헤드 | KV 헤드 | KV 헤드 하나당 query 수 |
|---|---|---|---|
| Llama 2 70B, Llama 3.1 8B / 3.3 70B | 64 / 32 / 64 | 8 | 8 / 4 / 8 |
| Mistral 7B v0.1, v0.3 | 32 | 8 | 4 |
| Qwen3-8B | 32 | 8 | 4 |
| Qwen3-235B-A22B | 64 | 4 | 16 |
| gpt-oss-20b, 120b | 64 | 8 | 8 |
| Gemma 3 27B | 32 | 16 | 2 |
| Falcon 40B | 128 | 8 | 16 |
비용. Llama 3.1 8B는 토큰당 128 KiB로 Llama 2 7B의 4분의 1이고, 32K 대화에 4 GiB가 듭니다. 그래도 그림에 나온 요즘 모델 가운데 가장 긴 막대입니다. 아래 설계들이 나온 이유가 이것입니다.
포기하는 것. MQA보다 적습니다. GQA 논문은 추가 학습한 GQA가 MHA에 가까운 품질을 MQA에 가까운 속도로 낸다고 보고합니다. 묶음 수는 설계하는 쪽이 고르는 값이고, 표를 보면 팀마다 꽤 다르게 골랐습니다. Gemma 3 27B는 KV 헤드 하나에 query 2개만 묶고, Qwen3-235B는 16개를 묶습니다. 다만 GQA는 다른 축은 건드리지 않습니다. 캐시는 여전히 토큰마다, 층마다, 끝없이 늘어납니다.
4. Sliding window와 local-global 혼합: 대부분의 층에서 오래된 토큰을 잊습니다
sliding window 층은 최근 W개 토큰만 봅니다. 그보다 앞은 보지 않으니 W개만 남기면 됩니다. 대화가 W보다 길어지면 이 층이 차지하는 캐시는 더 늘지 않습니다.
대신 창이 있는 층은 W보다 오래된 토큰을 직접 볼 수 없습니다. 층을 건너가며 정보가 더 멀리 전달되기는 합니다. 2층은 1층이 자기 창에서 요약한 것을 보고, 그다음 층도 같은 식입니다. 그러나 이렇게 전달하면 정보가 새기 때문에, 요즘 설계는 전체를 보는 층을 일부 남겨 둡니다.
쓰는 모델과 섞는 방식. 섞는 방식도, 그걸 나타내는 config 필드도 모델마다 다릅니다.
- Mistral 7B v0.1: 32층 모두 4,096토큰 창입니다(
sliding_window: 4096). Mistral 7B v0.3의 config는sliding_window: null이라 이 버전은 평범한 full attention입니다. 왜 뺐는지는 config에 나와 있지 않습니다. - Gemma 2: sliding 층(창 4,096)과 시퀀스 전체를 보는 global 층을 한 층씩 번갈아 둡니다(9B에서 21층과 21층).
- Gemma 3: global 층 하나마다 sliding 층 다섯 개를 두고, 창도 훨씬 작습니다. 4B와 27B는 1,024토큰, 1B는 512토큰입니다. 이 배치를 config에 직접 적은 것은 1B뿐입니다(
sliding_window_pattern: 6). 4B의 config에는 배치도 헤드 수도 없어서 transformers 기본값을 썼습니다. sliding 29층, global 5층, 256차원 KV 헤드 4개이고, llama.cpp가 4B를 읽을 때 찍는 로그도 같은 숫자를 보여 줍니다. 1B는 KV 헤드가 하나인 MQA이기도 해서, 설계 두 가지를 한꺼번에 씁니다. - gpt-oss-20b, 120b: sliding 층과 full 층을 엄격하게 반씩 번갈아 둡니다(
layer_types기준 20b는 12층과 12층, 120b는 18층과 18층). 창은 128토큰밖에 안 됩니다. - Llama 4 Scout: chunked attention이라는 변형입니다. 네 층 가운데 세 층은 8,192토큰짜리 고정 구간 안에서만 어텐션을 하고(
attention_chunk_size: 8192), 네 번째 층마다 위치 인코딩 없이 전체를 보는 global 층입니다(48층 가운데 12층). 필드 이름은 헷갈리기 쉽습니다.no_rope_layers에서 1은 그 층이 RoPE를 쓴다는 뜻이고, 0으로 적힌 12개가 global 층입니다. Meta 발표문은 이 설계를 iRoPE라고 부르고, 구간 크기와 네 층에 한 층이라는 배치는 config와 Hugging Face 출시 노트에서 확인했습니다.
비용. global 층은 여전히 토큰마다 늘고, sliding 층에는 상한이 있습니다. Gemma 3 4B라면 global 5층이 토큰당 20 KiB, sliding 29층은 창이 다 차면 116 MiB로 고정되어 32K에서 756 MiB입니다. 모든 층이 전부 남긴다면 4,352 MiB입니다. gpt-oss-20b는 771 MiB 대 1,536 MiB입니다. Mistral 7B v0.1은 길이와 상관없이 512 MiB에서 멈춥니다.
포기하는 것.
- 대부분의 층에서 먼 곳이 안 보입니다. 30,000토큰 전의 토큰을 직접 찾아볼 수 있는 것은 global 층뿐입니다. Gemma 3 기술 보고서는 local 대 global 비율을 7:1까지 올리거나 창을 1,024로 줄여도 perplexity가 거의 변하지 않았다고 보고했습니다. 저자들이 자기 평가로 잰 값입니다. perplexity는 평균이라, 아주 앞쪽에 나온 사실 하나를 여전히 꺼낼 수 있는지는 잘 말해 주지 않습니다.
- 절약은 런타임에 달렸습니다. 구조가 절약을 허락해도 그걸 실제로 챙기는 것은 런타임입니다. 배포를 다룬 글에서 Gemma 3 4B를 32K로 재 보니, llama.cpp는 계산값 756 MiB에 가까운 814 MiB를 잡았습니다. 그런데 vLLM은 기본 설정에서 요청 하나에 2,682 MiB를 예약했습니다. 창에 더해, 한 번에 처리할 수 있는 토큰 전부가 들어갈 자리를 잡아 두기 때문입니다. llama.cpp의
--swa-full을 켜면 모든 층이 모든 토큰을 남기고, 그러면 Gemma 캐시가 4,352 MiB가 됩니다. - 재사용이 어렵습니다. 요청 사이에 앞부분 캐시를 재사용하는 prefix caching은 오래된 토큰이 캐시에 남아 있다고 가정합니다. sliding 층은 그 토큰을 이미 버렸으니, 런타임이 이를 지원하려면 장부를 따로 관리하거나 캐시를 전부 남겨야 합니다.
Attention sink와 gpt-oss의 128토큰 창
Xiao 등(2023)은 모델이 시퀀스 맨 앞 몇 토큰에 내용과 상관없이 어텐션을 크게 몰아준다는 것을 발견했습니다. sliding window가 이 첫 토큰들을 밀어내면 모델 성능이 급격히 무너졌습니다. 창 옆에 첫 네 토큰의 key와 value를 계속 남겨 두자 문제가 풀렸고, 저자들은 이 토큰을 attention sink라고 불렀습니다. 평범한 창 어텐션에서는 첫 토큰 하나의 key와 value만 밀려나도 모델이 무너졌습니다.
gpt-oss는 이 아이디어를 구조에 넣었습니다. 어텐션 헤드마다 학습되는 sink가 있습니다. softmax에 붙는 편향으로, 헤드가 아무 토큰에나 어텐션을 주는 대신 "어디에도 주지 않을" 수 있게 합니다. 모델 카드는 이를 "softmax 분모에 들어가는 학습된 편향으로, off-by-one attention이나 attention sink와 비슷하다"고 설명합니다. 체크포인트를 열면 헤드마다 sinks라는 작은 가중치가 있습니다. 128토큰 창이 통하는 데 이 sink가 얼마나 기여하는지는 OpenAI가 밝히지 않았습니다. 다만 StreamingLLM 결과를 보면, 그렇게 짧은 창에는 이런 장치가 필요하리라 예상할 만합니다.
5. Multi-head latent attention(MLA): 토큰마다 작은 벡터 하나만 저장합니다
글 첫머리의 그 설계입니다. DeepSeek이 DeepSeek-V2(2024)에서 처음 내놓았습니다. 헤드마다 key와 value를 저장하는 대신, 층마다 토큰 하나에 압축 벡터 하나(잠재 벡터)만 저장합니다. 그리고 이 벡터를 모든 헤드의 key와 value로 다시 펼치는 행렬을 학습해 둡니다.
DeepSeek-V2-Lite의 잠재 벡터는 숫자 512개입니다(kv_lora_rank: 512). 위치 정보(RoPE)는 이 압축 기법을 거치면 살아남지 못하는데, 이유는 아래에서 설명합니다. 그래서 토큰마다 위치를 담는 64차원 key를 따로 하나 더 저장합니다(qk_rope_head_dim: 64). 층마다 토큰당 숫자 576개이고, 헤드가 16개든 128개든 똑같습니다.
쓰는 모델. DeepSeek-V2, V3, V3.2와 Moonshot의 Kimi K2입니다. Kimi K2의 config는 DeepseekV3ForCausalLM 구조를 선언하고 512 + 64 차원도 같지만, 헤드는 DeepSeek-V3의 128개가 아니라 64개입니다. 7절의 Kimi Linear도 full attention 층에 MLA를 씁니다. 이 모델들의 config가 공식을 헷갈리게 하는 이유도 여기 있습니다. num_key_value_heads가 V2-Lite에서는 16, V3에서는 128인데, 이 헤드들은 펼친 다음에야 생깁니다. 봐야 할 필드는 kv_lora_rank입니다.
비용.
| 모델 | 토큰당, 전체 층 | 32K 대화 | 평범한 K와 V로 저장하면 |
|---|---|---|---|
| DeepSeek-V2-Lite (27층, 헤드 16) | 30.4 KiB | 972 MiB | 8,640 MiB |
| DeepSeek-V3 (61층, 헤드 128) | 68.6 KiB | 2,196 MiB | 156,160 MiB |
"평범한 K와 V" 열은 헤드마다 key(128 + 64차원)와 value(128차원)를 따로 저장할 때의 크기입니다. 잠재 벡터는 헤드 수와 상관없이 크기가 같으니, 헤드가 많은 모델일수록 아끼는 양이 커집니다.
얻는 것. 비슷한 크기의 GQA 모델 대부분보다 캐시가 작으면서도, 펼친 뒤에는 헤드마다 자기 key를 갖습니다. DeepSeek-V2 논문은 DeepSeek 67B와 비교해 KV 캐시가 93.3% 작고 최대 생성 처리량이 5.76배라고 보고합니다. 이것은 모델 전체끼리 비교한 숫자이지, 같은 모델 안에서 MLA와 MHA를 비교한 숫자가 아닙니다. 부록의 ablation에서는 더 작은 MoE 모델로 MLA가 MHA보다 성능이 좋았다고 보고합니다. 모두 저자들의 숫자입니다.
포기하는 것.
- 계산이 디코딩 쪽으로 옮겨 갑니다. 단계마다 잠재 벡터를 key로 펼치면 비쌉니다. 그래서 펼치는 행렬을 query 투영에 미리 합쳐 두고, query를 잠재 벡터와 바로 비교하는 기법을 씁니다. 논문도 추론할 때 key와 value를 펼치는 행렬을 query 투영과 출력 투영에 흡수할 수 있다고 적었습니다. RoPE에 key를 따로 두는 이유도 이것입니다. 회전은 위치마다 달라서 고정된 행렬에 합칠 수 없습니다. 결과적으로 MLA 디코딩은 GQA보다 읽는 바이트당 연산이 많습니다. 연산 여유가 있는 GPU에는 잘 맞지만 전용 커널이 필요합니다.
- 런타임 지원. MLA에는 전용 어텐션 커널이 있어야 합니다. llama.cpp, vLLM, SGLang에는 이제 있지만, 작은 런타임이나 일부 양자화 캐시 경로에는 없을 수 있습니다.
- 기존 모델을 바꾸려면 학습이 필요합니다. GQA 모델을 config만 고쳐 MLA로 바꿀 수는 없습니다.
6. Sparse attention: 토큰은 모두 남기고 일부만 읽습니다
sparse attention이 줄이는 것은 메모리가 아니라 대역폭입니다. 토큰마다 캐시 항목은 메모리에 그대로 남고, 새 토큰은 그 가운데 골라낸 일부만 읽습니다.
쓰는 모델. DeepSeek-V3.2-Exp가 MLA 위에 DeepSeek Sparse Attention(DSA)을 얹었습니다. lightning indexer라는 작고 값싼 채점기(config 기준 128차원 헤드 64개)가 새 토큰마다 앞선 토큰 전부에 점수를 매기고, 어텐션은 상위 2,048개에만 합니다(index_topk: 2048). 기술 보고서는 핵심 어텐션이 O(L²)에서 O(L·k)로 줄어든다고 설명합니다. indexer 자체는 여전히 O(L²)이지만 MLA보다 훨씬 쌉니다. DeepSeek이 그보다 먼저 낸 Native Sparse Attention(NSA, 2025)은 압축 블록, 선택 블록, 로컬 창 세 갈래를 게이트로 합쳤고 ACL 2025 최우수 논문상을 받았습니다.
비용. 메모리는 줄지 않고 오히려 조금 늘어납니다. MLA 캐시를 전부 남기고, indexer용 key를 토큰마다 하나 더 저장하기 때문입니다. 보고서는 메모리에 대해 아무 주장도 하지 않습니다. 캐시가 전부 남는다는 것은 indexer가 앞선 토큰 전부에 점수를 매긴다는 수식을 보고 저희가 읽어 낸 것입니다. 줄어드는 것은 긴 맥락에서 토큰 하나당 어텐션 작업량입니다. 앞선 토큰 전부를 보던 것이 2,048개만 보고, 전체에는 값싼 indexer만 한 번 지나갑니다.
포기하는 것. 어떤 토큰이 중요한지 모델이 배워야 하고, indexer가 건너뛴 토큰은 그 단계에서 보이지 않습니다. 전용 커널도 필요하고, 주요 서빙 엔진 밖에서는 지원이 드뭅니다. 캐시를 줄이지 않으니 메모리 문제의 답은 아닙니다. 긴 입력에서 속도를 위한 답입니다.
7. 선형 어텐션과 상태 공간 혼합 구조: 대부분의 층이 토큰을 남기지 않습니다
선형 어텐션은 토큰마다 쌓이는 캐시를 아예 없앱니다. key와 value를 전부 남기는 대신, 크기가 정해진 행렬 하나(상태)를 두고 새 토큰이 올 때마다 거기에 접어 넣습니다. 상태를 읽는 비용은 100번째 토큰에서나 100,000번째 토큰에서나 같습니다. Katharopoulos 등(2020)은 이 형태라면 트랜스포머 층을 순환 신경망처럼 돌려 추론 메모리를 일정하게 유지할 수 있다는 것을 보였습니다. Mamba(Gu와 Dao, 2023)는 상태 공간 모델에서 출발해 비슷한 결과에 이르렀습니다. 요즘 실제 모델에 들어간 층인 Gated DeltaNet(Yang 등, ICLR 2025)과 Moonshot의 Kimi Delta Attention은 여기에 두 가지를 더했습니다. 상태가 얼마나 빨리 잊을지 정하는 게이트와, 새 연관을 위에 쌓는 대신 옛 연관을 덮어쓰는 delta 규칙입니다. Kimi 쪽은 Gated DeltaNet의 게이트를 더 잘게 나눈 확장판입니다.
대가는 크기가 정해진 상태에 모든 것을 담을 수는 없다는 점입니다. 긴 문단을 글자 그대로 옮겨 적거나, 긴 목록에서 전화번호 하나를 찾아내려면 바로 그 세부를 정확히 압축해 두었어야 합니다. 복사와 연관 기억을 다룬 연구들은 순수 선형 모델과 상태 공간 모델이 이런 과제에서 어텐션보다 약하다고 봅니다. Jelassi 등(2024)은 맥락에서 복사하고 찾아오는 과제에서 트랜스포머가 상태 공간 모델을 크게 앞선다는 것을 보였고, Zoology 연구(Arora 등, 2023)는 게이트 합성곱 모델과 어텐션 사이 perplexity 차이의 82%가 맥락 앞쪽에 나온 것을 다시 떠올리는 데서 생긴다고 분석했습니다. 그래서 실제 모델은 순수 선형으로 가지 않고, 정확한 조회를 맡을 full attention 층을 몇 개 남겨 둡니다.
쓰는 모델과 섞는 방식. 아래 모델은 모두 full attention을 일부 남깁니다.
| 모델 | 선형 층 | full attention 층 | full attention 종류 |
|---|---|---|---|
| Qwen3.5-9B | Gated DeltaNet 24 | 8 | GQA, KV 헤드 4 |
| Qwen3-Next-80B-A3B, Qwen3.6-35B-A3B | Gated DeltaNet 36, 30 | 12, 10 | GQA, KV 헤드 2 |
| Kimi Linear 48B-A3B | Kimi Delta Attention 20 | 7 | MLA |
| MiniMax-Text-01 | lightning attention 70 | 10 | GQA, KV 헤드 8 |
| Jamba Reasoning 3B | Mamba 26 | 2 | MQA |
비율은 config에서 바로 읽었습니다. Qwen은 layer_types 또는 full_attention_interval: 4(네 층에 full 한 층), Kimi는 linear_attn_config, MiniMax는 attn_type_list(0이 lightning, 1이 softmax이고 softmax 층은 여덟 번째 자리마다 있음), Jamba는 attn_layer_period: 14와 attn_layer_offset: 7(28층 가운데 어텐션 2층)입니다.
비용. 캐시는 full 층에서만 늘어납니다. Qwen3.5-9B의 full 8층은 토큰당 32 KiB, 32K에 1,024 MiB이고, 선형 24층의 상태는 전혀 늘지 않습니다. 이 부분은 llama.cpp에서 직접 쟀습니다. 512토큰, 4K, 32K, 128K 모두 상태가 50.25 MiB였습니다. MLA 층이 7개인 Kimi Linear는 32K 캐시 252 MiB에 상태 약 43 MiB입니다(계산값이고 재지 않았습니다).
얻는 것. 대부분의 층에서 메모리와 디코딩 속도가 길이에 거의 영향을 받지 않습니다. Qwen 팀은 Qwen3-Next가 32K 토큰이 넘는 맥락에서 Qwen3-32B보다 처리량이 열 배 넘게 높다고 밝혔습니다. Moonshot은 Kimi Linear가 같은 방식으로 학습한 full MLA 모델과 비교해 1M 토큰에서 KV 캐시를 최대 75% 줄이고 디코딩이 최대 여섯 배 빠르다고 보고합니다. 모두 각 회사가 자기 환경에서 잰 숫자입니다.
포기하는 것.
- 정확한 기억은 몇 안 되는 층이 맡습니다. 선형 층과 full 층의 비율로 메모리와 기억력 사이의 균형을 정하는데, 회사마다 다르게 정했습니다. Qwen과 Kimi는 full 한 층에 선형 세 층(Kimi는 27층이라 20층과 7층), MiniMax는 여덟 층에 한 층, Jamba Reasoning 3B는 열네 층에 한 층입니다.
- 캐시를 전제로 만든 기능이 어려워집니다. prefix caching, speculative decoding에서 거절된 추측 토큰 되돌리기, 대화 분기는 모두 캐시를 아무 토큰에서나 자를 수 있다고 가정합니다. 상태는 자를 수 없으니, 필요한 시점마다 통째로 저장해 둬야 합니다. 저희 vLLM 측정에서 Qwen3.5-9B의 요청당 고정 메모리는 prefix caching을 켜자 3블록에서 6블록으로 두 배가 됐습니다. 이때 vLLM 로그에는 상태 캐시를 "align" 모드로 바꾼다고 찍혔습니다. 이 모드에 왜 블록이 더 필요한지는 소스에서 확인하지 못했습니다.
- 런타임 지원이 아직 새롭습니다. Gated DeltaNet 계열은 prefill과 디코딩 모두 전용 커널이 필요합니다. 주요 엔진은 인기 모델용 커널을 갖췄지만, 포팅판이나 양자화 경로는 늦습니다.
일곱 가지를 한눈에
| 설계 | 층마다 토큰당 저장하는 것 | 쓰는 모델(config 확인) | 주로 얻는 것 | 주로 치르는 것 |
|---|---|---|---|---|
| MHA | 헤드마다 K와 V | Llama 2 7B, Gemma 7B | 표현력이 가장 높고 어디서나 지원 | 캐시가 가장 큼 |
| MQA | 공유 K와 V 하나 | Falcon 7B, PaLM, Gemma 3 1B(sliding도 씀) | 헤드를 나눠 쓰는 설계 가운데 토큰당 캐시가 가장 작음 | 품질 저하와 학습 불안정 보고, GPU 사이에 헤드를 나눌 수 없음 |
| GQA | 묶음마다 K와 V 하나 | Llama 3.x, Mistral, Qwen3, gpt-oss, Gemma 3 4B와 27B | MHA에 가까운 품질을 훨씬 작은 캐시로 | 여전히 모든 층에서 토큰마다 늘어남 |
| sliding / local-global | 대부분의 층에서 최근 W개 토큰의 K와 V만 | Mistral 7B v0.1, Gemma 2/3, gpt-oss, Llama 4(chunked) | 대부분의 층이 더 늘지 않음 | 직접 볼 수 있는 범위가 좁음, 절약은 런타임에 달림 |
| MLA | 잠재 벡터(512) + RoPE key(64) | DeepSeek V2/V3/V3.2, Kimi K2 | 작은 캐시로 헤드별 어텐션 유지 | 디코딩 단계마다 계산이 늘고 전용 커널 필요 |
| sparse | 전부(indexer key 추가) | DeepSeek V3.2-Exp | 긴 맥락에서 어텐션 작업량 감소 | 메모리 절약 없음, 전용 커널 |
| 선형 혼합 | 선형 층은 없음(고정 상태), 몇 안 되는 full 층에 K와 V | Qwen3.5/3.6/Next, Kimi Linear, MiniMax-01, Jamba | 캐시와 속도가 길이에 거의 무관 | 선형 층의 정확한 기억이 약함, prefix caching과 되돌리기에 상태 저장 필요 |
이 설계들은 겹쳐 쓸 수 있습니다. gpt-oss는 GQA이면서 sliding window입니다. Kimi Linear는 선형 어텐션에 full 층은 MLA입니다. DeepSeek-V3.2는 MLA에 sparse 읽기를 더했습니다. 새 모델 카드를 읽을 때 "어느 방식을 쓰는가"보다 "층마다 다섯 가지 가운데 무엇을 줄였는가"를 물으면 더 많은 것이 보입니다.
확인하지 않은 것
- 품질과 속도 숫자는 저자들의 것입니다. 이 글을 위해 어떤 모델의 정확도, 기억력, 디코딩 속도도 재지 않았습니다. 논문이나 회사가 보고한 품질·처리량 숫자는 누구의 숫자인지 밝혔습니다.
- 메모리 숫자는 config.json으로 32K, 16비트 기준으로 계산했습니다. 런타임은 저마다 예약분을 더합니다. 이 가운데 여섯 모델은 llama.cpp와 vLLM에서 실제 할당량을 쟀고, 곳에 따라 차이가 컸습니다. 그 결과는 실측 글에 있습니다. Kimi Linear의 상태 크기는 계산만 했고, Qwen3.5-9B의 상태는 쟀습니다.
- 모델 목록은 전부가 아닙니다. config를 읽을 수 있고(셋은 앞서 말한 Unsloth 사본) 각 설계를 분명히 보여 주는 모델을 골랐습니다. 층 사이 KV 공유, KV 캐시 양자화, 여러 토큰을 묶는 잠재 설계 같은 다른 변형은 다루지 않았습니다.
다음 글
연재의 나머지 글은 여기서부터 실제 GPU 쪽으로 갑니다.
- 어텐션 일곱 가지를 PyTorch 코드로: 위의 설계를 하나씩 짧은 함수로 쓰고, 이 글에서 말한 대로 동작하는지 검사합니다. MLA의 가중치 흡수는 DeepSeek-V2-Lite의 실제 가중치로 확인했습니다.
- 모델 여섯 개가 KV 캐시를 담는 방식, 실측: 설계마다 한두 모델을 골라 llama.cpp와 vLLM이 4K, 32K, 128K에서 실제로 얼마를 잡는지 쟀습니다.
- llama.cpp와 vLLM으로 배포할 때 달라지는 것: 같은 모델, 같은 길이인데 한쪽 런타임에서 메모리가 세 배 든 이유와, 그 크기를 바꾸는 설정을 다룹니다.