어텐션 28가지를 GIF와 짧은 함수로 정리했습니다: Bahdanau부터 Latent Sparse Attention까지
Additive attention, MHA, GQA, MLA, sink, BigBird, DSA, MoBA, Reformer, ClusterKV, LSA, Gated DeltaNet 등을 무엇을 바꾸는지에 따라 묶었습니다. 항목마다 GIF와 PyTorch 함수, 그리고 무엇이 나아졌고 왜 그렇고 무엇을 내주는지를 논문 수치로 적었습니다. 함수는 CPU에서 확인한 설명용 코드이며, 학습과 속도 측정은 하지 않았습니다.
어텐션 28가지를 GIF와 짧은 함수로 정리했습니다
"프랑스의 수도는" 다음에 올 단어를 고르려면 언어 모델은 앞 토큰들을 돌아보고 어느 토큰이 얼마나 중요한지 정해야 합니다. 이렇게 돌아보는 동작이 어텐션입니다. 2014년 이후 여러 번 다시 설계됐는데, 이 글의 설계들은 각각 네 군데 중 하나를 바꿉니다. 토큰 쌍에 점수를 매기는 방법, 메모리에 남기는 것, 읽을 토큰을 고르는 방법, 그리고 앞 토큰 목록을 아예 없앨 수 있는지입니다.
이 글은 그 순서대로 28가지를 봅니다. 항목마다 GIF 하나, 짧은 설명, 나아진 점과 이유와 대가를 적은 세 줄, PyTorch 핵심 함수가 있어서 앞 항목에서 무엇이 달라졌는지 바로 비교할 수 있습니다.
먼저 단어 세 개만 알면 됩니다. query는 지금 토큰이 찾는 것이고, key는 앞 토큰이 맞춰 보라고 내놓는 것이며, value는 맞았을 때 그 토큰이 건네주는 내용입니다. 저장해 둔 key와 value 목록을 KV 캐시라고 부르는데, 여기 나오는 설계 상당수가 이 캐시를 줄이려는 시도입니다.
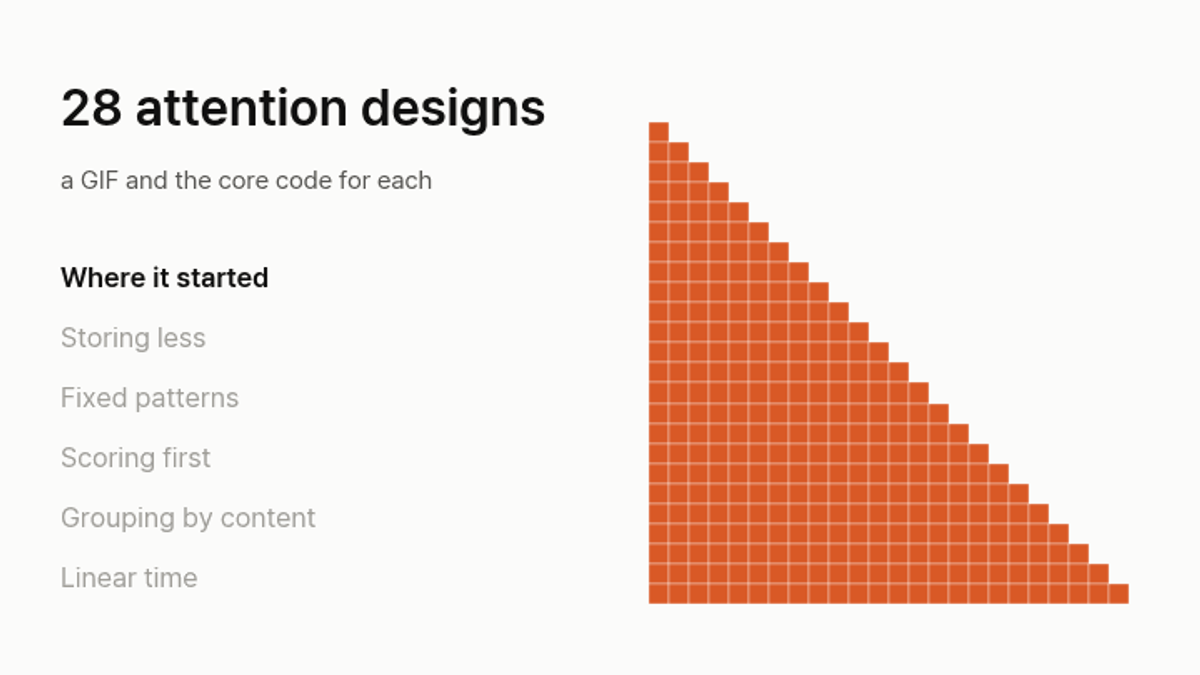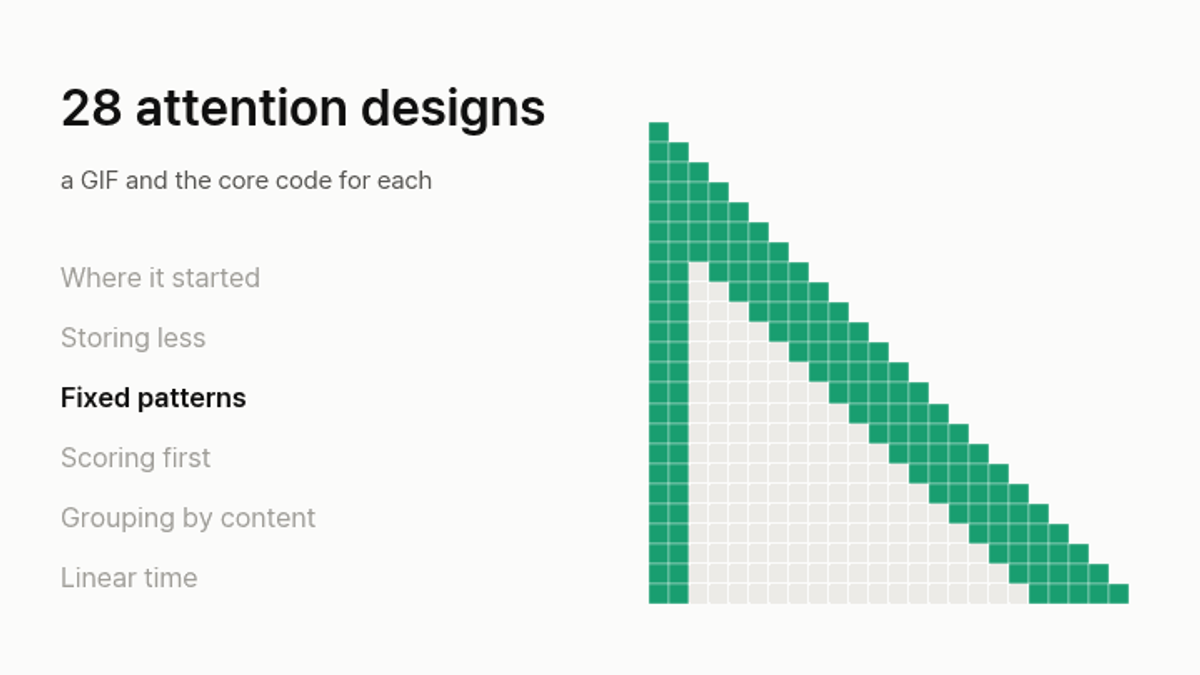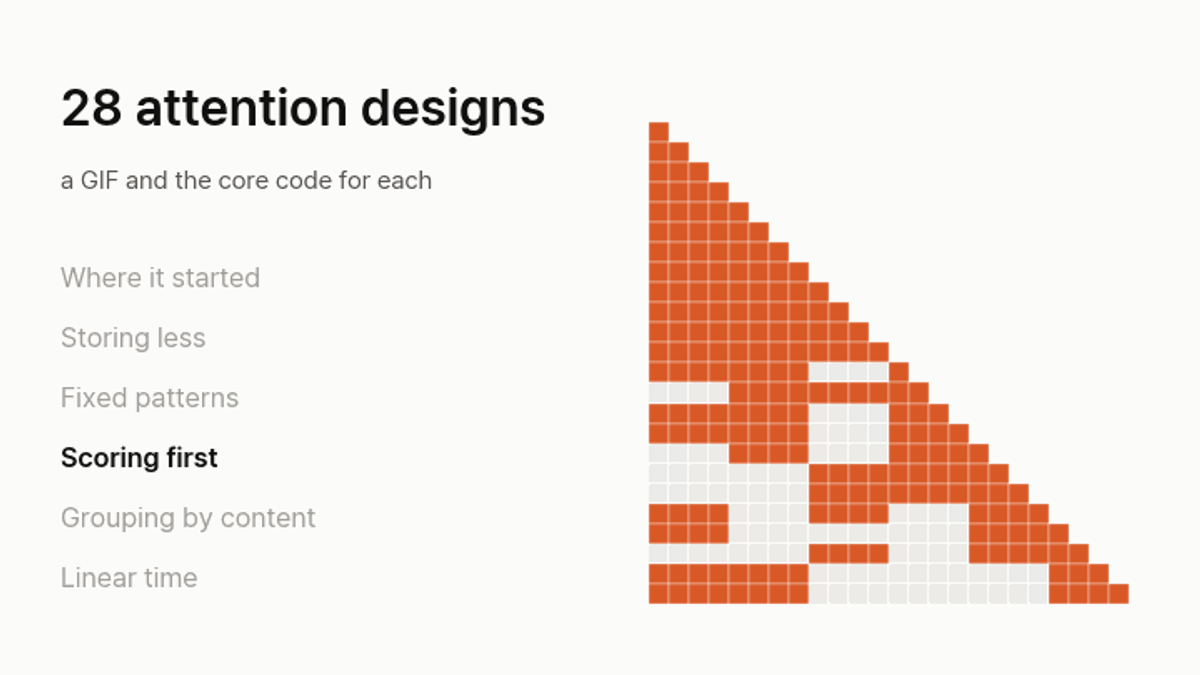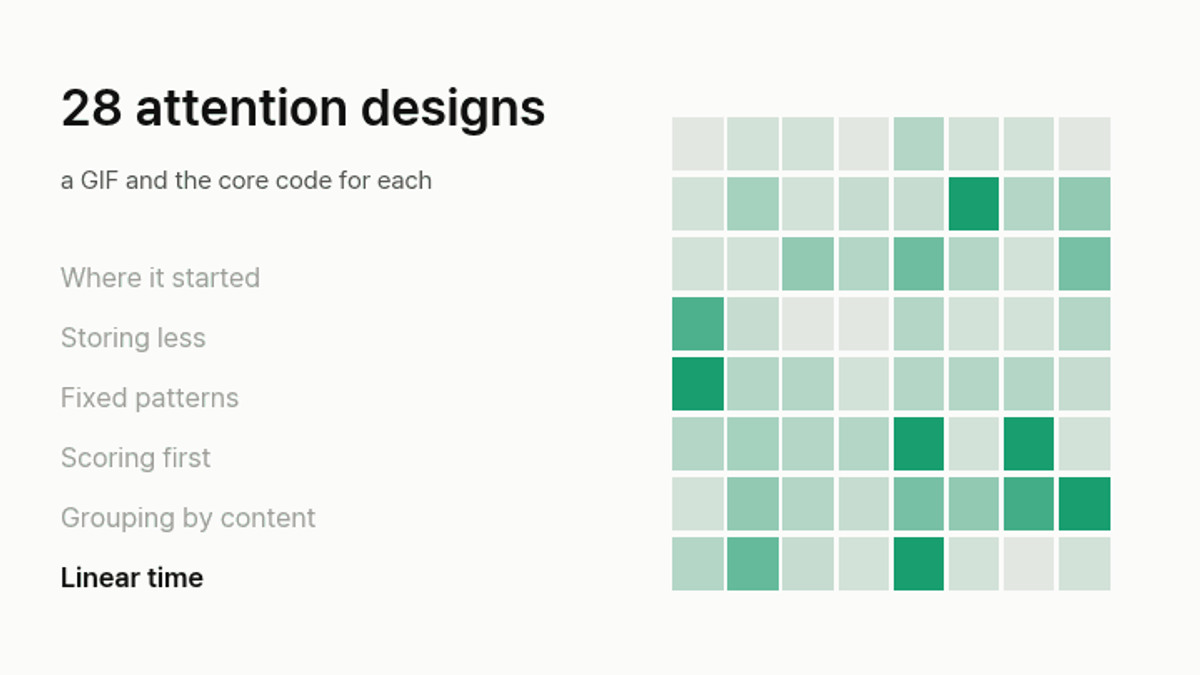
GIF는 대부분 같은 격자를 씁니다. 행은 query, 열은 key이고 시간은 아래로 흐르므로, 한 행을 보면 토큰 하나가 어떤 key를 읽는지 알 수 있습니다. 주황색은 읽는 칸, 초록색은 항상 읽는 칸, 연한 파란색은 점수만 매기고 읽지 않는 칸, 회색은 건너뛰는 칸입니다. 입력이 무작위이므로 동작 원리를 보여 줄 뿐 측정값은 아닙니다. GIF는 대부분 글에 실린 함수나 같은 식으로 계산했고, 정렬표, 저장량, cross-attention, Linformer, ClusterKV, LSA GIF는 개념도입니다.
코드의 성격. 요청 하나를 처리하는 설명용 코드이며 배치와 속도 최적화는 넣지 않았습니다. 저희가 CPU에서 글 끝에 적은 검사를 돌렸습니다. 텐서 크기, 미래를 읽으면 안 되는 설계가 미래를 읽지 않는지, 단순한 설계와 같아져야 하는 극한값을 봤습니다. 논문이 있는 항목은 논문과 함수를 대조했고, 뺀 내용은 항목마다 적었습니다. 학습은 하지 않았고 속도와 정확도도 재지 않았습니다. 따로 밝히지 않은 숫자는 모두 해당 논문이 보고한 값입니다.
숫자 읽는 법. 숫자마다 그 논문의 기준선, 데이터, 하드웨어가 다릅니다. 그래서 옆에 적힌 기준선과만 비교할 수 있고, 다른 항목의 숫자와는 비교할 수 없습니다. 논문에 숫자나 대가가 없으면 없다고 적었습니다. 이유 항목은 각 설계의 동작을 저희 말로 풀어 쓴 것이라 논문이 직접 밝힌 이유와 다를 수 있습니다. 저희 설명을 더한 곳은 저희 해석이라고 표시했습니다.
목록의 범위. 텍스트 모델용 설계 가운데 이름 붙은 논문이 있거나, 저희가 확인한 모델에 실제로 들어간 것을 골랐습니다. 비전 전용 어텐션과, 같은 결과를 더 빨리 계산할 뿐인 FlashAttention 같은 구현 기법은 뺐습니다. 그러니 간추린 목록이며, 지금까지 나온 어텐션 전부는 아닙니다.
출발점: 토큰 쌍에 점수를 매기는 방법
1. Additive attention (Bahdanau, 2014)
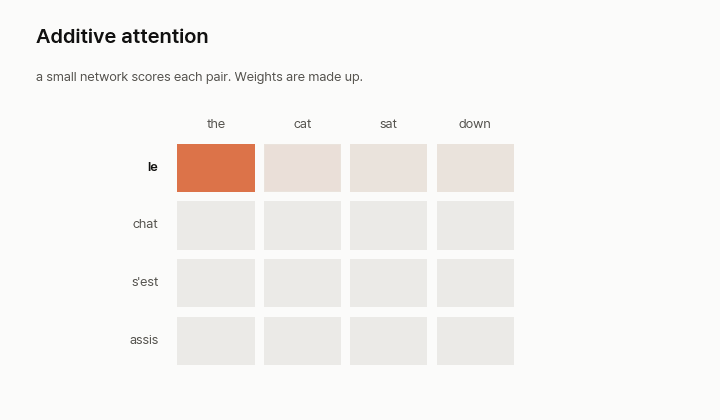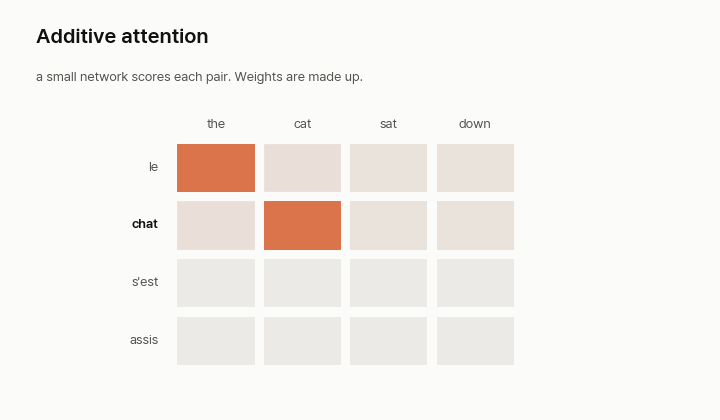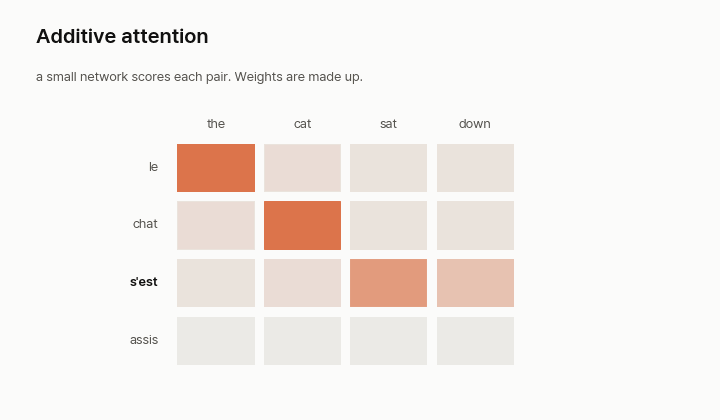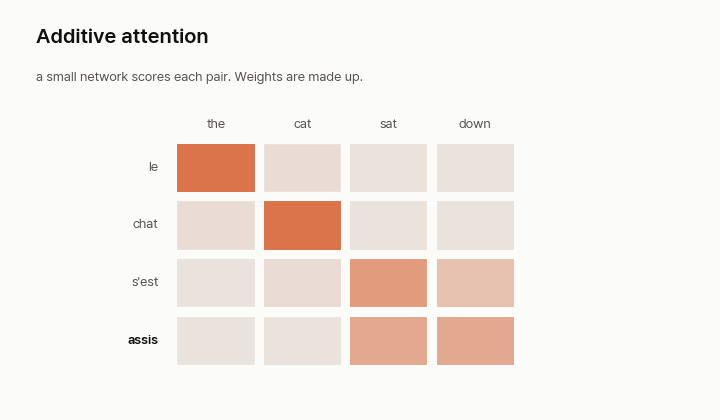
예전 번역 모델은 원문 전체를 벡터 하나에 눌러 담았습니다. Bahdanau 등은 디코더가 원문 단어를 전부 돌아보게 하고, 어느 단어를 볼지 번역과 함께 학습하게 했습니다. 점수는 작은 신경망이 매깁니다. 코드의 s는 디코더의 직전 상태이고, h는 양방향 인코더의 상태입니다.
- 나아진 점. 긴 문장에서 번역이 무너지지 않게 됐습니다. 영어-프랑스어 번역에서 BLEU(번역 점수, 높을수록 좋음)가 26.75로, 벡터 하나에 담는 모델의 17.82보다 높았습니다. 둘 다 50단어까지의 문장으로 학습했고, 50단어가 넘는 문장에서도 점수가 떨어지지 않았습니다.
- 이유. 디코더가 문장 전체를 벡터 하나에 담지 않아도 되니, 긴 문장의 앞부분을 매 단계 다시 볼 수 있습니다.
- 대가. 번역 단어 하나마다 원문 단어 전부에 가중치를 계산합니다. 논문은 15-40단어 문장에서는 큰 문제가 아니지만 다른 과제에서는 제약이 될 수 있다고 적었고, 시간 측정값은 없습니다.
def additive(s, h, W1, W2, v):
    """s: decoder state [d], h: encoder states [T, d]. Bahdanau: a small network scores each pair."""
    scores = v(torch.tanh(W1(s) + W2(h))).squeeze(-1)
    a = scores.softmax(-1)
    return a @ h, a
2. Multiplicative attention (Luong, 2015)
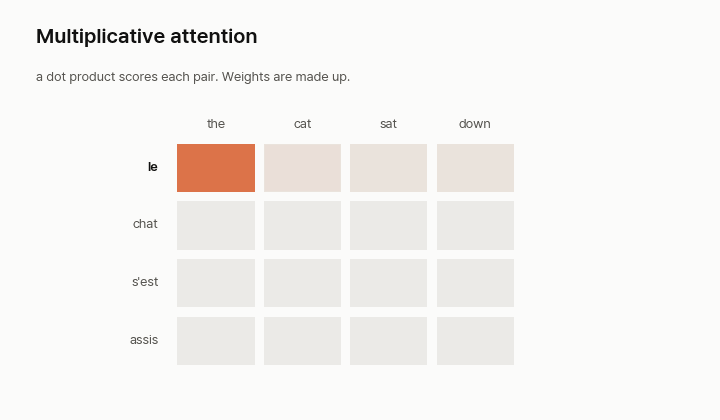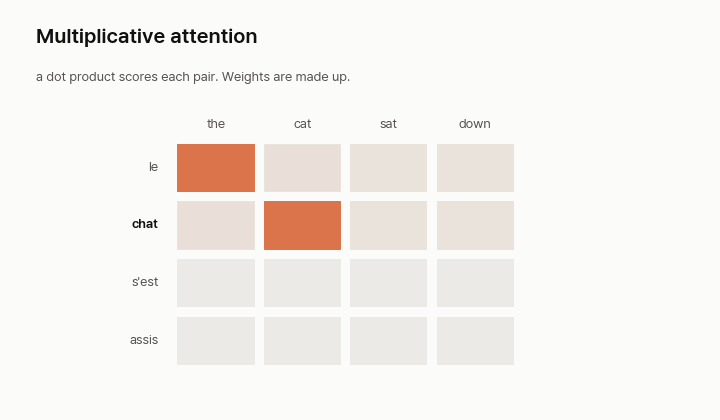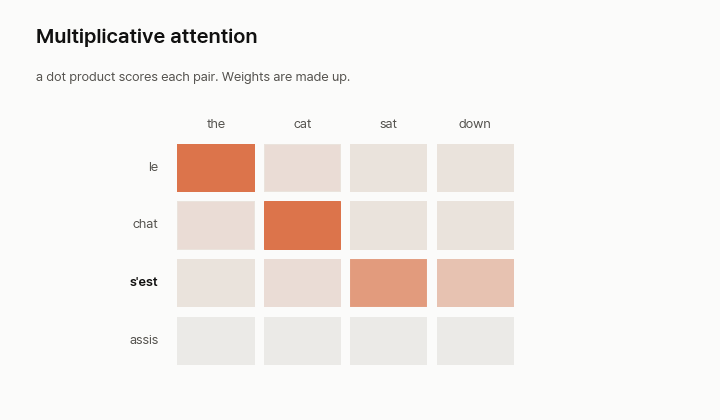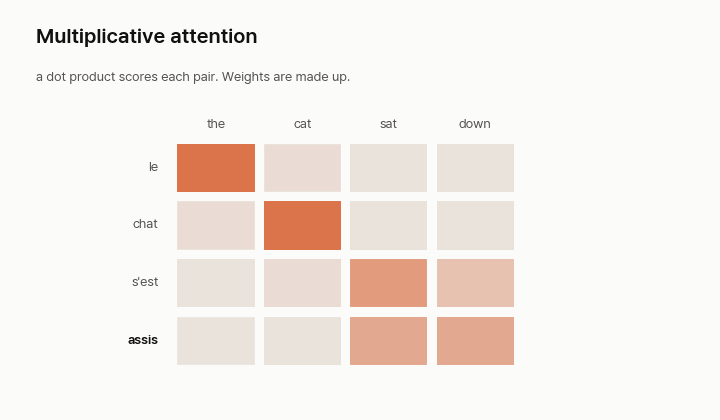
Luong 등은 작은 신경망 대신 내적을 쓰거나, 내적 사이에 학습 행렬을 하나 끼웠습니다(논문의 general 형태). 더 단순하고, Bahdanau가 디코더의 직전 상태를 쓴 자리에 현재 상태를 씁니다.
- 나아진 점. 점수 계산이 단순해졌는데 성능은 떨어지지 않았습니다. 영어-독일어 번역에서 global dot은 BLEU 18.6으로, 논문의 위치 기반 기준선 18.1보다 높았습니다(미등록 단어 치환 시 20.5와 19.3). 가장 좋은 local 모델은 19.0(20.9)이었습니다.
- 이유. 저희 해석으로는, 내적은 토큰 쌍마다 신경망을 따로 돌리지 않고 유사도를 바로 잽니다. 논문 자체에는 속도 비교가 없습니다.
- 대가. 어느 형태든 항상 이기지는 않습니다. global general은 17.3(19.1)이었고, local-m과 dot 조합은 perplexity가 7.0을 넘어 학습에 실패했습니다. perplexity는 모델이 다음 단어에 얼마나 놀라는지를 나타내므로 낮을수록 좋습니다.
def luong(s, h, W=None):
    """Luong: score with a dot product, or with one matrix in between ("general"). s is the current state."""
    scores = h @ (s if W is None else W.T @ s)
    a = scores.softmax(-1)
    return a @ h, a
3. Scaled dot-product attention (Vaswani, 2017)
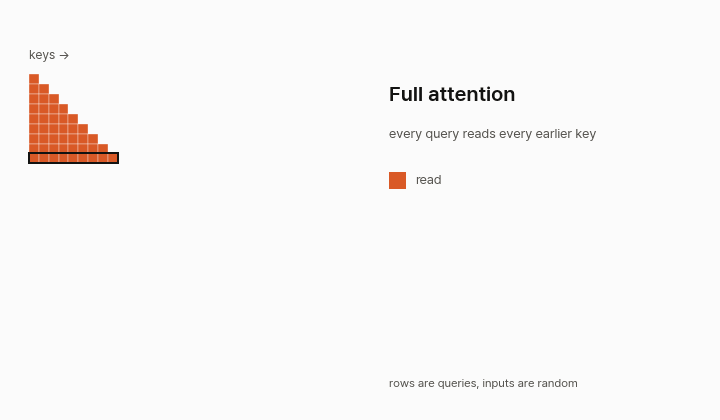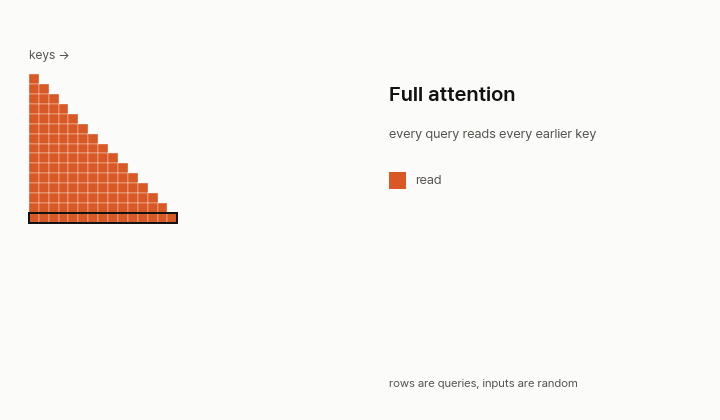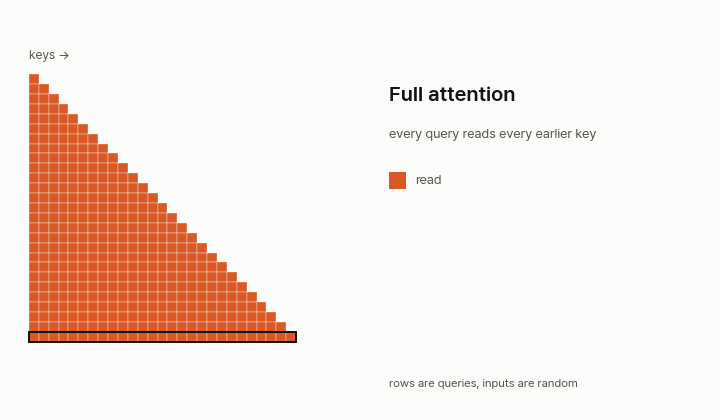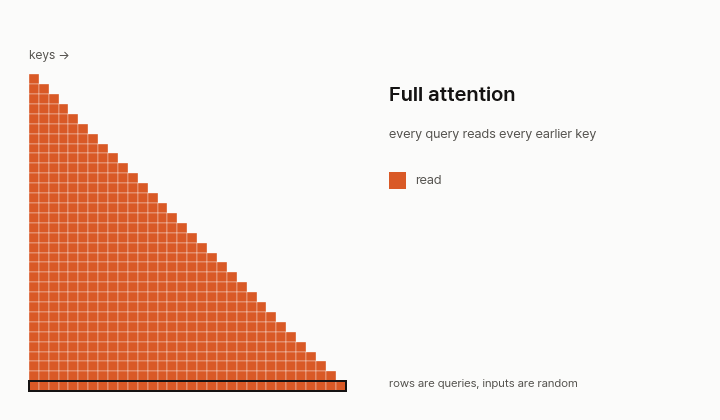
Attention Is All You Need는 query, key, value를 각각 다른 projection으로 만들고 점수를 차원의 제곱근으로 나눕니다(식 1). 아래 항목 대부분이 이 함수를 그대로 다시 씁니다. 선택 인자 read는 query마다 볼 수 있는 key를 정하는 마스크로, 희소 설계들은 이 인자로 동작합니다. GIF의 꽉 찬 삼각형이 full attention이고, 나머지 설계와 비교하는 기준입니다.
- 나아진 점. 차원이 커도 내적 점수를 쓸 수 있게 됐습니다. 나누지 않은 내적은 차원이 크면 additive attention에 뒤처졌습니다. 나눗셈만의 효과를 잰 숫자는 논문에 없고, BLEU 28.4는 모델 전체의 값입니다.
- 이유. 논문은 내적 값이 커지면 softmax가 기울기가 아주 작은 구간으로 밀린다고 추정하며, 나눗셈이 이를 막아 줍니다. 점수 계산은 그대로 행렬 곱이라 실제로 빠릅니다.
- 대가. 나눗셈 자체의 대가는 논문에 없습니다. 다만 query가 앞의 key 전부와 비교하는 구조는 그대로라, 레이어의 계산량은 길이의 제곱으로 늘어납니다.
def attend(q, k, v, read=None):
    """q [..., Q, d], k and v [..., T, d]. read is an optional boolean mask [Q, T]."""
    scores = q @ k.transpose(-1, -2) / math.sqrt(k.shape[-1])
    if read is not None:
        scores = scores.masked_fill(~read, float("-inf"))
    return scores.softmax(-1) @ v
4. Multi-head attention (Vaswani, 2017)
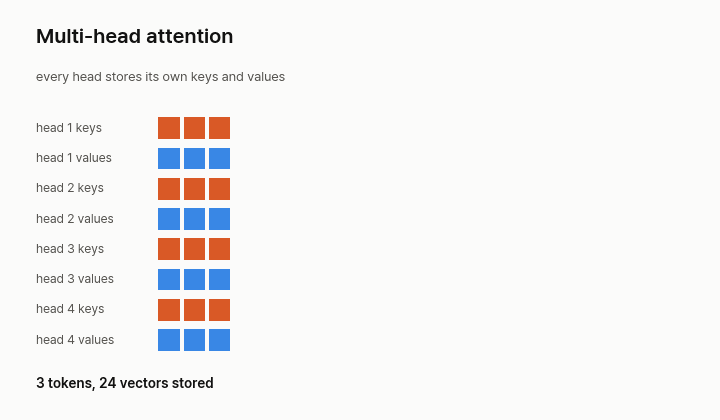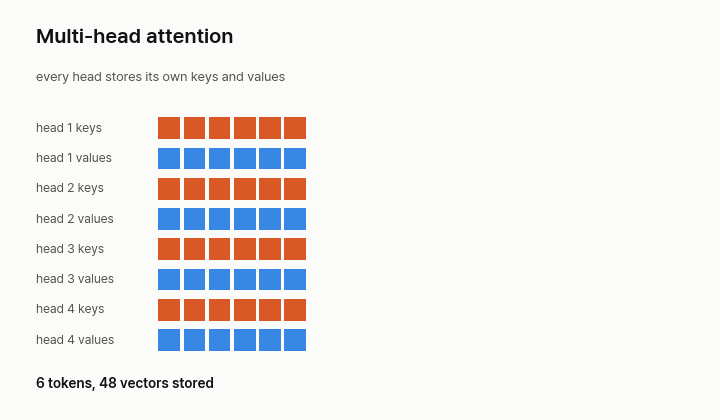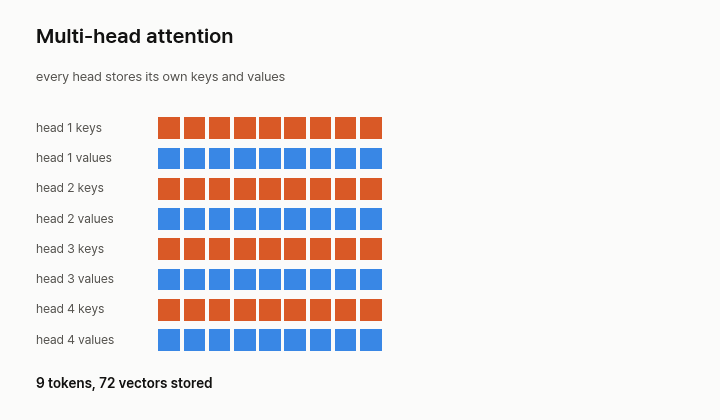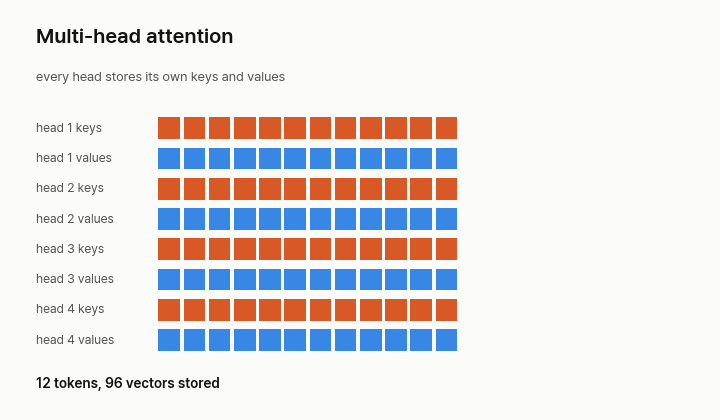
같은 논문은 벡터를 여러 헤드로 나눠 따로 어텐션한 뒤 결과를 합칩니다. 헤드마다 key와 value를 따로 저장하므로 KV 캐시가 빠르게 커집니다. 저희가 현재 모델을 정리한 글에서는 Llama 2 7B(query 헤드 32개, KV 헤드 32개)와 Gemma 7B(16개와 16개)가 이 기본 형태입니다.
- 나아진 점. 모델이 서로 다른 종류의 정보를 동시에 볼 수 있습니다. 이것만 따로 잰 숫자는 논문에 없습니다.
- 이유. 논문은 헤드가 하나면 평균을 내는 과정에서 이런 동작이 막힌다고 설명합니다. 64차원 헤드 8개가 각자 다른 projection으로 보고, 헤드가 작으니 전체 계산량은 큰 헤드 하나와 비슷합니다.
- 대가. 토큰마다 모든 key와 value를 저장합니다. 논문은 메모리 비용을 따로 말하지 않지만, 나중에 DeepSeek-V2는 KV 캐시를 배포의 큰 병목으로 꼽았습니다.
def mha(x, Wq, Wk, Wv, Wo, heads, read=None):
    """Every head keeps its own keys and values."""
    T, d = x.shape
    split = lambda t: t.view(T, heads, d // heads).transpose(0, 1)   # [heads, T, d/heads]
    out = attend(split(Wq(x)), split(Wk(x)), split(Wv(x)), read)
    return Wo(out.transpose(0, 1).reshape(T, d))
5. Cross-attention (Vaswani, 2017)
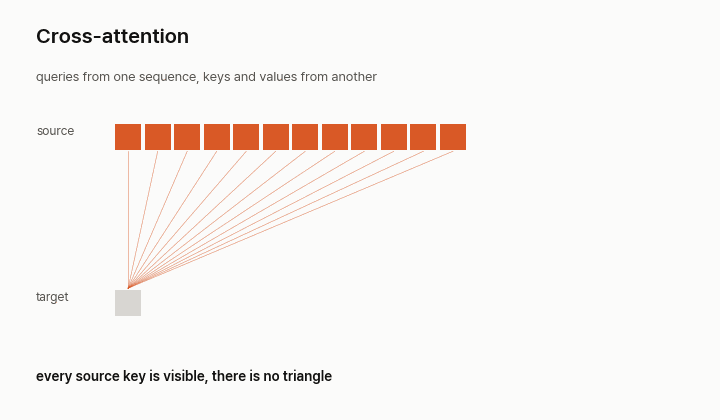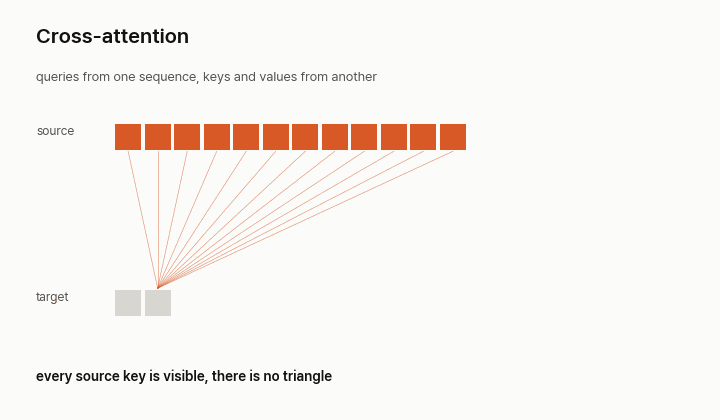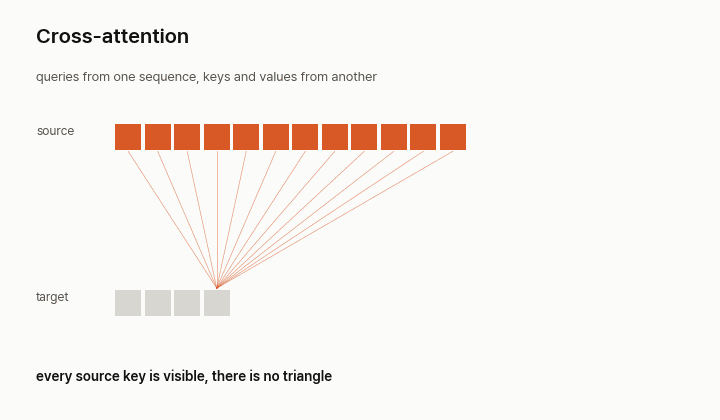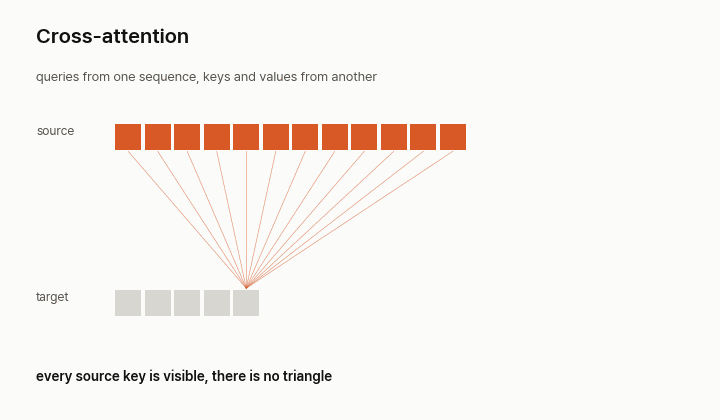
query는 한 시퀀스에서, key와 value는 다른 시퀀스에서 가져옵니다. 논문은 인코더와 디코더 사이에 이 방식을 씁니다. 원문 토큰은 이미 다 있으므로 삼각형 제한이 없습니다. 함수는 같은 attend이고 입력만 다릅니다.
- 나아진 점. 번역에서 쓰던 어텐션을 순환 신경망 없이 디코더에서 쓸 수 있게 됐습니다. 이것만 잰 숫자는 논문에 없습니다.
- 이유. query는 디코더에서, key와 value는 인코더에서 가져오므로 같은 함수가 두 시퀀스 사이에서 그대로 동작합니다.
- 대가. 저희 계산으로는, 디코더 위치마다 입력 위치 전부를 읽으므로 계산량이 두 길이의 곱으로 늘어납니다. 디코딩하는 동안 인코더 출력도 메모리에 남습니다.
def cross(x_dec, x_enc, Wq, Wk, Wv):
    """Queries from one sequence, keys and values from another. No triangle: every source token is visible."""
    return attend(Wq(x_dec), Wk(x_enc), Wv(x_enc))
덜 저장하기: key는 여전히 전부 읽습니다
이 세 가지는 메모리 비용을 바꾸고, 읽는 패턴은 그대로 둡니다.
6. Multi-query attention (Shazeer, 2019)
Shazeer는 query 헤드는 여럿 두고 key와 value는 모든 헤드가 함께 쓰게 했습니다. 토큰마다 key 하나, value 하나만 저장하면 됩니다. 정리 글에서 확인한 config 기준으로 Falcon 7B와 Gemma 3 1B가 이 방식입니다.
- 나아진 점. 디코딩이 크게 빨라졌습니다. 토큰당 디코더 시간이 46µs에서 3.8µs로, 폭 4 beam search는 203µs에서 32µs로 줄었습니다(TPUv2 기준, WMT14 영어-독일어, 길이 128).
- 이유. 논문은 매 단계 key와 value를 메모리에서 다시 읽는 일이 디코딩의 어려운 부분이라고 봅니다. 함께 쓰면 그 양이 헤드 수만큼 줄어듭니다.
- 대가. 표현력을 내줍니다. 논문은 파라미터 수를 맞추려고 feed-forward 층을 4096에서 5440으로 넓혔고, BLEU는 비슷했습니다(greedy와 beam 기준 27.5, 28.5와 27.7, 28.4). 더 큰 모델에서는 결과가 다릅니다. DeepSeek-V2의 7B dense 비교에서 MMLU 정확도는 MQA 37.9, GQA 41.2, MHA 45.2입니다.
def mqa(x, Wq, Wk, Wv, Wo, heads):
    """Heads differ only in the query. One key and one value per token are stored."""
    T, d = x.shape
    q = Wq(x).view(T, heads, d // heads).transpose(0, 1)
    k, v = Wk(x)[None], Wv(x)[None]                                  # [1, T, d/heads], shared by broadcast
    return Wo(attend(q, k, v).transpose(0, 1).reshape(T, d))
7. Grouped-query attention (Ainslie, 2023)
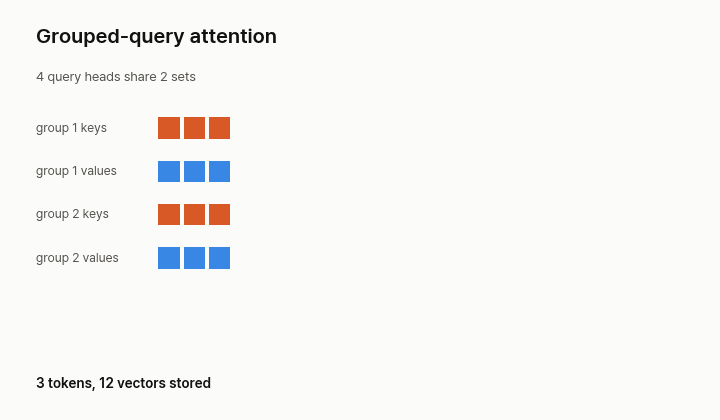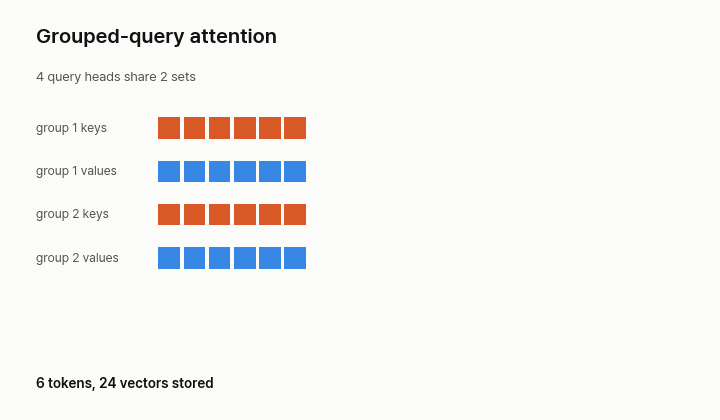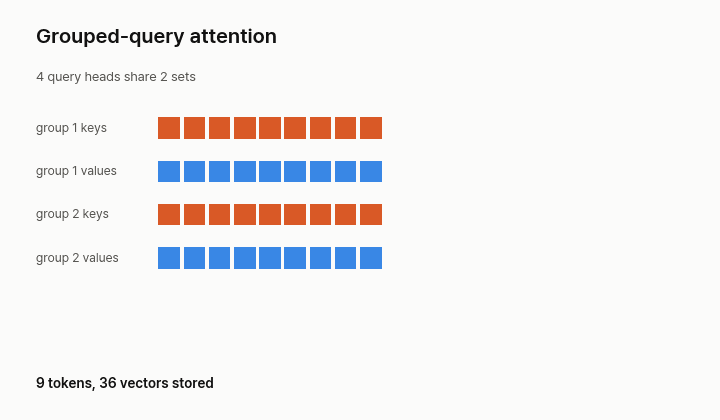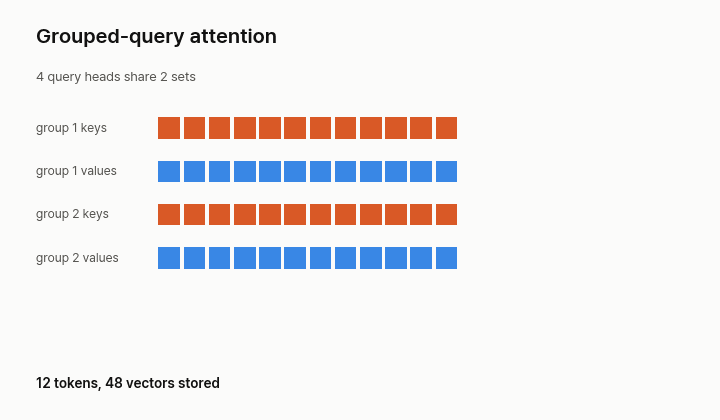
Ainslie 등은 그 중간입니다. 그룹 G개가 각각 key 헤드와 value 헤드 하나를 함께 씁니다. CPU 검사에서 양 끝이 맞는지 확인했습니다. groups=heads이면 MHA와 출력이 같고, groups=1이면 가중치를 공유한 MQA와 출력이 같습니다. 정리 글에서 본 2024년 이후 dense 모델(key를 전부 읽는 모델)은 이 형태가 가장 많습니다.
- 나아진 점. MQA에 가까운 속도로 MHA에 가까운 품질을 냅니다. T5-XXL에서 GQA-8은 TPUv4 칩 하나 기준 샘플당 0.28초에, 요약·번역·QA 일곱 과제의 평균 점수 47.1입니다. 원래의 MHA는 1.51초에 47.2, MQA는 0.24초에 46.6입니다. GQA와 MQA는 MHA에서 변환한 뒤 원래 학습량의 5%를 더 학습했습니다.
- 이유. 논문은 이렇게 설명합니다. 큰 모델에서는 KV 캐시의 메모리 대역폭이 속도를 덜 제약하고, 헤드가 많을수록 key·value 크기가 더 크게 줄어듭니다. 그래서 그룹을 하나에서 몇 개로 늘려도 추론은 조금만 느려집니다.
- 대가. 그룹이 늘수록 추론이 느려지는데, 처음에는 완만하다가 MHA에 가까워질수록 빠르게 느려집니다. DeepSeek-V2도 GQA가 캐시는 줄여도 MHA 품질에는 미치지 못한다고 봅니다(앞 항목의 41.2와 45.2, 모델 전체 비교).
def gqa(x, Wq, Wk, Wv, Wo, heads, groups):
    """In between: `groups` sets of keys and values, each shared by heads/groups query heads."""
    T, d, h_d = *x.shape, x.shape[1] // heads
    q = Wq(x).view(T, heads, h_d).transpose(0, 1)
    k = Wk(x).view(T, groups, h_d).transpose(0, 1).repeat_interleave(heads // groups, 0)
    v = Wv(x).view(T, groups, h_d).transpose(0, 1).repeat_interleave(heads // groups, 0)
    return Wo(attend(q, k, v).transpose(0, 1).reshape(T, d))
8. Multi-head latent attention (DeepSeek, 2024)
DeepSeek-V2는 토큰마다 작은 벡터 하나를 저장하고, 읽을 때 거기서 key와 value를 복원합니다. 논문은 KV 캐시가 DeepSeek 67B보다 93.3% 작다고 보고하는데, 모델 전체를 비교한 값입니다. 저희 함수에는 query 압축(식 12-13)과 위치 정보(RoPE, 회전 방식의 위치 인코딩)를 담는 작은 key(식 15)가 없습니다. 이 key도 캐시에 들어가므로 실제 캐시는 cache보다 큽니다.
- 나아진 점. 토큰당 KV 캐시가 줄었습니다. Small MoE 모델은 MHA의 110.6K에서 15.6K(14%)로, Large MoE는 860.2K에서 34.6K(4%)로 줄었습니다. 크기가 비슷한 모델 전체끼리 비교한 값이며, 파라미터 수가 똑같지는 않습니다.
- 이유. 논문은 key와 value를 낮은 차원의 벡터 하나로 함께 압축해 그것만 캐시에 저장합니다. 학습한 행렬로 되돌리므로 헤드마다 자기 key와 value를 읽습니다.
- 대가. RoPE가 압축된 형태와 맞지 않아 위치용 key를 따로 캐시해야 하고, RMS Norm도 하나 더 필요합니다. query를 압축해도 캐시는 전혀 줄지 않습니다.
def mla(x, Wq, Wc, Wuk, Wuv, Wo, heads):
    """Store one small vector per token. Keys and values are rebuilt from it when read. Leaves out the query
    compression and the small extra key that carries RoPE, which is also cached."""
    T, d = x.shape
    cache = Wc(x)                                                    # [T, small]: all that is kept, without RoPE
    split = lambda t: t.view(T, heads, d // heads).transpose(0, 1)
    out = attend(split(Wq(x)), split(Wuk(cache)), split(Wuv(cache)))
    return Wo(out.transpose(0, 1).reshape(T, d))
고정 패턴: 읽을 칸을 미리 정합니다
여기부터는 읽지 않는 key가 생깁니다. 다음 여섯 가지는 위치만 보고 정합니다. 아래 causal(n)은 아래쪽 삼각형 마스크로, 토큰이 자기 자신과 그 앞만 보게 합니다.
9. Sliding window
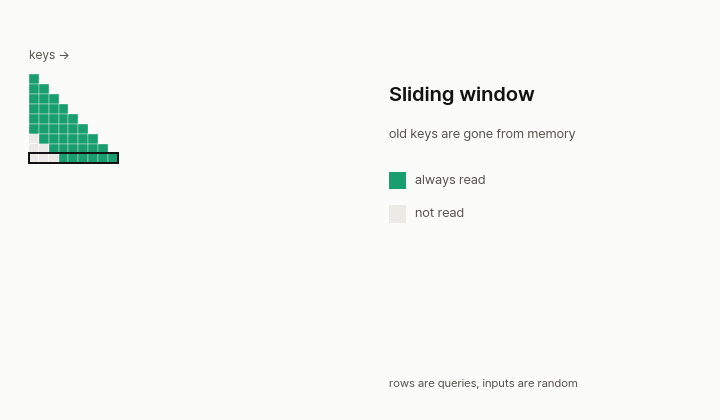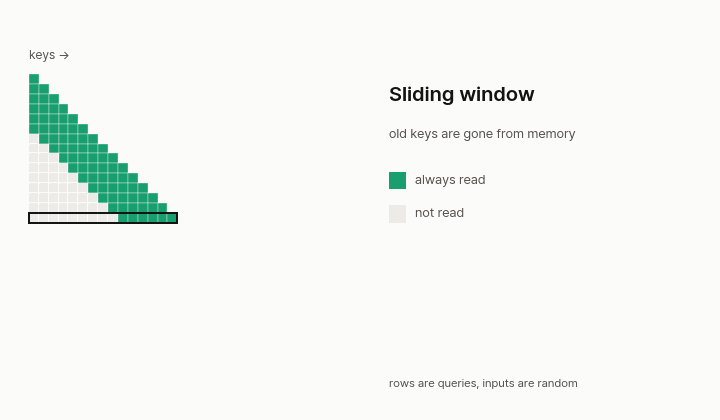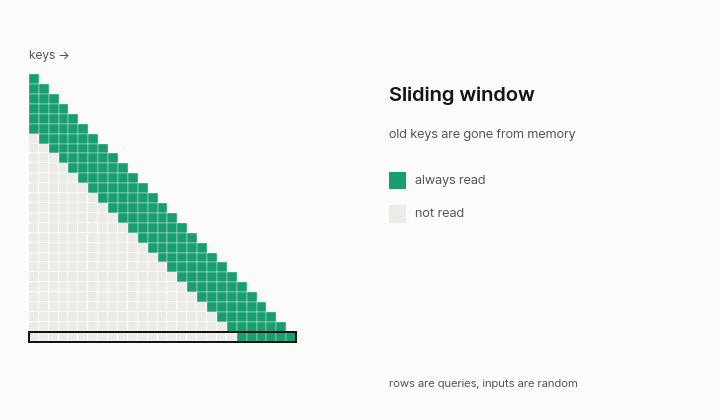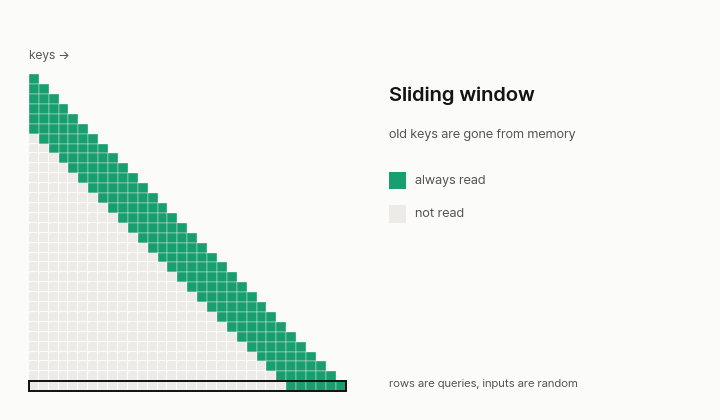
query마다 최근 window개 key만 읽고, 더 오래된 key는 메모리에서 내려도 됩니다. 캐시가 더 커지지 않는 대신, window 밖의 내용은 사라집니다. 특정 논문 하나에서 나온 설계는 아닙니다.
- 나아진 점. 메모리가 더 늘지 않고, 토큰 하나의 계산량도 컨텍스트 길이와 무관해집니다. 특정 원전 논문이 없어 가장 가까운 숫자를 들면, MQA 논문에서 현재와 앞 31개 위치만 읽는 모델은 토큰당 46µs가 23µs로, beam search는 203µs가 47µs로 줄었고 BLEU는 27.5, 28.3과 27.7, 28.4였습니다.
- 이유. 원전 논문이 없어 저희 해석으로 적으면, 컨텍스트가 아무리 길어도 query가 읽는 key 수는 정해져 있습니다.
- 대가. window를 벗어난 내용은 사라지며, 모델이 아예 망가지기도 합니다. sink 논문은 Llama-2-13B에서 window 1024로 맨 앞 토큰까지 지우자 PG-19 perplexity가 5158.07이 됐다고 보고합니다. LSA 논문의 128K 학습 비교에서는 작은 하이브리드 모델 하나에 window 2,560개와 sink key 4개를 썼을 때 RULER(긴 컨텍스트 시험, 높을수록 좋음)가 3.0으로, full attention의 34.7보다 낮습니다.
def sliding(n, window):
    """Each query reads its latest `window` keys. Older keys can be dropped from memory."""
    i, j = torch.meshgrid(torch.arange(n), torch.arange(n), indexing="ij")
    return (j <= i) & (j > i - window)
10. Attention sinks (Xiao, 2023)
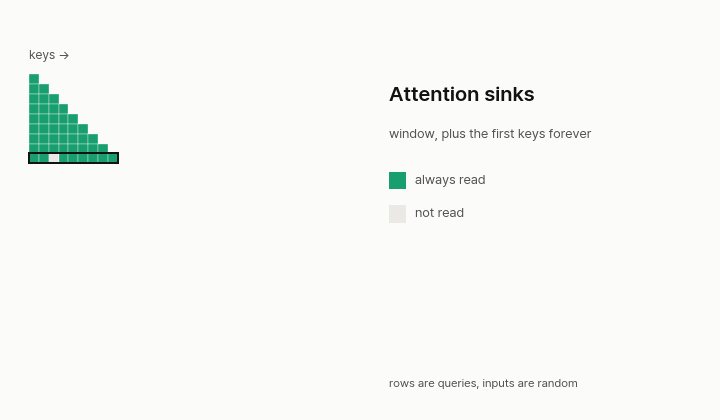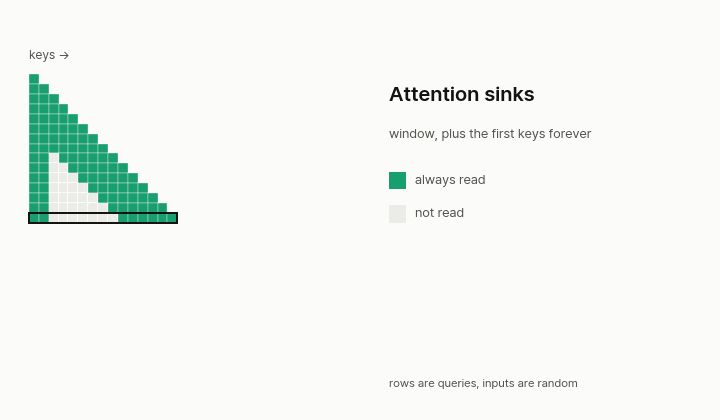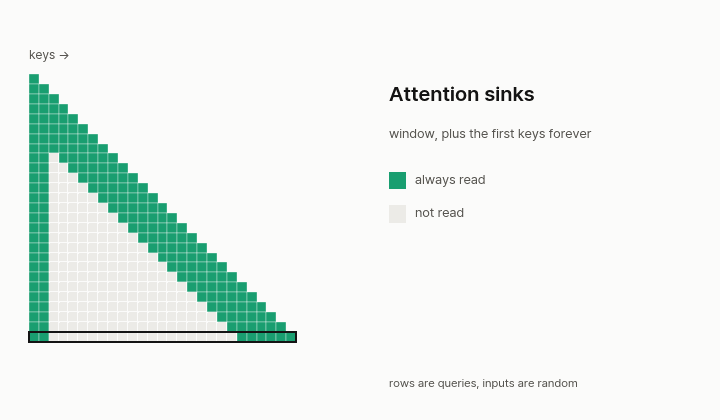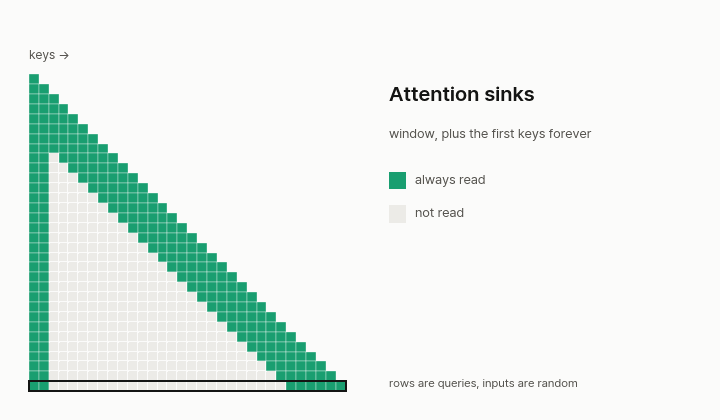
Xiao 등은 모델이 맨 앞 토큰에 계속 어텐션을 준다는 점을 발견했습니다. 내용만 보면 중요하지 않아 보여도 지우면 성능이 크게 떨어집니다. 그래서 앞 토큰 몇 개를 끝까지 남기는데, 논문은 4개면 충분하다고 합니다. 항목 22의 Latent Sparse Attention(LSA)에도 항상 읽는 이 줄이 있습니다.
- 나아진 점. 긴 스트리밍 생성이 망가지지 않게 됐습니다. 같은 시험에서 맨 앞 토큰 4개와 window 1020을 남기자 perplexity가 5158.07에서 5.40으로 내려갔고, 캐시를 다시 계산하는 sliding window보다 토큰당 최대 22.2배 빠릅니다.
- 이유. 논문의 설명은 이렇습니다. softmax 가중치는 합이 1이어야 하므로, 쓸 곳이 없는 어텐션이 맨 앞 토큰에 모입니다. 이 토큰을 남겨 두면 그 분포가 흔들리지 않습니다.
- 대가. 논문이 직접 밝히듯 컨텍스트가 늘거나 장기 기억이 생기지는 않습니다. 오래된 토큰은 여전히 사라집니다.
def sink(n, window, sinks=4):
    """Sliding window, but the first few keys stay forever. Attention keeps landing on them."""
    read = sliding(n, window)
    read[:, :sinks] = True
    return read & causal(n)
11. Local-global layers
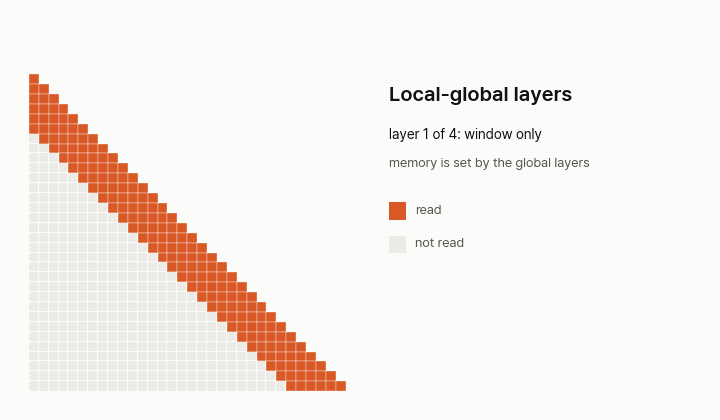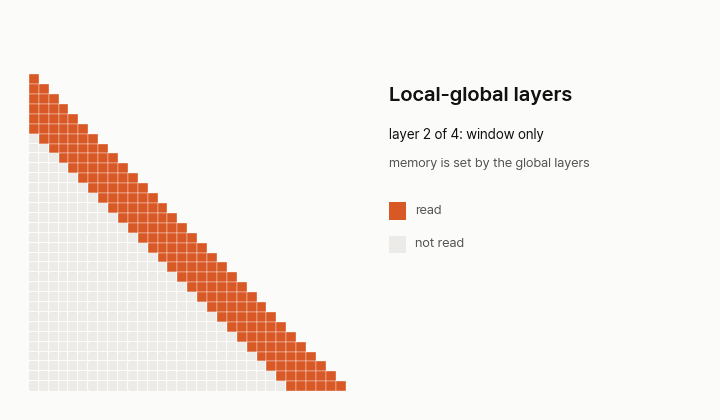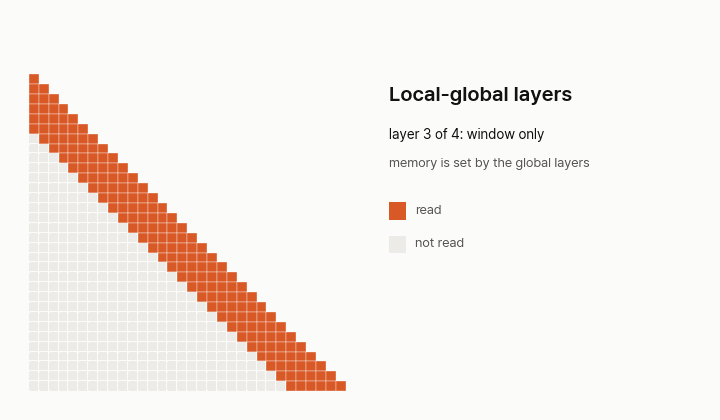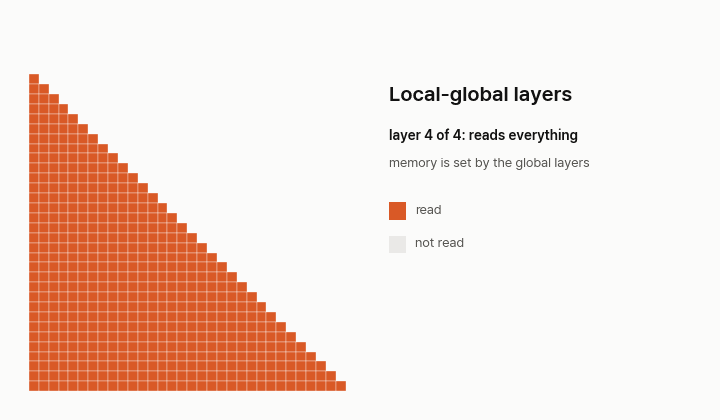
대부분의 레이어는 window만 읽고, 몇 레이어마다 한 번 전부 읽습니다. 그래서 컨텍스트가 길면 메모리는 대부분 전부 읽는 레이어가 결정합니다. 이것도 특정 논문 하나에서 나온 설계는 아니고, 섞는 비율은 모델마다 크게 다릅니다. 정리 글 기준으로 Gemma 2는 두 레이어에 하나, Gemma 3은 여섯 레이어에 하나, gpt-oss는 두 레이어에 하나이면서 window가 128입니다.
- 나아진 점. 대부분의 레이어가 가벼워지면서 먼 토큰에도 닿을 수 있습니다. 이 조합의 원전 논문은 없습니다. 가장 가까운 숫자는 다른 조합인 Routing Transformer에 있습니다. CIFAR-10, window 512에서 local만 쓰면 3.009 bits/dim에 9.023 steps/s, 2개 레이어의 routing 헤드 4개를 더하면 2.986에 7.409, full attention은 2.983에 5.608입니다. bits/dim은 낮을수록 좋습니다.
- 이유. 저희 해석으로는, window 레이어가 가까운 문맥을 싸게 처리하고 가끔 나오는 full 레이어가 먼 정보를 모델 전체로 옮깁니다.
- 대가. 비율 선택이 실제 맞교환입니다. linear와 full 레이어를 섞는 Kimi Linear에서 7대 1은 검증 성능이 나빴고, 1대 1은 추론 부담이 컸습니다. LSA 논문은 다른 쪽 한계도 짚습니다. global 레이어를 빠르게 해도 그 레이어만 빨라집니다.
def layer_read(layer, n, window, global_every):
    """Most layers read a window, every few layers one reads everything."""
    return causal(n) if (layer + 1) % global_every == 0 else sliding(n, window)
12. Sparse Transformer (Child, 2019)
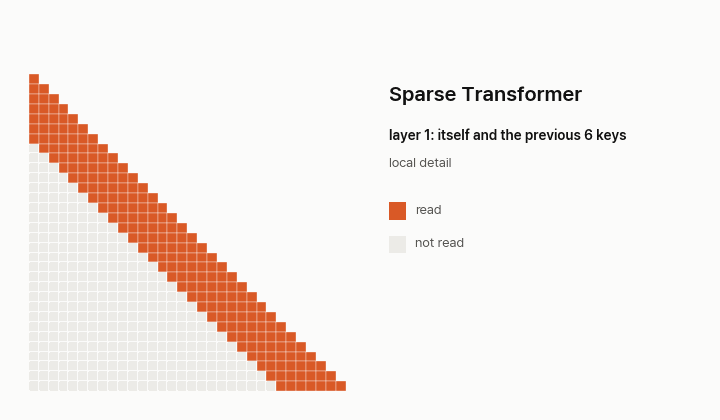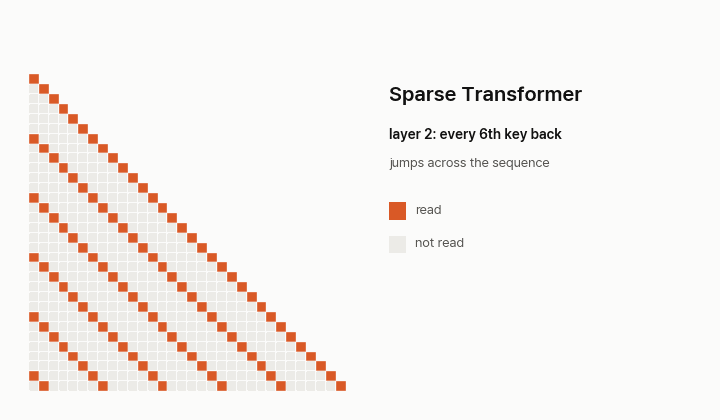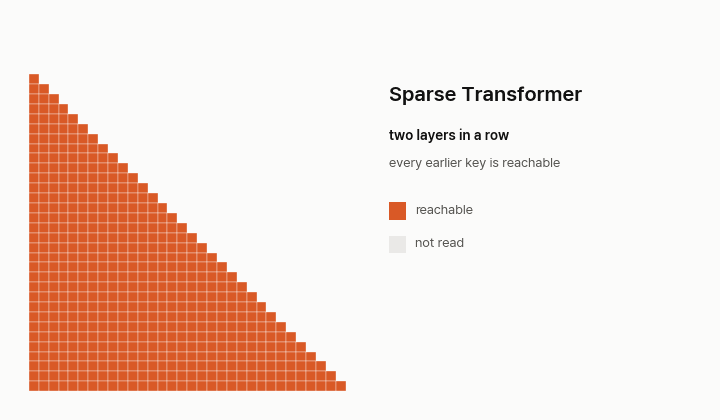
Child 등은 마스크 두 개를 번갈아 씁니다. 한 레이어는 최근 key를 읽고, 다음 레이어는 stride 간격으로 key를 읽으며, 비용은 O(n√n)입니다. 저희 검사에서 두 마스크를 거치면 앞의 어떤 key에도 닿는 것을 확인했습니다. 다만 논문은 이 패턴이 텍스트에서는 "can fail to properly route information"(정보를 제대로 전달하지 못할 수 있음)이라고 적었습니다.
- 나아진 점. 더 적은 계산으로 긴 시퀀스에서 dense 모델 수준의 품질을 냈습니다. CIFAR-10에서 strided는 2.80 bits/dim으로 dense의 2.82와 비슷했습니다(낮을수록 좋음). Enwik8에서는 파라미터 95M의 고정 패턴이 0.99로, Transformer-XL 88M의 1.03보다 낮고 277M의 0.99와 같았습니다.
- 이유. 두 단계면 앞의 어떤 key에도 닿으므로, 레이어마다 약 √n개만 읽어도 모두 연결됩니다.
- 대가. 텍스트에 쓴 고정 패턴은 strided보다 c배 비싸고(논문의 c는 8, 16, 32), 그만큼 아낀 계산을 일부 돌려줍니다. 나중에 Routing Transformer는 고정 패턴이 내용을 보지 않아 묶을 수 있는 토큰에 한계가 있다고 지적합니다.
def sparse_transformer(layer, n, stride):
    """Strided pattern. One layer reads itself and the previous `stride` keys, the next reads every stride-th key back.
    Together the two layers can reach any earlier key."""
    i, j = torch.meshgrid(torch.arange(n), torch.arange(n), indexing="ij")
    same = (j >= i - stride) if layer % 2 else ((i - j) % stride == 0)
    return same & causal(n)
13. Longformer (Beltagy, 2020)
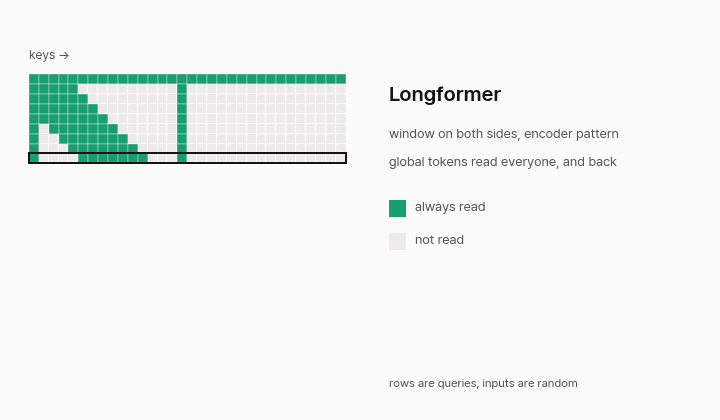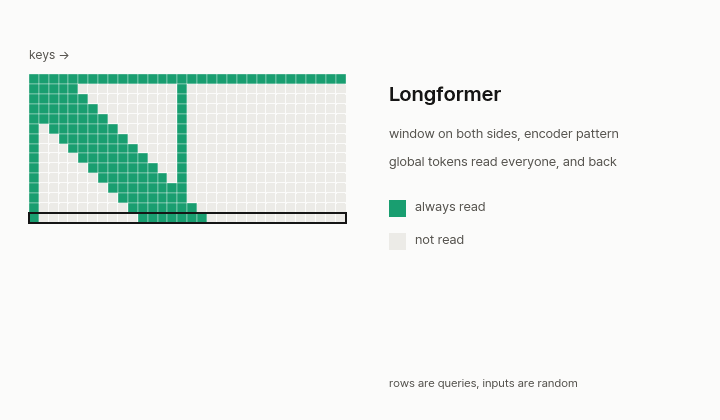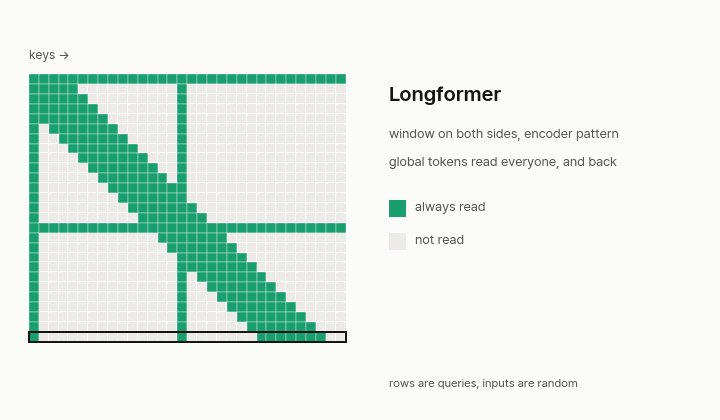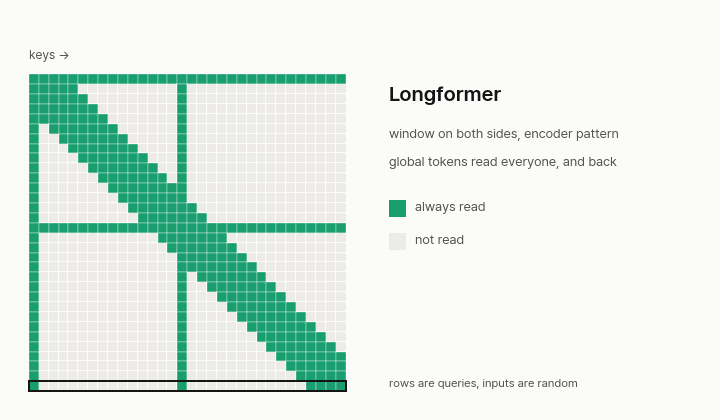
Longformer는 양쪽으로 window의 절반씩 읽는 구간과, 모두를 읽고 모두에게 읽히는 전역 토큰 몇 개를 합칩니다. 인코더용 패턴이라 격자가 정사각형이고 뒤쪽 토큰도 봅니다. 논문의 causal 언어 모델 설명에는 전역 토큰이 나오지 않고, 상위 레이어의 헤드 2개에만 일정 간격으로 key를 건너뛰는 dilated window를 씁니다. 인코더-디코더 구조의 디코더는 full self-attention을 유지합니다. 전역 어텐션용 별도 projection은 뺐습니다.
- 나아진 점. 긴 문서를 자르지 않고 통째로 읽을 수 있게 됐습니다. dev 셋에서 WikiHop 정확도는 73.8(15 에폭이면 75.0)로 RoBERTa-base의 72.4보다 높았고, Hyperpartisan F1은 94.8로 87.4보다 높았습니다.
- 이유. window가 가까운 문맥을 맡고, 전역 토큰이 문서 전체에 필요한 정보를 나릅니다. 논문이 직접 빼 보니 전역 어텐션과 그 linear projection 없이는 WikiHop이 65.5로, 길이 4,096의 73.8보다 8.3점 낮았습니다.
- 대가. 언어 모델 학습에는 가까운 문맥부터 배우게 하는 일정이 필요합니다. 인코더-디코더 버전은 디코더에 full self-attention을 남기므로 그쪽 비용은 그대로 제곱입니다.
def longformer(n, window, global_ids):
    """A window on both sides, plus a few global tokens that read and are read by everyone. Encoder pattern."""
    i, j = torch.meshgrid(torch.arange(n), torch.arange(n), indexing="ij")
    read = (i - j).abs() <= window // 2
    read[:, global_ids] = True
    read[global_ids, :] = True
    return read
14. BigBird (Zaheer, 2020)
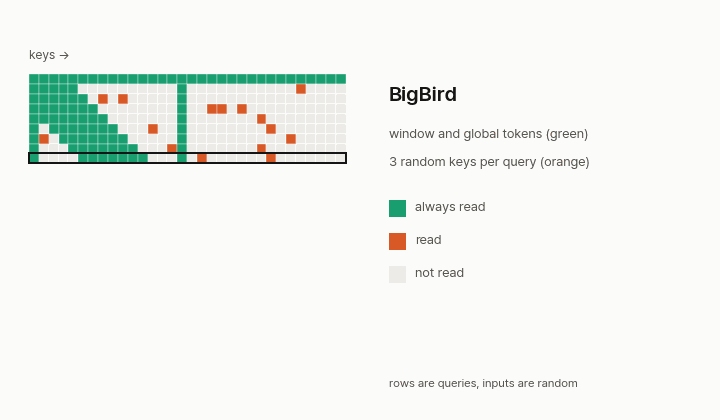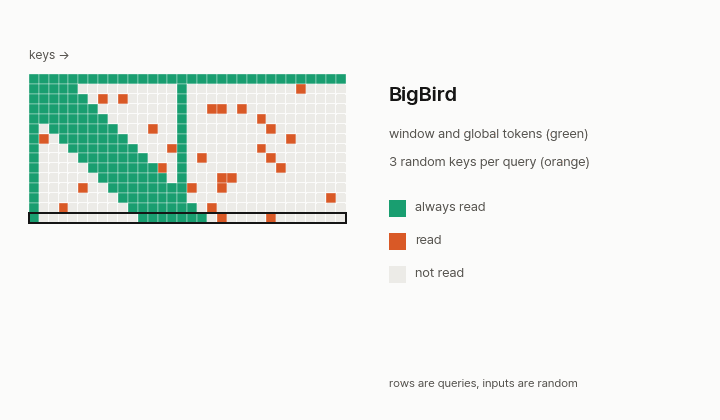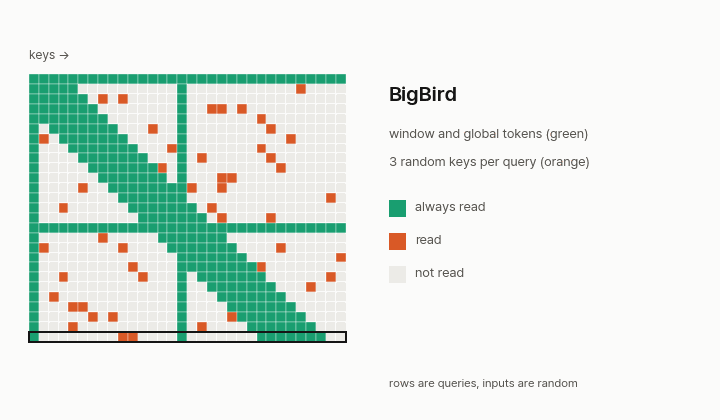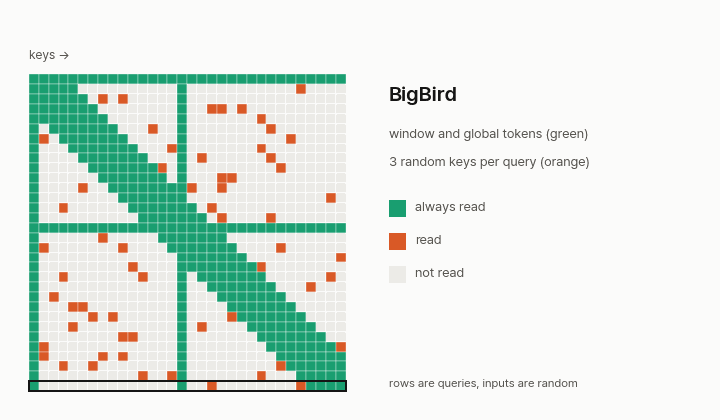
BigBird는 window와 전역 토큰에 무작위 key를 더합니다. 무작위 연결은 그래프 이론에서 온 아이디어로, 토큰 사이 경로를 짧게 유지합니다. 증명의 바탕은 전역 토큰입니다. 논문은 전역 토큰을 중심으로 한 star graph를 포함하는 희소 패턴이 시퀀스 함수를 원하는 만큼 가깝게 근사할 수 있고(universal approximator), 희소 인코더와 디코더로 어떤 Turing machine도 흉내 낼 수 있음을 보입니다. 실험에서 디코더는 full self-attention을 쓰고, 실제 구현은 토큰 블록 단위로 동작합니다. 저희 함수는 key를 하나씩 고릅니다.
- 나아진 점. 다룰 수 있는 시퀀스가 최대 8배 길어졌습니다. Longformer와 함께 실은 test 결과를 보면 TriviaQA Verified는 92.4와 85.3으로 차이가 크지만, HotpotQA는 81.2로 같고 WikiHop은 82.3과 81.9로 비슷합니다. 과제마다 이득이 다릅니다. Arxiv 분류에서는 당시 최고 수준보다 약 5점 높았습니다.
- 이유. 무작위 연결이 토큰 사이 경로를 짧게 유지해 적은 레이어로 정보가 시퀀스를 건너갑니다. 증명을 떠받치는 것은 전역 토큰입니다.
- 대가. 논문이 "no free lunch" 결과를 직접 제시합니다. 희소 어텐션이 full attention보다 다항식으로 많은 레이어를 써야 하는 과제가 있다는 내용입니다. 디코더도 full self-attention으로 남습니다.
def bigbird(n, window, global_ids, r, seed=0):
    """Longformer's two parts, plus r random keys per query. Encoder pattern; the real code works on blocks."""
    g = torch.Generator().manual_seed(seed)
    read = longformer(n, window, global_ids)
    for i in range(n):
        read[i, torch.randint(0, n, (r,), generator=g)] = True
    return read
먼저 점수 매기기: 가벼운 indexer가 고릅니다
이제 위치로 정하지 않습니다. query가 앞 토큰에 가벼운 점수를 매기고, 이긴 토큰만 읽습니다. key는 전부 메모리에 남으므로 계산은 줄지만 캐시는 줄지 않습니다(DSA는 indexer용 작은 key가 토큰마다 더 붙습니다). 그리고 LSA 글에서 보듯 비용이 바로 이 점수 단계로 옮겨 갑니다.
15. DeepSeek Sparse Attention (2025)
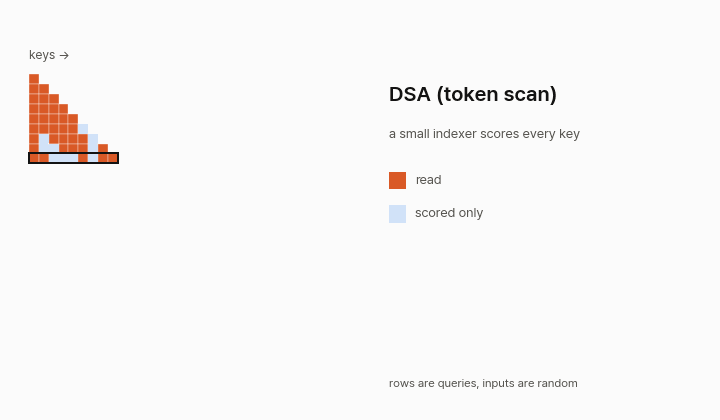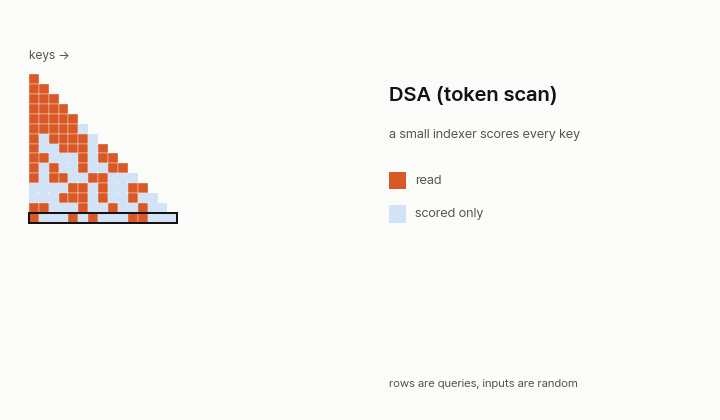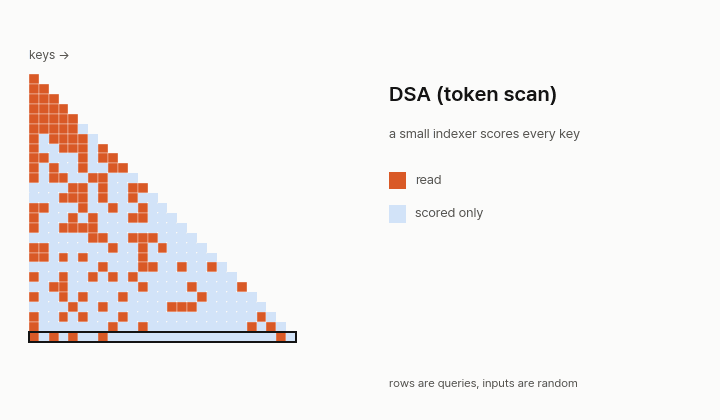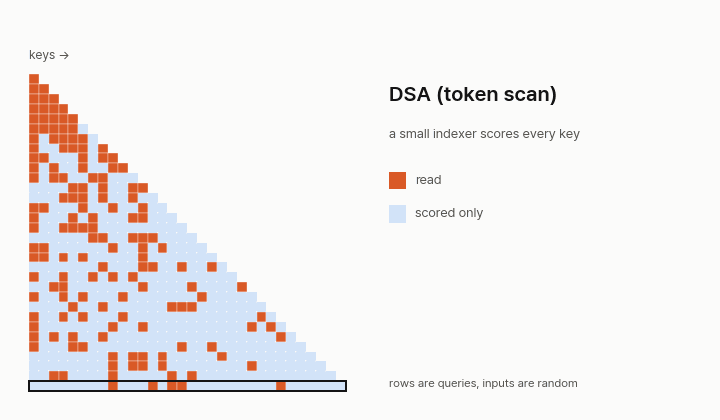
DeepSeek-V3.2는 작은 query 헤드들과 토큰당 작은 key 하나로 된 indexer를 더합니다. ReLU로 양수 점수만 남기고, 상위 2,048개를 읽습니다. query마다 key 전부에 점수를 매기므로 LSA 논문은 이런 방식을 token sparse attention이라고 부릅니다. 이 글에서는 token scan이라고 부르겠습니다. GIF는 잘 보이도록 5개만 읽게 그렸습니다.
- 나아진 점. 본 어텐션 계산이 길이의 제곱에서 L·k로 줄어듭니다(k는 읽는 key 수). 옮길 수 있는 점수는 모델 전체의 것입니다. V3.2-Exp가 AA-LCR 추론 모드에서 V3.1-Terminus보다 4점 높습니다. 이 어텐션만 잰 숫자는 논문에 없습니다.
- 이유. 작은 indexer가 상위 key를 고르므로, 비싼 멀티헤드 읽기는 고른 key에서만 돕니다.
- 대가. indexer 자체는 여전히 제곱입니다. 다만 논문은 MLA보다 훨씬 가볍다고 봅니다. 학습에는 나머지 파라미터를 고정하고 KL loss로 indexer를 가르치는 단계가 더 들어갑니다.
def dsa_scores(qi, ki, w):
    """A small indexer scores every key. qi [H, Q, d]: small query heads, w [H, Q]: their weights, ki [T, d]."""
    return (w[:, :, None] * F.relu(qi @ ki.T)).sum(0)                # [Q, T], then keep the top k
16. MoBA (Lu, 2025)
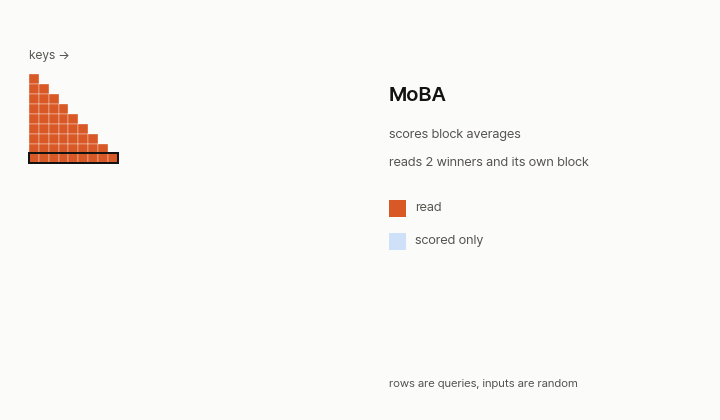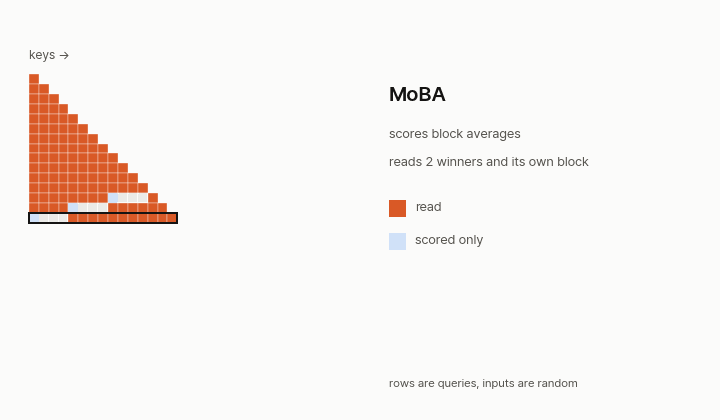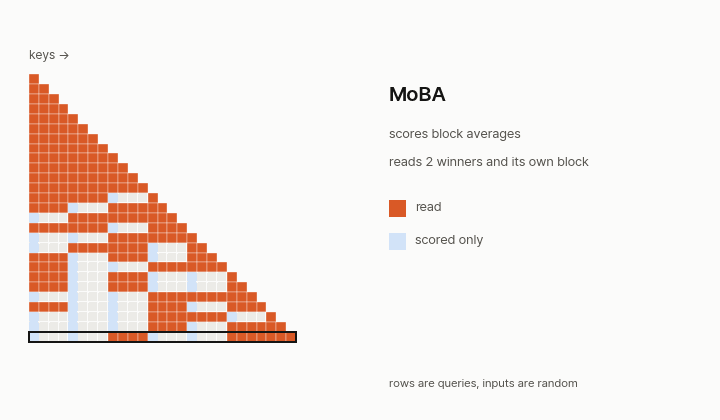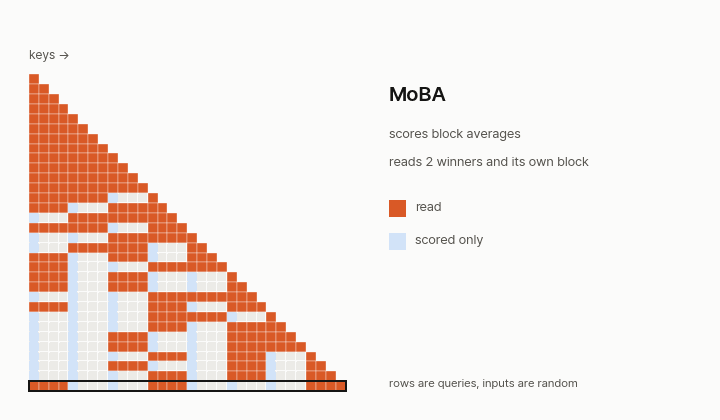
MoBA는 key를 블록으로 나누고 블록 평균에 점수를 매기므로, 블록마다 점수가 하나면 됩니다. 논문의 블록 64개, 상위 3개 설정은 희소도 95.31%인데, 1에서 3/64를 뺀 값입니다. query 자신의 블록도 세 개 중 하나로 칩니다. 논문은 헤드별로 고르고, 여기서는 헤드 하나만 보여 드립니다.
- 나아진 점. 1M에서 prefill이 full attention보다 최대 6.5배 빠르고, 10M에서는 어텐션 계산량이 16배 적습니다. 희소도 62.5%에서 128K RULER는 0.7818로, full attention의 0.7849와 비슷합니다.
- 이유. key를 평균 내어 블록으로 묶으므로, query는 블록마다 점수 하나만 매기고 이긴 블록만 읽습니다.
- 대가. MoBA로만 학습하면 긴 시퀀스 끝쪽 토큰의 loss가 높아지고, 논문의 해법은 학습 과정에 full attention을 다시 넣는 것입니다. query가 블록 전부에 점수를 매기는 비용도 남으며, LSA 논문이 줄이려는 부분이 이것입니다.
def moba_read(q, k, block, top):
    """Average each block of adjacent keys and score the averages. `top` counts the query's own block,
    which is always read. One head here; the paper selects per head."""
    Q, T = len(q), len(k)
    means = k.unfold(0, block, block).mean(-1)
    scores = q @ means.T
    read = torch.zeros(Q, T, dtype=torch.bool)
    for i in range(Q):
        closed = i // block                                          # blocks that lie fully in the past
        for b in scores[i, :closed].topk(min(top - 1, closed)).indices.tolist():
            read[i, b * block:(b + 1) * block] = True
        read[i, closed * block:i + 1] = True
    return read
17. Native Sparse Attention (Yuan, 2025)
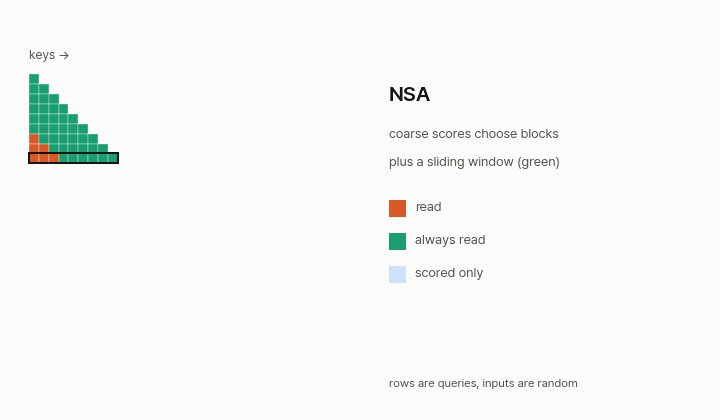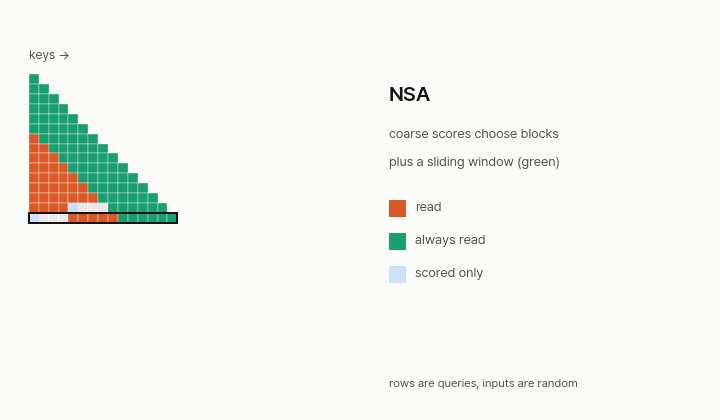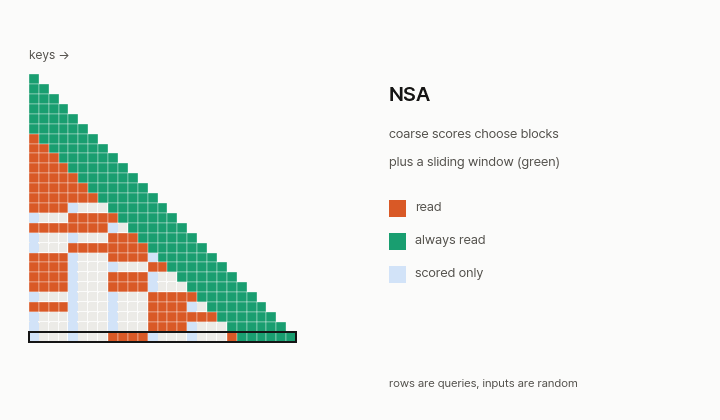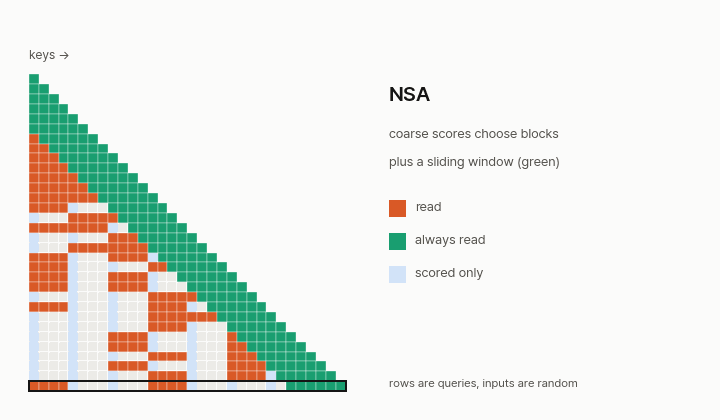
NSA는 gate가 달린 세 갈래를 섞습니다. 전체를 훑는 압축 블록, 세부를 읽는 선택 블록, sliding window입니다. 토큰 선택까지 모델과 함께 처음부터 학습하며, 논문은 27B 모델로 시험했습니다. 저희 함수는 어떤 key를 읽는지만 보여 줍니다. 논문의 작은 학습 신경망 자리에 평균을 썼고, gate와 갈래별 key·value는 뺐습니다. 논문의 압축 블록은 겹치지만(길이 32, 간격 16) 저희 블록은 겹치지 않습니다. 논문은 블록 16개를 고를 때 맨 앞 블록 1개와 가까운 블록 2개를 항상 넣는데, 저희 함수는 맨 앞 블록을 따로 넣지 않고 가까운 쪽은 sliding window가 맡습니다.
- 나아진 점. 읽는 메모리가 크게 줄었습니다. 64K에서 한 단계에 읽는 토큰이 65,536개에서 5,632개로 줄어, 논문은 11.6배 빨라질 것으로 계산합니다(8K에서는 4배). 접근량으로 계산한 값이며 실측은 아닙니다. LongBench 평균은 0.469로 full attention의 0.437보다 높습니다.
- 이유. 학습되는 세 갈래가 전체 개요, 세부, 가까운 문맥을 나눠 맡고, 선택까지 함께 학습하므로 모델에 맞춰집니다.
- 대가. LSA 논문의 128K 학습 비교에서 NSA는 검증 loss 1.117로 full attention의 1.085보다 높고, RULER도 19.2로 34.7보다 낮습니다. 그 논문의 설정에서 나온 값입니다. 블록 전부에 점수를 매기는 것도 그대로입니다.
def nsa_read(q, kc, block, top, window):
    """Scores on pooled keys choose blocks, then fine attention reads those keys and a window. Mean pooling
    stands in for the paper's small learned network. The real model mixes a compressed branch, this selected
    branch and the window branch with learned gates, each with its own keys and values."""
    Q, T = len(q), len(kc)
    scores = q @ kc.unfold(0, block, block).mean(-1).T
    read = sliding(max(Q, T), window)[:Q, :T].clone()
    for i in range(Q):
        closed = i // block
        for b in scores[i, :closed].topk(min(top, closed)).indices.tolist():
            read[i, b * block:(b + 1) * block] = True
    return read
18. Block scan: CSA, QSA, GLM-5.3-Flash SA
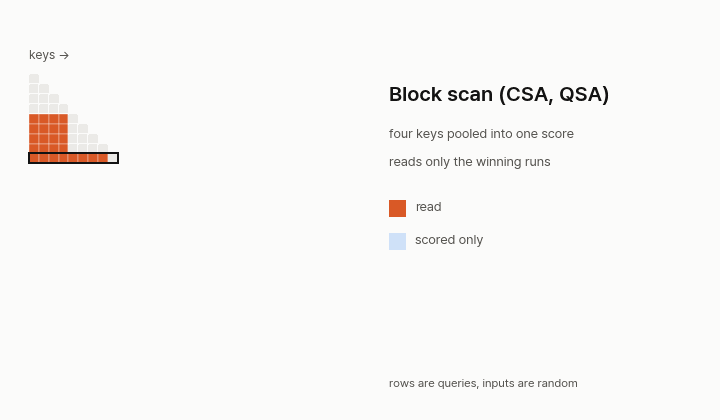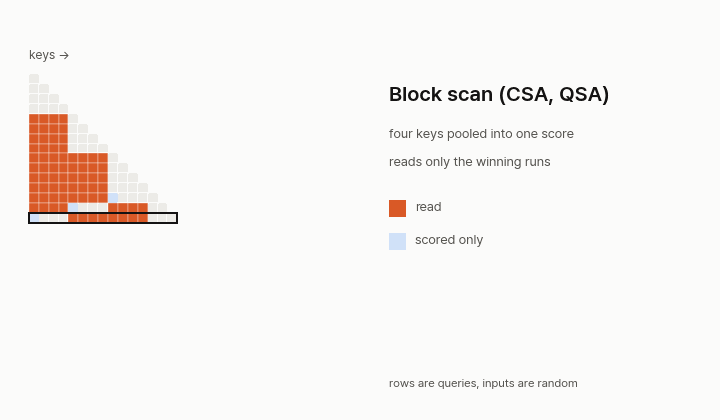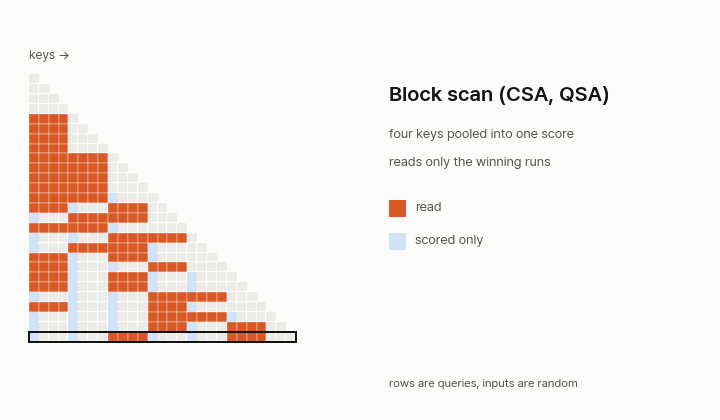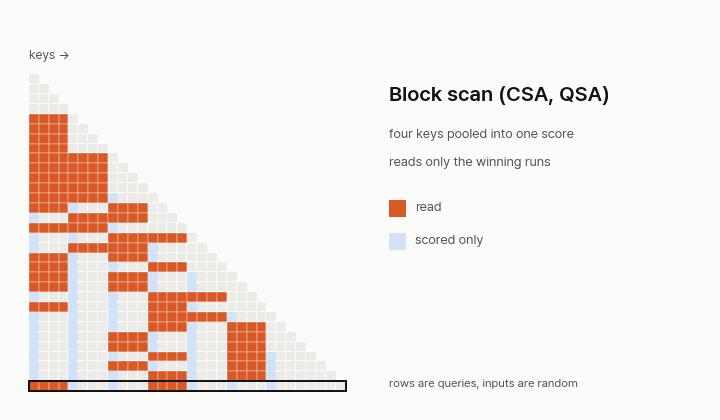
CSA, QSA, GLM-5.3-Flash SA는 최근 기술 보고서에 나온 sparse 레이어입니다. key 네 개를 점수 하나로 압축하므로, query마다 점수를 T/4번 매기고 네 칸 묶음을 통째로 읽습니다. LSA 논문은 이를 block sparse attention이라고 부릅니다. 저희는 각 보고서를 직접 읽지 않았고 LSA 논문의 설명을 따라 만들었으므로, 특정 모델의 코드가 아니라 대략적인 구조로 보시면 됩니다. 이 논문의 매개변수 표에서 기준 모델인 flat block 방식은 맨 앞 key와 window 값이 비어 있습니다. 그래서 저희 함수에도 없고, 다 찬 블록이 아직 없는 query는 여기서 아무것도 읽지 않습니다.
- 나아진 점. token scan이 T번 매기는 점수를 T/4번으로 줄입니다. 설계에서 나오는 산수이며, 이것만 잰 숫자는 찾지 못했습니다.
- 이유. LSA 논문의 설명으로는 key 네 개를 점수 하나로 압축하고, 이긴 묶음을 통째로 읽습니다.
- 대가. 점수 계산은 여전히 길이와 함께 늘어납니다. LSA 논문은 1,000만 토큰에서 GLM-5.3-Flash의 전역 어텐션 레이어 하나의 prefill 시간 중 98%를 indexer가 쓴다고 보고합니다. indexer 비용이 0이라면 H200 한 장에서 그 레이어의 prefill이 58배, decode가 8.9배 빨라진다는 것이 그 논문의 계산입니다.
def block_scan_read(q, k, block, top):
    """One score per run of adjacent keys, taken from small index vectors. Read only the winning runs."""
    Q, T = len(q), len(k)
    scores = q @ k.unfold(0, block, block).sum(-1).T                 # pool: four keys summed into one
    read = torch.zeros(Q, T, dtype=torch.bool)
    for i in range(Q):
        closed = i // block
        for b in scores[i, :closed].topk(min(top, closed)).indices.tolist():
            read[i, b * block:(b + 1) * block] = True
    return read
내용으로 묶기: 비슷한 key끼리 모읍니다
블록에는 우연히 옆에 있던 토큰이 들어갑니다. 이 네 가지는 내용으로 key를 묶기 때문에, query가 관련 토큰으로 위치와 상관없이 건너갈 수 있습니다.
19. Reformer (Kitaev, 2020)
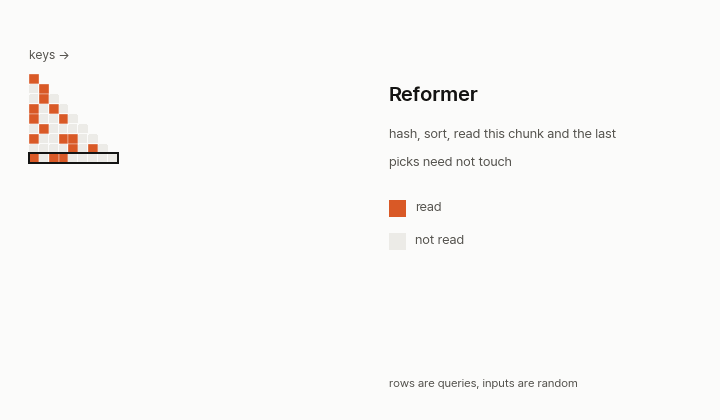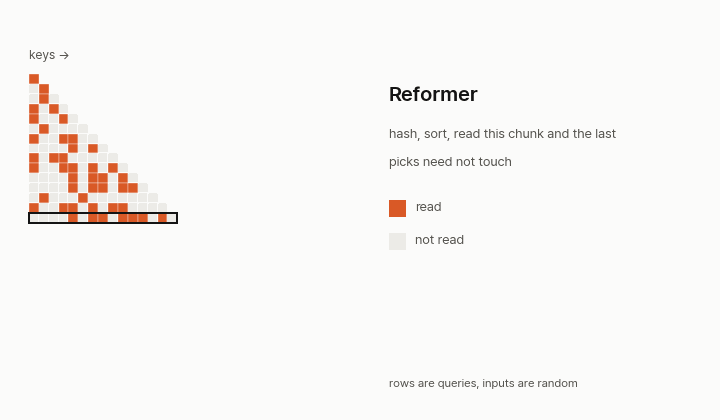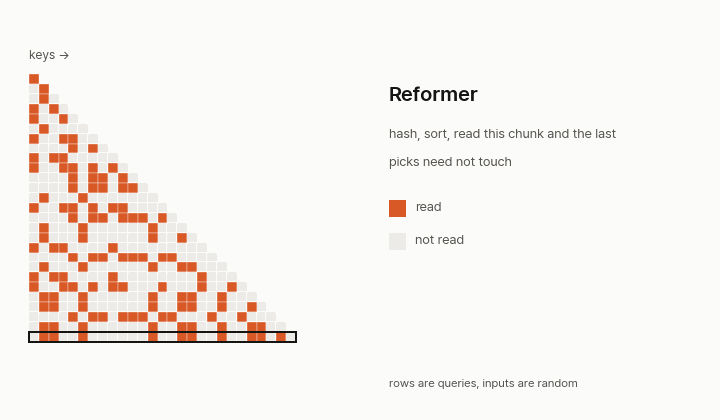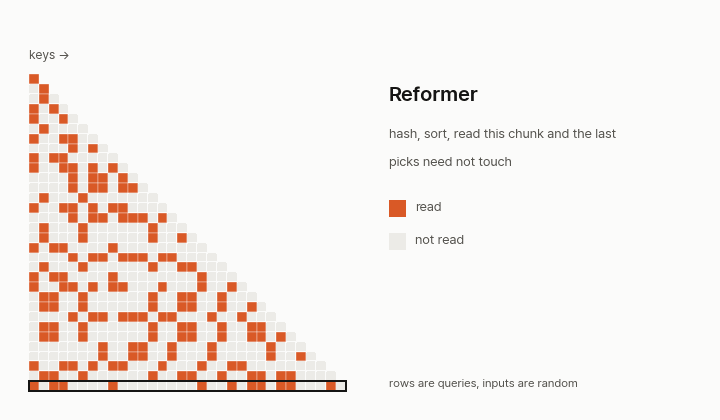
Reformer는 무작위 회전으로 해시를 만들고(h(x) = argmax([xR; -xR])), 위치를 버킷 순으로 정렬한 뒤 잘라 낸 구간과 그 앞 구간 안에서 어텐션합니다. query와 key는 같은 벡터를 쓰고, 토큰은 달리 읽을 것이 없을 때만 자신을 읽습니다. 논문은 놓치는 짝을 줄이려고 해시를 여러 번 돌리는데, 여기서는 한 번만 보여 드리고 key 정규화도 뺐습니다.
- 나아진 점. 긴 시퀀스 학습이 메모리에 들어옵니다. 논문은 보통 어텐션이라면 64K 토큰에서 가속기 메모리가 바닥날 수 있다고 적었습니다. 전체 토큰 수를 고정하면 해시 어텐션은 길이가 늘어도 속도가 거의 일정한데 보통 어텐션은 느려지며, 12레이어 모델이 enwik8에서 1.05 bits/dim을 냈습니다.
- 이유. 비슷한 벡터는 같은 버킷에 들어갈 확률이 높아서 토큰이 자기 구간만 읽으면 됩니다. 나머지 메모리는 학습 중 활성값을 다시 계산하는 가역 레이어가 줄입니다.
- 대가. 정확도는 해시 횟수에 달려 있고(8번이면 full attention에 거의 근접), 횟수만큼 계산이 늘어납니다. 나중에 Routing Transformer는 ImageNet-64에서 Reformer를 약 3.65 bits/dim으로, 자신을 3.43으로 보고했고, Linformer는 길이 2,048을 넘어야 효율 이득이 나타난다고 지적합니다.
def lsh_buckets(x, n_buckets, seed=0):
    """Random rotations: similar vectors tend to land in the same bucket. Queries and keys share one vector."""
    R = torch.randn(x.shape[-1], n_buckets // 2, generator=torch.Generator().manual_seed(seed))
    rotated = x @ R
    return torch.cat([rotated, -rotated], -1).argmax(-1)

def reformer_read(x, n_buckets, chunk, seed=0):
    """Sort positions by bucket, cut into chunks, attend within a chunk and the one before it. No token reads
    itself unless it has nothing else. One hash round here; the paper repeats it and combines the rounds."""
    order = torch.argsort(lsh_buckets(x, n_buckets, seed), stable=True)
    n = len(x)
    chunk_of = torch.empty(n, dtype=torch.long)
    chunk_of[order] = torch.arange(n) // chunk
    i, j = torch.meshgrid(torch.arange(n), torch.arange(n), indexing="ij")
    read = (chunk_of[j] == chunk_of[i]) | (chunk_of[j] == chunk_of[i] - 1)
    read = read & causal(n) & ~torch.eye(n, dtype=torch.bool)
    alone = ~read.any(1)
    read[alone, alone] = True
    return read
20. Routing Transformer (Roy, 2020)
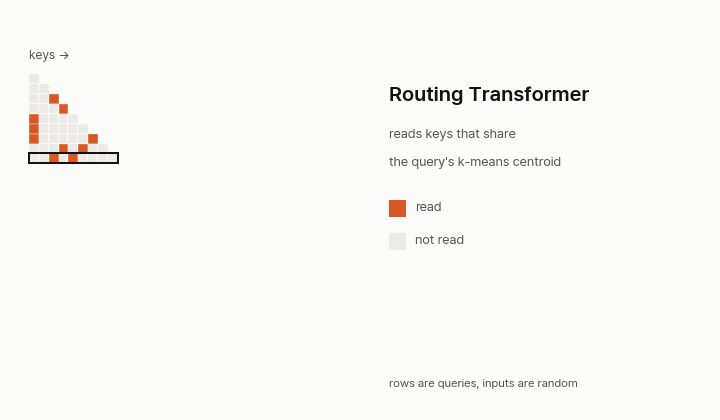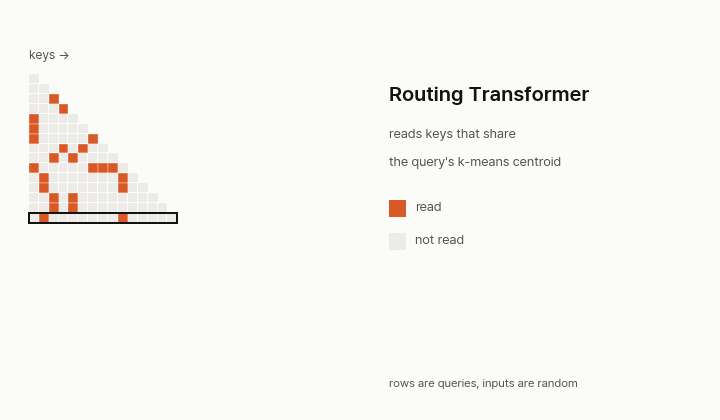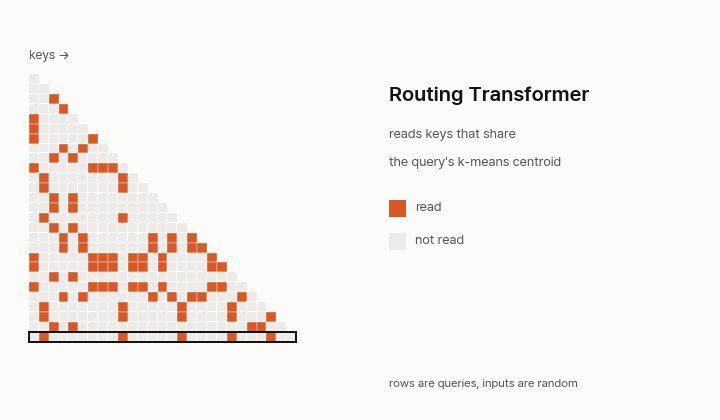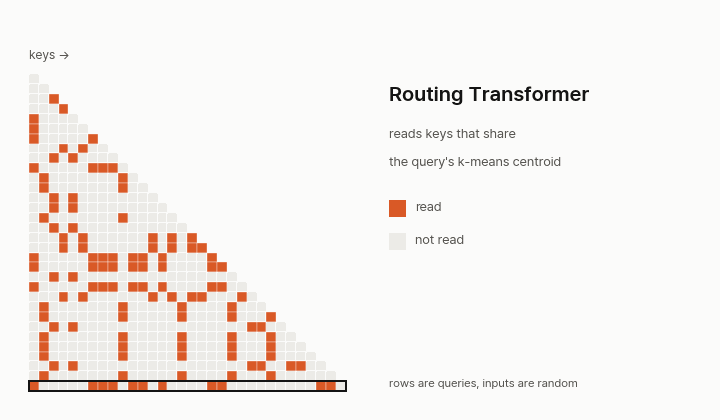
Roy 등은 묶음을 학습 중에 만들어 갑니다. query와 key가 가장 가까운 k-means centroid에 속하고, centroid는 이동 평균으로 데이터를 따라갑니다. centroid를 √n개 쓰면 비용은 O(n^1.5 d)입니다. 논문은 균형 잡힌 top-w로 배정하고, causal 마스크에서는 query와 key를 공유하며, local attention과 함께 씁니다. 저희 함수는 단순 argmax에 q와 k를 따로 받습니다.
- 나아진 점. 위치만 보던 고정 패턴과 달리 내용을 따라 읽습니다. Wikitext-103 perplexity는 15.8로 Transformer-XL의 18.3보다 낮고, ImageNet-64는 3.43 bits/dim으로 Sparse Transformer의 3.44보다 조금 낮습니다(둘 다 낮을수록 좋음).
- 이유. 데이터를 따라 움직이는 centroid가 query를 가장 비슷한 key로 보내므로, key가 어디에 있든 찾아갑니다.
- 대가. routing이 너무 많으면 오히려 나빠집니다. CIFAR-10, window 512에서 12개 레이어의 routing 헤드 8개는 3.400 bits/dim에 3.062 steps/s로, local만 쓴 3.009와 9.023보다 나쁘고 느렸습니다. 4개 레이어의 헤드 4개는 2.975와 6.492로 균형이 좋았습니다.
def routing_read(q, k, centroids):
    """q and k are LayerNorm-ed. Each joins its nearest k-means centroid, and a query reads keys that share it.
    The paper assigns with a balanced top-w; argmax here is simpler."""
    cq, ck = (q @ centroids.T).argmax(-1), (k @ centroids.T).argmax(-1)
    return (cq[:, None] == ck[None]) & causal(max(len(q), len(k)))[:len(q), :len(k)]

def routing_update(centroids, q, k, decay=0.999):
    """Centroids follow the data by a moving average of the queries and keys assigned to them."""
    cq, ck = (q @ centroids.T).argmax(-1), (k @ centroids.T).argmax(-1)
    centroids = decay * centroids
    centroids.index_add_(0, cq, (1 - decay) / 2 * q)
    centroids.index_add_(0, ck, (1 - decay) / 2 * k)
    return centroids
21. ClusterKV (Liu, 2024)
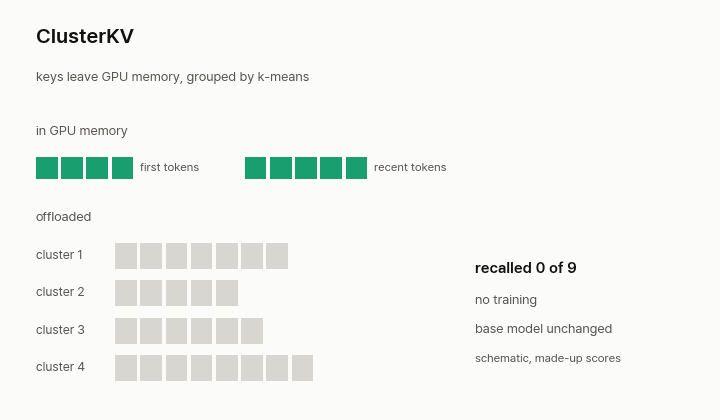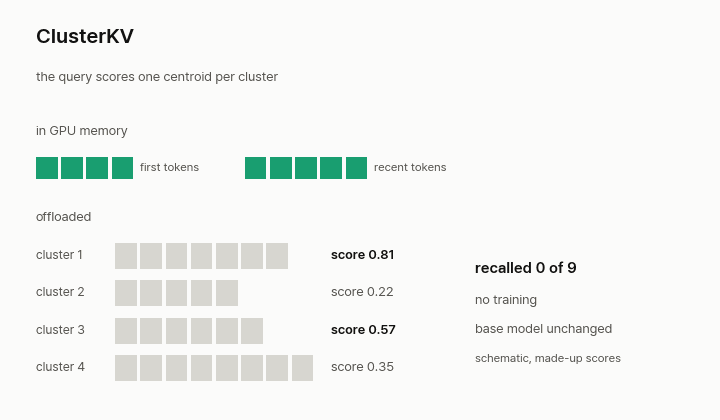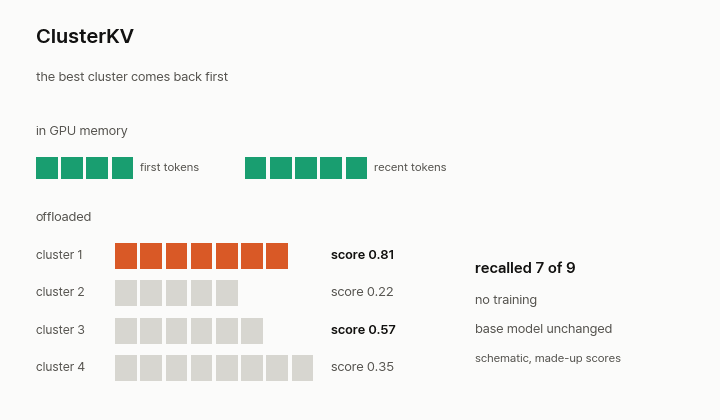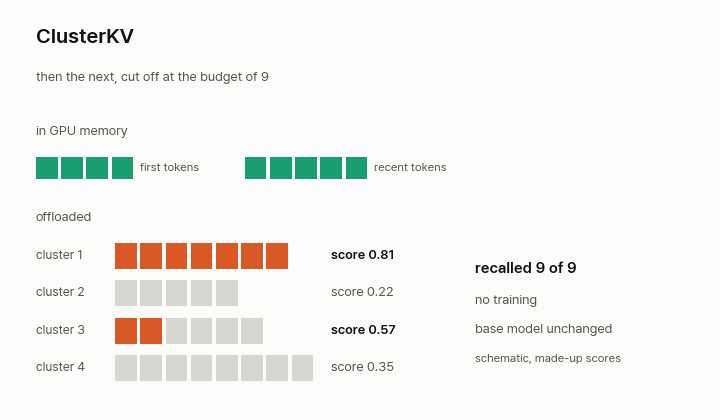
ClusterKV는 학습이 필요 없고 모델도 바꾸지 않는, 추론 단계의 캐시입니다. key를 k-means로 묶어 GPU 메모리에서 내려놓고, 매 단계 좋은 묶음부터 예산만큼 다시 올립니다. 논문은 컨텍스트 32K에 예산 1K에서 2K일 때 정확도 손실이 무시할 만하다고 보고합니다. 새로 생성한 토큰 320개마다 따로 묶고, 처음 16개 토큰은 항상 남기며, centroid를 L/80개로 시작하는데, 이 관리 부분은 뺐습니다.
- 나아진 점. 재학습 없이 KV를 GPU 메모리 밖에 둘 수 있습니다. 예산 1024에서 LongBench 8개 데이터셋 평균은 48.34로, 앞선 캐시 방법인 Quest의 43.23과 InfiniGen의 45.13보다 높습니다. 프롬프트 32K, 디코딩 1,024토큰, 예산 1,024일 때 지연 시간은 최대 절반으로 줄고, 디코딩 처리량은 최대 2.5배까지 올라갑니다.
- 이유. 위치가 아니라 내용으로 다시 불러오므로, query가 원하는 key가 컨텍스트 어디에 있어도 돌아올 수 있습니다.
- 대가. 예산을 어떻게 잡아도 전부 남기는 것보다는 낮습니다. 전체 캐시의 49.01에 비해 예산 256에서 46.69, 2,048에서 48.7입니다. OPT-6.7B와 예산 256으로 InfiniGen과 비교한 실험에서 고르는 데 디코딩 지연의 약 5%가 듭니다. 묶는 작업도 prefill의 6-8%, 전체 추론의 2% 미만을 차지합니다.
def clusterkv_recall(q, kept, evicted, labels, centroids, budget):
    """An inference-time cache: keys leave GPU memory grouped by k-means, except the first tokens and recent
    ones. Each step scores the centroids and recalls keys from the best clusters until the budget is full.
    No training, and the base model is unchanged."""
    back = []
    for c in (q @ centroids.T).argsort(descending=True).tolist():
        back += (labels == c).nonzero().squeeze(-1).tolist()
        if len(back) >= budget:
            break
    return torch.cat([kept, evicted[back[:budget]]])
22. Latent Sparse Attention (Kubicek, 2026)
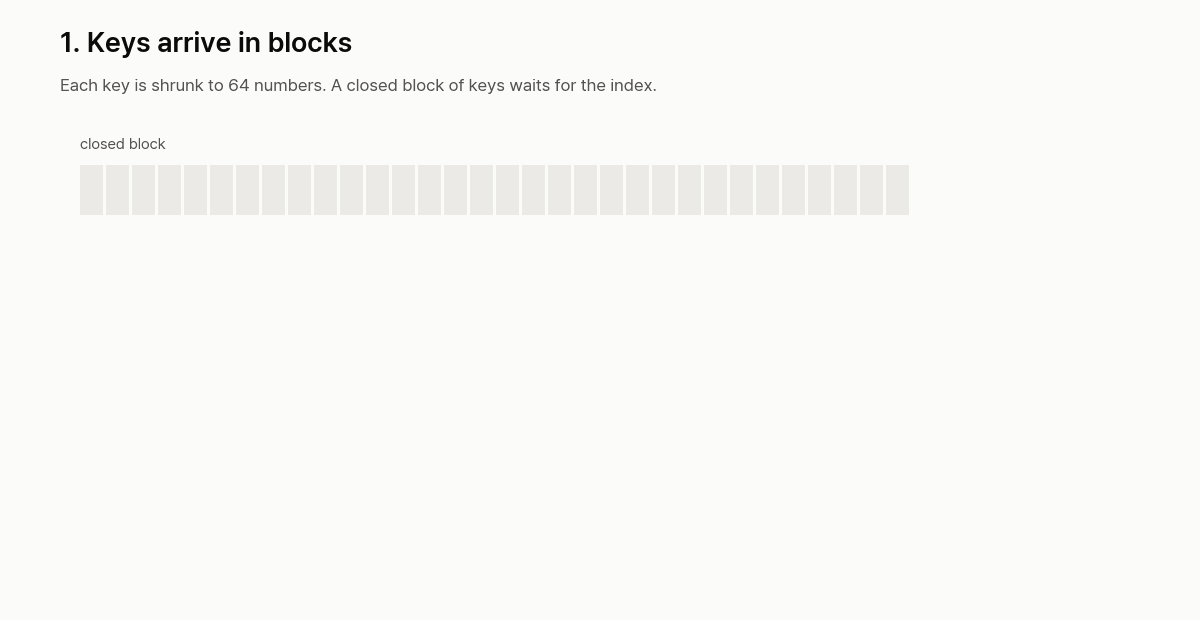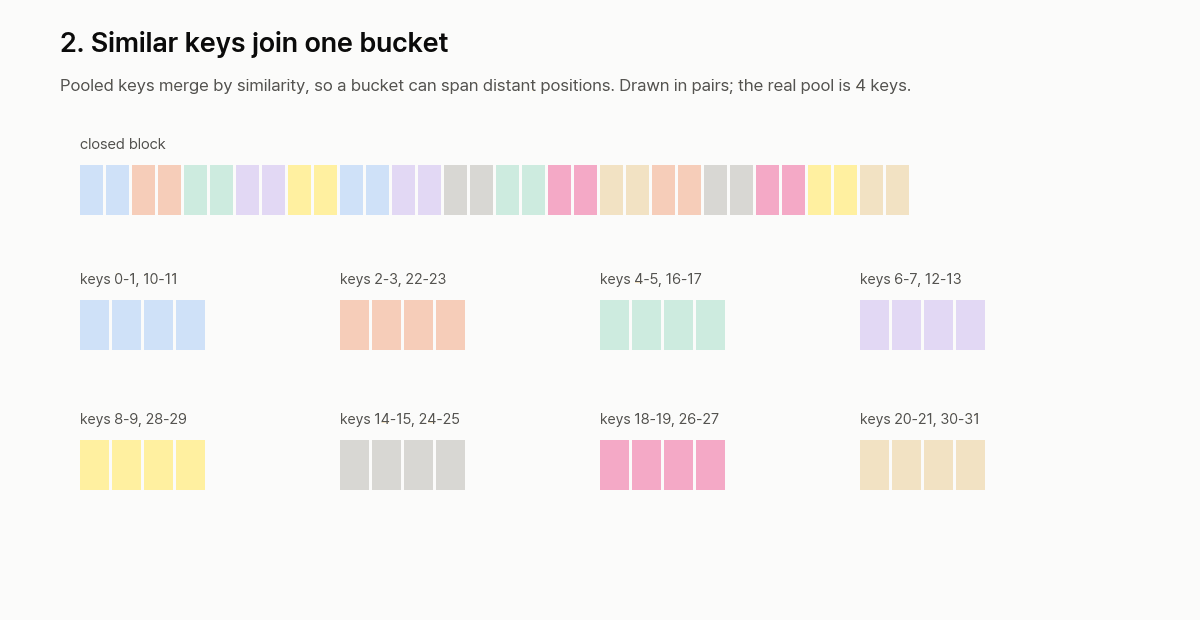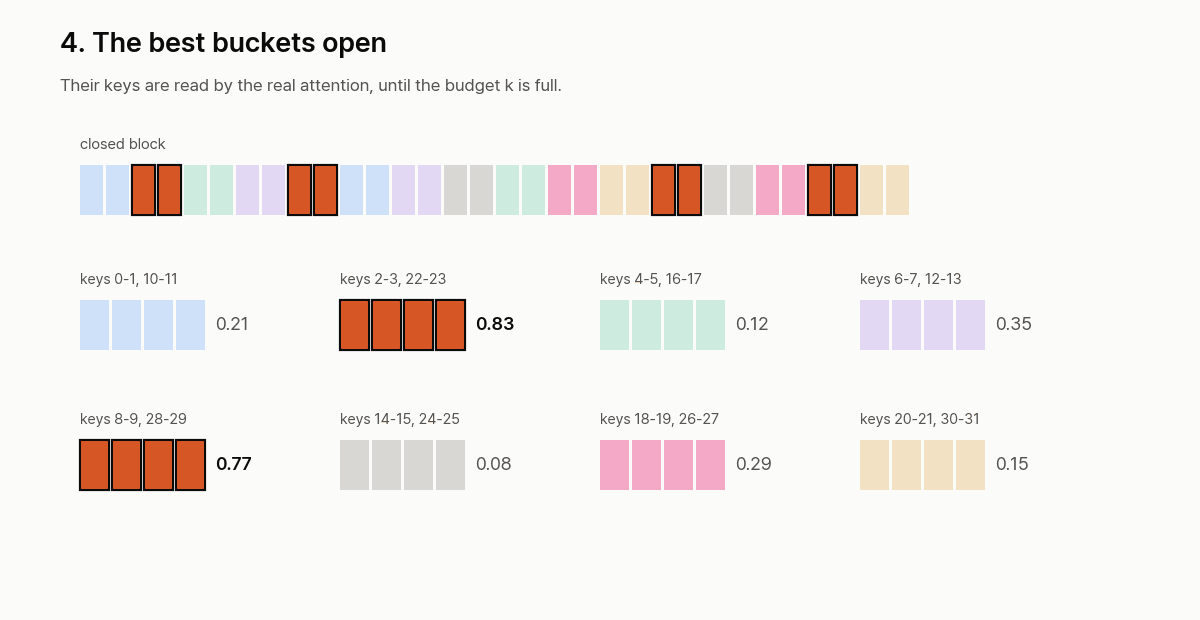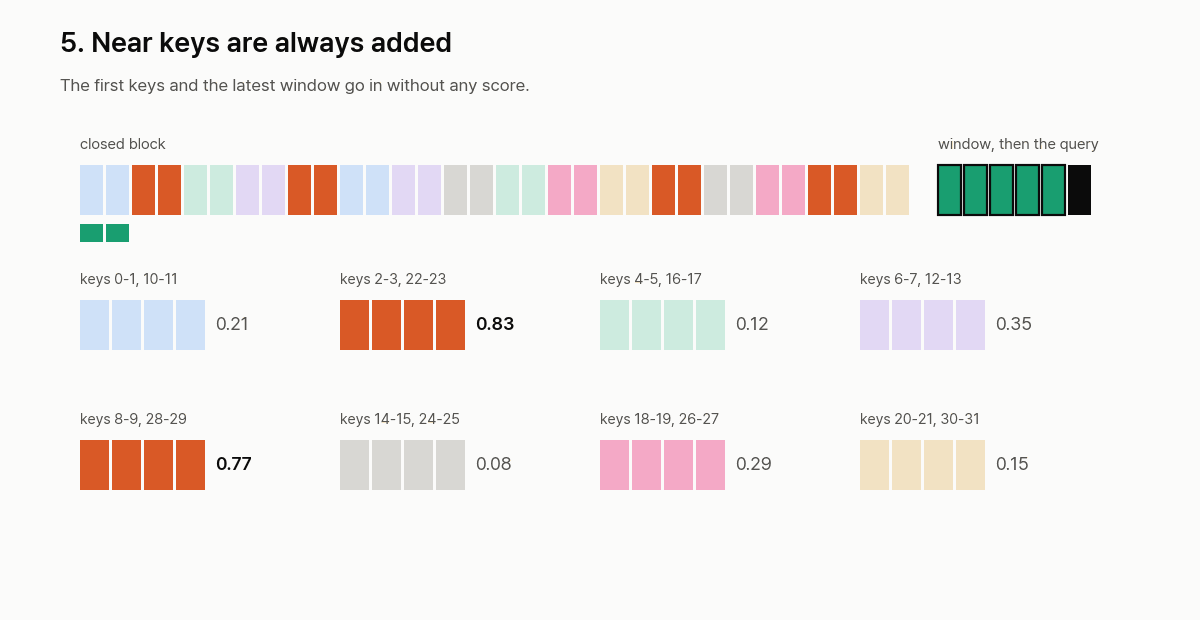
LSA는 모델에 맞춘 작은 인덱스 공간에서 비슷한 key를 버킷으로 묶습니다. 그래서 query는 key가 아니라 버킷에 점수를 매깁니다. 맨 앞 key와 최근 window는 점수 없이 항상 읽습니다. 저희 함수는 query 하나의 flat search만 보여 주며, pooling, clustering, tree search는 뺐습니다. 논문의 대표 수치는 H200에서 1,000만 토큰 기준입니다. 그 수치와 짧은 컨텍스트에서 줄어드는 정도, 저희가 작은 인덱스로 직접 잰 결과는 LSA 글에 있습니다.
- 나아진 점. 논문은 H200 한 장, 1,000만 토큰, Qwen3.8-27B 레이어 하나에서 prefill이 full attention보다 72.4배 빠르다고 보고합니다. H200 8장에서 모델 전체로 재면 첫 토큰까지 9.21배입니다.
- 이유. query가 key가 아니라 버킷에 점수를 매깁니다. 저희 계산으로 1,000만 토큰에서 점수 수가 token scan의 약 8분의 1이고, 고른 key 4,096개는 그대로 읽습니다.
- 대가. 시간은 아껴도 메모리는 아끼지 못해서, KV 캐시는 컨텍스트와 함께 계속 늘어납니다. 짧은 컨텍스트에서는 이득이 줄어 512K에서 모델 전체의 첫 토큰은 1.03배입니다. GLM-5.3-Flash에서는 200만-500만 토큰 구간에서 그 모델의 sparse attention보다 최대 8점 낮습니다. 논문은 기준선이 모델과 함께 학습됐으니 기준선에 유리한 비교라고 덧붙입니다.
def read_list(q, centroids, members, pos, top_p, k, window=512, sinks=4):
    """Which keys one query reads. q and centroids are unit vectors in the small index space."""
    near = set(range(sinks)) | set(range(max(0, pos - window), pos + 1))
    scores = centroids @ q                       # one score per bucket, not per key
    picked = scores.topk(min(top_p, len(scores))).indices
    far = []
    for b in picked.tolist():                    # open the best buckets first
        far += [key for key in members[b] if key not in near]
        if len(far) >= k:
            break
    return sorted(near | set(far[:k]))
길이에 선형: 늘어나는 목록을 읽지 않습니다
마지막 묶음은 비용이 커지는 원인 자체를 없앱니다. 대부분 query를 key 목록과 아예 비교하지 않습니다.
23. Linear Transformer (Katharopoulos, 2020)
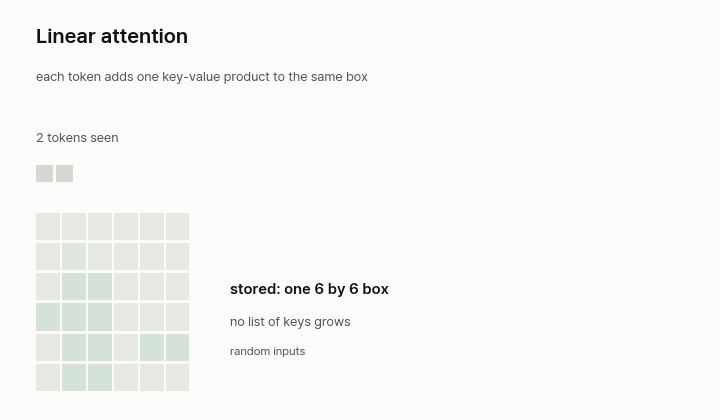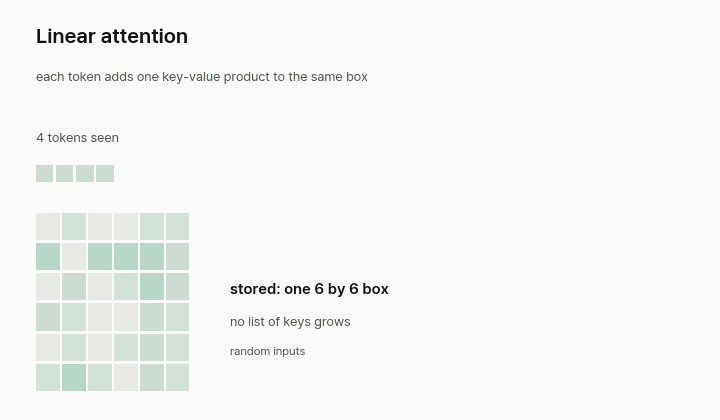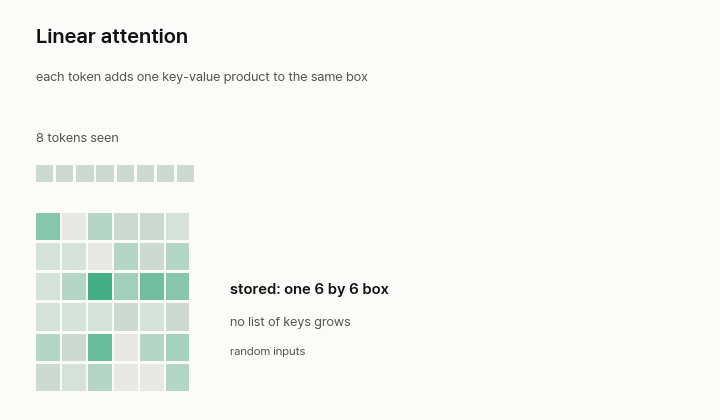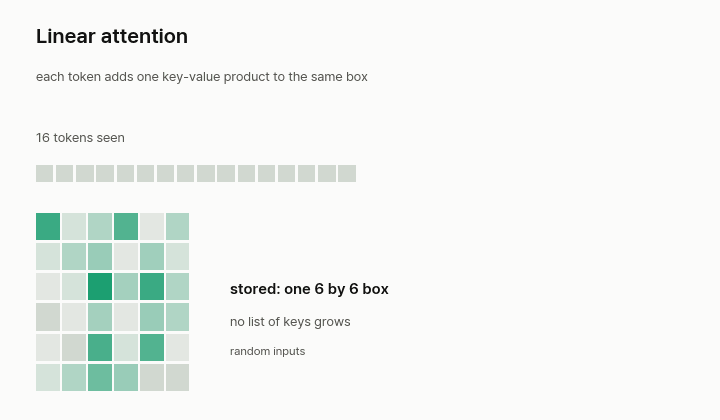
Transformers are RNNs는 softmax 대신 양수 feature를 씁니다. 덕분에 목록 자리에 누적 합을 쓸 수 있어 길이와 상관없이 메모리가 일정합니다. CPU 검사에서 이 누적 방식의 출력이 causal 합을 직접 계산한 값과 같음을 확인했습니다. GIF는 같은 누적 식을 무작위 입력으로 돌린 것입니다.
- 나아진 점. 생성 속도가 크게 빨라졌습니다. CIFAR-10에서 초당 17.85장으로 KV 캐시 없는 softmax의 0.004장보다 4,462배, 캐시를 쓴 softmax의 0.32장보다 약 56배(저희 계산) 빠릅니다. 일주일 학습 예산에서 3.40 bits/dim으로 3.47보다 낮았습니다(낮을수록 좋음).
- 이유. key 목록 자리에 누적 합을 쓰므로, 시퀀스가 아무리 길어도 새 토큰 하나의 비용이 같습니다.
- 대가. 품질이 떨어질 수 있습니다. WSJ 음성 인식의 검증 음소 오류율은 8.08로 softmax의 5.12보다 나쁘고, 에포크당 시간은 824초와 2,711초입니다. 3.3배 빠른 대신 눈에 띄게 부정확합니다. Gated DeltaNet 논문도 기본 linear attention이 언어 모델링에서 뒤처진다고 적었습니다.
def linear_attention(q, k, v):
    """elu + 1 keeps features positive, so a sum replaces the softmax. Memory stays fixed however long the input."""
    phi = lambda x: F.elu(x) + 1
    S, z, out = torch.zeros(k.shape[-1], v.shape[-1]), torch.zeros(k.shape[-1]), []
    for qi, ki, vi in zip(phi(q), phi(k), v):
        S = S + torch.outer(ki, vi)              # the state replaces the list of past keys
        z = z + ki
        out.append(qi @ S / (qi @ z))
    return torch.stack(out)
24. Linformer (Wang, 2020)
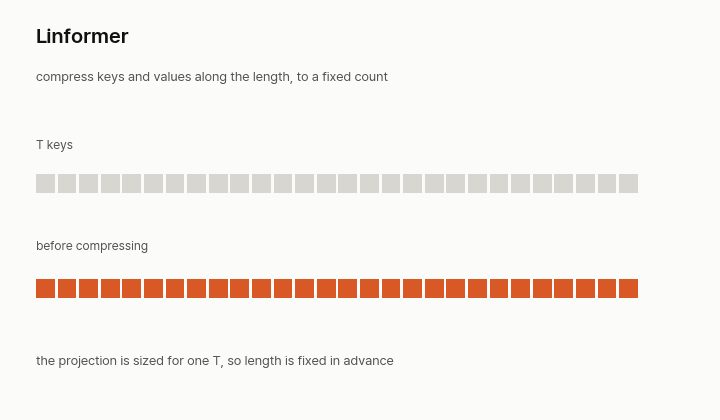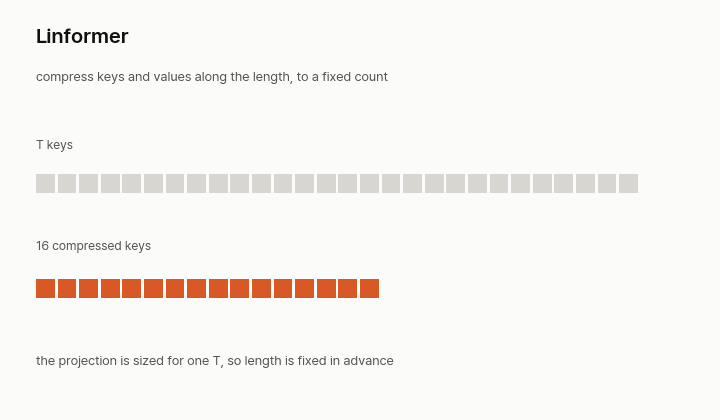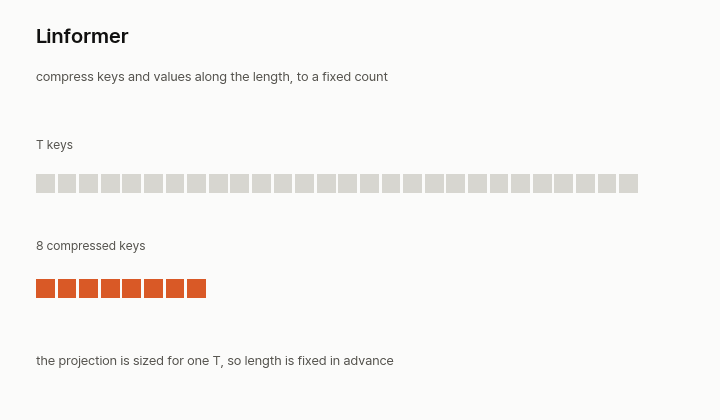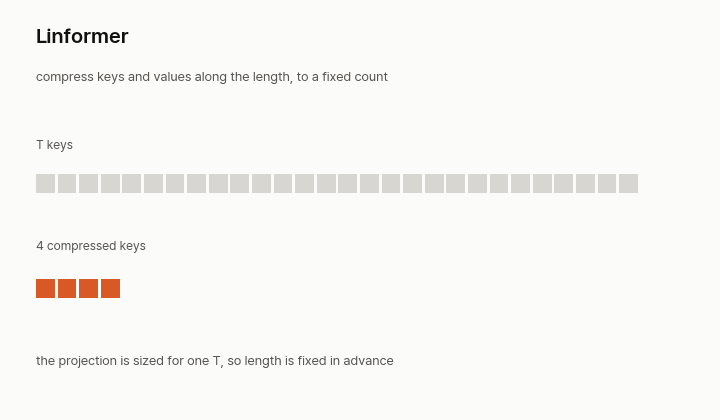
Linformer는 key와 value를 길이 방향으로 projection해 n과 무관한 고정 개수 c(논문의 k)로 줄이며, 비용은 O(nk)입니다. projection 행렬 크기가 길이에 맞춰져 있어서 길이를 미리 정해야 하고, 토큰마다 늘어나는 캐시와는 맞지 않습니다.
- 나아진 점. 시퀀스가 길수록 시간과 메모리를 크게 아낍니다. n=512, k=128에서 추론은 1.5배 빠르고 배치는 1.7배 커집니다. n=65536, k=128에서는 20배 빠르고 메모리는 60분의 1입니다(V100). n=512의 평균 분류 정확도는 k=128에서 91.75, k=256에서 92.08로 RoBERTa-base의 92.25와 비슷합니다.
- 이유. 논문은 self-attention이 낮은 rank에 가깝다는 점을 보이고, 그래서 key와 value를 길이 방향으로 크게 줄여도 내용이 남습니다.
- 대가. 품질은 k를 어떻게 고르느냐에 달려 있고, projection은 길이 하나에 맞춰져 있습니다. 나중에 Performer는 causal이 아니며 PG-19에서 성능이 정체된다는 점을 지적합니다.
def linformer(q, k, v, E, F_):
    """Compress T keys and values along the length to a fixed c. E and F_ are [c, T], so T is fixed in advance."""
    return attend(q, E @ k, F_ @ v)
25. Performer (Choromanski, 2020)
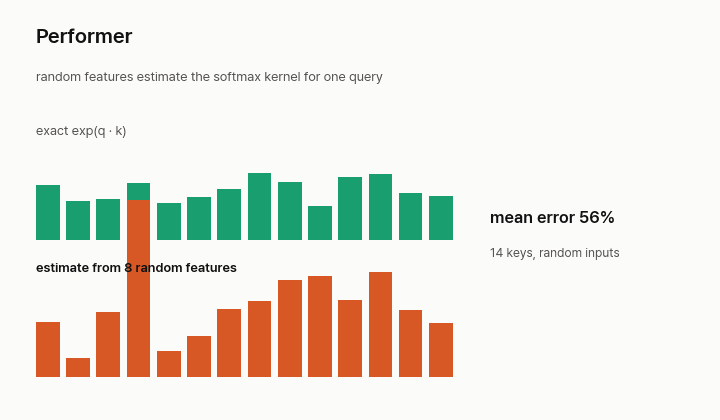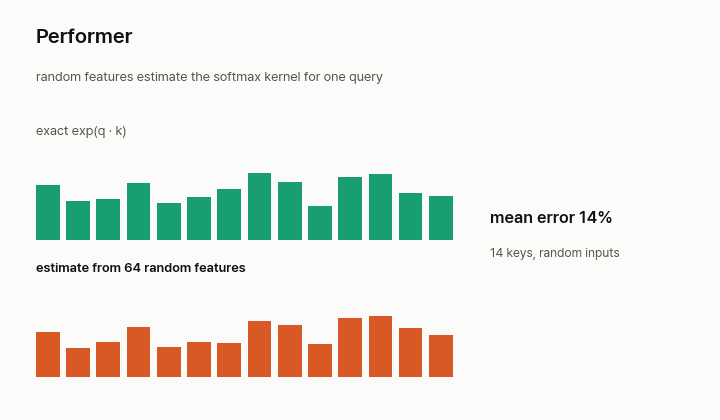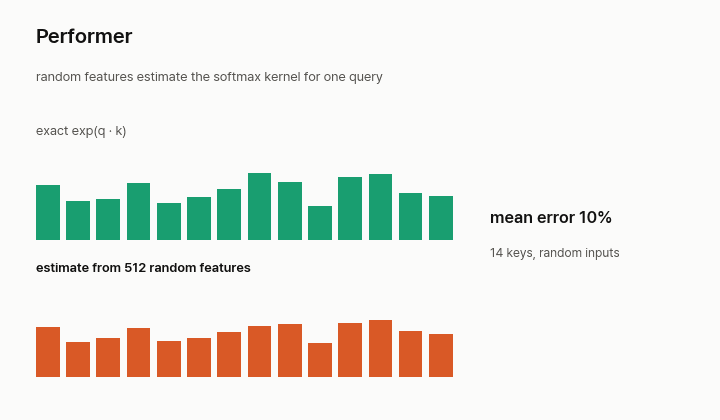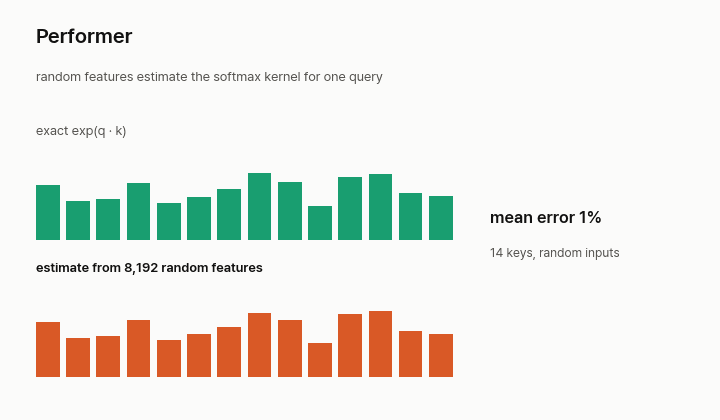
Performer는 양수 random feature로 softmax kernel을 추정합니다. 그래서 오른쪽 두 행렬을 먼저 곱할 수 있고, full attention의 O(L²d)가 O(Lrd)로 줄어듭니다. 논문은 음수가 나오는 sin·cos feature를 쓰지 않으며, performer_features는 논문의 양수 형태입니다(Lemma 1). GIF는 이 함수에 작은 무작위 입력을 넣은 결과이므로 오차는 예시일 뿐입니다. 직교 feature와 입력 크기 조정, prefix sum을 쓰는 causal 버전은 뺐습니다.
- 나아진 점. 앞선 빠른 설계들은 희소성이나 low-rank 가정을 더했지만, Performer는 softmax 형태를 유지한 채 추정합니다. 36레이어 TrEMBL에서 정확한 softmax와 정확도가 같습니다.
- 이유. 양수 random feature가 kernel을 두 인수로 나누므로, 곱하는 순서를 싼 쪽으로 바꿀 수 있습니다.
- 대가. 작은 오차가 레이어를 거치며 퍼지므로 아주 정밀한 추정이 필요할 수 있습니다. softmax 모델 가중치를 옮겨 오면 정확도 0.07에서 시작해 fine-tuning이 조금 필요합니다. PG-19에서는 양수 feature와 재추출을 함께 써야 Transformer에 맞먹고, sin·cos feature는 불안정합니다.
def performer_features(x, omega):
    """Positive random features whose dot product estimates the softmax kernel exp(x @ y). omega is [D, d]."""
    return (x @ omega.T - x.pow(2).sum(-1, keepdim=True) / 2).exp() / math.sqrt(len(omega))

def performer(q, k, v, omega):
    fq, fk = performer_features(q, omega), performer_features(k, omega)
    weights = fq @ (fk.T @ v)                    # multiply the right pair first: cost grows with T, not T squared
    return weights / (fq @ fk.sum(0, keepdim=True).T)
26. Mamba (Gu, 2023)
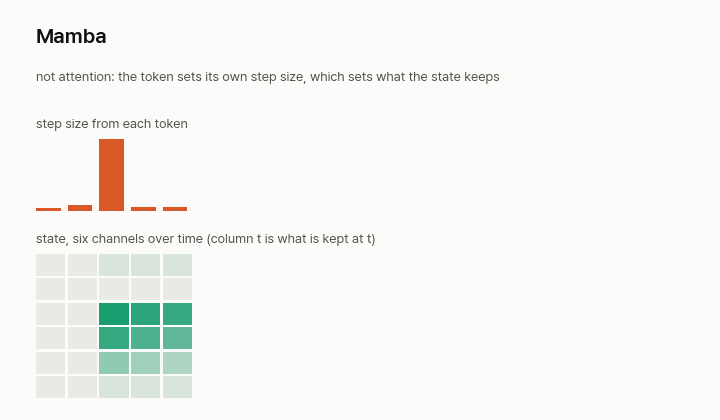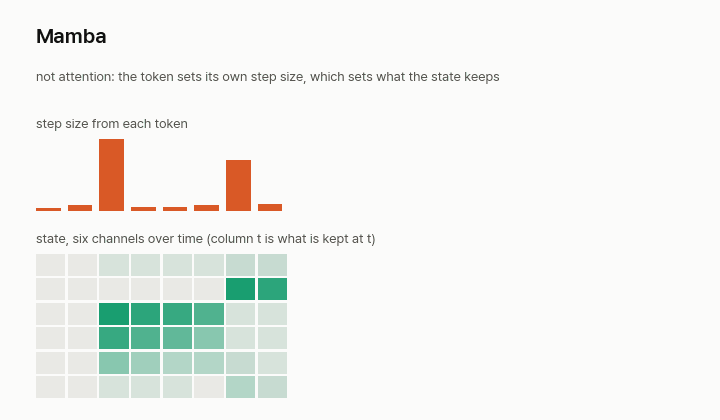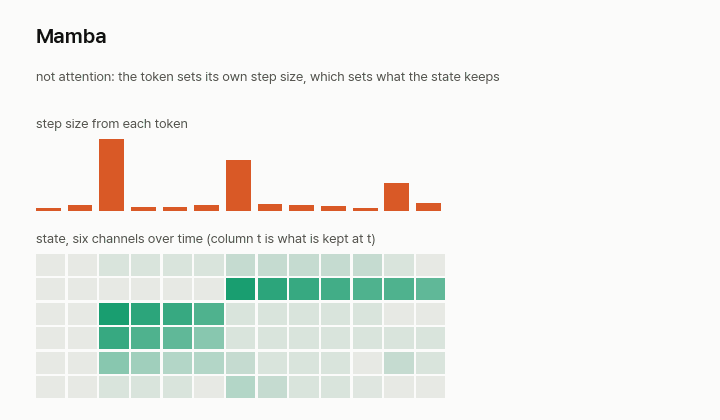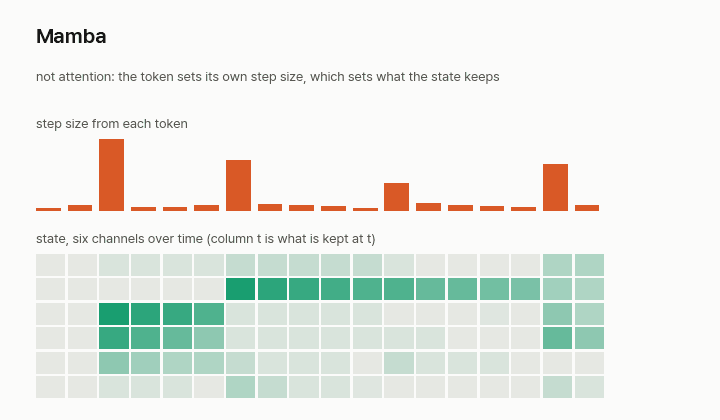
Mamba는 어텐션이 아닙니다. 어텐션과 섞은 hybrid가 있어서 넣었습니다(정리 글의 AI21 Jamba). Gu와 Dao는 Transformer급 성능을 내는 "first linear-time sequence model"이라고 소개합니다. state-space 모델이 고정 크기 상태를 한 단계씩 밀고 가는데, 현재 토큰이 step 크기와 입력·출력 변환을 정하므로 무엇을 남길지도 토큰이 정합니다. 여기서는 대각 행렬 A를 쓴 한 채널만 보여 드립니다.
- 나아진 점. 논문이 예전 state-space 모델의 약점으로 꼽은 내용 기반 추론이 나아졌습니다. Mamba-2.8B는 The Pile perplexity 6.22(낮을수록 좋음)와 벤치마크 평균 63.3으로, Pythia-2.8B의 6.73과 59.1을 앞섭니다. 추론 처리량은 비슷한 크기의 Transformer보다 4-5배 높습니다.
- 이유. 현재 토큰이 파라미터를 정하므로 모델이 무엇을 남길지 고릅니다. 저장할 KV 캐시가 없어 배치를 키울 수 있고, 논문은 처리량 이득을 여기에 돌립니다.
- 대가. 모든 내용을 고정 크기 상태에 담아야 하며, 논문도 이를 한계로 적었습니다. Gated DeltaNet 논문은 입력을 2K 토큰으로 자른 retrieval 평균에서 Mamba 21.0, Transformer++ 37.0을 보고합니다.
저희는 다른 글에서 작은 Mamba 하이브리드인 Granite-4.0-H-350M에 문장 하나를 넣어 층마다 따라가 봤습니다. 어텐션 4개 층을 끄면 18토큰 문장에서는 여전히 맞는 이름을 골랐지만, 1,410토큰에서는 그 확률이 0.002로 떨어졌습니다.
def mamba_step(h, x, A, B, C, delta):
    """A selective state-space step with diagonal A, one channel. The token sets the step size and also the
    input and output maps, so it decides what the state keeps and what gets read out. No attention at all."""
    d = delta(x)                                 # step size, from the current token
    a_bar = (d * A).exp()                        # zero-order hold of a diagonal system
    b_bar = (a_bar - 1) / A
    h = a_bar * h + b_bar * B(x)
    return h, (C(x) * h).sum(-1)
27. Gated DeltaNet (Yang, 2024)
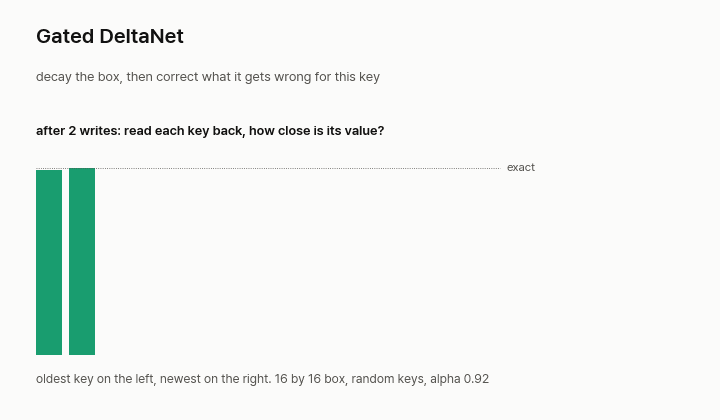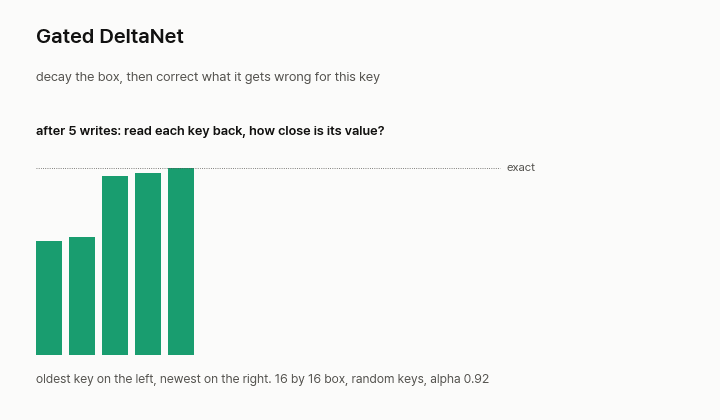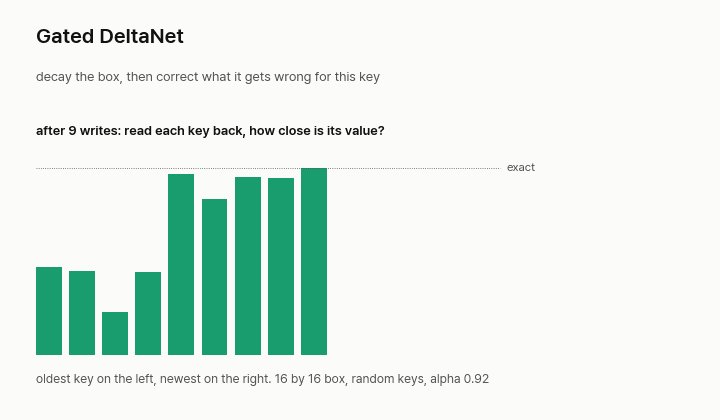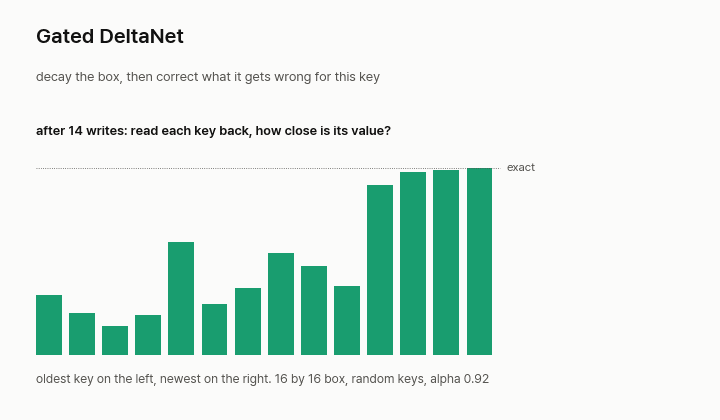
Gated DeltaNet은 고정 크기 행렬 하나를 둡니다. 매 단계 alpha로 줄인 뒤, 지금 key에서 틀린 만큼 고칩니다. 그래서 가장 최근 key는 잘 읽힙니다. 논문은 alpha가 0에 가까우면 기억이 지워지고 1에 가까우면 지금 오차만 고치는 순수 delta rule이 된다고 설명합니다. 정리 글의 최근 Qwen hybrid 모델들은 full attention 레이어와 함께 이것을 씁니다.
- 나아진 점. 고정 크기 상태에서 내용을 더 잘 꺼냅니다. 파라미터 1.3B의 건초더미 속 바늘 찾기 시험에서 S-NIAH-2 4K는 92.2로 Mamba 2의 56.2, DeltaNet의 18.6보다 높습니다. S-NIAH-1 8K는 91.8로 Mamba 2의 30.4보다 높지만, 여기서는 DeltaNet이 98.8로 앞섭니다.
- 이유. delta rule은 이번 key에서 틀린 만큼 상태를 고치고, gate는 오래된 내용을 흐리게 해 새 내용이 들어갈 자리를 만듭니다.
- 대가. 고정 크기 상태는 결국 찹니다. S-NIAH-2 8K는 29.6으로 떨어지고, retrieval 평균은 30.6으로 Transformer++의 37.0보다 낮습니다. 학습 토큰을 맞춘 Kimi 논문 표에서도 GDN-H 평균은 51.2로 MLA의 52.2보다 낮습니다.
def gdn_step(S, k, q, v, alpha, beta):
    """Delta rule: S is a matrix of fixed size. Decay it by alpha, then correct what it gets wrong for this key."""
    S_kept = alpha * S
    S = S_kept - beta * torch.outer(S_kept @ k - v, k)
    return S, S @ q
28. Kimi Delta Attention (Kimi Team, 2025)
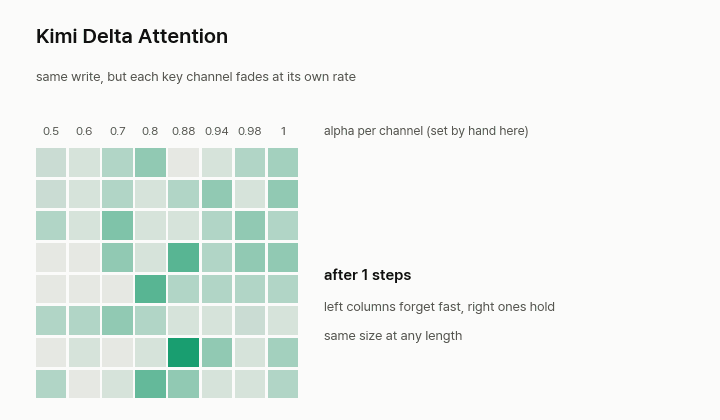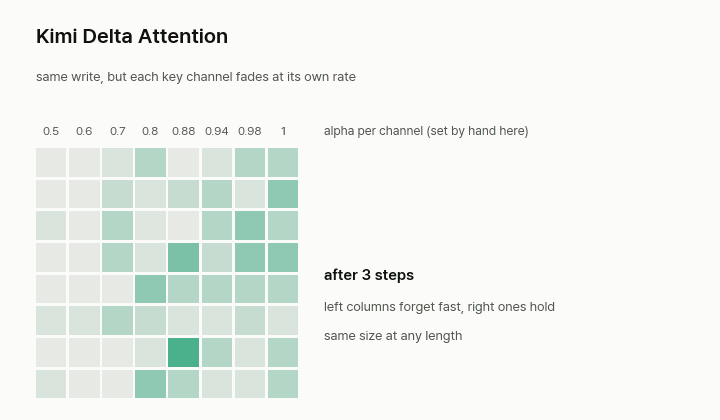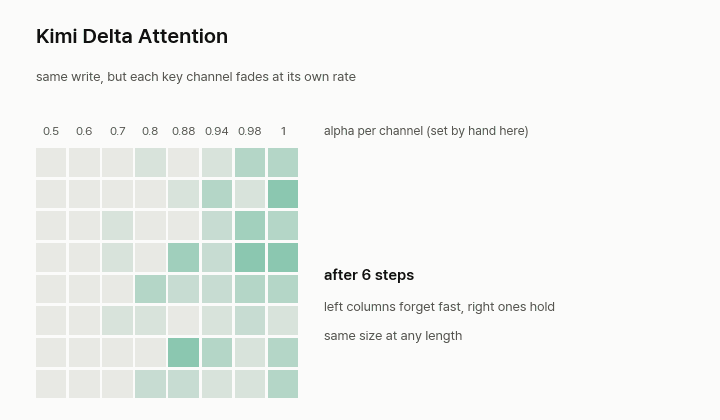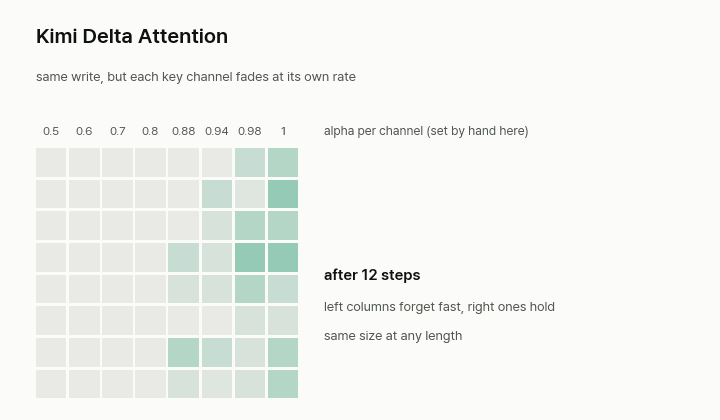
Kimi Linear는 쓰는 식은 같고, key 채널마다 감쇠율을 따로 두며, 읽을 때는 query를 그대로 씁니다(식 1). key와 query는 L2 정규화하고, 실제 레이어에는 출력 gate가 더 있습니다(식 10). 모델은 KDA와 full MLA 레이어를 3대 1로 섞고, 논문은 이 구조가 KV 캐시 사용량을 최대 75% 줄인다고 보고합니다. CPU 검사에서 alpha를 모두 같게 두면 Gated DeltaNet과 같은 행렬이 나오는 것을 확인했습니다.
- 나아진 점. 128K RULER가 84.3으로 MLA의 81.3, GDN-H의 80.5보다 높고, 평균도 54.5로 52.2와 51.2를 앞섭니다. 모두 학습 토큰 1.4T 기준입니다. 1M 토큰에서 논문이 보고한 decode 속도 향상은 2.3배입니다. 앞세운 숫자인 출력 토큰당 1.84ms와 MLA의 11.48ms(6.3배)는 논문이 이론값이라고 적었고, 이 설계로 키울 수 있는 배치를 이유로 들므로 요청 하나의 속도로 읽으면 안 됩니다.
- 이유. key 채널마다 감쇠율이 달라서, 어떤 채널은 먼 문맥을 오래 붙들고 어떤 채널은 빨리 잊습니다.
- 대가. full MLA 레이어는 남겨야 합니다. 논문은 긴 컨텍스트 검색이 병목이라고 봅니다. 모든 긴 컨텍스트 시험이 나아지지도 않았습니다. LongBench V2는 35.0과 36.1, Frames는 58.8과 60.5로 MLA보다 낮습니다.
def kda_step(S, k, q, v, alpha, beta):
    """Kimi Delta Attention: Gated DeltaNet's write, but alpha decays each key channel at its own rate.
    q and k are L2-normalised."""
    S_kept = S * alpha[None]                     # decay keeps channels independently
    S = S_kept - beta * torch.outer(S_kept @ k - v, k)
    return S, S @ q
새 모델 카드를 볼 때 물어볼 네 가지
이 글의 설계는 모두 다음 네 질문으로 위치를 정할 수 있고, 새 설계를 볼 때도 여기서 시작하면 좋습니다.
- 토큰마다 무엇을 저장합니까? 헤드별 key와 value, 그룹별 key와 value, 작은 벡터 하나, 또는 고정 크기 상자뿐일 수 있습니다.
- query가 어떤 key를 읽을 수 있습니까? 전부, 고정 마스크, 아니면 고른 일부입니다.
- 고른다면 무엇에 점수를 매깁니까? key 전부, 블록 전부, 또는 내용으로 묶은 그룹입니다.
- 어느 레이어에 적용합니까? 위 모델 다수가 레이어마다 설계를 섞으므로, 이름표 하나로 모델 전체를 설명하기는 어렵습니다.
확인한 것과 확인하지 않은 것
CPU에서 돌린 것. 출력 크기, causal 마스크가 미래를 읽지 않는지, Luong general 형태에 단위 행렬을 넣으면 dot 형태와 같은지, GQA의 양 끝이 MHA·MQA와 같은지, 큰 sliding window가 full causal 마스크와 같은지, sink 마스크의 key 수와 맨 앞 key, local-global 레이어가 window와 전체 마스크로 바뀌는지, Sparse Transformer가 두 단계로 닿는 범위, Longformer의 대칭과 window·전역 행, BigBird가 Longformer에 key만 더하는지, block scan이 이긴 묶음만 읽는지, Reformer가 혼자일 때만 자신을 읽는지, ClusterKV와 LSA 예산의 key 수, linear attention의 누적 방식과 직접 합, 작은 입력에서 Performer 추정값과 실제 kernel, alpha=1, beta=1일 때 delta rule이 정확히 쓰는지, alpha가 모두 같을 때 Kimi Delta Attention이 Gated DeltaNet과 같은지를 봤습니다.
원문과 대조한 것. 함수마다 논문과 비교했고, 뺀 내용은 각 항목에 적었습니다. sliding window와 local-global은 원전이 하나로 정해져 있지 않고, block scan은 LSA 논문의 설명에만 기댔습니다.
하지 않은 것. 어떤 설계도 학습하지 않았고, 속도나 정확도 수치도 재현하지 않았습니다. 실제 구현을 빠르게 만드는 최적화된 저수준 코드도 함수에 없습니다. 어떤 설계가 직접 쓰는 모델에 가장 좋은지는 이 글로 판단할 수 없습니다. 현재 모델에서 각 설계의 비용을 실제 config 값으로 보시려면 일곱 가지 설계 정리 글로 이어 가시면 됩니다.