LLM에 적용된 다양한 어텐션 방법들 구현하기: Multi-head attention부터 Gated DeltaNet까지
MHA, MQA, GQA, sliding window, attention sink, 가중치를 흡수한 MLA, DSA식 희소 어텐션, Gated DeltaNet을 각각 짧은 PyTorch 함수로 짜고, 설명대로 동작하는지 확인했습니다. MLA는 DeepSeek-V2-Lite의 실제 0번 층 가중치로 확인했고, 코드로 계산한 Qwen3.5-9B 상태 크기는 llama.cpp가 찍은 50.25 MiB와 같았습니다.
LLM에 적용된 다양한 어텐션 방법들 구현하기: Multi-head attention부터 Gated DeltaNet까지
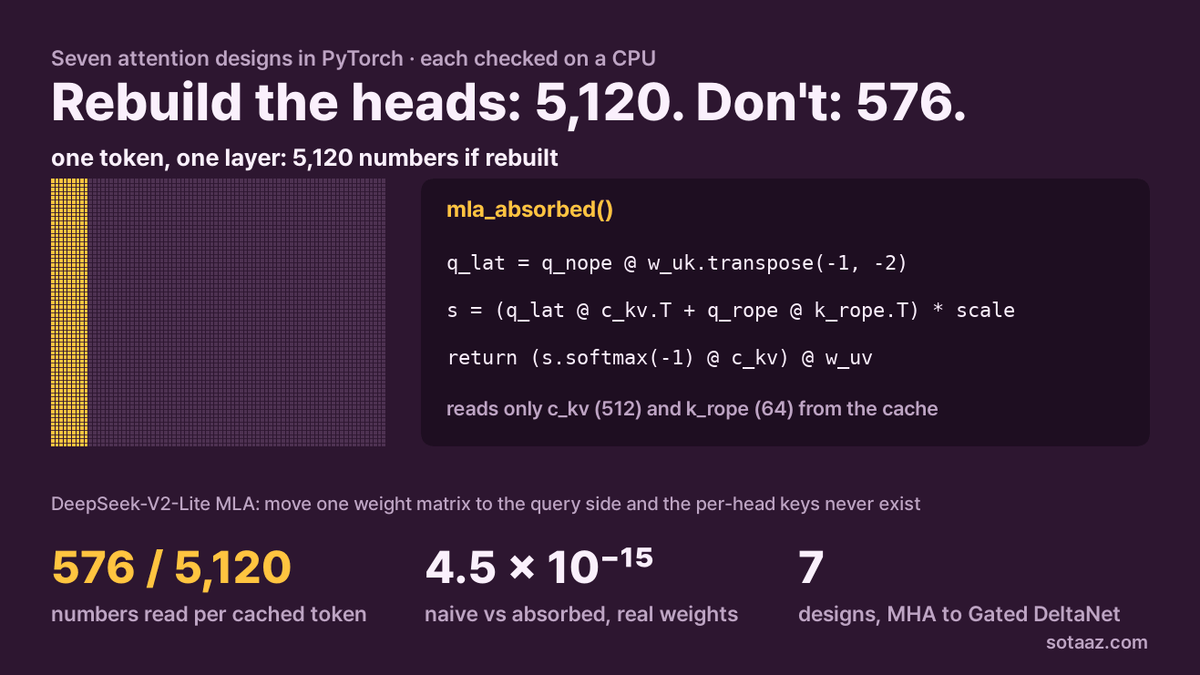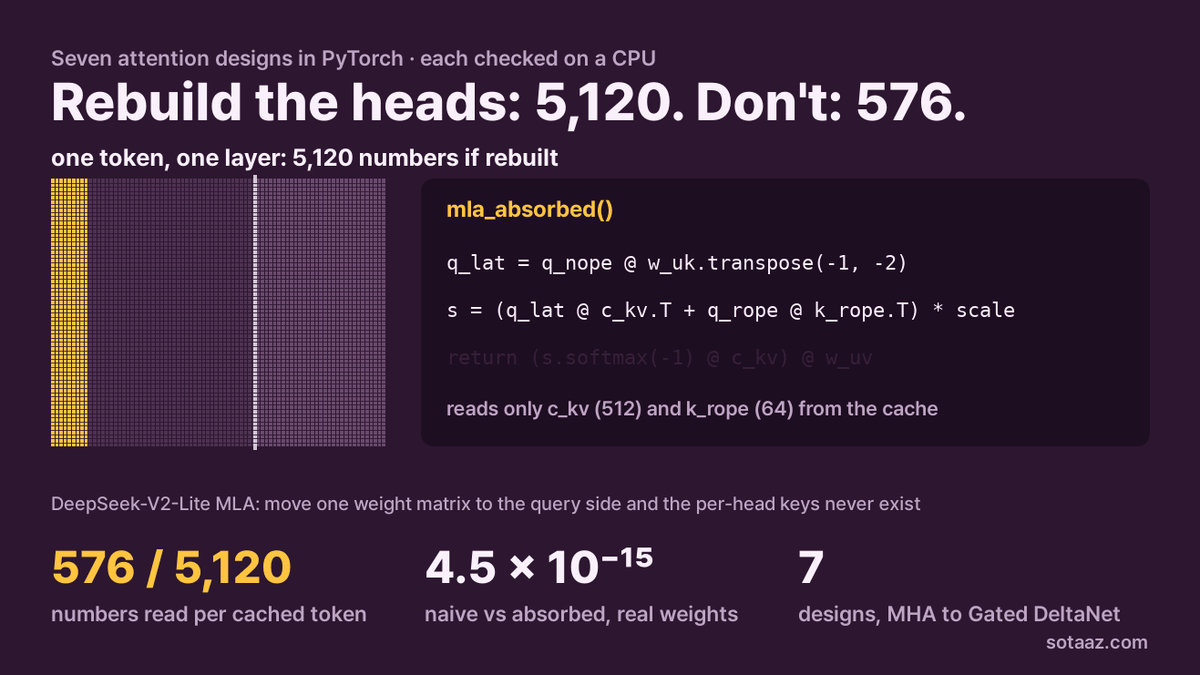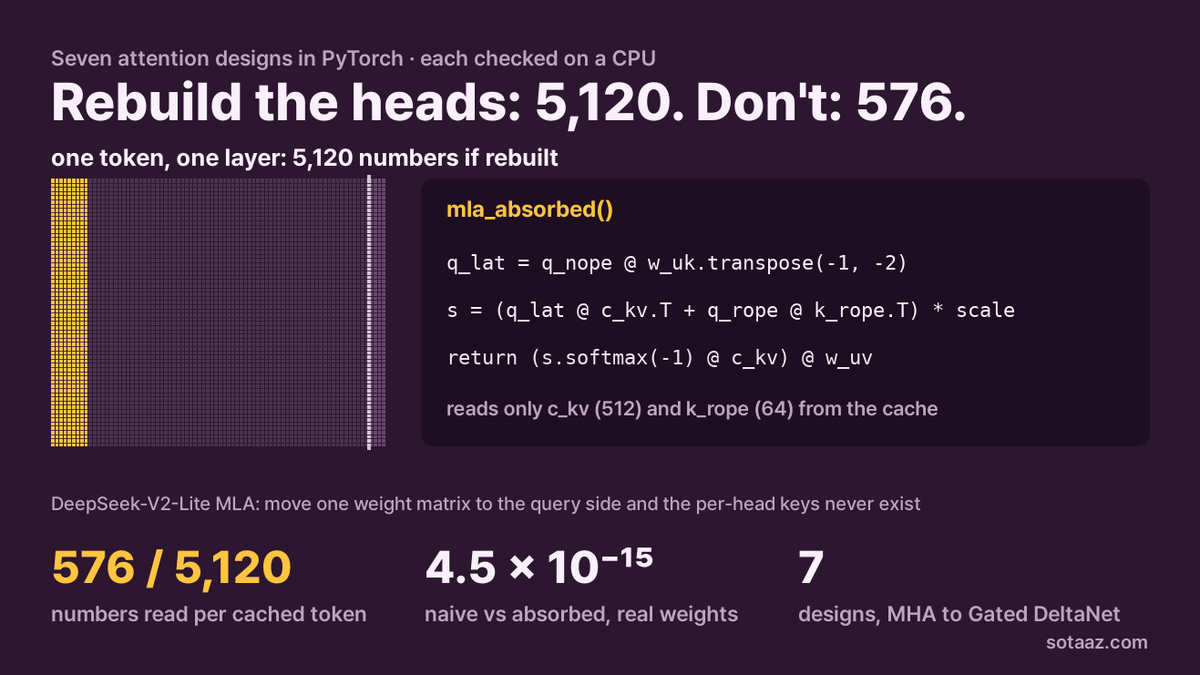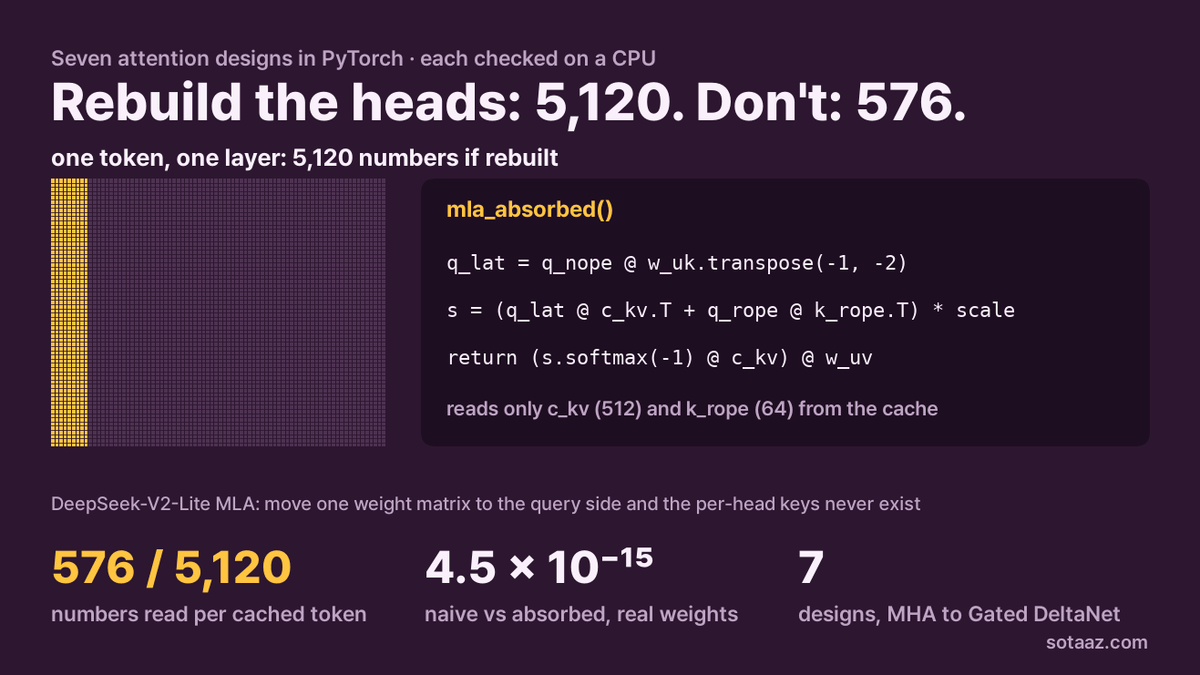
DeepSeek-V2-Lite는 토큰 하나, 층 하나에 숫자 576개를 저장합니다. 그런데 이 모델의 어텐션 헤드 16개가 쓰는 key와 value를 모두 합치면 5,120개입니다. multi-head latent attention(MLA)을 수식에 적힌 순서대로 짰더니, 코드는 매 단계마다 캐시에 든 토큰 전부에 대해 이 5,120개를 다시 만들었습니다. 답은 맞습니다. 하지만 이렇게 하면 MLA를 쓰는 의미가 사라집니다. 저장은 작게 해도, 매 단계 읽고 만드는 것은 큰 쪽이기 때문입니다.
해결은 세 줄입니다. 가중치 행렬 하나를 key 쪽에서 query 쪽으로 옮기면 됩니다. 두 버전을 DeepSeek-V2-Lite의 실제 0번 층 가중치로 돌렸더니 출력이 4.5 × 10⁻¹⁵ 안쪽으로 같았습니다. 그리고 두 번째 버전은 헤드별 key를 한 번도 만들지 않습니다.
이 글은 이런 것을 코드로 보여 드립니다. 이 연재의 첫 글에서는 어텐션 설계 일곱 가지를 글로 설명했습니다. 각 설계가 무엇을 저장하는지, 어떤 모델이 쓰는지, 무엇을 포기하는지였습니다. 이번에는 설계마다 짧은 PyTorch 함수를 하나씩 짜고, 그 함수가 설명대로 동작하는지 확인합니다. 예를 들어 W토큰짜리 sliding 캐시가 마스크를 씌운 계산과 같은 답을 내는지, grouped-query attention이 가중치를 공유한 multi-head attention과 같은지, linear attention의 누적 상태가 어텐션 모양으로 계산한 결과와 같은지를 봅니다. 확인은 모두 CPU에서 float64로 1초 안에 끝나고, 전부 통과했습니다. 코드는 읽기 쉽게 짰고 빠르게 짜지는 않았습니다. 실제 커널은 이 코드와 전혀 다르게 생겼습니다.
모든 설계가 쓰는 함수 하나
아래 설계들은 모두 같은 연산으로 끝나기 때문에 함수 하나로 묶었습니다. q, k, v는 헤드별 텐서이고 모양은 (헤드 수, 토큰 수, 헤드 크기)입니다. mask는 각 query가 어떤 토큰을 볼 수 있는지 정하고, causal은 "지나간 토큰만 본다"는 흔한 마스크를 만듭니다. 창 크기를 주면 그 창으로 자릅니다. sink는 3절에서 설명하겠습니다.
def attend(q, k, v, mask=None, sink=None):
    """q: (H, Tq, d), k and v: (H, Tk, d). mask: (Tq, Tk) bool, True = may look. sink: (H,) logits or None."""
    s = q @ k.transpose(-1, -2) / math.sqrt(q.shape[-1])
    if mask is not None:
        s = s.masked_fill(~mask, float("-inf"))
    if sink is not None:  # one extra logit per head with no value behind it
        s = torch.cat([s, sink.view(-1, 1, 1).expand(-1, s.shape[1], 1)], dim=-1)
        return s.softmax(-1)[..., :-1] @ v
    return s.softmax(-1) @ v


def causal(Tq, Tk, window=None):
    i = torch.arange(Tk - Tq, Tk)[:, None]  # positions of the new queries
    j = torch.arange(Tk)[None, :]
    m = j <= i
    if window is not None:
        m &= j > i - window
    return m
1. MHA, MQA, GQA: 클래스 하나, 설정 세 가지
multi-head attention(MHA)은 헤드마다 key와 value를 따로 둡니다. multi-query attention(MQA)은 모든 헤드가 key와 value 하나를 함께 씁니다. grouped-query attention(GQA)은 그 중간으로, 같은 묶음의 헤드끼리 하나를 나눠 씁니다. 코드에서는 숫자 하나만 다릅니다. key-value 헤드를 몇 개 만들어 저장하느냐입니다.
class GQA:
    """n_kv == n_heads is MHA, n_kv == 1 is MQA, anything in between is GQA."""

    def __init__(self, dim, n_heads, n_kv, head_dim):
        assert n_heads % n_kv == 0
        self.h, self.kv, self.d = n_heads, n_kv, head_dim
        self.wq = torch.randn(dim, n_heads * head_dim) / dim**0.5
        self.wk = torch.randn(dim, n_kv * head_dim) / dim**0.5
        self.wv = torch.randn(dim, n_kv * head_dim) / dim**0.5

    def __call__(self, x, cache):  # x: (T_new, dim); cache: dict with "k", "v" of shape (n_kv, T_past, d)
        T = x.shape[0]
        q = (x @ self.wq).view(T, self.h, self.d).transpose(0, 1)
        k = (x @ self.wk).view(T, self.kv, self.d).transpose(0, 1)
        v = (x @ self.wv).view(T, self.kv, self.d).transpose(0, 1)
        cache["k"] = torch.cat([cache["k"], k], dim=1) if "k" in cache else k  # only n_kv heads are stored
        cache["v"] = torch.cat([cache["v"], v], dim=1) if "v" in cache else v
        g = self.h // self.kv  # query heads per stored head
        K = cache["k"].repeat_interleave(g, dim=0)  # (n_heads, T_all, d), built on the fly, never stored
        V = cache["v"].repeat_interleave(g, dim=0)
        return attend(q, K, V, causal(T, K.shape[1]))
중요한 줄은 repeat_interleave입니다. 캐시에는 n_kv개 헤드만 들어 있고, query 헤드 수에 맞춘 복사본은 계산할 때마다 만들었다가 버립니다. 저장하지 않습니다.
두 가지를 확인했습니다. 먼저 세 설정 모두, 40토큰짜리 시퀀스를 캐시를 쓰며 한 토큰씩 넣은 결과가 한꺼번에 넣은 결과와 같았습니다(가장 큰 차이 1.1 × 10⁻¹⁵). 다음으로, key-value 헤드가 2개인 GQA는 헤드가 8개인 MHA와 출력이 같았습니다. 이때 MHA는 각 묶음의 key·value 가중치를 그 묶음의 헤드 4개에 똑같이 복사해 둔 것입니다(차이 6.7 × 10⁻¹⁶). GQA가 바로 이것입니다. MHA의 헤드들이 묶음 단위로 같은 것을 저장하도록 맞춘 것이고, 캐시는 묶음 크기만큼 줄어듭니다. 헤드 크기가 16인 헤드 8개라면 토큰 하나가 층마다 MHA에서 256개, 묶음 2개인 GQA에서 64개, MQA에서 32개를 씁니다.
실제 모델이라면 여기에 바이트 수와 층 수를 곱하면 됩니다. Llama 3.1 8B는 2 × KV 헤드 8개 × 128 × 2바이트 × 32층으로 토큰당 128 KiB입니다.
2. Sliding window: 링 버퍼
sliding window 층은 최근 W토큰만 보기 때문에 캐시에도 W칸만 있으면 됩니다. 새 토큰이 들어오면 가장 오래된 칸을 덮어씁니다.
class SlidingCache:
    """Keeps only the last `window` keys and values. Memory stops growing at the window."""

    def __init__(self, n_kv, head_dim, window):
        self.k = torch.zeros(n_kv, window, head_dim)
        self.v = torch.zeros(n_kv, window, head_dim)
        self.w, self.n = window, 0  # n = tokens seen so far

    def add(self, k, v):  # k, v: (n_kv, 1, d) for one new token
        slot = self.n % self.w  # overwrite the oldest token
        self.k[:, slot], self.v[:, slot] = k[:, 0], v[:, 0]
        self.n += 1
        filled = min(self.n, self.w)
        return self.k[:, :filled], self.v[:, :filled]  # order does not matter to softmax
한 바퀴를 돌고 나면 칸의 순서가 뒤섞이지만 문제없습니다. key 집합에 대한 softmax는 key의 순서와 상관이 없습니다. (위치 정보는 RoPE를 통해 캐시에 들어가기 전에 이미 key 안에 들어 있습니다.)
확인 결과, 창이 8이고 토큰이 50개일 때 링 버퍼는 모든 단계에서 창 마스크를 씌운 전체 어텐션과 같은 출력을 냈습니다(차이 8.9 × 10⁻¹⁶). 그러면서 들고 있는 토큰은 50개가 아니라 8개였습니다. 이 층이 무엇을 포기하는지도 확인했습니다. 0번 토큰의 value를 100만큼 바꿨더니, 8번째 단계부터는 출력이 전혀 바뀌지 않았습니다. 차이가 정확히 0이었습니다. 이 층에서 그 토큰은 사라진 것입니다.
그래서 sliding window를 쓰는 모델은 full attention 층을 섞어서, 0번 토큰을 볼 수 있는 층을 남겨 둡니다. Gemma 3는 full 층 하나에 sliding 층 다섯 개를 두고, gpt-oss는 하나씩 번갈아 둡니다. 코드로는 층 종류를 담은 목록 하나에, 층마다 자기 캐시 클래스를 두면 됩니다. 실제 런타임은 정확히 W칸만 들고 있지 않는 경우가 많습니다. llama.cpp와 vLLM 모두 창 옆에 자리를 더 잡는데, 그 양이 서로 다릅니다(배포 글에 측정값이 있습니다).
3. Attention sink: 어텐션을 버릴 자리
softmax는 언제나 어텐션을 정확히 100% 나눠 줍니다. 볼 만한 것이 없는 헤드도 어딘가에 어텐션을 나눠야 합니다. gpt-oss는 헤드마다 학습된 logit을 하나씩 더 둡니다. 이 "sink"는 softmax 계산에는 참여하지만, 뒤에 붙은 value가 없습니다. attend의 sink 분기가 이것입니다. logit을 열 하나로 덧붙이고, softmax를 계산하고, value를 곱하기 전에 그 열을 떼어 냅니다.
두 가지를 확인했습니다. sink를 음의 무한대로 두면 출력이 일반 어텐션과 정확히 같았습니다. sink logit을 점수들보다 훨씬 큰 20으로 두면 출력의 크기가 원래의 3.8 × 10⁻⁸로 줄었습니다. 헤드가 어텐션을 거의 전부 빈자리에 주고, 결과에 거의 아무것도 보태지 않는 것입니다. sink가 있으면 헤드는 할 일이 없을 때 결과에서 빠질 수 있습니다.
실제 가중치에도 있습니다. gpt-oss-20b의 0번 층에는 self_attn.sinks라는 텐서가 있고, query 헤드마다 하나씩 숫자 64개가 −2.45부터 4.06까지 들어 있습니다. sink는 캐시를 쓰지 않습니다. 토큰마다 쌓이는 상태가 아니라 가중치이기 때문입니다. StreamingLLM의 attention sink는 같은 문제에 대한 그 전의 다른 아이디어로, 처음 몇 개의 실제 토큰을 캐시에 계속 남겨 둡니다.
4. MLA: 잠재 벡터만 저장하고, 가중치는 query 쪽으로 옮기기
MLA는 토큰마다 압축된 벡터 c_kv 하나(DeepSeek-V2-Lite에서 숫자 512개)와, 모든 헤드가 함께 쓰는 작은 key k_rope 하나(64개)를 저장합니다. 각 헤드의 key와 value는 c_kv의 선형 함수로, c_kv @ w_uk[h]와 c_kv @ w_uv[h]입니다. 아래는 이 문장대로 계산하는 버전과, 같은 계산을 key와 value를 만들지 않고 하는 버전입니다.
def mla_naive(q_nope, q_rope, c_kv, k_rope, w_uk, w_uv):
    """Rebuild every head's key and value from the latent, then attend as usual.
    q_nope: (H, T, dn)  q_rope: (H, T, dr)  c_kv: (L, r)  k_rope: (L, dr), one per token shared by all heads
    w_uk: (H, r, dn)  w_uv: (H, r, dv)"""
    H, L = q_nope.shape[0], c_kv.shape[0]
    k = torch.cat([c_kv @ w_uk, k_rope.expand(H, L, -1)], dim=-1)  # (H, L, dn + dr)
    v = c_kv @ w_uv  # (H, L, dv)
    q = torch.cat([q_nope, q_rope], dim=-1)
    return attend(q, k, v, causal(q.shape[1], L))


def mla_absorbed(q_nope, q_rope, c_kv, k_rope, w_uk, w_uv):
    """Same result without ever building per-head keys or values: fold w_uk into the query
    and w_uv into the output. Only c_kv and k_rope are read from the cache."""
    scale = 1 / math.sqrt(q_nope.shape[-1] + q_rope.shape[-1])
    q_lat = q_nope @ w_uk.transpose(-1, -2)  # (H, T, r): query moved into latent space
    s = (q_lat @ c_kv.T + q_rope @ k_rope.T) * scale  # (H, T, L)
    s = s.masked_fill(~causal(q_nope.shape[1], c_kv.shape[0]), float("-inf"))
    return (s.softmax(-1) @ c_kv) @ w_uv  # attend over latents, then expand once per head
필요한 식 변형은 하나뿐입니다. 캐시에 든 토큰에 대한 헤드의 점수는 q_nope · (c_kv @ w_uk)이고, 이 값은 (q_nope @ w_ukᵀ) · c_kv와 같습니다. 그러니 매 단계 query에 w_ukᵀ를 한 번 곱하고, 저장된 잠재 벡터와 바로 비교하면 됩니다. value 쪽도 같습니다. 어텐션은 가중 평균이므로, 평균을 낸 뒤 w_uv를 곱하나 곱한 뒤 평균을 내나 결과가 같습니다. 흡수한 버전은 캐시 토큰마다 숫자 576개를 읽고, 토큰마다 새로 만드는 것이 없습니다.
MLA가 두 부분으로 되어 있는 이유는 64개짜리 k_rope 때문입니다. RoPE는 key를 위치에 따라 다른 각도로 회전시킵니다. 그래서 회전한 key는 c_kv의 고정된 선형 함수가 아니고, 위처럼 가중치를 query 쪽으로 옮길 수 없습니다. DeepSeek은 위치 정보를 담는 작은 key를 모든 헤드가 함께 쓰도록 따로 두고, 잠재 벡터 옆에 저장합니다. 512 + 64의 "+ 64"가 이것입니다.
두 함수는 무작위 가중치에서 같은 출력을 냈습니다(1.1 × 10⁻¹⁵). DeepSeek-V2-Lite 0번 층의 실제 kv_b_proj에서도 같았습니다(4.5 × 10⁻¹⁵). 이 행렬은 4,096 × 512 크기이고, 모델 코드가 하는 방식대로 헤드 16개의 w_uk와 w_uv로 나눴습니다. 두 버전이 같다는 것은 식에서 나오는 결과라 어떤 가중치로도 성립합니다. 실제 가중치로 돌려서 확인한 것은 가중치가 놓인 방식입니다. 헤드 16개가 있고, 헤드마다 128차원 key 부분과 128차원 value 부분이 있으며, 모두 잠재 벡터 512개에서 읽어 낸다는 것입니다. 헤드를 다시 만든 형태로 저장하면 같은 토큰이 층마다 576개가 아니라 16 × (128 + 64 + 128) = 5,120개를 씁니다.
5. 희소 어텐션: 전부 저장하고, 조금만 읽기
DeepSeek-V3.2-Exp의 DeepSeek Sparse Attention(DSA)은 캐시를 줄이지 않습니다. 대신 매 단계 캐시에서 읽는 양을 줄입니다. lightning indexer라는 작은 채점기가 현재 query에 대해 앞선 토큰 전부에 점수를 매기고, 어텐션은 상위 k개(모델 config에서 2,048개)만 대상으로 계산합니다. 여기서 짠 indexer는 논문에 나온 indexer의 모양을 따랐습니다. 작은 query 헤드 몇 개, 토큰마다 작은 key 하나, ReLU, 가중합으로 되어 있습니다.
def indexer_scores(qi, ki, wi):
    """Lightning-indexer style: qi (Hi, T, di) small query heads, ki (L, di) one small key per token,
    wi (Hi, T) per-head weights. score[t, s] = sum_j wi[j, t] * relu(qi[j, t] . ki[s])"""
    return (wi[..., None] * torch.relu(qi @ ki.T)).sum(0)  # (T, L)


def sparse_attend(q, k, v, scores, topk):
    """Each query attends only to its top-k tokens by indexer score (causal). All tokens stay in the cache."""
    T, L = scores.shape
    scores = scores.masked_fill(~causal(T, L), float("-inf"))
    keep = torch.zeros(T, L, dtype=torch.bool)
    idx = scores.topk(min(topk, L), dim=-1).indices
    keep.scatter_(1, idx, True)
    keep &= causal(T, L)  # top-k may pick masked slots for early queries
    return attend(q, k, v, keep), keep.sum(-1)
k가 시퀀스 길이 이상이면 결과가 전체 어텐션과 정확히 같았습니다(차이 0). 토큰 60개 가운데 k = 16이면 마지막 query는 토큰 16개를 읽었습니다. 가중치가 무작위라서 전체 어텐션과의 차이(상대 0.64)는 품질에 대해 아무것도 말해 주지 않습니다. 두 계산이 더는 같지 않다는 것만 보여 줍니다. indexer가 올바른 토큰을 고르는지는 학습된 가중치에 달린 문제이고, DeepSeek의 기술 보고서가 다루는 부분입니다.
코드로 짜 보면 두 가지가 분명해집니다. 첫째, 캐시는 전부 남습니다. 어떤 토큰이든 나중에 상위 k개에 들 수 있기 때문입니다. 둘째, indexer는 토큰마다 자기 key(ki, V3.2-Exp config 기준 토큰당 128개)를 캐시에 더합니다. 그래서 희소 어텐션은 메모리를 줄이는 것이 아니라 오히려 조금 더 씁니다. 아끼는 것은 읽는 양입니다. 비싼 어텐션은 매 단계 전체가 아니라 k개 토큰만 읽고, 전체를 훑는 것은 값싼 indexer뿐입니다.
6. Linear attention과 Gated DeltaNet: 캐시 대신 상태
softmax를 빼면 어텐션을 대화가 길어져도 아무것도 커지지 않는 형태로 바꿔 쓸 수 있습니다. feature map φ가 있을 때, 어텐션 모양의 계산은 φ(q) φ(k)ᵀ에 value를 곱합니다. 중간에 softmax가 없으니 같은 합을 토큰 하나씩 행렬 S = Σ v φ(k)ᵀ에 쌓을 수 있고, 각 query는 S φ(q)만 읽으면 됩니다.
def linear_parallel(q, k, v):
    """Causal linear attention written like attention: no softmax, feature map phi = elu + 1."""
    phi = lambda x: torch.nn.functional.elu(x) + 1
    a = (phi(q) @ phi(k).transpose(-1, -2)) * causal(q.shape[1], k.shape[1])
    return (a @ v) / a.sum(-1, keepdim=True)


def linear_recurrent(q, k, v):
    """The same thing as a running state: one (d_v x d_k) matrix and one vector per head, whatever the length."""
    phi = lambda x: torch.nn.functional.elu(x) + 1
    H, T, dk = k.shape
    S, z, out = torch.zeros(H, v.shape[-1], dk), torch.zeros(H, dk), []
    for t in range(T):
        kt, qt = phi(k[:, t]), phi(q[:, t])
        S = S + v[:, t, :, None] * kt[:, None, :]  # add v k^T
        z = z + kt
        out.append((S @ qt[..., None])[..., 0] / (z * qt).sum(-1, keepdim=True))
    return torch.stack(out, 1)


def gated_delta_step(S, k, v, q, alpha, beta):
    """Gated DeltaNet (Qwen3.5, Qwen3-Next) for one token, one head. S: (d_v, d_k).
    alpha in (0, 1] decays the whole memory; beta in (0, 1] is how much to correct toward v at key k."""
    S = alpha * S
    S = S + beta * torch.outer(v - S @ k, k)  # replace what is stored at k, instead of adding to it
    return S, S @ q
누적 상태 버전과 어텐션 모양 버전은 모든 단계에서 같은 출력을 냈습니다(8.9 × 10⁻¹⁶). 상태는 시퀀스가 40토큰이든 40,000토큰이든 헤드마다 16 × 16 행렬 하나입니다.
약점은 같은 자리에 두 번 쓸 때 드러납니다. 같은 key에 value 두 개를 쓰면 일반 linear attention은 둘의 합을 돌려줍니다. 확인해 보니 정확히 v1 + v2가 읽혔습니다. Gated DeltaNet의 바탕인 delta rule은 먼저 그 key에 저장된 값을 읽고, 차이(v - S @ k)만 씁니다. 그러면 같은 두 번의 쓰기 뒤에 정확히 v2가 읽힙니다. Gated DeltaNet의 또 다른 축은 게이트 alpha입니다. 토큰마다 기억 전체를 조금씩 줄여서, 오래된 내용이 흐려지게 합니다. alpha가 0.9이고 아무것도 쓰지 않는 토큰이 열 개 지나가면 v1의 0.349가 남습니다. 0.9¹⁰입니다.
실제 혼합 구조 모델은 정확하게 기억해 내야 하는 일을 위해 full attention 층을 몇 개 남기고, 나머지 층에 이 방식을 씁니다. Qwen3.5-9B는 Gated DeltaNet 층이 24개, full 층이 8개입니다. config.json에 따르면 층마다 value 헤드(32개)당 128 × 128 상태가 하나씩 있고, q, k, v의 최근 입력 3개를 들고 있는 짧은 합성곱이 붙습니다. f32로 계산하면 24 × (32 × 128 × 128 + 3 × (2 × 16 × 128 + 32 × 128)) × 4바이트 = 대화 하나에 50.25 MiB이고, 대화 길이와 상관없습니다. llama.cpp도 이 모델에 대해 50.25 MiB를 찍었습니다(앞 글의 실측).
linear_recurrent의 반복문이 디코딩 때 실제로 일어나는 일입니다. 긴 프롬프트를 처리할 때는 실제 구현이 같은 계산을 덩어리 단위의 행렬 곱으로 합니다. 토큰마다 Python 반복문을 돌리면 너무 느리기 때문입니다.
코드에서 뺀 것
- 속도. 이 함수들은 점수 행렬 전체를 만들고 Python으로 반복합니다. FlashAttention, paged 캐시, 덩어리 단위 DeltaNet 커널, FP8 indexer는 바로 이 때문에 있습니다.
- 학습. 위의 확인은 모두 설계가 무엇을 계산하는지에 관한 것이고, 학습된 모델이 그 설계로 무엇을 하게 되는지는 다루지 않습니다.
- 위치 정보는 대부분 뺐습니다. RoPE는 MLA 절에서만 썼습니다. 구조를 바꾸는 설계가 MLA뿐이기 때문입니다.
확인을 모두 담은 스크립트는 attention_code.py입니다. DeepSeek-V2-Lite와 gpt-oss-20b의 가중치가 로컬 Hugging Face 캐시에 있으면 읽고, 없으면 그 두 확인만 건너뜁니다.
이 연재의 다음 글
모델 여섯 개가 캐시를 담는 방식, llama.cpp와 vLLM 실측과 두 런타임으로 배포할 때 달라지는 것으로 이어집니다.