llama.cpp, vLLM 배포 환경에 따른 배포 방법과 전략 (1) 메모리
같은 모델을 llama.cpp와 vLLM에 올릴 때 달라지는 것 가운데 메모리를 먼저 다룹니다. 런타임마다 KV 캐시를 얼마나, 왜 예약하는지(Gemma 3 4B 32K에서 814 MiB 대 2,682 MiB), 그 크기를 바꾸는 설정(-ub, --swa-full, max_num_batched_tokens, prefix caching), 그리고 배포하며 부딪힌 네 가지 차이(학습 길이를 넘는 맥락, --parallel, GGUF 변환, vLLM의 시작 시 커널 빌드)를 정리했습니다.
llama.cpp, vLLM 배포 환경에 따른 배포 방법과 전략 (1) 메모리
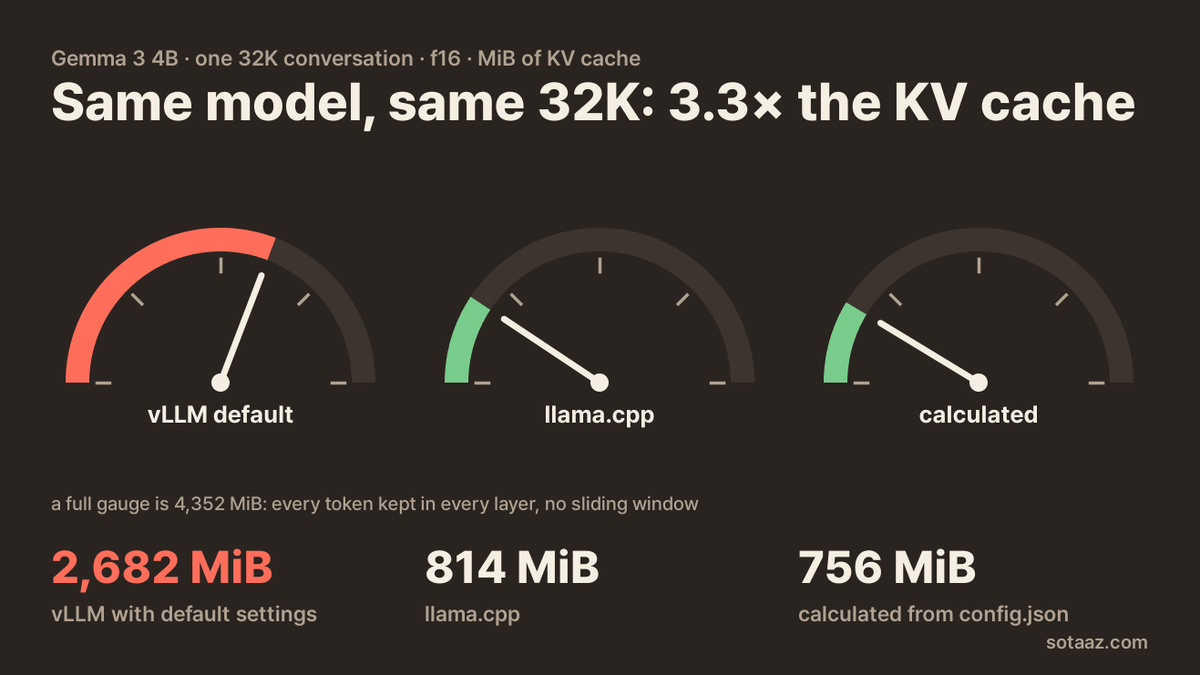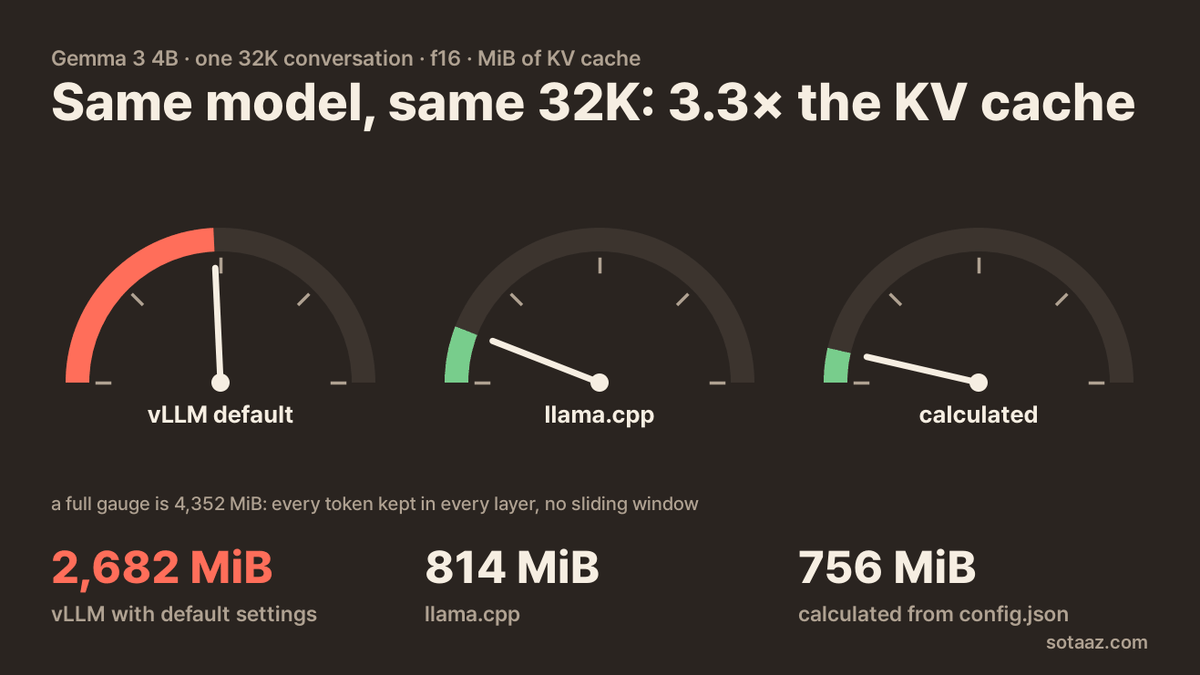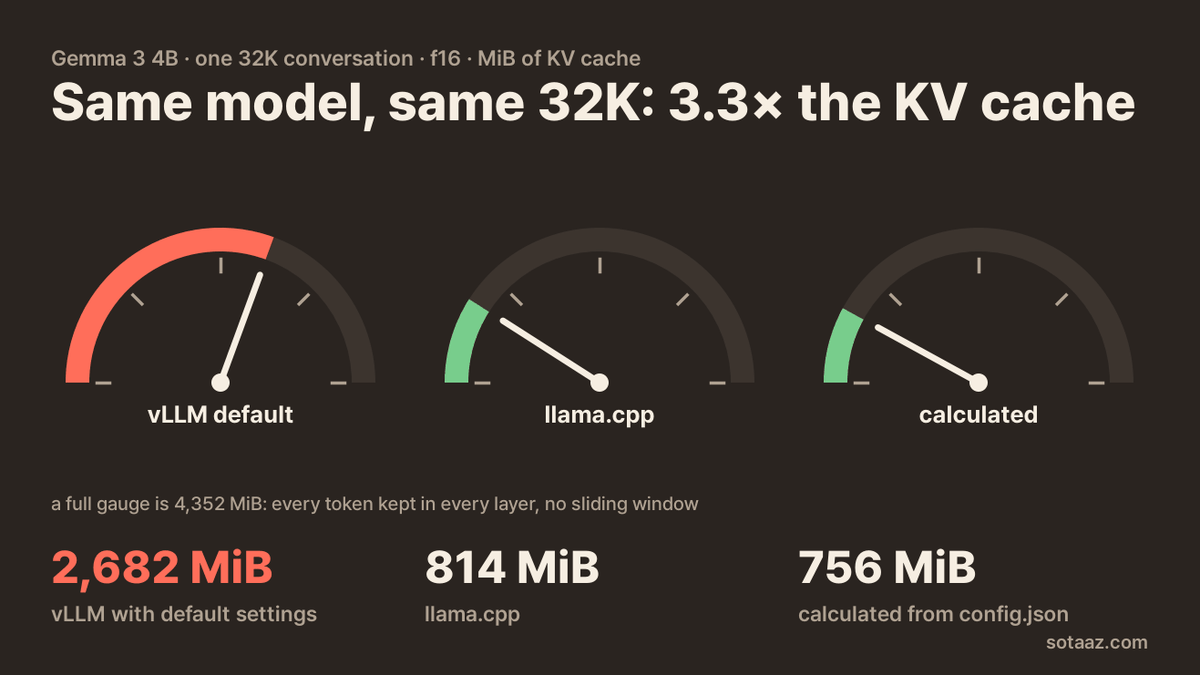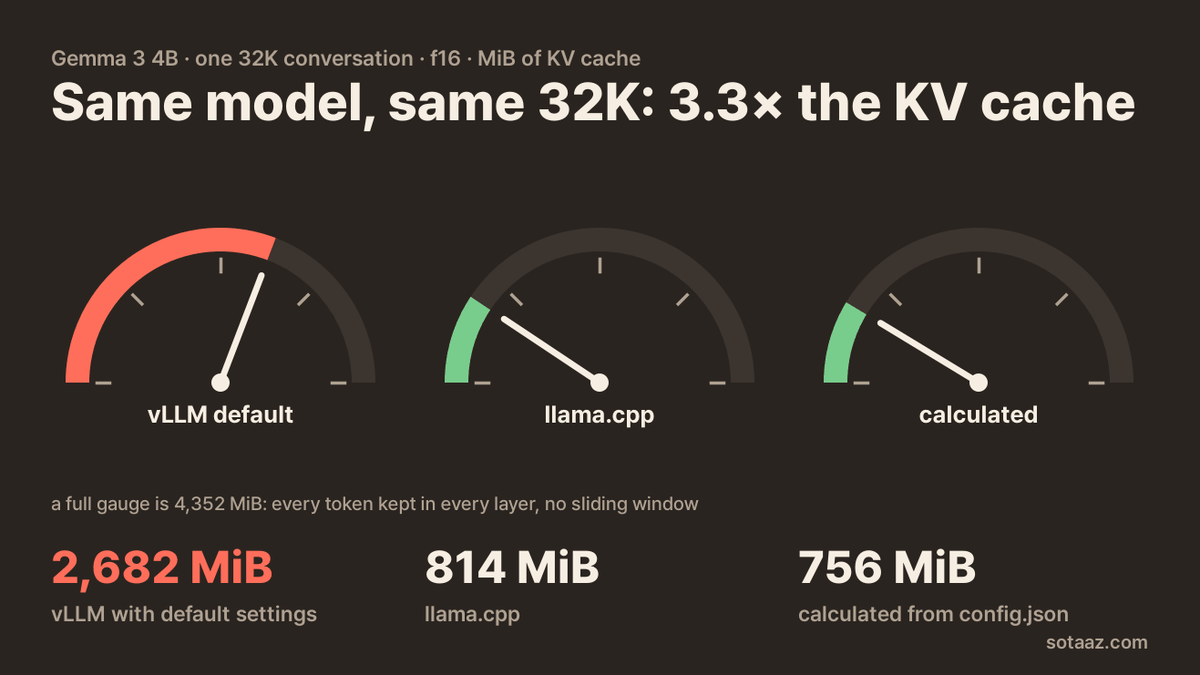
Gemma 3 4B는 34개 층 가운데 29개가 최근 1,024토큰만 보는 sliding window 층입니다. 모든 층이 모든 토큰을 들고 있으면 32K 대화의 KV 캐시는 4,352 MiB지만, 창 안의 토큰만 들고 있으면 약 756 MiB면 됩니다. 구조만 보면 메모리를 6분의 1 가까이로 줄이는 설계입니다. 실제로 배포했을 때에도 이런 아키텍처의 이점을 확인할 수 있을까요?
저희는 두 런타임을 띄우기 전에 모델 설정으로 이 756 MiB를 계산해 두었습니다. 이 값을 기억해 두고 아래의 실측값과 비교해 보세요. llama.cpp는 814 MiB를 잡아 계산에 가까웠습니다. 그런데 Python LLM 클래스로 띄운 vLLM은 기본 설정에서 같은 32K 요청 하나에 2,682 MiB를 예약했습니다. 모델도, 길이도, 16비트 캐시도 같은데 메모리가 세 배 넘게 들었습니다.
어느 쪽 런타임에 버그가 있는 것은 아닙니다. 두 런타임은 무엇을 들고 있겠다는 약속이 서로 다르고, 모델 설계가 주는 절약은 런타임과 설정이 허락할 때만 실제 GPU 메모리로 나타납니다. 이 글은 그 차이를 다룹니다. 런타임마다 무엇을 예약하는지, 그 숫자를 바꾸는 설정이 무엇인지, 그리고 같은 모델을 llama.cpp와 vLLM에 올리면서 달랐던 네 가지를 정리합니다.
숫자는 모두 앞 글의 실측에서 나왔습니다. 앞 글은 KV 캐시 구조가 네 종류인 모델 여섯 개를 모델 쪽에서 봤고, 이 글은 같은 데이터를 런타임 쪽에서 봅니다. 저희가 잰 것은 메모리뿐입니다. 두 런타임 모두 속도는 재지 않았고, vLLM은 저희 실행에서 글을 한 번도 생성하지 않았습니다(이유는 6절에 있습니다). 그래서 아래 내용으로는 어느 런타임이 더 빠른지 말할 수 없습니다. 속도와 동시 요청은 따로 실행해서 2편에서 다룹니다.
실행 환경. llama.cpp는 빌드 4da6337에서 llama-server -ngl 99 -fa on --parallel 1 -c <길이>로 띄웠습니다. vLLM은 0.29.1rc1을 Python LLM 클래스로 띄우고 max_model_len을 길이마다 맞추고 gpu_memory_utilization 0.85, eager 모드로 띄웠습니다. GPU는 A100 80GB 한 장이고, 따로 적지 않으면 캐시는 f16/bf16입니다.
1. 런타임마다 들고 있겠다고 약속하는 것
llama.cpp는 -c로 캐시 크기를 정합니다. N토큰짜리 맥락을 달라고 하면 시작할 때 N토큰 분량의 캐시를 잡고, 부분마다 크기를 찍습니다(KV self size, 혼합 구조 모델은 recurrent 상태를 따로). 평범한 모델이라면 이 숫자가 계산값과 정확히 같습니다. Qwen3-8B는 4K, 32K, 128K에서 576, 4,608, 18,432 MiB를 잡았습니다.
-c는 모든 슬롯을 합친 크기입니다. 이 빌드에서 통합 캐시를 쓰지 않으면 --parallel 4 -c 32768은 슬롯 네 개에 8,192토큰씩을 줍니다. 슬롯마다 32,768토큰이 아닙니다(소스가 n_ctx를 시퀀스 수로 나눕니다). 저희는 --parallel 1만 돌렸기 때문에 이 경우는 재지 않았습니다. 계획할 때는 -c를 "슬롯 수 × 대화 하나에 필요한 길이"로 잡으면 됩니다.
vLLM은 GPU의 일정 몫을 받아 전부 캐시로 채웁니다. 모델을 올린 뒤 gpu_memory_utilization(저희는 80 GB의 0.85) 안에서 남은 메모리를 재고, 그 전부를 KV 캐시 블록으로 바꿉니다. Gemma 3 4B 32K에서는 캐시가 58.33 GiB였고, 대화 길이와는 상관없이 이만큼을 잡습니다. vLLM이 답하는 질문은 "캐시가 얼마나 큰가"가 아니라 "요청이 몇 개 들어가는가"입니다.
로그에는 그 답이 두 가지 형태로 찍힙니다.
Available KV cache memory: 58.33 GiB
GPU KV cache size: 729,735 tokens, Maximum concurrency for 32,768 tokens per request: 22.27x
여기서 토큰 수는 캐시에 담을 수 있는 대화 토큰 수가 아닙니다. vLLM은 이 값을 "최대 길이 요청이 몇 개 들어가는가 × 최대 길이", 곧 22.27 × 32,768로 계산합니다. 그러니 캐시 메모리를 이 토큰 수로 나누면, vLLM이 최대 길이 요청 하나를 위해 예약하는 양을 그 길이로 나눈 값이 나옵니다. Gemma는 토큰당 85,828바이트, 32K 요청 하나에 2,682 MiB입니다. full attention만 쓰는 모델이라면 두 해석이 같은 값을 냅니다. sliding 층이나 고정 상태가 있는 모델에서는 달라지고, 다음 두 절이 바로 그 두 경우입니다.
2. Sliding window 모델: 창이 아니라 예약량
Gemma 3 4B는 full attention 5층과, 창이 1,024토큰인 sliding 29층으로 되어 있습니다. gpt-oss-20b는 full 12층과 창이 128토큰인 sliding 12층을 번갈아 둡니다. 두 런타임 모두 sliding 층이 계속 커지지 않게 막습니다. 차이는 창 옆에 자리를 얼마나 더 잡아 두느냐입니다.
llama.cpp: 창에 micro-batch 하나를 더합니다. 32K에서 Gemma는 814 MiB, gpt-oss는 786 MiB를 잡았습니다. sliding 층은 창에 micro-batch(-ub, 기본 512) 하나를 더하고 256의 배수로 올린 만큼을 들고 있습니다. Gemma는 층마다 1,024 + 512 = 1,536칸이고, gpt-oss는 128 + 512 = 640칸을 올려 768칸입니다. 이 식은 본 측정이 끝난 뒤에 찾았고, -ub를 바꿔 가며 확인했습니다.
-ub | Gemma 3 4B, 32K | gpt-oss-20b, 32K |
|---|---|---|
| 256 | 785 MiB | 780 MiB |
| 512 (기본값) | 814 MiB | 786 MiB |
| 1024 | 872 MiB | 798 MiB |
--swa-full | 4,352 MiB | 1,536 MiB |
--swa-full을 켜면 sliding 층도 모든 토큰을 들고 있고, 캐시가 정확히 전체 크기로 돌아갑니다. 필요한 기능이 이 옵션을 요구할 때만 켜는 것이 맞습니다. 메모리만 따지면 기본값을 그대로 두는 편이 낫습니다.
vLLM: 창에 처리 중인 토큰 전부를 더합니다. vLLM은 sliding 층마다 창에 더해, 스케줄러가 한꺼번에 처리하고 있을 수 있는 토큰 전부가 들어갈 자리를 예약합니다. A100에서 LLM 클래스의 기본값으로는 max_num_batched_tokens 두 배치, 2 × 8,192 = 16,384토큰이고, 요청 길이를 넘지는 않습니다. Gemma 32K라면 sliding 층 하나가 1,024토큰이 아니라 약 17,400토큰을 잡습니다. (vLLM은 Gemma의 sliding 29층을 5개씩 6묶음으로 나누기 때문에 30층 몫을 예약합니다.) 이 식은 4K, 32K, 128K에서 토큰당 143,840, 85,820, 36,815바이트를 예측합니다. vLLM에서 잰 값은 143,833, 85,828, 36,813바이트로, 0.01% 안쪽이었습니다. gpt-oss는 창이 128토큰밖에 안 되니 처리 중인 토큰 몫이 거의 전부를 차지합니다. 32K 요청 하나에 1,155 MiB이고, llama.cpp는 786 MiB였습니다.
이 예약에는 이유가 있습니다. 긴 프롬프트를 큰 덩어리로 한 번에 받아도 배치 도중에 자리가 모자라지 않게 해 줍니다. 다만 8,192에서는 sliding window가 아껴 주는 양의 절반가량을 도로 씁니다. Gemma가 32K에서 아낄 수 있는 3,596 MiB(4,352에서 756으로) 가운데 vLLM이 실제로 아낀 것은 1,670 MiB입니다. gpt-oss는 765 MiB 가운데 381 MiB를 아꼈습니다.
이 양을 바꾸는 설정은 max_num_batched_tokens입니다. 2,048과 512로 돌리기 전에 예약 식이 내는 값을 먼저 적어 두었습니다.
max_num_batched_tokens | Gemma 3 4B, 32K 요청 하나 | gpt-oss-20b, 32K 요청 하나 |
|---|---|---|
8,192 (A100, LLM 클래스 기본값) | 2,682 MiB | 1,155 MiB |
2,048 (A100, vllm serve 기본값) | 1,242 MiB | 867 MiB |
| 512 | 882 MiB | 795 MiB |
측정 여덟 개(모델 둘, 4K와 32K, 설정 둘)가 모두 예측과 0.01% 안쪽으로 맞았습니다. 512로 내리면 Gemma가 llama.cpp의 814 MiB 가까이 옵니다. 값이 작을수록 vLLM은 프롬프트를 한 번에 더 작은 덩어리로 나눠 처리합니다. 그만큼 느려지는 정도는 2편에서 쟀습니다. 32,000토큰 프롬프트의 첫 토큰이 8,192에서 1.36초, 512에서 1.73초에 나왔습니다.
어느 기본값에서 출발하는지는 vLLM을 띄우는 방법과 GPU에 따라 다릅니다. 이 빌드의 소스를 보면 A100에서 Python LLM 클래스는 8,192, vllm serve 서버는 2,048을 씁니다. H100급 GPU에서는 각각 16,384와 8,192입니다. 그러니 A100에서 서버를 기본값으로 띄웠다면 이미 표의 2,048 행에 있습니다.
3. 혼합 구조 모델: prefix caching이 고정 상태를 두 배로 잡습니다
Qwen3.5-9B는 32층 가운데 8층만 토큰을 남깁니다(토큰당 32 KiB). 나머지 24층은 Gated DeltaNet 층이라 토큰 대신 크기가 정해진 상태를 대화마다 하나씩 들고 있습니다. llama.cpp는 두 부분을 따로 찍었습니다. 32K에서 KV가 1,024 MiB였고, 여기에 길이와 상관없이 recurrent 상태 50.25 MiB가 붙었습니다. 이 상태 크기는 config.json으로 계산한 값과 정확히 같습니다.
vLLM에서는 고정분이 그 두 배쯤이었습니다. vLLM은 이 모델의 캐시를 528토큰짜리 블록(블록 하나에 16.5 MiB)으로 관리합니다. 32K 요청 하나가 69.02블록을 예약했고, 어텐션 층이 그 가운데 63블록(32,768 ÷ 528을 올림)을 씁니다. 남는 6.02블록, 약 99 MiB가 상태 몫입니다. 선형 층 세 묶음이 블록을 두 개씩 쓴 셈입니다.
블록이 두 개인 이유는 vLLM 로그에서 짐작할 수 있었습니다. prefix caching(기본으로 켜져 있습니다)이 켜져 있으면 vLLM은 상태 캐시 모드를 "align"으로 둡니다. 그래서 prefix caching을 끄면 블록이 6개가 아니라 3개가 될 것이라고 먼저 예측하고 돌렸습니다. 4K, 32K, 128K에서 3.00, 3.02, 3.08블록이 나왔고, 요청 하나에 약 49.5 MiB로 llama.cpp의 50 MiB와 비슷했습니다. align 모드가 왜 블록을 하나 더 쓰는지는 vLLM 소스에서 확인하지 못했습니다.
계획할 때는 이렇게 보시면 됩니다.
- 두 런타임 모두 고정 상태는 대화 길이가 아니라 동시에 들고 있는 대화 수(llama.cpp의
--parallel슬롯, vLLM의 동시 요청)만큼 곱해집니다. - vLLM에서는 prefix caching이 켜져 있는 동안 요청마다 상태의 두 배쯤을 잡아 두셔야 합니다.
enable_prefix_caching=False로 끄면 절반이 되지만, 반복되는 프롬프트 앞부분을 재사용하지 못하고 다시 계산합니다. 2편에서 앞부분 8,000토큰이 같은 요청을 보냈더니, 첫 토큰이 켰을 때 0.09초, 껐을 때 0.66초에 나왔습니다. - llama.cpp의 8비트 캐시(
-ctk q8_0 -ctv q8_0)는 어텐션 부분만 줄였습니다(32K에서 1,024 MiB가 544 MiB로). 50.25 MiB 상태는 그대로였습니다.
4. 학습 길이를 넘는 맥락: vLLM은 거절하고, llama.cpp는 잡은 뒤 제한합니다
두 런타임에 128K를 요청했습니다. Qwen3-8B는 config에 위치가 40,960개, Mistral-7B-v0.3은 32,768개로 적혀 있습니다.
vLLM은 시작하지 않았습니다.
User-specified max_model_len (131072) is greater than the derived max_model_len
(max_position_embeddings=40960.0 ...). To allow overriding this maximum, set the env var
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1.
이어지는 메시지는 RoPE 모델에서 그 범위를 넘는 위치는 NaN을 낸다고 경고합니다.
llama.cpp는 시작했고, 128K 캐시를 그대로 잡았습니다. Qwen3-8B에서 18,432 MiB입니다. 로그에는 경고가 두 줄 찍혔습니다.
n_ctx_seq (131072) > n_ctx_train (40960) -- possible training context overflow
the slot context (131072) exceeds the training context of the model (40960) - capping
바로 뒤에는 n_slots = 1, n_ctx_slot = 40960이 찍혔습니다. 이 빌드의 서버는 슬롯 하나의 길이를 모델의 학습 길이로 제한합니다(n_ctx_slot()이 둘 가운데 작은 값을 고릅니다). 그러니 서버는 131,072토큰 분량의 메모리를 잡고 있지만, 대화 하나는 그 가운데 40,960토큰까지만 쓸 수 있습니다. 그 길이에 닿는 요청을 실제로 보내 확인하지는 않았습니다. 그래도 계획할 때 할 일은 같습니다. llama.cpp에서 -c를 학습 길이보다 크게 잡으면 메모리만 더 들고 대화 하나의 자리는 늘지 않습니다. -c는 필요한 길이와, 모델을 읽을 때 로그에 찍히는 n_ctx_train을 보고 정하시기 바랍니다.
5. 모델 파일: vLLM은 체크포인트를 바로 읽고, llama.cpp는 GGUF가 필요합니다
vLLM은 Hugging Face 체크포인트를 그대로 읽습니다. llama.cpp는 GGUF 형식이 필요해서, 누군가 변환해 둔 파일을 받거나 직접 변환해야 합니다. DeepSeek-V2-Lite는 같은 llama.cpp 빌드의 변환기로 직접 바꿨는데, 모델의 토크나이저를 알아보지 못해 멈췄습니다. 어떤 토크나이저인지 직접 알려 준 뒤에야 변환이 끝났습니다.
이렇게 만든 파일은 MLA 압축 캐시를 제대로 저장했습니다. 32K에서 972 MiB로 계산값과 같았고, vLLM이 같은 길이에서 잡은 양(토큰당 31,102바이트, 합쳐서 972 MiB)과도 같았습니다. 잠재 벡터를 헤드 16개로 풀어 저장하는 파일이었다면 문제없이 올라가 돌아갔을 것이고, 메모리만 약 아홉 배(32K에서 8,640 MiB)를 썼을 것입니다. 그러니 직접 변환했든 남이 변환한 GGUF를 받았든, 모델을 올린 뒤 로그의 KV 크기를 구조상 나와야 하는 크기와 비교해 보시기 바랍니다. sliding window나 MLA 모델의 캐시가 full attention 모델처럼 크게 잡힌다면, 변환 과정에서 설계가 빠졌다는 신호입니다.
6. 처음 시작할 때: vLLM은 커널을 그 자리에서 빌드합니다
vLLM 실행 29번(2절과 3절을 위해 나중에 더한 11번 포함) 가운데 24번은 캐시 크기를 찍은 뒤 샘플러를 예열하는 단계에서 멈췄습니다. 그 단계에서 vLLM이 서버에 설치된 CUDA 컴파일러로 FlashInfer 커널을 빌드하는데, 시스템 컴파일러(nvcc 12.1)가 모르는 옵션을 만나 실패했습니다. 나머지 두 번은 4절의 128K 거절입니다.
nvcc fatal : Unknown option '--compress-mode=size'캐시는 이 단계보다 먼저 잡히기 때문에, 이 글에 나온 메모리 숫자는 이 실행들에서도 온전합니다. 다만 서빙 가능한 상태까지는 가지 못했습니다. DeepSeek-V2-Lite는 RoPE 커널을 캐시를 잡기 전에 빌드하기 때문에, 숫자 하나 찍기 전에 실패했습니다. vLLM의 Python 환경에 같이 설치된 CUDA 13.4 컴파일러를 쓰도록 지정하자 DeepSeek 세 번은 서빙 준비 상태까지 갔습니다.
정리하면, vLLM 설치는 Python 패키지만이 아니라 서버의 CUDA 툴킷에도 기댈 수 있고, 그 실패는 모델을 다 올린 뒤 첫 시작에서야 드러날 수 있습니다. 시스템 CUDA가 오래된 서버에 배포한다면, 첫 시작이 잘될 것이라고 믿기 전에 vLLM이 어떤 nvcc를 찾게 되는지부터 확인해 보시기 바랍니다. 이것은 서버 한 대에서 겪은 일이고, 자세한 내용은 vLLM과 FlashInfer 버전에 따라 다릅니다.
한눈에 보기
| llama.cpp | vLLM | |
|---|---|---|
| 무엇으로 크기를 정하나 | -c: 모든 슬롯을 합친 토큰 수 | gpu_memory_utilization: GPU의 일정 몫, 전부 캐시가 됨 |
| 로그가 알려 주는 것 | 부분별 캐시 크기(MiB) | max_model_len 요청이 몇 개 들어가는지("Maximum concurrency") |
| sliding window 모델 | 창 + -ub(256 단위로 올림), --swa-full은 꺼 둠 | 창 + 2 × max_num_batched_tokens, 낮추면 절약이 돌아옴 |
| 선형 어텐션 혼합 모델 | 슬롯마다 고정 상태 | prefix caching이 켜져 있으면 요청마다 상태의 약 두 배 |
| 학습 길이를 넘는 맥락 | -c만큼 잡고 슬롯은 학습 길이로 제한 | 환경 변수로 풀지 않으면 거절 |
| 모델 파일 | GGUF, 변환 뒤 KV 크기 확인 | Hugging Face 체크포인트 |
| 첫 시작 | 저희 실행에서는 문제 없음 | 커널 빌드에 최신 CUDA 컴파일러가 필요할 수 있음 |
확인하지 않은 것
- 런타임마다 빌드 하나만 썼습니다. sliding window와 혼합 구조를 다루는 방식은 버전마다 바뀌고, 위의 예약 식도 이 빌드 기준입니다.
- 이 글에서는 메모리만 쟀고, 속도는 2편에서 다룹니다. 답 품질은 재지 않았고, 바꾸라고 권한 설정도 마찬가지입니다.
- vLLM 숫자는 최대 길이 요청 하나를 위한 예약량이고, 실제 작업에서 쓰게 되는 메모리가 아닙니다.
--parallel과 학습 길이 제한은 이 빌드의 소스와 로그로 확인한 것이고, 실제로 요청을 보내 확인하지는 않았습니다.- 모델 여섯 개, GPU 한 장(A100 80GB)에서 쟀습니다.