내려받은 DeepSeek-V2-Lite GGUF에는 작은 KV 캐시가 없었습니다: 텐서 이름 두 개부터 확인하세요
DeepSeek-V2-Lite는 llama.cpp에서 32K 토큰 KV 캐시를 972MiB로 담아야 합니다. 저희가 내려받은 2024년 Q4_K_M GGUF는 attn_k_b·attn_v_b 텐서가 없어 8,640MiB를 썼습니다. 원본 가중치를 직접 변환하자 캐시는 972MiB로, 프로세스 전체는 20,162MiB에서 11,330MiB로 줄었습니다. 명령 하나로 파일을 확인하고 필요하면 변환하는 방법입니다.
내려받은 DeepSeek-V2-Lite GGUF에는 작은 KV 캐시가 없었습니다
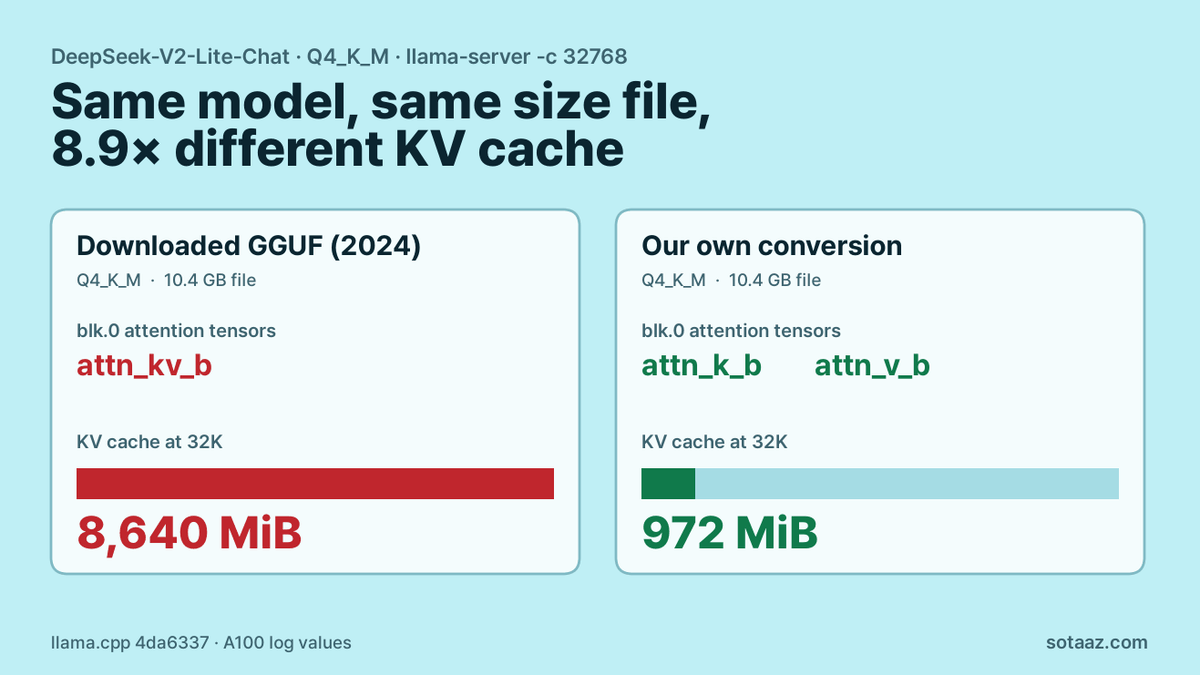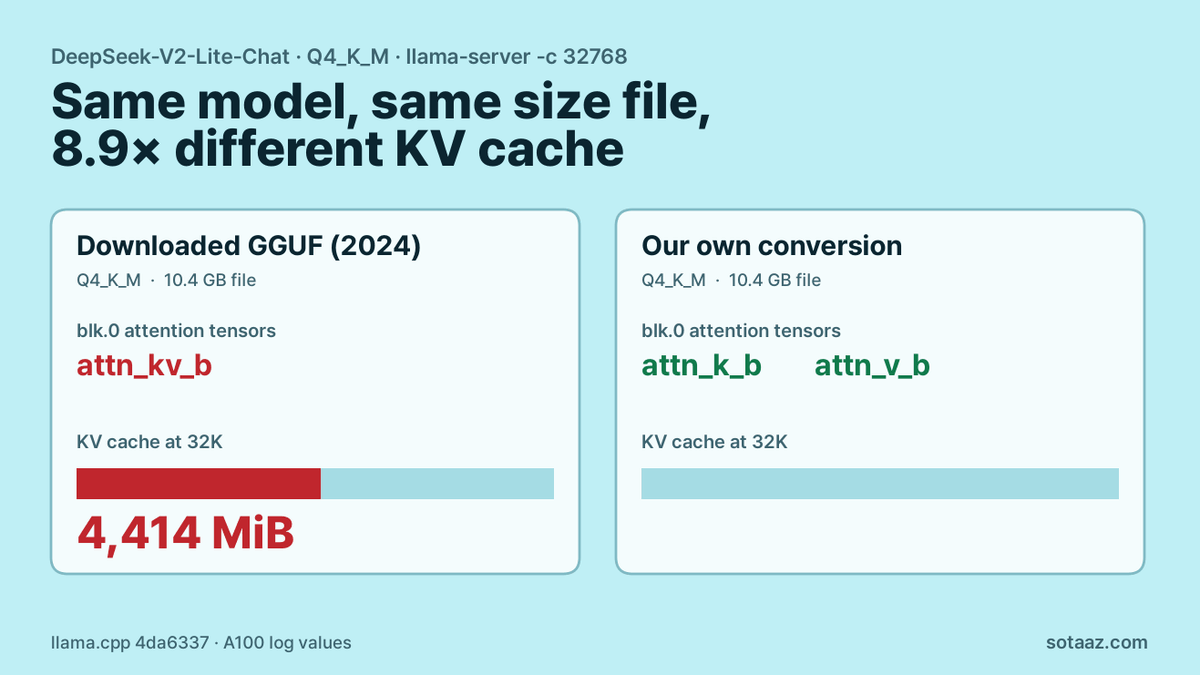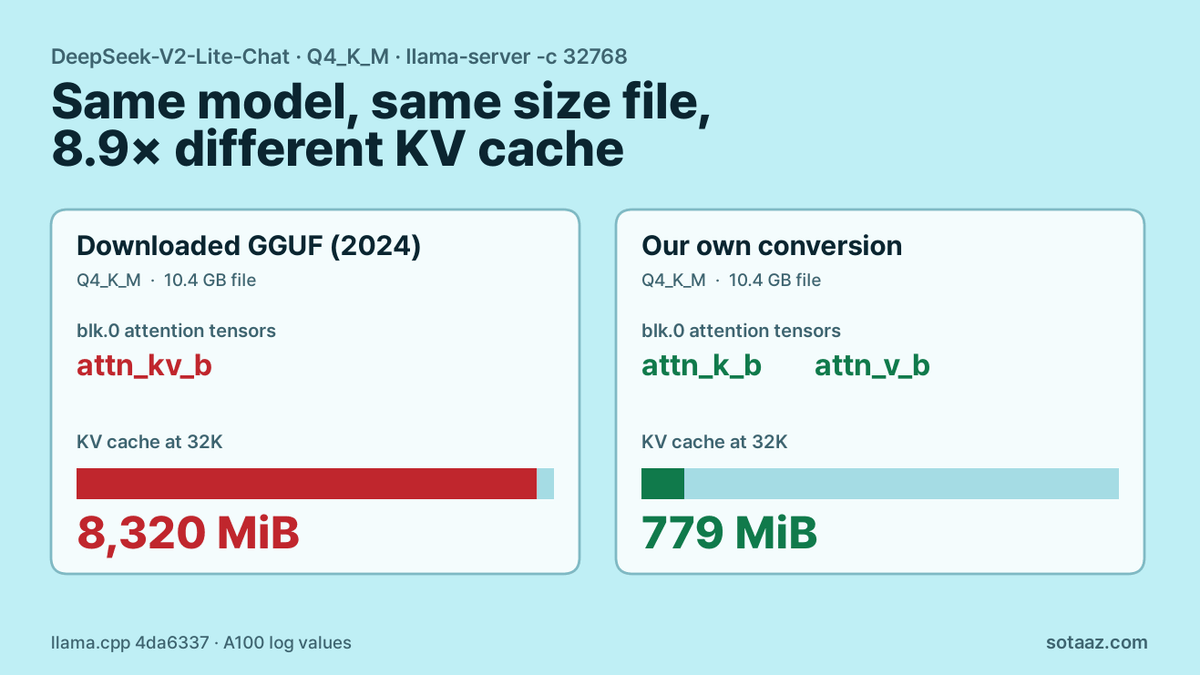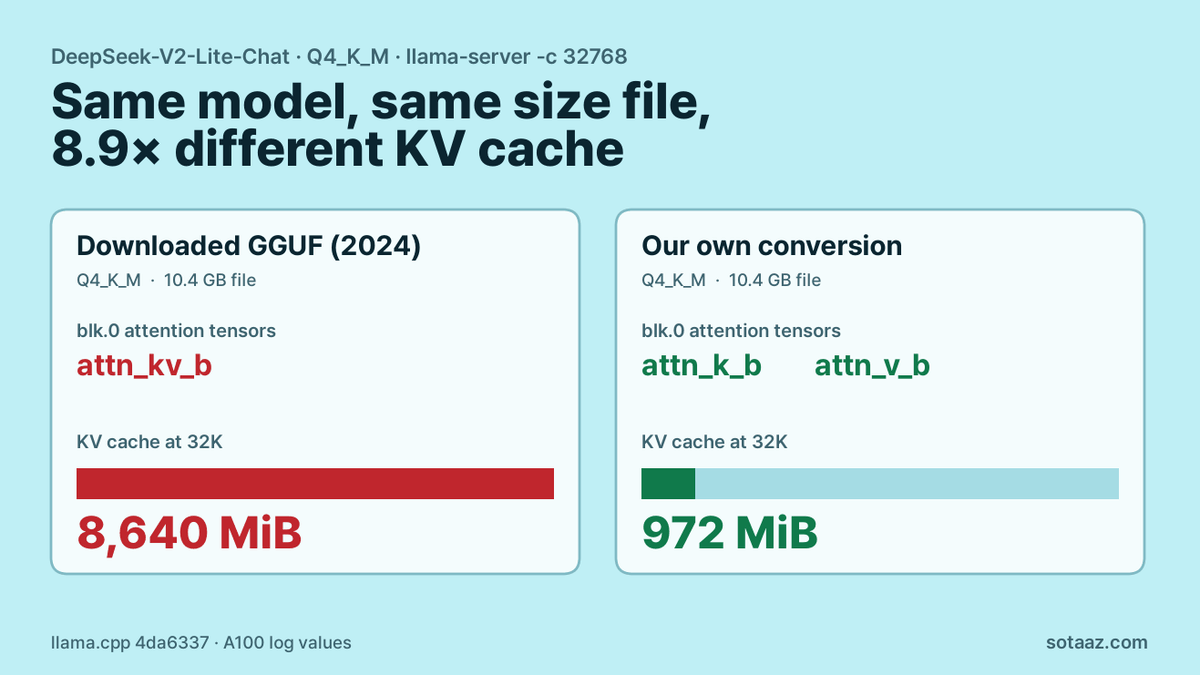
측정 전에 저희는 DeepSeek-V2-Lite를 llama.cpp에서 32K 컨텍스트로 띄우면 KV 캐시가 972MiB일 것이라고 적어 두었습니다. 이 모델은 MLA(Multi-head Latent Attention)라는 구조를 써서, 토큰마다 키와 값을 통째로 저장하지 않고 압축한 작은 벡터 하나만 저장하기 때문입니다. 그런데 허깅페이스에서 Q4_K_M GGUF를 내려받아 llama-server를 띄우자 로그에는 8,640MiB가 찍혔습니다.
파일이 깨진 것은 아니었습니다. 2024년 7월에 변환된 파일이라 어텐션 가중치가 예전 방식으로 들어 있었고, llama.cpp는 이 방식에서는 키와 값을 통째로 저장해야만 모델을 돌릴 수 있습니다. 허깅페이스 원본 가중치를 지금 변환기로 직접 변환하자 캐시는 972MiB로 돌아왔고, 프로세스 전체 사용량은 20,162MiB에서 11,330MiB로 줄었습니다.
DeepSeek-V2나 V2-Lite를 llama.cpp로 쓰신다면, 아래 명령 하나로 갖고 계신 파일이 어느 쪽인지 확인할 수 있습니다.
준비물
- CUDA로 빌드한 llama.cpp. 저희는 커밋
4da6337을 썼습니다. - DeepSeek-V2-Lite GGUF. 저희 파일은
mradermacher/DeepSeek-V2-Lite-Chat-GGUF의 Q4_K_M(10.36GB)입니다. - 변환이 필요할 때만: 원본
deepseek-ai/DeepSeek-V2-Lite-Chat가중치, llama.cpp 변환 의존성이 깔린 파이썬 환경(저희는 transformers 5.20.2, torch 2.7.0), 디스크 여유 약 42GB(f16 중간 파일 31.4GB와 최종 파일).
1단계: 텐서 이름 두 개 찾기
python llama.cpp/gguf-py/gguf/scripts/gguf_dump.py DeepSeek-V2-Lite-Chat.Q4_K_M.gguf \
  | grep -E 'blk\.0\.attn_(k_b|v_b|kv_b)'
첫 번째 층의 어텐션 텐서 이름을 보여 주는 명령입니다. 파일 머리말만 읽으므로 몇 초면 끝나고 GPU도 필요 없습니다.
나와야 할 출력
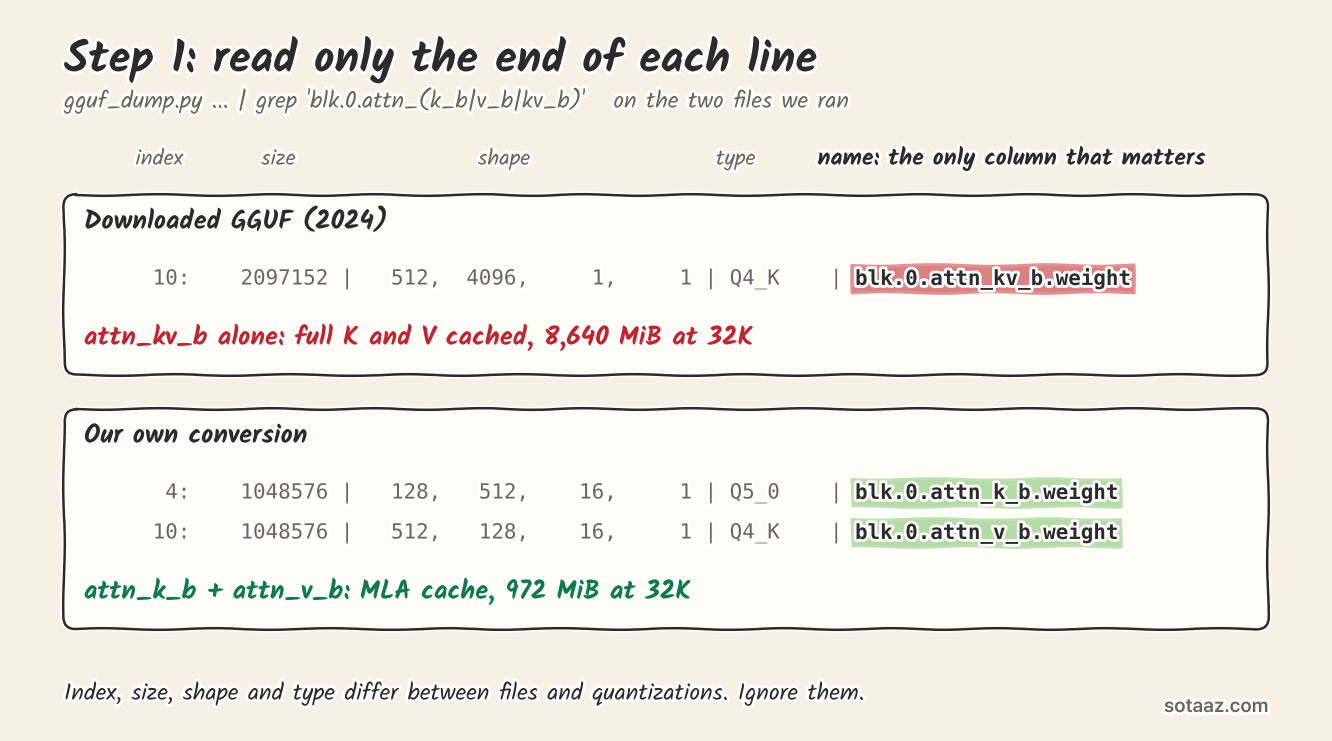
내려받은 파일에서는 한 줄만 나왔습니다.
10: 2097152 | 512, 4096, 1, 1 | Q4_K | blk.0.attn_kv_b.weight직접 변환한 파일에서는 두 줄이 나왔습니다.
      4:    1048576 |   128,   512,    16,     1 | Q5_0    | blk.0.attn_k_b.weight
     10:    1048576 |   512,   128,    16,     1 | Q4_K    | blk.0.attn_v_b.weight
이름 앞의 열은 텐서 번호, 크기, 모양, 양자화 형식이라 파일마다 다르게 나옵니다. 볼 것은 줄 끝의 이름뿐입니다. attn_k_b와 attn_v_b가 있으면 MLA 캐시를 쓸 수 있고, attn_kv_b 하나만 있으면 쓸 수 없습니다.
서버를 띄워서 확인해도 됩니다. 저희가 쓴 명령은 이렇습니다(뒤에 나오는 질문을 물을 때는 --temp 0도 붙였습니다).
llama.cpp/build/bin/llama-server -m DeepSeek-V2-Lite-Chat.Q4_K_M.gguf -ngl 99 -np 1 -c 32768 -lv 4-lv 4는 버퍼 크기 줄까지 찍히도록 로그 수준을 올리는 옵션입니다. 내려받은 파일로 띄우면 이렇게 나옵니다.
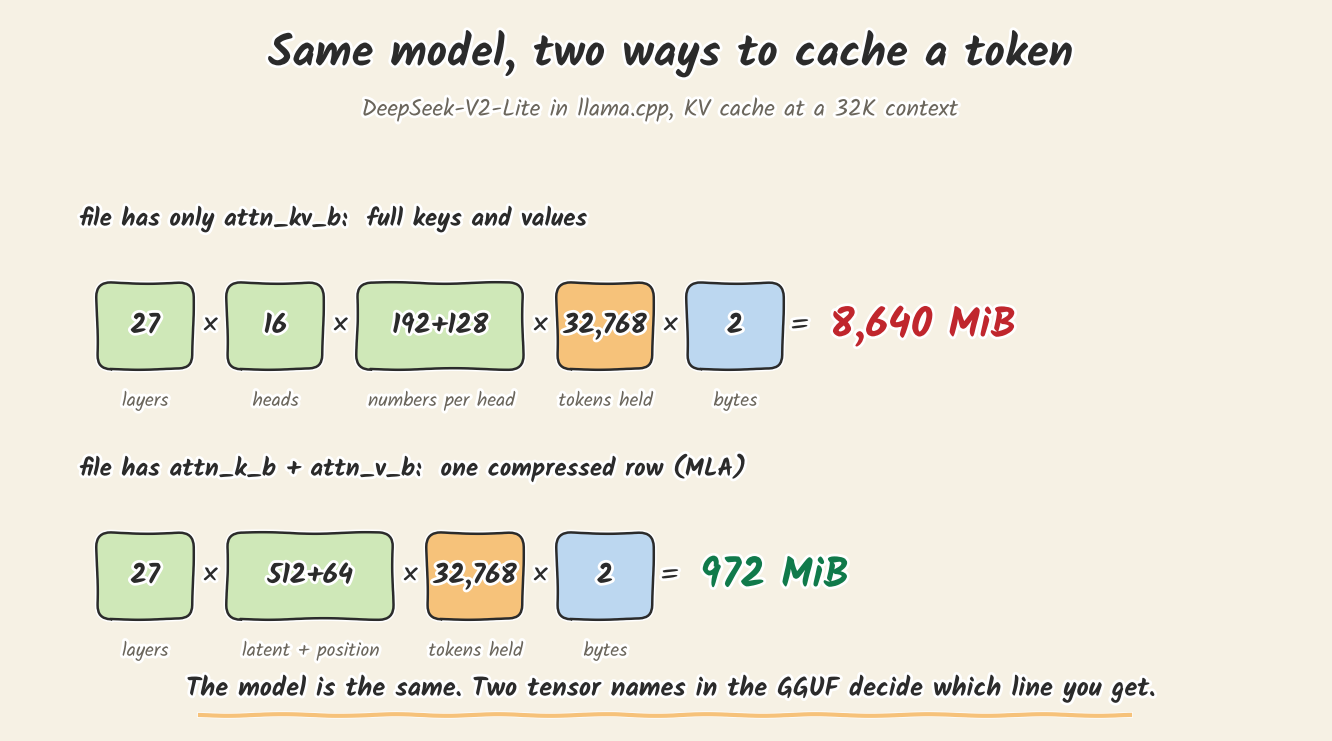
llama_kv_cache: size = 8640.00 MiB ( 32768 cells, 27 layers, 1/1 seqs), K (f16): 5184.00 MiB, V (f16): 3456.00 MiB직접 변환한 파일은 이렇습니다.
llama_kv_cache: size = 972.00 MiB ( 32768 cells, 27 layers, 1/1 seqs), K (f16): 972.00 MiB, V (f16): 0.00 MiB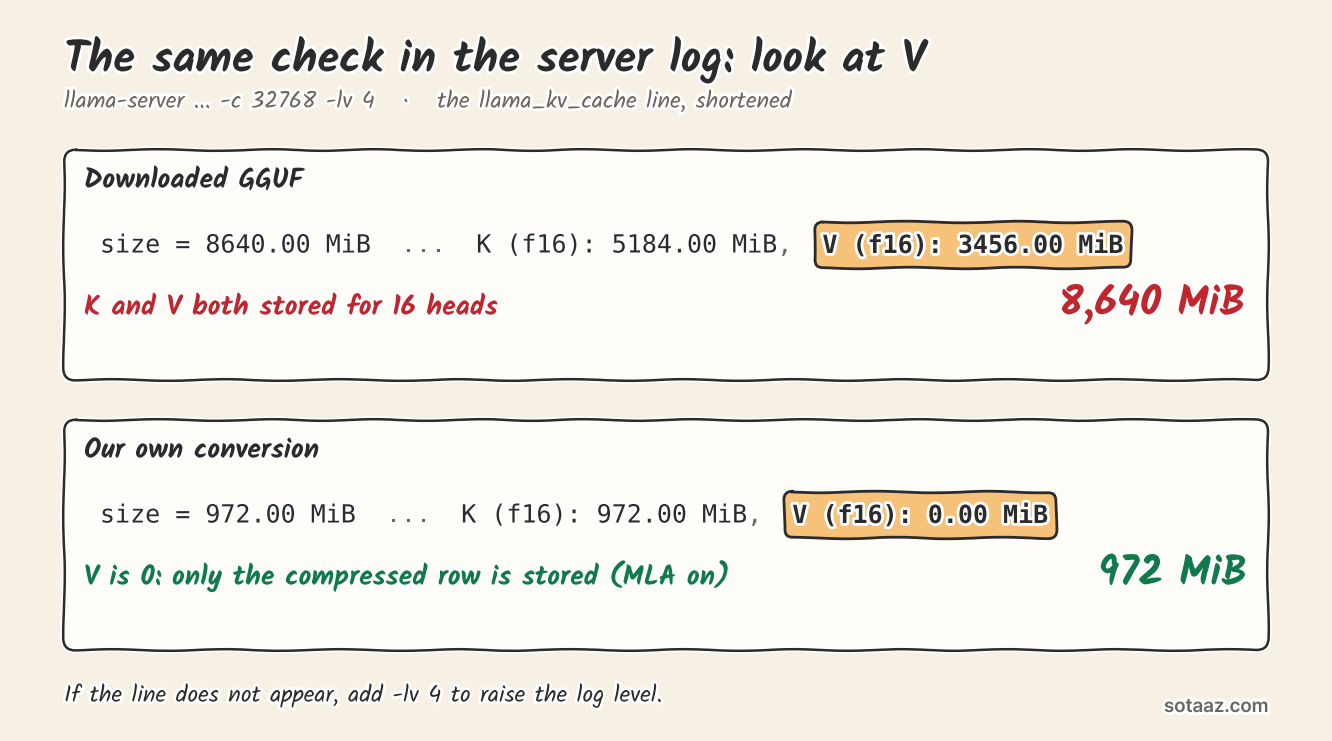
읽는 법
V (f16): 0.00 MiB가 보이면 MLA 캐시가 켜진 것입니다. 이때 llama.cpp는 층마다 토큰당 압축 벡터(숫자 512개와 위치용 64개)만 저장하고, 키와 값을 통째로 되살리지 않습니다. 어텐션을 계산할 때 attn_k_b로 쿼리를 압축 공간으로 옮겨 저장된 줄과 바로 비교하고, 그 결과를 attn_v_b로 헤드마다의 출력으로 바꿉니다. 값은 같은 줄의 앞 512칸을 다시 쓰기 때문에 V가 0.00 MiB로 찍힙니다. 그러려면 attn_k_b와 attn_v_b로 나뉜 텐서가 있어야 합니다. attn_kv_b 하나만 있는 파일에서는 헤드 16개의 키와 값을 모두 저장하는 방식으로 돌아갑니다.
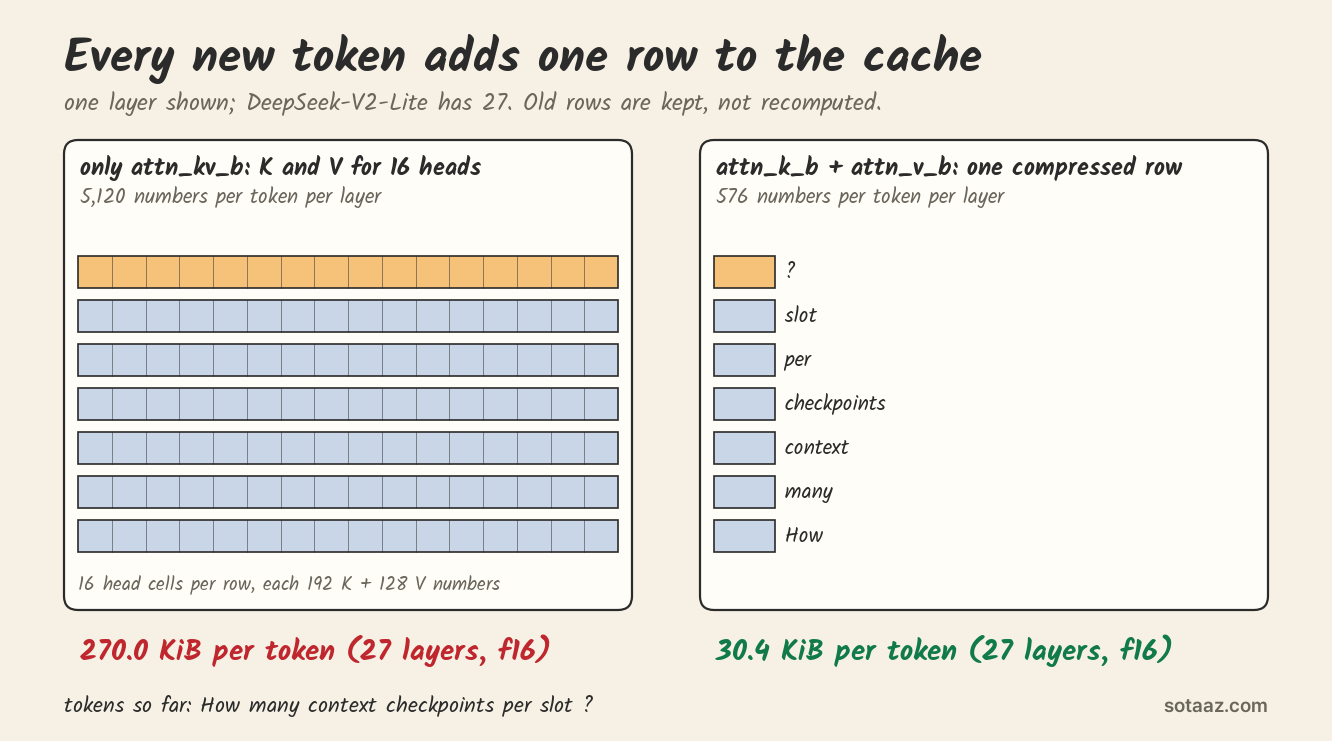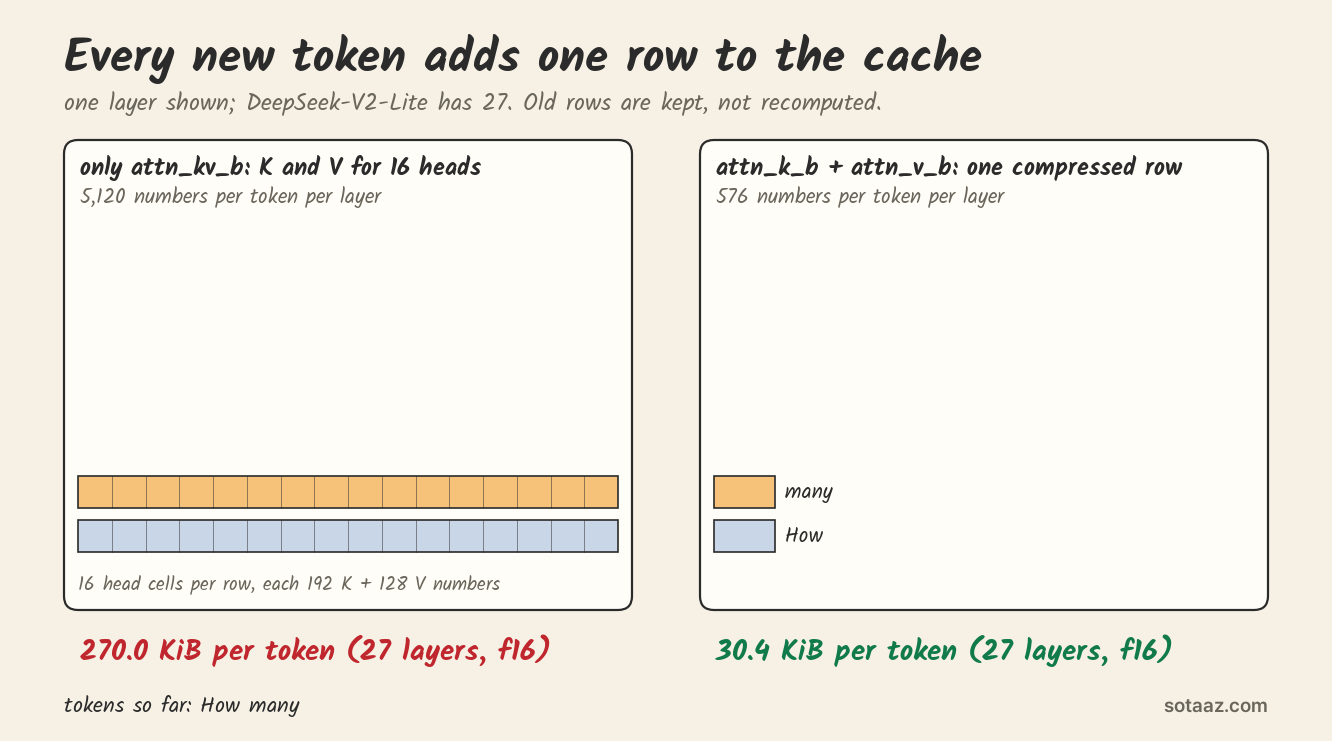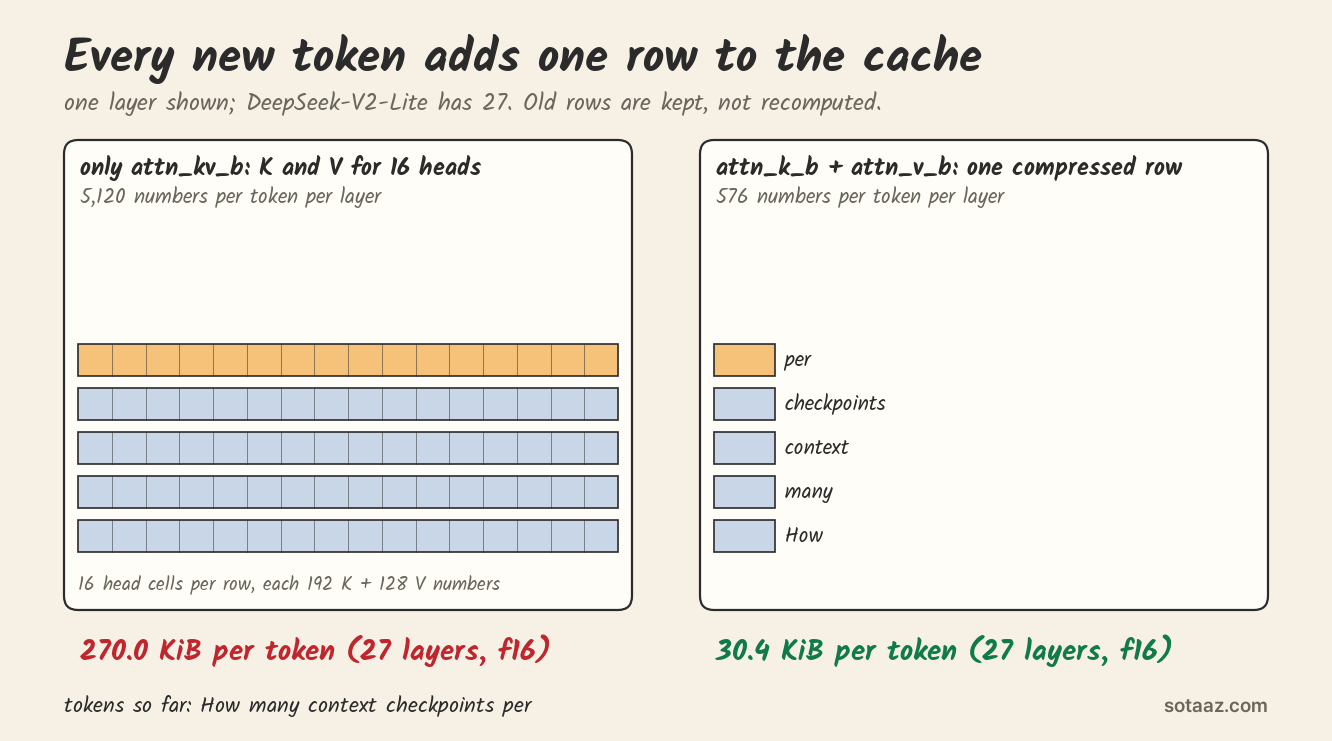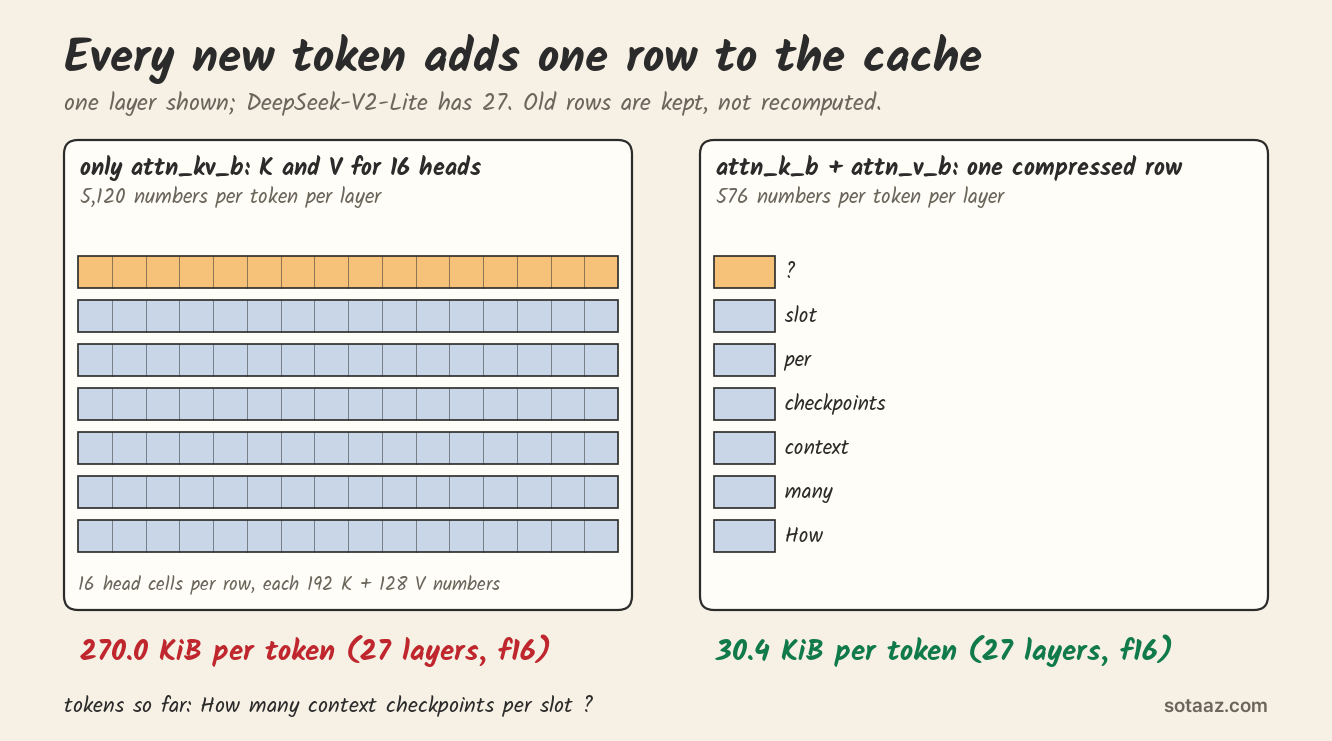
이 한 줄에 층 수와 담아 둘 토큰 수를 곱하면 로그의 두 숫자가 그대로 나옵니다(계산).
손해는 캐시에서 끝나지 않았습니다. 내려받은 파일에서는 llama.cpp가 Flash Attention을 껐습니다. 로그에는 "Flash Attention is assigned to device CPU (usually due to missing support)"와 "Flash Attention not supported, set to disabled" 두 줄만 있고 이유는 적혀 있지 않습니다. 이 모델의 키·값 전체 저장 경로에 GPU 커널이 없어서라고 짐작하지만 확인하지는 않았습니다. 직접 변환한 파일에서는 켜진 채였고, 계산 버퍼도 1,276MiB가 아니라 108MiB였습니다.
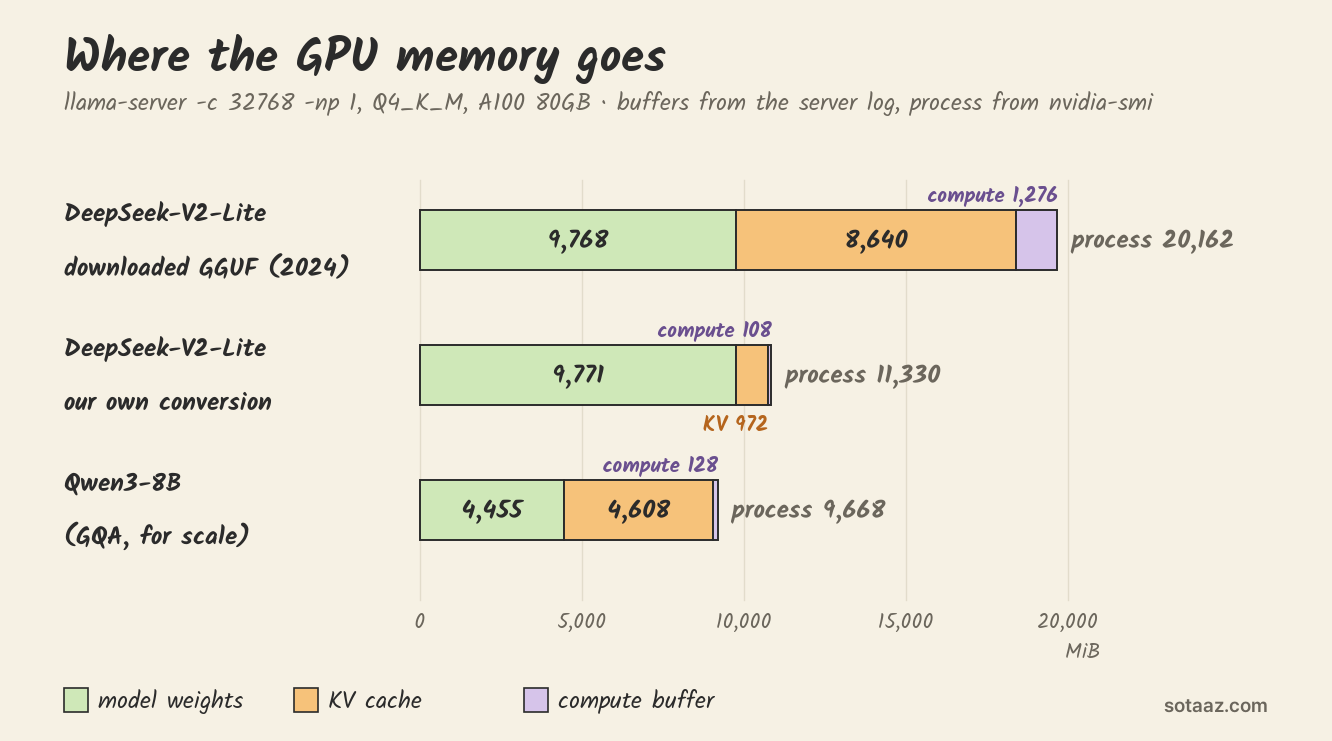
같은 가중치를 같은 Q4_K_M으로 양자화했고 파일 크기 차이도 3.5MB(10,364,416,768바이트와 10,367,958,112바이트)뿐인데, 직접 변환한 쪽이 프로세스 메모리를 8,832MiB 덜 썼습니다(로드 직후 nvidia-smi 측정). 막대는 서버 로그 값이고, nvidia-smi로 잰 프로세스 합계는 CUDA 컨텍스트가 더해져 약 480MiB 더 큽니다.
attn_kv_b만 있다면 직접 변환합니다
먼저 기본 변환기를 그대로 돌려 보세요. 커밋 4da6337에서는 이 모델의 토크나이저 해시를 알아보지 못해 BPE pre-tokenizer was not recognized로 멈췄습니다. 내려받은 GGUF가 이 전처리 이름을 deepseek-llm으로 적고 있어서, 저희는 같은 이름만 지정하는 짧은 래퍼를 쓰고 나머지는 건드리지 않았습니다.
# convert_deepseek.py — llama.cpp 4da6337에서만 확인
import runpy, sys
LLAMA_CPP = "/path/to/llama.cpp"
sys.path.insert(0, LLAMA_CPP)
import conversion.base as base
base.TextModel.get_vocab_base_pre = lambda self, tokenizer: "deepseek-llm"
sys.argv = ["convert_hf_to_gguf.py"] + sys.argv[1:]
runpy.run_path(f"{LLAMA_CPP}/convert_hf_to_gguf.py", run_name="__main__")python convert_deepseek.py /path/to/DeepSeek-V2-Lite-Chat --outtype f16 --outfile ds-v2-lite-f16.gguf
llama.cpp/build/bin/llama-quantize ds-v2-lite-f16.gguf DeepSeek-V2-Lite-Chat-own.Q4_K_M.gguf Q4_K_M저희 서버에서는 하드디스크에서 읽어 f16 파일을 쓰는 데 13분 31초(그 앞의 불러오기 시간은 기록하지 않았습니다), 양자화에 98초가 걸렸습니다. 끝나면 새 파일로 1단계를 다시 돌려 이름 두 개가 나오는지 봅니다.
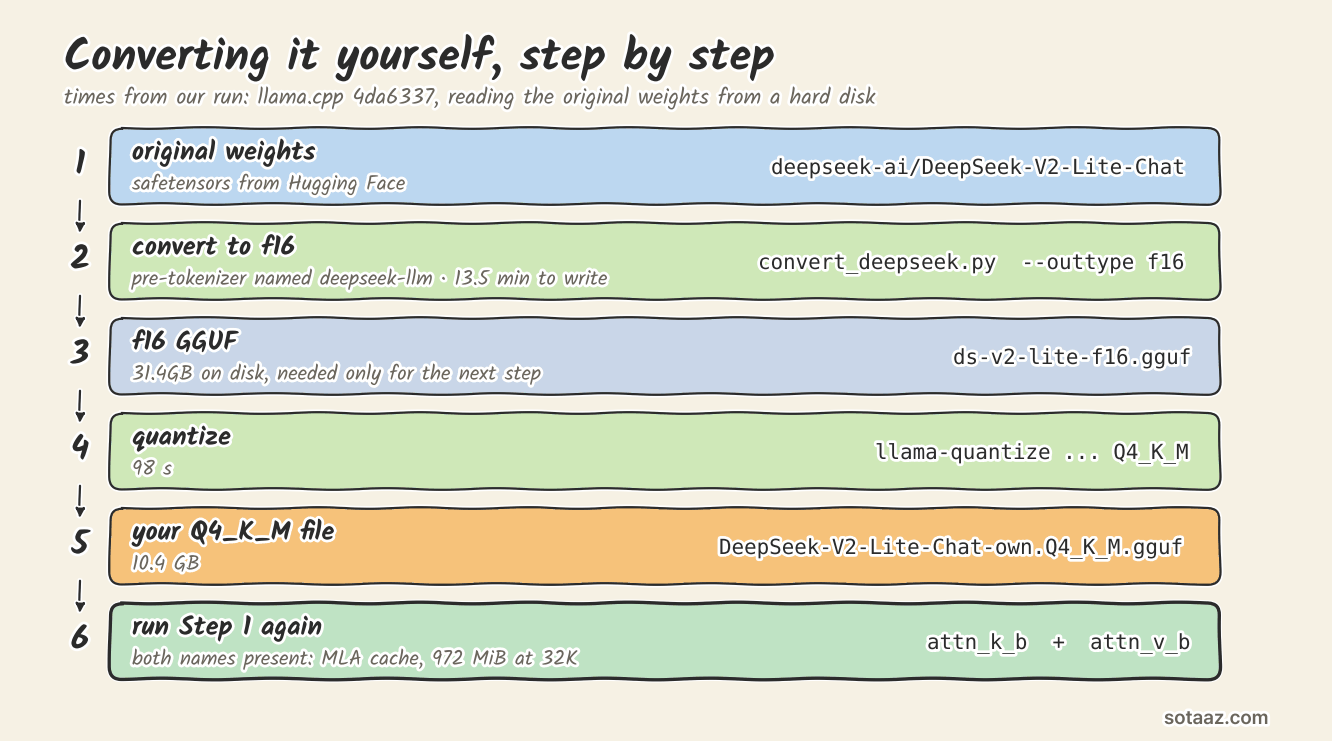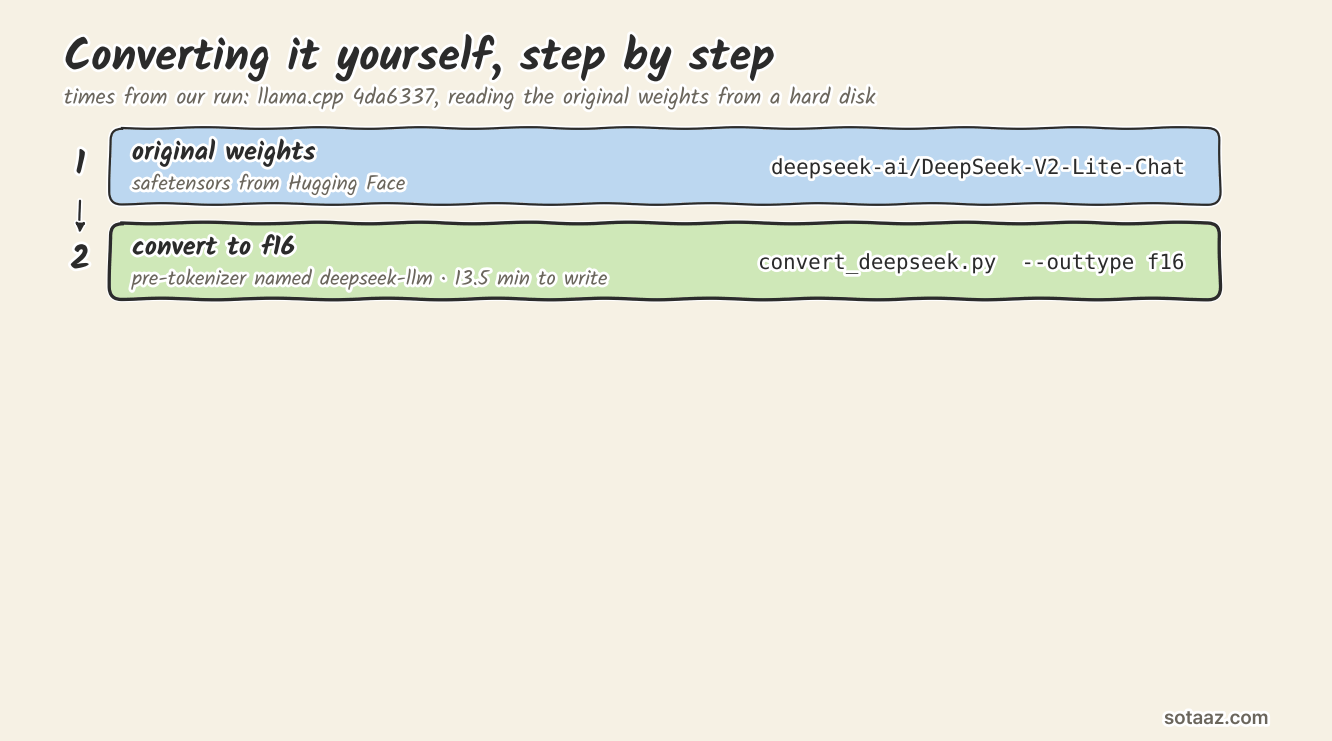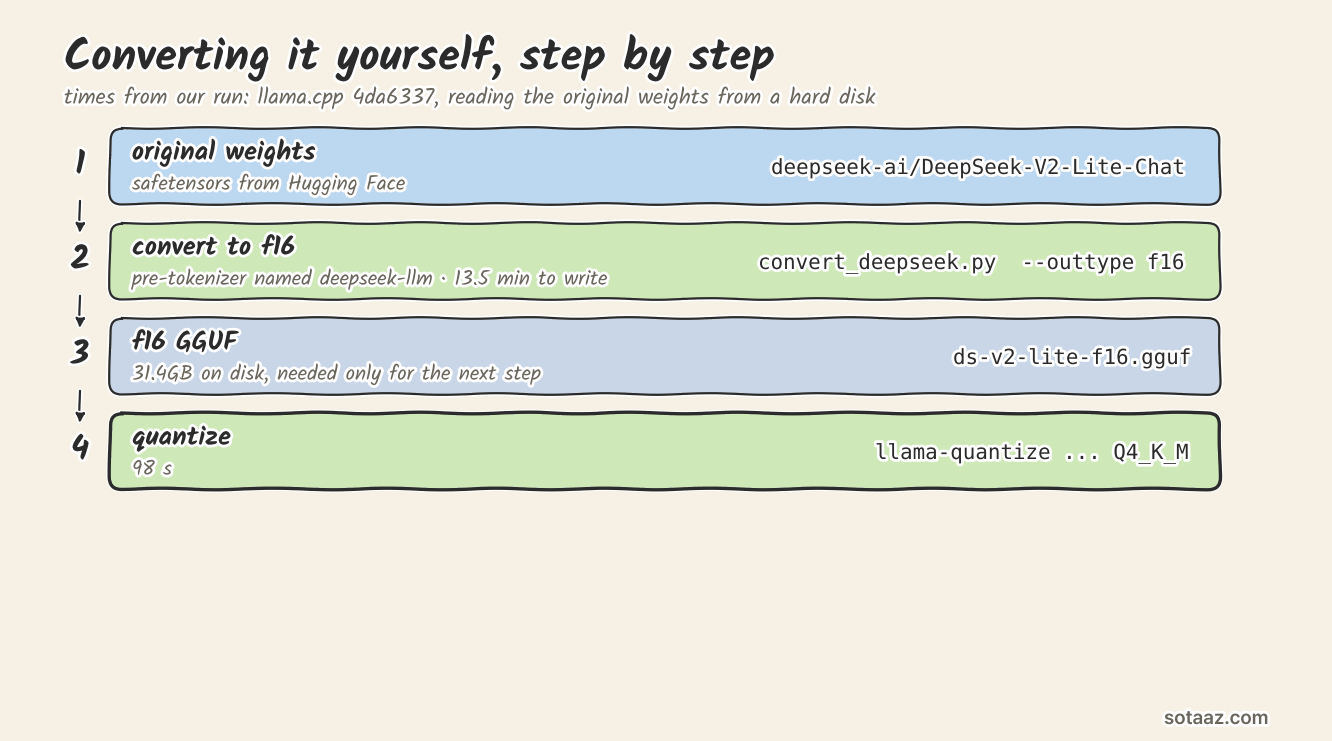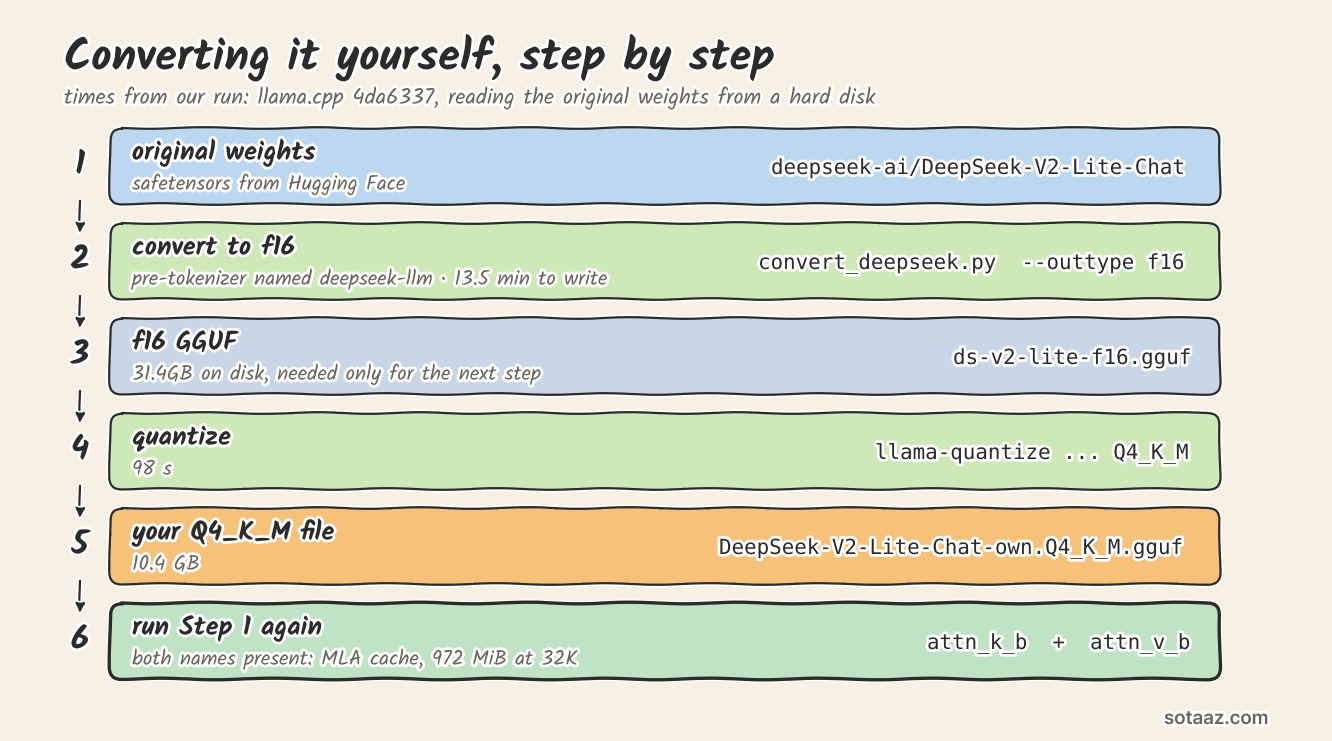
같은 문서를 넣었을 때 토큰 수는 두 파일 모두 30,179개로 같았습니다. 전처리 이름을 같게 지정했으니 예상한 결과입니다. 다만 메타데이터 값 하나는 달랐습니다. 지금 변환기는 add_bos_token = false로 적었고, 내려받은 파일은 true입니다. 채팅 템플릿이 BOS 토큰을 직접 넣기 때문에 첫 채팅 요청은 두 파일 모두 30,233토큰이었습니다. /completion에 날 텍스트를 보낸다면 서버를 --override-kv tokenizer.ggml.add_bos_token=bool:true로 띄우거나 토큰을 직접 붙이세요.
문서는 제대로 읽었을까
llama.cpp 서버 README에서 30,179토큰 분량을 잘라 두 파일에 넣고, 정답이 앞·중간·끝에 흩어진 질문 7개를 물었습니다. 정해 둔 문자열 채점으로 두 파일 모두 7개 중 6개를 맞혔고, 비교용으로 같은 문서를 넣은 Qwen3-8B도 6개였습니다. 내려받은 파일은 기본값 하나를 틀렸고, 직접 변환한 파일은 마지막 질문에서 오류 종류를 틀렸습니다. Qwen3-8B도 같은 질문에서 다른 오류 예시를 답해 틀렸습니다. 잘라 낸 문서에 오류 예시가 여러 개 들어 있어 애매한 질문이었습니다. 질문 7개로는 문서 전체를 읽는다는 점까지만 알 수 있고, 어느 파일이 더 정확한지는 알 수 없습니다.
기록은 했지만 예측하지 않은 숫자도 하나 있습니다. 생성 속도 중앙값이 내려받은 파일은 초당 23.7토큰, 직접 변환한 파일은 149.0토큰이었습니다. 한 번씩만 돌렸고, 두 DeepSeek 실행은 같은 모델(A100 80GB PCIe)의 서로 다른 카드에서 돌았으니 참고로만 봐 주세요.
예측과 결과
측정 전에 예측을 적어 두었습니다. C로 시작하는 예측은 내려받은 파일의 결과를 본 뒤 적었고, f16 변환이 이미 돌고 있을 때, 새 파일을 양자화하거나 띄우기 전에 커밋했습니다. C1은 P1과 같은 계산입니다. 9개 중 3개가 틀렸습니다.
| 예측 | 결과 | |
|---|---|---|
| P1: 내려받은 파일의 KV 캐시 972MiB | 8,640MiB | 틀림 |
| P2: Qwen3-8B KV 캐시 4,608MiB | 4,608MiB | 맞음 |
| P3: DeepSeek 프로세스가 Qwen3-8B보다 작지 않고, 차이는 1.5GiB 이내 | 내려받은 파일 10.2GiB, 직접 변환 1.62GiB 더 큼 | 틀림 |
| P4: Qwen3-8B 6/7 이상, DeepSeek 4/7 이상 | 세 파일 모두 6/7 | 맞음 |
| P5: DeepSeek이 프롬프트를 더 빨리 처리(활성 파라미터 약 2.4B 대 8B) | 초당 2,732·3,241 대 3,518토큰 | 틀림 |
| C1: 직접 변환한 파일의 KV 972MiB | 972MiB | 맞음 |
| C2: 직접 변환한 파일의 프로세스 11,000-12,500MiB | 11,330MiB | 맞음 |
| C3: 문서 토큰 수가 같은 30,179개 | 30,179개 | 맞음 |
| C4: 직접 변환한 파일 5/7 이상 | 6/7 | 맞음 |
P5는 한 번씩만 잰 값이고, 토크나이저가 달라 첫 요청(문서와 질문)이 DeepSeek에서는 30,233토큰, Qwen에서는 26,764토큰이었습니다. 3,241은 나머지 둘과 다른 카드에서 잰 값입니다. 이 조건에서는 활성 파라미터가 적어도 긴 프롬프트를 더 빨리 읽지는 않았습니다.
할 일
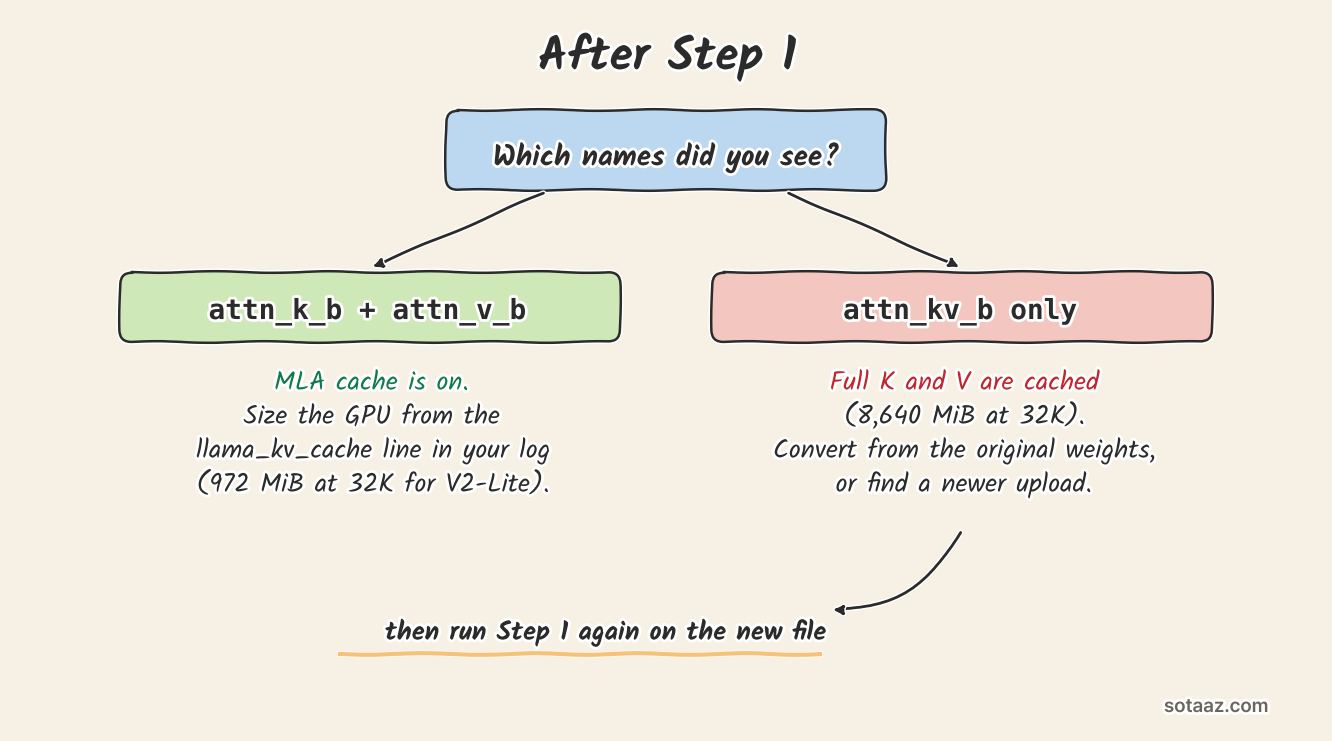
- DeepSeek-V2·V2-Lite GGUF는 GPU 크기를 정하기 전에 1단계부터 돌립니다.
attn_kv_b만 보이면 원본에서 직접 변환하거나, 더 최근에 올라온 파일을 찾아 같은 방법으로 확인합니다.- 메모리를 계획할 때는 모델 카드가 아니라 직접 띄운 서버 로그의 KV 줄을 기준으로 삼습니다.
한계
- A100 80GB PCIe에서만 쟀습니다. 내려받은 파일과 Qwen3-8B는 한 장에서, 직접 변환한 파일은 같은 모델의 다른 한 장에서 돌았습니다. 계산으로는 직접 변환한 파일의 32K 사용량 11,330MiB가 12GB 카드(12,288MiB) 안에 들어가고, 내려받은 파일의 20,162MiB는 들어가지 않습니다. 다만 llama.cpp 기본값
-fit은 빈 메모리를 1,024MiB 남기려 하는데 11,330에 1,024를 더하면 12,354MiB라, 12GB 카드에서는 컨텍스트를 줄이거나 층 일부를 GPU 밖으로 옮길 수 있습니다. 12GB 카드는 저희에게 없어 직접 확인하지 못했고, 드라이버가 쓰는 몫도 카드마다 다릅니다. - 내려받은 파일은 하나만 확인했습니다. 다른 업로드는 새로 변환됐을 수 있으니 1단계로 확인하세요.
- 래퍼는
4da6337에서만 확인했습니다. 더 새로운 변환기는 토크나이저를 스스로 알아볼 수도 있습니다. - 속도는 모두 한 번씩 돌린 값입니다. 프롬프트 처리 속도는 P5로 미리 예측했고, 생성 속도는 예측하지 않았습니다.