Latent Sparse Attention: 레이어 하나는 72배, 모델 전체는 9배 (1,000만 토큰 기준)
논문은 1,000만 토큰에서 Qwen3.8-27B 레이어 하나의 prefill 72.4배, 모델 전체 첫 토큰 9.21배를 보고했고, 512K에서는 첫 토큰 이득이 거의 없습니다. Qwen3-8B로 만든 작은 LSA 인덱스에서 실제 query를 따라가며 어떻게 작동했는지, 한계가 무엇인지, 무엇을 놓쳤는지 정리했습니다. LSA 서버는 돌리지 않았습니다.
Latent Sparse Attention: 레이어 하나는 72배, 모델 전체는 9배 (1,000만 토큰 기준)
Latent Sparse Attention(LSA)은 Prefrontal AI와 ETH Zurich의 Kubicek 등이 내놓은 새 어텐션 구조입니다. 논문에 따르면 컨텍스트가 1,000만 토큰일 때 Qwen3.8-27B의 어텐션 레이어 하나는 full attention보다 컨텍스트를 읽어 들이는 prefill이 72.4배, 새 토큰을 만드는 decode가 42.5배 빠릅니다. H200 8장에서 모델 전체를 돌리면 첫 토큰까지 걸리는 시간이 4,582초(약 76분)에서 약 8분으로 줄어 9.21배 빨라집니다.
다만 이 이득은 컨텍스트가 아주 길어져야 나타납니다. 같은 표에서 첫 토큰은 512K에서 1.03배, 1M에서 1.51배이고, 1M까지는 그다음 토큰들이 빨라지지 않습니다. 표에는 1M과 10M 사이 값이 없으니, 10M 부근이 아니라면 이 배수를 그대로 기대해서는 안 됩니다.
아이디어는 예시 하나로 설명됩니다. sparse attention은 앞선 토큰 가운데 일부만 읽으므로 무엇을 읽을지 고르는 장치가 필요합니다. LSA는 앞선 토큰을 비슷한 것끼리 버킷에 모아 두고, 새 토큰이 토큰 하나하나가 아니라 버킷에 점수를 매기게 합니다. 저희가 Qwen3-8B로 이 인덱스를 간단히 만들어 보니, 구텐베르크 머리말의 Author: Jane Aust와 196토큰 뒤 표지의 Jane Aust가 한 버킷에 들어갔습니다. Python 파일의 query_count: int와 query_count: Number도 함께 묶였습니다.
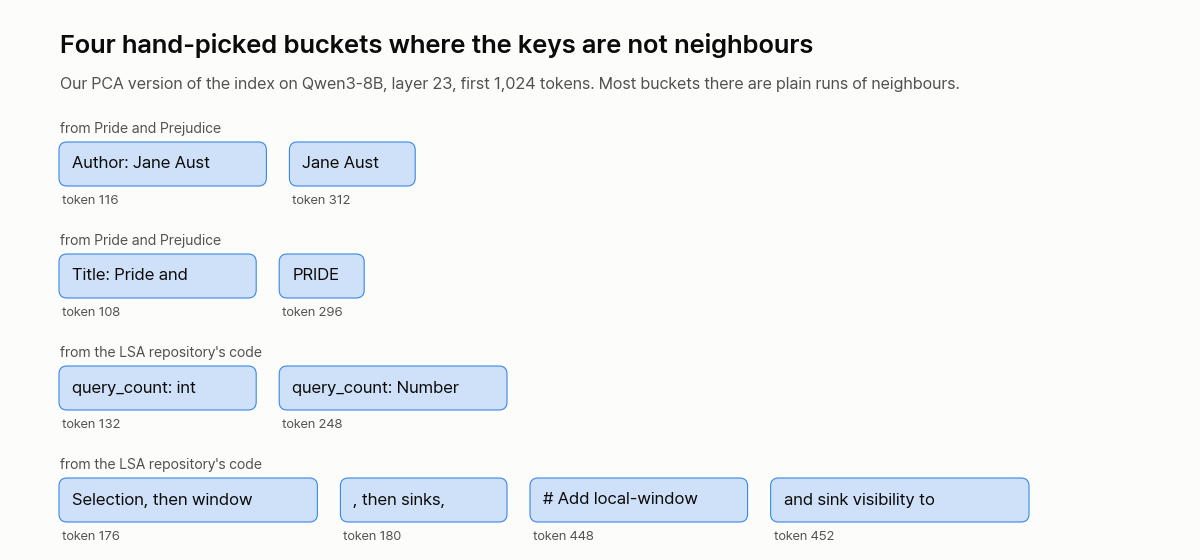
이 예시들은 눈에 띄는 것을 저희가 골라낸 것입니다. 레이어 23의 앞쪽 1,024토큰을 보면 대부분의 버킷은 그냥 이웃한 토큰끼리 묶였고, 문서 세 편에서 128개 중 95개, 74개, 93개가 그랬습니다.
이 글에서는 먼저 LSA가 줄이려는 비용을 보고, 실제 query 하나를 따라가면서 LSA의 동작을 살펴보고, 좋은 점과 한계점을 살펴봅니다. 그다음 저희가 측정한 시험에서 어떻게 나왔는지 적습니다. 참고로 LongCat Sparse Attention도 줄여서 LSA라고 부르지만 이 글과는 다른 구조입니다.
읽을 key를 고르는 작업이 비용이 많이 드는 이유
어텐션에서 새 토큰은 질문에 해당하는 query를 만들고, 앞선 토큰들은 저마다 이름표에 해당하는 key를 가집니다. full attention은 query를 모든 key와 비교하므로, 컨텍스트가 1,000만 토큰이면 새 토큰 하나가 1,000만 번 비교합니다.
sparse attention은 그 대신 4,096개처럼 정해진 개수만 읽습니다. 읽기는 싸졌지만, 앞선 토큰 전체에서 읽을 4,096개를 누군가 잘 골라 줘야 합니다. 이 일을 맡은 부분을 indexer라고 합니다.
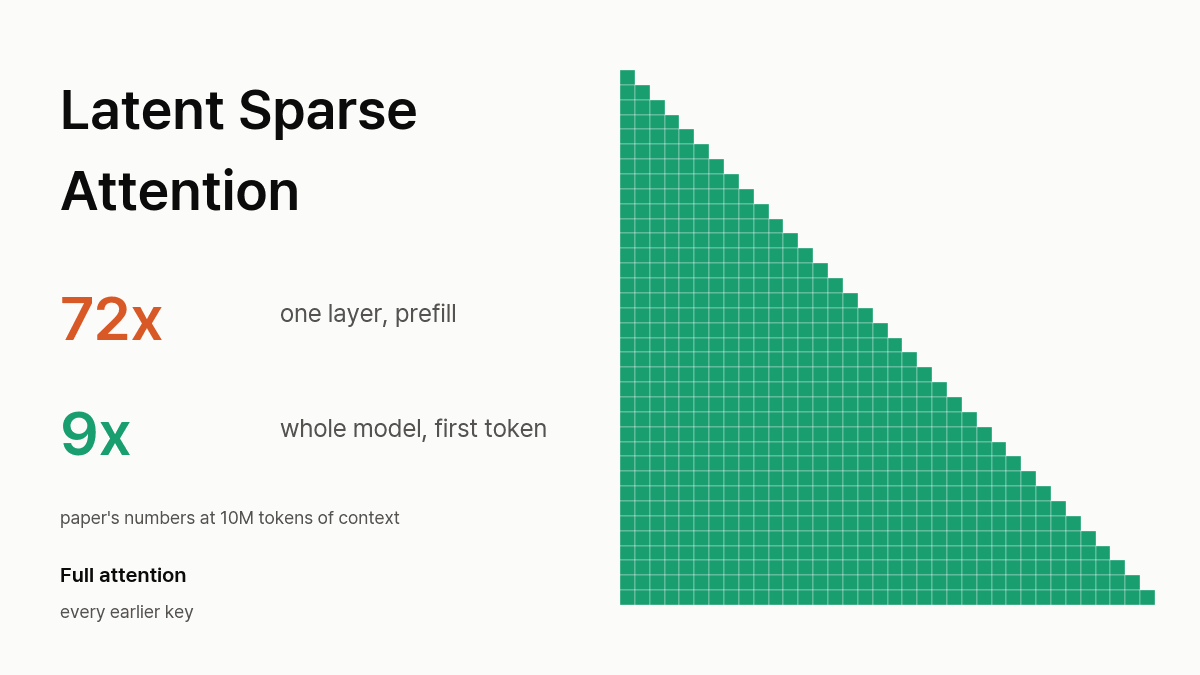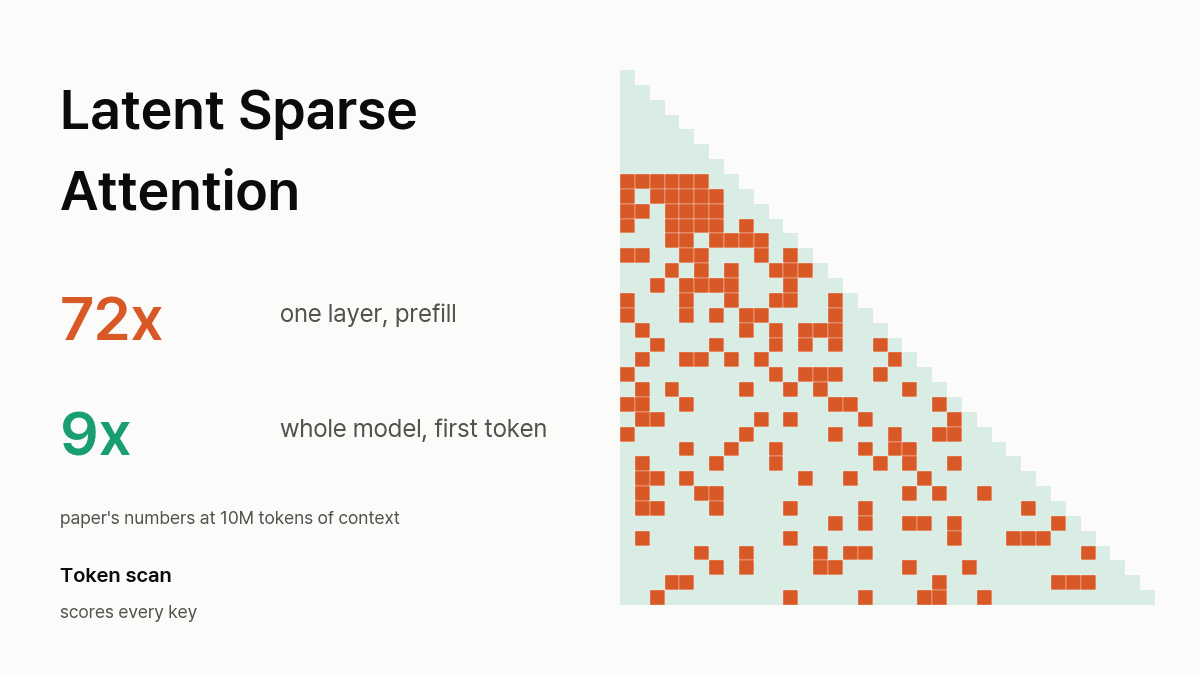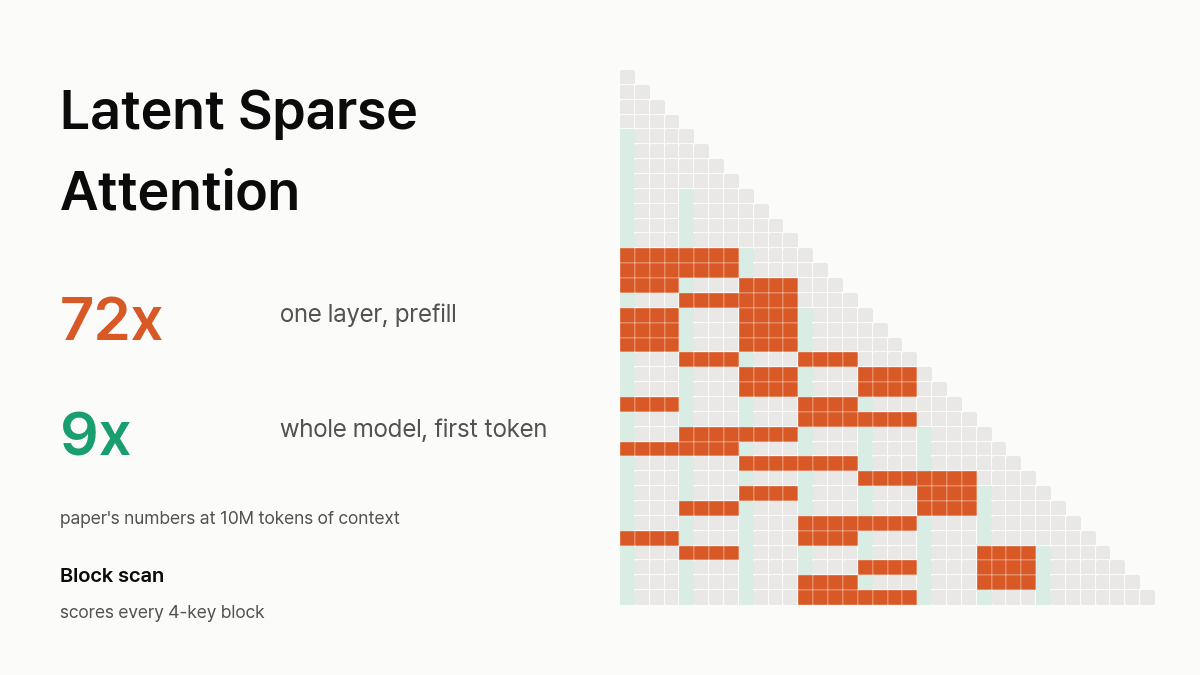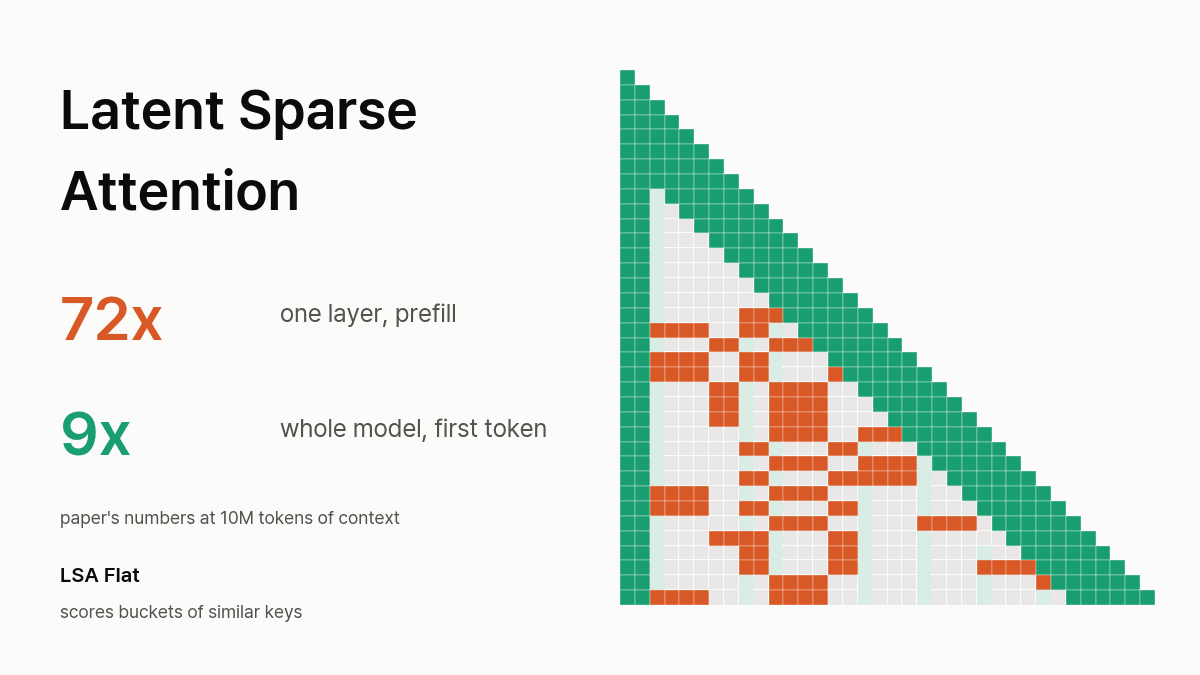
고르는 방법은 query 하나가 점수를 몇 번 매기느냐에 따라 크게 세 가지로 나뉩니다. 1,000만 토큰 기준으로 세면 다음과 같습니다.
- 토큰 스캔은 key마다 점수를 매깁니다. 1,000만 번입니다.
- 블록 스캔은 붙어 있는 key 4개를 한 묶음으로 보고 묶음마다 매깁니다. 250만 번입니다. (1,000만 / 4 = 250만)
- LSA는 key 약 8개가 든 버킷마다 매깁니다. 약 125만 번입니다. (1,000만 / 8 = 125만)
이 세 숫자는 1,000만을 묶음 크기로 나눈 값입니다. LSA에는 탐색 방식이 두 가지 있습니다. 위처럼 버킷을 전부 채점하는 것이 Flat이고, 버킷을 나무 모양으로 정리해 일부 경로만 채점하는 것이 Tree입니다. 이 글에서 별다른 언급이 없다면 모델 전체 숫자와 저희 시험은 Flat 기준입니다.
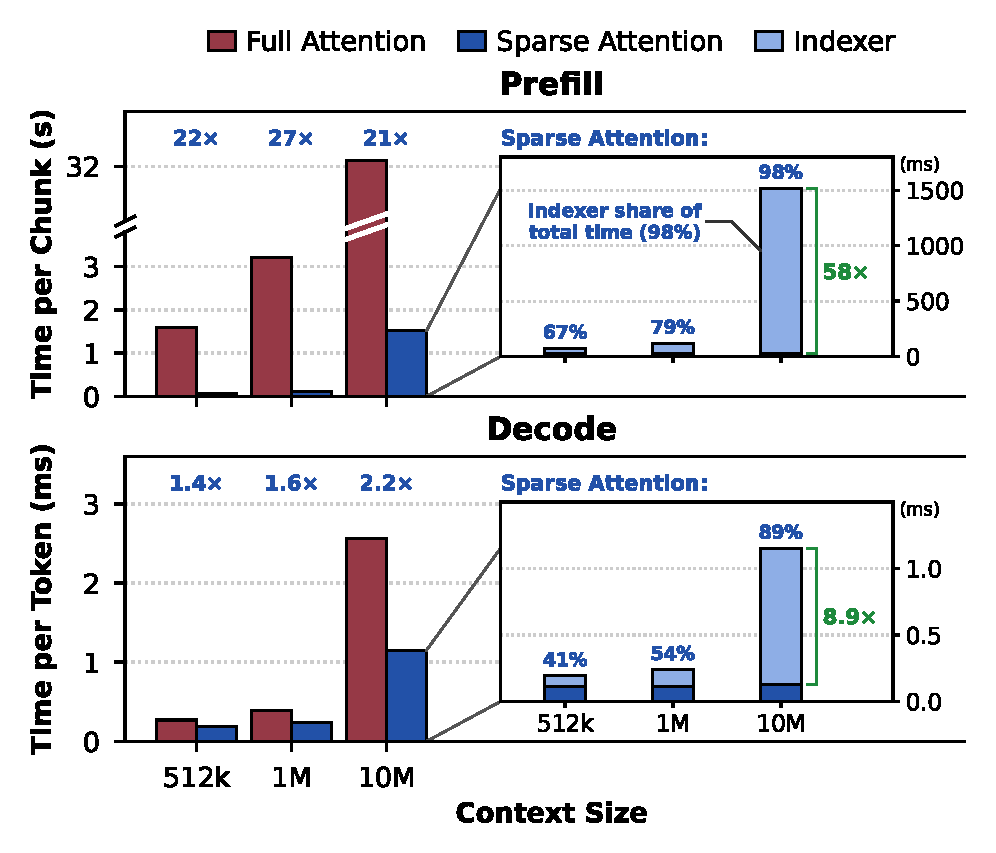
Scoring 횟수를 줄이는 일이 왜 중요한지는 논문의 측정에 나옵니다. GLM-5.3-Flash 레이어 하나를 1,000만 토큰에서 돌리면 sparse attention prefill 전체 시간의 98%가 indexer에 들어갑니다. 저자들은 indexer 비용이 0이 된다면 prefill이 58배, decode가 8.9배 더 빨라질 것으로 계산했습니다(H200 1장). LSA가 줄이려는 것은 읽는 비용이 아니라 바로 이 고르는 비용입니다.
아래는 논문의 그림 2입니다(Kubicek 등, CC BY 4.0). 오른쪽 작은 그래프에서 연한 파란 부분이 indexer이고, 컨텍스트가 길어질수록 sparse attention 시간의 대부분을 차지합니다.
실제 query 하나를 끝까지 따라가 보기
Scoring 횟수를 줄이면 그만큼 놓치는 것도 생길 수 있지 않을까요. 실제로 어떤지 저희가 만든 작은 인덱스로 query 하나를 따라가 보겠습니다. 모델은 Qwen3-8B, 문서는 『오만과 편견』, 위치는 레이어 23에서 테스트한 결과입니다.
따라갈 query는 소설의 23,711번째 토큰입니다. 모델은 단어를 조각(토큰)으로 쪼개 읽는데, 이름 Bingley는 B, ingle, y 세 조각이 됩니다. 이 query는 "...if Miss Bennet were not decidedly better. Bingley" 문장 끝의 y, 곧 모델이 Bingley라는 이름을 막 다 쓴 순간입니다.
이 query를 고른 기준은 성적이 보통이라는 것입니다. 이 문서에서 query 1,024개를 시험했고, LSA가 비교 대상(뒤에 나올 8개 블록)보다 앞선 정도가 딱 중간인 query를 골랐습니다. 잘된 사례만 골라 보여 주지 않으려는 것입니다.
이 query가 보려던 것. 먼저 고를 필요가 없는 key가 있습니다. 문서 맨 앞 4개와 바로 앞 512개는 점수 없이 항상 읽습니다. 그래서 실제로 골라야 하는 key는 그 사이의 23,195개입니다. 이 글에서는 query가 이 23,195개에 주는 어텐션을 먼 어텐션(far attention)이라고 부르겠습니다.
이 query의 먼 어텐션은 몇 군데에 몰려 있습니다. 먼 어텐션 전체를 100으로 보면 62.6이 단 8개 key로 갑니다. 그중 6개는 앞서 나온 다른 Bingley들의 가운데 조각 ingle이고, 2개는 서문의 "Miss Austen"에 든 Aust입니다. 방금 Bingley를 쓴 모델이 앞에 나온 Bingley들을 다시 보는 셈입니다. 그러니 잘 고르는 방법이라면 23,195개 가운데서 이 8개를 찾아내야 합니다.
찾는 방법 세 가지. 모두 key 256개까지 읽을 수 있습니다. 성적은 읽은 key에 먼 어텐션의 몫이 얼마나 담겼는지로 매기고, 이 값을 커버리지라고 부르겠습니다. 0.40이면 40%가 담겼다는 뜻입니다. 블록 스캔은 8개 단위로 잘라 넣었습니다. 그래야 점수 횟수가 LSA와 거의 같아져서, 같은 횟수로 누가 더 잘 찾는지 볼 수 있습니다. 이 글에서는 이것을 8개 블록이라고 부릅니다.
- 토큰 스캔은 23,195개 전부에 점수를 매깁니다. 8개를 모두 찾았고 커버리지는 0.771입니다.
- 8개 블록은 2,899번 점수를 매깁니다. 8개 중 2개를 찾았고 커버리지는 0.217입니다.
- LSA는 버킷 2,944개에 점수를 매긴 뒤, 점수가 높은 것부터 35개를 열어 256개를 채웁니다. 처음 연 세 버킷은
Bingley followed,ingley had not, 그리고Bingley was와 92토큰 뒤의ingley가 함께 든 버킷입니다. 8개 중 5개를 찾았고 커버리지는 0.401입니다.
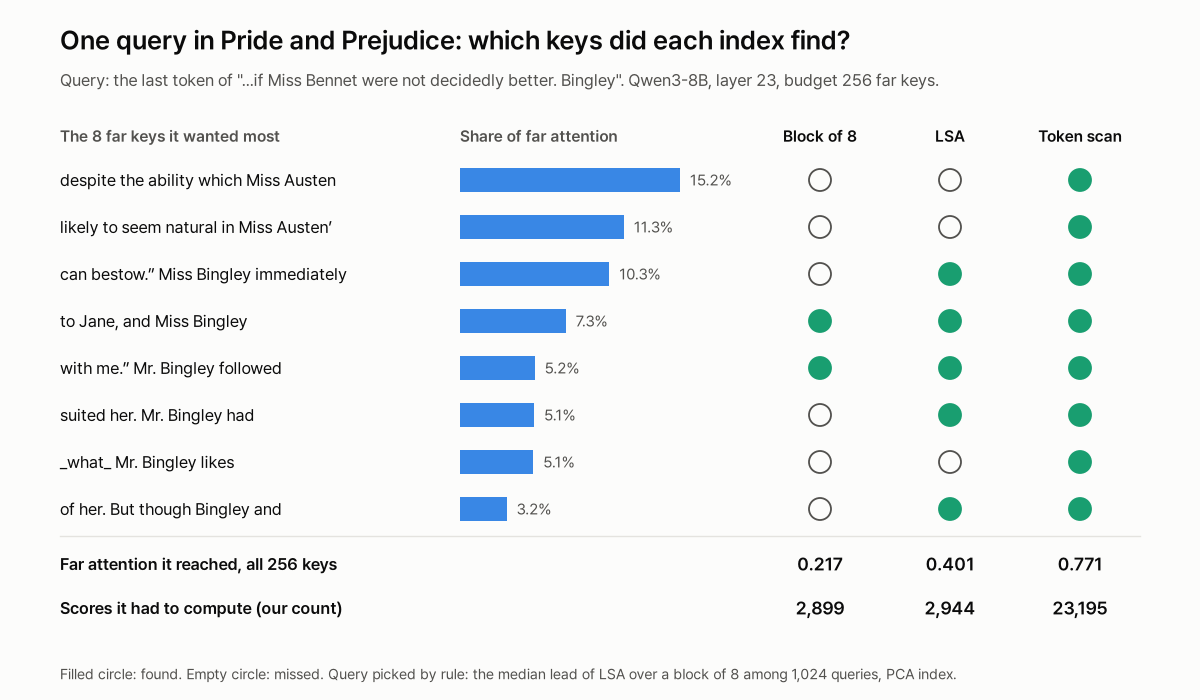
결과를 정리하면 이렇습니다. Scoring 횟수가 거의 같은데 LSA는 8개 블록의 두 배 가까이 건졌고, 토큰 스캔의 약 8분의 1만 채점하고도 그 절반 정도를 건졌습니다. 이유를 저희는 버킷의 평균 벡터는 대체로 Bingley를 나타내지만, 8개 블록의 평균 벡터에는 이름과 주변 단어가 뒤섞이기 때문이라고 해석했습니다.
대신 LSA가 놓친 것도 있습니다. 몫이 가장 큰 Aust 두 개와 ingle 하나는 끝내 열리지 않았습니다. 이 셋이 먼 어텐션의 31.5%를 차지하며, 토큰 스캔만 찾았습니다. 버킷 점수가 안에 든 key를 대신하기 때문에, 버킷 점수가 충분히 높지 않으면 그 key는 한 번도 살펴보지 못합니다. 점수 횟수를 줄인 값을 여기서 치른 셈입니다.
같은 과정을 일반적으로 쓰면
방금 query에 일어난 일을 순서대로 정리하면 다섯 단계입니다. 앞의 두 단계는 key가 들어올 때 미리 해 두고, 뒤의 세 단계는 query마다 합니다.
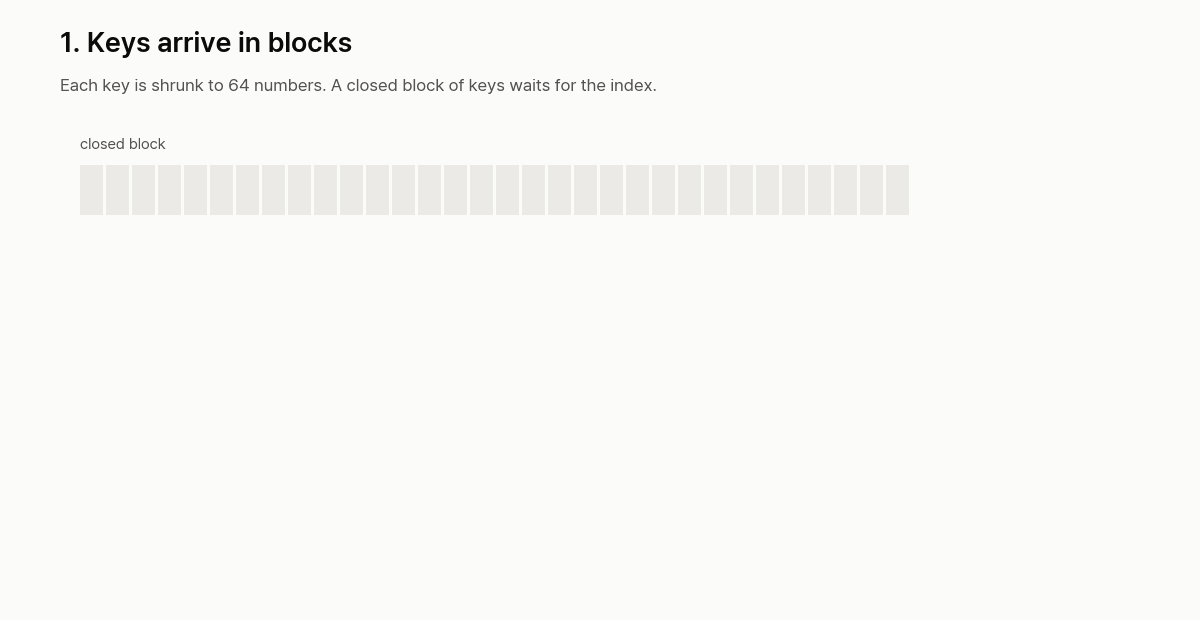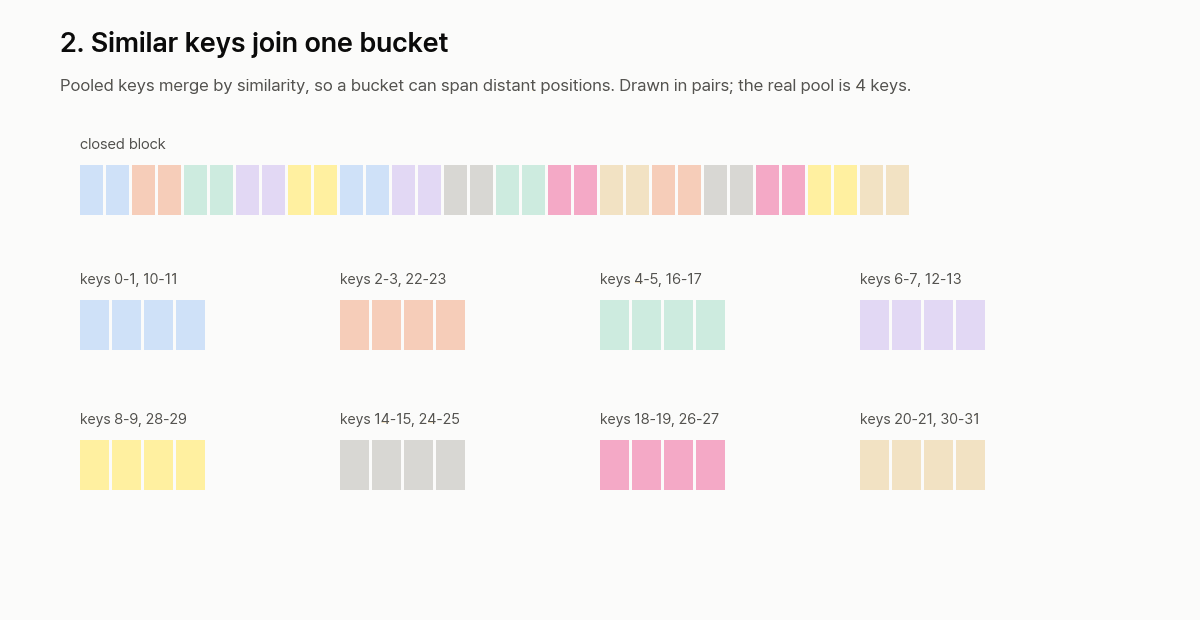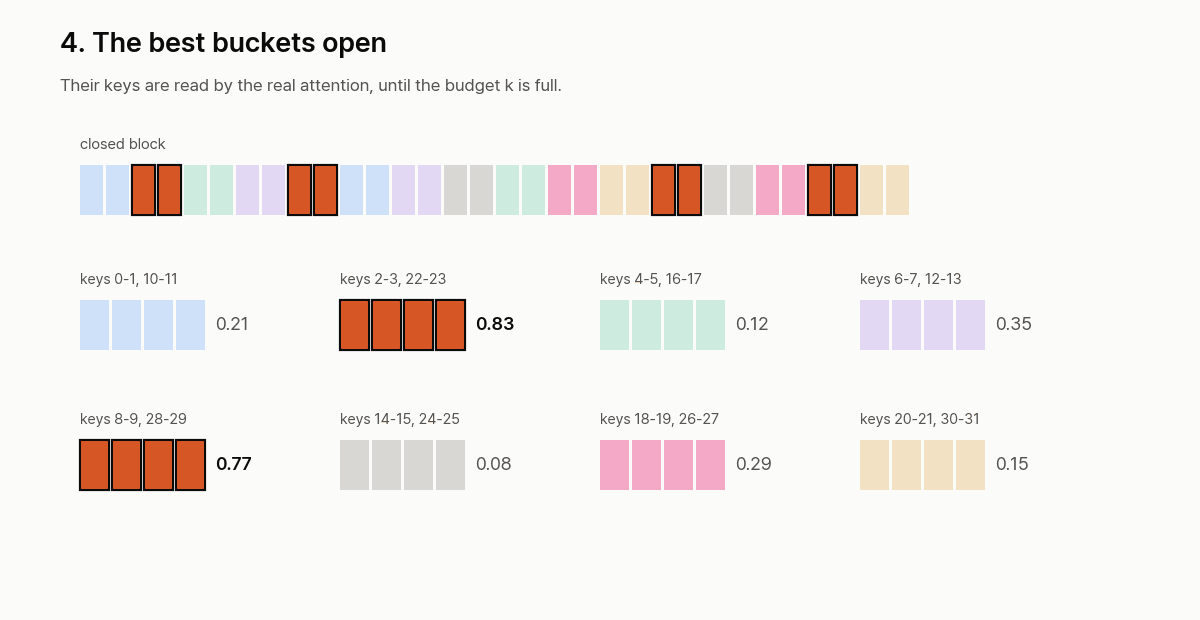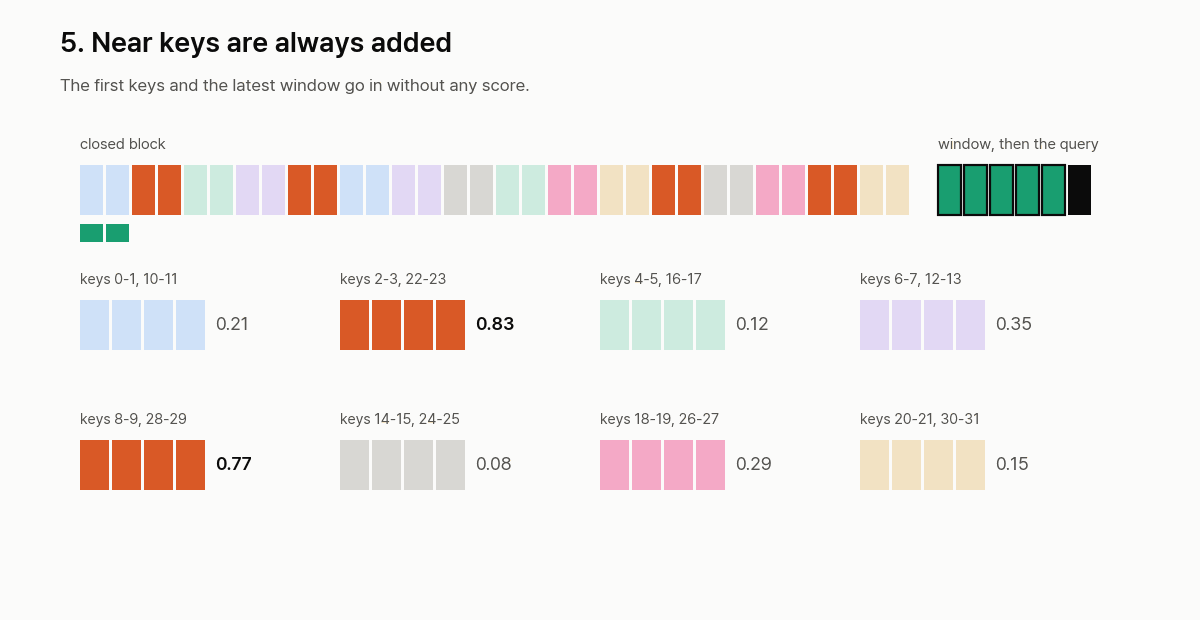
- 줄입니다. key마다 64차원으로 투영합니다. 이 작은 key는 고르는 데만 씁니다.
- 묶습니다. key 512개짜리 블록마다 4개씩 합친 뒤 비슷한 것끼리 병합(Ward 군집화)해, 평균 8개, 많아야 16개가 든 버킷을 만듭니다.
- 채점합니다. query도 같은 크기로 줄여 버킷마다 평균 벡터(centroid)와 비교합니다.
- 엽니다. 점수가 높은 버킷부터 열어 예산이 찰 때까지 key를 담습니다. Qwen3.8-27B에서는 4,096개입니다.
- 가까운 key를 더합니다. 맨 앞 4개와 최근 512개는 언제나 읽습니다. 진짜 어텐션은 이렇게 만든 목록 위에서 돌아갑니다.
3단계부터 5단계까지를 짧은 함수로 옮기면 다음과 같습니다. 저희가 이해한 내용을 시험하려고 직접 쓴 코드이고, 임의 벡터로 한 번 돌려 봤습니다. 저장소의 실제 구현은 decode_flat이고 배치 단위로 동작합니다.
def read_list(q, centroids, members, pos, top_p, k, window=512, sinks=4):
    """Which keys one query reads. q and centroids are unit vectors in the small index space."""
    near = set(range(sinks)) | set(range(max(0, pos - window), pos + 1))
    scores = centroids @ q                       # one score per bucket, not per key
    picked = scores.topk(min(top_p, len(scores))).indices
    far = []
    for b in picked.tolist():                    # open the best buckets first
        far += [key for key in members[b] if key not in near]
        if len(far) >= k:
            break
    return sorted(near | set(far[:k]))
window를 블록 하나 크기인 512개로 잡은 이유는 아직 군집화되지 않은 key를 모두 덮기 위해서입니다. 연 버킷의 key가 이미 window나 맨 앞 4개에 들어 있으면 건너뛰고 다음 key를 담습니다.
1단계의 작은 key를 만드는 방법은 세 가지입니다. 맨 위의 속도 숫자는 첫 번째 방법에서 나왔고, 저희 시험은 주로 두 번째 방법을 썼습니다.
- D-LSA는 이미 학습된 모델을 고정한 채 작은 투영 두 개와 레이어별 temperature만 학습해, 인덱스가 모델의 실제 어텐션을 흉내 내게 합니다. 논문은 3억 5,200만 토큰으로 48,000 스텝을 학습했고, 이 가중치는 저장소 릴리스로 받을 수 있습니다.
- D-LSA(Training-Free)는 학습 대신 PCA를 씁니다.
- N-LSA는 LSA를 넣은 채 모델을 새로 학습합니다. 논문은 약 5억 파라미터 모델로 시험했으며 Qwen에 적용한 결과는 아닙니다.
Contribution
여기부터는 논문이 보고한 결과입니다. 먼저 기존 구조와 나란히 놓으면 LSA의 위치가 보입니다.
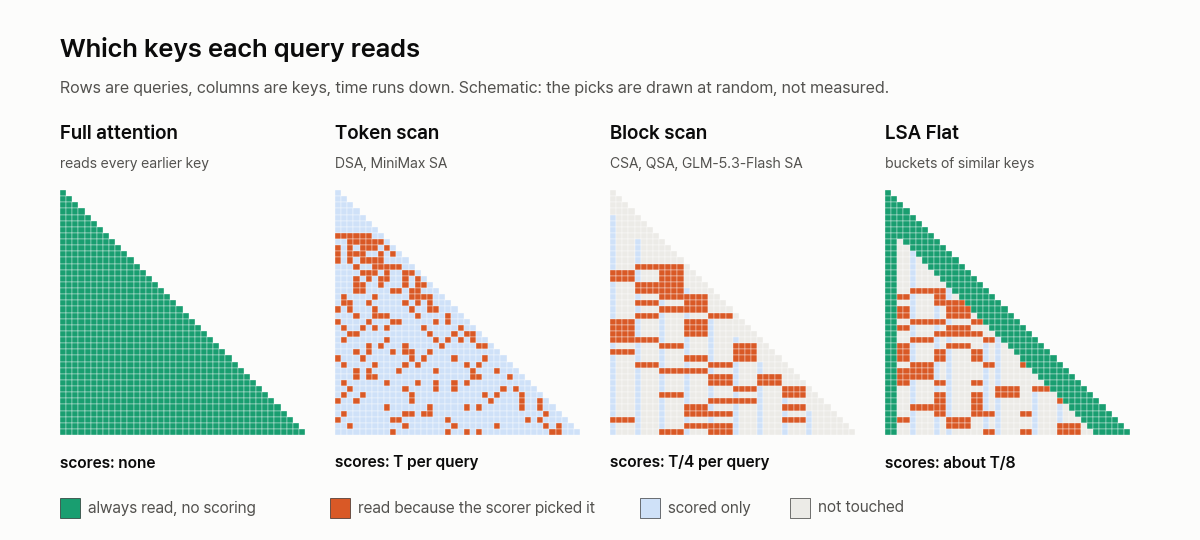
| 구조 | query가 점수를 매기는 대상 | query당 점수 계산 | 읽는 것 |
|---|---|---|---|
| Full attention | 없음 | 없음 | 앞선 key 전부 |
| Sliding window | 없음 | 없음 | 최근 key, 오래된 것은 버림 |
| 토큰 스캔(DSA, MiniMax SA) | 모든 key | T | 점수가 높은 key |
| 블록 스캔(CSA, QSA, GLM-5.3-Flash SA) | 붙어 있는 key 4개 묶음 전부 | T/4 | 점수가 높은 묶음 |
| 이전의 내용 기반 방식(ClusterKV, RetroInfer) | 군집 centroid 전부 | T보다 적지만 T와 함께 증가 | 점수가 높은 군집의 key |
| LSA Flat | 버킷 전부 | 약 T/8 | 점수가 높은 버킷의 key |
| LSA Tree | beam search 경로의 노드 | log T에 비례 | 점수가 높은 버킷의 key |
T는 앞선 key 수입니다.
고르는 비용을 줄이면서 읽는 양은 그대로 둡니다. 1,000만 토큰에서 query 하나의 점수 횟수는 토큰 스캔의 약 8분의 1, 블록 스캔의 약 절반인데, 고른 key 4,096개는 그대로 읽습니다. 그러려면 버킷 정보를 따로 저장해야 하지만 크지 않습니다. 논문에 따르면 GLM-5.3-Flash의 1,000만 토큰에서 레이어당 KV 캐시 10GiB 옆에 버킷 캐시는 246MiB입니다.
1,000만 토큰에서는 새 토큰을 만드는 속도도 빨라집니다. 모델 전체에서 첫 토큰 다음의 토큰들은 full attention보다 2.87배 빠릅니다. 같은 비교에서 블록 스캔은 0.89배로 오히려 조금 느립니다. 다만 두 구조는 읽는 key 수가 달라서(블록 스캔은 2,048개, LSA는 4,096개에 맨 앞과 최근 key를 더함) 구조만의 차이로 볼 수는 없습니다.
버킷에는 떨어져 있는 key도 들어갈 수 있습니다. 블록 스캔의 묶음은 우연히 옆에 놓인 key들이지만, LSA는 비슷한 key끼리 묶습니다. 앞의 query에서 LSA가 8개 중 5개를 찾아 8개 블록의 2개보다 많았던 것도 묶는 방식이 다른 구조에서 나온 결과입니다. 다만 떨어진 key를 묶은 덕분인지는 시험하지 않았고, 처음 연 두 버킷은 그냥 이웃한 토큰입니다.
묶는 공간을 모델이 실제로 보는 것에 맞춥니다. 내용으로 묶는 방식은 전에도 있었습니다. ClusterKV와 RetroInfer가 그렇고, 논문은 이들을 학습 없이 추론 때만 동작하는 방식으로 분류하면서 1M을 넘겨 평가한 방식은 없다고 적었습니다. D-LSA는 작은 key를 모델의 실제 어텐션에 맞춰 학습합니다.
Qwen에서는 정확도가 눈에 띄게 떨어지지 않았습니다. 빨라진 대신 답이 나빠졌다면 쓸 이유가 없으니 이 결과가 중요합니다. Qwen3.8-27B에 LSA Flat을 쓰면 긴 컨텍스트 시험인 RULER와 논문의 자체 데이터셋 PaperTrail에서 1M까지 full attention과 5점 안쪽 차이입니다. 10M에서는 RULER 63.9 대 59.9, PaperTrail 29.1 대 19.8로 오히려 높은데, 이 결과는 표본이 적어 한계점에서 다시 다룹니다.
72배가 모델 전체에서 9배로 줄어드는 이유
같은 1,000만 토큰인데 레이어 하나의 72배가 모델 전체에서는 9배로 줄어듭니다. 이유는 두 가지로 볼 수 있습니다.
첫째는 논문이 밝힌 이유입니다. LSA가 빠르게 만드는 것은 전역 어텐션 레이어뿐이고, 나머지 레이어에 드는 시간은 그대로입니다.
둘째는 저희 추측입니다. 72배는 1,000만 토큰 직전의 마지막 구간(query 32,768개)에서만 잰 값인데, 실제 prefill은 이득이 작은 짧은 구간부터 모두 지나옵니다. 컨텍스트가 짧을수록 이득이 작다는 점은 논문의 GLM-5.3-Flash 수치에서도 보입니다. GLM 자체 sparse attention과 비교한 레이어 하나의 이득이 512K에서 2.1배, 10M에서 22.7배입니다. 두 이유가 각각 얼마나 기여하는지는 재지 않았습니다.
아래 그래프가 모델 전체의 결과입니다. 요청을 한 번에 하나씩 처리해 잰 값이고, 그래프의 block sparse Flat이 이 글의 블록 스캔입니다.
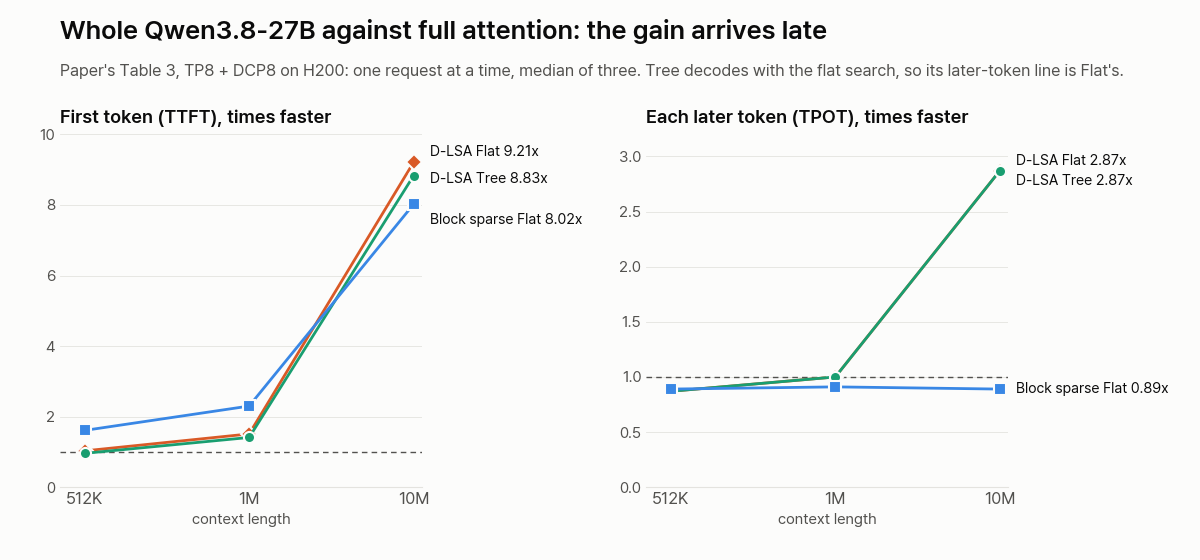
이 9배는 full attention과 비교한 숫자이기도 합니다. 이미 sparse attention을 쓰는 GLM-5.3-Flash에서는 이득이 훨씬 작습니다. GPU 8장에 KV 캐시를 토큰 단위로 나누는 구성에서 1,000만 토큰의 첫 토큰이 2.24배, 이후 토큰이 2.10배 빨라지고, 1M까지는 두 값 모두 1.09배를 넘지 않습니다.
한계점
1M 이하에서는 이득이 작습니다. full attention과 비교하면 첫 토큰이 512K에서 1.03배, 1M에서 1.51배 빠를 뿐입니다. 같은 구간에서 블록 스캔은 1.61배와 2.30배로 LSA보다 빠릅니다. LSA는 1,000만 토큰에 가서야 9.21배 대 8.02배로 앞섭니다. 다만 앞에서 적었듯 LSA가 더 많은 key를 읽는 설정이라, 구조 차이만의 결과로 볼 수는 없습니다. 이후 토큰은 512K에서 LSA와 블록 스캔 모두 full attention보다 약간 느립니다(0.87-0.89배).
시간을 줄일 뿐 메모리는 줄이지 않습니다. LSA가 줄이는 것은 key를 찾는 비용이지 저장하는 비용이 아닙니다. 논문도 KV 캐시가 여전히 컨텍스트에 비례해 늘어난다고 적었습니다. 그래서 1,000만 토큰을 돌리려면 GLM 기준으로 레이어마다 KV 10GiB가 그대로 필요합니다.
컨텍스트가 길어질수록 Flat의 비용도 계속 늘어납니다. 점수 횟수가 T/8로 줄었어도 여전히 T에 비례하기 때문입니다. 이 문제를 푸는 것이 점수 횟수가 log T에 비례하는 Tree인데, 아직 대가가 있습니다. 모델 전체의 10M 첫 토큰은 8.83배로 Flat의 9.21배보다 낮고, 논문은 prefill에서 10M을 넘어야 Tree가 앞설 것으로 예측합니다. GLM의 RULER 10M 점수도 Flat 66.8, Tree 55.8입니다.
버킷은 512개짜리 블록 안에서만 만들어집니다. 군집화가 블록 단위로 돌아가기 때문입니다. 앞의 query가 보려던 key는 1,827번부터 21,460번까지 퍼져 있었으므로 같은 ingle이어도 한 버킷에 들어갈 수 없고, query가 따로따로 열어야 합니다. 책 전체에 흩어진 같은 이름을 한 번에 찾는 구조는 아닙니다.
가장 좋은 정확도 결과의 표본이 가장 적습니다. 앞에서 본 10M의 높은 점수가 그렇습니다. 과제당 프롬프트가 1M까지는 100개인데 그 뒤로는 20개이고, RULER 격차 4.0점 가운데 약 2.7점은 13개 과제 중 둘에서 나옵니다(MultiQuery 92 대 72, HotpotQA 35 대 20). Qwen은 YaRN으로 위치 인코딩을 40배(PaperTrail은 42배) 늘려야 10M에 닿는다는 점도 있습니다. GLM에서는 LSA Flat이 1M까지 기준 sparse attention과 3점 안쪽이지만 2M에서 5M 사이에서는 최대 8점 뒤집니다. 논문은 기준 모델이 sparse attention과 함께 학습되었으므로 이 비교가 기준 쪽에 유리하다고 덧붙입니다.
모델을 새로 학습하는 쪽은 아직 규모가 작습니다. 논문의 N-LSA는 약 5억 파라미터, 128K 토큰까지, Flat 탐색만으로 학습했고, 더 큰 모델과 Tree는 남은 과제로 적었습니다. 128K에서 최대 메모리도 레이어당 약 1GiB 더 들었는데, 역전파를 위해 고른 위치를 저장하는 것이 원인의 일부입니다.
직접 테스트해보며 나온 것
논문 표는 속도와 정답률을 알려 주지만, 앞의 query처럼 버킷을 열었을 때 원래 보려던 어텐션을 얼마나 건지는지는 알려 주지 않습니다. 그래서 커버리지를 더 큰 규모로 쟀습니다.
시험 규모는 작고 논문과 조건도 다릅니다. A100에서 Qwen3-8B를 32,768토큰 문서 세 편(LSA 논문, 저장소 코드, 『오만과 편견』)에 돌렸고, 문서마다 뒤쪽 절반에서 query 1,024개를 뽑았습니다. 인덱스는 논문의 Algorithm 1을 보고 직접 구현했으며 저자 코드를 쓰지 않았습니다. 먼 key 예산은 256개에서 2,048개까지 네 단계여서, 문서 3개, 레이어 3개, 예산 4개로 모두 36칸입니다. 비교 대상은 8개 블록, 점수 횟수가 LSA의 두 배인 4개 블록(실제 블록 스캔의 크기), 여덟 배인 토큰 스캔, 그리고 어텐션이 가장 많은 key를 그냥 집는 이론 최대입니다.
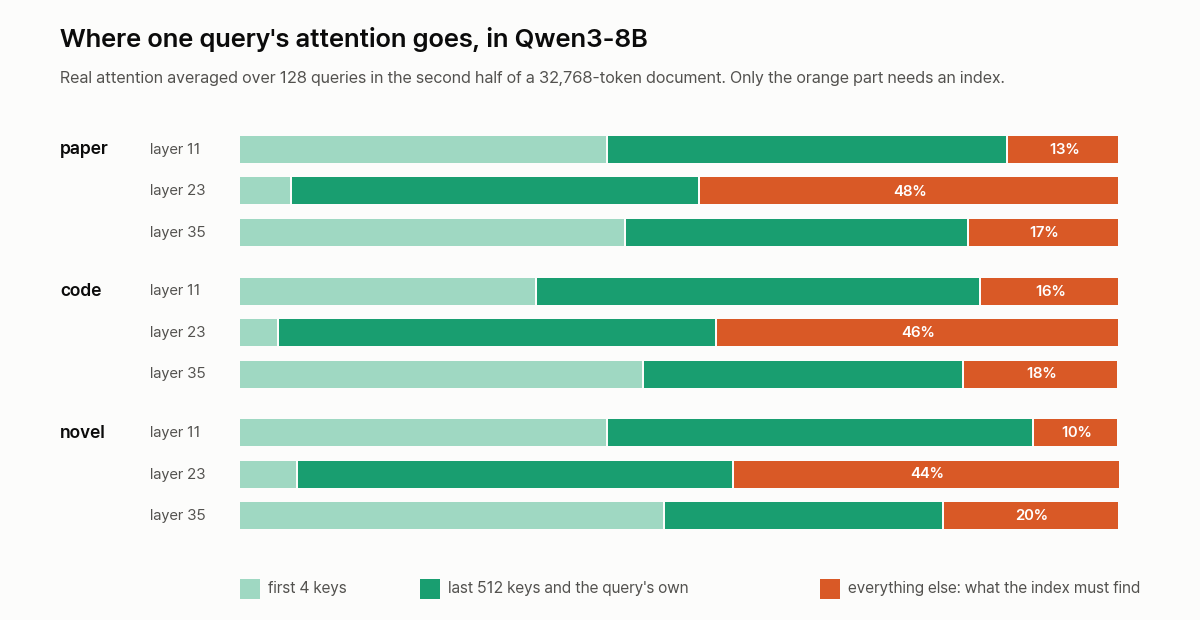
레이어마다 고를 것의 양이 크게 다릅니다. query 128개로 재 보면 레이어 11과 35에서는 어텐션의 10-20%만 먼 key로 갑니다. 나머지는 점수 없이 읽는 맨 앞 4개와 최근 512개가 가져갑니다. 레이어 23만 44-48%입니다. 그래서 아래 결과는 레이어 23과 나머지로 나눠 읽어야 합니다.
점수 횟수가 같으면 LSA가 8개 블록보다 많이 찾았지만, 큰 차이는 레이어 23에서만 났습니다. 학습 없이 PCA로 작은 key를 만든 결과입니다(PCA는 나머지 두 문서로 구했습니다).
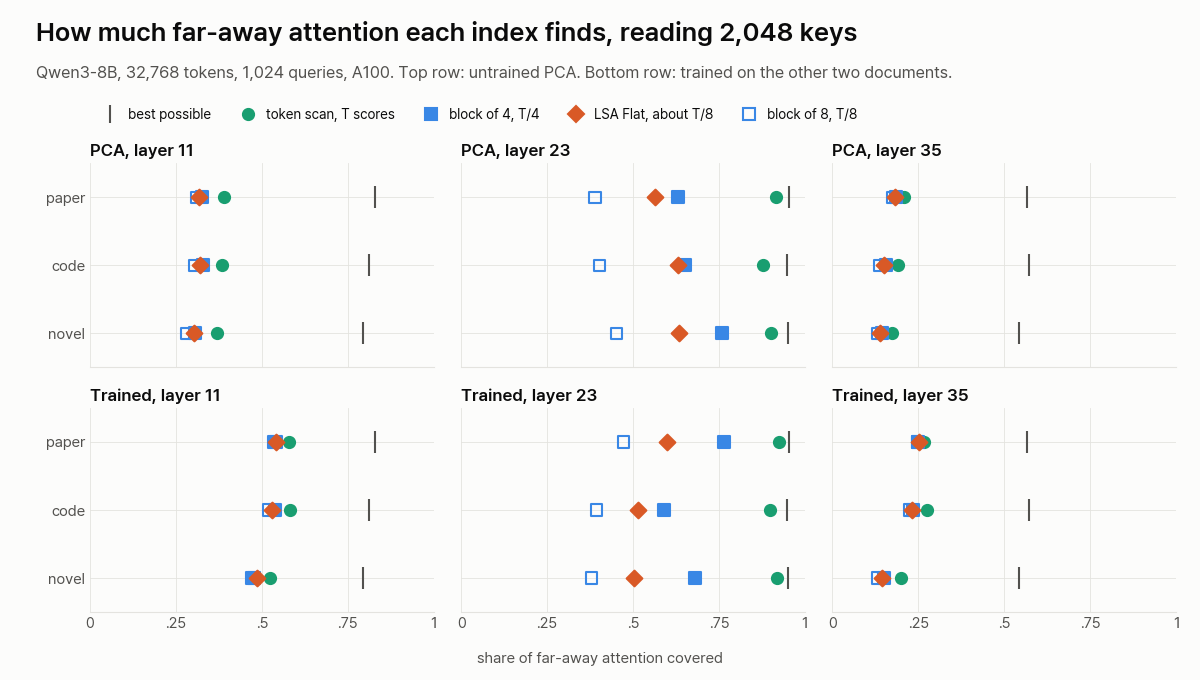
- LSA는 8개 블록을 36칸 모두 이겼습니다(query별로 짝지어 다시 뽑은 부트스트랩의 95% 구간이 0보다 위). 차이는 레이어 23에서 0.11-0.23인데, 레이어 11과 35에서는 많아야 0.021입니다.
- 점수를 더 많이 매기는 4개 블록과 토큰 스캔은 각각 36칸 모두 LSA보다 높았습니다. 이 둘은 구간 없는 점 추정치이고, 가장 작은 차이는 0.0012입니다.
- 레이어 11과 35에서는 어떤 방법이든 이론 최대에 한참 못 미칩니다. 소설의 레이어 11에서 2,048개를 읽으면 토큰 스캔 0.370, 4개 블록 0.305, LSA 0.302, 8개 블록 0.280이고 이론 최대는 0.793입니다.
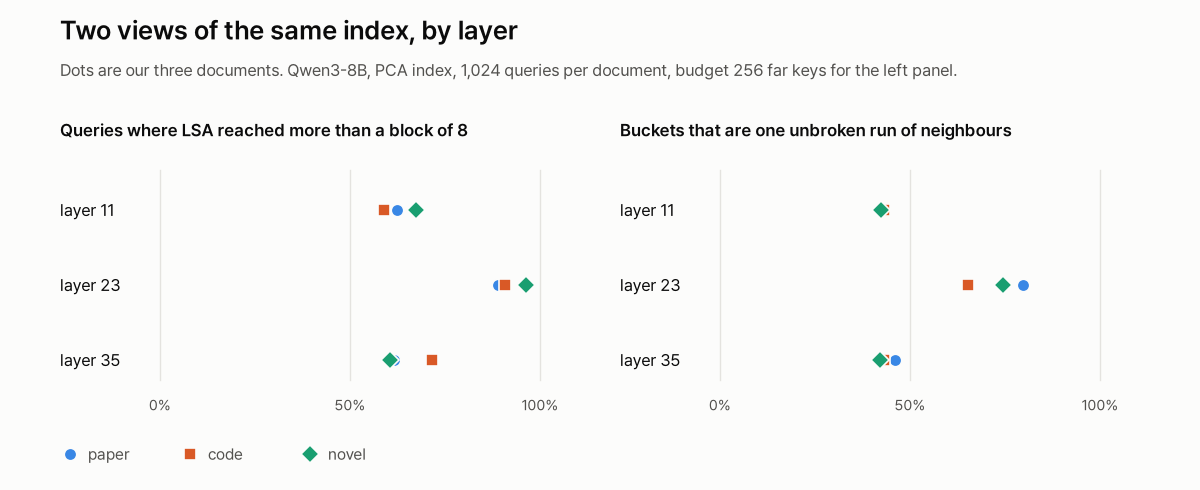
query별로 나눠 봐도 같은 그림입니다. 이 결과를 본 뒤 가장 작은 예산 256에서 query를 하나씩 다시 봤습니다. 레이어 23에서는 LSA가 8개 블록보다 많이 건진 query가 89-96%이고, 레이어 11과 35에서는 59-72%이며 앞선 정도의 중앙값도 0.001-0.007뿐입니다. 나머지 query는 8개 블록이 이겼습니다.
차이가 이렇게 작은 query는 어떤 모습인지 하나를 보겠습니다. 소설의 레이어 11에서 중간쯤 되는 query인 "...delight in overthrowing those kind of schemes, and"의 and입니다. 가장 많이 보려던 key 8개를 다 합쳐도 먼 어텐션의 4.6%이고, 어느 key도 1%를 넘지 않습니다. 커버리지는 LSA 0.024, 8개 블록 0.017, 토큰 스캔 0.060입니다. 맨 앞의 query처럼 몰린 key가 없으니 어떤 방법이든 찾을 것이 뚜렷하지 않습니다. query 하나의 사례이고, 이 패턴을 전체 query로 재지는 않았습니다.
사람 눈에 비슷한 것과 모델이 보려는 것은 다릅니다. 레이어 23으로 돌아가, 소설에서 LSA가 앞선 정도가 하위 10%인 query를 보겠습니다. 교양 있는 숙녀를 두고 대화하는 대목의 "They all paint tables, cover screens,"에서 마지막 쉼표입니다. LSA가 처음 연 버킷은 otch and Irish airs, and singing too long in public, sentiments, of playing이었습니다. 저희 눈에는 주제가 맞아 보입니다. 하지만 실제 어텐션은 이번에도 Bingley와 Austen을 찾았고, 먼 어텐션의 72.2%가 key 8개에 몰렸습니다. LSA는 그중 1개를 찾아 0.137을 건졌고, 토큰 스캔은 8개를 모두 찾아 0.843을 건졌습니다.
떨어진 key를 묶는 버킷은 흔하지 않았습니다. 맨 위의 Jane Aust 같은 버킷이 얼마나 있는지 세어 봤습니다. 32,768토큰 문서 전체에서 끊기지 않고 이웃한 토큰으로만 된 버킷이 레이어 23에서 65-80%, 레이어 11과 35에서 약 43%입니다. 떨어져서 묶인 버킷도 첫 key부터 끝 key까지 거리의 중앙값이 레이어 23에서 24-32토큰, 레이어 11과 35에서 60-132토큰이니, Jane Aust의 196토큰은 중앙값보다 훨씬 먼 쪽입니다.
작은 key를 학습시켜도 결과가 갈렸습니다. 사람 눈과 모델의 차이는 논문의 학습이 풀려는 문제이므로, 이 결과를 본 뒤 작은 학습 실행을 추가했습니다. 논문의 식 2를 따라 나머지 두 문서로 학습했지만, 규모는 65,536토큰에 1,500 스텝으로 3억 5,200만 토큰에 48,000 스텝인 논문보다 훨씬 작습니다. temperature도 논문처럼 레이어별로 보정하지 않고 -3.0에서 시작했습니다. 그래서 이 결과가 논문의 학습을 평가하는 것은 아닙니다. 토큰 스캔과 블록 스캔에도 같은 투영을 적용해 같은 공간에서 비교했습니다.
- 레이어 11과 35는 평균으로 나아졌습니다. LSA가 레이어 11에서 0.055-0.223, 레이어 35에서 0.001-0.083 올랐습니다. 이 상승폭에는 짝지은 구간을 구하지 않았습니다. 8개 블록도 함께 올라서, 소설의 레이어 11에서 2,048개를 읽으면 0.280에서 0.471이 되고 LSA와의 차이는 0.021에서 0.016으로 줄었습니다.
- LSA는 이 24칸 중 6칸에서 점 추정치로 4개 블록을 넘었고, 토큰 스캔은 여전히 넘지 못했습니다.
- 레이어 23은 세 문서 중 두 문서에서 나빠졌고, 소설에서는 최대 0.178 떨어졌습니다.
레이어 23은 어텐션이 몇 개 key에 몰려 있습니다. 이 레이어의 결과가 유독 다른 것과 관련 있을 수 있는 관찰입니다. key 8개가 query 128개 평균으로 먼 어텐션의 54-69%를 차지하는데, 다른 두 레이어에서는 1%도 되지 않습니다. 소설에서는 이 8개가 모두 Aust 아니면 ingle로, 앞의 두 query가 찾던 바로 그 key입니다. 토큰 1,827번부터 21,460번까지 흩어져 있으니 문서 맨 앞에서 나타나는 현상도 아닙니다. 이것이 버킷이 뒤처지거나 학습이 역효과를 낸 이유인지는 시험하지 않았습니다.
이 시험으로 말할 수 있는 범위입니다. 72배를 확인할 수도 반박할 수도 없습니다. 작은 모델 하나, 1,000만이 아닌 32K 토큰, 훨씬 작은 학습량이고, 답의 정확도가 아니라 어텐션 커버리지만 쟀으며, 시간은 재지 않았습니다. Qwen3는 위치 인코딩이 key 차원 전체를 회전시키는데, 논문에 따르면 Qwen3.8은 4분의 1만 회전시킵니다. 저희 인덱스는 회전 전 key를 읽고 맞히려는 대상은 회전이 들어간 어텐션인데, 이 영향도 시험하지 않았습니다. 볼 수 있는 것은 이 규모에서 묶음이 무엇을 맞바꾸는지입니다. 점수 횟수가 같으면 붙어 있는 블록보다 더 많이 찾고, 더 많이 훑는 방식보다는 덜 찾습니다.
직접 돌려 보려면
저장소(Apache-2.0)의 안내입니다. 저희는 커밋 97b82d6을 읽기만 했고 실행하지 않았습니다. 서빙은 SGLang 포크 이미지 ghcr.io/prefrontal-ai/sglang:lsa-v0.1.0에 --attention-backend fa3 --page-size 1 --disable-prefill-cuda-graph를 줍니다. 이미지에 LSA가 들어 있지는 않아서 README대로 저장소를 그 안에 설치해야 합니다. 서버 로그에는 armed가 찍혀야 하고, 이 줄이 없으면 체크포인트 원래의 어텐션으로 돌아가는 것입니다. 투영 가중치는 릴리스 d-lsa-weights-v1의 .pt 파일이고 기본 모델은 따로 받습니다.
빠른 커널은 H200과 B300용 CuTe DSL로 작성되어 있고, Triton 버전은 특정 GPU에 묶여 있지 않습니다. 논문 표 11에 따르면 H200에서 CuTe는 17.41ms, Triton은 39.48ms입니다. 10M에서 Flat prefill query 32,768개 구간 하나를 합성 입력으로 돌려 커널 시간만 잰 값입니다. README의 H200 1장 재현 절차는 Qwen Flat으로 RULER 4K와 32K를 돌리는 것으로, 기대값은 0.974와 0.968(논문 0.975와 0.966)이고 1시간 52분이 걸린다고 적혀 있습니다. 설치 점검용이며 10M 실행은 아닙니다.
확인하지 않은 것
모델을 서빙하지 않았고, 가중치를 받지 않았으며, 논문의 속도나 정확도 숫자를 재현하지 않았습니다. 위의 H200 숫자는 모두 논문이나 README의 값이고, B300 숫자는 적지 않았습니다. 4,582초는 특정 장비 구성에서 요청 하나를 잰 값이므로, 요청이 몰리는 서버에서는 다를 수 있습니다.
토큰 스캔과 블록 스캔을 포함한 기존 구조 일곱 가지는 어텐션 정리 글에서, 짧은 함수로 보고 싶다면 코드 글에서 이어서 읽을 수 있습니다.
LSA를 포함해 어텐션 설계 28가지를 같은 그림 방식으로 나란히 놓은 글은 어텐션 28가지를 GIF와 짧은 함수로 정리했습니다입니다.