문장 하나를 GPT-2, Qwen3, Mamba 하이브리드에 넣어 봤습니다: 이름은 어느 층에서 나올까
GPT-2, Qwen3-0.6B-Base, Granite-4.0-H-350M의 forward를 직접 짜서 문장 하나의 마지막 토큰을 층마다 따라갔습니다. 세 모델 모두 Alice라고 답합니다. 하이브리드 모델은 18토큰 문장에서 어텐션 4개 층을 꺼도 답이 그대로였지만, 1,410토큰에서는 어텐션을 끈 모델만 0.002로 떨어졌습니다(원래 모델 0.990).
문장 하나를 GPT-2, Qwen3, Mamba 하이브리드에 넣어 봤습니다: 이름은 어느 층에서 나올까
작은 언어 모델 세 개에 끝나지 않은 문장 하나를 똑같이 넣었습니다.
In the morning, Alice gave Bob a book. Later, Bob gave the book back to ________
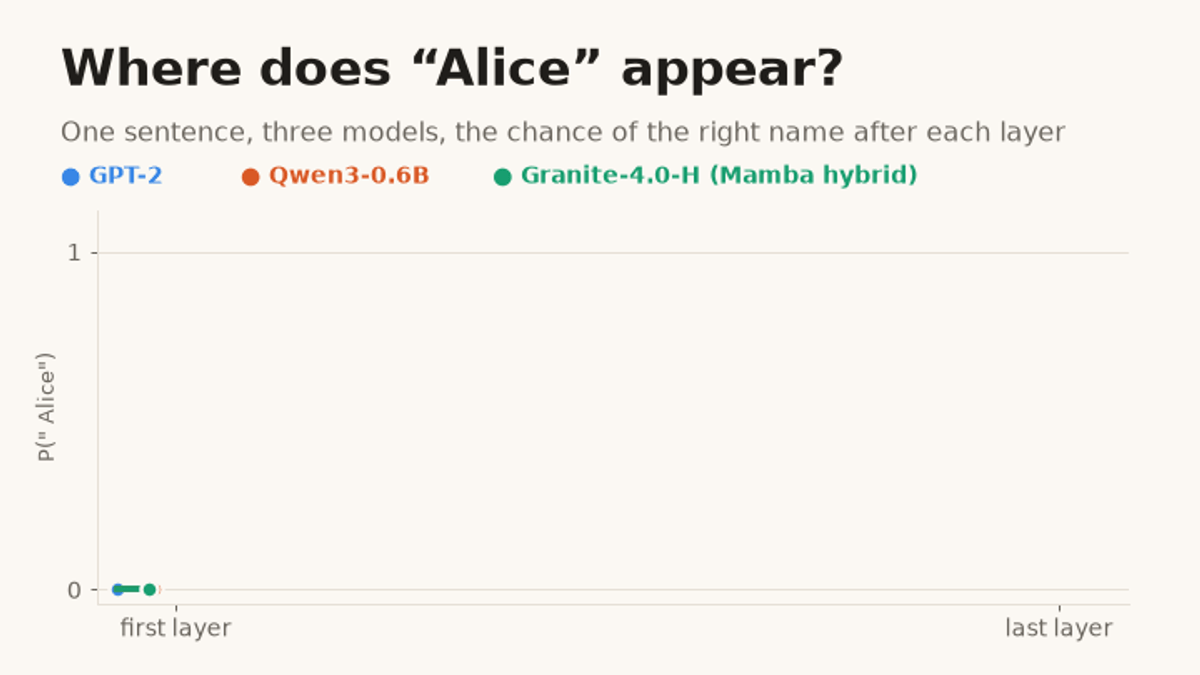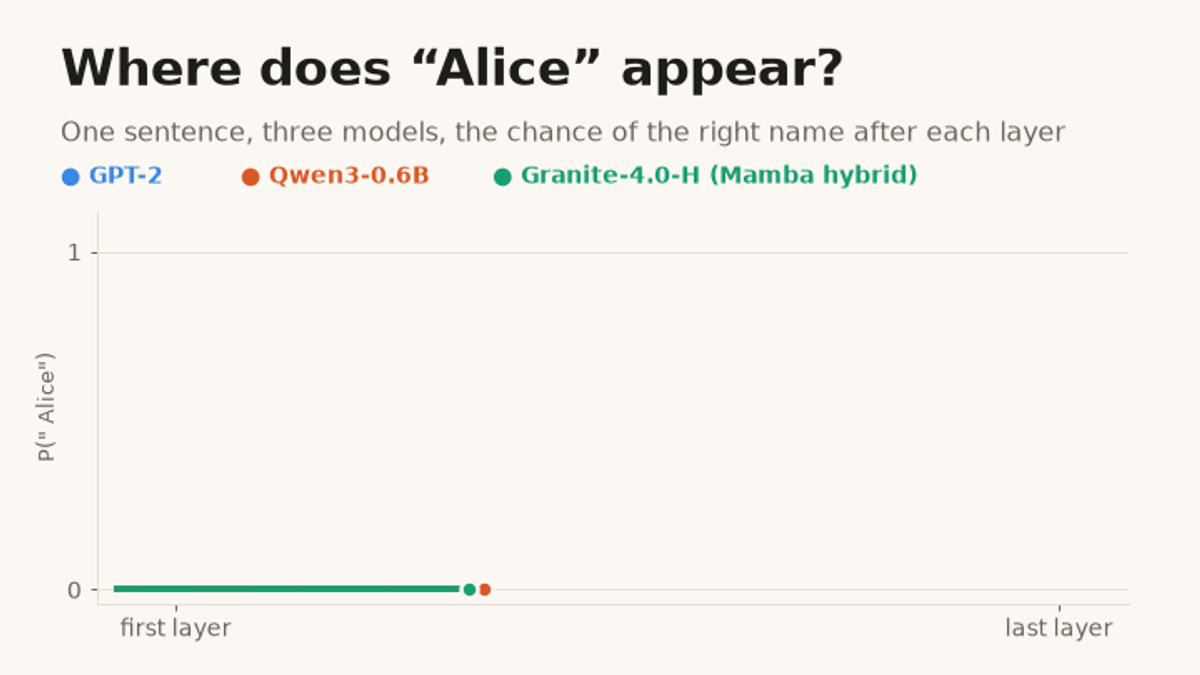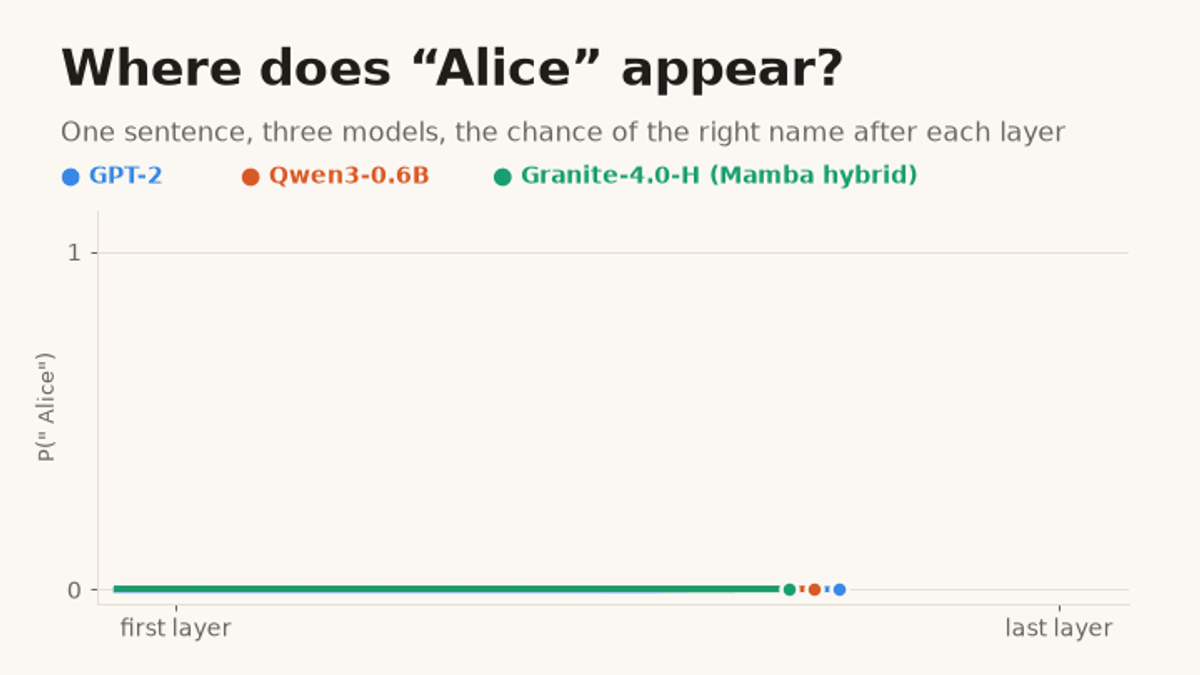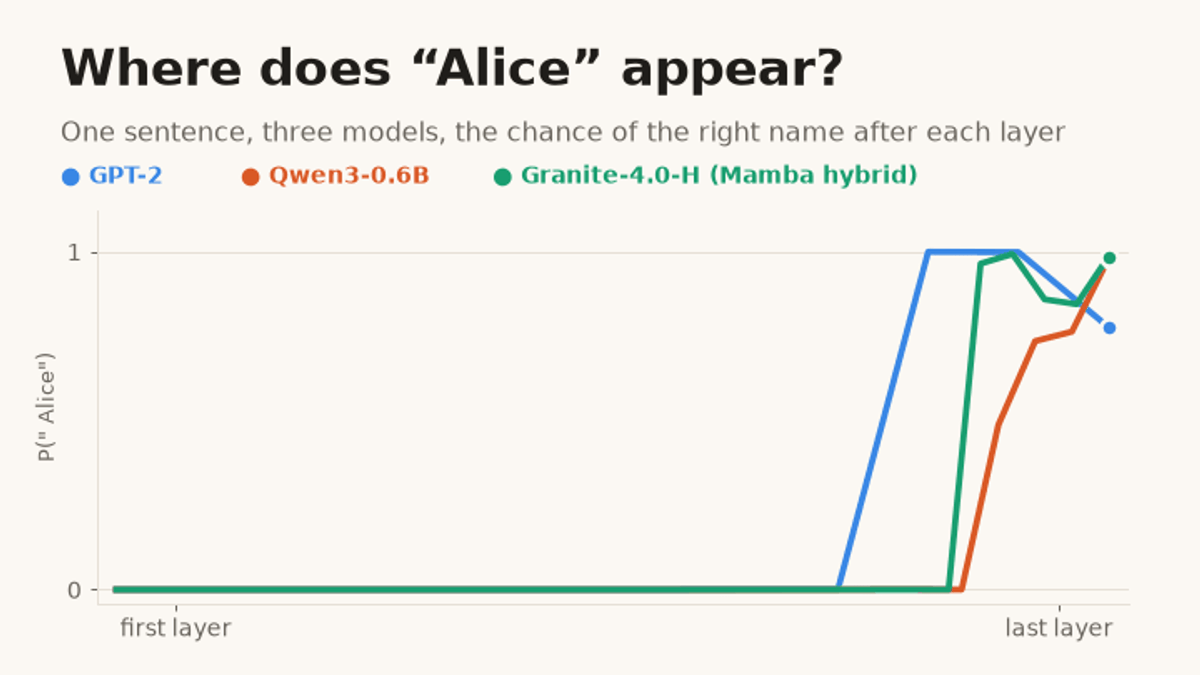
아침에 Alice가 Bob에게 책을 주었고, 나중에 Bob이 그 책을 누구에게 돌려주었는지 묻는 문장입니다. 빈칸은 "back to" 바로 뒤에 있습니다. 세 모델 모두 다음 토큰으로 " Alice"를 골랐습니다. 확률은 GPT-2가 0.776, Qwen3-0.6B-Base가 0.980, Granite-4.0-H-350M이 0.986입니다.
Granite는 하이브리드 모델입니다. 32개 층 가운데 28개가 Mamba2 층이고 어텐션 층은 4개뿐입니다. 층마다 멈춰서 "지금 답하면 무엇을 고르겠느냐"를 보면, " Alice"는 27번 어텐션 층을 지난 직후에 처음 1위가 됩니다. 이 글에서 층과 자리 번호는 0부터 셉니다. 그래서 이름을 가져오는 일이 어텐션 층에 달려 있는지 보려고, 어텐션 4개 층을 모두 꺼 봤습니다. 확률은 0.988로 그대로였습니다.
그런데 Alice와 질문 사이에 상관없는 글을 1,400토큰쯤 끼워 넣자 결과가 갈렸습니다. 원래 모델은 여전히 0.990인데, 어텐션을 끈 모델은 0.002로 떨어졌습니다.
이 결과는 세 모델의 forward를 PyTorch로 모델마다 수십 줄씩 직접 짜서 얻었습니다. 그 코드로 마지막 토큰 " to"가 번호에서 출발해 마지막 확률이 되기까지를 따라갔습니다. 이 글은 그 길을 한 단계씩 걷고, 단계마다 코드를 보여 드립니다. 세 모델은 뼈대가 같고 몇 칸만 다르기 때문에, 어느 칸이 다른지 나란히 짚어 보기 좋습니다.
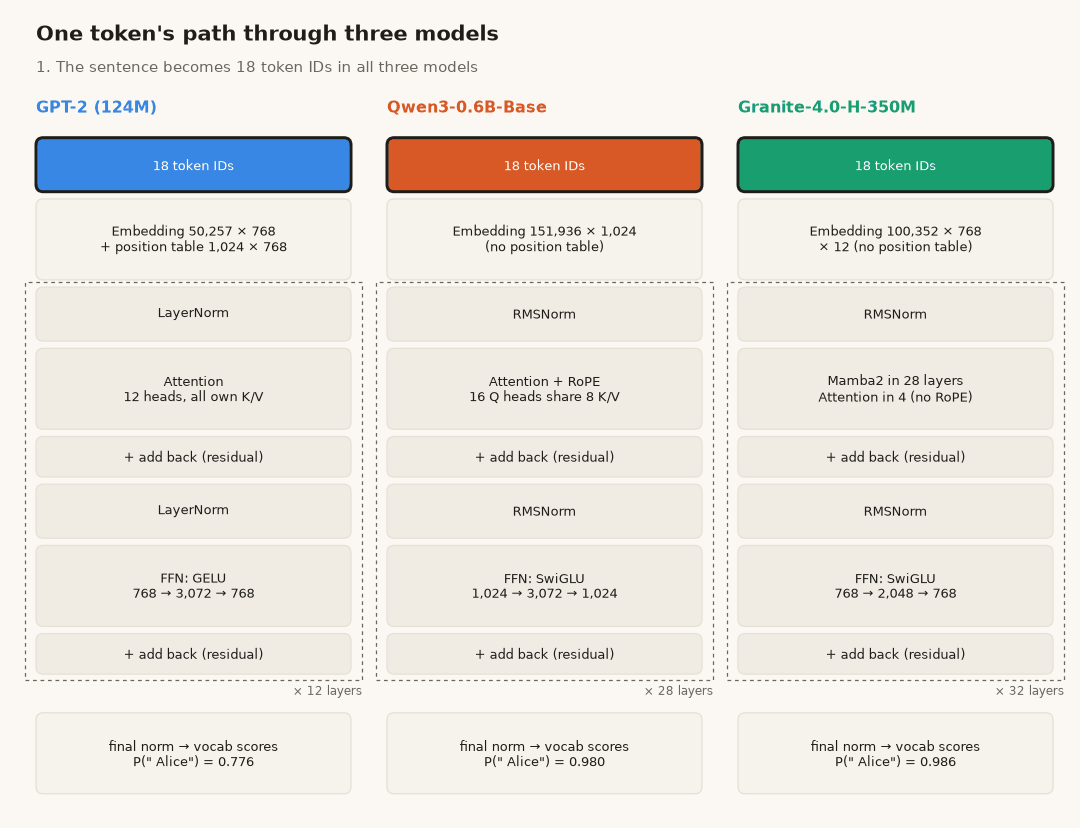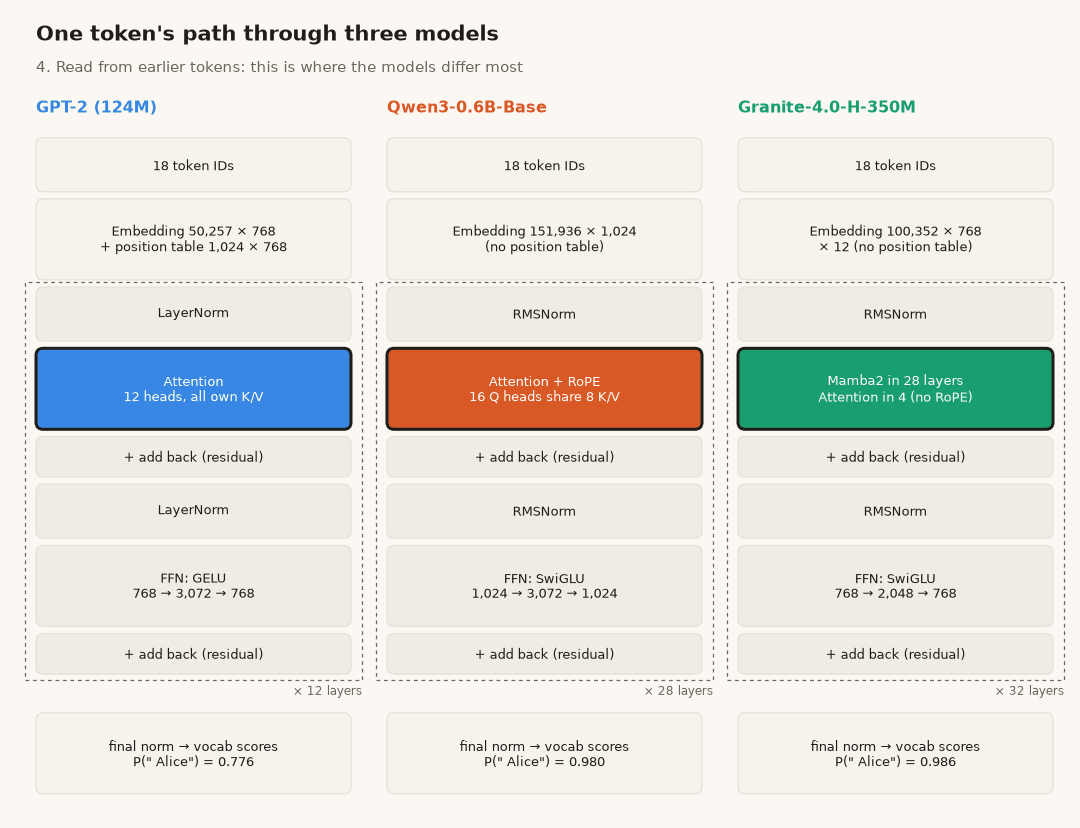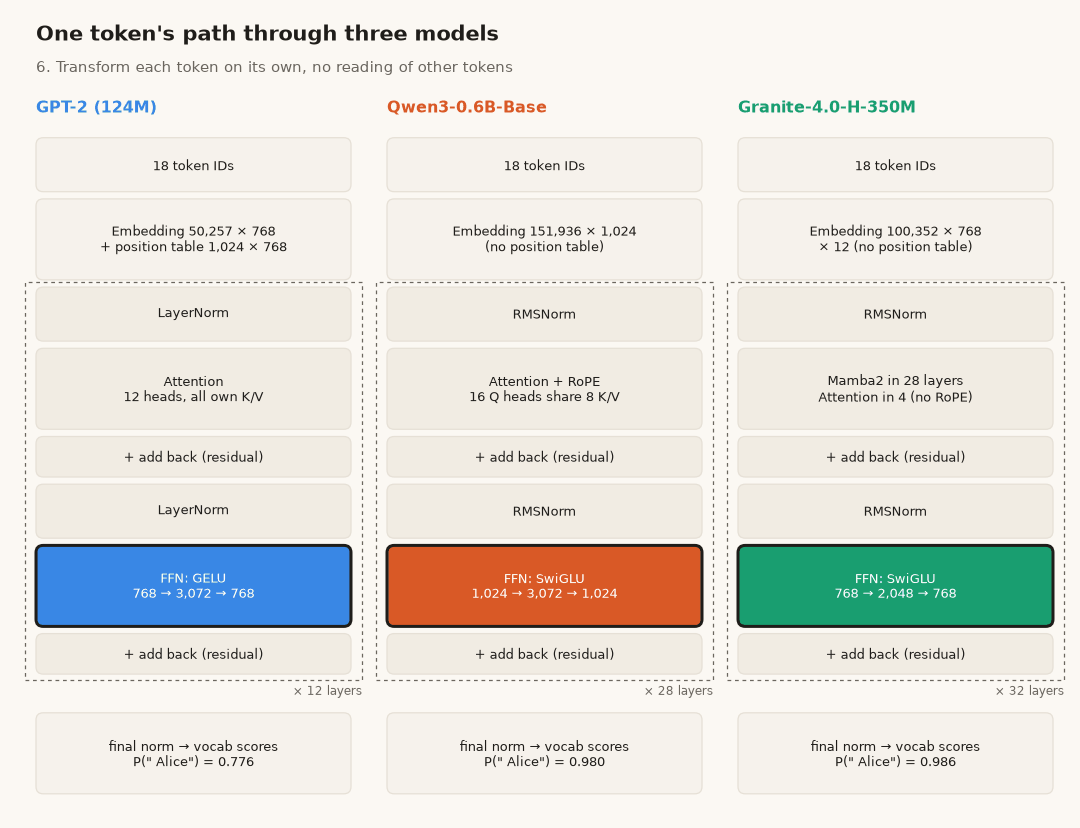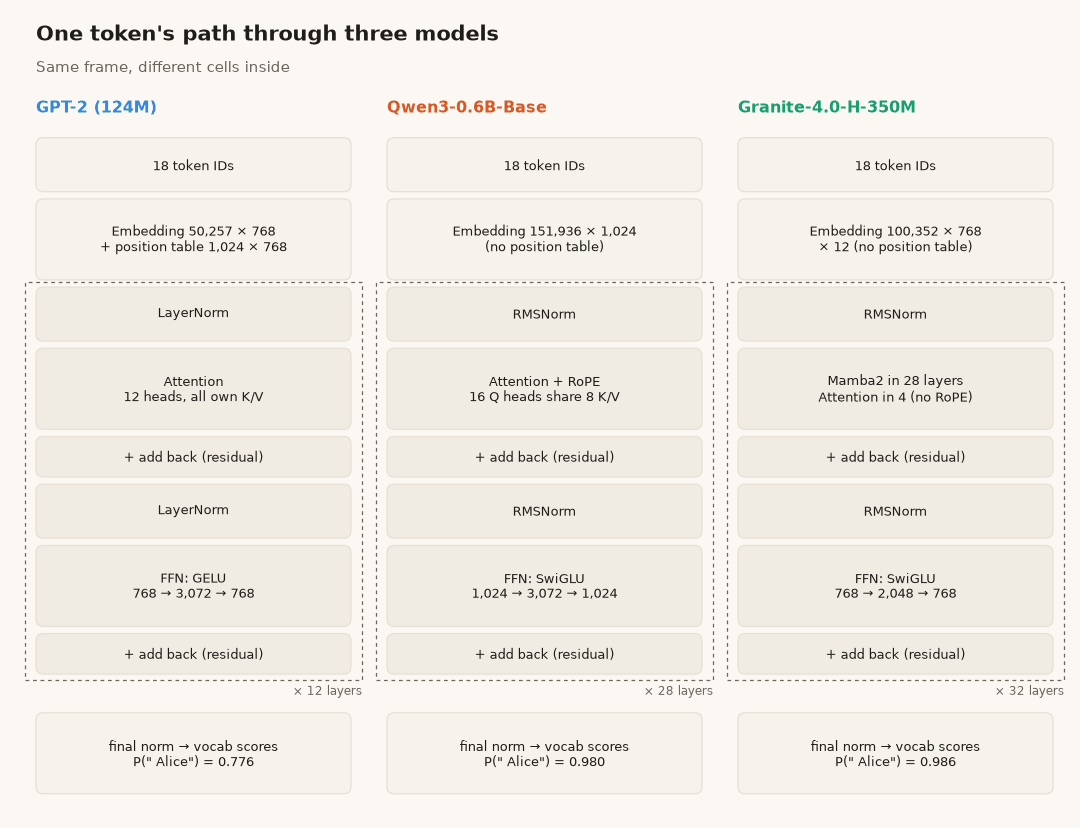
세 모델
| GPT-2 | Qwen3-0.6B-Base | Granite-4.0-H-350M | |
|---|---|---|---|
| 파라미터 | 124M | 596M | 340M |
| 층 | 12 | 28 | 32 (Mamba2 28, 어텐션 4) |
| 벡터 크기 | 768 | 1,024 | 768 |
| 어휘 표의 행 | 50,257 | 151,936 | 100,352 |
| 공개 | 2019 | 2025 | 2025 |
GPT-2는 초기 Transformer 설계에 가깝고, Qwen3는 요즘의 dense 모델이며, IBM의 Granite-4.0-H는 Mamba2와 어텐션을 섞은 모델입니다. 셋 다 채팅용 튜닝을 하지 않은 base 모델이고, 모두 CPU에서 float32로 돌렸습니다.
직접 짠 코드를 믿기 전에, 같은 문장에서 Hugging Face transformers 라이브러리의 출력과 비교했습니다. 확률로 바꾸기 전 점수(logit)의 최대 차이는 GPT-2 7.6e-5, Qwen3 2.9e-5, Granite 4.2e-5였습니다. 아래 숫자는 모두 라이브러리와 같은 계산을 하는 코드에서 나왔습니다.
모델이 Alice라는 이름을 원래 자주 내놓는 것은 아닌지도 확인했습니다. 문장은 그대로 두고 이름만 바꿨습니다.
In the morning, Carol gave Bob a book. Later, Bob gave the book back to
이름은 다섯 개를 넣어 봤습니다. Mirabel은 일부러 넣은 드문 이름입니다. 세 토크나이저 모두 이 이름을 " Mir"와 "abel" 두 조각으로 자르기 때문에, 이 행은 첫 조각 " Mir"의 확률을 적었습니다. 표의 숫자는 문장에 넣은 바로 그 이름이 다음 토큰으로 나올 확률입니다.
| 문장에 넣은 이름 | GPT-2 | Qwen3 | Granite |
|---|---|---|---|
| Alice | 0.776 | 0.980 | 0.986 |
| Carol | 0.885 | 0.955 | 0.974 |
| Emma | 0.792 | 0.825 | 0.969 |
| Sarah | 0.661 | 0.875 | 0.979 |
| Mirabel (" Mir") | 0.769 | 0.800 | 0.795 |
15번 모두 문장에 넣은 이름이 1위였습니다. 모델은 좋아하는 이름을 고르는 것이 아니라, 앞 문장에 나온 이름을 옮겨 오고 있습니다.
1단계: 글이 토큰 번호가 됩니다
모델마다 토크나이저가 따로 있습니다. 글을 조각으로 자르고 조각마다 번호를 붙이는 고정된 목록입니다. 저희 문장은 마침 세 모델 모두 18조각이 됐지만, 늘 이렇게 맞지는 않습니다. "안녕하세요"는 GPT-2에서 14토큰, Qwen3에서 3토큰, Granite에서 5토큰입니다. GPT-2 목록에는 한글 조각이 거의 없어서 바이트 단위로 쪼개기 때문입니다.
마지막 조각은 " to"이고, 번호는 GPT-2에서 284, 나머지 두 모델에서 311입니다. 다음 토큰은 마지막 자리에서 읽어 내므로, 여기서부터는 이 토큰 하나를 따라갑니다.
2단계: 번호로 표의 한 행을 꺼냅니다
임베딩은 어휘 하나에 행 하나씩 있는 표입니다. 토큰을 찾는다는 것은 그 번호에 해당하는 행을 꺼낸다는 뜻입니다.
x = sd["transformer.wte.weight"][ids]           # GPT-2: (18, 768)
x = sd["model.embed_tokens.weight"][ids]        # Qwen3: (18, 1024)
x = sd["model.embed_tokens.weight"][ids] * 12   # Granite: (18, 768), 12를 곱함
Qwen3에서 " to"의 행은 -0.0247, 0.0134, -0.0347, -0.0304로 시작해 숫자 1,024개로 이어집니다. 이 숫자 어디에도 "18번째 토큰"이라는 정보는 없습니다. 세 모델은 단어 순서를 각자 다른 방법으로 다룹니다.
GPT-2는 위치용 행을 하나 더 더합니다. 위치마다 행이 하나씩 있는 1,024행짜리 표가 따로 있어서, 17번 행을 토큰 행에 더합니다.
x = sd["transformer.wte.weight"][ids] + sd["transformer.wpe.weight"][:T]위치 행이 작지 않습니다. 17번 자리의 " to"에서 위치 행의 길이는 3.59로, 토큰 행의 2.52보다 깁니다. 이 표는 넘을 수 없는 한계도 정합니다. 1,024번 행이 없으므로, 뒤에서 쓰는 1,410토큰 문장은 GPT-2로 돌릴 수 없었습니다.
Qwen3는 벡터를 돌립니다. 위치 표가 없습니다. 대신 어텐션 안에서 쿼리와 키 벡터(4단계에서 설명합니다)를 위치에 비례하는 각도만큼 돌립니다. 이 방법을 RoPE라고 부릅니다.
def rope(x, pos, theta):
    d = x.shape[-1]
    inv = 1.0 / theta ** (torch.arange(0, d, 2) / d)
    ang = pos[:, None].float() * inv[None]
    cos, sin = torch.cat([ang, ang], -1).cos(), torch.cat([ang, ang], -1).sin()
    x1, x2 = x[..., : d // 2], x[..., d // 2:]
    return x * cos + torch.cat([-x2, x1], -1) * sin
이렇게 돌리면 두 토큰의 맞춤 점수가 각자 어느 자리에 있는지와는 상관없이, 둘 사이의 거리에 따라서만 달라집니다. 확인하는 방법은 간단합니다. 숫자 128개짜리 무작위 쿼리 하나와 키 하나를 만듭니다. 128은 Qwen3 헤드 하나의 크기입니다. 두 벡터를 각각 어떤 자리에 있는 것처럼 돌린 뒤 내적을 구합니다. 이 내적이 어텐션이 쓰는 맞춤 점수입니다.
q, k = torch.randn(1, 1, 128), torch.randn(1, 1, 128)
def score(m, n):   # 쿼리는 m번 자리, 키는 n번 자리
    return (rope(q, torch.tensor([m]), 1e6) * rope(k, torch.tensor([n]), 1e6)).sum().item()
돌리지 않으면 점수는 11.796입니다. 17번과 5번 자리에 두면 1.14666입니다. 112번과 100번 자리는 위치는 전혀 다르지만 거리는 똑같이 12칸이고, 점수도 다시 1.14666입니다. 한 칸 떨어진 17번과 16번 자리에서는 10.646입니다. 어떤 무작위 벡터로 해도 같은 성질이 나오고, 정확한 점수는 저희가 돌린 값입니다.
Granite는 둘 다 하지 않습니다. 설정 파일에 position_embedding_type: nope라고 적혀 있고, 어텐션 층은 위치 정보를 따로 더하지 않습니다. 순서 정보는 토큰을 차례로 읽는 Mamba2 층을 통해 들어옵니다. 4단계에서 자세히 봅니다.
3단계: 계산하기 전에 크기를 맞춥니다
각 층은 토큰 벡터로 계산하기 전에 크기를 다시 맞춥니다. GPT-2는 평균을 빼고 퍼진 정도로 나누는 LayerNorm을 씁니다. Qwen3와 Granite는 제곱평균의 제곱근으로만 나누는 RMSNorm을 씁니다.
def rms_norm(x, w, eps):
    return w * (x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + eps))
Qwen3 첫 층에 들어가는 " to"의 제곱평균 제곱근은 0.0242에서 0.999가 되고, 평균은 0.034로 0이 아닌 채 남습니다. GPT-2의 LayerNorm은 같은 일을 하면서(0.162에서 1.0) 평균을 정확히 0으로 만듭니다. 그다음 둘 다 학습된 가중치 w를 곱합니다. RMSNorm은 평균 계산을 건너뛰어 조금 가볍고, 요즘 모델은 대부분 이쪽을 씁니다.
4단계: 앞 토큰에서 읽어 옵니다
토큰이 다른 토큰을 보는 단계는 여기 하나뿐이고, 세 모델이 가장 많이 다른 곳도 여기입니다.
어텐션 (GPT-2, Qwen3, Granite의 4개 층). 토큰마다 자기 벡터에서 세 가지를 만듭니다. 찾는 것을 나타내는 쿼리, 자기가 내놓는 것을 나타내는 키, 실제로 건네줄 값입니다. 마지막 토큰은 자기 쿼리를 18개 토큰의 키와 하나씩 비교하고, 점수를 합이 1인 가중치로 바꾼 다음, 그 가중치로 값을 섞어 가져옵니다.
def attention(q, k, v, scale):
    rep = q.shape[0] // k.shape[0]                  # Qwen3: 16 // 8 = 2
    k, v = k.repeat_interleave(rep, 0), v.repeat_interleave(rep, 0)
    T = q.shape[1]
    scores = (q @ k.transpose(-1, -2)) * scale
    scores = scores.masked_fill(torch.triu(torch.ones(T, T, dtype=torch.bool), 1), float("-inf"))
    return scores.softmax(-1) @ v
masked_fill 줄은 뒤에 오는 토큰을 가립니다. 그래서 어떤 토큰도 미래를 읽지 못합니다. GPT-2는 헤드 12개가 각자 키와 값을 가집니다. Qwen3는 쿼리 헤드가 16개인데 키·값 헤드는 8개뿐이어서, 키·값 헤드 하나를 쿼리 헤드 둘이 나눠 씁니다(repeat_interleave). 이것을 grouped-query attention이라고 부르며, 여기서는 메모리에 들고 있어야 하는 키와 값이 절반으로 줄어듭니다. 이 단계 하나의 변형 28가지는 어텐션 정리 글에서 다뤘습니다.
Mamba2 (Granite의 28개 층). 앞 토큰 전부와 비교하는 과정이 없습니다. 대신 크기가 고정된 숫자 표, 즉 상태를 하나 들고 다니며 토큰마다 한 번씩 고칩니다.
for t in range(T):
    decay = torch.exp(dt[t] * A)                  # A < 0이므로 0 < decay < 1
    state = decay[:, None, None] * state + (dt[t][:, None] * xs[t])[:, :, None] * B[t][None, None, :]
    ys.append(state @ C[t] + D[:, None] * xs[t])
반복문의 핵심만 옮긴 코드입니다. 실제 층에는 이 앞에 짧은 합성곱이, 뒤에 문(gate)이 하나 더 있습니다.
한 번 돌 때마다 이전 상태를 decay만큼 줄이고 지금 토큰을 써 넣습니다. dt는 토큰 자신에게서 계산되므로, 토큰마다 세게 쓸지 약하게 쓸지, 앞 내용을 얼마나 남길지가 달라집니다. 출력은 C로 상태에서 읽어 냅니다. 반복문이 순서대로 돌기 때문에 5번 자리 토큰은 여섯 번, 17번 자리 토큰은 열여덟 번 고친 상태를 봅니다. Granite가 위치 표 없이 순서를 아는 것은 이 덕분입니다. 상태 크기는 18번째 토큰에서나 18,000번째 토큰에서나 같습니다. 길이가 늘어도 메모리가 늘지 않는다는 것이 Mamba를 쓰는 주된 이유입니다.
이 반복문을 풀어 쓰면 어텐션과 같은 모양의 표가 나옵니다. 각 토큰이 앞의 각 토큰에서 얼마나 가져오는지를 적은 표입니다. 아래는 Granite의 어텐션 층 하나와 바로 다음 Mamba2 층의 표입니다.
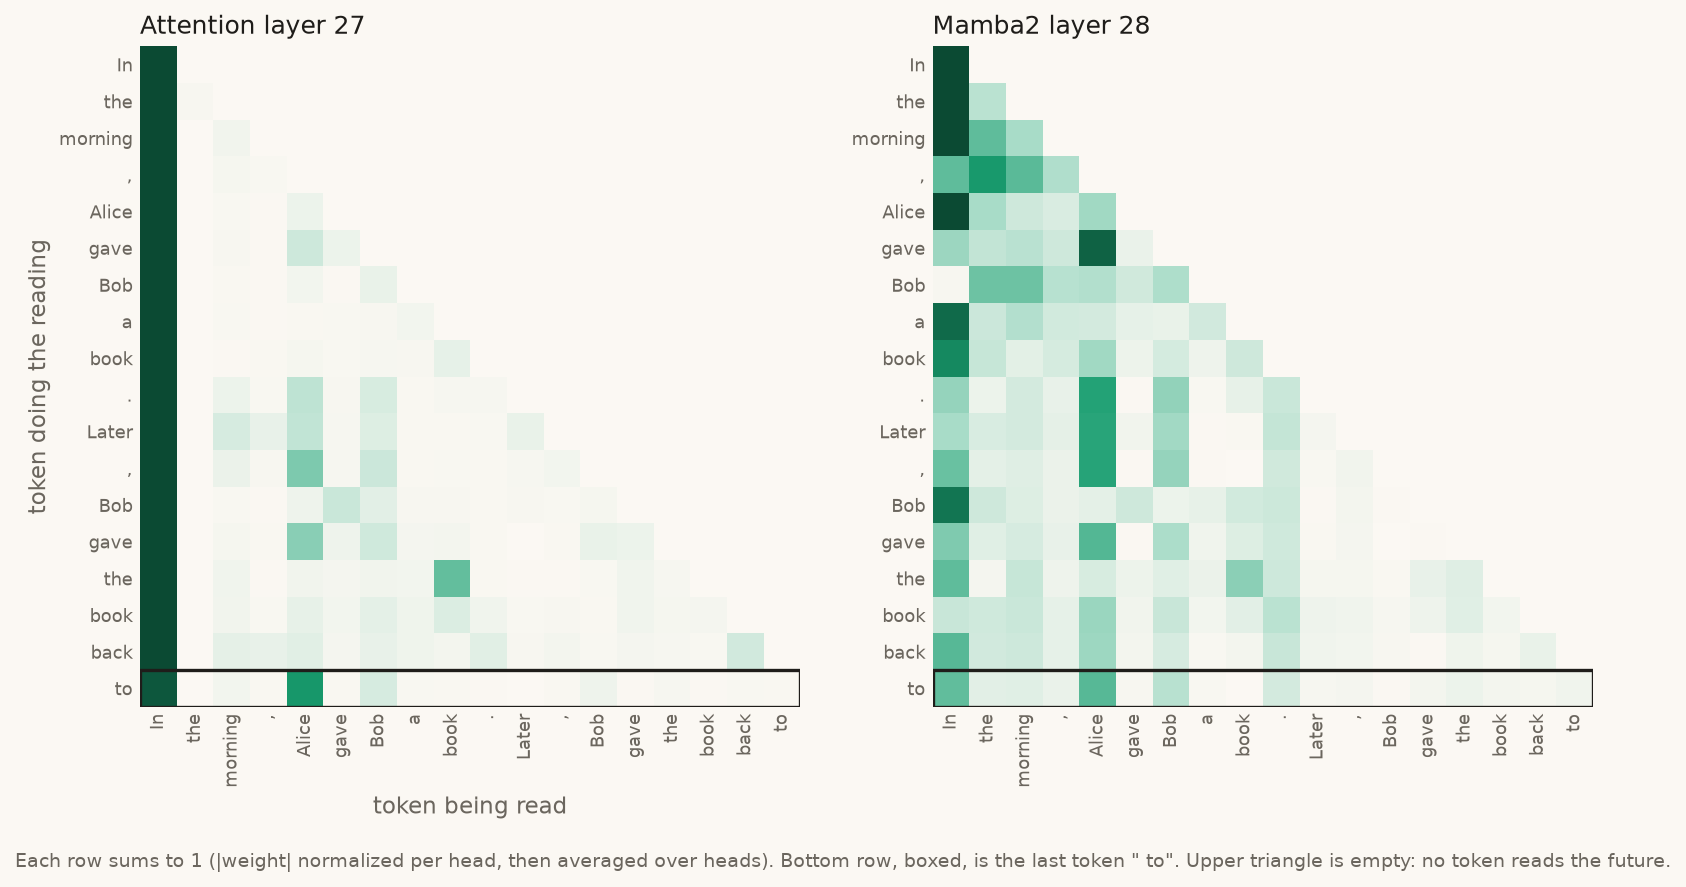
두 표 모두 대각선 위가 비어 있습니다. 어텐션 표에서는 대부분의 행이 첫 토큰에 크게 기대는데, 모델은 따로 볼 것이 없을 때 첫 토큰에 가중치를 몰아 두는 경향이 있다고 알려져 있습니다(attention sink). 그러니 그 칸이 진하다고 "In"이 중요하다는 뜻은 아닙니다. 또 가중치가 크다고 그 칸이 답의 원인인 것도 아닙니다. 층이 실제로 무슨 일을 하는지는 이 글 뒤쪽에서 층을 꺼 보며 확인합니다.
5단계: 다시 더합니다
섞는 단계가 만든 결과는 토큰 자기 벡터에 더해져서 다음으로 넘어갑니다. 6단계 뒤에도 똑같이 더합니다. 이것을 residual 연결이라고 부릅니다.
x = x + mix          # GPT-2, Qwen3
x = x + mix * 0.246  # Granite는 더할 때마다 residual 배율을 곱합니다
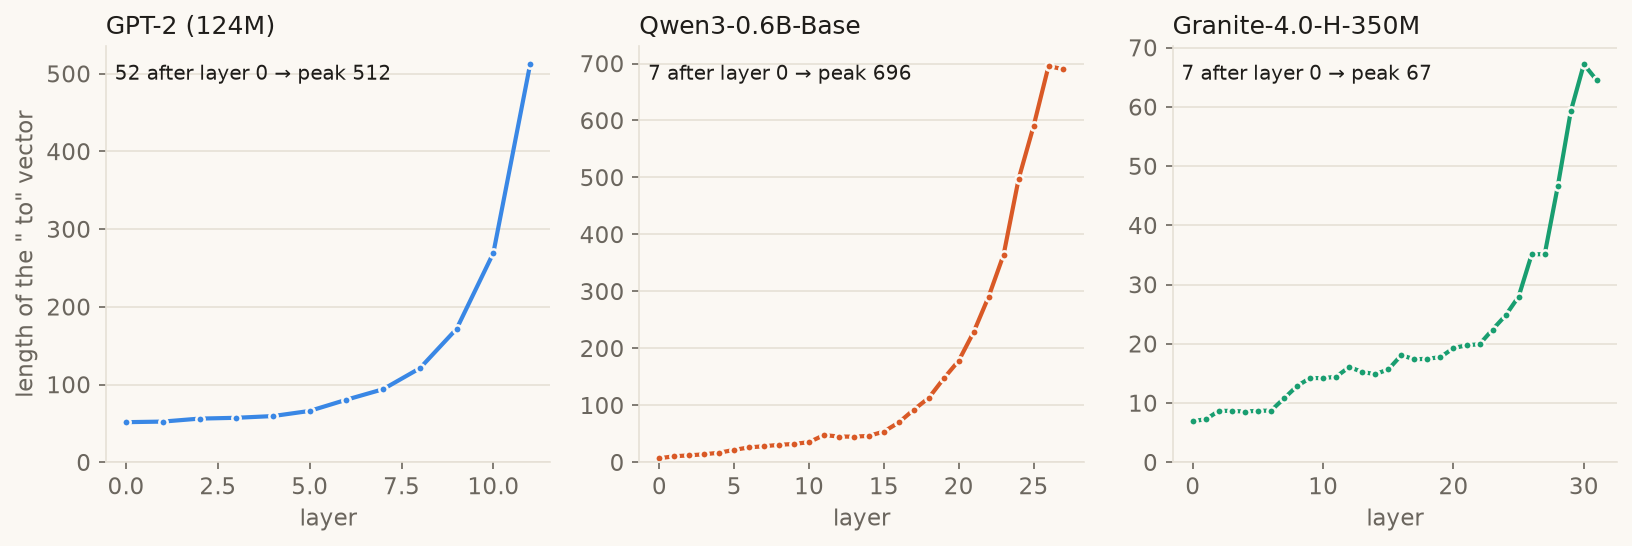
층마다 더한 값이 쌓이므로 벡터는 대체로 길어집니다. 0번 층을 지난 직후와 가장 길 때를 비교하면 " to" 벡터의 길이는 GPT-2에서 52에서 512로, Qwen3에서 7에서 696으로, Granite에서 7에서 67로 늘었습니다. 예측 직전에는 7단계의 마지막 정규화가 크기를 다시 맞춥니다.
6단계: 토큰 하나씩 따로 바꿉니다
FFN(feed-forward network)은 토큰을 하나씩 따로 다룹니다. 벡터를 넓혔다가 비선형 함수를 거쳐 다시 좁힙니다. GPT-2는 GELU를 씁니다.
h = F.gelu(h @ W_in + b_in, approximate="tanh")   # 768 -> 3,072
x = x + h @ W_out + b_out                          # 3,072 -> 768
Qwen3와 Granite는 SwiGLU를 씁니다. 넓힌 벡터를 두 개 만들어 곱하는데, 그중 하나는 SiLU를 거쳐 문 역할을 합니다.
h = F.silu(h @ W_gate.T) * (h @ W_up.T)            # Qwen3: 1,024 -> 3,072
x = x + h @ W_down.T                               # 3,072 -> 1,024
3단계부터 6단계까지가 층 하나입니다. GPT-2는 이것을 12번, Qwen3는 28번, Granite는 32번 반복합니다.
7단계: 벡터가 확률이 됩니다
마지막 층 뒤에 정규화를 한 번 더 합니다. 그다음 벡터를 2단계 임베딩 표의 모든 행과 비교합니다. 세 모델 모두 여기서 같은 표를 다시 쓰므로, " Alice"의 점수는 마지막 " to" 벡터가 " Alice" 행과 얼마나 맞는지입니다. Granite는 이 점수를 먼저 3으로 나눕니다. 마지막으로 softmax가 점수를 확률로 바꿉니다.
# Qwen3와 Granite 기준. GPT-2는 LayerNorm과 wte 표를 씁니다
x = rms_norm(x, sd["model.norm.weight"], eps)
logits = x @ sd["model.embed_tokens.weight"].T     # 어휘 행마다 점수 하나(Granite는 여기서 / 3)
1위와 2위는 GPT-2가 " Alice"와 " her"(0.776, 0.057), Qwen3가 " Alice"와 " the"(0.980, 0.006), Granite가 " Alice"와 " him"(0.986, 0.006)입니다.
이름이 떠오르는 층
7단계는 마지막 층뿐 아니라 어느 층 뒤에도 붙일 수 있습니다. i번 층을 막 지난 " to" 벡터를 꺼내 마지막 정규화와 임베딩 표에 통과시키고, " Alice"의 확률을 읽습니다.
for i, x in enumerate(layer_outputs):      # x: i번 층을 지난 " to" 벡터
    p = (rms_norm(x, sd["model.norm.weight"], eps) @ sd["model.embed_tokens.weight"].T).softmax(-1)
    print(i, p[alice_id].item())           # GPT-2는 LayerNorm과 wte, Granite는 점수를 먼저 3으로 나눔
이렇게 하면 모델이 i번 층에서 멈췄을 때 무엇이라고 답할지 보입니다. 이 방법을 logit lens라고 부릅니다. 중간 층은 이렇게 읽히도록 학습되지 않았으므로 거친 방법이지만, 답이 언제쯤 생기는지는 보여 줍니다.
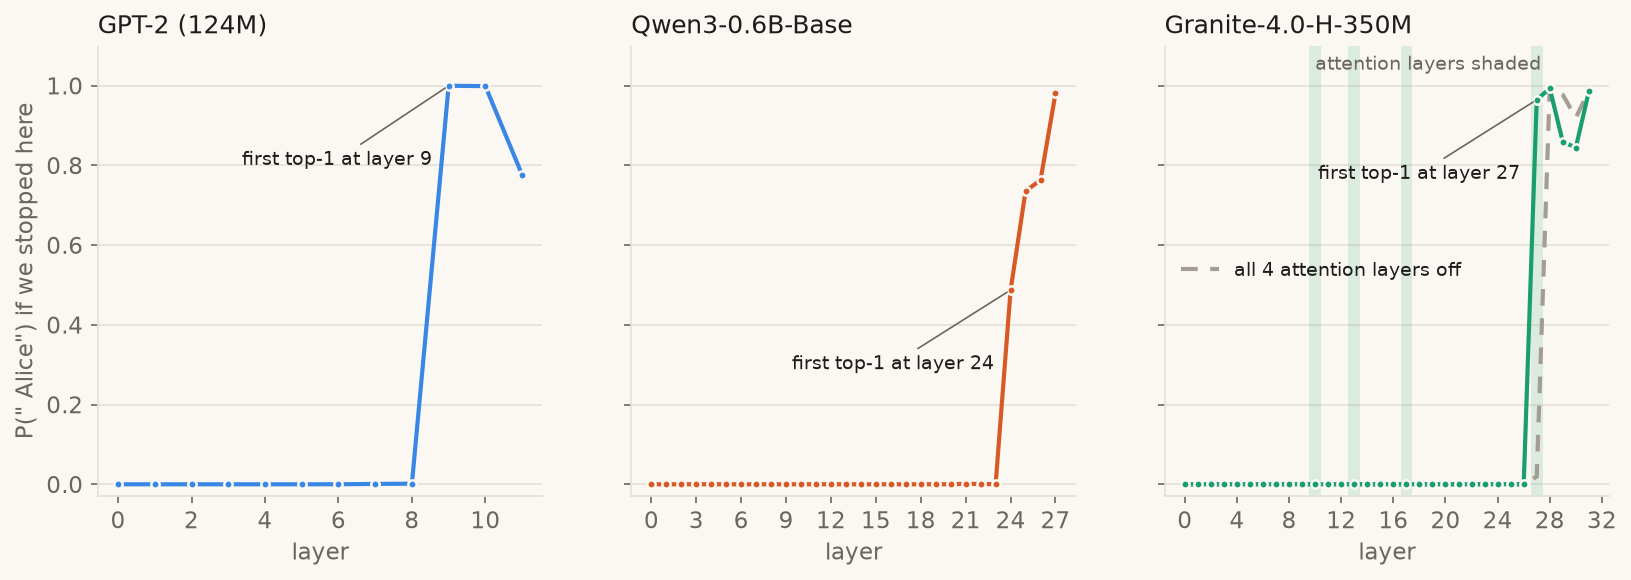
세 모델 모두 " Alice"가 늦게, 전체 층의 마지막 4분의 1에서 나타납니다. GPT-2는 12층 중 9층, Qwen3는 28층 중 24층, Granite는 32층 중 27층입니다. 그 직전에는 대명사가 1위입니다. GPT-2는 6층부터 8층까지 " him", Qwen3는 23층에서 " her"입니다. "여기에는 사람이 온다"를 먼저 정하고, 어느 사람인지는 나중에 채우는 것처럼 보입니다.
Granite의 27층은 어텐션 층입니다. 앞의 섞는 표에서도 " to"가 " Alice"에서 눈에 띄는 몫을 가져오는 층이 바로 여기였습니다. 어텐션 층이 이름을 가져오는 것처럼 보입니다. 그런데 점선을 보면 꼭 그렇지는 않습니다. 어텐션 4개 층을 모두 꺼도 " Alice"는 한 층 늦게 Mamba2 28층 뒤에 나타나고, 마지막에는 0.988이 됩니다.
층을 꺼 보면
섞는 단계를 끈다는 것은 계산은 평소대로 하되 그 출력에 0을 곱한다는 뜻입니다. 그러면 5단계에서 더할 것이 없어서(GPT-2는 어텐션 출력 투영의 고정 bias만 남습니다) 벡터가 그 칸을 거의 그대로 지나가고, 같은 층의 FFN은 계속 돕니다. 저희 코드에서는 모든 어텐션 층이 같은 attention 함수를 부르므로, 그 함수를 0을 돌려주는 함수로 잠깐 바꿔 끼웁니다.
orig = hf.attention
hf.attention = lambda q, k, v, scale: orig(q, k, v, scale) * 0   # 모든 어텐션 층이 0을 더함
logits = hf.granite_forward(sd, cfg, ids, {})
hf.attention = orig                                              # 원래대로 되돌림
층 하나만 끌 때는 바꿔 끼운 함수가 자기가 몇 번째로 불렸는지 세다가 j번째 호출만 0으로 만듭니다. Mamba2 층은 mamba2 함수를 같은 방식으로 바꿔서 끕니다. 실행할 때마다 0으로 만든 호출 수가 계획과 같은지 확인했습니다. 어텐션을 모두 끄면 4번, Mamba2를 모두 끄면 28번이어야 합니다. 이 절의 입력은 모두 처음의 18토큰 문장이고, 마지막 토큰에서 " Alice"의 확률을 읽었습니다.
한 층씩 끄면 답은 대체로 살아남습니다. GPT-2는 어텐션 12개 층 중 어느 하나를 꺼도 " Alice"가 1위이고, 가장 낮을 때가 0.427(5층)입니다. Qwen3는 28번 중 27번에서 0.843 이상을 지켰습니다. 예외는 0번 층입니다. 이 층을 끄면 Qwen3는 " Web"이라고 답하고, Granite는 첫 Mamba2 층을 끄면 " their"라고 답합니다. 두 층은 이름과 관계없이 모델이 돌아가는 데 필요한 층으로 보입니다.
Granite에서 Mamba2 28개 층을 모두 끄면 0.000이고, 1위 단어가 " *_"가 됩니다. 말이 되는 출력 자체가 사라집니다. 16층 이후의 Mamba2 층 14개만 꺼도 0.0001이고 " the"라고 답합니다. 어텐션 4개 층을 모두 끄면 0.988입니다. 이 문장에서 이름에는 어텐션이 필요하지 않았습니다. 다만 이 시험으로는 Mamba2 층이 이름을 옮기는 것인지, 모델이 돌아가게 하는 것뿐인지 가릴 수 없습니다.
거리를 늘려 보면
18토큰 문장에서 "Alice"는 4번 자리에 있고 질문은 17번 자리에서 끝납니다. 이름과 질문 사이가 13토큰밖에 안 됩니다. 그래서 이 거리를 늘려 봤습니다. 다만 모델이 옮겨 올 만한 새 단서가 끼어들면 안 되므로, 입력을 세 부분으로 나눠 만들었습니다.
- 앞부분: "In the morning, Alice gave Bob a book."
- 끼워 넣는 문단: 사람도 책도 나오지 않는 문단 하나입니다. 답에 대한 단서가 전혀 없습니다.
- 뒷부분: "Later, Bob gave the book back to"
끼워 넣은 문단은 다음과 같습니다. 비 오는 마을, 빵집, 버스, 공원, 강과 다리 이야기입니다.
The sky was grey and a light rain fell over the town. The bakery on the corner opened late, and the smell of bread drifted down the street. A bus stopped, waited, and pulled away. In the park, the benches were wet and nobody sat on them. The river was high after a week of rain, and the old bridge creaked when the wind picked up. Shops put out their signs one by one.
이 문단을 0번, 1번, 4번, 16번 그대로 반복해 넣었습니다. 질문과 정답은 그대로이고, 이름과 질문 사이의 거리만 늘어납니다. 전체 길이는 세 토크나이저에서 모두 같게 나왔습니다.
| 문단 반복 횟수 | 전체 토큰 수 |
|---|---|
| 0 | 18 (처음 문장) |
| 1 | 105 |
| 4 | 366 |
| 16 | 1,410 |
text = HEAD + FILLER * n + TAIL # n = 0, 1, 4, 16입력마다 마지막 토큰에서 " Alice"의 확률을 읽었습니다. Granite는 두 번 쟀습니다. 한 번은 학습된 그대로, 한 번은 위와 같은 방법으로 어텐션 4개 층을 모두 끈 채입니다.
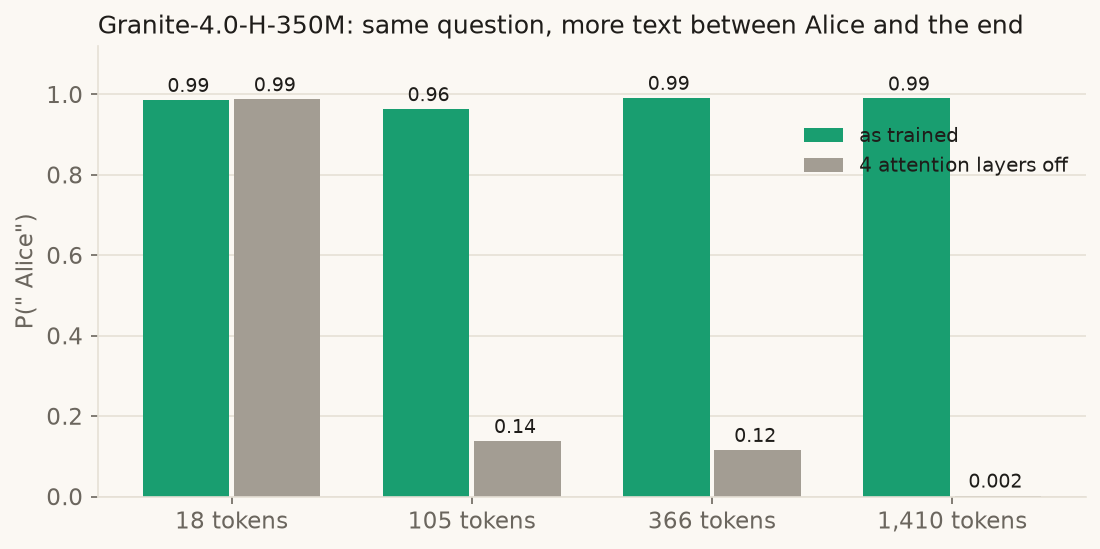
| 전체 토큰 수 | Granite | Granite, 어텐션 끔 | Qwen3 | GPT-2 |
|---|---|---|---|---|
| 18 | 0.986 | 0.988 | 0.980 | 0.776 |
| 105 | 0.963 | 0.138 (1위 " the") | 0.972 | 0.604 |
| 366 | 0.991 | 0.116 (" the") | 0.966 | 0.706 |
| 1,410 | 0.990 | 0.002 (" the") | 0.973 | 돌릴 수 없음 (1,023번 뒤 위치 행 없음) |
문단을 한 번만 넣은 105토큰에서 벌써 어텐션을 끈 Granite는 0.138로 떨어지고 " the"라고 답합니다. 1,410토큰에서는 0.002입니다. 학습된 그대로의 Granite는 모든 길이에서 0.96 이상을 지켰고, 어텐션 층만 있는 Qwen3도 마찬가지였습니다.
정리하면 어텐션 4개 층을 켜 두면 저희가 시험한 모든 길이에서 이름이 살아남았고, 끄면 105토큰부터 사라졌습니다. 긴 입력에서 상태나 어텐션 가중치를 따로 재지는 않았으므로, 이유는 저희의 해석입니다. 크기가 고정된 상태는 모든 것을 같은 공간에 담아야 해서 한 걸음마다 오래된 내용을 조금씩 흐리게 하는 반면, 어텐션은 거리와 상관없이 "Alice"를 곧바로 읽을 수 있기 때문으로 보입니다. 하이브리드 설계가 노리는 분업도 이런 모습입니다. 대부분의 층은 고정 크기 상태로 싸게 돌리고, 몇 개 층만 앞을 직접 되돌아보게 하는 것입니다.
이 결과가 말하는 범위
- 문장 하나와 끼워 넣은 문단 하나로 잰 결과입니다. 다른 문장이나 이름이 섞인 문단이라면 숫자가 달라질 수 있습니다.
- 층 끄기는 거친 방법입니다. 뒤쪽 층은 학습 중에 그 자리에서 0을 본 적이 없으므로, 확률이 떨어졌다는 것은 그 층이 필요하다는 뜻이지 그 층이 정확히 무엇을 하는지까지 말해 주지는 않습니다.
- logit lens와 섞는 표는 모습을 보여 줄 뿐이고, 원인을 시험한 것은 층 끄기뿐입니다.
- CPU에서 float32로 돌린 작은 base 모델 세 개의 결과입니다. 같은 계열의 더 큰 모델은 다르게 움직일 수 있습니다.
세 모델을 칸별로 보면
| 단계 | GPT-2 | Qwen3-0.6B-Base | Granite-4.0-H-350M |
|---|---|---|---|
| 위치 | 학습된 행을 더함, 최대 1,024 | 어텐션 안에서 RoPE 회전 | 없음, 순서는 Mamba2가 담당 |
| 정규화 | LayerNorm | RMSNorm (Q, K에도) | RMSNorm |
| 섞기 | 어텐션, 헤드 12 | 어텐션, 쿼리 헤드 16이 키·값 헤드 8을 나눠 씀 | 28개 층 Mamba2, 4개 층 어텐션 |
| FFN | GELU | SwiGLU | SwiGLU |
| 출력 | 임베딩 표 재사용 | 임베딩 표 재사용 | 임베딩 표 재사용, 점수 ÷ 3 |
세 모델의 뼈대는 같고, 다른 것은 표에 적은 칸들입니다. 다음 글에서는 이 칸들을 더 많은 설계에 걸쳐 살펴봅니다. 원조 Transformer에서 Mamba와 다른 하이브리드까지입니다. 받아 보고 싶으시면 아래 뉴스레터 폼에서 구독하실 수 있습니다.
주간 뉴스레터에 새 글 링크를 담아 보냅니다. 메일은 영어로 발송됩니다.