결정 모델은 얼마나 줄여도 될까: decider-4b를 BF16부터 Q2_K까지 llama.cpp로 재 봤습니다
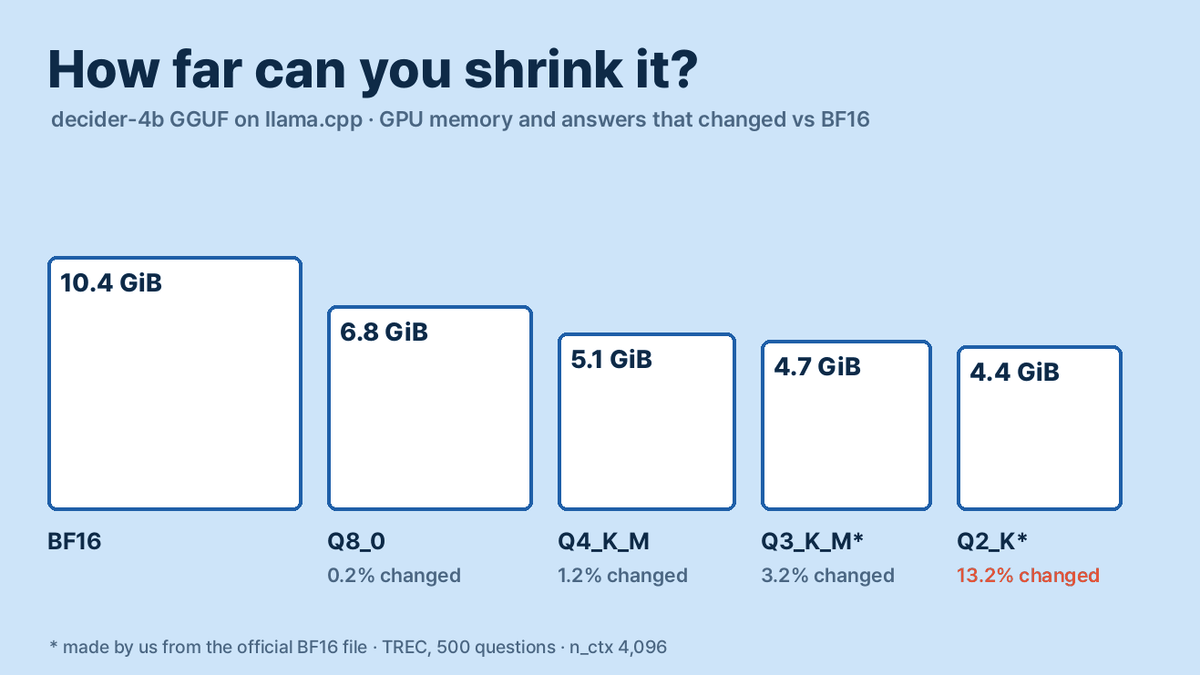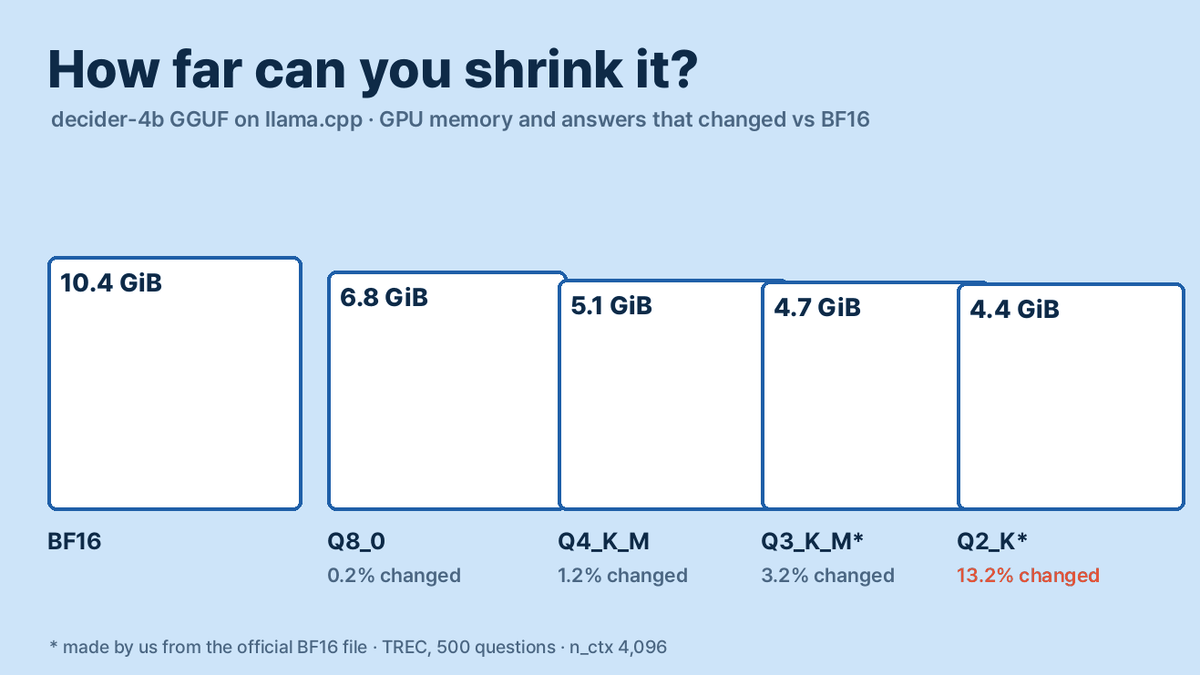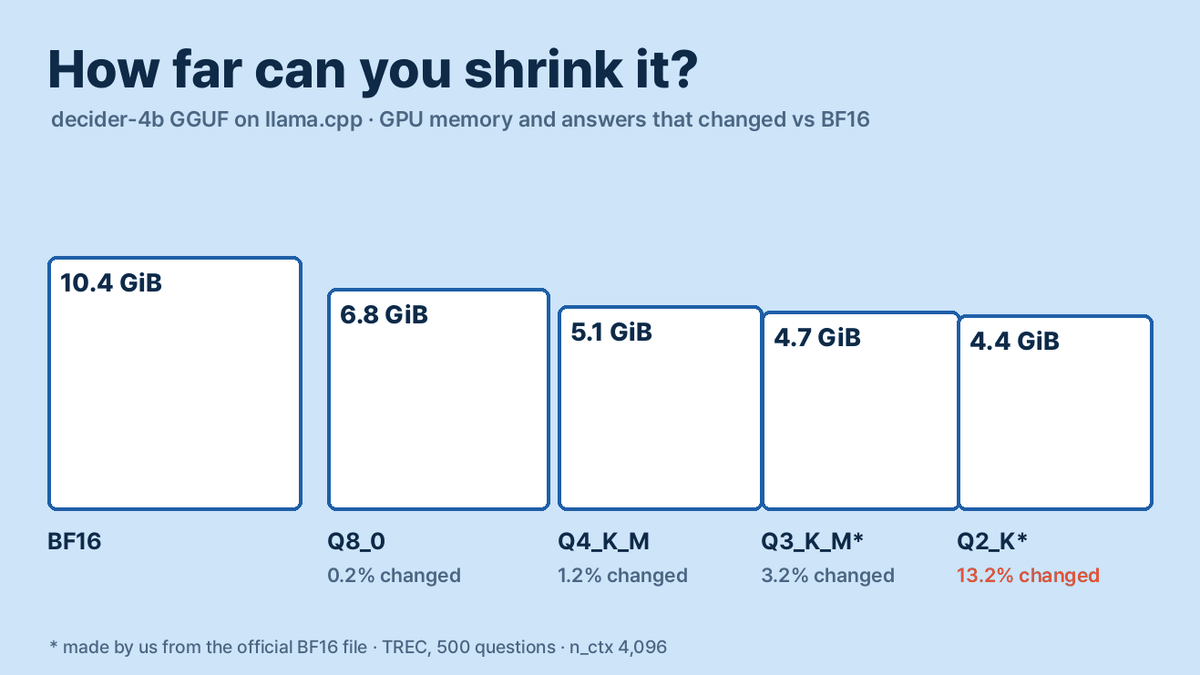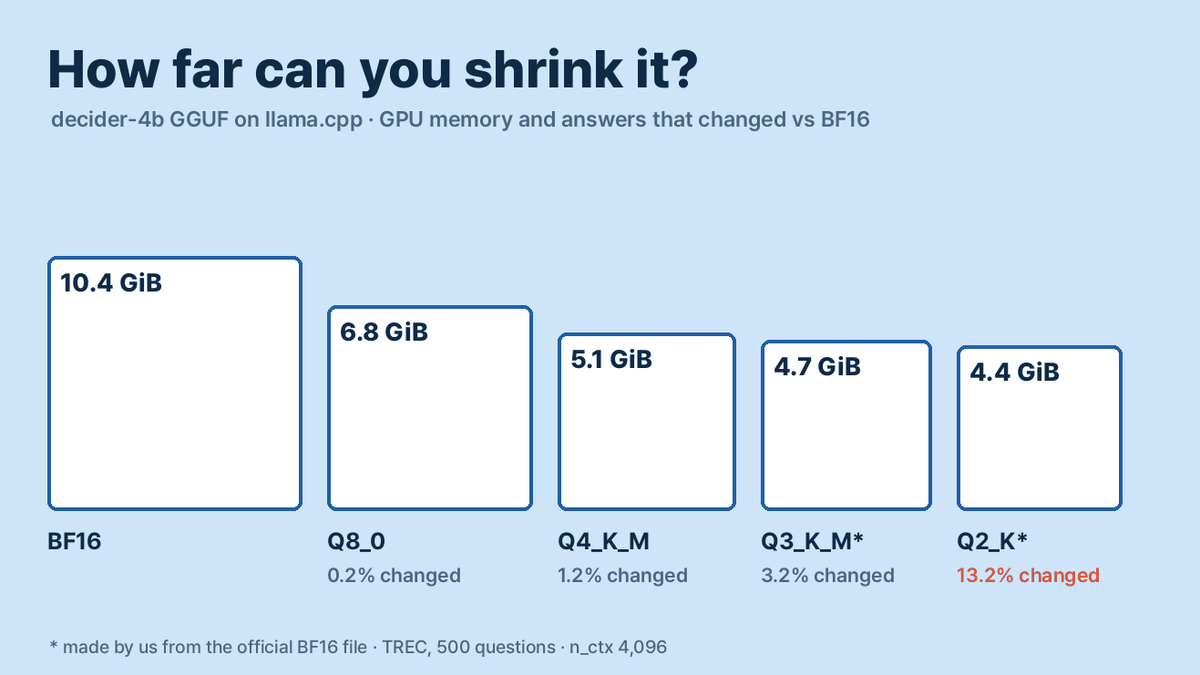
공개 결정 모델 decider-4b를 GGUF 다섯 단계로 줄여 가며 TREC 질문 500개에 돌렸습니다. GPU 메모리는 BF16 10.4GiB에서 Q2_K 4.4GiB까지 줄었고, 정확도 차이는 어느 단계에서도 검출되지 않았습니다. 확률은 달라졌습니다. 로그 손실은 Q4_K_M에서 조금 좋아졌고 Q8_0(아주 조금), Q3_K_M, Q2_K에서는 나빠졌습니다. Q2_K는 답의 13%가 바뀌었고, Q3_K_M은 확률 0.9를 넘는 답이 40%에서 23%로 줄었습니다. Q4_K_M은 메모리를 절반으로 줄였고, 정확도 차이는 검출되지 않았으며 로그 손실은 좋아졌습니다.
결정 모델은 얼마나 줄여도 될까: decider-4b를 BF16부터 Q2_K까지 llama.cpp로 재 봤습니다
결정 모델은 판단할 내용과 답이 정해진 질문을 받아 답마다 확률을 돌려줍니다. 이 모델을 쓰는 이유는 결국 그 확률입니다. 확률이 높으면 애플리케이션이 처리하고, 낮으면 사람에게 넘깁니다. 그러니 작은 GPU에 맞추려고 양자화할 때 봐야 할 것은 정답을 여전히 고르는지만이 아닙니다. 확률이 여전히 같은 뜻인지도 봐야 합니다.
decider-4b는 4B 크기의 공개 결정 모델이고, llama.cpp용 공식 GGUF 파일이 있습니다. 원저자는 큰 회귀 세트에서 BF16, Q8_0, Q4_K_M의 정확도, 로그 손실, 보정 오차를 이미 공개했습니다. Q4_K_M은 144,226행 중 97.06%에서 bf16 가중치와 같은 답을 냈습니다(GGUF 카드). 파일을 고르는 입장에서는 두 가지가 빠져 있습니다. Q4보다 작은 단계와, 단계마다 메모리를 실제로 얼마나 아끼는지입니다. 저희는 이 두 가지를 쟀습니다. 원저자가 이름을 밝힌 학습 데이터 목록에 없는 과제를 썼고, Decision-1 글에서 쓴 "이름이 정의와 어긋나는 선택지" 시험도 함께 했습니다.
먼저 말씀드리고 싶은 발견은 파일 크기가 아닙니다. 정확도 차이는 어느 단계에서도 검출되지 않았지만, 같은 0.9 기준에서 Q3_K_M이 받아들인 답은 23.2%로 BF16의 40.2%보다 적었습니다. 사람이 맡을 질문이 60%에서 77%로 늘어난다는 뜻입니다. 양자화는 메모리만이 아니라 사람이 처리할 일의 양도 바꿨습니다.
측정 방법
- 파일
- 공식 파일: decider-4b v2.1의 BF16, Q8_0, Q4_K_M GGUF입니다. 받은 파일의 체크섬이 저장소와 일치합니다.
- 저희가 만든 파일: Q3_K_M과 Q2_K입니다. 공식 BF16 파일을 llama.cpp 4da6337의 llama-quantize 기본 설정으로 줄였고, importance matrix는 쓰지 않았습니다. 원저자가 만든 파일이 아닙니다.
- 실행 환경: decider-ai 1.6.0과 llama-cpp-python 0.3.36(CUDA)으로 A100 한 장에 모든 층을 올렸습니다. 컨텍스트는 모든 단계에서 4,096으로 같습니다. GPU 메모리는 모델을 올리고 첫 질문에 답한 뒤 프로세스가 쓴 양입니다.
- 데이터: TREC 질문 500개(답 종류 6가지)이고, 선택지마다 이름과 정의를 붙였습니다. decider-ai 1.6.0 소스(
decider/data/core.py)의 공개 과제 구성에서trec은 학습에서 뺀(held-out) 과제로, 아래에서 한 번 쓰는ag_news는 학습 과제로 지정돼 있습니다. decider 자체의 미세조정에 무엇을 썼는지를 말해 줄 뿐이고, decider가 바탕으로 삼은 기반 모델이 TREC를 본 적이 없다는 뜻은 아닙니다. - 주 지표(채점 전에 정함): 작은 파일 네 개 각각을 BF16과 비교한 정확도와 로그 손실(NLL)입니다. 모두 비교 8개라 p값을 Holm 방법으로 한꺼번에 보정했습니다. 함께 적은 95% 구간은 일반 부트스트랩 구간이고, 다중 비교 보정을 하지 않은 값입니다. 보정 뒤에도 남는 차이만 차이로 보고, 방향은 어느 쪽이든 적습니다.
- 판정 없이 보고한 것: 보정 오차(ECE), 최고 확률이 맞은 답과 틀린 답을 얼마나 잘 가르는지(AUROC), 0.9를 넘는 답의 비율, 그리고 BF16과 답이 달라진 비율입니다.
GPU를 다른 작업과 함께 써서 속도는 재지 않았습니다.
결과
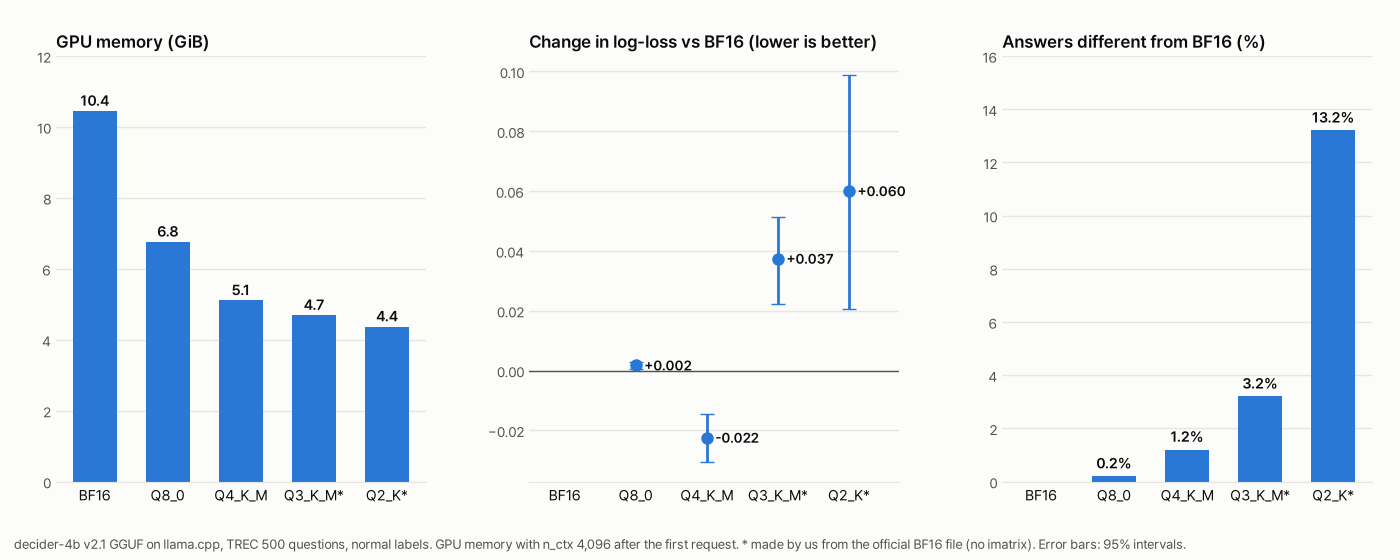
| 파일 | 디스크 크기 | GPU 메모리 | BF16 대비 아낀 메모리 | 정확도(변화, 95% 구간) | 로그 손실(변화, 95% 구간) | BF16과 달라진 답 |
|---|---|---|---|---|---|---|
| BF16 | 8.42GB | 10.4GiB | — | 86.4% | 0.387 | — |
| Q8_0 | 4.48GB | 6.8GiB | 3.7GiB(35%) | 86.2%(−0.2, −0.6에서 0.0) | 0.389(+0.002, +0.001에서 +0.003) | 1개(0.2%) |
| Q4_K_M | 2.71GB | 5.1GiB | 5.3GiB(51%) | 86.4%(0.0, −1.0에서 +1.0) | 0.365(−0.022, −0.031에서 −0.015) | 6개(1.2%) |
| Q3_K_M(저희가 만듦) | 2.26GB | 4.7GiB | 5.8GiB(55%) | 86.0%(−0.4, −2.0에서 +1.2) | 0.425(+0.037, +0.022에서 +0.051) | 16개(3.2%) |
| Q2_K(저희가 만듦) | 1.92GB | 4.4GiB | 6.1GiB(58%) | 85.6%(−0.8, −3.8에서 +2.2) | 0.447(+0.060, +0.021에서 +0.099) | 66개(13.2%) |
디스크 크기는 GB(10⁹바이트), GPU 메모리는 GiB(2³⁰바이트)입니다. 정확도 변화의 단위는 %p입니다.
정확도는 어느 단계에서도 차이가 검출되지 않았습니다. BF16 대비 변화는 −0.2, 0.0, −0.4, −0.8%p였습니다. 다만 Q2_K의 95% 구간이 −3.8에서 +2.2%p라서, 질문 500개로는 몇 %p 정도의 손실까지는 배제할 수 없습니다.
로그 손실은 양쪽으로 움직였습니다. p값을 Holm 방법으로 보정한 뒤의 판정입니다(구간은 보정 전).
- Q8_0은 0.0017 나빠졌습니다(구간 0.0006-0.0028). 실제 차이지만 아주 작습니다.
- Q4_K_M은 0.022 좋아졌습니다(구간 −0.031에서 −0.015).
- Q3_K_M은 0.037 나빠졌습니다(0.022-0.051).
- Q2_K는 0.060 나빠졌습니다(0.021-0.099).
Q4_K_M이 BF16보다 좋게 나온 것은 질문 500개에서 잰 결과입니다. 양자화가 원래 도움이 된다고 기대할 근거는 아닙니다. 원저자 표에서도 Q4_K_M의 로그 손실은 학습 과제 쪽 행에서는 조금 나빠지고, 학습하지 않은 과제 쪽 행에서는 조금 좋아졌습니다.
답이 달라졌다고 틀린 답이 된 것은 아닙니다. Q2_K는 66개의 답이 바뀌었습니다. 그중 28개는 Q2_K가 맞고 BF16이 틀렸고, 32개는 반대였고, 6개는 둘 다 틀렸습니다. 답이 많이 바뀌었는데도 정확도가 거의 그대로인 이유입니다. 하지만 BF16의 동작에 맞춰 조정해 둔 파이프라인이라면, 정확도와 상관없이 결정의 13%가 바뀌는 것 자체가 변화입니다. Q4_K_M에서는 6개가 바뀌었고 3개씩 양쪽으로 갈렸습니다. 저희의 일치율(Q8_0 99.8%, Q4_K_M 98.8%)은 원저자의 99.31%, 97.06%와 데이터도 규모도 달라서 비교하지 않습니다.
"0.9가 넘으면 바로 처리"는 어떻게 되나
| 파일 | 0.9 이상인 답 | 그중 틀린 답(건수, 95% 구간) | ECE |
|---|---|---|---|
| BF16 | 40.2% | 201개 중 3개(0.5-4.3%) | 0.054 |
| Q8_0 | 39.4% | 197개 중 3개(0.5-4.4%) | 0.049 |
| Q4_K_M | 39.8% | 199개 중 3개(0.5-4.3%) | 0.070 |
| Q3_K_M | 23.2% | 116개 중 0개(0.0-3.2%) | 0.086 |
| Q2_K | 31.0% | 155개 중 2개(0.4-4.6%) | 0.098 |
구간은 Wilson 95% 구간입니다.
Q3_K_M에서 0.9에 이른 답은 23.2%로, BF16의 40.2%보다 적었습니다(차이 −17.0%p, 구간 −20.4에서 −13.6). 받아들인 116개에서는 틀린 답을 관찰하지 못했습니다. 다만 그렇다고 안전하다는 뜻은 아니고, 116개라 구간이 3.2%까지 열려 있습니다. 분명한 비용은 따로 있습니다. 0.9 규칙을 쓰면 질문의 60%가 아니라 77%가 사람에게 넘어갑니다. 임계값은 그대로 두고 파일만 바꾸면, 정확도가 같아도 사람이 맡을 일의 양이 달라집니다.
BF16 대비 ECE 변화는 Q3_K_M +0.032(구간 0.006-0.058), Q2_K +0.044(0.014-0.068)이고, Q8_0(−0.006)과 Q4_K_M(+0.016)은 구간이 0을 포함합니다. 이 숫자들은 보고용이고 판정이 아닙니다. 사전에 정한 판정은 정확도와 로그 손실에만 적용합니다.
이름이 정의와 어긋날 때
Decision-1 글에서 쓴 뒤바뀐 선택지도 모든 파일에 넣었습니다. 정의마다 다른 범주의 이름을 붙였고, 정답은 언제나 정의가 뜻하는 범주입니다.
| 파일 | 뒤바꿈 정확도 | 이름을 따름 | 뒤바꿈 AUROC | 선택지 순서를 뒤집었을 때 바뀐 답 |
|---|---|---|---|---|
| BF16 | 70.6% | 23.6% | 0.699 | 11 |
| Q8_0 | 71.0% | 23.2% | 0.697 | 12 |
| Q4_K_M | 77.4% | 16.4% | 0.761 | 10 |
| Q3_K_M | 68.8% | 23.6% | 0.608 | 13 |
| Q2_K | 66.2% | 23.6% | 0.633 | 41 |
모든 파일이 이름보다 정의를 더 많이 따랐고, 모든 파일이 정상 라벨보다 정확도가 떨어졌습니다(−9.0에서 −19.4%p). 양자화한 파일이 BF16보다 이름을 더 많이 따르지는 않았습니다. 선택지 순서를 뒤집으면 모든 파일에서 답이 몇 개씩 바뀌었는데, Q2_K에서 가장 많이 바뀌었습니다. 500개 중 41개였고, 다른 파일은 10-13개(BF16은 11개)였습니다. AG News 기사 제목 200개에서 라벨을 뒤바꿨을 때도 Q2_K의 정확도는 80.0%로, BF16의 90.0%보다 낮았습니다.
어떤 파일을 쓸까
이 절은 위 표를 보고 내린 저희 판단이고, 사전에 정한 판정이 아닙니다.
- Q4_K_M은 GPU 메모리를 10.4GiB에서 5.1GiB로 절반 넘게 줄였습니다. 이 과제에서는 정확도 차이가 검출되지 않았고 로그 손실은 좋아졌습니다. 0.9를 넘은 답은 39.8%로 BF16의 40.2%와 0.4%p 차이였고, 구간(−2.4에서 +1.6)이 0을 포함합니다. 저희라면 이 파일부터 쓰겠습니다.
- Q8_0은 아끼는 메모리가 더 적고, 이번 측정에서는 Q4_K_M보다 나은 점이 보이지 않았습니다.
- Q3_K_M과 Q2_K는 메모리를 0.4-0.7GiB 더 아낍니다. 그 대가로 로그 손실이 나빠졌습니다. Q3_K_M은 0.9를 넘는 답이 크게 줄었고, Q2_K는 답 여덟 개 중 하나가 바뀌었습니다. 선택지 순서를 뒤집었을 때 바뀐 답도 Q2_K는 41개로, BF16의 11개보다 많았습니다. 메모리가 그만큼 빠듯하다면, 바꾸기 전에 정답을 아는 사례로 임계값을 다시 확인하시기 바랍니다.
한계
- 과제 하나, 질문 500개, 파일마다 한 번씩 돌렸습니다. 같은 요청을 다시 돌린 결과는 모든 파일에서 확률까지 똑같았습니다.
- 저희가 만든 Q3_K_M과 Q2_K는 importance matrix 없이
llama-quantize기본 설정으로 만든 파일입니다. 더 공들여 만든 저비트 파일은 결과가 다를 수 있습니다. - GPU 메모리에는 CUDA 컨텍스트가 포함되고, 컨텍스트 크기(여기서는 4,096)에 따라 달라집니다.
- TREC는 짧은 6지선다 과제입니다. 입력이 길거나 선택지가 많은 질문은 양자화에 다르게 반응할 수 있습니다.
계획서, 스크립트, 파일 체크섬, 모든 답은 아래 재현 패키지에 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
decision-quant-repro.zip · 2,683 KB