llama.cpp KV 캐시 양자화, -ctk와 -ctv는 무엇으로 둘까: 현재 빌드에서 다시 잰 결과
KV 캐시가 VRAM에 들어가면 f16 그대로, 모자라면 -ctk q8_0 -ctv q8_0을 씁니다. 64K에서 4.2GiB를 아꼈지만 그 길이에서 디코드 속도는 f16의 56%였습니다.
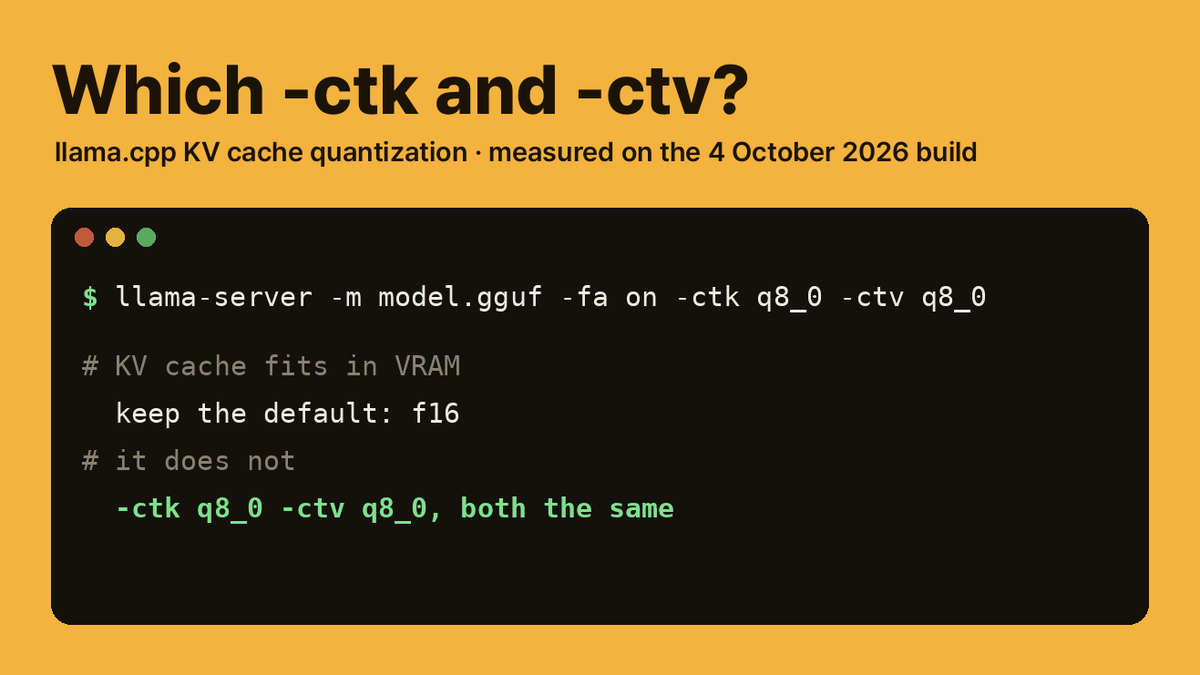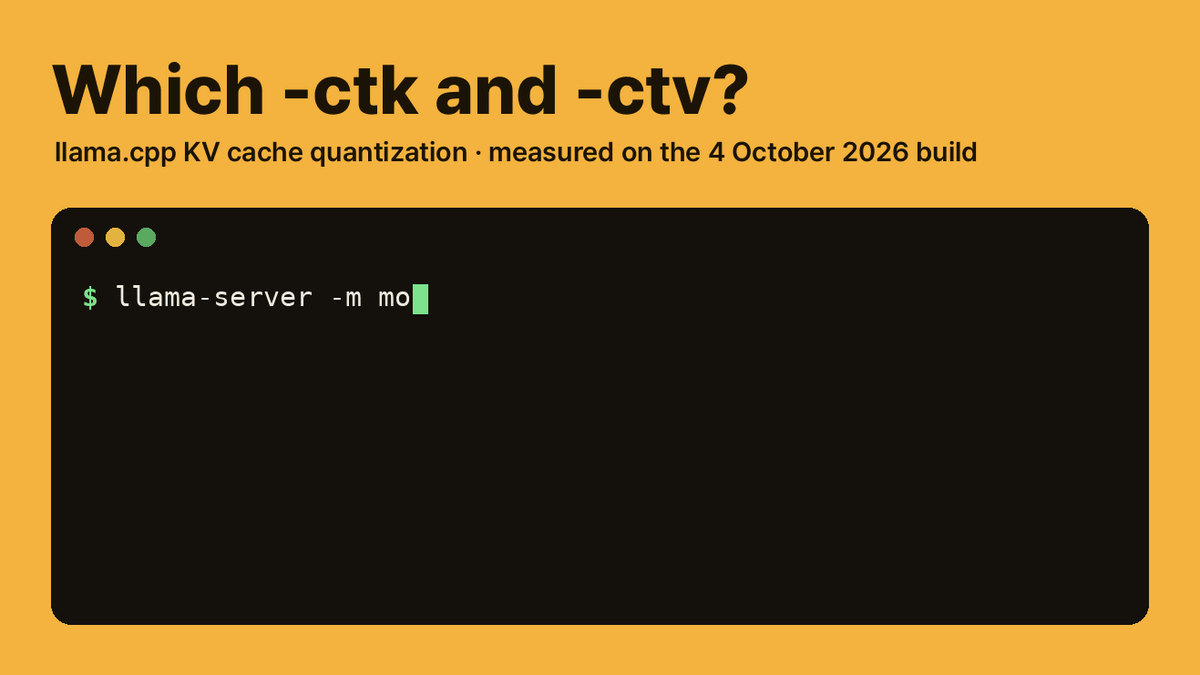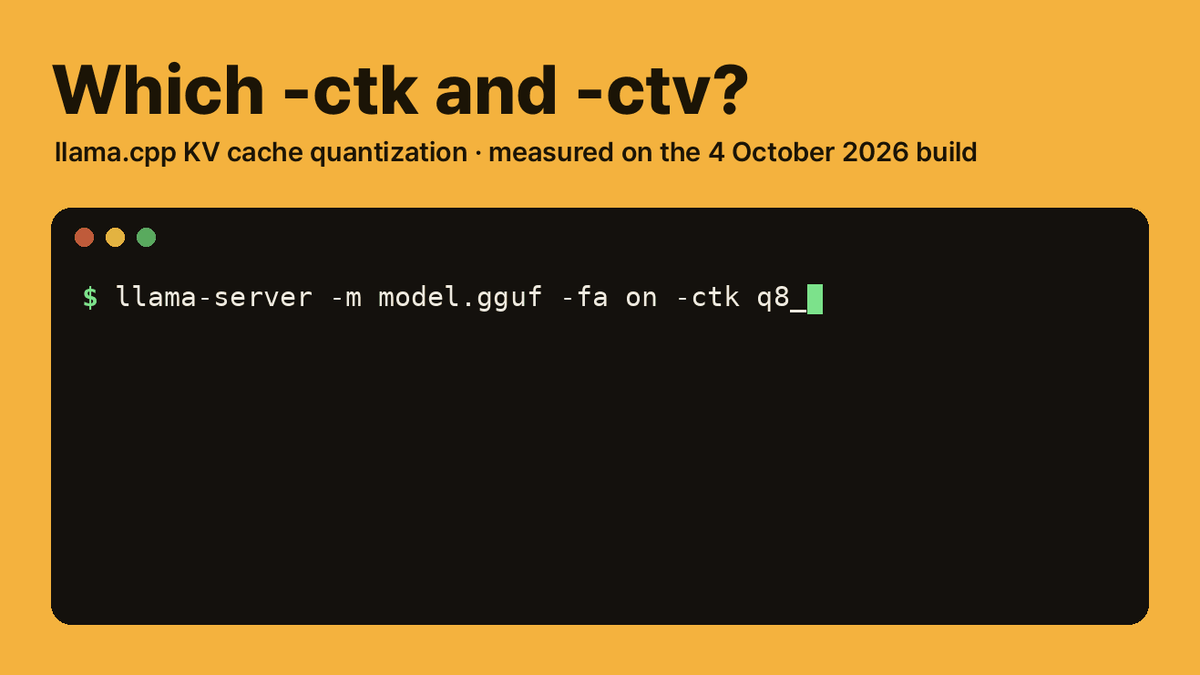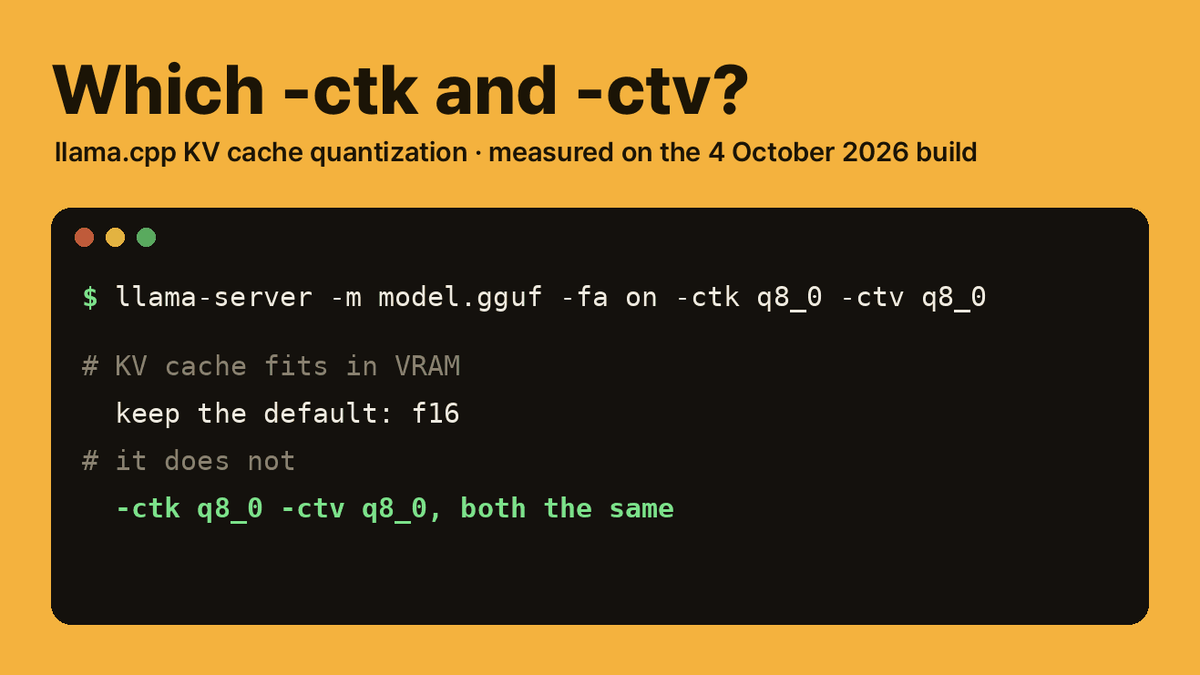
결론부터 말씀드립니다. KV 캐시가 VRAM에 들어간다면 기본값 f16을 그대로 두면 됩니다. 들어가지 않는다면 -ctk q8_0 -ctv q8_0을 씁니다. 두 플래그에는 같은 값을 넣고, 아낀 메모리가 공짜가 아니라는 점은 알고 쓰셔야 합니다. 문맥이 64K 토큰까지 차면 양자화한 캐시의 디코드 속도는 f16의 절반 정도입니다.
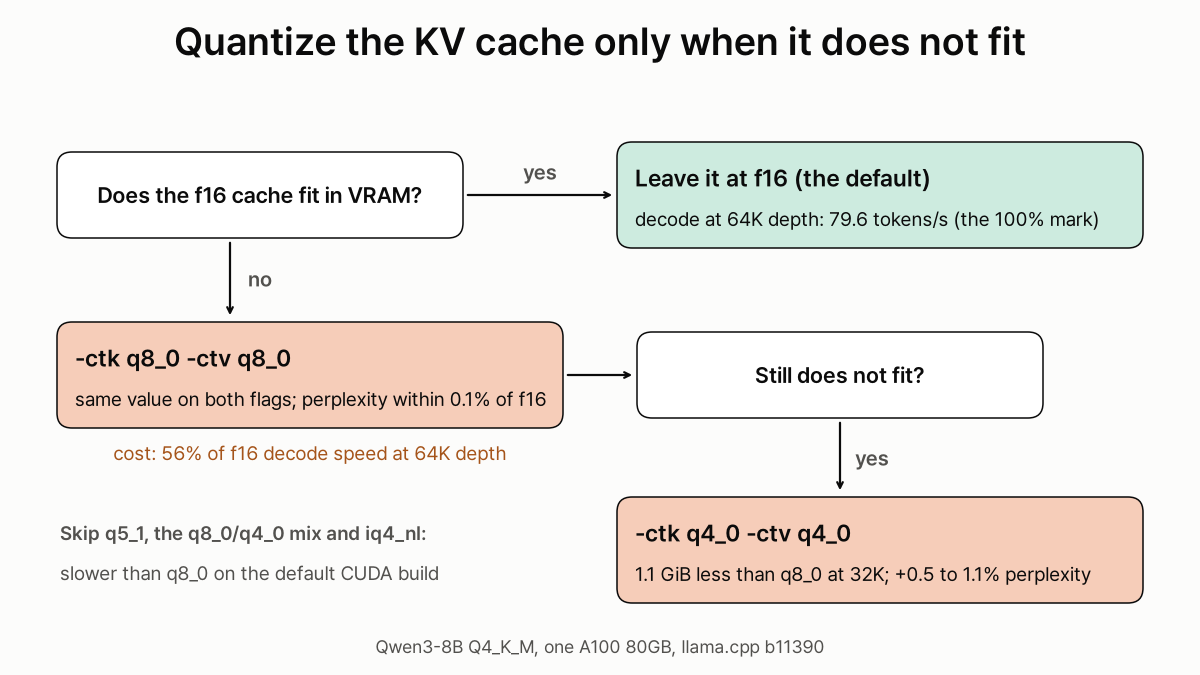
이 글은 이 블로그의 실측 글 세 편을 한 페이지로 줄이고, 2026년 10월 4일 llama.cpp 빌드에서 다시 확인한 것입니다. 다시 재 보기를 잘했습니다. 9월 9일에 들어간 변경으로 잘 쓰지 않는 타입들의 동작이 바뀌었고, 9월에 발행한 내용 일부는 지금 빌드에서 맞지 않습니다. 아래 숫자 중 예전 빌드에서 잰 것은 따로 적었습니다.
명령
# server, chat, CLI 모두 같은 두 플래그를 씁니다
llama-server -m model.gguf -ngl 99 -fa on -ctk q8_0 -ctv q8_0 -c 32768

# 정하기 전에 내 그래픽카드에서 타입별로 비교해 봅니다. 한 번에 한 타입씩
for t in f16 q8_0 q4_0; do
  llama-bench -m model.gguf -ngl 99 -fa on -ctk $t -ctv $t -p 4096 -n 128 -d 0 -d 32768
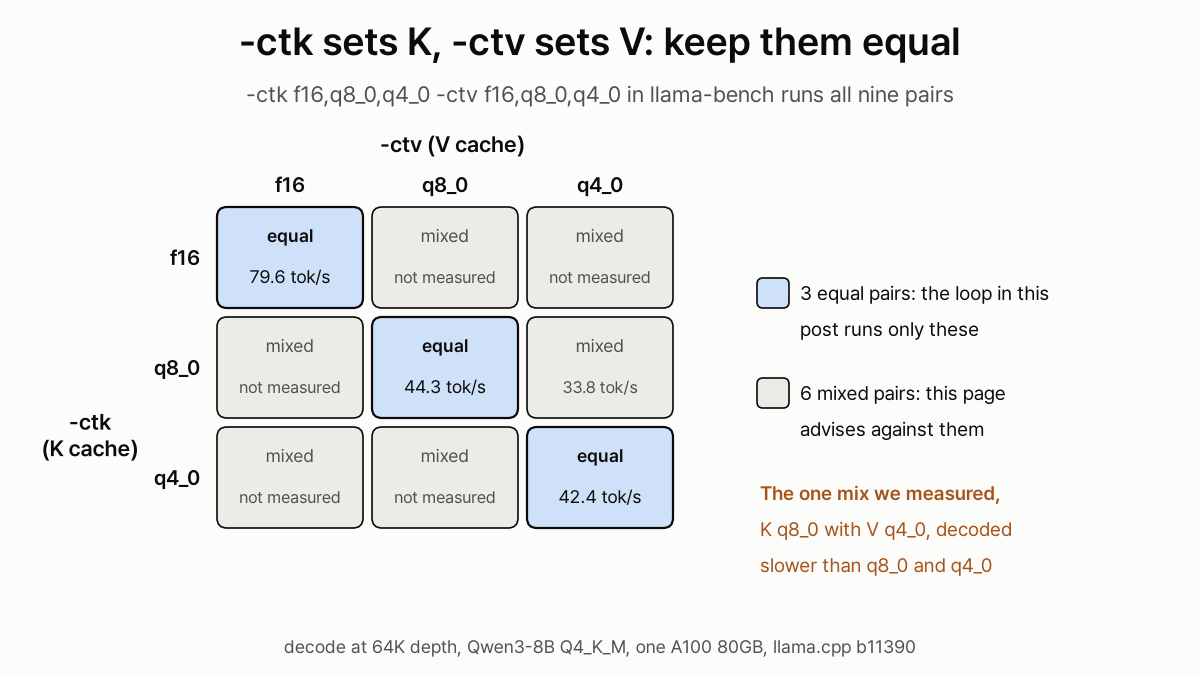
done-ctk와 -ctv는 --cache-type-k, --cache-type-v의 줄임말입니다. -fa on은 켜 두세요. llama.cpp에서 V 캐시를 양자화하려면 플래시 어텐션이 필요합니다. llama-bench는 쉼표로 여러 값을 받기도 하지만, -ctk f16,q8_0,q4_0 -ctv f16,q8_0,q4_0라고 쓰면 K/V 조합 9개를 모두 돌립니다. 그중 6개는 이 글이 권하지 않는 혼합 조합입니다. 위처럼 반복문으로 K와 V를 같은 값으로 맞추세요.
설정마다 치르는 비용
Qwen3-8B Q4_K_M, A100 80GB 한 장입니다. 속도는 10월 4일 빌드(b11390 (dd26678), CUDA 기본 옵션)에서 잰 초당 토큰입니다. 메모리는 32K 토큰일 때 캐시만의 크기를 타입의 비트 수로 계산한 값입니다. 퍼플렉서티는 9월 빌드(b10753 (69320fe))에서 잰 값입니다. 캐시 형식은 타입이 정하므로 커널이 바뀌어도 달라지지 않을 것으로 보지만, 다시 재지는 않았습니다.
-ctk / -ctv | 32K 캐시 | 퍼플렉서티, f16 대비 (4K-32K) | 프리필 4096 | 64K 깊이 디코드 |
|---|---|---|---|---|
| f16 / f16 | 4.50GiB | 기준 | 4,704 | 79.6 (100%) |
| q8_0 / q8_0 | 2.39GiB | 0.0%에서 +0.1% | 4,584 | 44.3 (56%) |
| q4_0 / q4_0 | 1.27GiB | +0.5%에서 +1.1% | 4,599 | 42.4 (53%) |
| bf16 / bf16 | 4.50GiB | 재지 않음 | 4,672 | 41.3 (52%) |
| q5_1 / q5_1 | 1.69GiB | 재지 않음 | 4,583 | 27.8 (35%) |
| q8_0 / q4_0 | 1.83GiB | 재지 않음 | 4,582 | 33.8 (42%) |
| iq4_nl / iq4_nl | 1.27GiB | 재지 않음 | 104 | 재지 않음 |
대부분의 설정은 이 표에서 세 가지로 정해집니다.
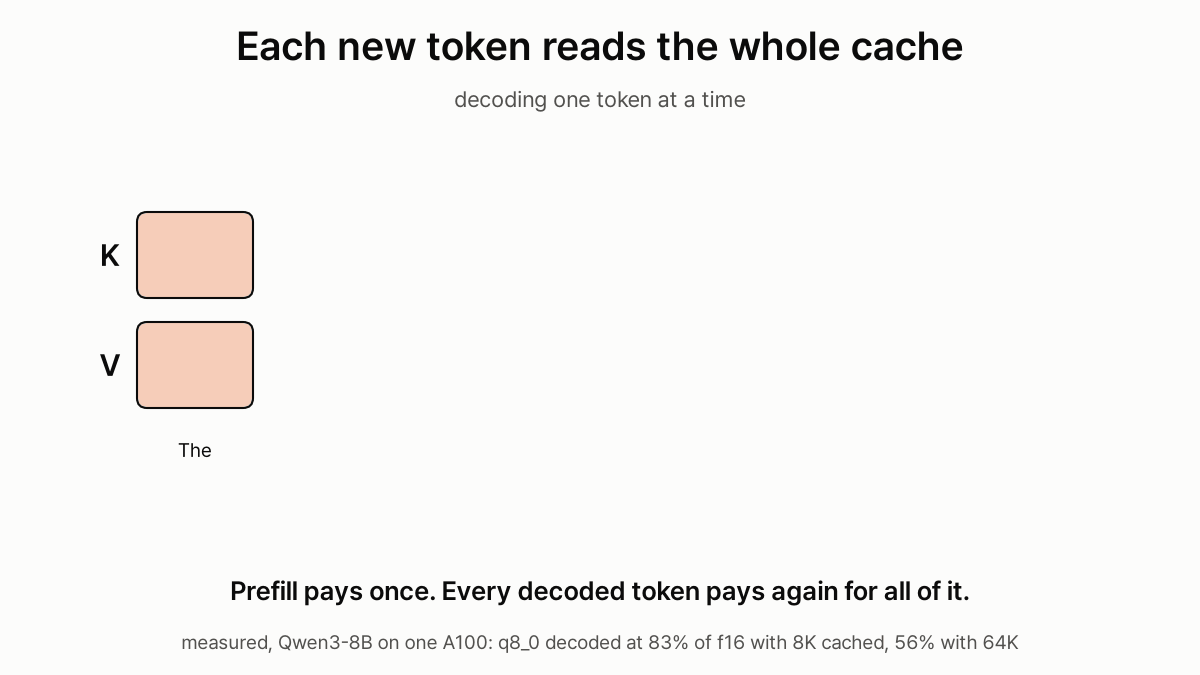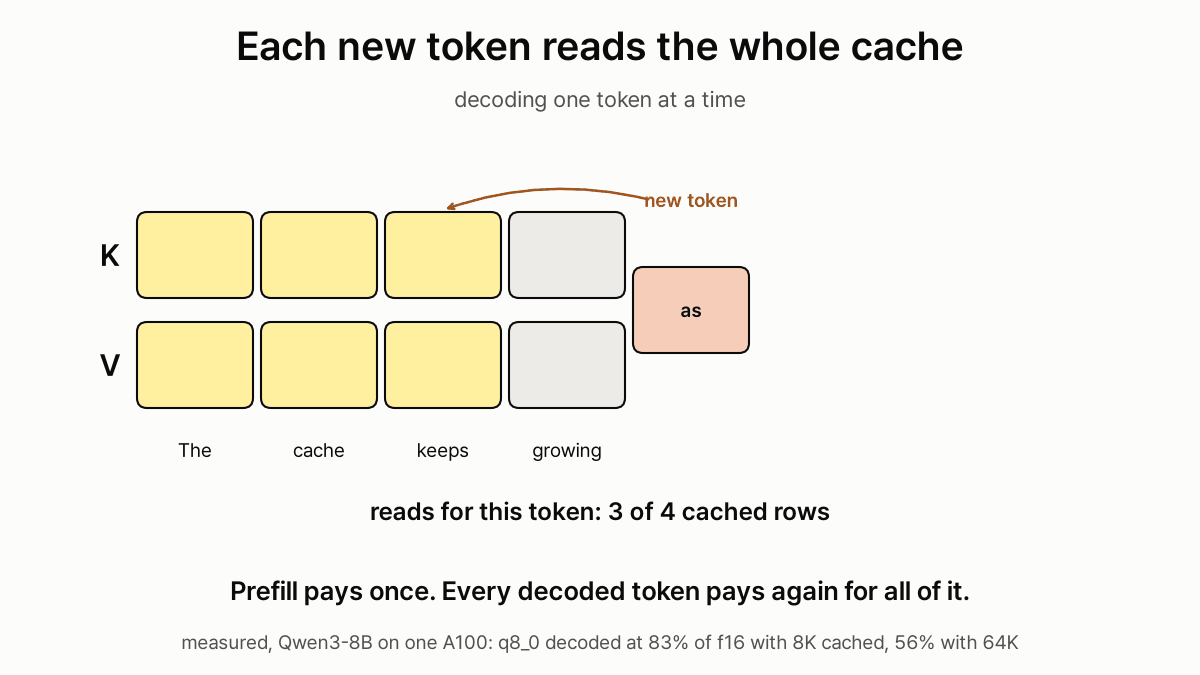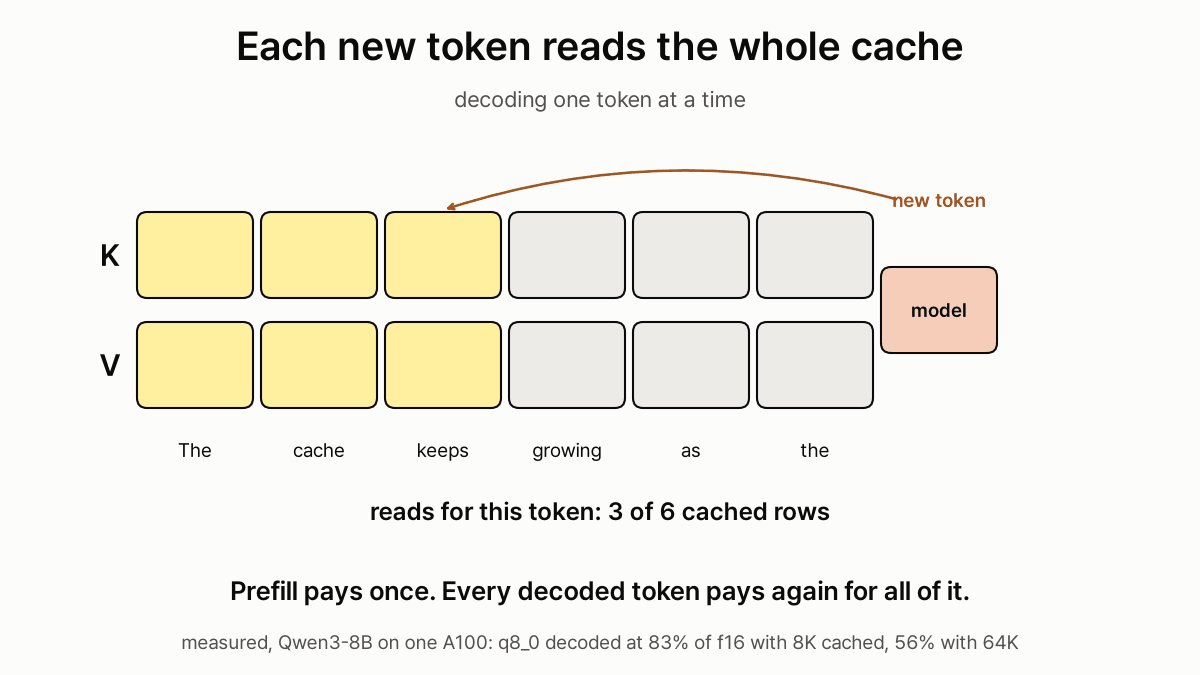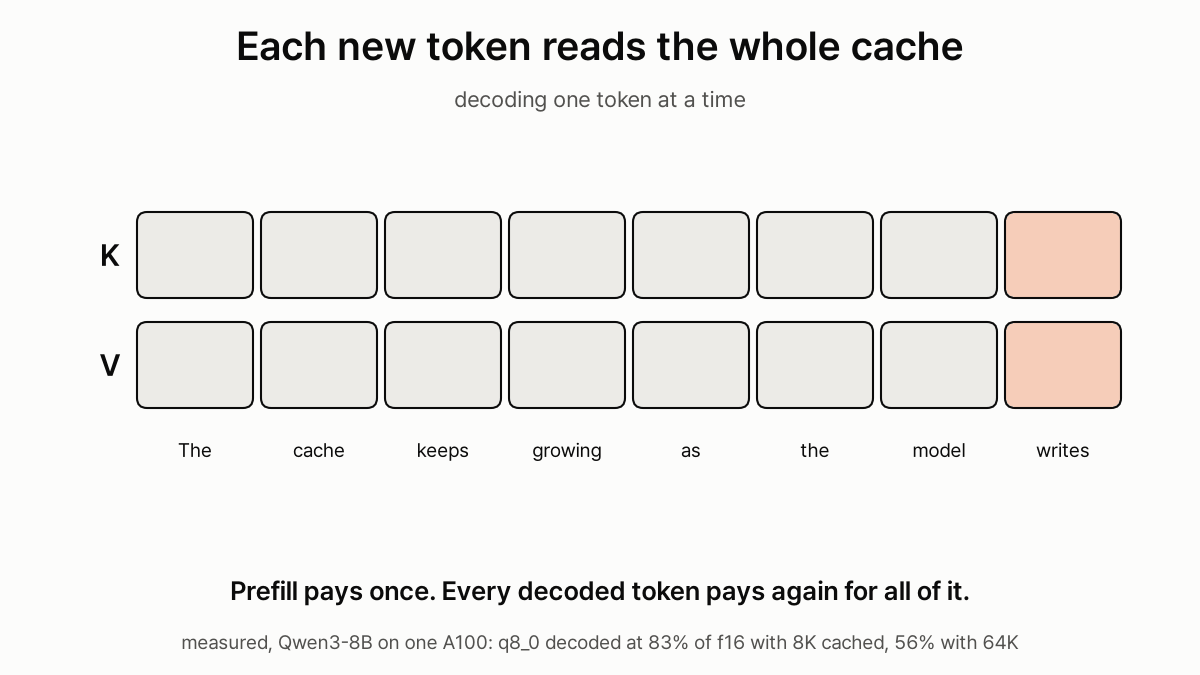
프리필은 거의 그대로이고, 깊은 문맥의 디코드가 느려집니다. 동작하는 타입은 모두 프리필이 f16과 3% 안쪽으로 차이 납니다. 비용은 캐시가 이미 길게 쌓였을 때 드러납니다. 새 토큰 하나를 만들 때마다 캐시 전체를 읽기 때문입니다. 캐시에 8K 토큰이 있을 때 q8_0의 디코드는 f16의 83%였고, 64K에서는 56%였습니다. 메모리가 필요했던 바로 그 긴 문맥에서, 아낀 메모리만큼 시간을 더 씁니다.
q8_0과 q4_0의 디코드 속도는 거의 같습니다. 8K, 32K, 64K 어디서든 5% 안쪽으로 차이 납니다. 그러니 둘 중 고르는 기준은 메모리와 품질입니다. 이 모델에서 q4_0은 32K 기준 1.1GiB를 더 아끼고, 퍼플렉서티가 1% 정도 나빠집니다. 그 1GiB가 모델을 올릴 수 있느냐를 가를 때만 q4_0을 고르시면 됩니다.
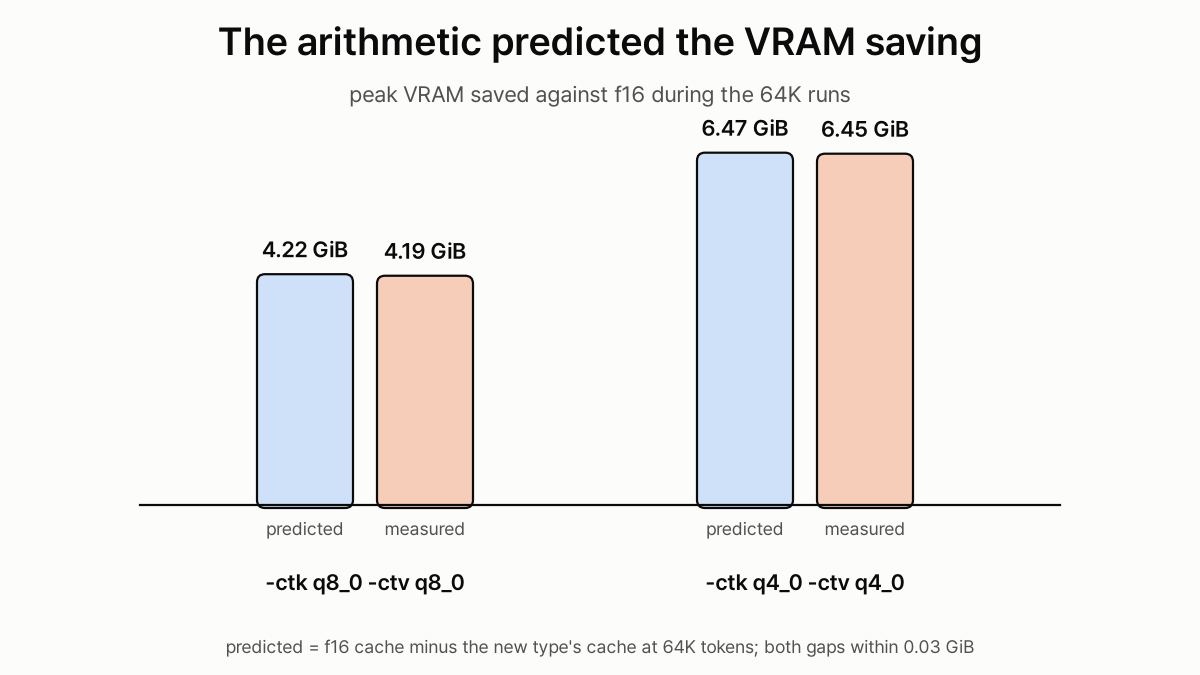
메모리는 실제로 줄어듭니다. 64K 측정 중 VRAM 최고치는 q8_0에서 4.19GiB, q4_0에서 6.45GiB 줄었습니다. 계산값은 4.22GiB와 6.47GiB였으니, 0.03GiB 안에서 맞았습니다.
돌아는 가지만 고를 이유가 없는 타입
9월 빌드에서는 이 중 타입 넷과 K/V를 다르게 준 조합이 모두 프리필 초당 83-284토큰이었습니다. 정상은 4,600토큰 안팎입니다. CUDA 기본 빌드가 이 조합들의 플래시 어텐션 커널을 아예 컴파일하지 않았기 때문입니다. 그래서 그때 글에서 "두 플래그에 같은 값을 넣고, 타입은 넷만 쓰라"고 정리했습니다.
지금 빌드에서는 대부분 그 낭떠러지가 사라졌습니다. 9월 9일에 들어간 변경(llama.cpp #28079)이 두 가지를 바꿨습니다. q4_1, q5_0, q5_1을 플래시 어텐션이 지원하는 타입으로 넣었습니다. 그리고 어떤 K/V 조합의 디코드 커널이 컴파일되어 있지 않으면, 느린 경로로 넘기는 대신 K와 V를 그때그때 f16으로 바꿔 계산합니다. 이때 llama-server가 한 줄을 찍습니다.
ggml_cuda_flash_attn_ext_vec: no FlashAttention vector kernel compiled for K/V types q5_1-q5_1, converting K and V to f16 instead (slow). Add "q5_1-q5_1" to GGML_CUDA_FA_QUANTS to compile it.llama-bench는 기본으로 라이브러리 로그를 꺼 두기 때문에, -v를 주지 않으면 이 줄이 보이지 않습니다.
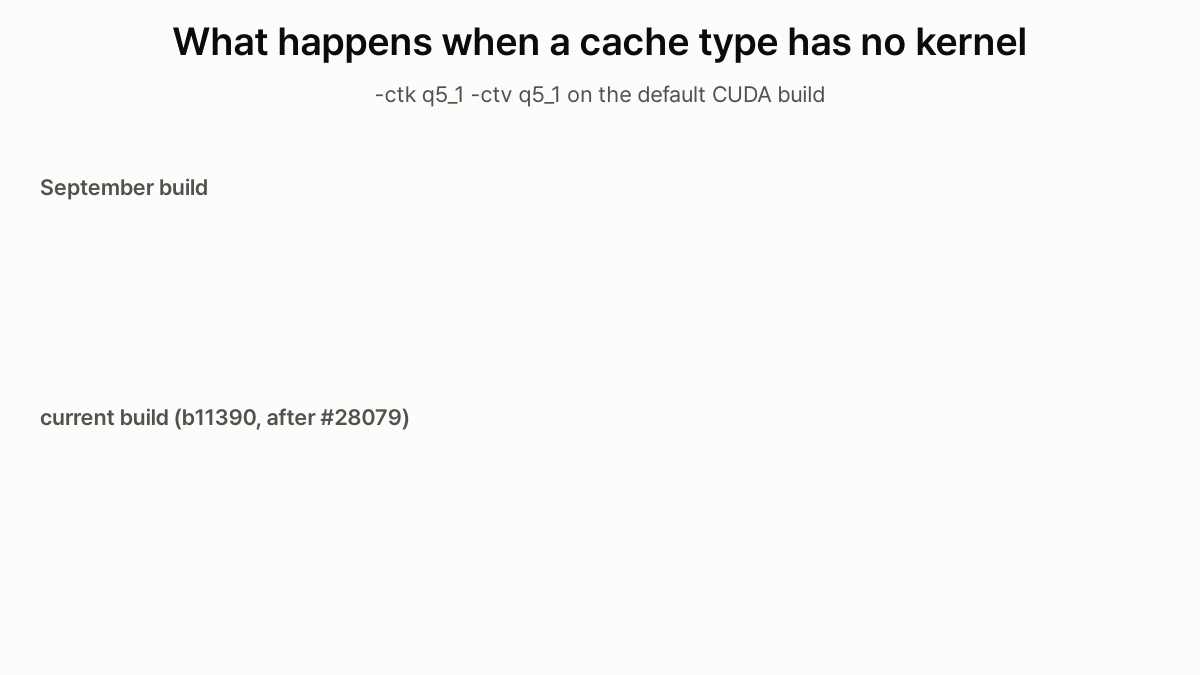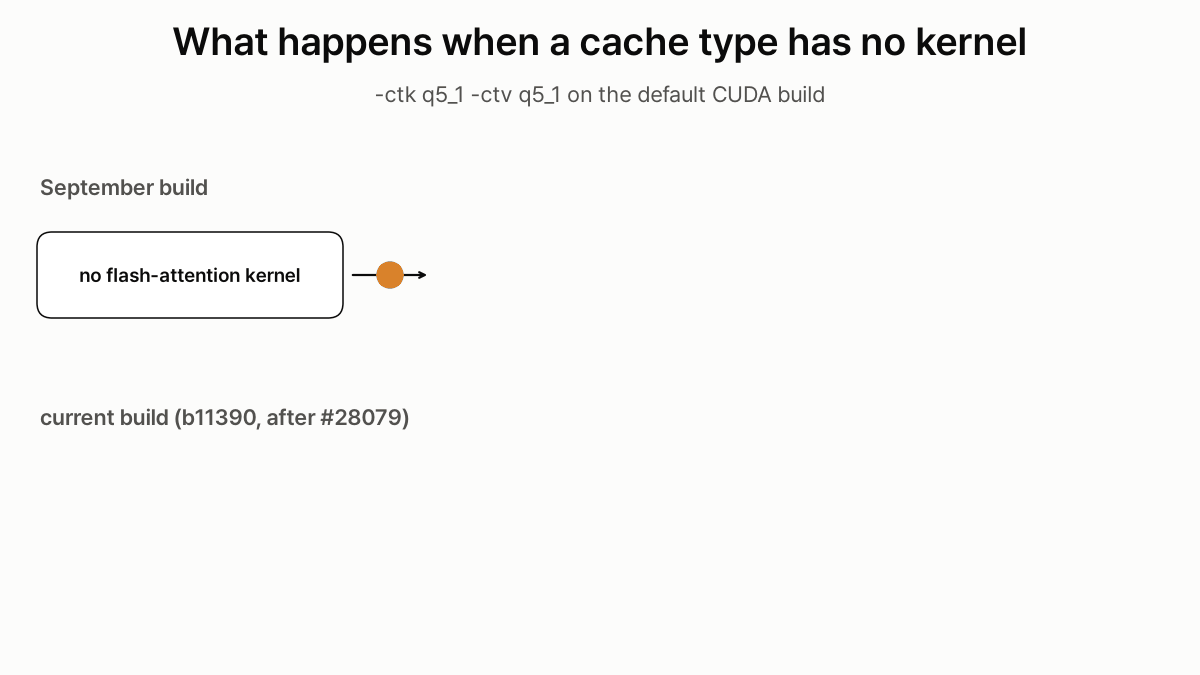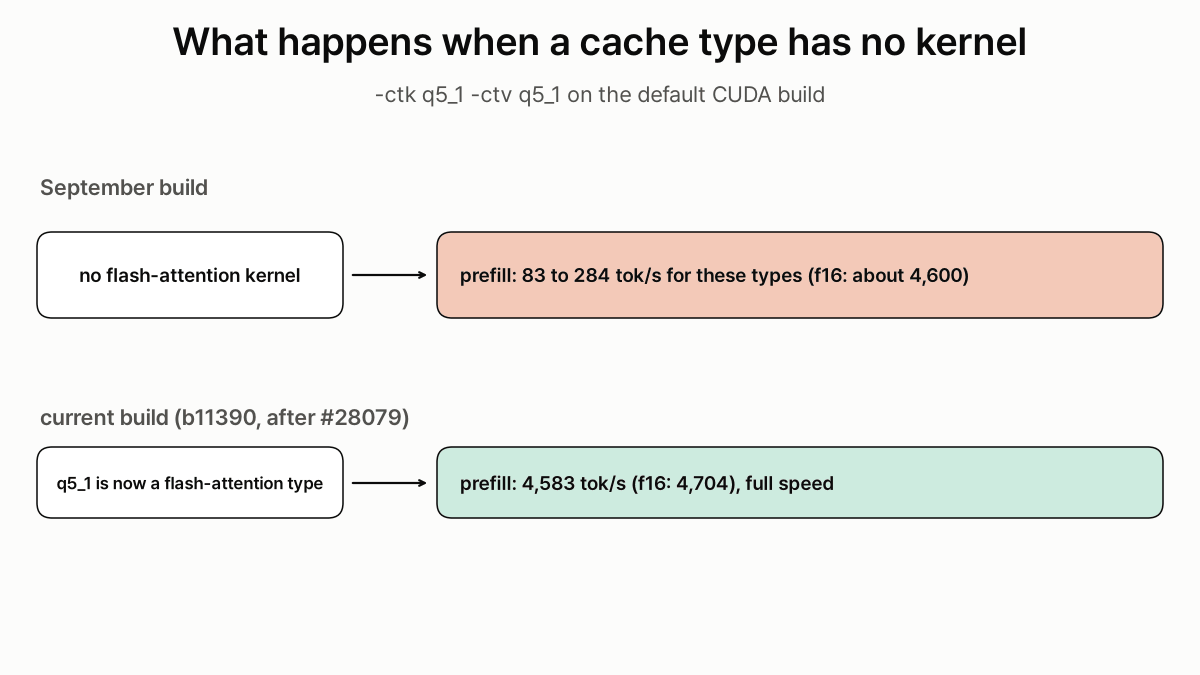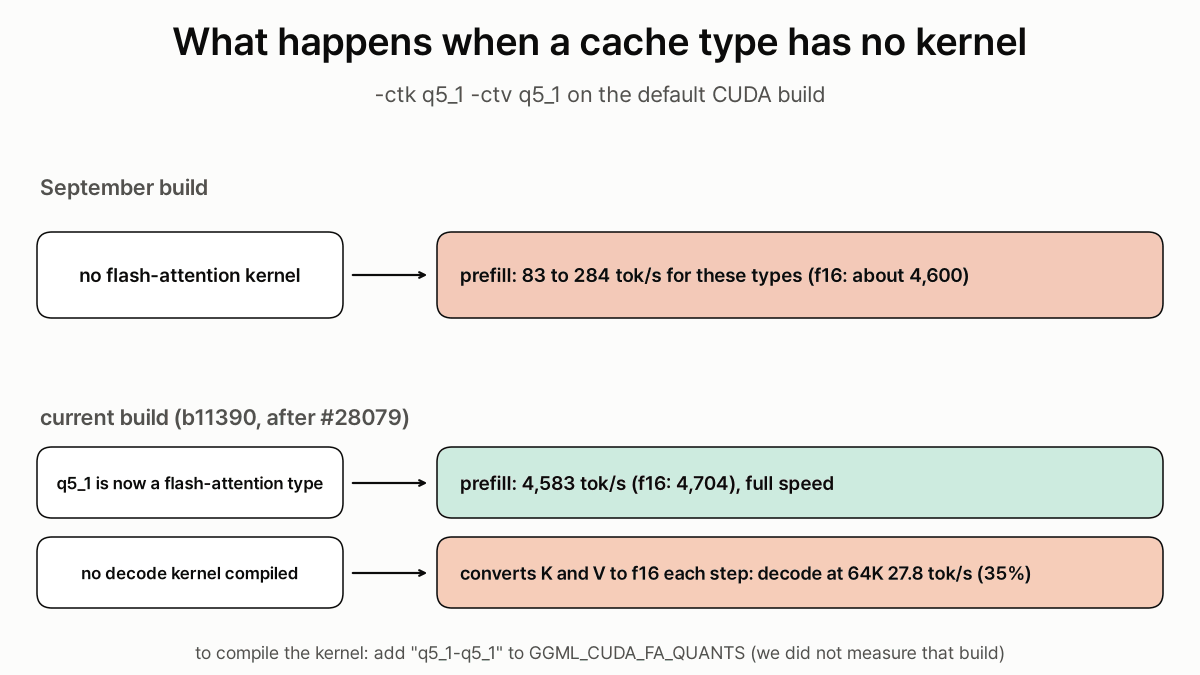
그래서 q5_1과 q8_0 / q4_0 혼합은 이제 프리필이 제 속도로 돕니다. llama-server에 짧은 시험 요청을 하나씩 보냈을 때 둘 다 정상적인 답을 냈지만, 품질은 재지 않았습니다. 그래도 기본 빌드에서는 손해 보는 선택입니다. q5_1은 64K에서 f16의 35%로 q4_0보다 느리면서, 메모리는 q4_0보다 더 씁니다. 혼합 조합은 속도가 그 사이이고, 아끼는 메모리는 q4_0보다 적습니다. bf16도 함정입니다. 메모리는 f16과 똑같이 쓰면서 64K에서 디코드가 f16의 52%라, 이 그래픽카드에서는 얻는 것이 없습니다.
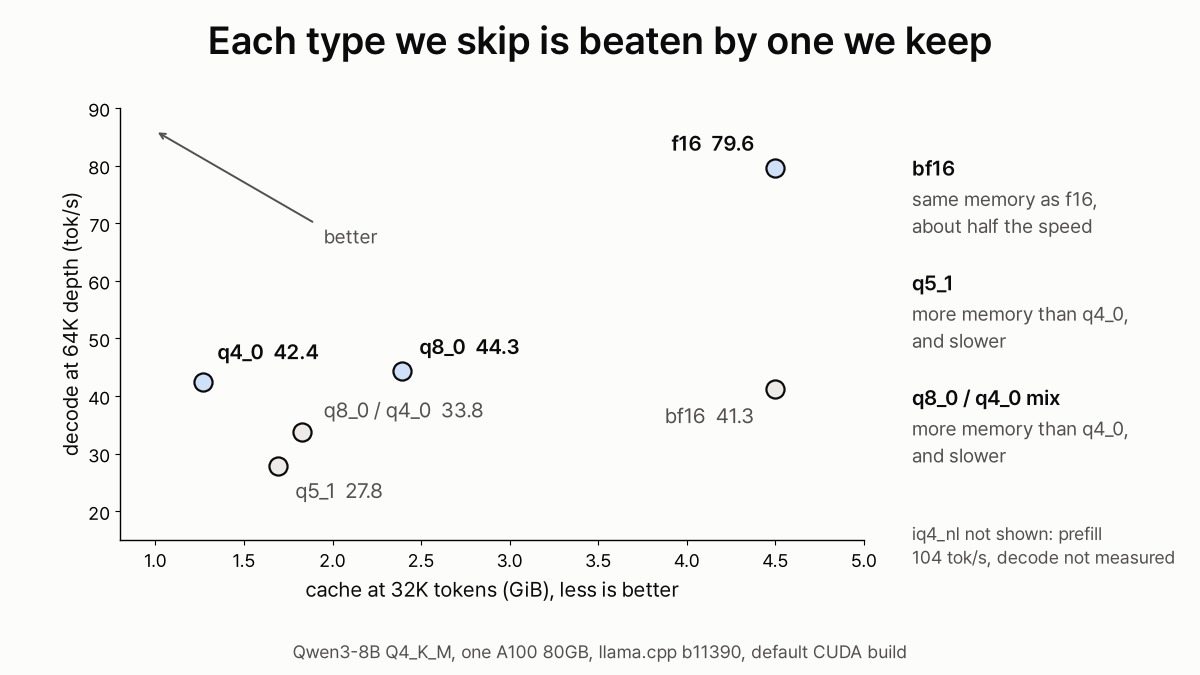
여전히 쓸 수 없는 타입은 iq4_nl 하나입니다. 플래시 어텐션 지원 목록에 아예 없고, 프리필이 초당 104토큰이었습니다.
그 뒤 빌드 b12274에서 f8_e4m3 타입이 새로 들어왔습니다. 같은 A100에서 재 보니 캐시는 q8_0보다 6% 작았지만, 출력이 f16에서 벗어난 정도는 q8_0의 약 8-10배였고 32K에서 디코드가 12-13% 느렸습니다. 자세한 결과는 llama.cpp 새 FP8 KV 캐시, q8_0에서 바꿔야 할까에 정리했습니다.
q5_1이나 혼합 조합을 꼭 써야 한다면, 그 조합의 디코드 커널을 넣어서 빌드하면 됩니다. -DGGML_CUDA_FA_QUANTS="q8_0-q8_0;q4_0-q4_0;f16-f16;bf16-bf16;q5_1-q5_1"처럼 목록에 더하거나, 빌드 시간이 훨씬 길어지는 것을 감수하고 all을 줍니다. 예전 옵션 GGML_CUDA_FA_ALL_QUANTS는 이제 all의 별칭으로만 남아 있습니다. 현재 커밋에서 커널을 더 넣은 빌드는 재지 않았습니다.
서버라면 답의 길이가 비용을 정합니다
한 요청씩 디코드하는 경우가 가장 불리합니다. 9월 빌드에서 잰 llama-server 동시 요청 실측에서는 32K 프롬프트에 q8_0을 쓰면, 요청마다 128토큰을 만들 때 전체 처리량이 9% 줄었고 1,024토큰을 만들 때 22% 줄었습니다. 답이 짧으면 요청 시간 대부분이 프리필이고, 양자화는 프리필을 거의 건드리지 않기 때문입니다. 프롬프트에 비해 답이 긴 서비스라면, 실제 비율로 직접 재 보셔야 합니다.
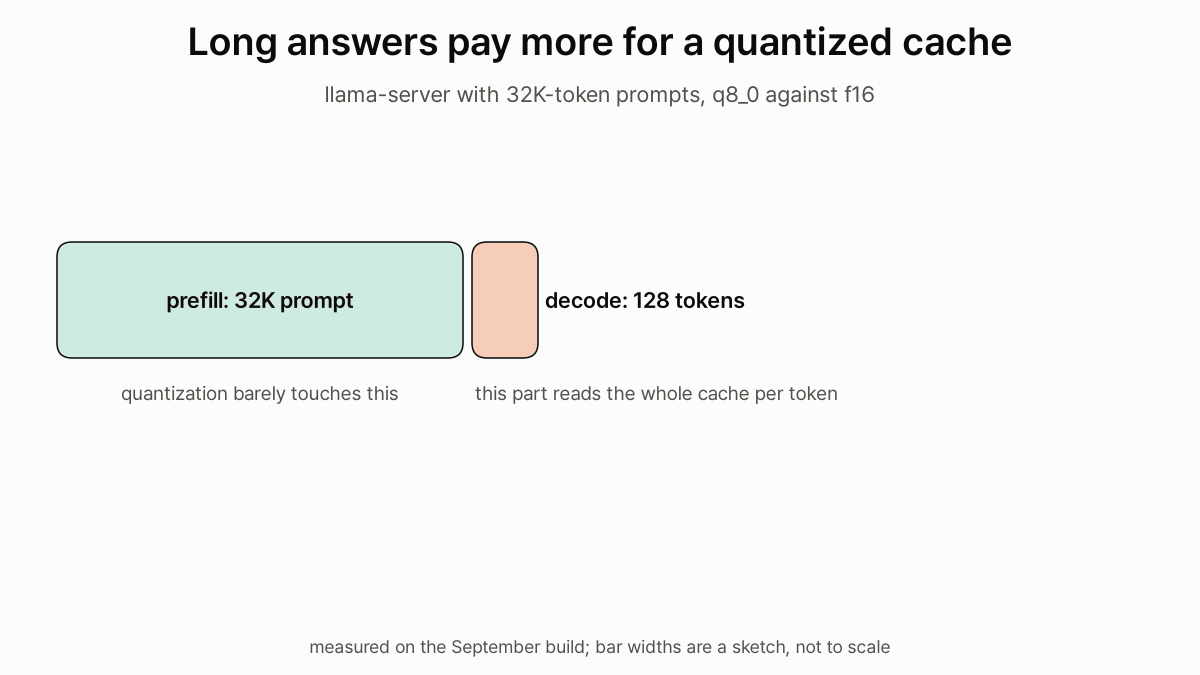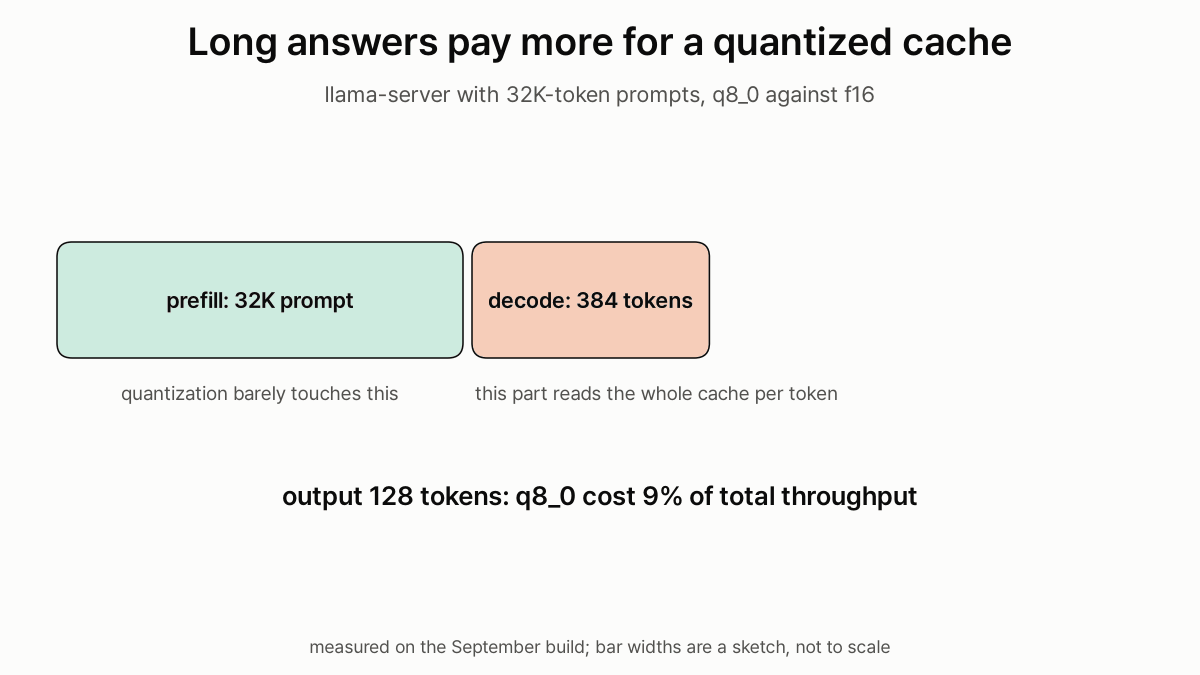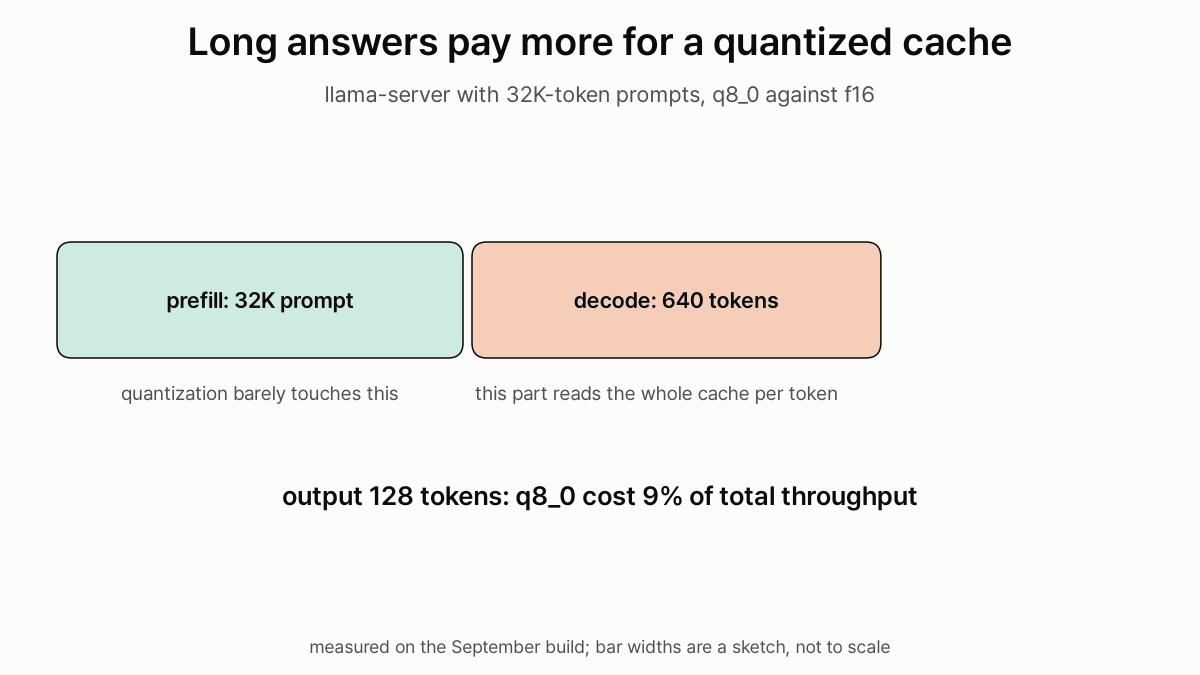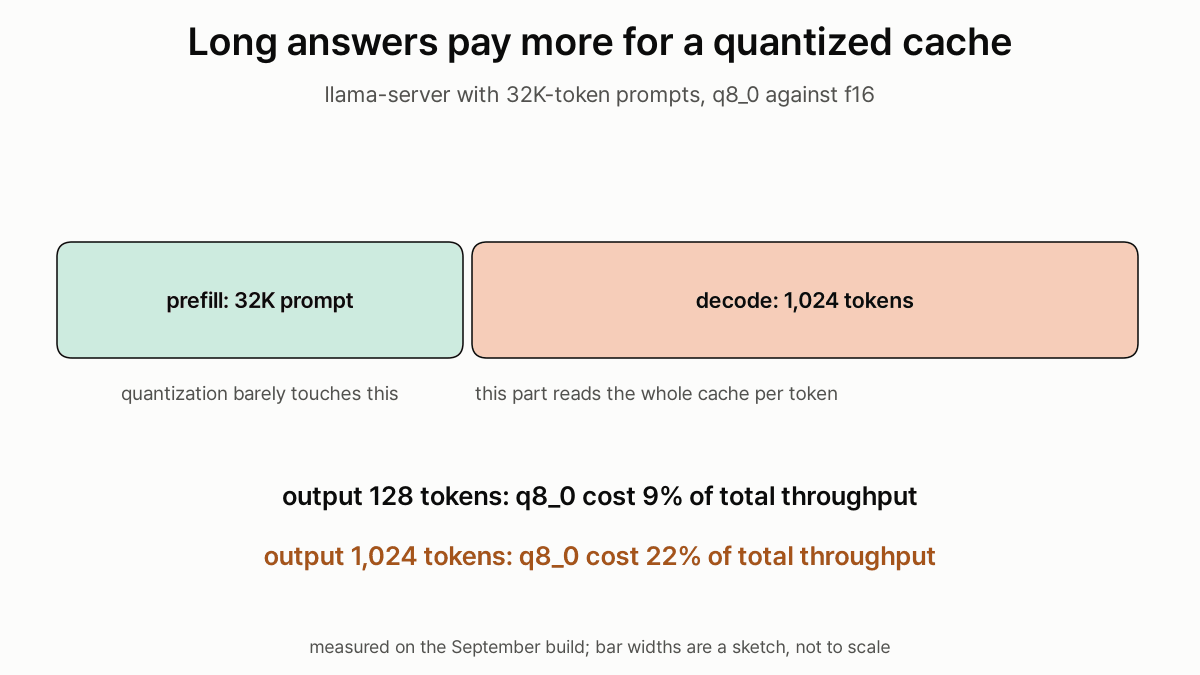
내 그래픽카드에서 잰 숫자를 믿기 전에
- GPU에 다른 프로세스가 없는지 확인합니다.
nvidia-smi --query-compute-apps=pid,used_memory --format=csv로 봅니다. 9월 첫 측정에서f16프리필이 초당 4,707이 아니라 1,976으로 나왔습니다. 멈춘 줄 알았던 측정이 같은 그래픽카드를 쓰고 있었기 때문입니다. - 실제로 쓸 문맥 길이에서 잽니다. 캐시가 비어 있을 때는 동작하는 타입이 모두 비슷해 보입니다. llama-bench에
-d 32768이나 실제 문맥 길이를 넣으세요. - 속도만 보지 말고 로그를 봅니다.
converting K and V to f16줄이, 그 조합이 컴파일된 커널 밖으로 밀려났다는 유일한 표시입니다.
내 모델의 캐시는 얼마나 클까
토큰 하나당 캐시 크기는 층 수 × KV 헤드 수 × 헤드 차원 × 2(K와 V) × 값당 바이트입니다. Qwen3-8B는 36층에 KV 헤드 8개, 헤드 차원 128이라 f16으로 토큰당 144KiB, 32K면 4.5GiB입니다. q8_0은 값당 8.5비트, q4_0은 4.5비트를 씁니다. KV 헤드가 더 많은 모델은 캐시도 그만큼 커지고, 깊은 문맥에서 느려지는 폭도 클 가능성이 있습니다. 다만 저희는 이 모델 하나만 쟀습니다. 다른 모델에 쓰는 공식과 계산 스크립트는 KV 캐시 해설에 있습니다.
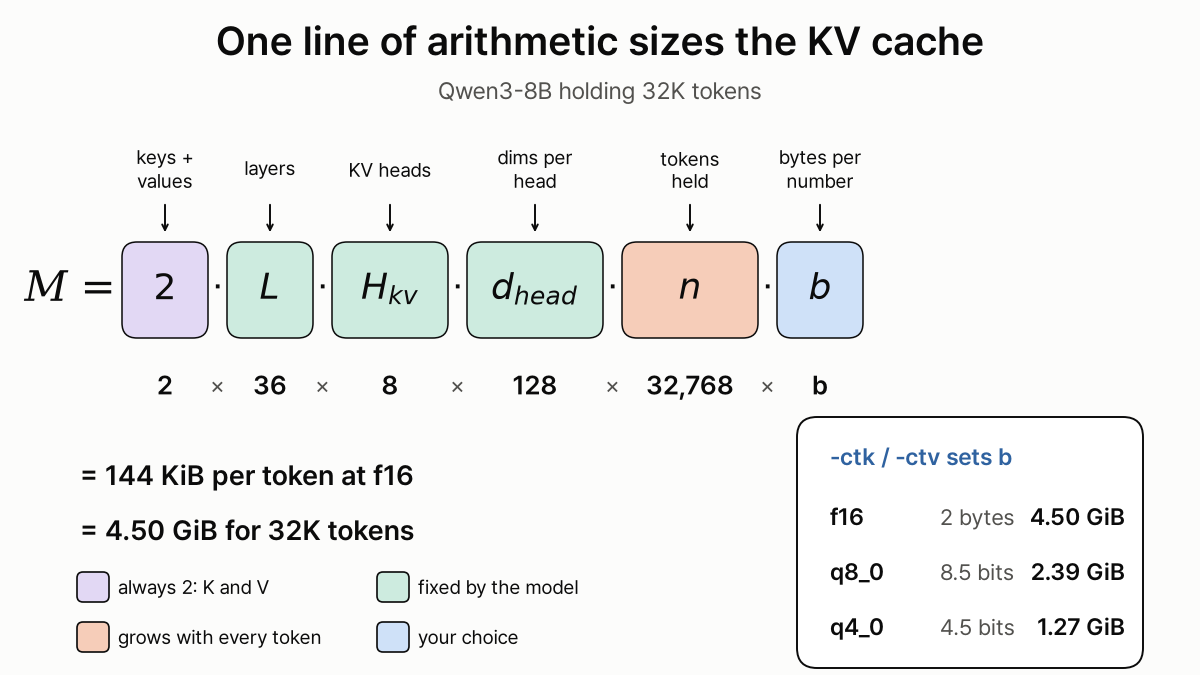
이 공식은 모든 레이어가 KV 헤드마다 K와 V를 전부 저장한다고 가정합니다. 최근 모델들은 이 가정을 저마다 다른 방식으로 깨는데, 그중 여섯 개를 직접 잰 결과를 맥락은 네 배인데 캐시는 더 적게에 정리했습니다.
이 결과의 한계
모델 하나, 가중치 양자화 하나, A100 한 장이고, 속도 표는 배치 크기 1입니다. 퍼플렉서티와 서버 숫자는 현재 빌드가 아니라 9월 빌드에서 잰 것입니다. 64K 디코드 수치는 설정마다 한 번씩 잰 값입니다. llama.cpp는 매주 바뀌고, 9월 9일 변경처럼 이런 표는 한 달이면 낡을 수 있습니다. 언제 어느 커밋에서 잰 것인지 아래에 적어 두었습니다.
전체 표는 이 글의 바탕이 된 세 편에 있습니다. 한 요청 기준 속도·메모리·퍼플렉서티, llama-server 동시 요청, 9월 빌드에서 -ctk 값 전부입니다. 측정 스크립트는 무료 KV 캐시 벤치마크 하네스에 들어 있습니다.
현재 빌드 측정: llama.cpp b11390 (dd26678)(ggml-org master, 2026년 10월 4일), sm80용 CUDA 빌드, 기본 옵션(GGML_CUDA_FA_QUANTS=q4_0-q4_0;q8_0-q8_0;f16-f16;bf16-bf16), Qwen3-8B Q4_K_M, A100 80GB PCIe 한 장, -fa on -ngl 99. 프리필은 -p 4096 -n 128 -d 0 -d 8192 -r 2, 깊이는 -p 0 -n 128 -d 32768 -d 65536 -r 1이고 VRAM은 nvidia-smi로 0.5초마다 기록했습니다. 경고 줄은 llama-server(-c 8192)에 짧은 요청 하나를 보내 확인했습니다. 스크립트 scripts/bench-kv-types-master.sh, scripts/bench-kv-depth-master.sh, 원시 JSON과 로그는 drafts/llamacpp-kv-guide/에 있습니다. 퍼플렉서티와 서버 수치는 같은 그래픽카드와 모델로 llama.cpp b10753 (69320fe)(2026년 9월 2일)에서 잰 것이며, 위에 링크한 글에서 가져왔습니다.