Jev의 속도 주장, 라벨만 필요한 분류에도 적용될까? BANKING77 기준선 실측
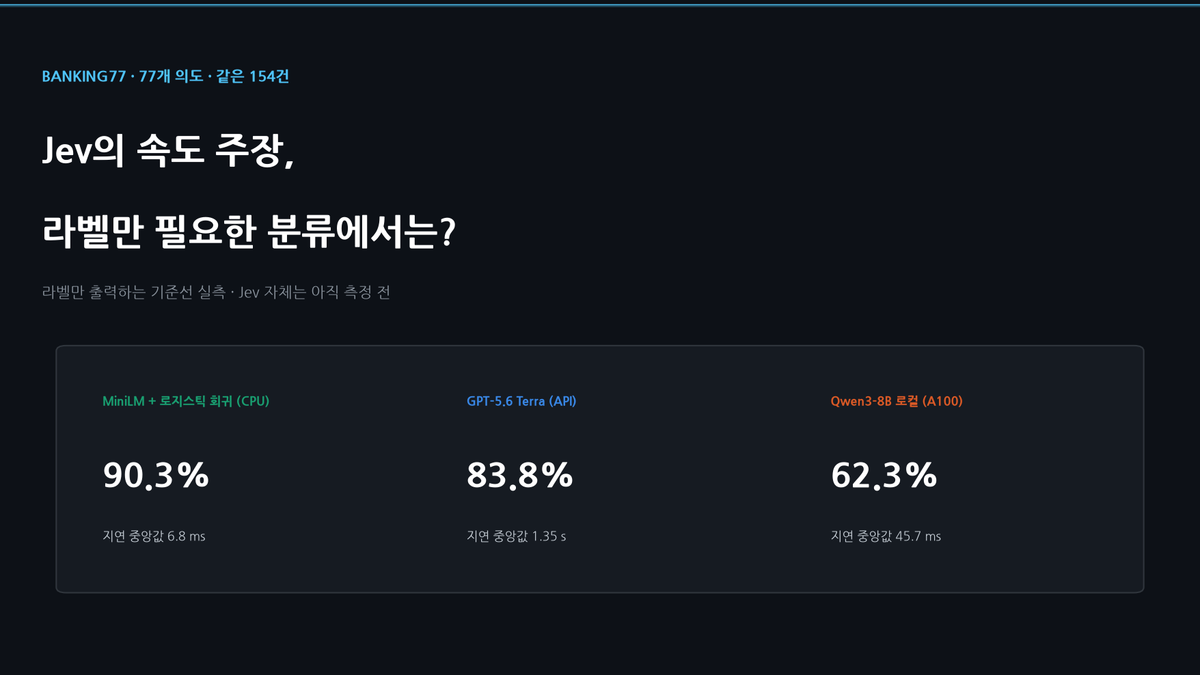
BANKING77 테스트셋에서 라벨만 출력하는 네 가지 분류 방식을 같은 메시지 154건으로 비교했습니다. MiniLM 임베딩과 로지스틱 회귀는 CPU에서 정확도 90.3%, 지연 중앙값 6.8ms를 기록했습니다. Jev 자체는 아직 측정하지 않았습니다.
Jev의 속도 주장, 라벨만 필요한 분류에도 적용될까? BANKING77 기준선 실측
TypeSafe AI가 9월 15일에 Jev를 공개했습니다. 문장을 쓰지 않는 모델입니다. 구조화된 질문과 고정된 선택지를 주면 그중 하나를 골라 확률과 함께 돌려줍니다. 공개 발표는 Jev의 응답 시간을 70~500ms로 적었고, 프런티어 모델의 응답 시간 3~329초는 외부 LLM 벤치마크를 인용했습니다.
확률을 요청한 비교는 발표의 워크플로 평가 쪽에 있습니다. TypeSafe는 워크플로 평가에서 다른 모델들을 전용 래퍼로 감싸 Jev API와 같은 형식의 구조화 판단을 내게 했습니다. 그리고 이 방식이 확률 없이 판단만 받을 때보다 느리고 비싼 편이라고 적었습니다.
이번 글은 라벨만 필요한 분류를 대상으로 합니다. 사람이 정답을 단 공개 데이터셋에서 라벨을 얻는 방법 네 가지를 쟀습니다. 이번에는 GPT-5.6 Terra와 GPT-6 Astra를 측정했습니다. TypeSafe의 워크플로 평가에는 OpenAI의 'Terra'가 비교 대상으로, Astra가 평가 정답을 만드는 모델 중 하나로 등장합니다. 평가표의 Terra는 정확한 버전이 명시되어 있지 않습니다. Jev는 대기자 명단에 올려 둔 상태라 아직 표에 없습니다.
| 방식 | 과제별 추가 학습 예시 | 정확도(154건) | 지연 중앙값 | 장비 |
|---|---|---|---|---|
| 사전학습 MiniLM 임베딩 + 로지스틱 회귀 | 10,003건 | 90.3% (139건) | 6.8ms | CPU (AMD EPYC 7742) |
| GPT-5.6 Terra, 라벨만 요청 | 없음 | 83.8% (129건) | 1,351ms | OpenAI API |
| GPT-6 Astra, 라벨만 요청 | 없음 | 83.1% (128건) | 2,163ms | OpenAI API |
| Qwen3-8B Q4_K_M, 문법 제약 | 없음 | 62.3% (96건) | 45.7ms | A100 80GB 1장 |
| Jev | — | 아직 측정 전 | — | — |
가장 분명한 결과는 첫 줄입니다. 라벨이 고정된 이 과제에서는 학습 데이터를 활용한 작은 분류기가 가장 빠르고 가장 정확했습니다. 두 프런티어 모델보다 정확도가 6~7%p 높았고, 지연 중앙값은 200~300분의 1이었습니다. 대신 이 방식만 라벨 달린 학습 데이터가 필요했습니다.
과제와 측정 조건
BANKING77(PolyAI, CC-BY-4.0)의 테스트셋은 은행 고객 문의 3,080건이고, 사람이 건마다 77개 의도 중 하나를 붙였습니다. 의도마다 정확히 40건씩 있습니다. 학습 세트는 10,003건이며 분류기만 이것을 씁니다. card_arrival(카드가 언제 오는지)과 card_delivery_estimate(배송 예상 기간)처럼 뜻이 거의 겹치는 의도가 여럿 섞여 있습니다.
세 언어 모델에는 77개 라벨을 모두 적은 같은 시스템 프롬프트를 주고, 예시 없이 바로 답하게 했습니다. 출력은 유효한 라벨 하나로 제한했습니다. OpenAI 모델은 구조화 출력의 열거형으로, 로컬 모델은 문법(grammar)으로 막았습니다. 응답 462건 가운데 형식이 틀리거나 빈 응답은 없었습니다.
API 호출에는 비용이 들어서, 모든 방식을 같은 표본 154건(의도마다 2건)으로 쟀습니다. 표본이 전체를 대표하는지 보려고 로컬 모델과 분류기는 3,080건 전체로도 돌렸습니다. 로컬 모델은 표본 62.3%, 전체 63.5%였고, 분류기는 표본 90.3%, 전체 93.0%였습니다.
부하 조건은 방식마다 달랐습니다. API 모델은 동시 요청 8개로 보냈고, 로컬 모델은 한 번에 한 요청씩 처리했습니다. 분류기도 CPU에서 메시지를 하나씩 임베딩했습니다. 표의 지연은 이 조건에서 메시지 한 건에 걸린 시간입니다.
두 프런티어 모델에 라벨만 요청했을 때
두 OpenAI 모델 모두 Responses API로 호출했고, 추론 강도는 low로 맞췄습니다. GPT-6 Astra가 받는 가장 낮은 값입니다.
- GPT-6 Astra: 154건 중 128건 정답, 지연 중앙값 2,163ms, p95 3,950ms, 1,000건당 9.81달러
- GPT-5.6 Terra: 154건 중 129건 정답, 지연 중앙값 1,351ms, p95 2,666ms, 1,000건당 2.02달러
같은 메시지끼리 맞대 보면 둘 다 맞힌 것이 125건, 둘 다 틀린 것이 22건이었습니다. Astra만 맞힌 것은 3건, Terra만 맞힌 것은 4건입니다. 관측 정확도는 비슷했고, 154건 중 한 건 차이로는 어느 쪽이 이 과제에 더 나은지 말할 수 없습니다. 메시지당 비용은 Terra가 Astra의 약 5분의 1이었습니다.
두 모델 모두 메시지당 추론 토큰을 6~7개만 썼기 때문에 비용은 거의 다 입력에서 나왔습니다. 요청당 입력은 864~938토큰, 평균 873토큰입니다. 77개 라벨이 프롬프트에 한 번, 출력 스키마에 또 한 번 들어가기 때문입니다. 두 실행 모두 캐시된 입력 토큰은 0이었습니다. 가격은 OpenAI 모델 문서(GPT-6 Astra, GPT-5.6 Terra, 2026-09-18 확인) 기준으로, 100만 토큰당 Astra가 입력 10달러·출력 50달러, Terra가 입력 2달러·출력 12달러입니다.
라벨만 요청한 이번 측정에서도 중앙값은 1.4~2.2초였습니다. 이 시간에는 측정 장비에서 OpenAI까지 오가는 네트워크 시간이 들어 있습니다. API와 가까운 곳에 배포한 서비스라면 이 시간이 더 짧을 수 있습니다.
문법 제약을 건 로컬 모델
Qwen3-8B(Q4_K_M)를 llama.cpp로 A100 한 장에 올리고, 77개 라벨만 출력할 수 있도록 문법을 걸었습니다. 라벨 목록은 요청 사이에 캐시되므로 요청마다 새로 처리하는 것은 메시지 부분, 20토큰 안팎입니다. 한 번에 한 요청씩 보냈을 때 지연 중앙값은 45.7ms, p95는 73.5ms였습니다.
정확도는 62.3%로, 같은 메시지에서 프런티어 모델보다 약 20%p 낮았습니다. 호출마다 내는 API 요금은 없지만 비용이 없는 것은 아닙니다. GPU 장비와 이를 운영할 사람이 필요합니다.
사전학습 임베딩 위의 분류기
사전학습된 문장 임베딩 모델 all-MiniLM-L6-v2(파라미터 약 2,200만 개)는 손대지 않고 그대로 썼습니다. 학습한 것은 그 임베딩 위에 얹은 로지스틱 회귀뿐이고, BANKING77의 학습용 메시지 10,003건을 썼습니다. 학습 데이터의 임베딩 추출과 회귀 모델 학습을 합쳐 약 12초가 걸렸습니다. 장비는 AMD EPYC 7742이고, 스레드는 64개를 썼습니다.
같은 CPU에서 GPU 없이 지연 중앙값 6.8ms, p95 11.4ms로 분류했습니다. 정확도는 표본에서 90.3%, 전체 테스트셋에서 93.0%입니다.
제로샷 방식과 같은 조건의 대결은 아닙니다. 이 분류기는 라벨 달린 예시 1만 건으로 배웠고, 나머지 셋은 하나도 보지 않았습니다. 이번 표본에서는 학습 분류기가 세 제로샷 방식보다 높은 정확도를 보였습니다. 라벨 목록이 고정되어 있고 라벨 달린 데이터가 있는 팀이라면 적은 비용으로 먼저 해 볼 만한 방법입니다.
라벨 1만 건이 무엇을 가르쳤는지는 메시지 하나로 볼 수 있습니다. "When should I expect my card?"(카드를 언제 받을 수 있나요?)의 정답 라벨은 card_delivery_estimate입니다. 두 GPT 모델은 모두 card_arrival을 골랐는데, 라벨 이름만 보면 그쪽도 충분히 그럴듯합니다. 학습 세트는 이 경계를 문장 표현으로 긋습니다. 분류기가 쓰는 임베딩 공간에서 이 메시지와 가장 가까운 학습 메시지 10건이 모두 card_delivery_estimate이고, 가장 가까운 것은 "When can I expect my card?"(코사인 유사도 0.96)입니다. 반면 "When will my new card arrive?"는 card_arrival로 분류되어 있습니다. 분류기는 라벨을 단 사람들이 두 의도를 어디서 나눴는지 배웠고, 제로샷 모델에게는 라벨 이름 두 개뿐이었습니다. 표본에서 분류기만 맞히고 두 GPT 모델이 모두 틀린 메시지는 이것을 포함해 12건입니다(메시지별 결과를 남기려고 분류기를 다시 돌린 실행 기준). 뜻이 겹치는 라벨이 섞인 과제에서는 정확도가 라벨을 단 사람들의 구분 방식과 얼마나 일치하는지도 함께 잽니다. 라벨 달린 예시가 가르치는 것이 바로 그 부분입니다.
Jev가 공개한 수치와 이번 측정의 범위
TypeSafe는 자체 워크플로 평가를 공개했습니다. 보안 사고, 에이전트 실행 기록 관측, 청구서 처리, 고객 상담 네 가지 워크플로를 합친 집계 화면에서 Jev는 정확도 67.8%, 건당 0.4초, 건당 0.0004달러입니다. 같은 화면에서 Terra(workflow)는 67.9%, 10.1초, 0.0304달러입니다(2026-09-19 확인). 해당 평가의 참조 정답에 대한 집계 점수가 67.8%와 67.9%로 비슷하다는 뜻이며, 사람 정답 기준으로 성능이 같다거나 통계적으로 동등하다는 뜻은 아닙니다. 다만 여기서 정답은 사람이 단 라벨이 아닙니다. TypeSafe 설명으로는 GPT-6 Astra와 Claude Fable 5.1에 높은 추론 강도로 받은 응답을 평균한 기준입니다.
그 수치와 이 글의 수치는 서로 비교할 수 없습니다. 과제가 다르고, 한쪽은 사람의 라벨로, 다른 쪽은 두 프런티어 모델의 응답으로 채점했습니다. TypeSafe는 자체 워크플로 평가를 공개했지만, BANKING77에서의 Jev 정확도와 지연은 이번 실험에서 확인하지 못했습니다. 접근 권한을 받으면 같은 154건과 같은 프롬프트로 돌려 표의 빈 줄을 채우겠습니다.
Jev는 보정된 확률을 제공한다고 설명합니다. 이번 비교에서는 어떤 방식에 대해서도 확률의 보정 품질을 평가하지 않았습니다. 로지스틱 회귀도 확률을 내놓습니다. 그 확률이 얼마나 잘 맞는지는 따로 재야 하는 문제입니다.
라벨만 필요할 때 무엇을 쓸까
- 라벨 목록이 고정되어 있고 라벨 달린 예시가 있다면: 사전학습 임베딩 위의 분류기부터 해 봅니다. 이번 과제에서는 가장 정확하고 가장 빨랐으며, CPU로 충분했습니다.
- 라벨 달린 데이터가 없고 지연보다 정확도가 중요하다면: 라벨만 요청하는 프런티어 모델입니다. 이번 과제에서 Terra와 Astra는 한 건 차이였고, Terra가 5분의 1 가격이었습니다.
- 라벨 달린 데이터가 없고 지연이 중요하며 GPU를 운영할 수 있다면: 문법 제약을 건 로컬 모델입니다. 다만 먼저 자기 라벨로 정확도를 재 봐야 합니다. 이번 과제에서는 약 20%p 모자랐습니다.
이 결과로 말할 수 없는 것
데이터셋은 하나이고 영어이며, 뜻이 겹치는 의도가 섞인 77개 세부 분류입니다. 라벨 구성이 다른 과제에서는 순위가 달라질 수 있습니다. API 결과는 154건으로 한 번씩만 돌렸습니다. 방식마다 동시 요청 수가 달랐다는 점은 앞에서 적었습니다. 로컬 모델은 여러 요청을 묶어 처리하는 설정을 조정하지 않았습니다. 그리고 Jev는 아직 재지 못했습니다.
Jev 측정 결과를 받아보려면 아래에서 구독해 주세요.
측정 환경: BANKING77 테스트셋(PolyAI, CC-BY-4.0)에서 의도마다 2건씩 뽑은 154건(시드 20260918). 세 언어 모델은 같은 시스템 프롬프트로 예시 없이 답했습니다. OpenAI: Responses API, 라벨 열거형 구조화 출력, 추론 강도 low, 동시 요청 8개. 로컬: Qwen3-8B Q4_K_M, llama.cpp 69320fe, A100 80GB, 문법 제약, cache_prompt 사용, 동시 요청 1개. 분류기: 사전학습 all-MiniLM-L6-v2 임베딩 + scikit-learn 로지스틱 회귀(C=10), AMD EPYC 7742, 스레드 64개. 측정일 2026-09-18.
이 블로그의 텍스트 분류 실측을 쓰는 순서대로 한 페이지에 엮었습니다: 분류기, LLM, 판단 모델 중 무엇을 쓸까.
같은 측정을 당신 모델로 받아 보시겠습니까
모델과 조건을 알려 주시면 측정 조건표 초안과 견적을 1영업일 안에 무료로 보내 드립니다. 값은 후보 수와 과제 수에 따라 정합니다. 기본 장비는 A100 80GB이고 다른 GPU도 가능합니다.