Qwen 3.5 파인튜닝 실전 가이드 — LoRA로 나만의 모델 만들기
Qwen 3.5를 LoRA/QLoRA로 파인튜닝하는 전 과정을 다룹니다. 8GB GPU에서도 가능한 QLoRA 설정부터 Unsloth 최적화, GGUF 변환, Ollama 배포까지.
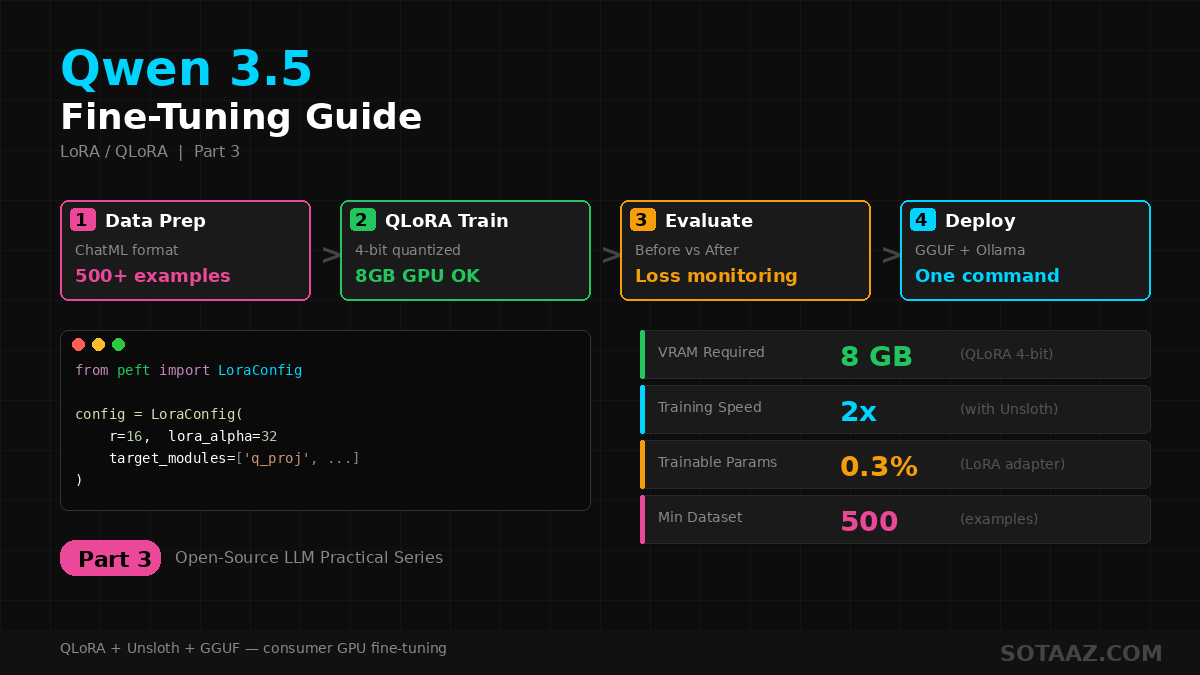
Qwen 3.5 파인튜닝 실전 가이드 — LoRA로 나만의 모델 만들기
이전 글에서 Qwen 3.5를 로컬에 설치하고 실행하는 방법을 다뤘습니다. 이번에는 한 단계 더 나아가서, 자신만의 데이터로 모델을 파인튜닝하는 방법을 다룹니다.
LoRA/QLoRA를 사용하면 소비자 GPU에서도 Qwen 3.5를 파인튜닝할 수 있습니다. 데이터 준비부터 학습, 평가, 배포까지 전 과정을 단계별로 정리했습니다.
1. 파인튜닝이 필요한 이유
Qwen 3.5는 범용 모델입니다. 대부분의 작업에서 잘 동작하지만, 다음과 같은 경우에는 파인튜닝이 필요합니다:
- 특정 도메인 전문성: 의료, 법률, 금융 등 전문 용어와 지식이 필요한 경우
- 일관된 출력 형식: JSON, 특정 템플릿 등 정해진 형식으로 답변해야 하는 경우
- 브랜드 톤/스타일: 자사 서비스에 맞는 말투와 스타일이 필요한 경우
- 특정 언어 강화: 한국어 등 특정 언어의 품질을 더 높이고 싶은 경우
- 비용 절감: 큰 모델 대신 작은 모델을 파인튜닝해서 동일한 성능을 내고 싶은 경우
Full Fine-Tuning vs LoRA
| 방법 | VRAM 요구 | 학습 속도 | 품질 | 추천 |
|---|---|---|---|---|
| Full Fine-Tuning | 매우 높음 (모든 파라미터 업데이트) | 느림 | 최고 | 서버급 GPU |
| LoRA | 보통 | 빠름 | 높음 | 24GB GPU |
| QLoRA | 낮음 (4bit 양자화) | 빠름 | 좋음 | 8GB GPU |
이 가이드에서는 QLoRA를 중심으로 설명합니다. 8GB GPU에서도 Qwen 3.5를 파인튜닝할 수 있는 가장 실용적인 방법입니다.
2. 하드웨어별 추천 모델
| GPU VRAM | 추천 모델 | 방법 | 예상 학습 시간 (1K 샘플) |
|---|---|---|---|
| 8GB | Qwen3.5-4B | QLoRA (4bit) | ~30분 |
| 12GB | Qwen3.5-9B | QLoRA (4bit) | ~45분 |
| 24GB | Qwen3.5-9B | LoRA (bf16) | ~30분 |
| 24GB | Qwen3.5-27B | QLoRA (4bit) | ~2시간 |
| 48GB+ | Qwen3.5-35B-A3B | LoRA (bf16) | ~1시간 |
핵심: 9B + QLoRA + 12GB GPU가 가장 현실적인 조합입니다.
3. 환경 설정
3-1. 필수 패키지 설치
pip install torch transformers accelerate
pip install peft trl datasets
pip install bitsandbytes  # QLoRA 양자화용
3-2. Unsloth 설치 (선택, 2배 빠른 학습)
Unsloth는 LoRA 학습 속도를 2배까지 높여주고 VRAM도 절약해주는 최적화 라이브러리입니다.
pip install unsloth4. 데이터 준비
파인튜닝의 성패는 데이터 품질에 달려 있습니다.
4-1. 데이터 형식
Qwen 3.5는 ChatML 형식을 사용합니다:
[
  {
    "messages": [
      {"role": "system", "content": "You are a helpful medical assistant."},
      {"role": "user", "content": "두통이 3일째 계속됩니다. 어떻게 해야 하나요?"},
      {"role": "assistant", "content": "3일 이상 지속되는 두통은 여러 원인이 있을 수 있습니다..."}
    ]
  },
  {
    "messages": [
      {"role": "user", "content": "혈압약을 먹고 있는데 자몽을 먹어도 되나요?"},
      {"role": "assistant", "content": "자몽은 일부 혈압약과 상호작용할 수 있습니다..."}
    ]
  }
]
4-2. 데이터 품질 체크리스트
- 최소 500개 이상의 예시 (1,000~5,000개 권장)
- 답변 길이가 일정한 범위 내에 있는지 확인
- 중복 제거: 동일하거나 거의 같은 예시 제거
- 형식 일관성: 모든 예시가 동일한 구조를 따르는지 확인
- 오류 검증: 잘못된 정보나 문법 오류가 없는지 확인
4-3. 데이터 로드
from datasets import load_dataset

# JSON 파일에서 로드
dataset = load_dataset("json", data_files="train_data.json", split="train")

# 또는 HuggingFace Hub에서 로드
# dataset = load_dataset("your-username/your-dataset", split="train")

# 학습/검증 분할
split = dataset.train_test_split(test_size=0.1, seed=42)
train_dataset = split["train"]
eval_dataset = split["test"]

print(f"Train: {len(train_dataset)}, Eval: {len(eval_dataset)}")
5. QLoRA 파인튜닝 (HuggingFace PEFT + TRL)
5-1. 모델 로드 (4bit 양자화)
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

model_name = "Qwen/Qwen3.5-9B"

# 4bit 양자화 설정 (QLoRA)
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True,
)

tokenizer = AutoTokenizer.from_pretrained(model_name)
tokenizer.pad_token = tokenizer.eos_token

model = AutoModelForCausalLM.from_pretrained(
    model_name,
    quantization_config=bnb_config,
    device_map="auto",
    attn_implementation="flash_attention_2",  # 속도 향상
)
5-2. LoRA 설정
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training

model = prepare_model_for_kbit_training(model)

lora_config = LoraConfig(
    r=16,                      # LoRA rank (8~64, 높을수록 품질↑ VRAM↑)
    lora_alpha=32,             # 보통 rank의 2배
    target_modules=[           # Qwen 3.5 어텐션 모듈
        "q_proj", "k_proj", "v_proj", "o_proj",
        "gate_proj", "up_proj", "down_proj",
    ],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
)

model = get_peft_model(model, lora_config)
model.print_trainable_parameters()
# 출력 예: trainable params: 26M || all params: 9.0B || trainable%: 0.29%
5-3. 학습 설정 및 실행
from trl import SFTTrainer, SFTConfig

training_args = SFTConfig(
    output_dir="./qwen35-finetuned",
    num_train_epochs=3,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=4,   # 실질 배치 사이즈 = 2 × 4 = 8
    learning_rate=2e-4,
    weight_decay=0.01,
    warmup_ratio=0.03,
    lr_scheduler_type="cosine",
    logging_steps=10,
    save_strategy="epoch",
    eval_strategy="epoch",
    bf16=True,
    max_seq_length=2048,
    gradient_checkpointing=True,     # VRAM 절약
    report_to="none",
)

trainer = SFTTrainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    processing_class=tokenizer,
)

trainer.train()
5-4. 모델 저장
# LoRA 어댑터만 저장 (수십 MB)
trainer.save_model("./qwen35-finetuned/final")
tokenizer.save_pretrained("./qwen35-finetuned/final")

# 전체 모델로 병합 저장 (선택)
from peft import PeftModel

merged_model = model.merge_and_unload()
merged_model.save_pretrained("./qwen35-finetuned/merged")
tokenizer.save_pretrained("./qwen35-finetuned/merged")
6. Unsloth로 2배 빠르게 학습
Unsloth는 커스텀 커널을 사용해서 LoRA 학습 속도를 2배까지 높여줍니다.
from unsloth import FastLanguageModel

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name="Qwen/Qwen3.5-9B",
    max_seq_length=2048,
    load_in_4bit=True,
)

model = FastLanguageModel.get_peft_model(
    model,
    r=16,
    lora_alpha=32,
    target_modules=[
        "q_proj", "k_proj", "v_proj", "o_proj",
        "gate_proj", "up_proj", "down_proj",
    ],
    lora_dropout=0.05,
)
나머지 학습 코드는 위의 SFTTrainer와 동일합니다. Unsloth가 내부적으로 최적화를 적용합니다.
Unsloth vs 기본 PEFT
| 항목 | 기본 PEFT | Unsloth |
|---|---|---|
| 학습 속도 | 1x | ~2x |
| VRAM 사용 | 기본 | ~40% 절약 |
| 설치 | pip install peft | pip install unsloth |
| 호환성 | 전 모델 | 주요 모델 지원 |
7. 파인튜닝된 모델 테스트
7-1. 추론 테스트
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

# 베이스 모델 + LoRA 어댑터 로드
base_model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen3.5-9B",
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
model = PeftModel.from_pretrained(base_model, "./qwen35-finetuned/final")
tokenizer = AutoTokenizer.from_pretrained("./qwen35-finetuned/final")

# 테스트
messages = [
    {"role": "user", "content": "파인튜닝 데이터에 맞는 질문을 입력하세요"}
]

text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(text, return_tensors="pt").to(model.device)

outputs = model.generate(**inputs, max_new_tokens=512, temperature=0.7, do_sample=True)
response = tokenizer.decode(outputs[0][inputs.input_ids.shape[-1]:], skip_special_tokens=True)
print(response)
7-2. 파인튜닝 전후 비교
def compare_models(question, base_model, finetuned_model, tokenizer):
    messages = [{"role": "user", "content": question}]
    text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
    inputs = tokenizer(text, return_tensors="pt").to(base_model.device)

    # 베이스 모델 답변
    base_out = base_model.generate(**inputs, max_new_tokens=256, temperature=0.7, do_sample=True)
    base_response = tokenizer.decode(base_out[0][inputs.input_ids.shape[-1]:], skip_special_tokens=True)

    # 파인튜닝 모델 답변
    ft_out = finetuned_model.generate(**inputs, max_new_tokens=256, temperature=0.7, do_sample=True)
    ft_response = tokenizer.decode(ft_out[0][inputs.input_ids.shape[-1]:], skip_special_tokens=True)

    print("=== Base Model ===")
    print(base_response)
    print("\n=== Fine-tuned Model ===")
    print(ft_response)
8. GGUF로 변환해서 Ollama에서 사용
파인튜닝한 모델을 Ollama에서 바로 사용할 수 있도록 GGUF로 변환합니다.
8-1. 병합 모델을 GGUF로 변환
# llama.cpp 설치 (이전 편 참조)
cd llama.cpp

# 모델 변환
python convert_hf_to_gguf.py ./qwen35-finetuned/merged \
  --outfile qwen35-finetuned-q4_k_m.gguf \
  --outtype q4_k_m
8-2. Ollama에 등록
# Modelfile 작성
cat > Modelfile << 'EOF'
FROM ./qwen35-finetuned-q4_k_m.gguf

TEMPLATE """{{- if .System }}<|im_start|>system
{{ .System }}<|im_end|>
{{ end }}<|im_start|>user
{{ .Prompt }}<|im_end|>
<|im_start|>assistant
"""

PARAMETER temperature 0.7
PARAMETER top_p 0.9
PARAMETER stop "<|im_end|>"
EOF

# Ollama에 등록
ollama create my-qwen35 -f Modelfile

# 실행
ollama run my-qwen35
이제 파인튜닝한 모델을 ollama run my-qwen35 한 줄로 실행할 수 있습니다.
9. 실전 팁
학습률 (Learning Rate)
- QLoRA:
2e-4~5e-4가 일반적 - LoRA (bf16):
1e-4~2e-4 - 데이터가 적을수록 (500개 미만) 학습률을 낮추세요
LoRA Rank
- r=8: 가벼운 작업 (톤/스타일 변경)
- r=16: 일반적 추천값
- r=32~64: 복잡한 도메인 지식 학습
과적합 방지
- 검증 데이터로 loss를 모니터링하세요
- 검증 loss가 올라가기 시작하면 학습을 중단하세요
lora_dropout=0.05~0.1로 설정- 데이터가 적으면 epoch 수를 줄이세요 (1~2 epoch)
MoE 모델 (35B-A3B) 파인튜닝 주의점
- MoE 모델은 라우터(router) 레이어가 있습니다
- 파인튜닝 시 라우터 레이어는 보통 고정하는 것이 안정적입니다
target_modules에 라우터 관련 모듈을 포함하지 마세요- 학습률을 Dense 모델보다 약간 낮게 설정하세요
10. 트러블슈팅
"CUDA out of memory" 에러
per_device_train_batch_size를 1로 줄이세요gradient_accumulation_steps를 늘려서 실질 배치 사이즈를 유지하세요gradient_checkpointing=True확인max_seq_length를 줄이세요 (2048 → 1024)
Loss가 줄어들지 않음
- 데이터 형식이 올바른지 확인하세요 (ChatML 형식)
- 학습률이 너무 높거나 낮지 않은지 확인하세요
- 데이터에 노이즈가 많지 않은지 확인하세요
파인튜닝 후 성능이 오히려 나빠짐
- 과적합: epoch를 줄이세요
- 데이터 품질: 데이터를 다시 검수하세요
- 학습률: 너무 높은 학습률은 기존 지식을 망가뜨립니다
마무리
Qwen 3.5 파인튜닝의 핵심을 정리합니다:
- QLoRA + 9B 모델: 12GB GPU에서 파인튜닝 가능 — 가장 실용적인 조합
- 데이터가 핵심: 500개 이상의 고품질 데이터가 모델 크기보다 중요합니다
- Unsloth: 학습 속도 2배, VRAM 40% 절약
- GGUF 변환: 파인튜닝 후 Ollama에서 바로 사용 가능
파인튜닝은 거창한 작업이 아닙니다. 좋은 데이터 500개와 8GB GPU만 있으면 시작할 수 있습니다.
이 글은 오픈소스 LLM 실전 시리즈의 Part 3입니다.
- Part 1: Qwen 3.5 vs DeepSeek V3.2 비교 분석
- Part 2: Qwen 3.5 로컬 설치 & 실행 튜토리얼
- Part 3: Qwen 3.5 파인튜닝 실전 가이드 (현재 글)
이 글에서 다룬 양자화와 서빙을 GPTQ, AWQ, GGUF, QLoRA까지 코드로 직접 다뤄보고 싶다면 LLM Quantization and Compression 강의에 24강 분량으로 정리해뒀습니다. 3강까지는 무료입니다.
이메일로 받아보기
관련 포스트
Gemma 4 MoE 파인튜닝 — 3.8B 활성 파라미터로 Arena #6 성능 커스터마이징
Gemma 4 26B MoE 모델에 QLoRA 적용. Expert 레이어 LoRA 전략, Dense 대비 비교, MoE 전용 학습 팁, Ollama 배포까지. LoRA 시리즈 Part 4.
파인튜닝 모델 평가부터 배포까지 — 실전 완결편
Perplexity, KoBEST 벤치마크로 평가하고, LoRA 가중치를 머지하고, vLLM/Ollama/HuggingFace Spaces로 배포합니다.
QLoRA + 한국어 — T4 한 장으로 7B 모델을 한국어 전문가로 만들기
QLoRA로 T4 16GB에서 7B 모델을 파인튜닝합니다. 한국어 데이터셋 구축, 학습 실행, Wandb 모니터링, Before/After 비교까지.