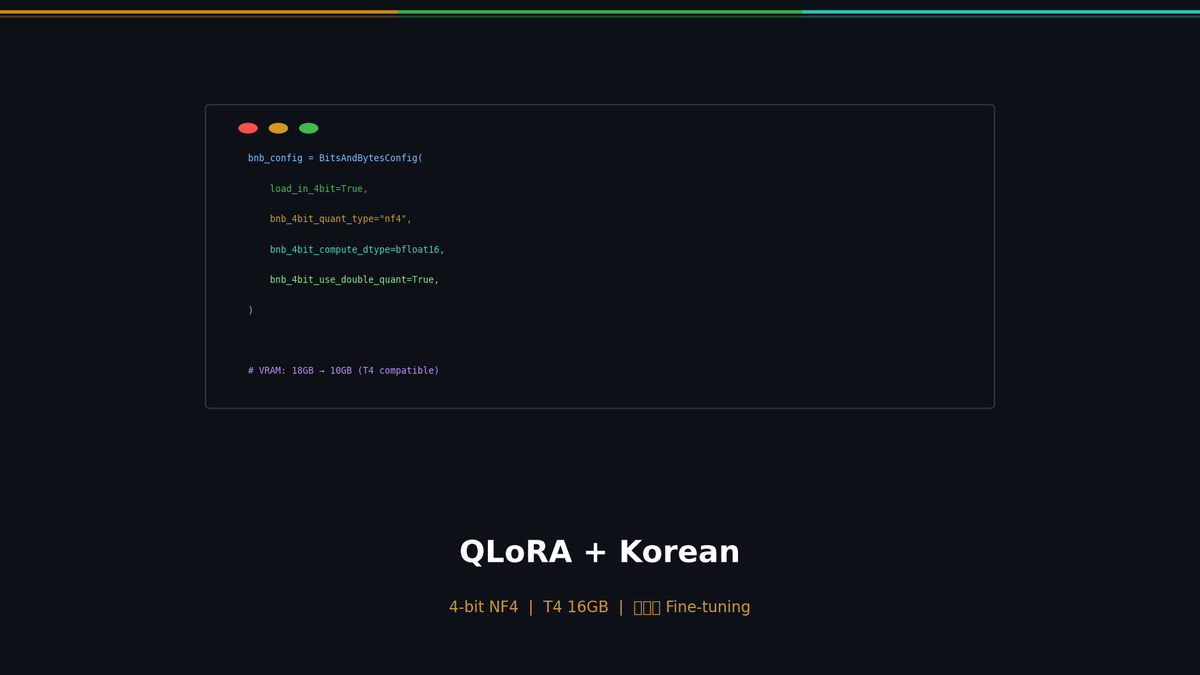
QLoRA + 한국어 — T4 한 장으로 7B 모델을 한국어 전문가로 만들기
QLoRA로 T4 16GB에서 7B 모델을 파인튜닝합니다. 한국어 데이터셋 구축, 학습 실행, Wandb 모니터링, Before/After 비교까지.
QLoRA + 한국어 — T4 한 장으로 7B 모델을 한국어 전문가로 만들기
Part 1에서 LoRA의 원리와 Qwen 2.5 7B 파인튜닝을 다뤘습니다. RTX 3090(24GB)에서 약 18GB VRAM이 필요했습니다. 이번 글에서는 QLoRA로 T4 16GB 한 장까지 줄이고, 한국어 데이터셋을 구축해서 실제로 한국어 응답 품질을 끌어올립니다.
시리즈: Part 1: LoRA 이론 | Part 2 (이 글) | Part 3: 평가 + 배포
QLoRA: 메모리의 한계를 뚫다
LoRA가 학습 파라미터를 99.8% 줄였다면, QLoRA는 모델 자체의 메모리까지 줄입니다.
여기부터는 유료 연재입니다
- ✓ 「LoRA 파인튜닝」 연재 전체: 한국어 3편, 영어 3편
- ✓ 한 번 결제, 기한 없음. 결제한 이메일로 로그인하면 열립니다.
연재 단품은 로그인 없이 결제됩니다. 구독은 무료 계정이 필요합니다.