Gemma 4 MoE 파인튜닝 — 3.8B 활성 파라미터로 Arena #6 성능 커스터마이징
Gemma 4 26B MoE 모델에 QLoRA 적용. Expert 레이어 LoRA 전략, Dense 대비 비교, MoE 전용 학습 팁, Ollama 배포까지. LoRA 시리즈 Part 4.
Gemma 4 MoE 파인튜닝 — 3.8B 활성 파라미터로 Arena #6 성능을 커스터마이징하기
시리즈: Part 1: LoRA 이론 | Part 2: QLoRA + 한국어 | Part 3: 평가 + 배포 | Part 4 (이 글)
Part 1~3에서 Qwen 2.5 7B로 LoRA의 기초부터 배포까지 다뤘습니다. Part 4에서는 한 단계 올라갑니다 — Gemma 4 MoE 모델에 LoRA를 적용합니다.
왜 Gemma 4인가? 세 가지 이유:
- MoE 아키텍처: 26B 파라미터 중 3.8B만 활성화. 추론 비용은 4B급이지만 성능은 Arena #6
🔐
구독 회원 전용 글입니다
구독하면 모든 프리미엄 시리즈와 Jupyter 노트북이 열립니다.
결제하려면 무료 계정이 필요합니다. 언제든 취소할 수 있습니다.
관련 포스트
AI Research
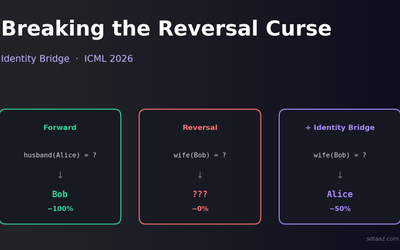
Reversal Curse를 깨는 Identity Bridge — ICML 2026, 이래도 되는데 되는 fix
언어 모델은 "Alice의 남편은 Bob"을 학습해도 "Bob의 아내는?"을 못 맞힙니다 — 유명한 reversal curse. ICML 2026 논문 하나가 학습 데이터에 이상한 자기참조 예제를 섞는 것만으로 이 문제를 해결합니다. 순진한 버전은 안 되고, 정교한 버전은 됩니다.

Models & Algorithms
Qwen 3.5 로컬 설치 완전 가이드 — Ollama부터 vLLM까지
Qwen 3.5를 로컬에서 실행하는 4가지 방법을 단계별로 설명합니다. Ollama 5분 설치부터 llama.cpp, vLLM 프로덕션 서버, HuggingFace Transformers까지.
Models & Algorithms
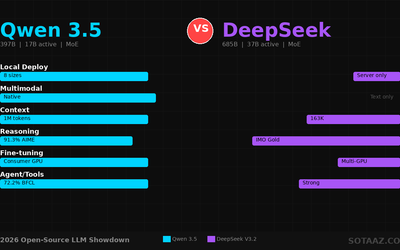
Qwen 3.5 vs DeepSeek V3.2 — 2026년 오픈소스 LLM 양강 구도 완전 분석
Qwen 3.5와 DeepSeek V3.2를 아키텍처, 벤치마크, 하드웨어, 파인튜닝까지 완전 비교. 어떤 상황에 어떤 모델을 써야 하는지 정리했습니다.