Strata와 llama.cpp에 같은 Qwen3.8-Flash-Next 파일을 넣어 봤습니다: 점수 차이는 보이지 않았고, 12GiB에서는 Strata가 빨랐습니다
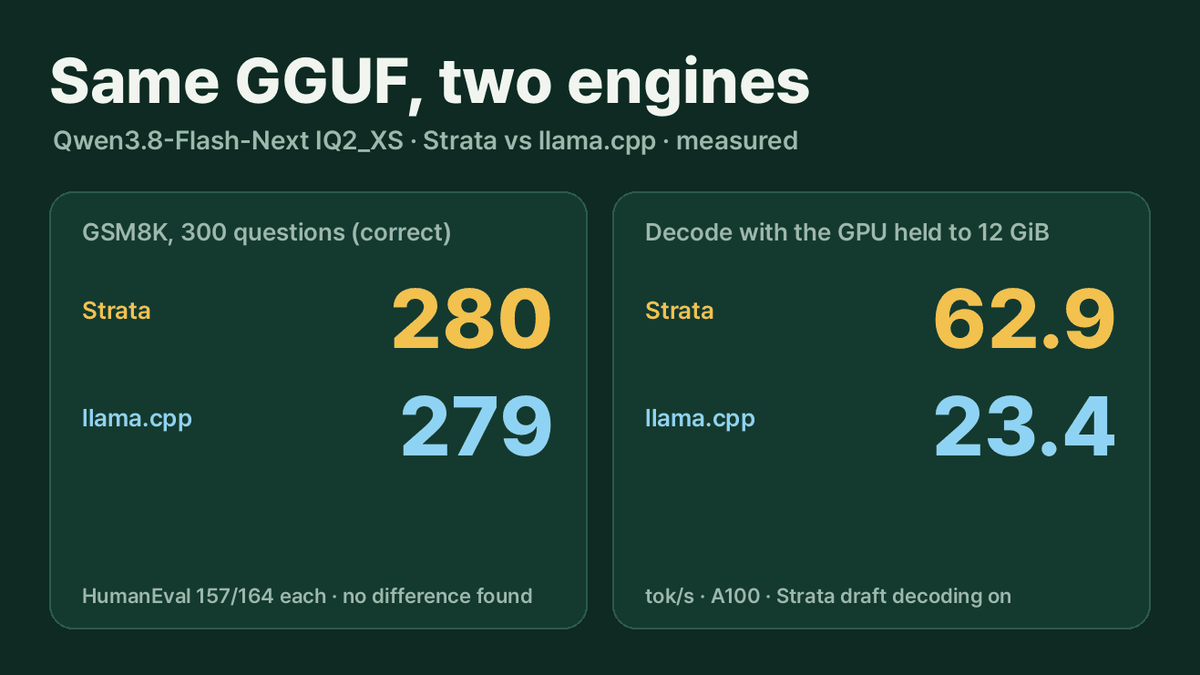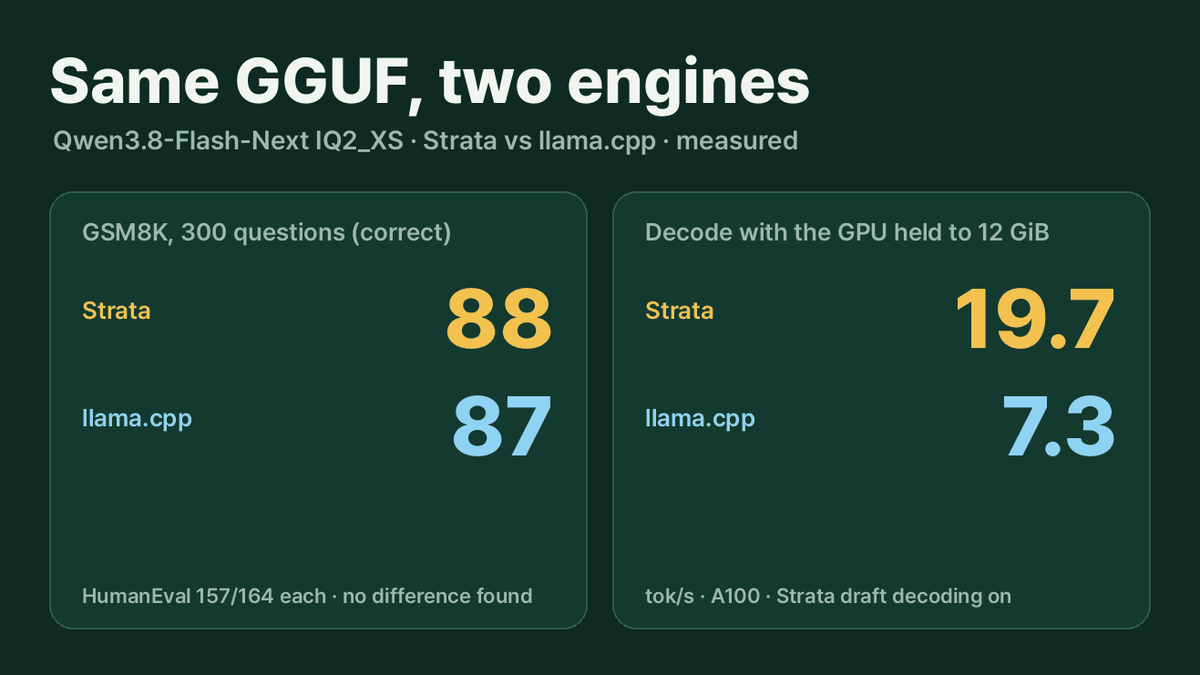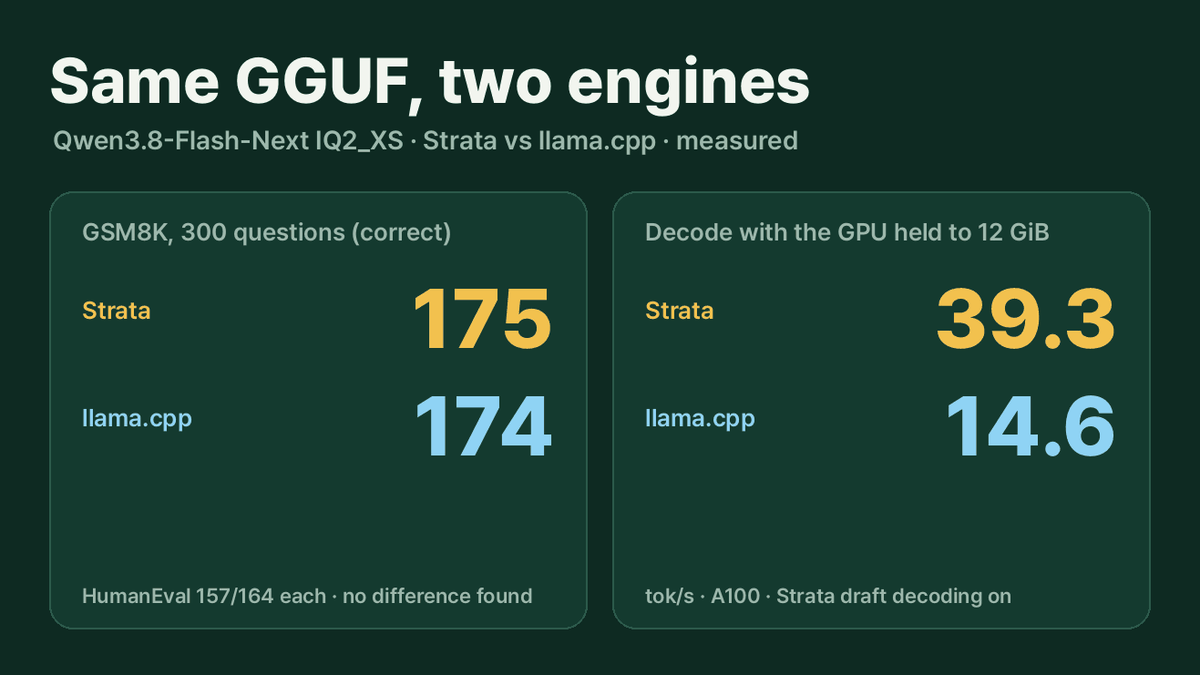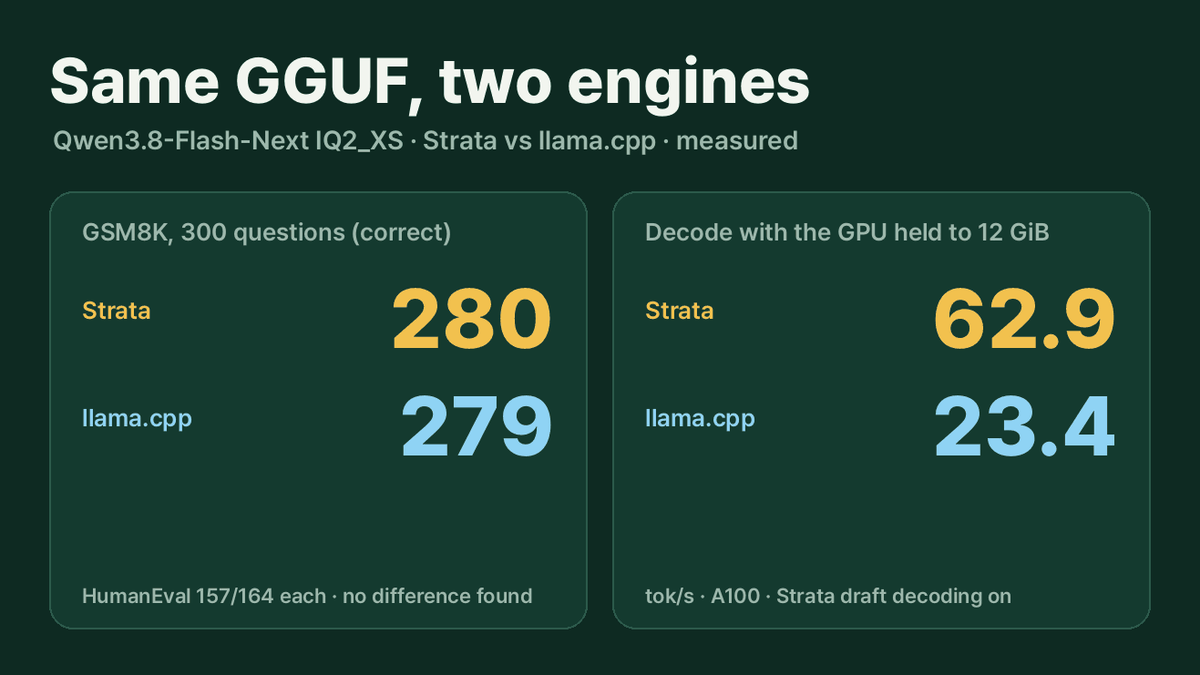
같은 IQ2_XS 파일로 GSM8K 93.3% 대 93.0%, HumanEval은 둘 다 157/164였고, COCO 100장 좌표 과제에서도 차이가 나타나지 않았습니다. GPU를 12GiB로 묶으면 디코드는 Strata 62.9(추측 디코딩 켬), llama.cpp 23.4 tok/s였습니다.
Strata와 llama.cpp에 같은 Qwen3.8-Flash-Next 파일을 넣어 봤습니다: 점수 차이는 보이지 않았고, 12GiB에서는 Strata가 빨랐습니다
10월 4일 Hacker News 1면에 Strata라는 추론 엔진이 올라왔습니다. 제목은 "Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s"였습니다. Qwen3.8-Flash-Next 한 모델만 돌리는 엔진이고, 12GB짜리 게이밍 그래픽카드에서도 이 모델을 돌릴 수 있다고 내세웁니다.
댓글은 두 갈래로 나뉘었습니다. llama.cpp보다 훨씬 빠르다는 사용기가 이어졌고, 반대로 답이 체감상 나빠졌다는 댓글도 있었습니다. 그중 한 댓글은 구체적인 숫자를 붙였습니다. 이미지 50장에서 물체 좌표를 물었더니, 같은 GGUF와 같은 비전 어댑터인데도 Strata의 오차 중앙값이 154.8픽셀로 llama.cpp(46.5픽셀)의 세 배가 넘었다는 것입니다.
이 두 주장은 직접 확인할 수 있습니다. 모델 파일이 표준 GGUF라 llama.cpp에서도 그대로 돌기 때문입니다. 그래서 같은 파일을 두 엔진에 넣고 같은 요청을 보내 점수, 반복했을 때 같은 답이 나오는지, 속도를 비교했습니다.
결론부터
- 점수 차이는 나오지 않았습니다. 같은 IQ2_XS 파일로 GSM8K는 Strata 280/300, llama.cpp 279/300이었고 HumanEval은 둘 다 157/164였습니다. COCO 이미지 100장에서 물체를 가리키게 했을 때 오차 중앙값은 Strata 37.6픽셀, llama.cpp 37.7픽셀이었습니다. 댓글에서 말한 세 배 차이는 이 이미지들에서는 나타나지 않았습니다.
- 속도는 Strata가 빨랐고, GPU 메모리가 작을수록 차이가 컸습니다. GPU 사용량을 12GiB 안팎으로 묶으면 디코드는 Strata 62.9 tok/s, llama.cpp 23.4 tok/s였습니다. 약 29K 토큰짜리 프롬프트를 읽는 속도는 2,726 대 275 tok/s였습니다.
- 눈여겨볼 차이가 하나 있습니다. GPU를 12GiB로 묶은 상태에서 Strata 기본 설정은 temp 0인데도, 같은 질문 30개 중 세 번 모두 똑같은 답을 낸 것이 12개뿐이었습니다. llama.cpp는 30개 전부 같았습니다. Strata 문서에 이미 적혀 있는 현상이고 해결 스위치도 있는데, 켜면 디코드 속도가 4분의 1쯤 줄어듭니다.
제 장비는 게이밍 PC가 아니라 A100 80GB와 64코어 서버 CPU입니다. 점수와 반복 결과는 장비가 달라도 그대로 참고하실 수 있지만, 속도는 그렇지 않습니다. 이유는 아래에 적었습니다.
125B 모델이 12GB 카드로 돌아가는 이유
125B는 저장해 둔 크기이지 토큰마다 하는 계산량이 아닙니다. Qwen 모델 카드에 따르면 Qwen3.8-Flash-Next는 파라미터 125B 가운데 토큰 하나에 6B만 씁니다. 여기에 51B짜리 n-gram 임베딩 표와, 다음 토큰을 미리 짐작하는 4B짜리 MTP 층이 따로 붙습니다. 층마다 전문가(expert)가 512개 있고, 토큰 하나는 그중 10개와 공유 전문가 1개를 거칩니다.
이 구조 덕분에 부품마다 둘 곳을 나눌 수 있습니다. n-gram 표는 토큰마다 몇 줄만 찾아 읽는 조회표라 RAM이나 SSD에 두면 됩니다. 전문가는 나머지 가중치의 대부분을 차지하지만 토큰 하나가 건드리는 것은 몇 개뿐이라 시스템 RAM에 둘 수 있습니다. 모든 토큰이 거치는 부분만 GPU에 있으면 됩니다. 제가 쓴 양자화 파일(ISTA-DASLab의 GSQ-RCO 배포본)도 이렇게 나뉘어 있습니다. 가중치 샤드가 39.2GB, n-gram 표 샤드가 28.8GB입니다.
두 엔진은 전문가를 다루는 방식이 다릅니다. llama.cpp에서 작은 카드에 맞추는 흔한 방법은 --n-cpu-moe N으로, 앞쪽 N개 층의 전문가를 통째로 CPU에 둡니다. Strata는 전문가를 하나하나 자주 쓰이는 순서로 매겨 많이 쓰는 것을 VRAM에 두고, 나머지는 CPU가 계산하거나 PCIe로 넘겨 받습니다. 12GiB로 묶은 점수 측정의 Strata 로그를 요청별로 보면, 필요한 전문가를 GPU 캐시에서 바로 찾은 비율이 중앙값 77%였고(요청 490개에서 44-95%), PCIe로 넘겨 받은 비율이 17%였습니다. 아래 속도 차이는 이 배치 방식과, 토큰 여러 개를 미리 짐작해 한꺼번에 확인하는 방식에서 나옵니다. 두 엔진의 방식 모두 모델이 이렇게 나뉘어 있기 때문에 쓸 수 있는 것입니다.
무엇을 돌렸나
두 엔진에 같은 모델 파일을 넣었습니다. 받은 파일은 Hugging Face에 올라 있는 SHA-256 값과 대조했습니다. 요청도 OpenAI 호환 API로 바이트까지 같게 보냈습니다. temp 0, 사고(thinking) 모드 끔, 한 번에 요청 하나입니다.
| Strata | llama.cpp | |
|---|---|---|
| 버전 | 커밋 6f32ec0(엔진 0.1.39), sm80용으로 빌드한 Docker 이미지 | master d89651a(2026년 10월 5일), CUDA 12.1 |
| 설정 | setup이 써 준 그대로: KV 캐시 int8, MTP 추측 디코딩 켬(--spec 4) | -fa on -c 65536, KV 캐시 f16, 추측 디코딩 없음(이 GGUF에는 MTP 층이 없음) |
| 조건 A | 전문가 전부 GPU에(80GB 카드에서 setup 기본값) | -ngl 99 |
| 조건 B | --vram-reserve-mib 69000, 최대 12.3GiB 사용(속도 측정 때 12.25GiB) | -ngl 99 --n-cpu-moe 42, 최대 12.3GiB 사용(속도 측정 때 12.19GiB) |
질문, 표본 수, 판정 기준은 첫 측정 전에 파일로 적어 커밋해 두었습니다. 다만 조건 B의 점수 측정은 그 계획에 없었습니다. 조건 A를 돌려 보니 전문가가 전부 GPU에 올라가 있어서, 12GB 카드 사용자가 실제로 타는 CPU 계산 경로를 한 번도 거치지 않았기 때문입니다. 그래서 결과를 본 뒤 추가했습니다. 또 이 서버의 디스크는 SSD가 아니라 HDD라서 Strata setup이 n-gram 표를 RAM에 올렸습니다. llama.cpp에도 조건 B 점수 측정과 모든 속도 측정에서 같은 조건(--lazy-mode off)을 줬습니다. 모델 카드가 권하는 --lazy-mode on은 조건 A 점수 측정에만 썼는데, 이 옵션은 속도에만 영향을 주고 답에는 영향이 없습니다.
점수: 차이를 찾지 못했습니다
| 조건 | llama.cpp | Strata | llama.cpp만 맞힘 | Strata만 맞힘 | McNemar p | |
|---|---|---|---|---|---|---|
| GSM8K(300) | A | 279(93.0%) | 280(93.3%) | 2 | 3 | 1.00 |
| GSM8K(300) | B | 280(93.3%) | 281(93.7%) | 3 | 4 | 1.00 |
| HumanEval(164) | A | 157(95.7%) | 157(95.7%) | 1 | 1 | 1.00 |
두 엔진이 같은 글을 쓰지는 않았습니다. 조건 A에서 GSM8K 답 300개 중 글자까지 같은 것은 138개였고, 마지막 숫자가 같은 것은 290개였습니다. llama.cpp 하나만 놓고 조건 A와 B를 비교해도 비슷했습니다. 글자까지 같은 답은 156개, 숫자가 같은 답은 291개였습니다. 커널마다 반올림이 조금씩 달라서 수백 토큰을 쓰는 동안 표현이 갈라집니다. 이 표본에서 최종 답까지 바뀐 경우는 드물었습니다.
이 숫자로 말할 수 있는 범위도 적어 둡니다. 300문항이면 1-2%p 차이는 통계적으로 드러나지 않습니다. 또 GSM8K와 HumanEval은 오래되고 쉬운 편이라 이 모델이 90% 넘게 맞힙니다. 사고 모드를 켠 길고 어려운 작업에서 차이가 나는지는 이 측정으로 알 수 없습니다.
비전 좌표 차이는 공개 이미지에서 재현되지 않았습니다
댓글 작성자는 이미지 50장에서 지정한 물체의 좌표를 묻고 정답까지 거리를 쟀습니다. 그 이미지는 공개되지 않아서 공개 데이터로 같은 실험을 만들었습니다. COCO val2017에서 어떤 범주의 물체가 딱 하나만 있는 이미지 100장을 골라 "Point to the {물체} in the image"라고 묻고, 이 모델이 쓰는 0-1000 좌표로 답하게 했습니다. 댓글 작성자도 나중에 단 답글에서 BF16 비전 파일과 0-1000 좌표 형식을 썼다고 밝혔으니, 이 두 가지는 제 실험과 같습니다.
| 조건 | 엔진 | 박스 안에 찍음(100장 중) | 오차 중앙값 | 오차 평균 |
|---|---|---|---|---|
| A | llama.cpp | 95 | 37.7px | 46.3px |
| A | Strata | 93 | 37.6px | 48.0px |
| B | llama.cpp | 95 | 36.7px | 46.1px |
| B | Strata | 95 | 37.7px | 46.0px |
이미지 한 장이 프롬프트 토큰 몇 개가 되는지는 이미지마다 129개에서 439개까지 달랐지만(중앙값 298개), 같은 이미지라면 100장 모두 두 엔진에서 토큰 수가 같았습니다. 조건 A에서 Strata가 두 장 덜 맞혔는데, 그중 하나는 좌표 없이 "There is no bowl in the image."라고 답한 경우입니다. 조건 B에서는 맞힌 수가 같았습니다. Strata 문서에도 "테스트 이미지에서 llama.cpp의 멀티모달 구현과 토큰 단위로 일치한다"는 문장이 있습니다.
그렇다고 댓글이 틀렸다는 뜻은 아닙니다. 이미지, 질문 문구, Strata 버전이 모두 다릅니다. Strata 변경 기록을 보면 이미지 처리 부분은 최근 릴리스에서 여러 번 바뀌었습니다(0.1.23, 0.1.33). 제가 말할 수 있는 것은, 이 공개 이미지와 이 버전에서는 그 차이가 나오지 않았다는 데까지입니다.
같은 질문에 다른 답
GSM8K 앞 30문항을 설정마다 temp 0으로 세 번씩 물었습니다.
| 설정 | 세 번 모두 같은 글 | 마지막 숫자가 같음 |
|---|---|---|
| llama.cpp, 조건 A와 B | 30/30 | 30/30 |
| Strata, 조건 A(전문가 전부 GPU) | 30/30 | 30/30 |
| Strata, 조건 B, 기본 설정 | 12/30 | 29/30 |
| Strata, 조건 B, 재현성 스위치 켬 | 30/30 | 30/30 |
이유는 Strata 문서에 나와 있습니다. 전문가가 GPU와 CPU에 나뉘어 있으면 같은 전문가를 서로 다른 커널이 계산할 수 있고, 커널마다 반올림이 다릅니다. 어느 커널이 돌지는 추측 디코딩이 몇 토큰을 묶었는지, 지난 요청 이후 어떤 전문가가 VRAM으로 옮겨졌는지에 따라 달라집니다. 문서가 안내하는 해결책은 STRATA_IQ_MT_MIN=1에 --prompt-cache 0 --adapt-swaps 0 --pcie-frac 0을 더하는 것입니다. 켜니 30문항 모두 세 번 같은 답이 나왔고, 조건 B 디코드 속도는 62.9에서 46.3 tok/s로 내려갔습니다.
대화용이라면 거의 상관없습니다. 30문항 중 최종 답이 바뀐 것은 하나였습니다. 하지만 두 설정을 A/B로 비교하거나, 평가 결과를 캐시해 두고 다시 쓰거나, 두 번 돌린 결과를 맞대 보는 작업이라면 다릅니다. 내가 바꾼 것과 상관없이 답이 달라질 수 있기 때문입니다.
속도
디코드는 서로 다른 질문 15개에 256토큰씩 답하게 했습니다. 프롬프트 읽기는 약 4K 토큰과 약 29K 토큰짜리를 세 개씩 넣었습니다. 프롬프트 캐시가 끼어들지 않도록 요청을 매번 다르게 했고, 속도는 클라이언트에서 잰 중앙값입니다.
| 조건 | 엔진 | 디코드 tok/s | 4K 프롬프트 읽기 tok/s | 29K 프롬프트 읽기 tok/s |
|---|---|---|---|---|
| A, 카드 전체 | llama.cpp | 63.0 | 879 | 965 |
| A, 카드 전체 | Strata | 110.7 | 1,995 | 2,826 |
| B, 12GiB, 64코어 | llama.cpp | 23.4 | 242 | 275 |
| B, 12GiB, 64코어 | Strata | 62.9 | 1,865 | 2,726 |
| B, 12GiB, 8코어 | llama.cpp | 8.8 | 237 | 274 |
| B, 12GiB, 8코어 | Strata | 43.1 | 1,763 | 2,736 |
12GiB 조건에서 Strata의 디코드는 64코어일 때 llama.cpp의 2.7배, 8코어일 때 4.9배였습니다. 긴 프롬프트를 읽는 속도는 12GiB로 묶어도 카드 전체를 쓸 때와 거의 같았습니다. llama.cpp는 3분의 1 아래로 떨어졌습니다.
이 표에는 Strata에 유리한 조건이 셋 있고, 그중 마지막 하나만 제가 고른 것입니다. 첫째, Strata는 추측 디코딩을 켰고 llama.cpp는 이 파일로는 쓸 수 없습니다. 둘째, KV 캐시가 Strata는 8비트, llama.cpp는 16비트입니다. 셋째, --n-cpu-moe는 작은 카드에 맞추는 가장 간단한 방법일 뿐 유일한 방법은 아닙니다. llama.cpp의 텐서 단위 배치(-ot)는 시도하지 않았고, Strata를 추측 디코딩 없이 돌려 보지도 않았습니다.
장비 차이도 큽니다. A100은 게이밍 카드보다 메모리 대역폭이 훨씬 넓고, EPYC 7742는 메모리 채널이 8개입니다(데스크톱은 보통 2개). 8코어 행은 데스크톱 CPU에 조금 가까워진 조건이지만 메모리는 여전히 서버 것입니다. Strata가 공개한 RTX 5070(12GB)과 RAM 64GB 표에는 IQ2_XS가 79 tok/s로 적혀 있습니다(세부 문서에 따르면 속도가 같은 같은 크기의 파인튜닝 모델로 잰 값입니다). 작성자가 다른 장비에서 잰 값이고, 저는 재현하지 않았습니다.
그래서 어떻게 쓰면 되나
- 이미 이 모델을 llama.cpp로 돌리고 있고 모델이 GPU에 다 들어간다면, 이번 측정에서 두 엔진의 점수 차이는 보이지 않았습니다. 제 측정에서는 그 경우에도 Strata가 읽기와 쓰기 모두 빨랐습니다.
- 그래픽카드가 12GB 안팎이라면 Strata가 겨냥한 바로 그 경우이고, 속도 차이가 컸습니다. 이번 과제들에서는 품질 손해를 찾지 못했습니다.
- 실행 결과를 서로 비교하거나 캐시해 둔다면 재현성 스위치를 켜 두는 편이 좋습니다. 그러지 않으면 temp 0에서 답이 바뀌어도 성능 저하가 아니라 잡음일 수 있다고 보셔야 합니다.
- 모델 라이선스는 Qwen Community License 1.0입니다. 양자화 저장소 카드에는 Apache 2.0이라고 적혀 있지만, 그 표기가 원 모델의 라이선스를 바꾸지는 않습니다.
이 결과의 한계
파일 하나(IQ2_XS), 사고 모드 끔, 최대 1,024토큰짜리 짧은 답에서 잰 결과입니다. 작은 수치 차이가 오래 쌓이는 긴 추론이나 에이전트 작업은 재지 않았습니다. GSM8K 300문항, HumanEval 164문항, 이미지 100장으로는 큰 차이만 드러납니다. 조건 B의 점수 측정은 조건 A 결과를 본 뒤 추가했습니다. 속도는 A100과 서버 CPU에서 클라이언트가 잰 값이고, Strata만 추측 디코딩을 썼습니다. 8코어 행에서 Strata가 스레드를 몇 개 띄웠는지는 로그에 남지 않아 확인하지 못했습니다. SSD, 다른 양자화, llama.cpp의 다른 배치 방식은 시험하지 않았습니다. 일반 llama.cpp에서 어떤 Qwen 파일이 어느 그래픽카드에 맞는지는 Qwen 로컬 실행 글에 정리해 두었습니다.
다음 측정을 메일로 받아 보고 싶으시면 바로 아래 구독란을 이용해 주세요.
환경: A100 80GB PCIe 한 장(드라이버 580.178.04), AMD EPYC 7742(64코어), RAM 251GB, 모델 파일은 HDD에 둠. 모델: ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF의 IQ2_XS/ 두 샤드(SHA-256 92cee27a…, 316b46f3…, Hugging Face 값과 일치)와 mmproj-Qwen3.8-Flash-Next-BF16.gguf. Strata 6f32ec0(엔진 0.1.39)는 CUDA_ARCHITECTURES=80으로 빌드한 Docker 이미지에서 setup.py --setup --yes --model IQ2_XS --gguf-dir … --context 65536 --vision yes로 설정. llama.cpp d89651a는 llama-server -m … --mmproj … -c 65536 -fa on -lm mmap -ngl 99(조건 A 점수 측정은 --lazy-mode on, 나머지는 off, 조건 B는 --n-cpu-moe 42). 요청: OpenAI chat completions, temperature 0, chat_template_kwargs: {"enable_thinking": false}, max_tokens 1024(이미지는 64), 한 번에 하나. GSM8K: 테스트 세트를 seed 0으로 섞어 앞 300문항, 마지막 숫자를 정답과 비교. HumanEval: 164문항 전부, 돌려받은 함수를 테스트로 실행(제한 10초). COCO: val2017에서 인스턴스가 하나뿐이고 이미지 면적의 1% 이상인 (이미지, 범주) 쌍 100개, seed 0, 이미지당 한 쌍, 오차는 원본 픽셀 기준 박스 중심까지 거리. 점수 측정은 GPU 두 장에 엔진을 하나씩 올려 동시에 돌렸고, 속도 측정은 다른 GPU를 비운 채 한 장에서 하나씩, 1분 부하 평균 8 미만일 때 돌렸습니다. 8코어 행은 llama.cpp taskset -c 0-7 … -t 8, Strata 컨테이너 --cpuset-cpus 0-7. VRAM은 nvidia-smi로 0.5초마다 기록한 최대값. 측정 전에 커밋한 계획, 스크립트(scripts/strata-repro/), 원시 응답과 로그는 drafts/strata-repro/에 있습니다. 측정일 2026-10-05.
주간 뉴스레터에 새 글 링크를 담아 보냅니다. 메일은 영어로 발송됩니다.
이 글과 이어지는 강좌
SOTAAZ 강좌
강좌는 하나씩 살 수 있습니다. 13개 전체가 필요하면 $199 평생 번들도 있습니다.
이메일로 받아보기
관련 포스트
llama.cpp KV 캐시 양자화, -ctk와 -ctv는 무엇으로 둘까: 현재 빌드에서 다시 잰 결과
KV 캐시가 VRAM에 들어가면 f16 그대로, 모자라면 -ctk q8_0 -ctv q8_0을 씁니다. 64K에서 4.2GiB를 아꼈지만 그 길이에서 디코드 속도는 f16의 56%였습니다.
Qwen 로컬 실행: 내 GPU(8·12·16·24GB)에 맞는 파일 고르기, 실측
8·12·16·24GB 그래픽카드별로 받을 Qwen GGUF 파일을 실측 메모리로 골랐습니다. 9B Q4_K_M 5.8GiB, 27B Q3_K_XL 13.1GiB, 35B-A3B는 30개 층의 전문가를 CPU에 두면 7.3GiB로 돌아갑니다.
DiffusionGemma vLLM 예제 서버, 입력 설명 한 문장에 54.5%가 31.8%로
DiffusionGemma를 결정 모델로 쓰게 해 주는 vLLM 풀 리퀘스트가 병합됐습니다. 그 예제 서버를 A100에서 돌려 BANKING77 154건을 쟀습니다. 질문 하나에 선택지를 26개까지만 받아서 의도 77개를 아홉 그룹으로 나눠 두 번 읽었고, 노이즈 추출 1회로 54.5%(119ms), 기본 설정으로 51.3%가 나왔습니다. 같은 두 단계 읽기를 transformers로 옮긴 제 구현은 68.2%였고, 예제 서버에 입력을 설명하는 문장 하나를 넣자 54.5%가 31.8%로 떨어졌습니다.