Qwen-Image-2.1을 A100 한 장에서: 셀 수 있는 것만 재고, OCR이 틀린 것을 잡았습니다
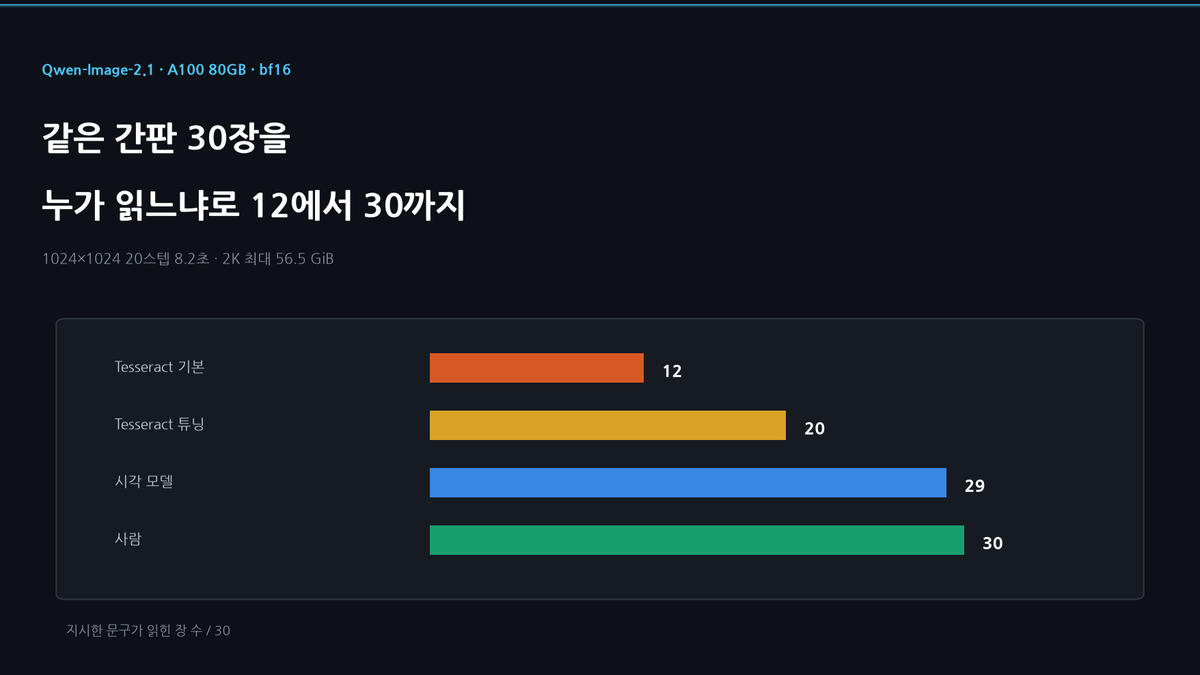
1024×1024 20스텝에 8.2초, 2048×2048에서 최대 56.5 GiB입니다. 간판 30장을 직접 확인하니 지시한 문구가 모두 제대로 그려져 있었는데, 같은 30장에서 Tesseract는 기본 설정으로 12장만 찾았습니다. 약한 쪽은 편집입니다. 마스크 없이 준 지시 여덟 건 중 넷만 따랐고, 바뀐 픽셀 비율의 중앙값은 84%였습니다.
Qwen-Image-2.1을 A100 한 장에서: 셀 수 있는 것만 재고, OCR이 틀린 것을 잡았습니다
Qwen이 9월 20일에 Qwen-Image-2.1을 공개했습니다. 이미지 생성과 편집을 한 체크포인트로 하고, 가중치는 33.1GB입니다. 7B 생성부와 Qwen3-VL 인코더, VAE 셋으로 나뉩니다. 라이선스는 qwen-research이고 첫 Qwen-Image의 Apache-2.0이 아닙니다. 상업적으로 쓰기 전에 확인해야 하는 부분입니다.
A100 80GB 한 장에서 셀 수 있는 것만 쟀습니다. 시간, 메모리, 지시한 글자가 실제로 나오는지, 그리고 편집을 시켰을 때 원본이 얼마나 남는지입니다. 미감이나 지시 반영 점수는 재지 않았습니다. 사람 여럿이 붙어야 하는 값이고 저는 한 명입니다.
속도와 메모리
프롬프트를 고정하고 설정마다 시드 3개씩, bf16, diffusers는 git 판(0.41.0.dev0)입니다.
| 해상도 | 스텝 | 중앙값 | 시드 3개 폭 | 스텝당 |
|---|---|---|---|---|
| 1024×1024 | 20 | 8.2초 | 0.06초 | 0.41초 |
| 1024×1024 | 40 | 16.3초 | 0.08초 | 0.41초 |
| 2048×2048 | 20 | 43.6초 | 0.04초 | 2.18초 |
| 2048×2048 | 40 | 86.1초 | 0.05초 | 2.15초 |
20스텝에서 40스텝으로 가면 시간이 거의 정확히 두 배입니다. 그래서 들고 다닐 숫자는 스텝당 시간이고, 1K에서 0.41초, 2K는 2.15~2.18초입니다. 이 값은 파이프라인 전체 시간을 스텝 수로 나눈 것이라 순수 디노이징 시간보다 큽니다. 픽셀이 네 배가 되면 시간은 5.3배가 됩니다. 최대 할당은 1K에서 36.8GiB, 2K에서 56.5GiB이고, 로컬 디스크에서 모델을 올리는 데 10초쯤 걸립니다.
글자 시험, 그리고 채점자를 셋으로 늘린 이유
이번 공개가 내세운 것 중 판단이 안 들어가고 확인할 수 있는 항목이 글자 렌더링입니다. 문구를 지정한 간판 열 개를 시켰습니다. OPEN 24 HOURS, Gate B12, SALE 70%, Cafe Aurora, PLATFORM 9, NO PARKING, Espresso 4.50, EXIT, Room 301, Fresh Bread Daily입니다. 시드 3개씩 30장을 만들고, 지시한 문자열이 그대로 읽히는 횟수를 셌습니다.
| 읽은 쪽 | 문구가 온전히 읽힌 장 |
|---|---|
Tesseract 4.1.1, --psm 6 | 12 / 30 |
| Tesseract, 전처리 4가지 × 페이지 분할 4가지 중 정답을 알고 고른 최선 | 20 / 30 |
| GPT-5.6 Terra 시각 모델, 옮겨 적으라고만 지시 | 29 / 30 |
| 저 (30장을 직접 확인) | 30 / 30 |
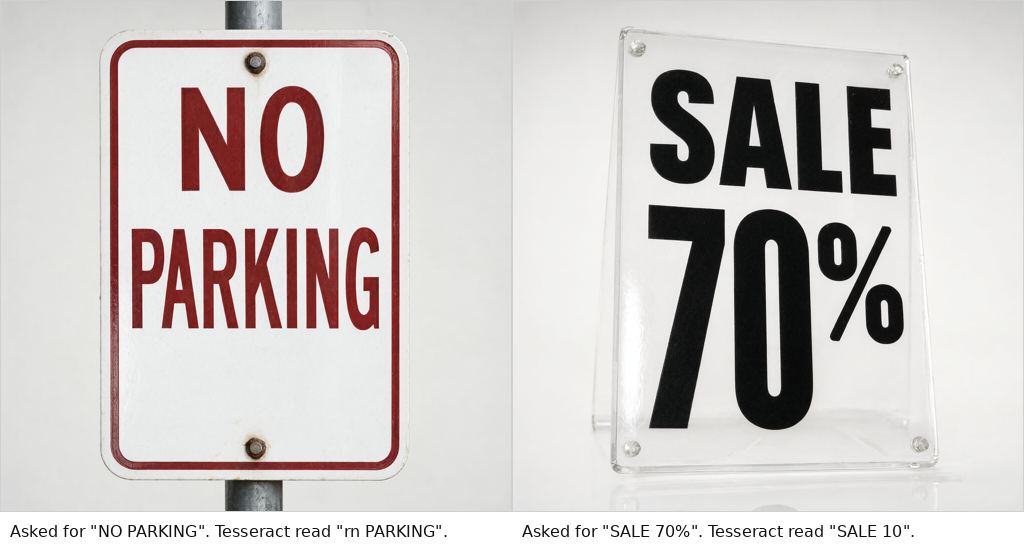
첫 줄은 모델에 대한 결과가 아닙니다. Tesseract는 NO PARKING을 rn PARKING으로, SALE 70%를 SALE 10"로 읽었습니다. 두 장 다 두꺼운 산세리프로 또렷하게 그려져 있습니다.
두 번째 줄은 다른 줄과 조건이 다릅니다. 정답을 알고 16가지 설정 중 성공한 것을 고른 값이라, 한 번만 전사한 시각 모델의 29/30과 나란히 읽으면 안 됩니다.
맨 아랫줄은 제가 30장을 전부 열어 확인한 결과입니다. OCR이 실패로 본 10장은 한 장씩 봤고, 나머지 20장은 네 장 묶음 대조 시트로 봤습니다. 지시한 글자는 30장 모두 그대로 있었습니다. Cafe Aurora의 필기체와 소수점이 들어간 가격도 포함해서요. 이건 사람이 읽을 수 있는 글자에 대한 이야기이지 이미지가 얼마나 좋은지에 대한 이야기가 아닙니다. 그리고 읽는 쪽이 셋으로 갈린 것이 이 절이 존재하는 이유입니다. 채점자가 대상보다 약하면 그 숫자는 대상이 아니라 채점자를 설명합니다. 저는 40%로 낼 뻔했습니다.
편집은 구도를 남기고 표면을 다시 그립니다
같은 파이프라인이 image 인자를 받습니다. 모델 카드가 안내하는 편집 방식이 그것입니다. 원본을 넣고 지시를 프롬프트로 씁니다. 나무 탁자 위 빨간 머그를 만든 뒤 지시 네 개를 시드 2개씩, 40스텝으로 줬습니다.
| 지시 | 이행 | 원본 대비 PSNR 중앙값 | 바뀐 픽셀 |
|---|---|---|---|
| 머그를 파랗게 | 2 / 2 | 12.2 | 86% |
| 머그에 MORNING이라고 쓰기 | 2 / 2 | 14.3 | 80% |
| 머그 옆에 작은 화분 추가 | 0 / 2 | 14.8 | 80% |
| 탁자에서 머그 제거 | 0 / 2 | 12.2 | 84% |
색을 바꾸는 것과 글자를 넣는 것은 됐습니다. MORNING은 두 시드 모두 또렷하게 나왔습니다. 물건을 더하는 것은 두 번 다 실패했습니다. 한 번은 머그 옆이 아니라 머그 안쪽에 녹색 얼룩이 생겼습니다. 제거는 다른 방식으로 실패했습니다. 한 시드에서는 머그가 그대로 남았고, 다른 시드에서는 반투명한 유령처럼 흐려진 채 그 자리에 있었습니다.
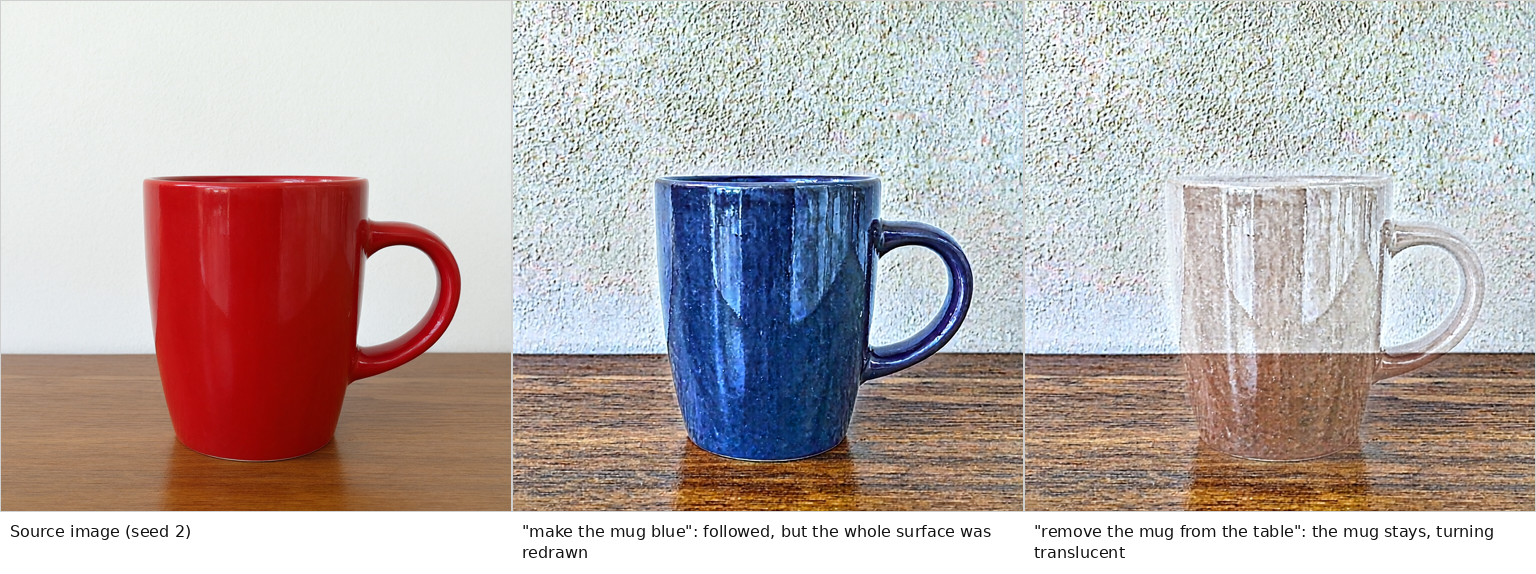
나머지는 픽셀 숫자가 말합니다. 편집 여덟 건의 바뀐 픽셀 비율은 중앙값 84%, 평균 82%, 개별로는 71%에서 91%까지였습니다. 원본 대비 PSNR은 10.8에서 15.8 사이입니다. 눈으로 보면 구도는 남습니다. 같은 구성, 같은 탁자, 같은 자리의 머그입니다. 그런데 질감과 색조는 다시 그려집니다. 한 시드에서는 머그 자체가 둥근 것에서 직선형으로, 다른 머그가 되어 돌아왔습니다. 마스크 없이 문장 지시만 준 이 여덟 건에서는 원본 픽셀이 보존되기를 기대하기 어려웠습니다. 모델 카드는 원을 치거나 칠하거나 별도 마스크를 주는 국소 편집도 지원한다고 적어 두었는데, 이번에는 재지 않았습니다. 따라서 "이 모델은 편집을 못 한다"가 아니라 "문장만 주는 방식으로는 그대로 두라는 보장이 없다"가 이번 결과입니다.
정리하면
- A100에서 스텝당 1K는 0.41초, 2K는 2.15초로 잡으십시오. 2K 40스텝이면 한 장에 1분 26초입니다. 줄일 자리는 스텝 수입니다. 배치 처리는 재지 않았습니다.
- 2K에서 최대 56.5GiB라, 48GiB 카드는 bf16으로 이 해상도를 오프로딩 없이 감당하지 못합니다.
- 짧은 간판 문구의 글자 렌더링은 실제로 좋습니다. 제가 시험한 범위가 그것입니다. 긴 문단은 다른 문제이고 재지 않았습니다.
- 문장만으로 주는 편집은 결과를 확인하고 쓰십시오. 색이나 글자는 이번 시험에서 두 번 다 얻었지만, 물건을 더하거나 빼라는 지시는 네 번 다 실패했고 나머지 화면도 같이 바뀌었습니다. 마스크를 주는 방식은 재지 않았습니다.
- 라이선스를 확인하십시오.
qwen-research는 Apache-2.0이 아닙니다.
이 결과로 말할 수 없는 것
시험마다 프롬프트 계열이 하나씩이고, 간판 30장과 편집 8건, 카드 한 장, 자료형 하나입니다. 미감, 복잡한 장면에서의 지시 반영, RGBA와 다중 참조 기능은 재지 않았습니다. 편집 숫자는 이미지 전체를 비교한 것이라 지시가 가리킨 영역의 변화와 그 밖의 표류가 섞여 있습니다. 그리고 같은 30장을 읽는 쪽이 셋(Tesseract, 시각 모델, 사람)이고 채점 조건이 넷으로 갈렸다는 사실은, OCR로 채점한 이미지 벤치마크를 볼 때마다 같은 질문을 해야 한다는 뜻입니다. 그건 누가 읽었습니까.
측정 환경: Qwen/Qwen-Image-2.1, bf16, diffusers 0.41.0.dev0, torch 2.13.0+cu126, A100 80GB PCIe 한 장, 드라이버 535. 생성: 프롬프트 고정, 시드 1~3. 글자 시험: 문구 10개 × 시드 3개, 1024×1024, 40스텝. 판정은 대문자로 바꾸고 A~Z·0~9·%·마침표만 남긴 뒤, 지시 문구가 읽어낸 문자열 안에 들어 있는지를 봤습니다(전체 일치가 아니라 포함 여부입니다). 편집 시험: 시드마다 원본 한 장, 지시 4개, 40스텝. PSNR과 바뀐 픽셀 비율은 이미지 전체에서 계산했고, 어느 한 채널이라도 16/255 넘게 움직이면 바뀐 픽셀로 셌습니다. 측정일 2026-09-23.
이메일로 받아보기
관련 포스트
llama.cpp의 -ctk·-ctv, 기본 CUDA 빌드에서 쓸 수 있는 값은 넷입니다
llama-bench는 KV 캐시 타입 여덟 개를, llama-server는 아홉 개를 받습니다. 그런데 기본 CUDA 빌드는 FlashAttention 커널을 f16·bf16·q8_0·q4_0 네 타입에만, 그것도 K와 V가 같을 때만 컴파일합니다. 나머지 설정은 커널이 없어 프리필이 초당 4,600토큰에서 83~284토큰으로 떨어집니다. llama.cpp 69320fe, A100 실측입니다.
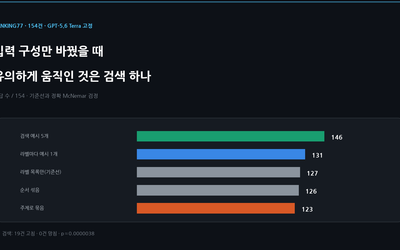
분류 입력 구성만 바꿨더니 유의하게 움직인 것은 검색 하나였습니다
BANKING77에서 GPT-5.6 Terra를 고정하고 입력 구성만 바꿔 봤습니다. 라벨 순서를 섞거나 주제로 묶거나 추론 강도를 바꾼 결과는 기준선과 짝지어 비교했을 때 개선과 악화가 한두 건씩 오가 유의하지 않았습니다. 가까운 학습 예시 다섯 개를 붙인 구성만 146건으로, 19건을 고치고 하나도 망치지 않았습니다(p≈3.8×10⁻⁶).
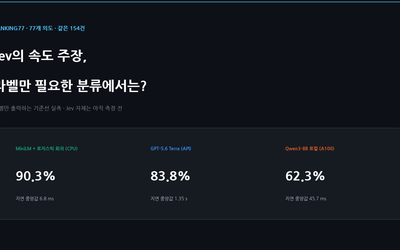
Jev의 속도 주장, 라벨만 필요한 분류에도 적용될까? BANKING77 기준선 실측
BANKING77 테스트셋에서 라벨만 출력하는 네 가지 분류 방식을 같은 메시지 154건으로 비교했습니다. MiniLM 임베딩과 로지스틱 회귀는 CPU에서 정확도 90.3%, 지연 중앙값 6.8ms를 기록했습니다. Jev 자체는 아직 측정하지 않았습니다.