DiffusionGemma vLLM 예제 서버, 입력 설명 한 문장에 54.5%가 31.8%로
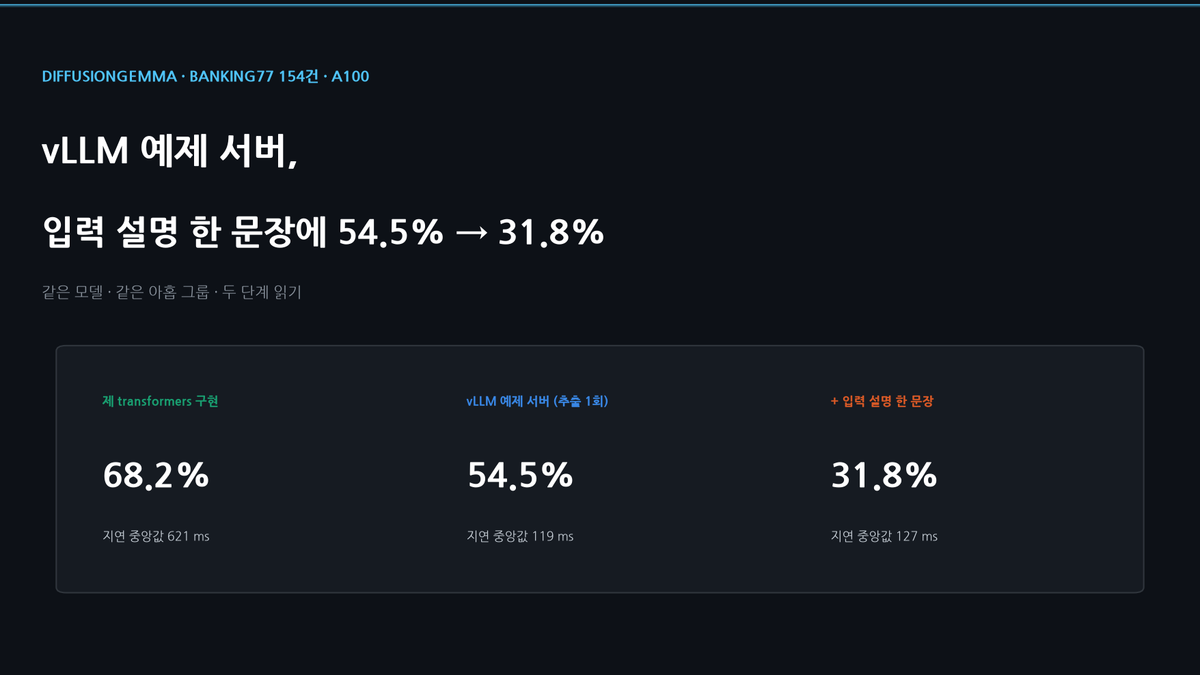
DiffusionGemma를 결정 모델로 쓰게 해 주는 vLLM 풀 리퀘스트가 병합됐습니다. 그 예제 서버를 A100에서 돌려 BANKING77 154건을 쟀습니다. 질문 하나에 선택지를 26개까지만 받아서 의도 77개를 아홉 그룹으로 나눠 두 번 읽었고, 노이즈 추출 1회로 54.5%(119ms), 기본 설정으로 51.3%가 나왔습니다. 같은 두 단계 읽기를 transformers로 옮긴 제 구현은 68.2%였고, 예제 서버에 입력을 설명하는 문장 하나를 넣자 54.5%가 31.8%로 떨어졌습니다.
DiffusionGemma vLLM 예제 서버, 입력 설명 한 문장에 54.5%가 31.8%로
확산 언어 모델은 글을 앞에서부터 한 토큰씩 쓰지 않고 캔버스 전체를 한 번에 채웁니다. 9월 22일 병합된 vLLM 풀 리퀘스트가 이 성질을 분류에 씁니다. 캔버스에 답안 틀을 미리 써 두고 정답 자리 한 칸만 노이즈로 남긴 뒤, 디노이즈를 한 번 돌려 그 자리의 분포를 읽습니다. 그러면 생성 없이 확률이 붙은 결정이 바로 나옵니다. TypeSafe의 Jev가 "System One 모델"이라며 파는 것과 같은 방식을 공개 가중치 모델로 구현한 셈입니다.
앞 글에서 이미 측정해 둔 과제로 이 PR의 예제 서버를 돌렸습니다. BANKING77, 의도 77개, 같은 메시지 154건입니다. 같은 읽기를 transformers 위에 직접 구현한 판도 만들어 두어서, 두 구현을 메시지 단위로 비교할 수 있었습니다.
| 방식 | 정확도 | 지연 중앙값 | 장비 |
|---|---|---|---|
| 사전학습 MiniLM 임베딩 + 로지스틱 회귀 | 90.3% | 6.8ms | CPU |
| GPT-5.6 Terra, 라벨만 요청 | 83.8% | 1,351ms | OpenAI API |
| DiffusionGemma, 제 transformers 구현, 77개 한 번에 | 68.2% | 316ms | A100 80GB 1장 |
| DiffusionGemma, 제 transformers 구현, 두 단계 | 68.2% | 621ms | A100 80GB 1장 |
| Qwen3-8B Q4_K_M, 문법 제약 | 62.3% | 45.7ms | A100 80GB 1장 |
| DiffusionGemma, vLLM 예제 서버, 두 단계, 추출 1회 | 54.5% | 119ms | A100 80GB 1장 |
| DiffusionGemma, vLLM 예제 서버, 추출 횟수 기본값 | 51.3% | 325ms | A100 80GB 1장 |
예제 서버에서 추출을 1회로 고정하면 문법 제약을 건 8B 모델보다 8%p, 같은 읽기를 제가 구현한 판보다 약 14%p, CPU 로지스틱 회귀보다 36%p 낮습니다. 기본 추출 설정으로는 각각 11%p, 17%p, 39%p 낮습니다. 대신 이 과제에서 26B 모델을 돌린 방법 중에는 가장 빠릅니다.
서버는 질문 하나에 선택지를 26개까지만 받습니다
예제 서버 structured_server.py는 선택지에 A부터 Z까지 라벨을 직접 붙이고, 그보다 많으면 요청을 거절합니다. 확인하려고 의도 77개를 질문 하나로 보내 봤더니 모든 요청이 422: question 'intent': at most 26 alternatives로 돌아왔습니다. 이유는 PR 설명에 나와 있습니다. 캔버스가 밀리지 않도록 답이 한 토큰이어야 하고, 긴 선택지는 클라이언트가 글자로 바꿔 보내면 된다는 것입니다.
그러니 77개는 나눠야 하고, 서버에 그 기능이 있습니다. 질문에 ask_if를 달면 앞 질문의 답이 조건에 맞을 때만 그 질문을 읽습니다. 의도 이름을 대소문자를 구분하는 ASCII 순서로 정렬했더니 Refund_not_showing_up이 맨 앞에 왔고, 이것을 순서대로 최대 아홉 개씩 끊어 그룹 아홉 개를 만들었습니다. 마지막 그룹은 다섯 개입니다. 그룹을 고르는 질문 하나와 그룹별 의도 질문 아홉 개를 보냈습니다. 이름순으로 끊으면 비슷한 의도가 대체로 한 그룹에 모이지만 완전하지는 않습니다. card_* 의도 열 개 중 여덟 개가 한 그룹에 들어가고, 나머지 두 개는 다음 그룹으로 넘어갑니다.
노이즈 추출 횟수는 기본적으로 서버가 정합니다. 첫 읽기의 엔트로피가 0.1을 넘으면 단계마다 네 번씩 뽑아 평균을 내고, 154건 중 130건이 이렇게 모두 여덟 번 읽혔습니다. 추출을 1회로 고정(samples: 1)하면 154건 중 23건의 답이 바뀌었고, 정답은 79건에서 84건이 됐지만 유의한 차이는 아니었습니다(p = 0.27). 지연 중앙값은 325ms에서 119ms로 줄었습니다.
A100에서 돌리기까지
이 PR은 vLLM 0.29를 대상으로 하고, 그 커널은 CUDA 13 런타임을 요구합니다. CUDA 13을 쓰려면 드라이버가 580번대여야 하는데 이 장비는 535였습니다. 그래서 드라이버를 올리고 torch도 cu130 빌드로 바꿨습니다.
처음에는 병합 전 커밋 407326b로 돌렸습니다. 그때는 FlashInfer가 자동으로 골라져 CUDA 그래프를 캡처하다가 죽었고, FlashAttention은 이 모델의 512 폭 어텐션 헤드를 지원하지 않았습니다. 그래서 --attention-backend TRITON_ATTN을 직접 넘겨야 했습니다. 같은 크래시를 L40S와 GB10에서 겪은 사람이 두 명 더 PR에 보고했고, 병합 전에 고쳐졌습니다. 병합된 커밋에서는 서버가 알아서 Triton을 고르고, A100에서 백엔드 옵션 없이 뜹니다.
이 글의 숫자는 병합된 커밋에서 쟀습니다. 407326b에서는 같은 두 요청이 84건과 79건 대신 88건과 86건이었습니다. 두 커밋의 추출 1회 결과는 답이 25건 달랐지만, 어느 쪽도 유의하게 낫지 않았습니다(9건 대 5건, p = 0.42).
같은 모델, 같은 그룹인데 14%p 차이
제 transformers 구현도 같은 자리를 같은 방식으로 읽고, 디노이즈는 한 번입니다. 같은 아홉 그룹으로 돌리면 그룹은 80.5%를 맞혔고 최종 105건이 맞았습니다. 예제 서버(추출 1회)는 그룹을 68.8% 맞혔고 최종 84건이었습니다.
두 구현의 예측은 154건 중 99건이 같습니다. 한쪽만 맞힌 메시지를 세면 제 구현만 맞힌 것이 29건, 예제 서버만 맞힌 것이 8건입니다. 정확 McNemar 검정으로 p = 0.0008이고, 기본 추출과 비교하면 34건 대 8건으로 p = 0.0001입니다. 실행할 때마다 생기는 흔들림으로는 설명되지 않습니다. 예제 서버를 추출 1회로 두 번 돌리면 154건이 모두 같은 답이었습니다.
다른 점은 읽기를 둘러싼 프롬프트입니다. 예제 서버는 "Answer a fixed set of questions about the state the user provides"라는 범용 시스템 메시지를 쓰고 선택지를 A: card_arrival 식으로 나열합니다. 제 구현은 "You are a banking customer-support intent classifier"로 시작하고 의도마다 한 글자 기호를 붙입니다. 예제 서버는 두 번째 읽기 전에 첫 번째 답을 다시 적어 주기도 합니다. 이 가운데 무엇이 차이를 만드는지는 따로 떼어 재지 않았습니다.
추가(2026-09-23): 후속 측정에서 시스템 메시지는 원인이 아닌 것으로 나왔습니다. 예제 서버와 같은 범용 프롬프트를 쓰는 openjev가 77개를 한 번에 읽어 154건 중 103건을 맞혔습니다. 차이는 예제 서버의 두 단계 구현 쪽에 있습니다. 자세한 내용.
과제 설명 한 문장에 20%p 넘게 떨어졌습니다
그렇다면 서버에 과제가 무엇인지 알려 주면 되지 않을까 싶었습니다. 스키마에 최상위 instructions 항목이 있고, 서버는 이것을 시스템 메시지에 한 줄 덧붙이는 데만 씁니다. 코드에서 다른 쓰임이 없는 것도 확인했습니다. 두 문장을 넣어 봤고, 추출은 둘 다 1회입니다.
| 시스템 메시지에 덧붙인 문장 | 정답/154 | 그룹 정답률 |
|---|---|---|
| 없음 | 84 | 68.8% |
| "The state is a message a customer sent to a bank's support team." | 49 | 39.6% |
| "You are a banking customer-support intent classifier. Read the customer's message and pick the matching intent." | 44 | 35.1% |
둘 다 나빠졌고, 각각 23%p와 26%p가 떨어졌습니다. 두 번째 문장은 의도를 고르라고 하는데 첫 질문의 선택지는 그룹이라서, 거기서 충돌이 생겼다고 볼 여지는 있습니다. 그런데 입력이 무엇인지 설명만 한 첫 번째 문장도 35건을 잃었습니다.
이 결과만으로는 어느 프롬프트가 맞는지 말할 수 없습니다. 다만 한 스텝 읽기가 문구 한 줄에 얼마나 크게 흔들리는지는 보입니다. 이 글에 나온 어떤 추출 설정보다 문장 한 줄의 영향이 훨씬 컸습니다. PR 스레드에서 vineethsai7도 자기 데이터로 비슷한 것을 봤습니다. 공개한 네 조건에서 F1이 0.51에서 0.90까지 갈렸고, 스키마 선택이 결과를 좌우하며 그 차이가 어떤 맥락 변화보다 훨씬 크다고 적었습니다("Schema choice dominates… much larger than any context change"). 여기서 맥락은 앞선 대화 몇 턴을 붙이는 것을 말합니다. 이 방식을 쓰려면 자기 데이터에서 자기 프롬프트로 직접 재야 합니다. 남의 프롬프트로 나온 숫자는 참고가 거의 되지 않습니다.
제 구현의 설정들과 CUDA 버전
첫 표에서 두 구현을 비교하는 행은 둘 다 새 드라이버에서 쟀습니다. 그러니 두 구현의 차이가 CUDA 버전에서 올 수는 없습니다. 남는 질문은 아래 설정 비교 표가 새 드라이버에서도 유효한가입니다. 이 표는 예전 드라이버와 torch cu126에서 쟀기 때문입니다. 기본 조건을 cu130에서 다시 돌렸더니 154건의 예측이 모두 같았습니다.
| 제 구현에서 바꾼 조건 (드라이버 535, cu126) | 정답/154 | 지연 중앙값 |
|---|---|---|
| 답 자리를 노이즈로 둠 (기본) | 105 | 301ms |
| 답 자리를 첫 기호로 채움 | 105 | 304ms |
| 캔버스 꼬리를 무작위 토큰으로 채움 | 106 | 308ms |
| 디노이즈 4스텝, 템플릿 고정 | 105 | 443ms |
| 노이즈 4회 추출 후 확률 평균 | 106 | 1,209ms |
새 드라이버에서 잰 것 중에도 거의 영향이 없던 것이 셋 있습니다.
- PR은 캔버스 맨 앞에 빈 사고 블록(
<|channel>thought\n<channel|>)을 둡니다. 이것을 빼면 105건이 102건이 되었습니다(p = 0.45). - 77개 기호를 무작위로 다시 배정해 세 번 돌리면 103건, 104건, 102건이었습니다.
- 한 번에 읽기와 두 단계 읽기는 105건 대 105건이었고, 상대가 틀린 것을 서로 10건씩 맞혔습니다.
PR이 밝힌 수치와 제가 잰 수치
PR이 보고한 속도는 DGX Spark 한 대에서 단건 요청 0.12초에 초당 8.7건, 동시 32건에서 0.58초에 초당 54건입니다. 이 측정은 NVFP4 체크포인트, 캔버스 32토큰, 요청당 결정 세 개로 잰 것입니다. 저는 A100에서 bf16 가중치, 캔버스 64토큰, 프롬프트 1,600토큰, 요청당 두 단계로 쟀고, 한 번에 한 요청씩 보내 중앙값 119ms에 초당 8.49건이 나왔습니다. 숫자는 비슷해 보이지만 조건이 이만큼 달라서 재현이라고 부르지는 않겠습니다.
PR에 정확도 수치가 없지는 않습니다. PR 설명에 직접 만든 소규모 시험이 있습니다. 프로그래밍 언어 10/10, 사람 언어 9/10, 단위 비교 10/12이고, 색·개수 세기 같은 비전 과제도 있습니다. 커밋 메시지에는 일관성 측정이 있습니다. 한 캔버스 안에서 서로 의존하는 두 선택이 노이즈 추출 24번 중 몇 번 서로 맞았는지를 센 것인데, 고정 없이 8스텝이면 18번, 고정하면 24번이었습니다. 두 질문을 차례로 읽게 하면 17번이 24번이 됐습니다. 스레드에도 수치가 더 있습니다. pst2154는 직접 만든 72건짜리 진단 세트에서 71/72(98.6%)를 보고했고(NanoJev는 55건), 스스로 넓은 벤치마크가 아니라고 밝혔습니다. vineethsai7 님은 자기 사례 12,152건의 F1을, Gibcity는 언어 식별 간이 시험 98.6%를 올렸습니다.
PR 설명과 댓글을 모두 읽었지만 공개 데이터셋에서 사람 라벨로 잰 정확도는 찾지 못했습니다. 위 시험들은 대부분 선택지가 몇 개뿐이고, BANKING77은 26개 제한을 넘는 77개를 묻습니다. 이 글이 채우는 것은 그 빈자리 하나, 과제 하나입니다.
Jev가 공개한 자체 평가는 네 가지 워크플로에서 67.8%로, 제 구현의 68.2%와 거의 같습니다. 하지만 두 숫자는 다른 과제를 다른 기준으로 잰 것입니다. 저쪽은 프런티어 모델 두 개의 답을 평균한 것을 정답으로 삼았고, 이쪽은 사람이 붙인 라벨이 정답입니다. 둘이 가까운 것은 우연이지 비교가 아닙니다.
이 방식이 맞는 자리
흥미로운 쪽은 확률입니다. 제 구현은 고른 답에 평균 0.95의 확률을 붙였습니다. 그리고 제 구현과 예제 서버(추출 1회) 모두 다시 돌려도 예측이 한 건도 바뀌지 않았습니다. 그러니 임계값을 두고 확신이 큰 건은 바로 처리하고 나머지는 느린 경로로 보내는 식으로 쓸 수 있습니다. 다만 그 확률이 실제 정답률과 맞는지는 재지 않았습니다. 기본값인 4회 추출에서는 vineethsai7 님이 똑같은 요청 804건 중 19건(2.36%)에서 답이 뒤집혔다고 보고했고, 저는 그 설정의 반복성은 재지 않았습니다.
세밀한 77지선다는 이 PR이 노리는 자리도 아닙니다. PR의 예제들은 "급한 건인가", "사람이 봐야 하는가", "세 대기열 중 어디로 보낼까" 같은 예·아니오나 몇 지선다 질문입니다. 26개 제한 안에 질문 하나로 들어가는 크기이고, 먼저 시험해 볼 것도 그쪽입니다.
이 결과로 말할 수 없는 것
데이터셋 하나, 메시지 154건, 모델 하나, 프롬프트 몇 개입니다. 예제 서버는 요청 스키마로만 조정했고, 그룹을 나눈 방식은 제가 정한 것입니다. 14%p 차이가 프롬프트의 어느 부분에서 오는지는 따로 떼어 보지 않았습니다. DGX Spark에서 나온 PR의 수치는 이 장비에서 확인할 수 없었습니다. 모델은 transformers에서 bf16으로 A100 메모리 48.1 GiB를 차지하고, vLLM 서버는 카드 대부분을 잡습니다.
측정 환경: google/diffusiongemma-26B-A4B-it(파라미터 25.8B, bf16). 예제 서버는 vLLM PR #57250 병합 커밋 1b3b88e의 examples/features/structured_diffusion/structured_server.py, 캔버스 64, 어텐션 백엔드는 자동 선택된 Triton, 드라이버 580.178.04, torch 2.13.0+cu130, A100 80GB PCIe 한 장, 요청은 한 번에 하나, 프롬프트 중앙값 1,600토큰입니다. 파이썬 코드는 병합 커밋이고 컴파일된 커널은 병합 전 빌드(0.29.1rc1.dev453+g407326b73)인데, 둘 사이의 커널 소스 변경은 이 모델과 관계없는 파일 두 개(all-reduce 커널, 양자화 경로의 Hadamard 변환 수정)뿐입니다. 제 구현은 transformers 5.17, 캔버스 256, 디노이즈 1스텝(템플릿 고정은 두 스텝 이상에서만 의미가 있습니다), 단일 토큰 기호에 대한 argmax입니다. 첫 표의 제 구현 행은 예제 서버와 같은 드라이버·torch에서, 설정 비교 표는 드라이버 535·torch 2.13.0+cu126에서 쟀습니다. BANKING77 테스트셋(PolyAI, CC-BY-4.0)에서 의도마다 2건씩 뽑은 154건, 시드 20260918. 짝지은 예측에 양측 정확 McNemar 검정을 썼습니다. 측정일 2026-09-22, 2026-09-23.
이메일로 받아보기
관련 포스트
오픈소스 Jev 대안 셋을 같은 데이터로 재 보니: laya·openjev·NanoJev 실측
laya, openjev, NanoJev를 A100 한 장에서 BANKING77(의도 77개), TREC(질문 유형 6개), AG News로 쟀습니다. 선택지가 6개면 421M짜리 laya가 TREC 86.6%를 23ms에 냈고, 77개면 DiffusionGemma 기반 openjev가 66.9%로 앞섰습니다. 다만 77개에서는 CPU에서 도는 로지스틱 회귀가 90%로 전부를 이겼습니다.
분류 입력 구성만 바꿨더니 유의하게 움직인 것은 검색 하나였습니다
BANKING77에서 GPT-5.6 Terra를 고정하고 입력 구성만 바꿔 봤습니다. 라벨 순서를 섞거나 주제로 묶거나 추론 강도를 바꾼 결과는 기준선과 짝지어 비교했을 때 개선과 악화가 한두 건씩 오가 유의하지 않았습니다. 가까운 학습 예시 다섯 개를 붙인 구성만 146건으로, 19건을 고치고 하나도 망치지 않았습니다(p≈3.8×10⁻⁶).
Jev의 속도 주장, 라벨만 필요한 분류에도 적용될까? BANKING77 기준선 실측
BANKING77 테스트셋에서 라벨만 출력하는 네 가지 분류 방식을 같은 메시지 154건으로 비교했습니다. MiniLM 임베딩과 로지스틱 회귀는 CPU에서 정확도 90.3%, 지연 중앙값 6.8ms를 기록했습니다. Jev 자체는 아직 측정하지 않았습니다.