오픈소스 Jev 대안 셋을 같은 데이터로 재 보니: laya·openjev·NanoJev 실측
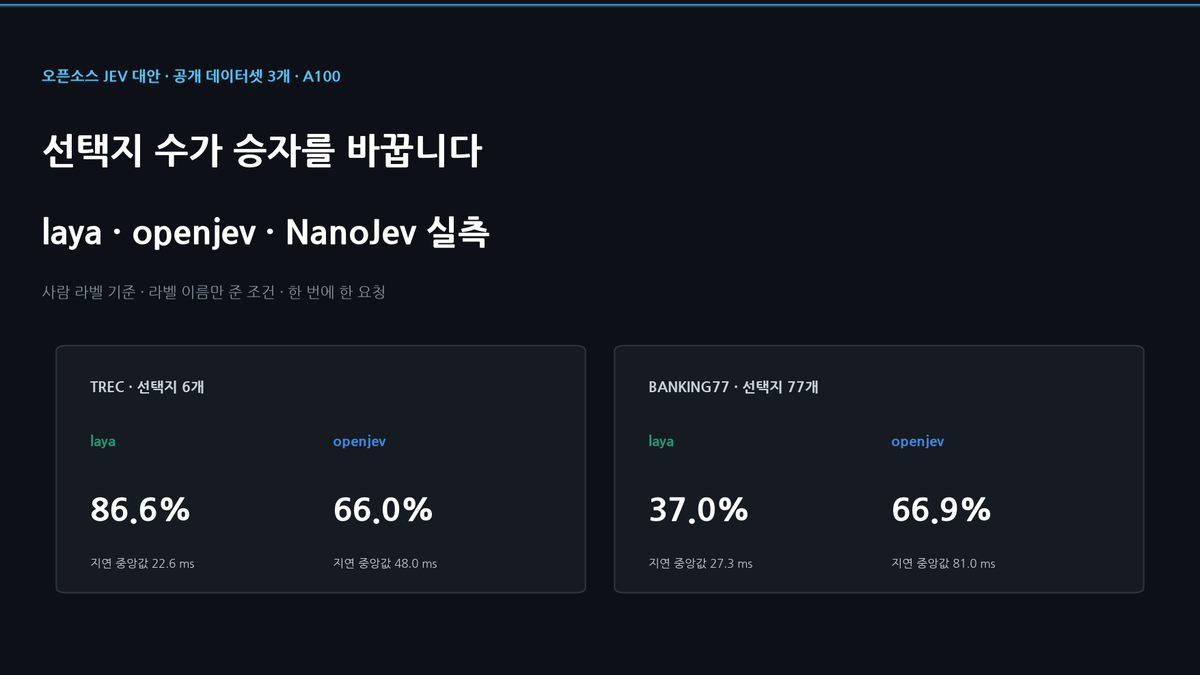
laya, openjev, NanoJev를 A100 한 장에서 BANKING77(의도 77개), TREC(질문 유형 6개), AG News로 쟀습니다. 선택지가 6개면 421M짜리 laya가 TREC 86.6%를 23ms에 냈고, 77개면 DiffusionGemma 기반 openjev가 66.9%로 앞섰습니다. 다만 77개에서는 CPU에서 도는 로지스틱 회귀가 90%로 전부를 이겼습니다.
오픈소스 Jev 대안 셋을 같은 데이터로 재 보니: laya·openjev·NanoJev 실측
TypeSafe의 Jev는 질문에 글로 답하지 않고, 정해 둔 선택지마다 확률을 매겨 돌려줍니다. 출시 이후 같은 방식의 오픈소스 프로젝트들이 주목받고 있고, 그중 하나는 GitHub 별이 18,000개를 넘었습니다. 프로젝트마다 자기 수치를 내놓지만 표본도, 프롬프트도, 장비도 제각각이고, 학습에 쓴 데이터로 잰 수치도 섞여 있습니다. 같은 공개 데이터, 같은 사람 라벨로 셋을 나란히 잰 결과는 찾지 못했습니다.
그래서 A100 한 장에서 한 번에 한 요청씩 직접 쟀습니다.
- laya: ModernBERT 인코더(421M)에 결정용 헤드를 붙이고, 확률을 정직하게 말할수록 보상을 받도록 강화학습한 모델입니다. 0.3.7 버전입니다.
- openjev: DiffusionGemma 26B-A4B를 Jev와 같은 API로 감싼 서버입니다. 직전 글에서 잰 vLLM 구조화 읽기 PR 위에 만들어졌습니다. 0.4.0 버전입니다.
- NanoJev: Qwen3-0.6B에 결정 헤드를 붙이고 게임 데이터(미로, 스네이크, ViZDoom)로만 학습한 모델입니다.
unified-games-v1릴리스입니다.
데이터셋은 선택지 수가 다른 셋을 골랐습니다.
| 데이터셋 | 선택지 | 표본 | 학습에 쓰였나 |
|---|---|---|---|
| BANKING77 | 의도 77개 | 154건 (의도마다 2건) | laya의 벤치 코드는 학습에 안 썼다고 표시 |
| TREC | 질문 유형 6개 | 500건 (테스트셋 전체) | 세 프로젝트 어디에도 언급 없음 |
| AG News | 주제 4개 | 200건 (주제마다 50건) | laya 학습 데이터에 포함, 문서에 명시 |
선택지가 6개면 421M 인코더가 26B 모델과 맞먹거나 앞섭니다
TREC는 질문이 어떤 종류의 답을 원하는지 고르는 과제입니다. 약어, 개체, 설명, 사람, 장소, 수치 중 하나입니다. 세 도구 모두 같은 지시문과 같은 라벨 이름 여섯 개를 받았습니다.
| TREC 500건 | 라벨 이름만 | 이름 + 한 줄 설명 | 지연 중앙값 (이름만) |
|---|---|---|---|
| MiniLM 임베딩 + 로지스틱 회귀, 5,452건으로 학습 | 90.4% | — | 5.7ms (CPU) |
| laya | 86.6% | 88.6% | 23ms |
| DiffusionGemma, vLLM 예제 서버 | 67.0% | 87.6% | 49ms |
| DiffusionGemma, openjev | 66.0% | 80.0% | 48ms |
| MiniLM 임베딩, 라벨 이름과 가장 가까운 것 | 48.6% | — | — |
| NanoJev | 18.4% | 23.8% | 31ms |
laya는 공개된 학습 데이터 목록에 TREC가 없는데도, TREC 학습셋 전체로 학습시킨 분류기보다 4%p만 낮았습니다. 한쪽만 맞힌 질문이 38건 대 57건이라 유의 수준에 조금 못 미칩니다(p = 0.06). 설명 없이도 잘한 것은 laya 하나였습니다. typed-decisions 체크포인트는 여기서 81.8%로 기본 체크포인트보다 낮았습니다.
두 DiffusionGemma 서버 모두 특정 질문 유형 하나를 거의 전부 틀렸습니다. 답이 사람인 질문 65건("전화기를 발명한 사람은?")에서 openjev는 0건, 예제 서버는 1건을 맞혔고, 거의 전부를 entity로 골랐습니다. human이라는 라벨을 글자 그대로 읽은 것으로 보입니다. TREC 분류 체계에서 가져온 한 줄 설명("human: a person, a group of people or an organization")을 붙이자 예제 서버는 335건에서 438건이 됐고, 사람 질문도 65건 중 57건을 맞혔습니다. 설명이 예제 서버를 20%p 움직였고, laya는 2%p만 움직였습니다(p = 0.25).
NanoJev는 매번 description만 골라도 나오는 27.6%보다 낮았습니다. 게임만 배운 모델이라는 점이 그대로 드러납니다.
선택지가 77개면 순위가 뒤집힙니다
BANKING77은 앞 글들과 같은 154건이고, 라벨은 의도 이름을 그대로 썼습니다.
| BANKING77 154건 | 정확도 | 지연 중앙값 |
|---|---|---|
| MiniLM 임베딩 + 로지스틱 회귀, 학습 | 90.3% | 6.8ms (CPU) |
| GPT-5.6 Terra, 라벨만 요청 | 83.8% | 1,351ms |
| DiffusionGemma, openjev, 한 번에 읽기 | 66.9% | 81ms |
| laya, MiniLM으로 후보를 20개로 줄인 뒤 | 59.1% | 43ms |
| MiniLM 임베딩, 라벨 이름과 가장 가까운 것 | 56.5% | — |
| DiffusionGemma, vLLM 예제 서버, 두 단계 | 54.5% | 119ms |
| laya, 선택지 예산을 512토큰으로 | 46.1% | 28ms |
| laya, 기본 설정 | 37.0% | 27ms |
| NanoJev | 20.1% | 73ms |
laya의 기본 설정 결과는 laya 문서가 이미 예고한 것입니다. 선택지 전체가 입력 안에서 192토큰을 나눠 쓰기 때문에, 77개면 선택지마다 4토큰으로 잘려 서로 구분이 안 됩니다. 문서가 권하는 대로 예산을 512토큰으로 늘리자 57건이 71건이 됐습니다(p = 0.04). 문서의 다른 권고인 "임베딩으로 후보를 20개로 줄인 뒤 고르기"는 91건까지 올라갔습니다. 그런데 임베딩 모델 혼자서도 거의 그만큼 합니다. 메시지와 가장 가까운 라벨 이름을 고르면 87건이 맞고, 후보 추리기가 쓰는 순위(지시문을 메시지와 함께 임베딩합니다)의 1순위는 82건이 맞습니다. laya가 20개 후보 위에서 더한 것은 4~9건이고, 둘 다 유의한 차이가 아닙니다(p = 0.57, 0.16). 이 행의 성적은 대부분 MiniLM이 낸 것입니다. 참고로 typed-decisions 체크포인트는 기본 설정 39.0%, 512토큰 예산 46.1%였습니다.
openjev는 직전 글의 예제 서버와 같은 vLLM 커밋, 같은 범용 시스템 프롬프트 위에서 DiffusionGemma를 씁니다. 가장 큰 차이는 선택지 수입니다. 예제 서버는 선택지를 26개까지만 받아서 77개를 나눠 두 번 읽어야 하지만, openjev는 A~Z, a~z에 한 토큰짜리 두 글자 조합까지 라벨로 써서 77개를 한 번에 묻습니다. 작은 차이도 둘 있습니다. 예제 서버는 질문 이름을 모델에게 보여 주고 openjev는 숨기며, Z 다음부터 라벨을 적는 방식이 다릅니다. 똑같은 vLLM에 둘을 붙여 비교하면 한쪽만 맞힌 건이 33건 대 12건으로 openjev의 한 번 읽기가 앞섭니다(p = 0.002).
이 결과로 직전 글에 남겨 둔 질문의 범위가 좁혀집니다. 다 풀리지는 않았습니다. 제 transformers 구현은 한 번에 읽어도, 같은 아홉 그룹으로 두 번 나눠 읽어도 105건이었습니다. 그러니 나누는 것 자체가 원인은 아닙니다. 한편 예제 서버와 같은 범용 프롬프트를 쓰는 openjev는 한 번에 읽어서 103건으로 제 구현과 비슷했습니다(제 두 단계 결과와 154건 중 120건이 같고, 한쪽만 맞힌 건 9건 대 11건, p = 0.82). 따라서 14%p 차이를 만든 것은 제 과제 맞춤 프롬프트가 아닙니다. 차이는 예제 서버의 두 단계 구현 안에 있습니다. 그룹에 라벨을 붙이는 방식, 두 번째 읽기 전에 첫 답을 다시 적는 것, 선택지를 늘어놓는 방식 가운데 무엇인지는 아직 떼어 보지 않았습니다.
AG News는 laya가 이미 배운 과제입니다
AG News에서 laya는 94.5%(typed-decisions 체크포인트 95.0%)로, 4,000건으로 학습시킨 로지스틱 회귀(88.5%)보다 높았습니다(15건 대 3건, p = 0.008). 다만 laya 문서가 AG News를 학습 데이터로 명시하고 있으니, 이것은 새 과제를 푼 성적이 아니라 배운 것을 기억하는 성적입니다. DiffusionGemma 서버는 86.5%(예제 서버)와 85.0%(openjev), NanoJev는 우연 수준(25%)을 조금 넘는 31.0%였습니다.
Jev 본체는 어디쯤인가
저는 Jev API를 쓸 수 없어서, 아래는 다른 사람이 다른 표본으로 잰 값입니다. AbdelStark의 시범 측정은 Jev 1.13.0이 AG News에서 0.910, 라벨 72개짜리 BANKING77 변형에서 0.870이라고 보고했습니다. 데이터셋마다 100건이고, 라벨 설명을 함께 넣었습니다. nibzard의 벤치마크는 의도 77개를 모두 선택지로 줬을 때 76.3%이고, 그 표에서 Jev는 중간쯤입니다. 같은 과제에서 gpt-oss-120b가 81.3%, GLM-5.3이 80.4%였습니다. 표본이 다르다는 전제를 달면, 선택지 77개에서 Jev는 여기서 잰 가장 좋은 오픈소스보다 약 9%p 위에 있습니다. 0.870은 라벨 72개짜리 변형에 라벨 설명을 넣은 조건이고, 그 설명은 TREC에서 DiffusionGemma를 20%p 움직인 바로 그 종류의 입력입니다.
모델을 바꾸지 않아도 답이 바뀐 두 가지
라벨도 프롬프트입니다. TREC에서 선택지마다 한 줄 설명을 붙인 것만으로 예제 서버는 20%p, openjev는 14%p가 올랐고 laya는 거의 그대로였습니다. DiffusionGemma 기반 도구를 평가할 때는 설명부터 써 두고 판단하는 것이 맞습니다.
서버도 답을 바꿉니다. openjev와 예제 서버는 같은 가중치를 같은 vLLM 커밋 위에서 돌립니다. 그런데 설명을 붙인 TREC에서는 예제 서버가 44건 대 6건으로 앞섰고(p < 0.001), BANKING77에서는 77개를 한 번에 물을 수 있는 openjev가 앞섰습니다. vLLM을 옵션 하나(--async-scheduling)만 더해 다시 띄워도 예제 서버의 답이 154건 중 28건 바뀌었습니다. 정확도는 두 건 안쪽이었고, 같은 옵션으로 연달아 돌리면 답이 한 건도 바뀌지 않았습니다.
무엇을 고를까
- 선택지가 몇 개뿐이고 영어이며 지연이 중요하다면: laya입니다. 421M 모델이 GPU에서 23ms에 답하고, 설명이 없어도 되며, TREC에서 학습시킨 분류기에 몇 %p 차이까지 따라왔습니다. 다만 대표 수치를 믿기 전에, 내 과제가 laya가 이미 학습한 과제는 아닌지 확인해야 합니다.
- 선택지가 수십 개라면: 여기 셋 중 무엇도 작은 분류기 학습을 대신하지 못합니다. 라벨 붙은 예시가 수천 건 있으면 작은 분류기를 학습시키는 편이 낫습니다. BANKING77에서 MiniLM과 로지스틱 회귀는 모든 도구를 20%p 넘게 앞섰고, TREC에서는 설명을 붙인 laya와 차이가 없었습니다(32건 대 41건, p = 0.35). 라벨이 없다면 제가 잰 오픈소스 중에는 openjev(67%)가 가장 낫고, 26B 모델을 올릴 GPU가 필요합니다.
- NanoJev: 텍스트 분류용이 아닙니다. 게임 결정 모델이고, 제작자의 수치도 게임에서 나온 것입니다.
이 결과로 말할 수 없는 것
GPU 한 장, 한 번에 한 요청, 데이터셋마다 지시문 하나로 쟀고, 각 프로젝트 문서가 권하는 것 이상으로 조정하지 않았습니다. openjev는 원래 NVFP4 체크포인트로 돌리지만 A100은 FP4를 직접 지원하지 않아 bf16 가중치를 썼습니다. openjev의 Docker 이미지는 vLLM을 두 군데 고칩니다(라벨 id 한도 128→512, 이미지 어텐션). 저는 고치지 않은 커밋에 붙였고, 텍스트만 쓰는 라벨 77개짜리 과제에는 두 수정 모두 해당하지 않습니다. TREC와 AG News에서 예제 서버는 질문 이름 intent를 모델에게 보여 줬고, openjev는 질문 이름을 숨깁니다. 확률이 실제 정답률과 맞는지는 재지 않았고, 각 도구가 1순위로 고른 답만 채점했습니다. 위의 Jev 수치는 이 표본에서 잰 것이 아닙니다.
측정 환경: A100 80GB PCIe 한 장, 드라이버 580.178.04. laya 0.3.7과 NanoJev unified-games-v1은 torch 2.14.0+cu130, transformers 5.17. openjev 0.4.0과 vLLM 예제 서버는 vLLM 1b3b88e(--async-scheduling, 캔버스 64), google/diffusiongemma-26B-A4B-it bf16, 노이즈 추출 1회(samples: 1). BANKING77 표의 예제 서버 행(54.5%)은 직전 글에서 --async-scheduling 없이 잰 값이고, openjev와의 건별 비교에는 openjev와 같은 vLLM에서 다시 잰 결과(82건)를 썼습니다. 지시문은 "Which intent does this banking customer's message express?", "What kind of answer does this question ask for?", "Which topic is this news article about?"입니다. NanoJev는 선택지마다 설명이 필수라, 설명을 주지 않은 조건에서는 라벨 이름을 설명으로 넣었습니다. BANKING77(PolyAI, CC-BY-4.0), TREC(Li & Roth), AG News(Zhang et al.) 테스트셋, 표본 시드 20260918. 짝지은 예측에 양측 정확 McNemar 검정을 썼습니다. 측정일 2026-09-23.
이메일로 받아보기
관련 포스트
10분 만에 이해하는 Jev: 빠른 판단 모델은 언제 쓸모 있나
Jev는 글로 답하지 않고 선택지마다 확률을 매겨 돌려주는 모델입니다. 이런 모델이 왜 필요한지, 오픈소스는 같은 일을 어떻게 하는지, 그리고 세 번에 걸쳐 직접 재 본 결과를 정리했습니다. 선택지가 몇 개뿐이면 421M 모델이 23ms에 86.6%를 맞혔고, 77개면 CPU에서 도는 작은 분류기가 90%로 여전히 앞섰습니다.
DiffusionGemma vLLM 예제 서버, 입력 설명 한 문장에 54.5%가 31.8%로
DiffusionGemma를 결정 모델로 쓰게 해 주는 vLLM 풀 리퀘스트가 병합됐습니다. 그 예제 서버를 A100에서 돌려 BANKING77 154건을 쟀습니다. 질문 하나에 선택지를 26개까지만 받아서 의도 77개를 아홉 그룹으로 나눠 두 번 읽었고, 노이즈 추출 1회로 54.5%(119ms), 기본 설정으로 51.3%가 나왔습니다. 같은 두 단계 읽기를 transformers로 옮긴 제 구현은 68.2%였고, 예제 서버에 입력을 설명하는 문장 하나를 넣자 54.5%가 31.8%로 떨어졌습니다.
Jev의 속도 주장, 라벨만 필요한 분류에도 적용될까? BANKING77 기준선 실측
BANKING77 테스트셋에서 라벨만 출력하는 네 가지 분류 방식을 같은 메시지 154건으로 비교했습니다. MiniLM 임베딩과 로지스틱 회귀는 CPU에서 정확도 90.3%, 지연 중앙값 6.8ms를 기록했습니다. Jev 자체는 아직 측정하지 않았습니다.