10분 만에 이해하는 Jev: 빠른 판단 모델은 언제 쓸모 있나
Jev는 글로 답하지 않고 선택지마다 확률을 매겨 돌려주는 모델입니다. 이런 모델이 왜 필요한지, 오픈소스는 같은 일을 어떻게 하는지, 그리고 세 번에 걸쳐 직접 재 본 결과를 정리했습니다. 선택지가 몇 개뿐이면 421M 모델이 23ms에 86.6%를 맞혔고, 77개면 CPU에서 도는 작은 분류기가 90%로 여전히 앞섰습니다.
10분 만에 이해하는 Jev: 빠른 판단 모델은 언제 쓸모 있나
운전하다 빨간불을 보면 발은 이미 브레이크에 가 있습니다. 이걸 한 시간씩 고민하는 사람은 없습니다. 이직을 할지 말지는 다릅니다. 며칠을 두고 장단점을 적어 보고, 믿을 만한 사람에게 묻습니다. 사람이 두 종류의 판단을 다 잘하는 것은 둘을 상황에 맞게 나눠 쓰기 때문입니다. 빨간불 앞에서 신중하게 따지기 시작하면 사고가 납니다.
그런데 지금 많은 AI 에이전트가 빨간불마다 고민하고 있습니다. 이 문의가 급한 건인지, 어느 팀으로 보낼지, 이 도구 호출이 안전해 보이는지 같은 작은 판단까지, 코드를 짜는 바로 그 큰 모델에게 매번 맡겨 글로 답을 받는 경우가 많습니다. 답이 네 개 중 하나인 질문치고는 느리고 비쌉니다.
TypeSafe가 9월 15일에 내놓은 Jev는 이 빠른 쪽을 맡으려고 만든 모델입니다. 공식 문서도 이렇게 설명합니다. "System One 모델은 빠르고 초점이 분명한 판단을 위해 만들어졌습니다. 맥락이 주어졌을 때 잘 아는 사람이 1초 만에 내릴 수 있는 판단을 물으세요(System One models are built for fast, focused judgments. Ask for a judgment a knowledgeable person makes in a second given the right context)."
Jev가 하는 일
판단할 대상인 상태(state)와, 유형이 정해진 질문들을 함께 보냅니다. 상태는 대화나 기록을 담은 JSON인 경우가 많습니다. 질문 유형은 셋입니다.
- 예·아니오(Jev는
noul이라고 부릅니다): 답이 "예"일 확률을 돌려줍니다. - 선택: 선택지마다 확률을 돌려줍니다. TypeSafe는 선택지를 255개까지 받는다고 밝혔고, 외부 시험에서도 256개부터는 요청이 실패했습니다.
- 점수: 순서가 있는 단계마다 확률을 돌려줍니다.
글을 쓰지 않으니 답을 해석할 필요가 없고, 선택지 밖의 답이 나올 수도 없습니다. TypeSafe는 출시 글에서 응답 시간을 70~500ms로 밝혔습니다.
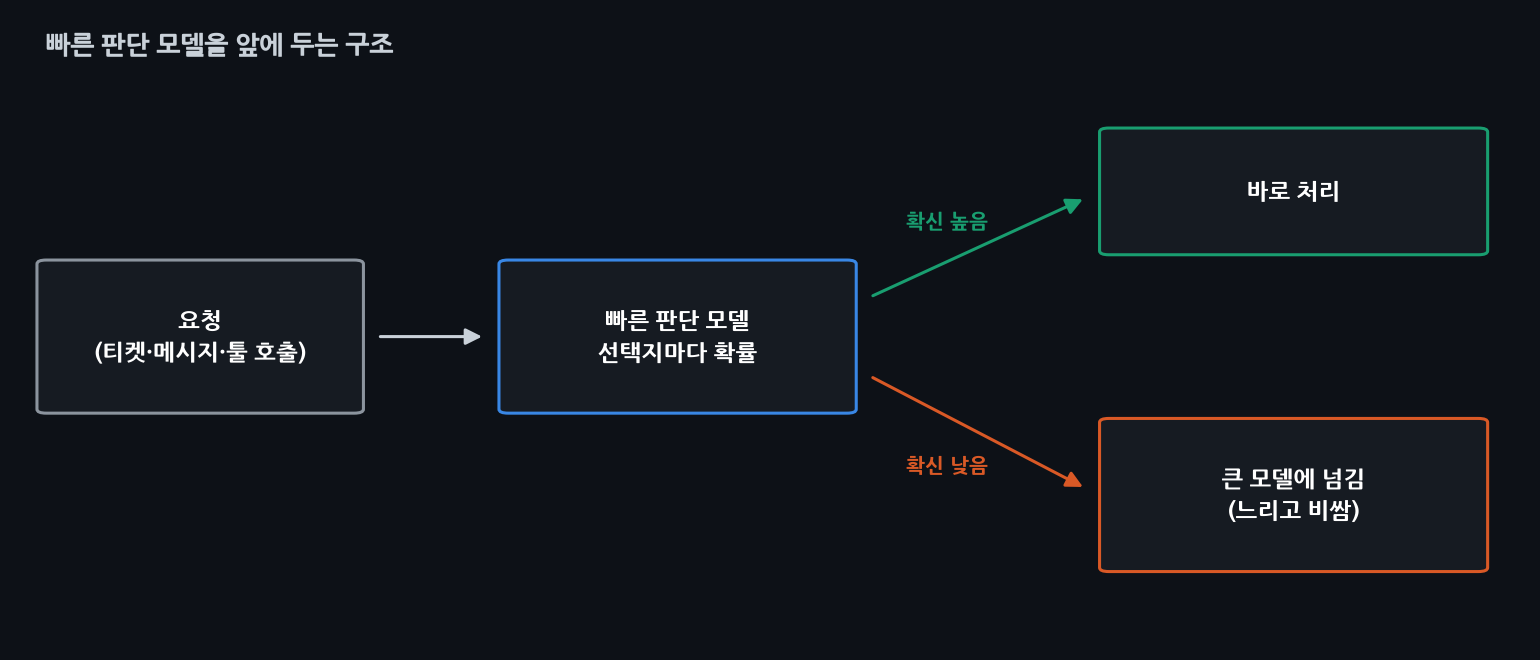
쓸모는 확률에서 나옵니다. 모델이 확신하는 답은 바로 처리하고, 확신이 낮은 것만 느리지만 더 똑똑한 모델에게 넘길 수 있습니다.
글을 쓰지 않고 답하는 방법
TypeSafe는 Jev의 내부를 개략적으로만 밝혔습니다. 새 모델 구조, 효율을 위한 병렬 샘플러, 그리고 RLCD(Reinforcement Learning for Calibrated Decisions)라는 학습법을 썼고, 모든 출력을 한 번의 요청으로 낸다는 정도입니다. 세부는 공개되지 않았습니다. 같은 방식의 인터페이스를 제공하는 오픈소스 프로젝트들은 두 가지 방법을 씁니다.
- 인코더에 분류 헤드 달기. laya는 ModernBERT 인코더(421M)로 상태와 선택지를 함께 읽고, 한 번의 계산으로 모든 선택지에 점수를 매깁니다. laya도 자기 학습법을 RLCD라고 부릅니다.
- 확산 언어 모델에서 한 번에 읽기. vLLM 풀 리퀘스트는 DiffusionGemma의 캔버스에 답안 틀을 써 두고 한 칸만 비운 뒤, 디노이즈를 한 번 돌려 그 칸에 올 라벨마다 확률을 읽습니다. openjev는 이것을 Jev와 같은 API로 감쌌습니다.
제 측정에서 둘 다 GPU 한 장으로 요청 하나에 23~120ms가 걸렸습니다(DiffusionGemma는 노이즈 추출 1회 기준). 토큰을 하나씩 생성하지 않기 때문입니다.
직접 재 보니
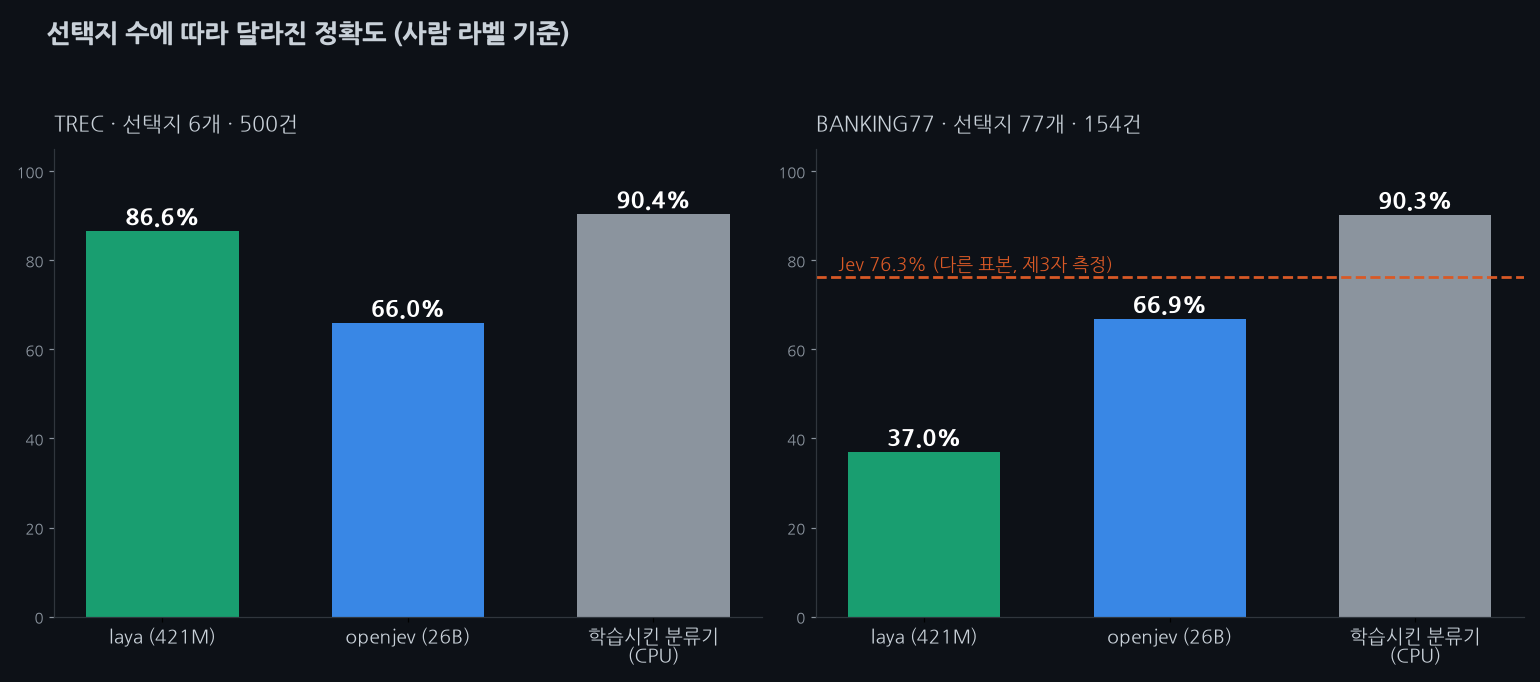
글 세 편에 걸쳐 사람이 라벨을 붙인 공개 데이터셋으로 이 모델들을 쟀습니다. A100 한 장에서 한 번에 한 요청씩입니다. 저는 Jev를 쓸 수 없어서, 아래의 Jev 수치는 다른 사람이 다른 표본으로 잰 값입니다.
눈에 띈 것은 세 가지입니다.
선택지 수가 승자를 바꿉니다. 질문 유형이 6개인 TREC에서 laya는 23ms에 86.6%를 맞혔습니다. 공개된 학습 데이터 목록에 TREC가 없는데도 그렇습니다. 그런데 은행 의도가 77개인 BANKING77에서는 같은 모델이 37.0%로 떨어졌습니다. 모든 선택지가 입력 안에서 정해진 토큰 예산을 나눠 쓰는데, 77개면 서로 자리를 빼앗기기 때문입니다. 문서가 권하는 두 가지 조치를 쓰면 나아집니다. 토큰 예산을 512로 늘리면 46.1%, 임베딩 모델로 후보를 20개까지 먼저 줄이면 59.1%였습니다. 그 과제에서 가장 나은 오픈소스는 DiffusionGemma 기반 openjev(66.9%)였습니다. (자세히)
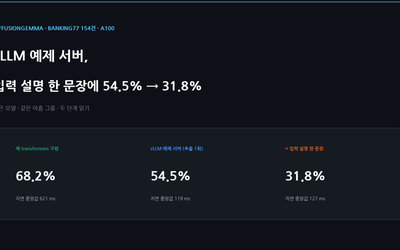
라벨도 프롬프트입니다. 라벨 이름만 주면 DiffusionGemma는 TREC의 "사람" 질문을 거의 하나도 맞히지 못했습니다. human이라는 이름을 글자 그대로 읽은 것으로 보입니다. 라벨마다 한 줄 설명을 붙이자 vLLM 예제 서버는 20%p, openjev는 14%p가 올랐습니다. 주변 문구도 영향을 줍니다. 예제 서버에 과제 설명 한 문장을 넣자 BANKING77 정확도가 54.5%에서 31.8%로 떨어졌습니다. (라벨, 과제 설명 문장)
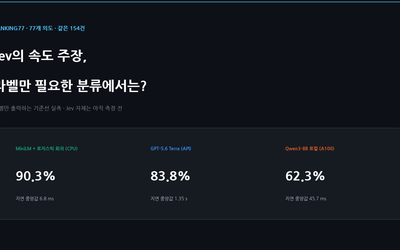
작은 분류기를 이기기는 어렵습니다. 문장 임베딩에 로지스틱 회귀를 얹어 그 데이터셋의 라벨 붙은 예시로 학습시키면, 두 과제 모두 CPU에서 10ms 안쪽에 약 90%가 나왔습니다. 선택지 77개에서는 제가 잰 모든 판단 모델보다 높았고, 다른 표본으로 제3자가 잰 Jev 수치보다도 높았습니다. (BANKING77, TREC)
판단 모델이 쓸모 있을 때
잘 맞는 경우입니다.
- 라벨 붙은 예시가 아직 없고, 선택지가 몇 개뿐일 때. 급한지 아닌지, 다섯 팀 중 어디인지, 안전한지 아닌지 같은 질문입니다. 판단 모델은 예시 없이도 답합니다. 라벨이 생기면 선택지가 6개여도 작은 분류기가 더 높았습니다(TREC에서 90.4% 대 laya 86.6%. 한쪽만 맞힌 질문은 57건 대 38건, p = 0.06으로 유의 수준에 조금 못 미칩니다).
- 확신도에 따라 나누고 싶을 때. 확실한 답은 바로 처리하고, 나머지는 큰 모델이나 사람에게 넘깁니다.
- 같은 판단을 아주 많이 반복할 때. 한 번에 수십 ms와 몇 초의 차이는 쌓이면 커집니다.
한 번 더 생각해 볼 경우입니다.
- 선택지가 수십 개일 때. 라벨 붙은 예시가 수천 건 있다면 작은 분류기를 학습시키는 편이 낫습니다. 위의 두 과제에서 가장 빠르고 가장 정확했습니다. TREC에서는 설명을 붙인 laya가 2%p 차이까지 따라왔지만 유의한 차이는 아니었습니다.
- 라벨 이름이 모호할 때. 선택지마다 한 줄 설명을 쓰고, 내 데이터로 시험해 봅니다.
- 확률 값 자체를 믿고 움직일 때. laya 문서는 기본 상태에서 확신이 과하게 나오니 내 데이터로 온도를 먼저 맞추라고 권합니다. 저는 확률이 실제 정답률과 맞는지는 재지 않았습니다.
- 남이 낸 벤치마크를 볼 때. 그 데이터셋이 모델의 학습 데이터에 들어 있었는지 확인합니다. 예를 들어 laya 문서는 AG News를 학습 데이터로 적고 있고, 거기서 laya는 94.5%를 냈습니다.
더 읽을거리
- Jev의 속도 주장, 라벨만 필요한 분류에서는: BANKING77 기준선
- DiffusionGemma 한 스텝 읽기를 vLLM 예제 서버로 재 보니
- 오픈소스 Jev 대안 셋을 같은 데이터로 재 보니
출처: TypeSafe 출시 글(내부 구조 개요, 선택지 255개 한도, 70~500ms)과 공식 문서. 256개부터 실패한다는 시험과 BANKING77 76.3%는 nibzard의 결정 모델 벤치마크에서 가져왔습니다. 나머지 수치는 위에 링크한 세 편의 측정 결과입니다. A100 80GB 한 장, 한 번에 한 요청, 측정일 2026-09-18~2026-09-23.
이메일로 받아보기
관련 포스트
오픈소스 Jev 대안 셋을 같은 데이터로 재 보니: laya·openjev·NanoJev 실측
laya, openjev, NanoJev를 A100 한 장에서 BANKING77(의도 77개), TREC(질문 유형 6개), AG News로 쟀습니다. 선택지가 6개면 421M짜리 laya가 TREC 86.6%를 23ms에 냈고, 77개면 DiffusionGemma 기반 openjev가 66.9%로 앞섰습니다. 다만 77개에서는 CPU에서 도는 로지스틱 회귀가 90%로 전부를 이겼습니다.
DiffusionGemma vLLM 예제 서버, 입력 설명 한 문장에 54.5%가 31.8%로
DiffusionGemma를 결정 모델로 쓰게 해 주는 vLLM 풀 리퀘스트가 병합됐습니다. 그 예제 서버를 A100에서 돌려 BANKING77 154건을 쟀습니다. 질문 하나에 선택지를 26개까지만 받아서 의도 77개를 아홉 그룹으로 나눠 두 번 읽었고, 노이즈 추출 1회로 54.5%(119ms), 기본 설정으로 51.3%가 나왔습니다. 같은 두 단계 읽기를 transformers로 옮긴 제 구현은 68.2%였고, 예제 서버에 입력을 설명하는 문장 하나를 넣자 54.5%가 31.8%로 떨어졌습니다.
Jev의 속도 주장, 라벨만 필요한 분류에도 적용될까? BANKING77 기준선 실측
BANKING77 테스트셋에서 라벨만 출력하는 네 가지 분류 방식을 같은 메시지 154건으로 비교했습니다. MiniLM 임베딩과 로지스틱 회귀는 CPU에서 정확도 90.3%, 지연 중앙값 6.8ms를 기록했습니다. Jev 자체는 아직 측정하지 않았습니다.