llama-server의 -c는 VRAM 추정식 말고 두 번 띄워서 정하세요: 확인한 일곱 길이에서 로드 메모리를 1MiB 안쪽으로 맞혔고, 추정식은 Gemma 3 128K에서 13.7GiB를 더 잡았습니다
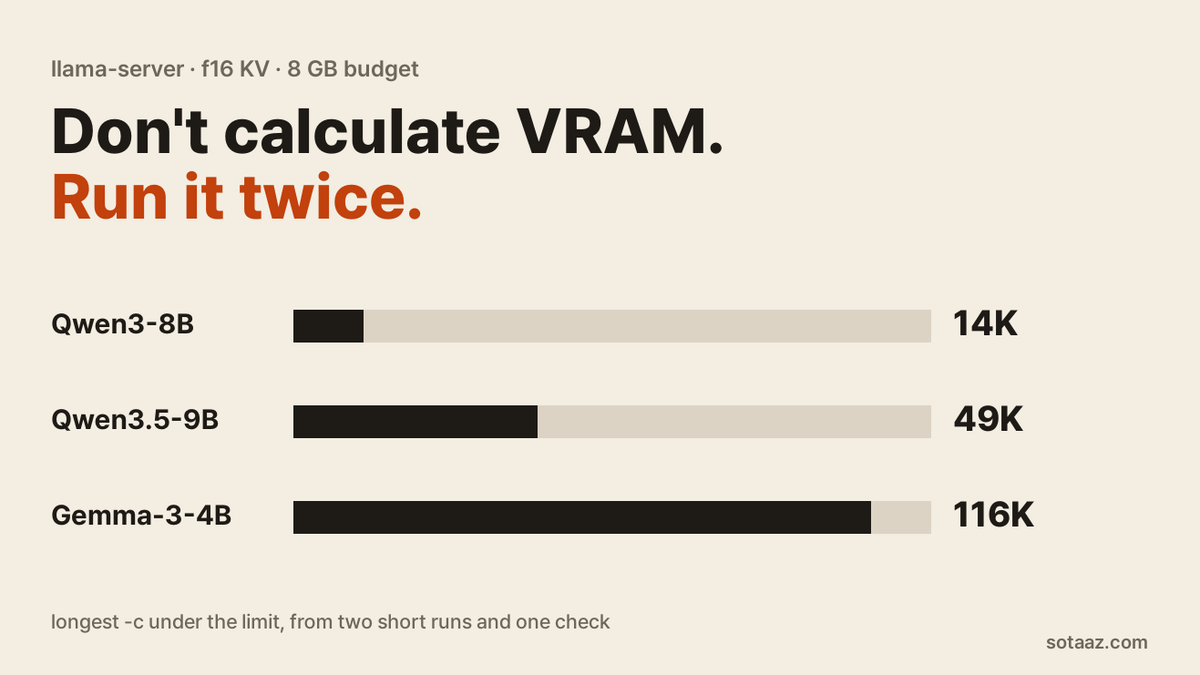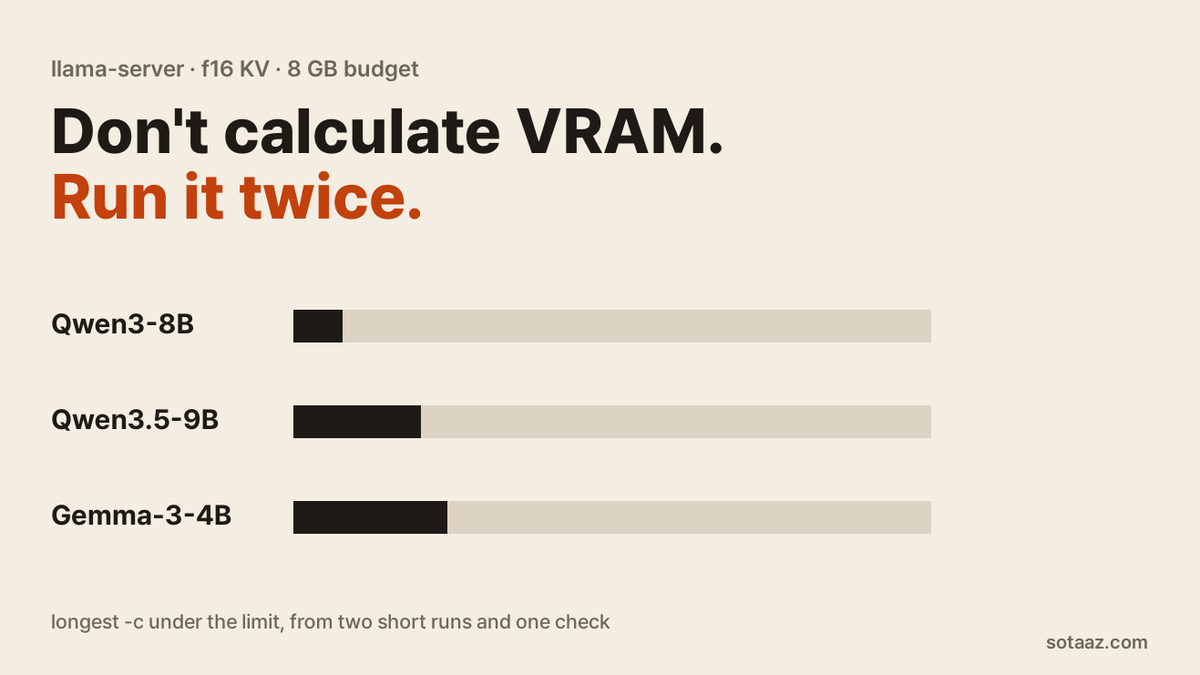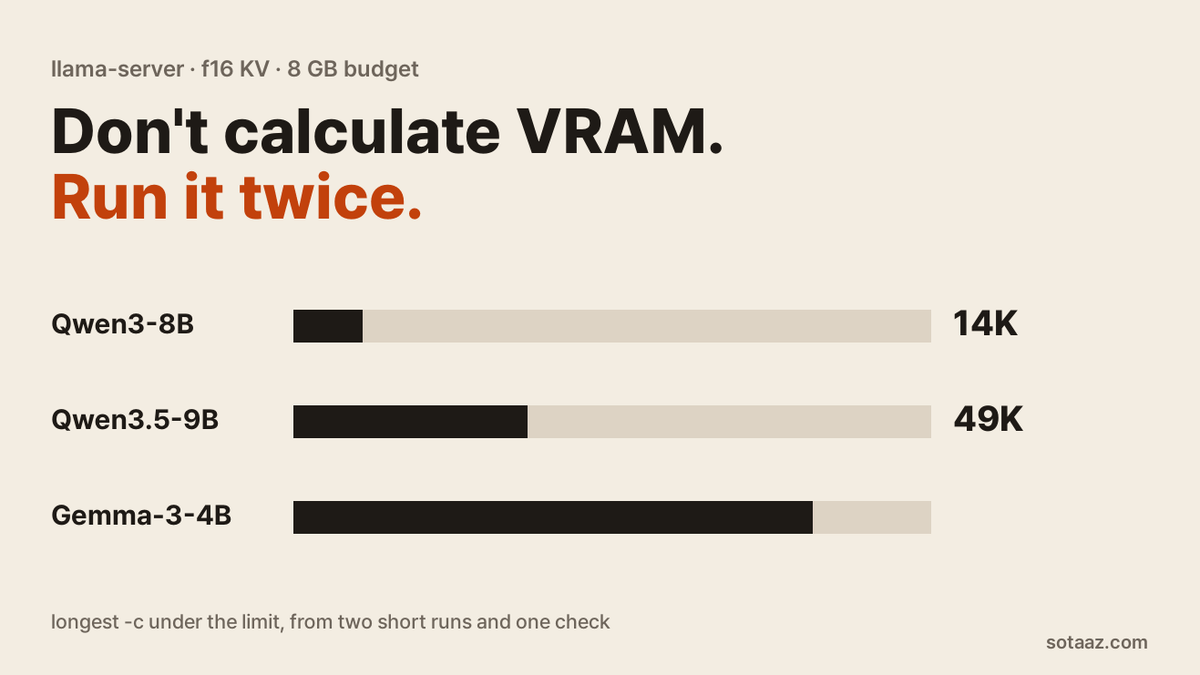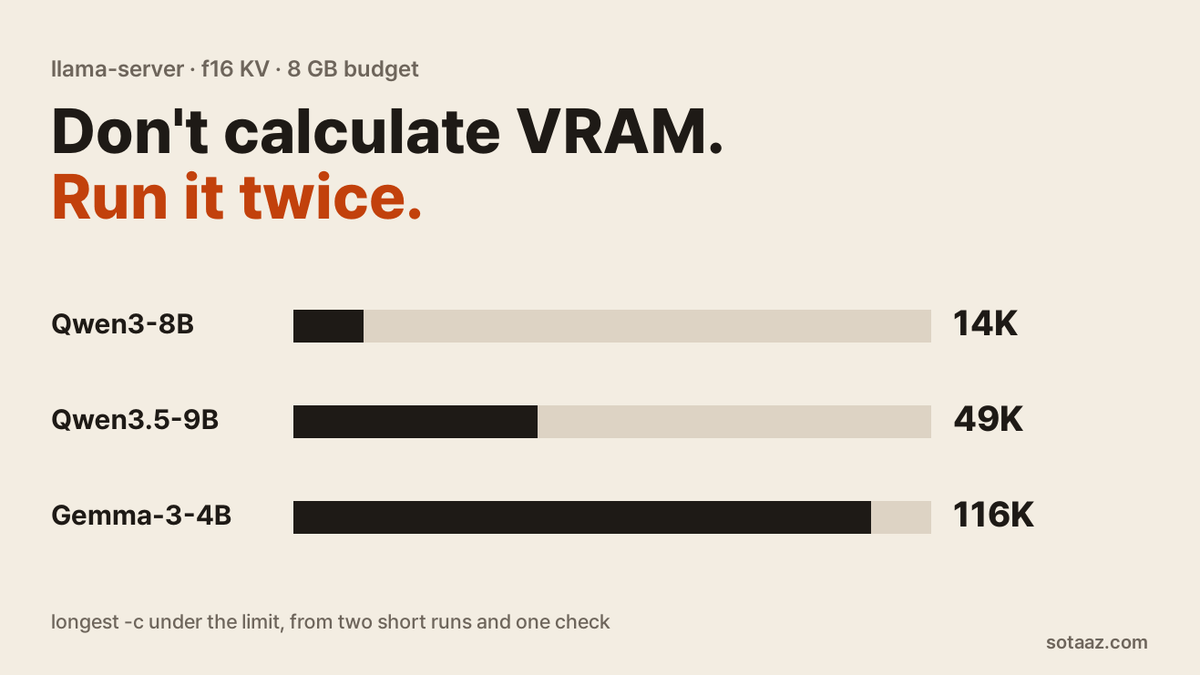
Qwen3-8B, Qwen3.5-9B, Gemma 3 4B를 llama-server로 4K와 8K에서 한 번씩 띄워 메모리 두 값으로 직선을 긋고, 메모리 예산에 들어가는 가장 긴 -c를 골랐습니다. 그 길이로 다시 띄운 일곱 길이에서 직선은 로드 직후 메모리를 1MiB 안쪽으로 맞혔습니다. 프롬프트 처리 중 12-14MiB가 더 붙어 두 길이가 예산을 넘었고, 그래서 16MiB를 더 뺍니다. 모든 층을 전체 어텐션으로 보는 단순 추정식은 Gemma 3 128K에서 13.7GiB를 더 잡았습니다.
llama-server의 -c는 VRAM 추정식 말고 두 번 띄워서 정하세요
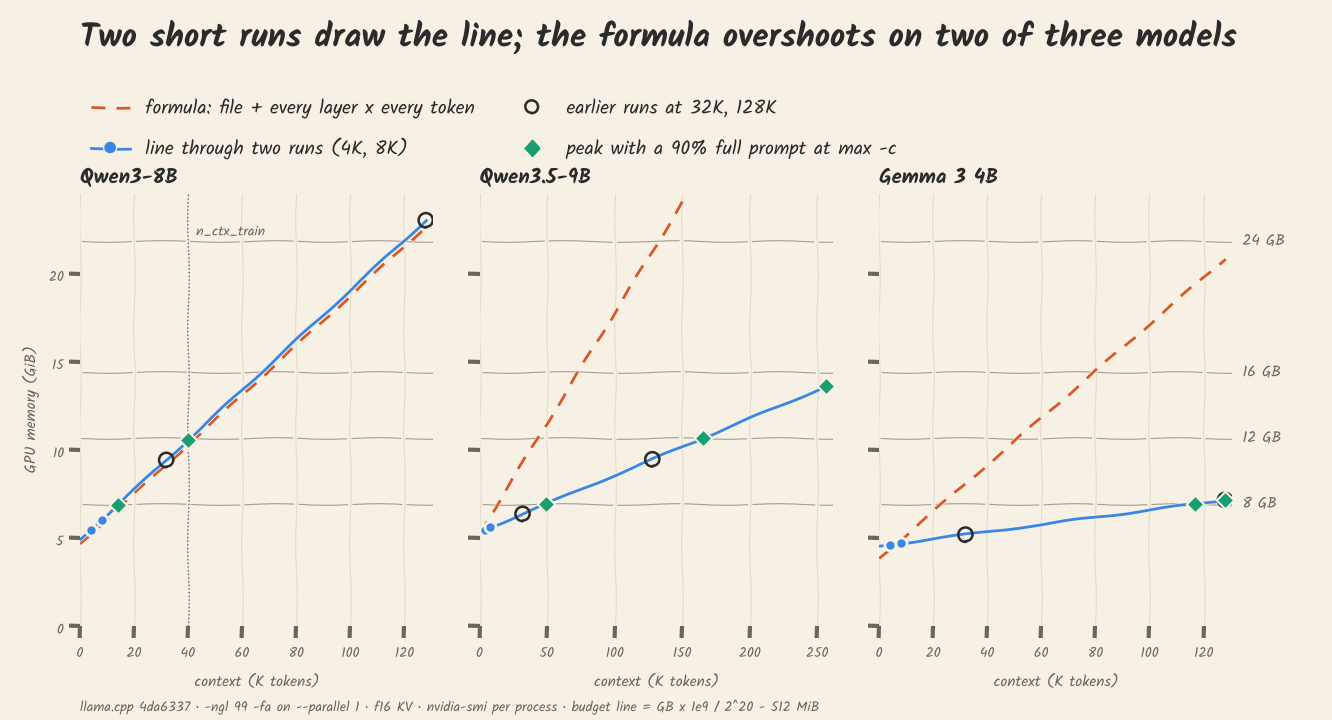
모든 층이 지금까지 들어온 토큰을 전부 KV 캐시(토큰마다 저장해 두는 중간 계산값)에 담는다고 보는 흔한 VRAM 추정식으로 계산하면, Gemma 3 4B를 컨텍스트 128K로 띄우는 데 20.9GiB가 필요합니다. 24GB 카드가 있어야 한다는 숫자입니다. 같은 설정으로 llama-server를 띄워 보니 7.2GiB를 썼습니다. 그런데 4K에서는 같은 식이 실측과 251MiB 차이로 거의 맞았습니다. 짧은 길이에서 맞춰 보면 식이 맞아 보이고, 길게 갈수록 벌어진다는 뜻입니다.
그래서 계산하지 않고 재는 방법을 정리했습니다. llama-server를 컨텍스트 4K와 8K로 한 번씩 띄워 GPU 메모리를 잽니다. 가로축을 컨텍스트 길이, 세로축을 메모리로 두고 이 두 점을 잇는 직선을 긋습니다. 직선에서 메모리 예산에 들어가는 가장 긴 -c를 읽고(이 글에서는 이 값을 "최대 -c"라고 부릅니다), 그 길이로 한 번 더 띄워 확인합니다. 확인용으로 띄운 일곱 길이에서 이 직선은 로드 직후 메모리를 1MiB 안쪽으로 맞혔습니다. 이 방법을 만들기 전에 재 둔 32K·128K 값도 MiB 단위까지 똑같이 나왔지만, 이 값들은 이미 본 숫자라 결과를 모르고 맞힌 것은 아닙니다.
한 번은 틀렸습니다. 프롬프트를 처리하는 동안 12-14MiB가 더 붙어, 처음 고른 길이 가운데 모델 상한에 걸리지 않은 네 개 중 두 개가 예산을 4MiB, 11MiB 넘었습니다. 그래서 예산에서 16MiB를 더 빼도록 고쳤습니다. 이 글은 고친 방법과 근거 숫자, 그리고 추정식이 어디서 빗나가는지를 다룹니다.
이 글은 "내 GPU에 맞춰 로컬 모델 세팅하기" 연재의 1편입니다.
측정 조건
- 실행환경: llama.cpp
4da6337,llama-server -ngl 99 -fa on --parallel 1 -c <길이> -lv 4. KV 캐시는 기본값 f16이고, 슬롯(서버가 요청 하나를 맡는 자리)은 하나입니다. - 모델: Qwen3-8B Q4_K_M(36층 모두 전체 어텐션, 곧 앞의 모든 토큰을 KV 캐시에 저장), Qwen3.5-9B Q4_K_M(32층 중 8층만 전체 어텐션, 나머지 24층은 토큰 수와 상관없이 크기가 고정된 상태만 보관), Gemma 3 4B it Q8_0(34층 대부분이 최근 1,024토큰만 보는 슬라이딩 윈도).
- 읽은 값: 서버가 준비됐다고 알린 3초 뒤
nvidia-smi의 프로세스 메모리와, 서버 로그의common_memory_breakdown_print줄입니다. 조건마다 두 번 돌렸고, 두 번의 값은 매번 같았습니다. - GPU: A100 80GB 한 장입니다. 8·12·16·24GB 카드에서는 돌리지 않았고, 카드 대신 메모리 예산을 정해 A100에서 잰 값과 비교했습니다. 예산을 어떻게 잡았는지는 아래 3단계에 적었습니다.
측정 단계마다 결과를 보기 전에 예측을 먼저 적어 두었습니다. 추정식에 대한 예측 다섯 개, 방법에 대한 예측 네 개이고, 아홉 개 모두 글 끝에서 채점합니다.
방법: 두 번 띄워 직선을 긋고, 한 번 더 띄워 확인
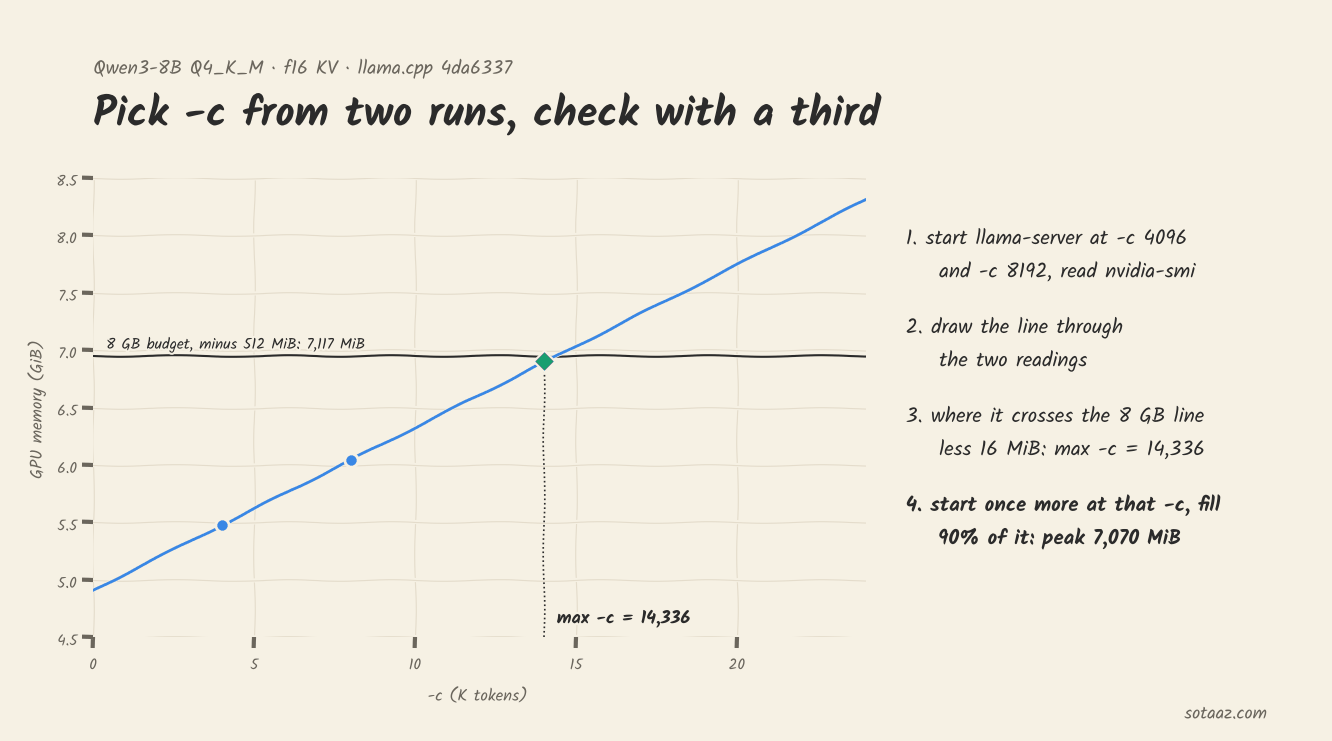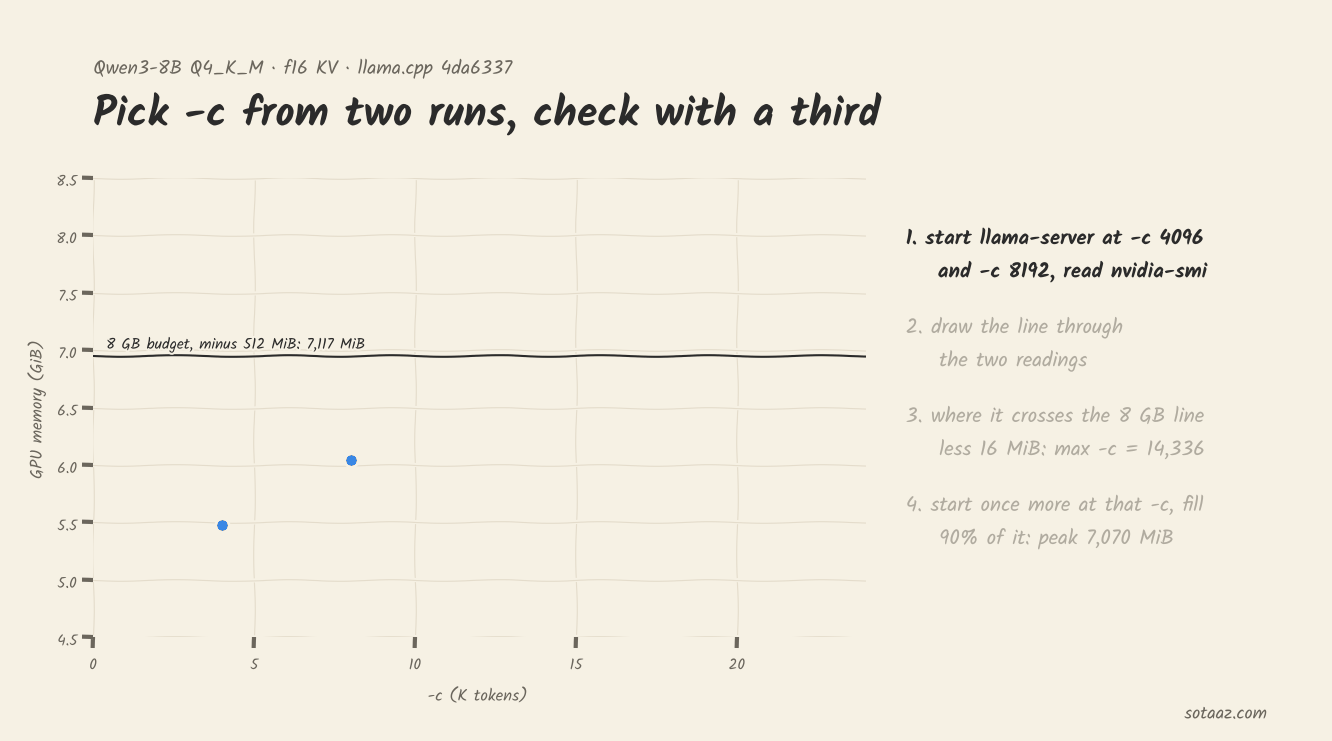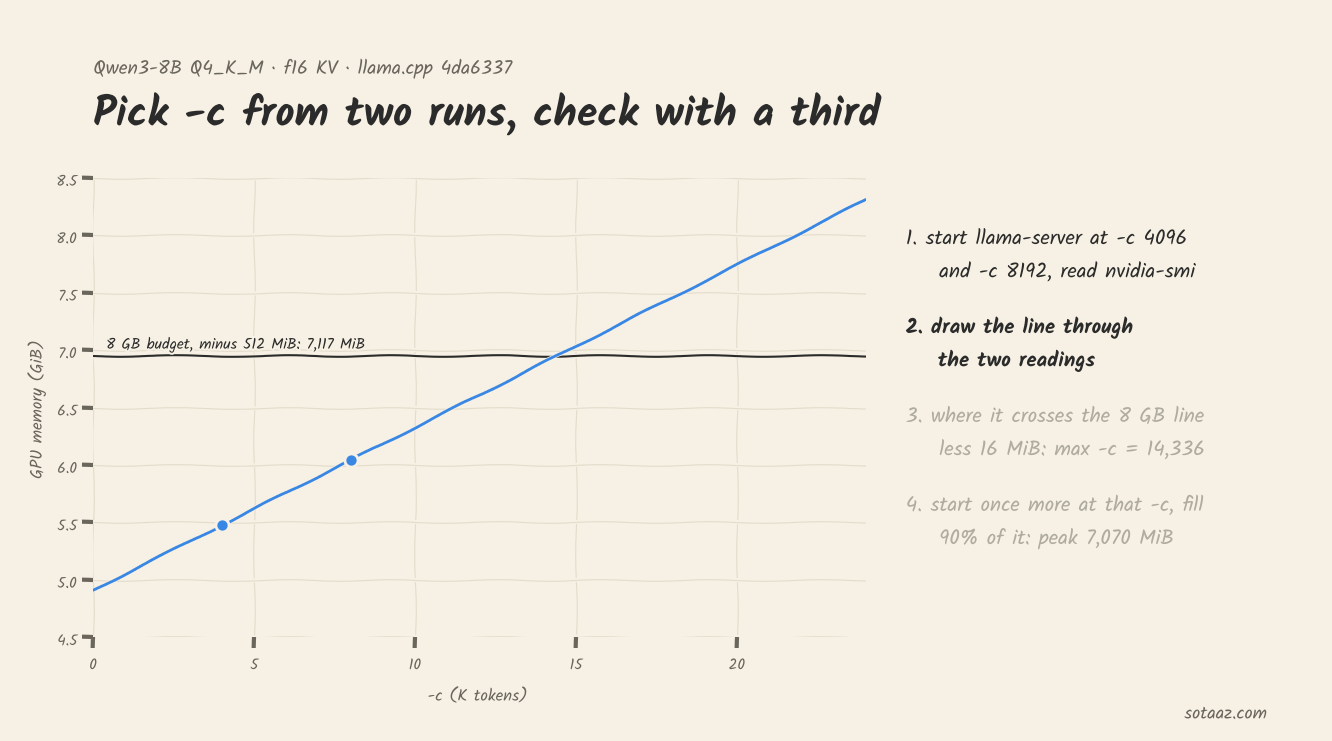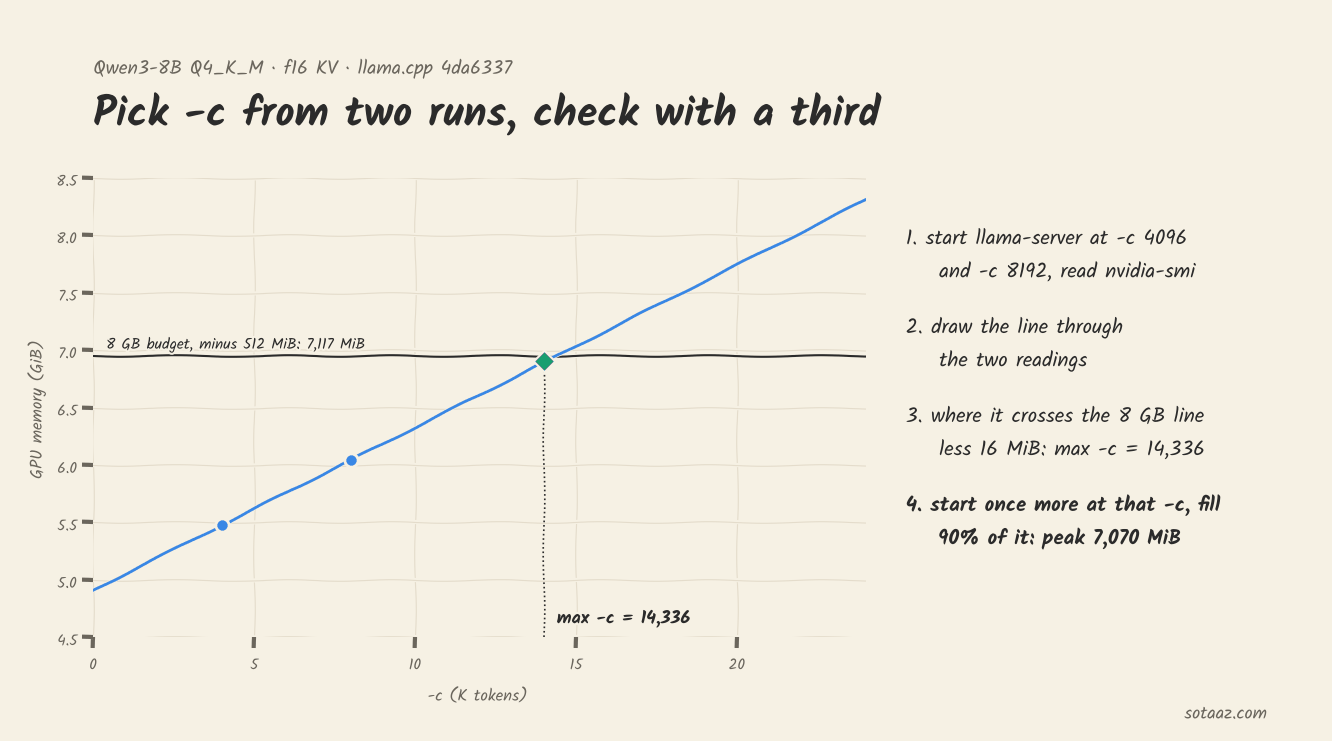
GPU 메모리는 두 종류의 조각으로 이뤄집니다. 하나는 길이와 상관없이 고정된 조각입니다(모델 가중치, 서버 로그에 잡히지 않는 약 480MiB, Qwen3.5-9B가 층마다 들고 있는 고정 크기 상태, Gemma의 슬라이딩 윈도 캐시). 다른 하나는 토큰마다 일정하게 커지는 조각입니다(전체 어텐션 층의 KV 캐시). 계산 버퍼도 커지긴 하지만, 저희 측정에서는 세 모델 모두 1K토큰당 1MiB씩 늘었습니다(Qwen3-8B는 4K, 32K, 128K에서 100, 128, 224MiB). 이것도 직선입니다. 그러니 길이 두 개에서 잰 두 값이면 직선 전체를 그을 수 있습니다. 어느 층이 모든 토큰을 저장하는지 몰라도 됩니다. 기울기에 이미 들어 있기 때문입니다.
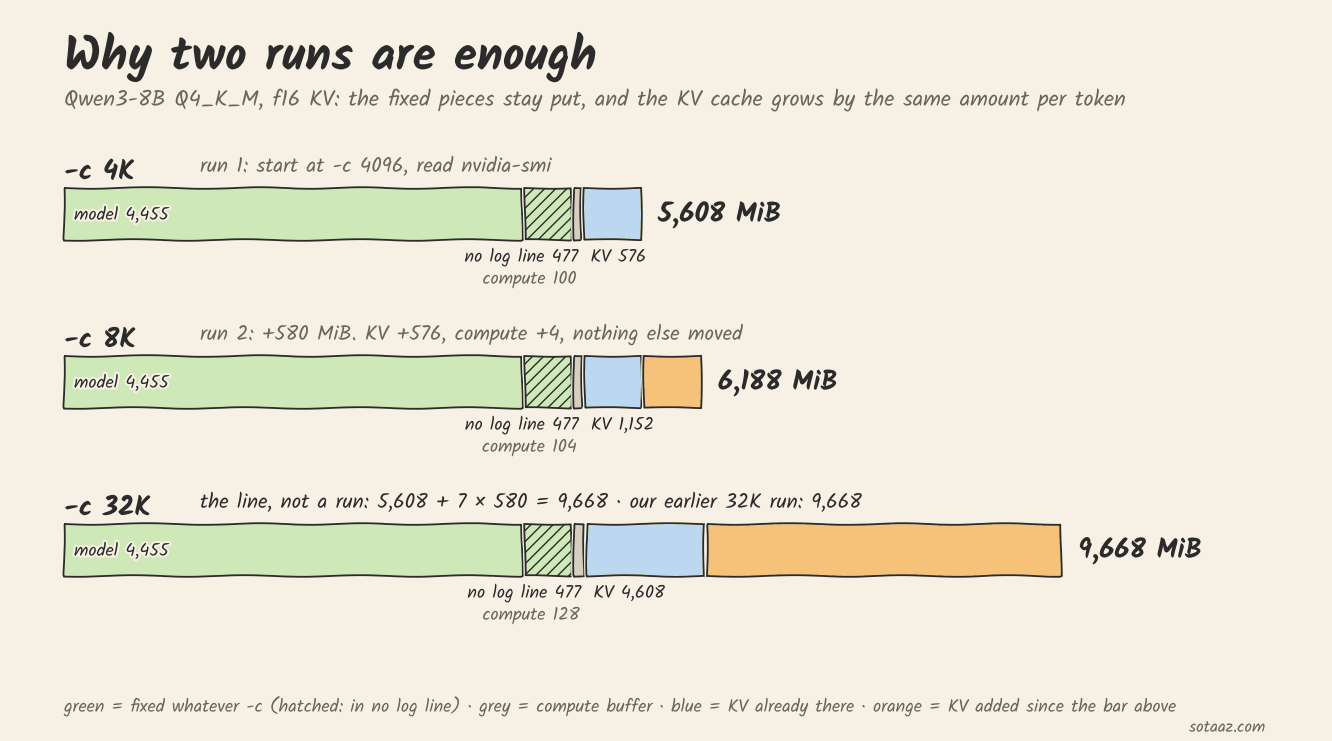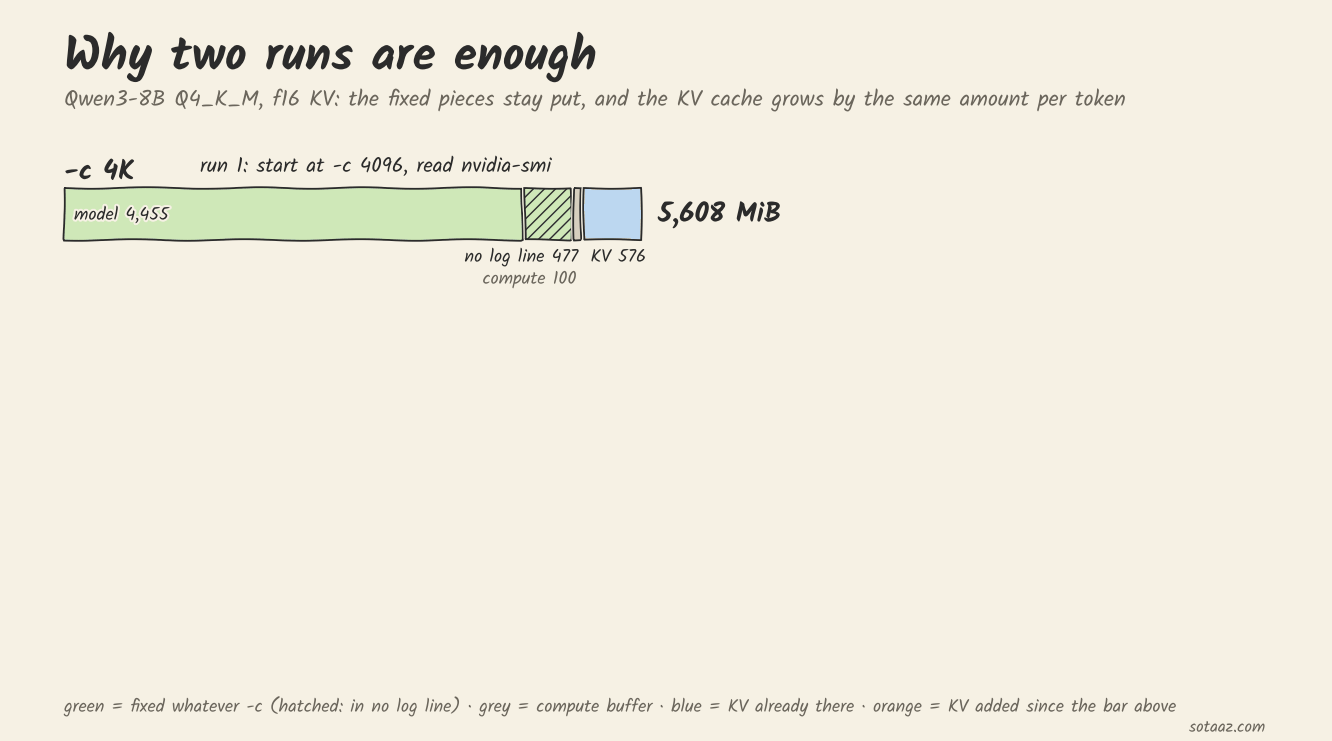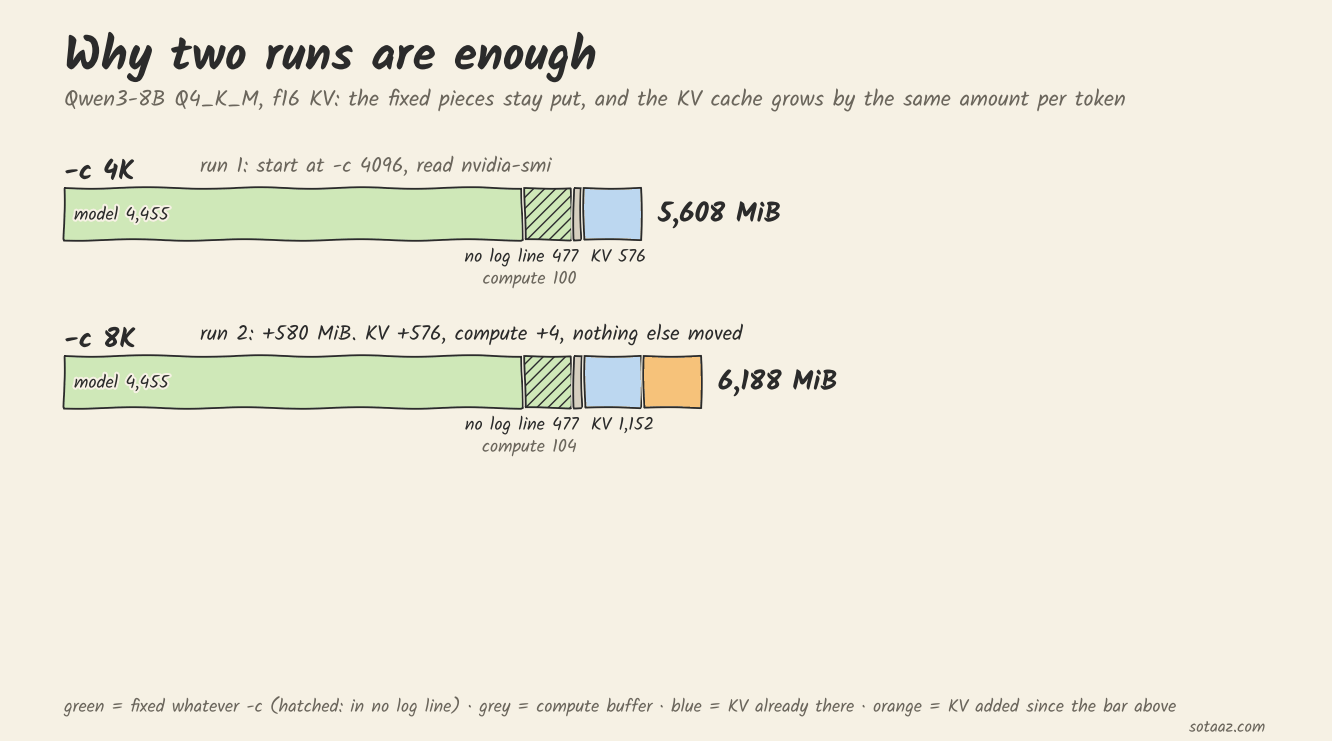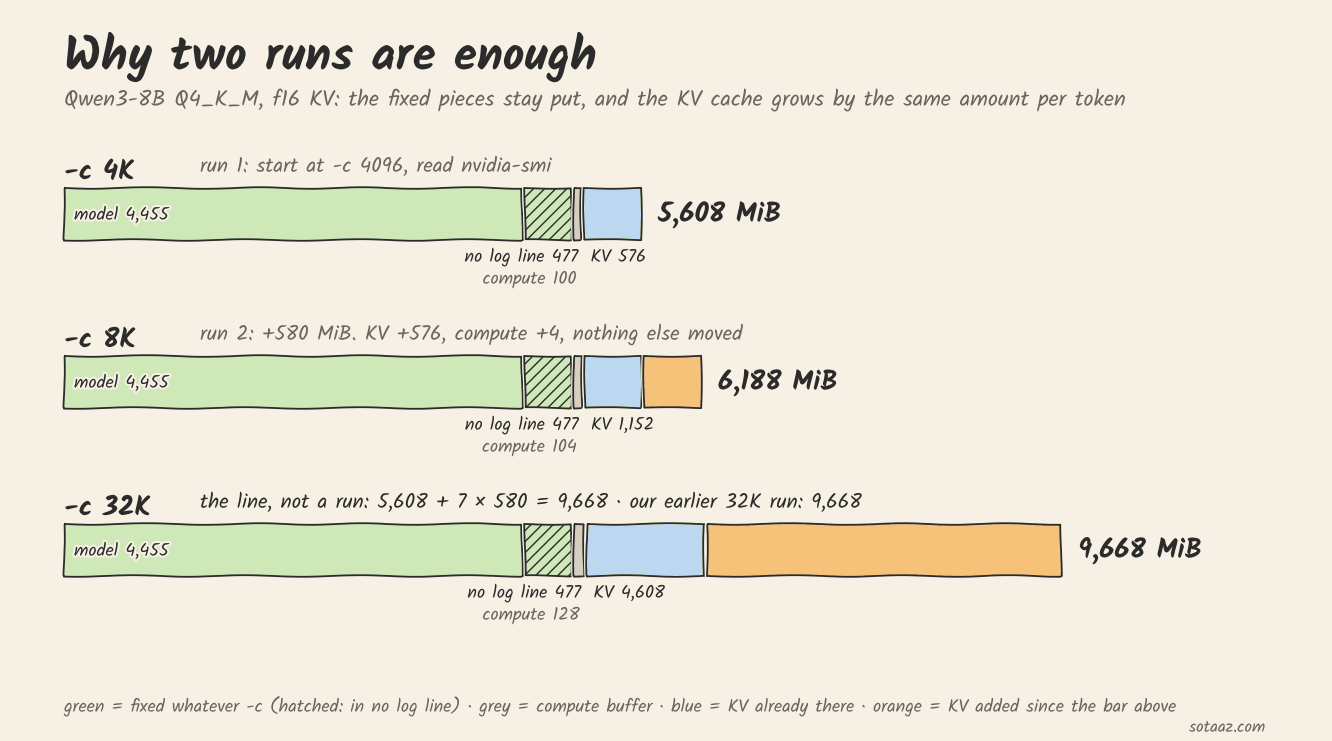
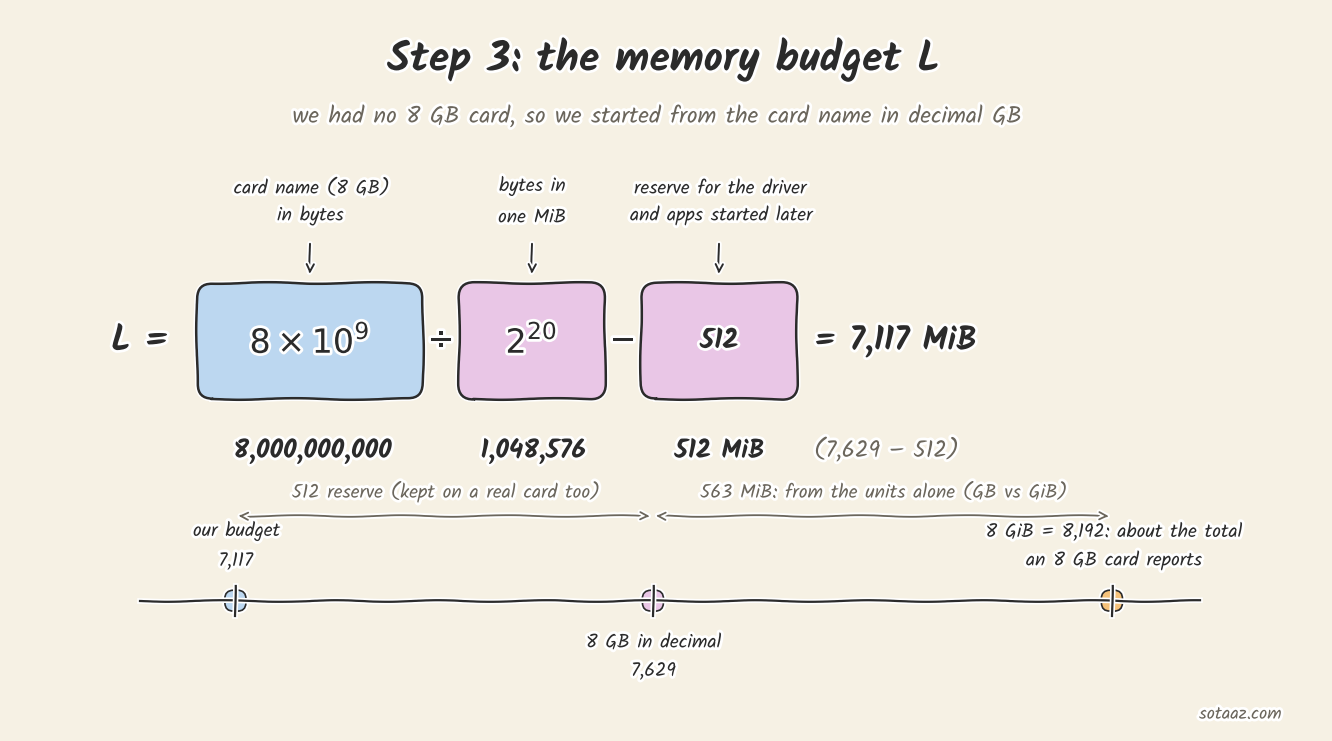
-c 4096으로 서버를 띄우고, 준비됐다는 응답이 오면nvidia-smi --query-compute-apps=pid,used_memory --format=csv로 프로세스 메모리를 읽습니다. 이 값이 M1입니다. 서버를 끕니다.-c 8192로 똑같이 합니다. 이 값이 M2입니다. 기울기는 (M2 − M1) ÷ 4,096이고, 단위는 토큰당 MiB입니다.- 메모리 예산 L을 정합니다. 서버를 띄우기 전에
nvidia-smi --query-gpu=memory.free --format=csv로 비어 있는 메모리를 읽고 512MiB를 뺍니다. 512MiB는 드라이버와 나중에 뜰 다른 프로그램 몫으로 남기는 예비분입니다. 저희는 작은 카드가 없어서, 카드 용량을 10진 GB로 보고 MiB로 바꾼 값에서 512를 뺐습니다. 8GB면 8 × 10⁹ ÷ 2²⁰ − 512 = 7,117MiB입니다. 실제 8GB 카드는 총량이 2진 단위로 8GiB(8,192MiB) 가까이 보고됩니다. 그래서 이 예산은 실제 8GB 카드보다 약 560MiB, 24GB 카드보다는 약 1.6GiB 작게, 곧 보수적으로 잡혀 있습니다. 아래 표의 "8GB"는 이 예산을 가리키는 이름입니다. - 최대 -c = 4,096 + (L − 16 − M1) ÷ 기울기를 계산하고, 1,024의 배수로 내림한 뒤, GGUF 메타데이터에 적힌 상한(
n_ctx_train)을 넘지 않게 자릅니다. 16MiB는 프롬프트 처리 몫으로, 이번 실험에서 본 12-14MiB를 덮는 보정값입니다. 이유는 아래에서 설명합니다. - 그 길이로 한 번 더 띄우고, 실제로 쓸 만큼 긴 프롬프트를 보내면서 최댓값을 봅니다. 긴 출력을 쓸 거라면 확인 실행에서 그만큼 생성해 재세요. 저희는 프롬프트를 90% 채우고 토큰 하나만 생성했습니다.
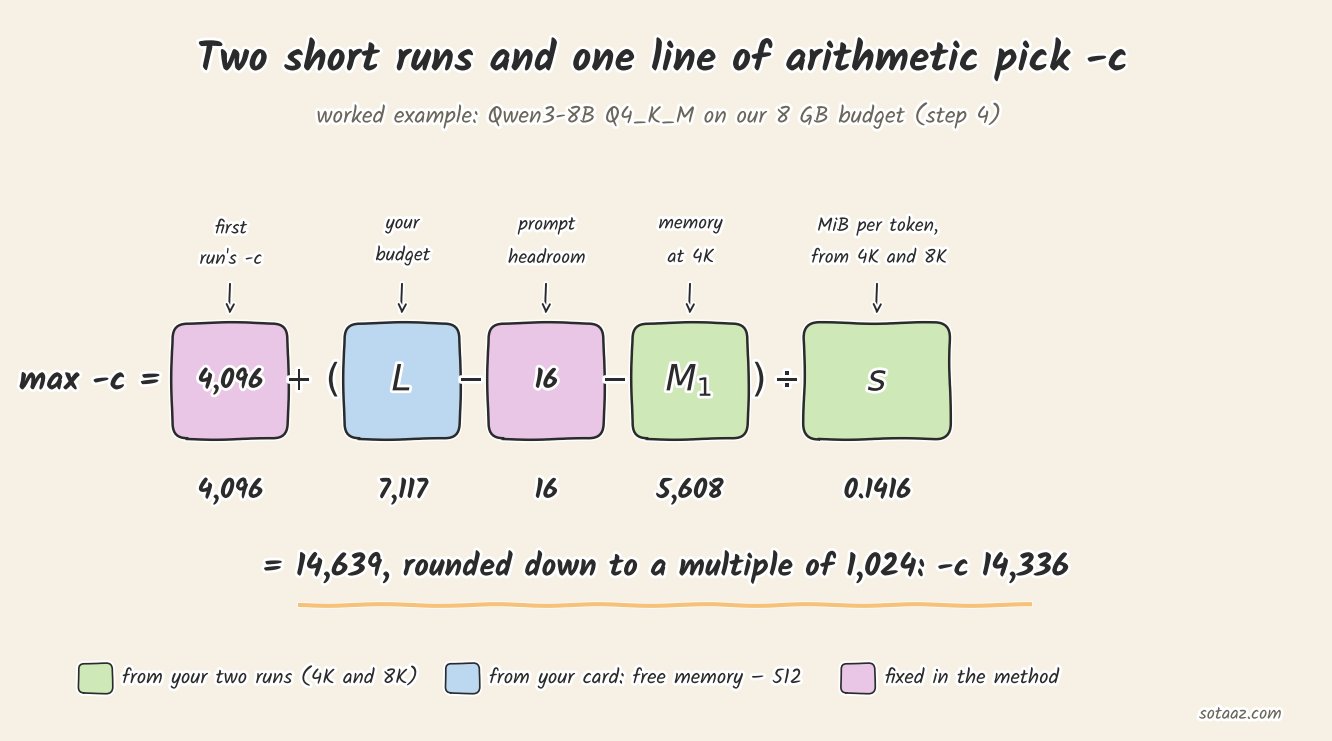
두 번째 점을 32K가 아니라 8K로 잡은 이유는 Qwen3-8B를 32K로 띄우면 9,668MiB라 8GB 카드에는 아예 올라가지 않기 때문입니다. 크기를 맞추려는 바로 그 카드에서 돌릴 수 있어야 방법이 됩니다.
직선은 맞았나
| 모델 | 4K | 8K | 기울기(MiB/1K토큰) | 직선의 32K | 실측 32K | 직선의 128K | 실측 128K |
|---|---|---|---|---|---|---|---|
| Qwen3-8B | 5,608 | 6,188 | 145 | 9,668 | 9,668 | 23,588 | 23,588 |
| Qwen3.5-9B | 5,612 | 5,744 | 33 | 6,536 | 6,536 | 9,704 | 9,704 |
| Gemma 3 4B | 4,742 | 4,826 | 21 | 5,330 | 5,330 | 7,346 | 7,346 |
4K·8K 두 점으로 그은 직선이 32K·128K 실측값 여섯 개를 MiB 단위까지 똑같이 맞혔습니다. 미리 적어 둔 예측은 '16MiB 안에서 맞힌다'였습니다. 다만 32K·128K 값은 추정식을 시험하던 첫 번째 측정에서 이미 본 숫자입니다. 그때 4K·32K 두 값으로 그은 직선이 128K를 정확히 맞혔고, 이 방법은 거기서 나왔습니다. 4K·8K 직선을 그을 때 32K·128K 값을 쓰지는 않았지만, 결과를 모르는 상태에서 맞힌 것은 아닙니다. 결과를 모르고 맞힌 근거는 다음 절의 확인 실행입니다.
최대 -c로 띄워 확인
16MiB 보정을 넣기 전의 계산으로 8·12·16·24GB 예산별 최대 -c를 정하고, 결과를 보기 전에 예측을 적어 둔 뒤 그 길이로 서버를 띄웠습니다. 아래 표에서 '직선'은 직선이 예측한 로드 직후 메모리(MiB)이고, 마지막 열이 음수면 예산을 넘었다는 뜻입니다. 서로 다른 길이마다 프롬프트를 90%까지 채워 두 번씩 돌렸고, 최댓값은 0.2초 간격으로 읽은 nvidia-smi 값 중 가장 큰 값입니다.
| 모델 | 예산 | 최대 -c | 직선 | 로드 직후 | 처리 중 최댓값(0.2초 간격) | 예산 − 최댓값 |
|---|---|---|---|---|---|---|
| Qwen3-8B | 8GB | 14,336 | 7,058 | 7,058 | 7,070 | 47 |
| Qwen3-8B | 12GB 이상 | 40,960(상한) | 10,828 | 10,828 | 10,840 | 92 |
| Qwen3.5-9B | 8GB | 50,176 | 7,097 | 7,096 | 7,110 | 7 |
| Qwen3.5-9B | 12GB | 168,960 | 10,925 | 10,924 | 10,936 | −4 |
| Qwen3.5-9B | 16GB 이상 | 262,144(상한) | 13,928 | 13,928 | 13,942 | 805 |
| Gemma 3 4B | 8GB | 119,808 | 7,115 | 7,116 | 7,128 | −11 |
| Gemma 3 4B | 12GB 이상 | 131,072(상한) | 7,346 | 7,346 | 7,358 | 3,574 |
로드 직후 메모리는 일곱 길이 모두 직선과 1MiB 안쪽으로 맞았습니다. 그런데 프롬프트를 처리하는 동안에는 열네 번 모두 12-14MiB가 더 붙었습니다. 이 때문에 표의 두 행(Qwen3.5-9B 12GB, Gemma 3 4B 8GB)이 예산을 4MiB, 11MiB 넘었습니다. 최대 -c를 1,024 단위로 내림하면서 남은 여유가 이 두 행에서는 프롬프트 몫보다 작았기 때문입니다.
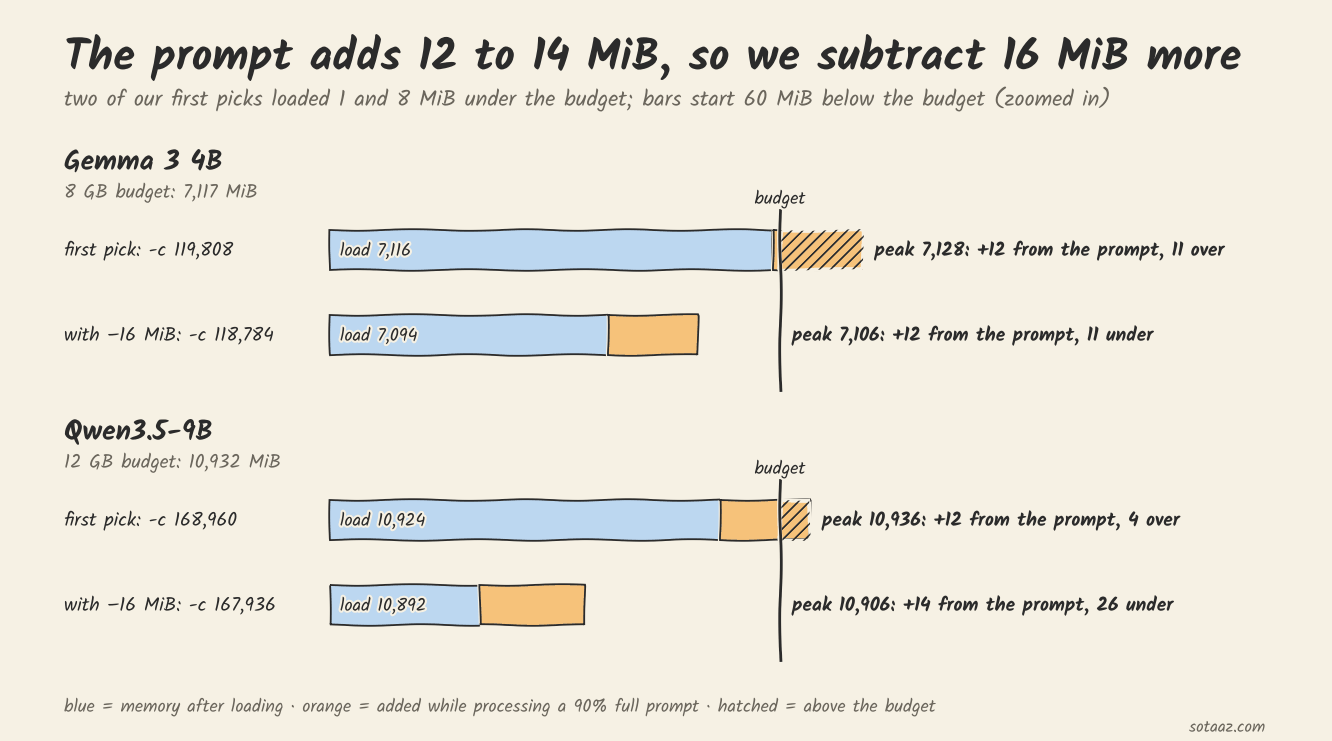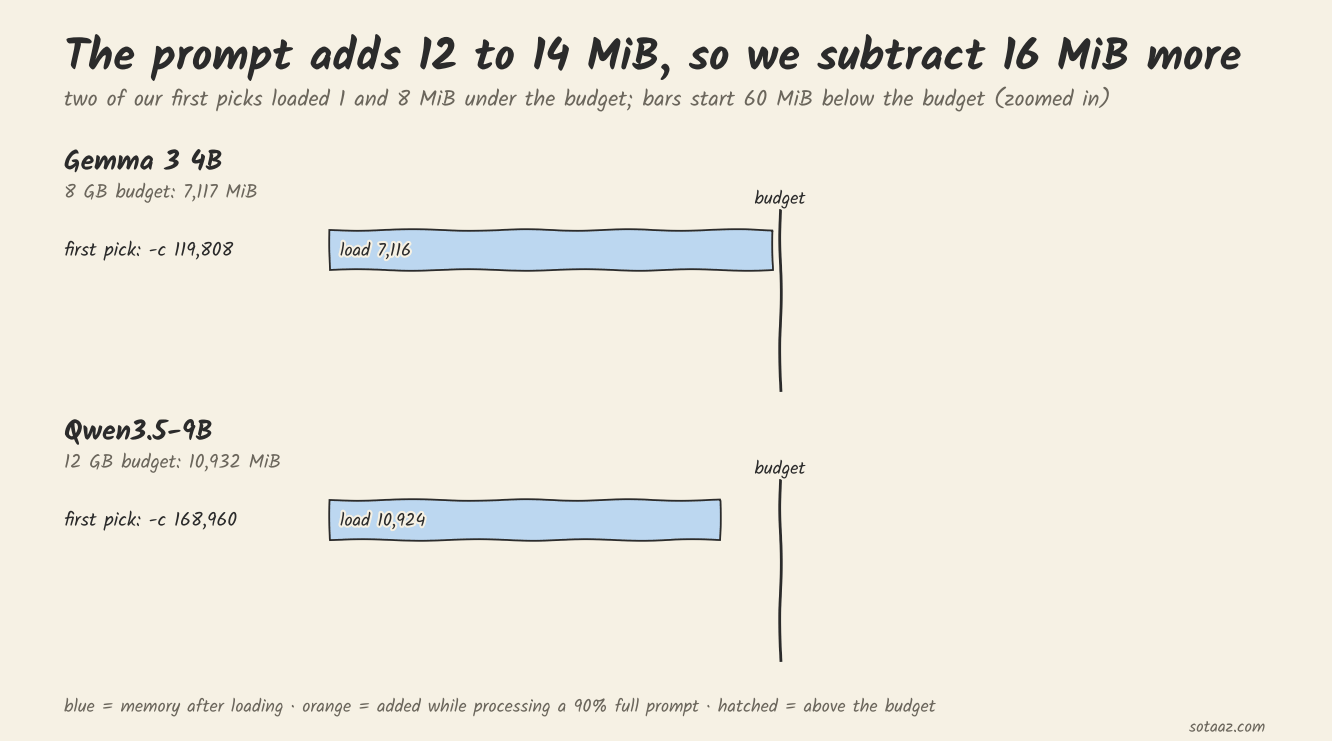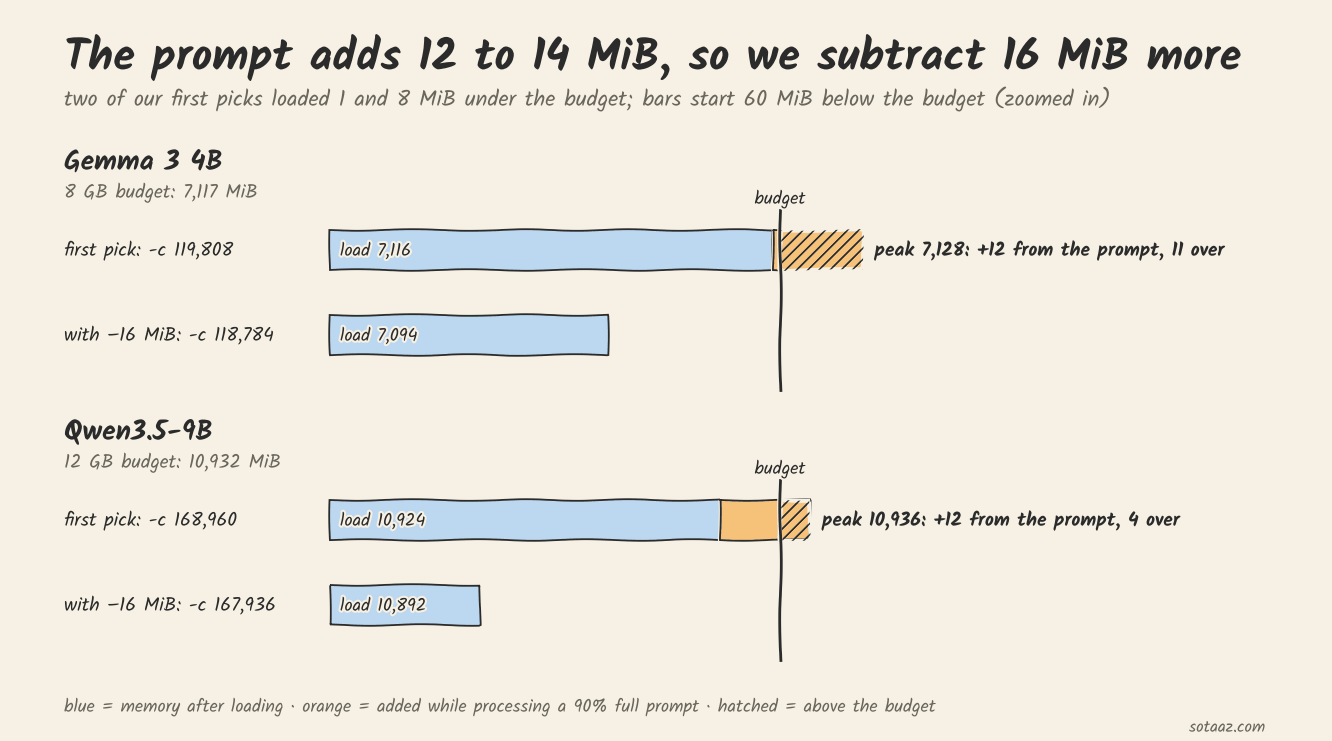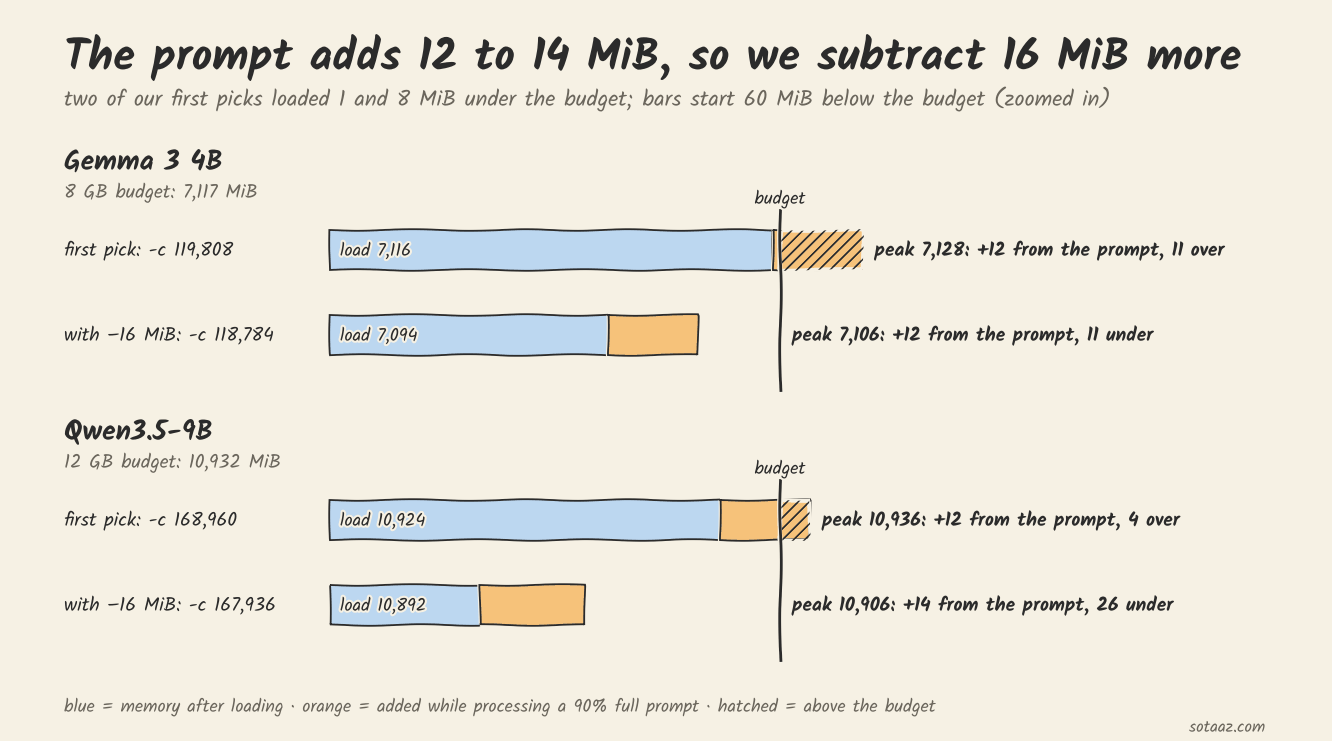
저희는 이렇게 고른 길이가 모두 예산 안에 들 거라고 예측했고, 틀렸습니다. 초과한 부분은 512MiB 예비분 안쪽이고, 위에서 말한 대로 저희 예산은 실제 카드보다 보수적입니다. 실제 카드에서 돌린 것도 아니라서 메모리 부족 오류를 직접 확인한 것은 아닙니다. 그렇지만 길이를 고르는 방법을 예비분에 의존하면 안 됩니다.
그래서 4단계 계산식에 16MiB를 넣었고, 다시 돌리기 전에 예측을 먼저 적어 두었습니다. 16MiB를 더 빼면 위의 두 행만 최대 -c가 1,024토큰씩 줄고, 둘 다 예산 안에 들 것이라는 예측이었습니다. 예측대로 두 칸 모두 예산 안에 들었습니다.
| 모델 | 예산 | 새 최대 -c | 로드 직후 | 처리 중 최댓값(0.2초 간격) | 예산 − 최댓값 |
|---|---|---|---|---|---|
| Gemma 3 4B | 8GB | 118,784 | 7,094 | 7,106 | 11 |
| Qwen3.5-9B | 12GB | 167,936 | 10,892 | 10,906 | 26 |
이 보정은 예측이 틀린 뒤에 더한 것입니다. 처음부터 맞힌 예측이 아니라 한 번 확인한 보정으로 봐 주세요. 16MiB도 이 조건(A100, 프롬프트 하나, 토큰 하나 생성)에서 본 값입니다.
예산별 최대 -c
16MiB 보정을 넣고 직선에서 읽은 값입니다. 내 카드에 그대로 옮겨 쓰기보다는 후보로 보고, 3단계처럼 내 카드의 빈 메모리로 다시 계산한 뒤 5단계로 확인해 주세요.
| 모델 | 8GB | 12GB | 16GB | 24GB | 8GB에서 추정식이 고르는 값 | 8GiB로 잡으면(계산만) |
|---|---|---|---|---|---|---|
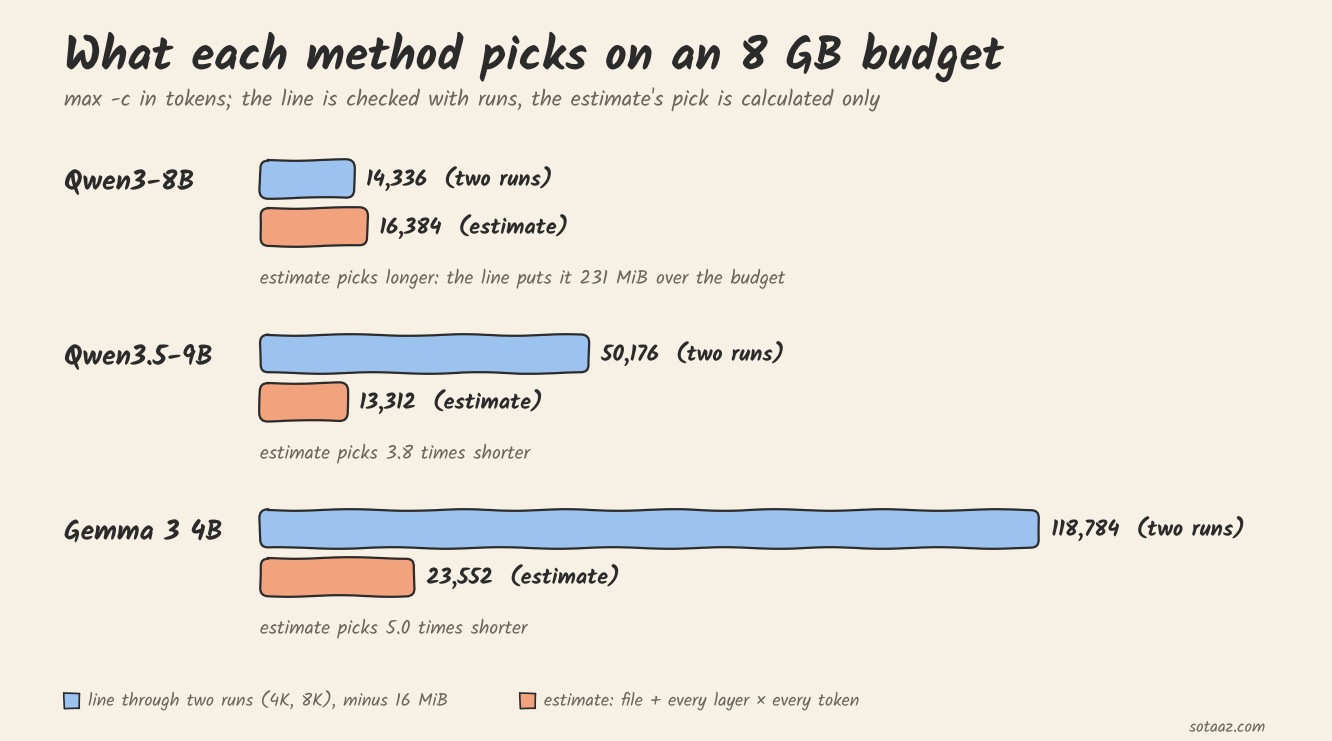
| Qwen3-8B Q4_K_M | 14,336 | 40,960(상한) | 40,960 | 40,960 | 16,384 | 18,432 |
| Qwen3.5-9B Q4_K_M | 50,176 | 167,936 | 262,144(상한) | 262,144 | 13,312 | 67,584 |
| Gemma 3 4B Q8_0 | 118,784 | 131,072(상한) | 131,072 | 131,072 | 23,552 | 131,072(상한) |
마지막 열은 예산을 8,192 − 512 = 7,680MiB로 잡고 같은 직선에서 계산한 값이고, 이 길이로는 띄워 보지 않았습니다. 12GiB로 잡으면 Qwen3.5-9B가 194,560으로 바뀌고, 16GB 이상은 모두 상한이라 그대로입니다.
추정식 열도 띄워 보지 않고 계산만 한 값으로, 추정식이 그리는 선이 8GB 예산과 만나는 길이입니다. 저희 8GB 예산에서 추정식은 Qwen3.5-9B와 Gemma 3 4B에 직선보다 3.8배, 5.0배 짧은 길이를 고릅니다. Qwen3-8B에는 반대로 더 긴 16,384를 고릅니다. 직선으로 계산하면 이 길이에서 로드 직후 메모리는 7,348MiB로, 저희 예산을 231MiB 넘습니다. 다만 이 정도는 512MiB 예비분 안쪽이고, 예산을 8GiB(7,680MiB)로 잡으면 들어갑니다. 그래서 추정식이 크게 어긋나는 쪽은 길이를 짧게 고르는 두 모델입니다.
추정식은 어디서 빗나가나
비교한 추정식은 모든 층이 모든 토큰의 K와 V를 저장한다고 보는 단순한 셈입니다.
총량 = GGUF 파일 크기 + 층 수 × KV 헤드 수 × (K 헤드 크기 + V 헤드 크기) × 2바이트 × 컨텍스트 길이
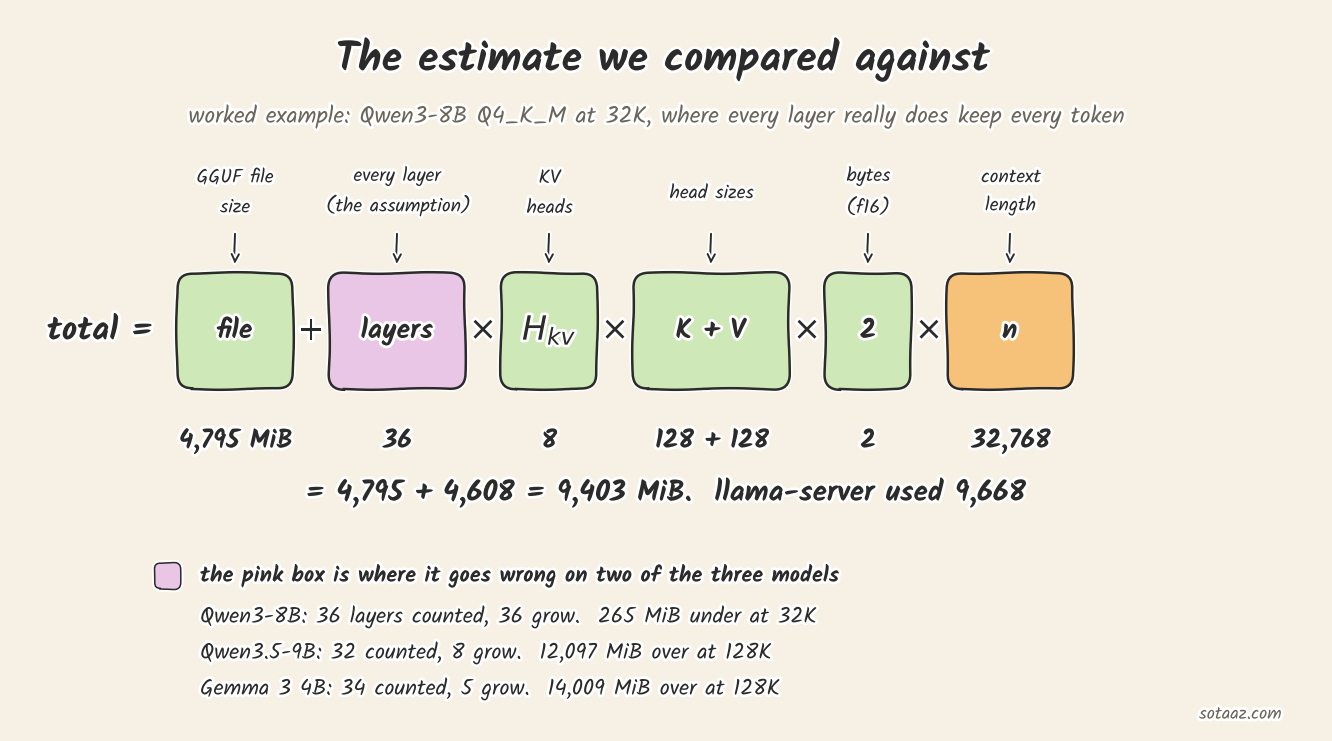
특정 온라인 계산기를 시험한 것은 아니고, 이 식 자체를 실측과 나란히 놓았습니다.
| 모델 | 컨텍스트 | 추정식 | 실측 | 추정식 − 실측 |
|---|---|---|---|---|
| Qwen3-8B | 4K | 5,371MiB | 5,608 | −237 |
| Qwen3-8B | 32K | 9,403 | 9,668 | −265 |
| Qwen3-8B | 128K | 23,227 | 23,588 | −361 |
| Qwen3.5-9B | 4K | 5,929 | 5,612 | +317 |
| Qwen3.5-9B | 32K | 9,513 | 6,536 | +2,977 |
| Qwen3.5-9B | 128K | 21,801 | 9,704 | +12,097 |
| Gemma 3 4B | 4K | 4,491 | 4,742 | −251 |
| Gemma 3 4B | 32K | 8,299 | 5,330 | +2,969 |
| Gemma 3 4B | 128K | 21,355 | 7,346 | +14,009 |
Qwen3-8B에서는 추정식이 수백 MiB 모자랐습니다. 나머지 두 모델은 4K에서는 거의 맞다가 길이가 늘수록 점점 크게 빗나갔고, 128K에서는 서버가 실제로 쓴 메모리의 2.2배(Qwen3.5-9B), 2.9배(Gemma 3 4B)를 잡았습니다.
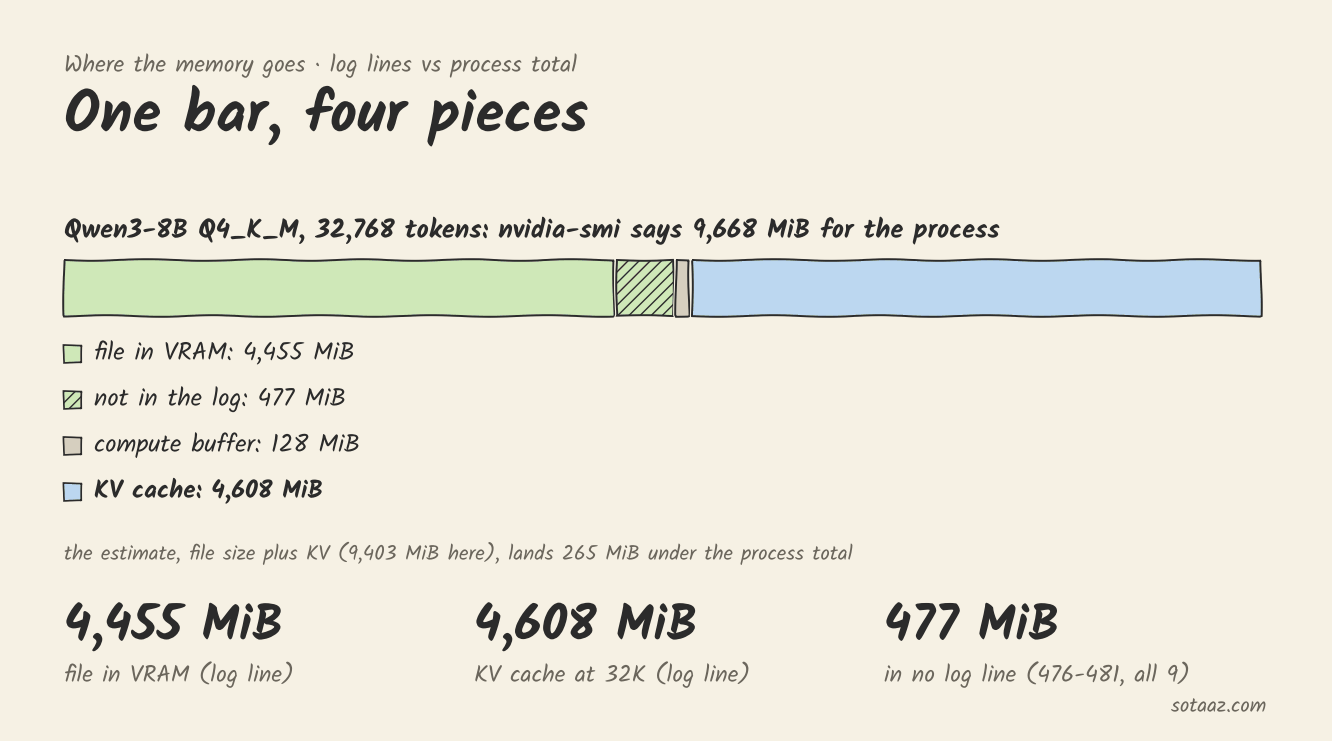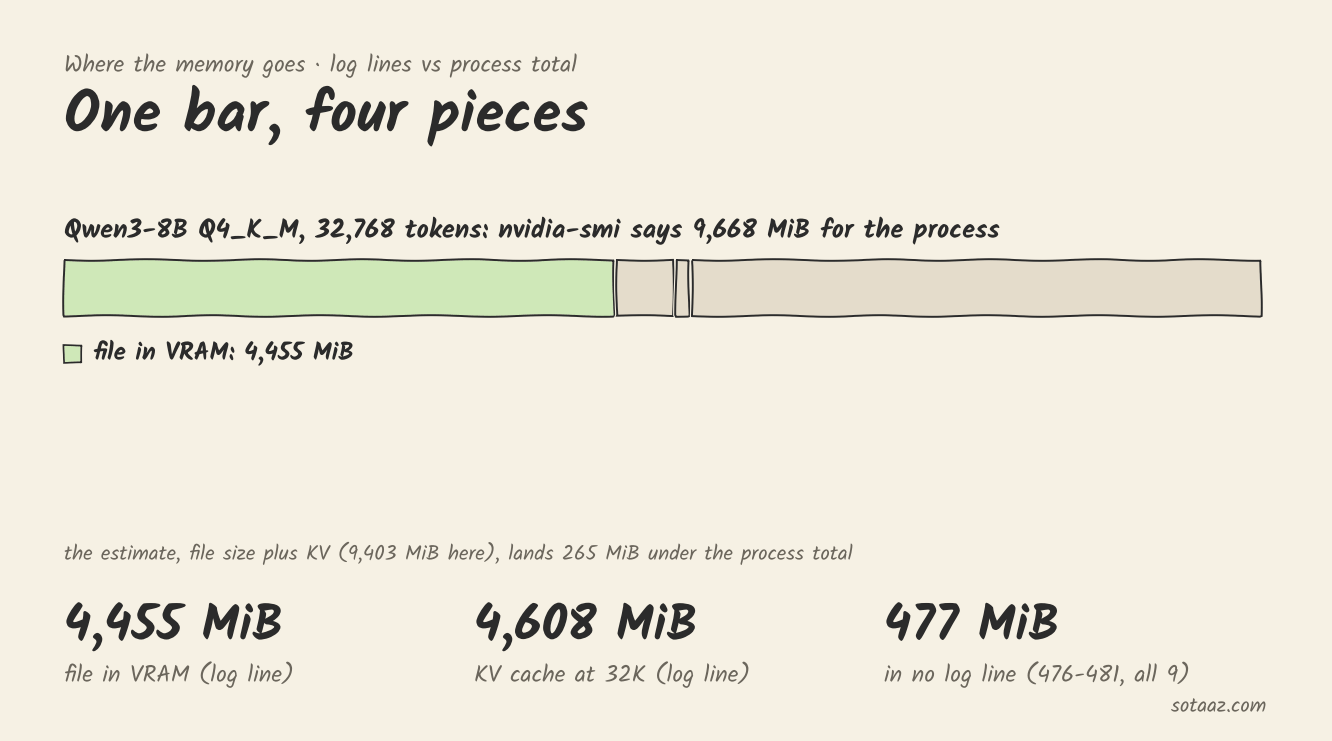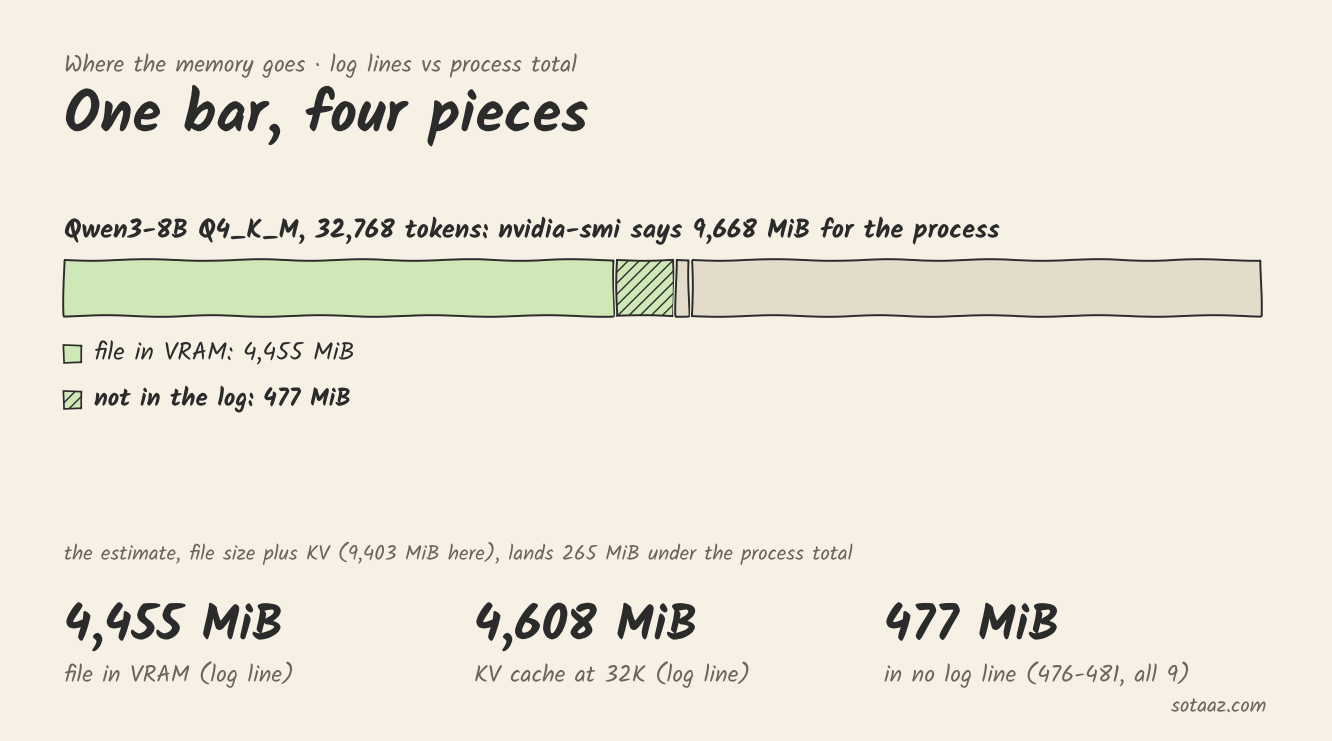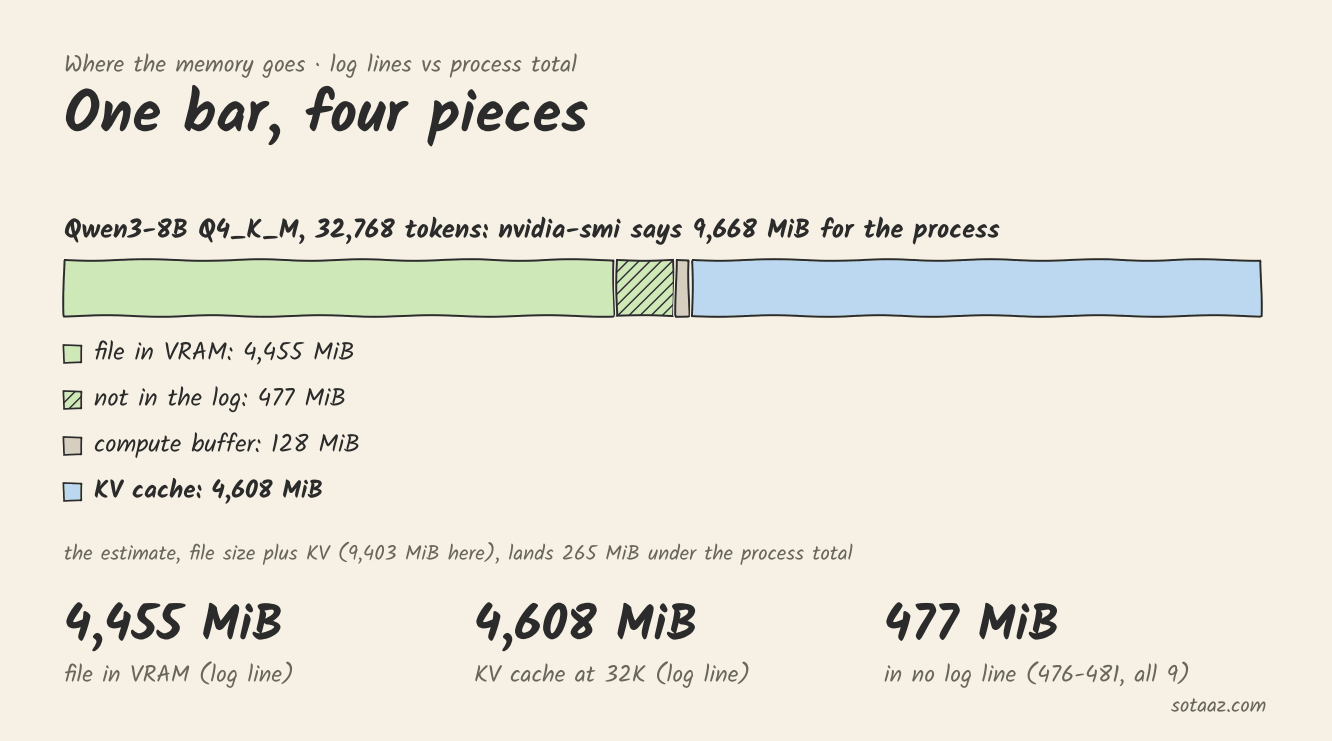
Qwen3-8B 32K의 총량을 로그가 세 조각으로 나누고, nvidia-smi가 네 번째 조각을 보탭니다. 아래 로그 줄에서 괄호 안의 9191 = 4455 + 4608 + 128이 각각 모델, KV 캐시, 계산 버퍼(MiB)입니다.
| - CUDA0 (A100 80GB PCIe) | 81151 = 77113 + (9191 = 4455 + 4608 + 128) + -5152 |- 모델 4,455MiB. 파일 4,795MiB보다 340MiB 작고, 그중 334MiB는
CPU_Mapped model buffer로 CPU에 남습니다. Qwen3.5-9B도 같은 식으로 나뉩니다. Gemma 3 4B는 달라서, GPU 쪽이 파일보다 14MiB 작을 뿐이고 CPU 쪽 680MiB가 그 위에 더 얹힙니다. 어떤 텐서가 CPU에 남는지는 확인하지 않았습니다. - KV 캐시 4,608MiB. 이 모델은 추정식대로 토큰당 144KiB가 정확히 맞았습니다.
- 계산 버퍼 128MiB. 아홉 조건 전체에서 79-224MiB로, 네 조각 중 가장 작았습니다.
- 로그 어느 줄에도 없는 약 480MiB. 프로세스 총량에서 로그의 세 조각을 빼면 아홉 조건 모두 476-481MiB가 남았고, 모델마다 길이와 상관없이 같았습니다. CUDA 프로세스라면 누구나 갖고 있는 CUDA 컨텍스트와 라이브러리 몫으로 보이지만 직접 재지는 않았습니다.
Qwen3-8B의 수백 MiB 차이는 이것으로 설명됩니다. 나머지 두 모델의 차이(128K에서 12,097MiB와 14,009MiB)는 "모든 층이 모든 토큰을 저장한다"는 가정에서 나옵니다.
- Qwen3.5-9B는 32층 중 8층만 전체 어텐션을 씁니다. 128K 로그에는
4096.00 MiB (131072 cells, 8 layers)가 찍히고, 여기에 컨텍스트가 길어져도 커지지 않는RS buffer50.25MiB가 붙습니다. 추정식은 32층을 다 세어 16,384MiB를 잡았습니다. - Gemma 3 4B는 5개 층만 전체 캐시를 두고(128K에서 2,560MiB), 나머지 29개 층은 토큰 1,536개분만 담는 슬라이딩 윈도 캐시를 둡니다(길이와 상관없이 174MiB). 새 토큰이 들어오면 가장 오래된 토큰을 밀어내는 캐시입니다. 1,536이 1,024토큰 윈도에 micro-batch 512를 더한 값이라는 것은 llama.cpp와 vLLM 메모리 비교 글에서 정리했습니다. 추정식은 34층을 모두 전체 어텐션으로 보고 17,408MiB를 잡았습니다.
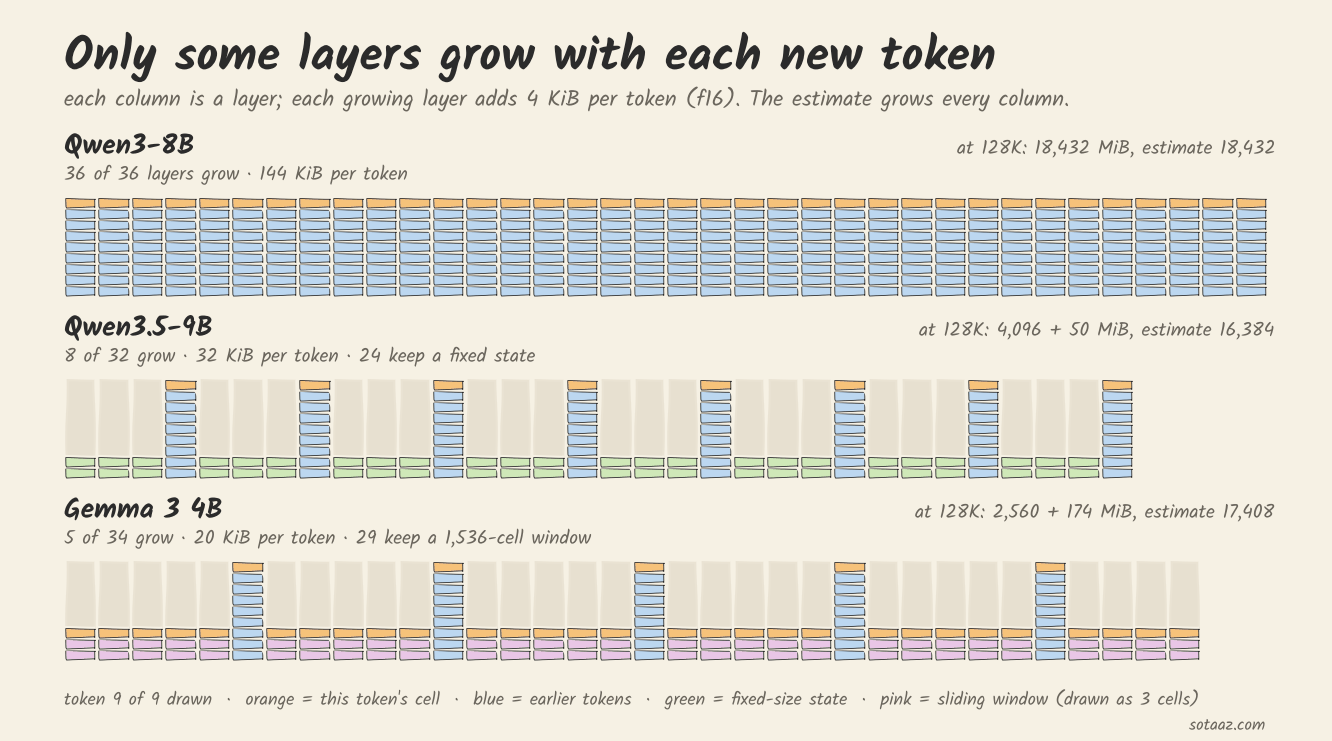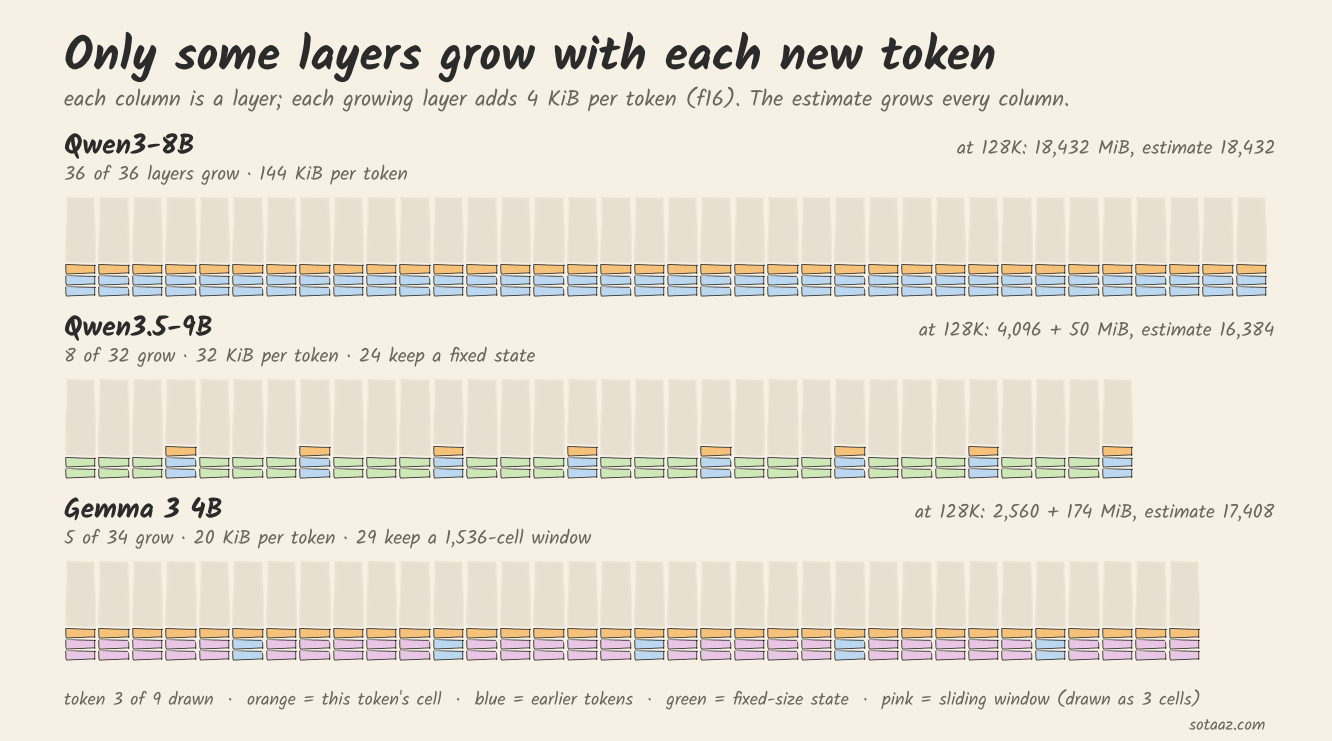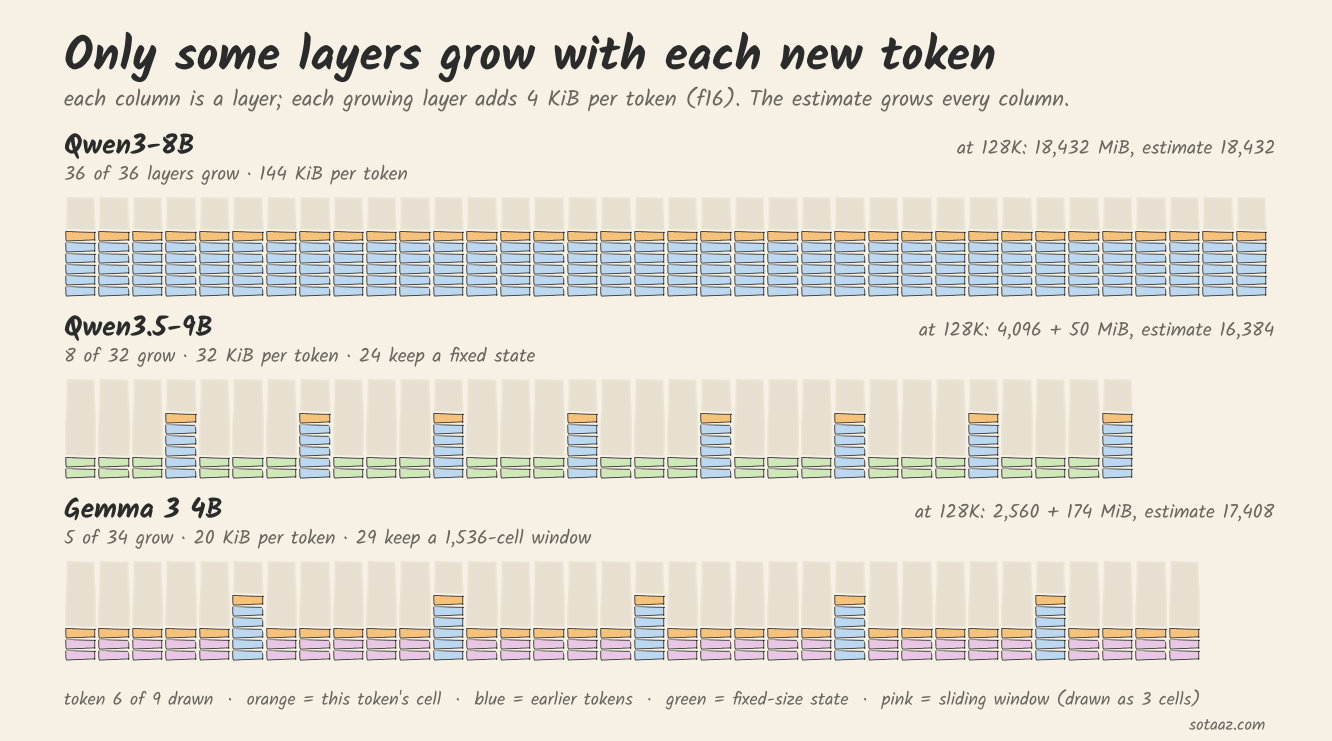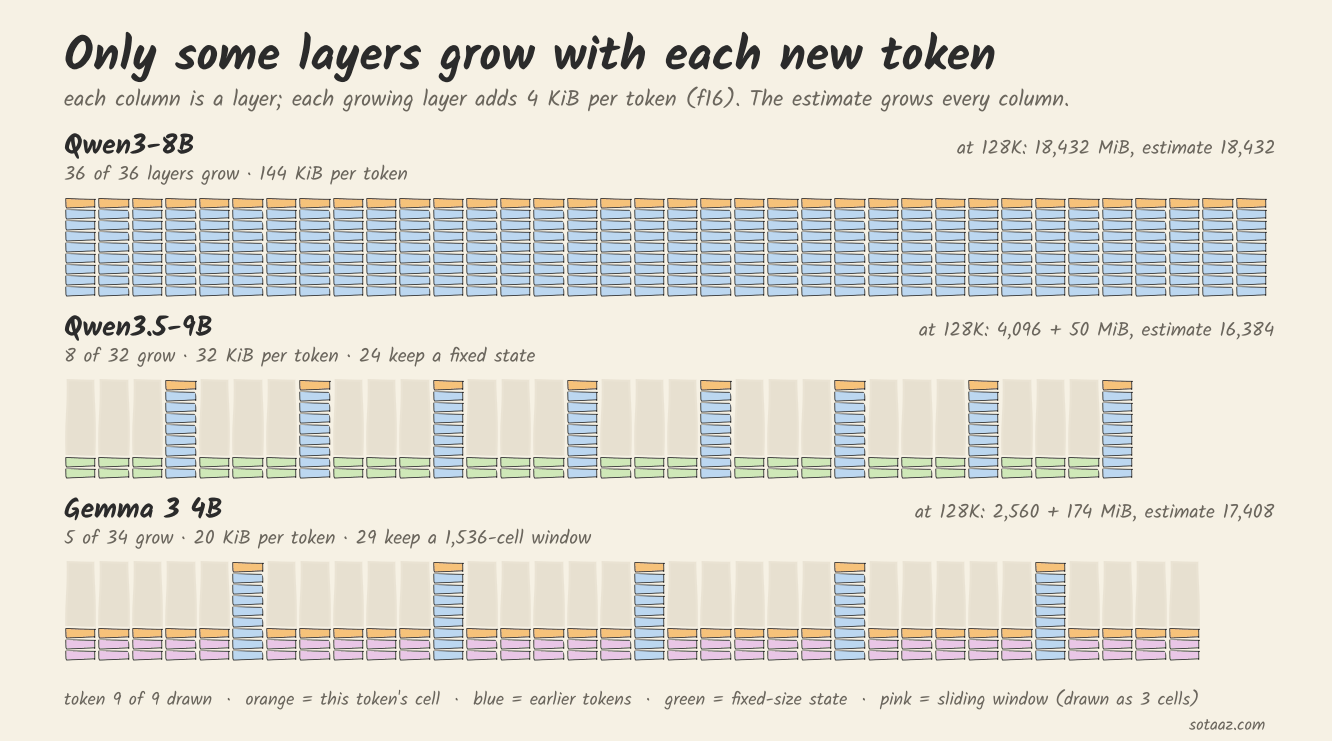
기울기로 보면 더 간단합니다. 추정식의 기울기는 1K토큰당 Qwen3-8B 144MiB, Qwen3.5-9B 128MiB, Gemma 3 4B 136MiB입니다. 실측 기울기는 145, 33, 21MiB였고, 세 모델 모두 1MiB는 계산 버퍼 몫이며 나머지(144, 32, 20MiB)가 KV 캐시입니다. 이런 캐시 구조는 모델별 KV 캐시 글에서 여섯 모델로 측정해 봤으니 참고해 주세요.
예측 채점
첫 번째 측정 전(추정식에 대해):
| 예측 | 결과 | |
|---|---|---|
| P1 | Qwen3-8B: 세 길이 모두 추정식이 실측과 1,024MiB 이내이고, 실측보다 작음 | 맞음: −237, −265, −361 |
| P2 | Qwen3.5-9B 128K: 추정식이 실측보다 10,000MiB 이상 큼(KV를 가진 층이 8층) | 맞음: +12,097 |
| P3 | Gemma 3 4B 128K: 추정식이 실측보다 12,000MiB 이상 큼(슬라이딩 윈도 캐시는 길이에 비례하지 않음) | 맞음: +14,009 |
| P4 | 아홉 조건 모두 프로세스 메모리가 로그 조각 합보다 150-700MiB 큼 | 맞음: 476-481 |
| P5 | 같은 길이에서 Gemma의 계산 버퍼가 Qwen3-8B보다 큼 | 틀림: 79 대 100, 107 대 128, 203 대 224MiB |
두 번째 측정 전(방법에 대해):
| 예측 | 결과 | |
|---|---|---|
| F1 | 4K·8K 직선이 32K·128K 실측을 16MiB 안에서 맞춤 | 맞음: 여섯 개 모두 0MiB |
| F2 | 4K·8K로 구한 최대 -c가 첫 번째 측정으로 미리 구해 둔 값과 1,024 안에서 같음 | 맞음: 모두 같음 |
| F3 | 프롬프트를 90% 채웠을 때 최댓값이 로드 직후보다 0-64MiB 큼 | 맞음: 열네 번 모두 12-14MiB |
| F4 | 상한에 걸리지 않은 네 조건에서 최댓값이 예산 이하이고, 남는 여유가 1,024토큰분 메모리(기울기 × 1,024) + 64MiB보다 작음 | 틀림: 네 조건 중 두 조건이 4MiB, 11MiB 넘음 |
P5는 Gemma 3의 어휘가 26만 개라 출력층이 크고, 그러면 계산 버퍼도 클 거라는 생각에서 나온 예측이었습니다. 그렇지 않았고, 왜 그런지는 로그에서 찾지 못했습니다. F4는 방법을 고치게 만든 오답입니다.
한계
- A100 80GB 한 장, 리눅스, 빌드 하나입니다. 476-481MiB와 12-14MiB는 GPU나 드라이버가 바뀌면 달라질 수 있고, 작은 카드에서는 돌리지 않았습니다. 예산도 실제 카드의
memory.free가 아니라 10진 GB로 정한 값입니다.nvidia-smi가 프로세스별 메모리를 보여 주지 않는 환경이라면 로그의 breakdown 줄에 로그 밖 몫을 더하는 방법이 있지만, 그 몫의 크기는 이 장비에서만 알고 있습니다. - f16 KV 캐시만 쟀습니다. KV 캐시를 8비트로 바꾸면 계산 버퍼가 길이에 따라 훨씬 빨리 커진다는 것을 8GB 카드 컨텍스트 글에서 확인했습니다. 그때도 두 점이 직선을 이루는지는 아직 보지 않았습니다.
- 긴 생성이 아니라 프롬프트 처리만 봤습니다. 확인 실행마다 프롬프트 하나를 보내고 토큰 하나만 생성했고, 메모리는 0.2초 간격으로 읽었습니다. 그보다 짧게 스치는 최댓값은 놓쳤을 수 있습니다.
- 모델은 세 개입니다. MLA나 다른 윈도 크기를 쓰는 구조도 조각이 고정분과 토큰당 증가분으로만 이뤄져 있다면 직선이 나와야 하지만, 직접 돌려 보지는 않았습니다.
그 뒤 convolution 층과 256토큰 sliding-window 층을 섞은 LFM3에 같은 방법을 써 봤습니다. 이미지·음성을 받는 모델 세 개 모두 --mmproj를 붙이고 4K와 32K로 그은 직선이 128K 실측과 1MiB 안에서 맞았습니다. 8GB GPU에서 멀티모달 모델 돌리는 법에 정리했습니다.
그 뒤 로컬 코딩 모델 9개에도 써 봤습니다. 4K와 8K로 그은 직선이 9개 모두 16K 실측과 정확히 같았습니다. 카드 예산별 결과는 이 글에 있습니다. 다만 그 글은 예산을 이 글보다 넉넉하게 잡았고, 차이도 함께 적었습니다.
- 상한은 GGUF 메타데이터 값입니다. 표의 "상한"은 각 GGUF에 적힌
n_ctx_train입니다. Qwen3-8B의 경우 이 값은 40,960이지만, 모델 카드는 기본 컨텍스트를 32,768, YaRN을 켜면 131,072로 설명합니다. Qwen3-8B 128K 실측은 메모리 숫자로만 봐 주세요.
다음 편
직선의 출발점은 대부분 모델 파일입니다. 다음 편에서는 이 출발점을 바꿉니다. 같은 모델을 Q8_0, Q4_K_M, Q3_K_L로 올려, 줄어든 1GB가 이 카드들에서 컨텍스트 몇 토큰이 되는지, 그 대신 정확도는 얼마나 잃는지 잽니다. 나오면 아래 뉴스레터로 편마다 보내 드립니다.