8GB GPU로 사진 한 장을 3D 모델로 만들 수 있을까요? 8GB로 제한한 A100에서 Idol은 7,380MiB를 썼습니다
사진 한 장을 3D 물체로 바꾸는 Speridlabs의 Idol을 8GB로 제한한 A100에서 재 봤습니다. 실제 8GB 카드로 재지는 못했습니다. 실제 사진의 최고치는 nvidia-smi 기준 7,380MiB입니다. 8,192MiB로 세고 데스크톱이 512MiB를 쓰면 300MiB가 남고, 8×10⁹바이트로 세면 263MiB가 모자랍니다. 실행 명령과 762MiB를 더 쓰는 단계를 정리했습니다.
8GB GPU로 사진 한 장을 3D 모델로 만들 수 있을까요? 8GB로 제한한 A100에서 Idol은 7,380MiB를 썼습니다
Idol의 README에는 "7.2 GB of VRAM"을 쓴다고 적혀 있습니다. 그런데 저희 첫 테스트에서는 6,618MiB가 나왔습니다.
문제는 저희가 고른 입력 이미지에 있었습니다. Idol README의 미리보기 이미지를 썼는데, 이 이미지들은 배경이 이미 투명합니다. 그래서 배경 제거 단계가 한 번도 돌지 않았습니다. 일반 사진을 넣으니 nvidia-smi 기준 최고치가 7,380MiB, 즉 7.21GiB가 나왔습니다. 같은 사진의 배경을 미리 지워 다시 넣자 6,616MiB로 내려갔습니다.
그럼 8GB 카드에 들어갈까요? 저희에게는 8GB 카드가 없어서, A100에서 PyTorch가 쓸 수 있는 메모리를 제한해 측정했습니다. Idol은 이미지 인코더(DINOv3)를 기본으로 bf16 정밀도로 돌리는데, 이 기본 설정은 제한 아래에서 모두 끝까지 돌았습니다. 8GB 카드를 8,192MiB로 보면 모니터가 없을 때 812MiB, 데스크톱이 512MiB를 쓴다고 가정하면 300MiB가 남습니다. 앞선 글의 더 엄격한 계산처럼 8×10⁹바이트로 보면 같은 데스크톱 조건에서 7,380MiB는 7,117MiB보다 263MiB 많습니다. fp32 이미지 인코더는 첫 번째 계산으로도 데스크톱 512MiB를 뺀 7,680MiB를 넘습니다.
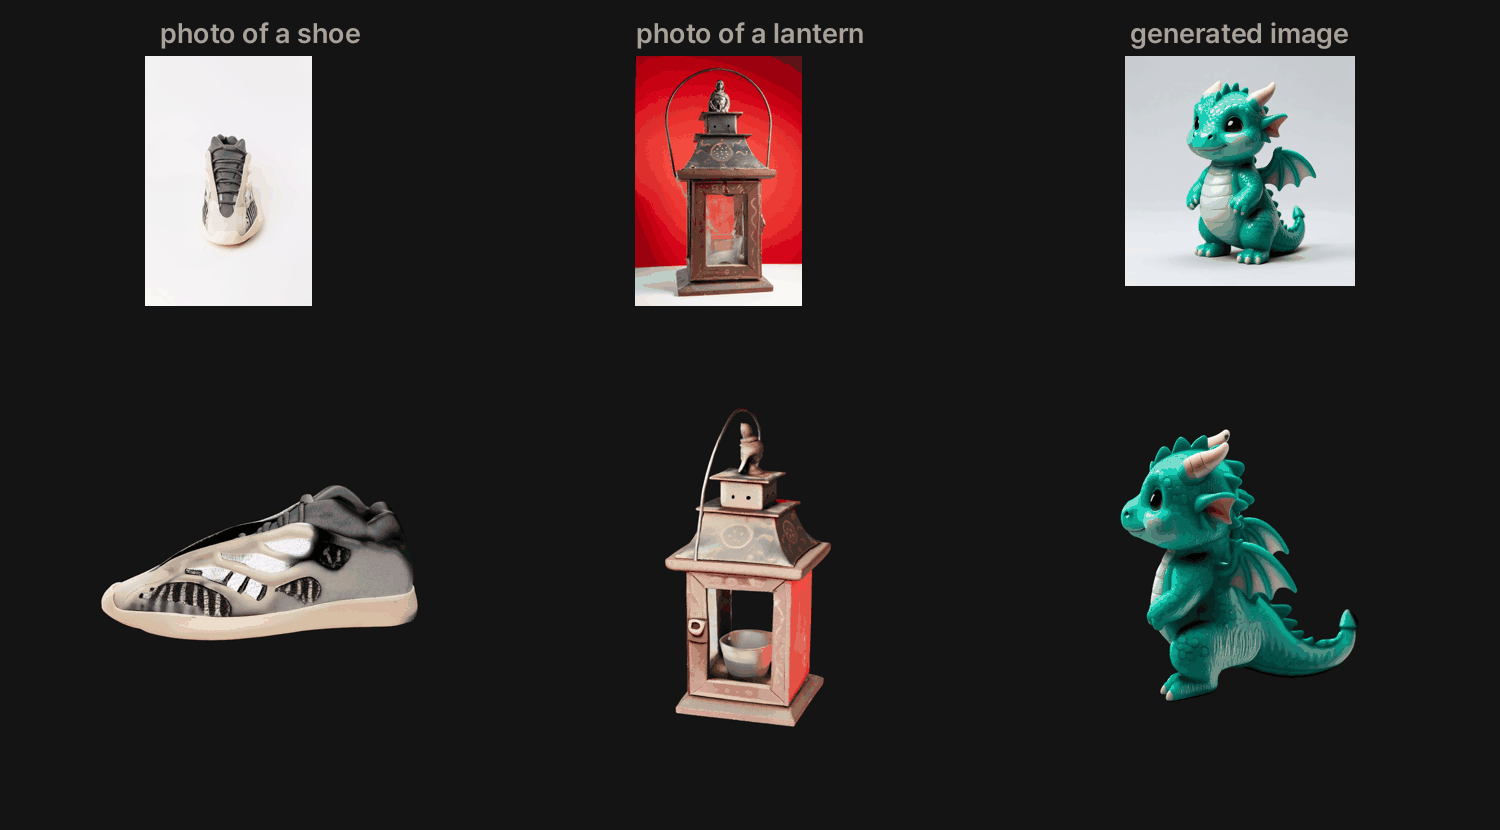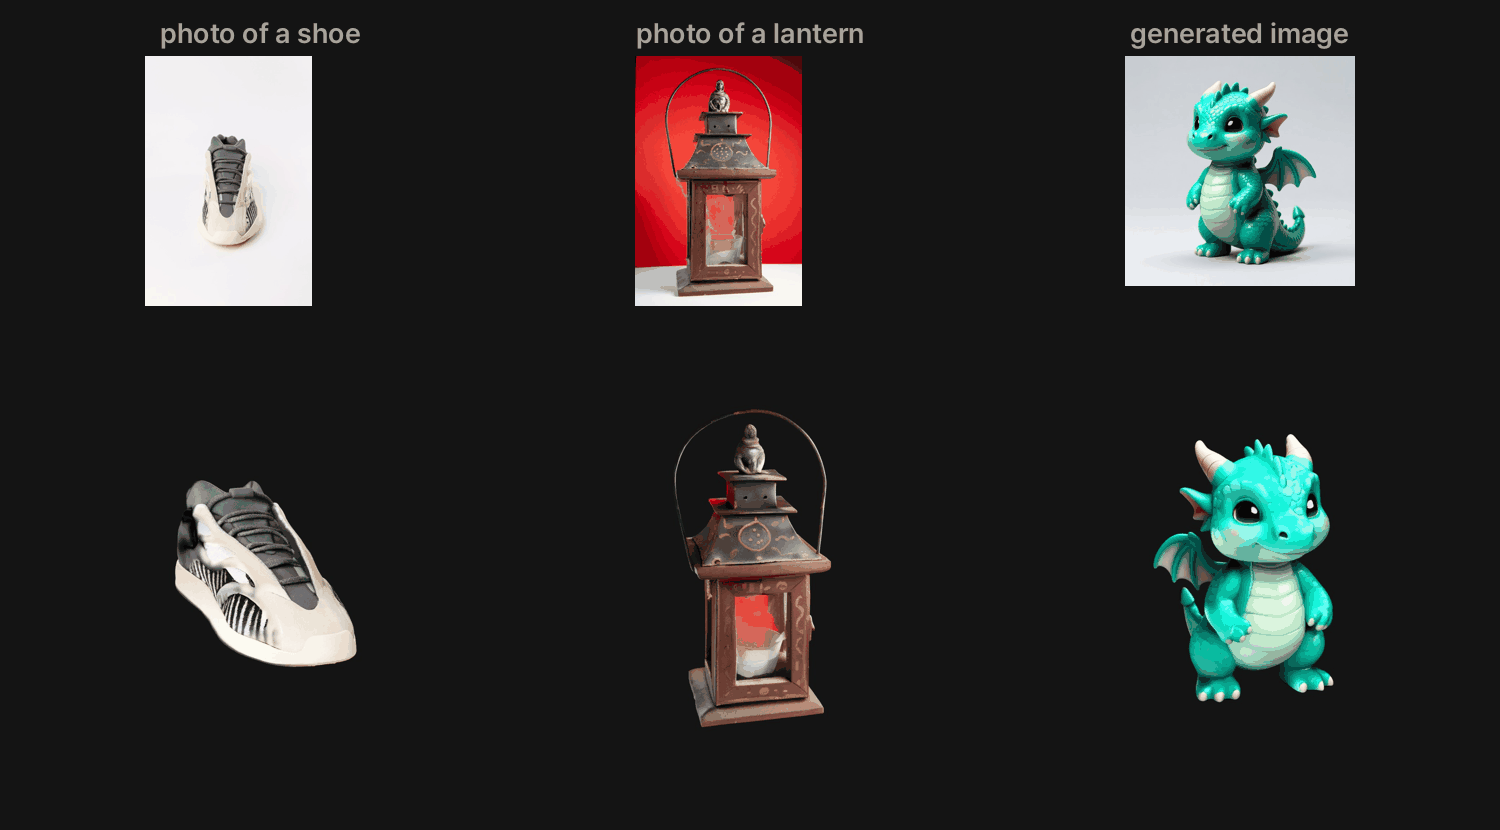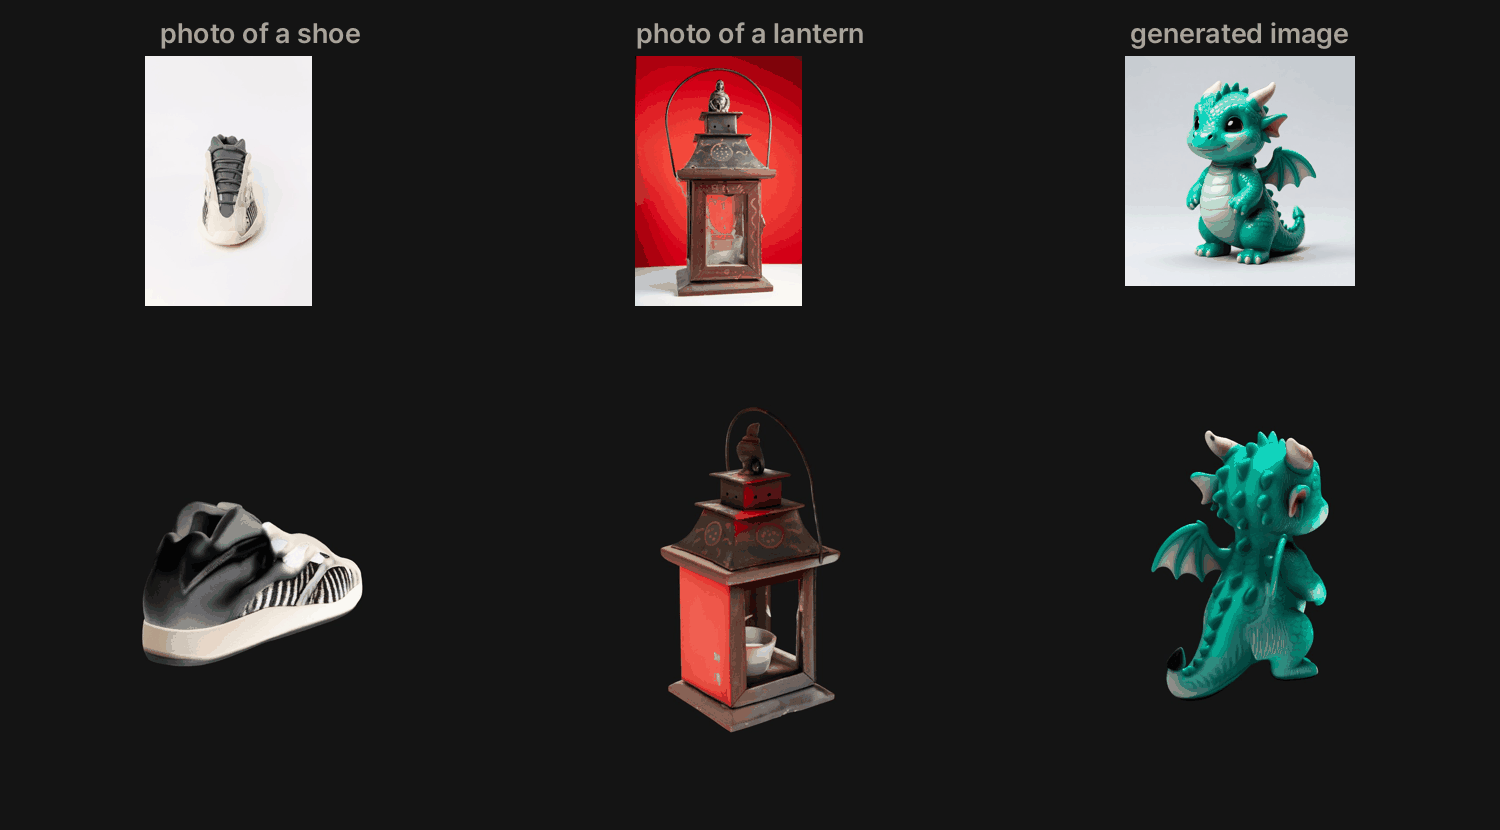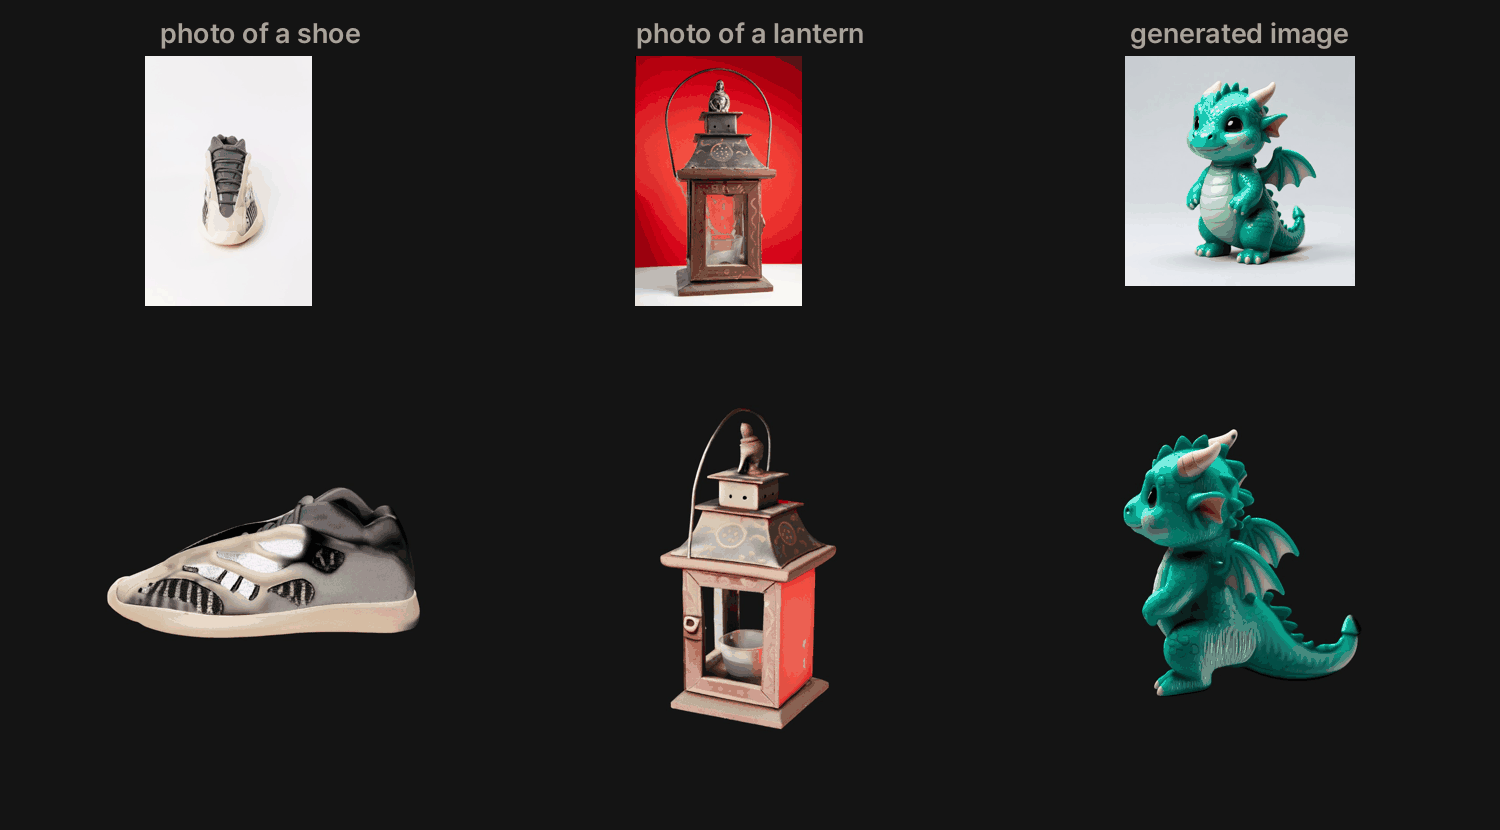
입력에 없는 면은 모델이 생성한 것입니다. 실제 물체와 얼마나 비슷한지는 따로 측정하지 않았습니다.
신발과 등불은 Pexels 스톡 사진이고, 용 이미지는 저희가 flux로 생성한 이미지로 테스트했습니다.
준비물
- 8GB 이상 NVIDIA GPU. 다만 실제 8GB 카드에서 돌려 본 것은 아닙니다. 뒤의 한계 절을 봐 주세요.
- Python 3.10 이상(저희는 3.11)과 드라이버에 맞는 PyTorch.
- Hugging Face 계정과 접근 승인 두 건. facebook/dinov3-vith16plus-pretrain-lvd1689m과 black-forest-labs/FLUX.2-dev입니다. FLUX.2-dev에서는 VAE만 내려받습니다.
라이선스도 확인해 두세요. Idol 모델 페이지에는 Apache-2.0, BiRefNet 페이지에는 MIT로 표시되어 있습니다. DINOv3에는 자체 DINOv3 License가 있습니다. FLUX.2-dev 페이지에는 FLUX Non-Commercial License라고 적혀 있고, VAE에 대한 별도 라이선스는 나와 있지 않습니다. 상업적으로 쓰려면 약관을 직접 확인하시기 바랍니다. 접근 승인은 각 저장소 페이지에서 신청하며, 바로 나지 않을 수도 있습니다.
1단계: 설치
git clone https://github.com/speridlabs/idol-sdk
cd idol-sdk
git checkout 4702a7f
python3 -m venv .venv
. .venv/bin/activate
pip install torch==2.11.0 torchvision==0.26.0 --index-url https://download.pytorch.org/whl/cu128
pip install -e . diffusers==0.42.1 transformers==5.22.1
hf auth login
torch를 먼저 설치한 데는 이유가 있습니다. 기본으로 깔리는 2.15는 CUDA 13.2용이라 저희 드라이버(580.178.04, CUDA 13.0)와 맞지 않았습니다. nvidia-smi 첫 줄에 드라이버의 CUDA 버전이 나오니, 그보다 새롭지 않은 torch를 고르면 됩니다. 위 명령은 저희가 잰 SDK 커밋과 주요 버전을 고정합니다. 저희는 uv로 설치했고, 이 pip 명령을 그대로 돌려 보지는 않았습니다.
2단계: 물체 하나 만들기
python -m idol.sample --image photo.jpg --mode real --out outputs사진이면 --mode real을 붙이고, 렌더링했거나 생성한 이미지면 빼면 됩니다. 기본값이 synthetic입니다. 이미지마다 photo.ply, 모델이 실제로 본 이미지인 photo_input.png, photo_camera.json 세 파일이 나옵니다.
신발 사진으로 이 명령을 그대로 돌렸더니 가중치를 이미 내려받은 상태에서 전체 37.2초가 걸렸고, 17.8MB짜리 .ply가 나왔습니다. README에는 어떤 Gaussian splat 뷰어로도 열 수 있다고 적혀 있습니다. 저희는 gsplat으로 직접 렌더링했는데, Y축을 아래 방향으로 봐야 했습니다. 물체가 거꾸로 보이면 뒤집어 보세요.
돌아가는 동안 메모리를 보려면 터미널을 하나 더 열어 이렇게 실행합니다.
nvidia-smi --query-gpu=memory.used --format=csv -lms 2000.2초마다 재는 명령입니다. 1초 간격으로 재면 최고치를 놓칠 수 있습니다. 다른 작업이 없던 A100에서 카드 전체 최고치는 7,390MiB였습니다.
메모리를 얼마나 썼을까요
bf16 설정은 먼저 제한 없이 재고, 8GB 카드를 대신하는 두 제한 아래에서 다시 쟀습니다. fp32는 제한 아래에서만 쟀습니다. 제한에는 PyTorch의 set_per_process_memory_fraction을 썼습니다. 모니터 없는 카드는 7,700MiB로 잡았습니다. 모델을 올린 뒤 nvidia-smi 값이 PyTorch reserved보다 492MiB 컸는데, 8,192에서 그만큼을 뺀 값입니다. 데스크톱이 있는 카드는 여기서 512를 더 뺀 7,188MiB입니다. 아래 그림의 7,680 선은 8,192에서 512를 뺀 값입니다.
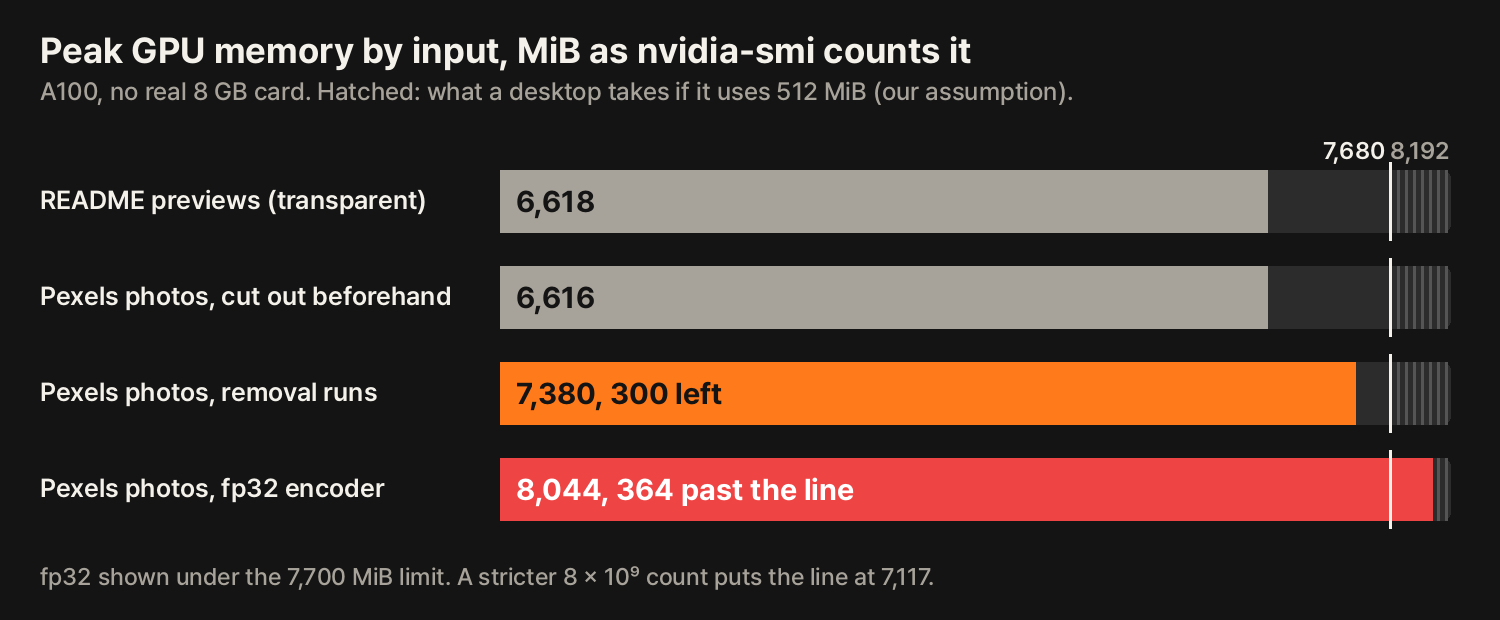
표에는 수치가 세 가지 있습니다. allocated는 PyTorch의 텐서가 실제로 차지한 최대량입니다. reserved는 PyTorch가 드라이버에서 받아 둔 양으로, 다 쓰고 돌려주지 않은 블록까지 포함합니다. nvidia-smi는 드라이버가 프로세스 전체에 대해 보고하는 값이고, 카드 크기와 견줄 때 보는 수치입니다.
| 입력과 설정 | PyTorch allocated | PyTorch reserved | nvidia-smi |
|---|---|---|---|
| README 미리보기 이미지(배경이 이미 투명) | 5,117 | 6,096 | 6,618 |
| Pexels 사진, 배경을 미리 지움 | 5,117 | 6,096 | 6,616 |
| Pexels 사진, 배경 제거 실행 | 5,119 | 6,858 | 7,380 |
| Pexels 사진, fp32 이미지 인코더, 7,700 제한 | 6,820 | 7,520 | 8,044 |
모두 기본값인 Gaussian 262,144개에서 잰 최고치이고 단위는 MiB입니다. 앞의 세 행은 제한 없이 잰 값입니다. 미리보기 이미지와 사진은 두 제한에서도 최고치가 같았습니다. bf16의 reserved 최고치가 어느 제한에도 닿지 않았기 때문입니다. 배경을 미리 지운 행은 제한 없이만 쟀습니다.
8GB를 어떻게 세느냐에 따라 답이 달라집니다. 이 글은 이 연재의 직전 글처럼 8,192MiB로 계산합니다. 그 글은 여유분 16MiB를 더 빼서 7,664MiB를 씁니다. 실제 카드의 memory.total은 읽어 보지 못했습니다. 더 앞선 글들은 8×10⁹바이트, 즉 7,629MiB로 세고 데스크톱 512MiB를 빼 7,117MiB를 썼습니다. 이 기준이면 사진의 7,380MiB는 데스크톱 화면이 같은 카드를 함께 쓰면 7,117MiB보다 263MiB 많고, 모니터가 없으면 249MiB가 남습니다. 저희가 건 7,188MiB 제한은 7,117보다 높아서, 이만큼 엄격한 제한은 시험하지 못했습니다. 내 카드의 값은 nvidia-smi --query-gpu=memory.free --format=csv로 확인할 수 있습니다.
7.2는 두 가지로 해석됩니다. 7,380MiB는 7.21GiB이고, PyTorch reserved 6,858MiB는 십진 단위로 7.19GB입니다. 둘 다 반올림하면 7.2입니다. README에 어느 수치인지 나와 있지 않아서 어느 쪽을 뜻하는지는 알 수 없습니다.
bf16에서는 배경을 미리 지운 입력의 최고치가 더 낮았습니다(사진 두 장, 제한 없음). 이미지에 투명 영역이 있으면 배경 제거가 돌지 않아 최고치가 6,616MiB입니다. 데스크톱 512MiB 가정에서 1,064MiB, 더 엄격한 계산으로는 501MiB가 남습니다. 배경 제거 모델의 가중치는 어느 경우든 올라갑니다. 저희는 Idol의 배경 제거 모델을 별도 프로세스로 돌려 배경을 지웠습니다. 이 단계 자체의 메모리는 재지 않았고, 배경을 지운 입력을 fp32로 돌리거나 3D 결과의 품질을 비교하지도 않았습니다.
fp32는 사진에서 7,680 선을 넘습니다. --dinov3_dtype fp32는 이미지 인코더를 fp32(32비트) 그대로 돌립니다. README에는 1.7GB를 더 쓴다고 적혀 있습니다. 사진에서 allocated 최고치는 실제로 1,701MiB 늘었지만, nvidia-smi는 664MiB만 늘었습니다. PyTorch가 이미 받아 둔 메모리를 다시 쓴 것으로 보이지만, 추적해 확인하지는 않았습니다. 7,700 제한에서 8,044MiB이므로 8,192까지 148MiB가 남습니다. README 미리보기 이미지는 첫 요청에서 8,124MiB까지 올라 68MiB만 남았고, 이후 요청은 7,570MiB였습니다. 7,188 제한에서 사진은 7,686MiB로 선보다 6MiB 많았고 이후 7,564MiB였습니다. 미리보기 이미지는 처음 두 요청에서 7,650MiB, 이후 7,488MiB였습니다. 모두 끝까지 돌았습니다. 이 제한은 PyTorch의 메모리만 막을 뿐 CUDA 컨텍스트는 막지 않으므로, 실제 카드에서 실패할지는 이 결과로 알 수 없습니다. 제한 없이 fp32를 돌린 기록은 없고, fp32가 결과를 바꾸는지도 재지 않았습니다. 여유가 이 정도면 저희는 데스크톱 화면을 함께 띄운 8GB 카드에서 fp32를 쓰지 않겠습니다.
7,380MiB는 어디에 쓰일까요
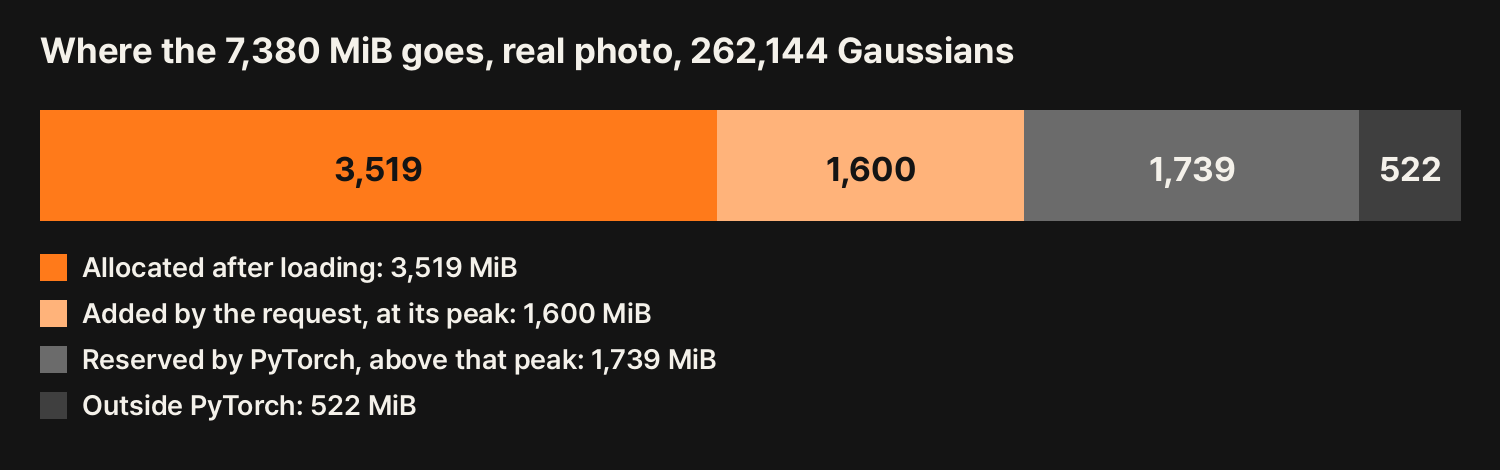
사진을 넣은 실행의 수치를 네 조각으로 나누면 이렇습니다. 최고치끼리의 차이이지 한순간의 내역은 아니므로, 각 최고치의 시점은 다를 수 있습니다. 아래에서 요청은 이미지 한 장을 물체 하나로 바꾸는 처리를 뜻합니다.
- 로드 후 allocated 3,519MiB. 모델의 여섯 부분이 요청 내내 GPU에 머뭅니다. 오프로드나 저사양용 옵션은 없습니다. README는 가중치를 3.7-4.4GB로 적고 있습니다.
- 이미지를 처리하면서 메모리를 가장 많이 쓸 때 더해지는 1,600MiB. 여기까지가 allocated 최고치 5,119MiB입니다.
- 그 위로 잡아 둔 1,739MiB. PyTorch는 다 쓴 메모리를 돌려주지 않고 잡아 둡니다. 배경 제거가 바꾸는 부분이 여기입니다. reserved는 762MiB 늘지만 allocated는 2MiB만 움직입니다. 7,188MiB보다 더 낮게 제한하면 줄어들 수도 있지만, 그 조건은 재지 않았습니다.
- PyTorch 밖 522MiB. PyTorch reserved 밖에서 nvidia-smi가 추가로 세는 양입니다. CUDA 컨텍스트가 들어 있지만 더 나눠 보지는 않았고, 다른 GPU에서는 달라질 수 있습니다.
Gaussian을 늘려도 최고치는 그대로입니다
Gaussian은 물체를 이루는 작은 색 덩어리입니다. --num_gaussians로 32,768개에서 1,048,576개까지 32의 배수로 고를 수 있습니다.
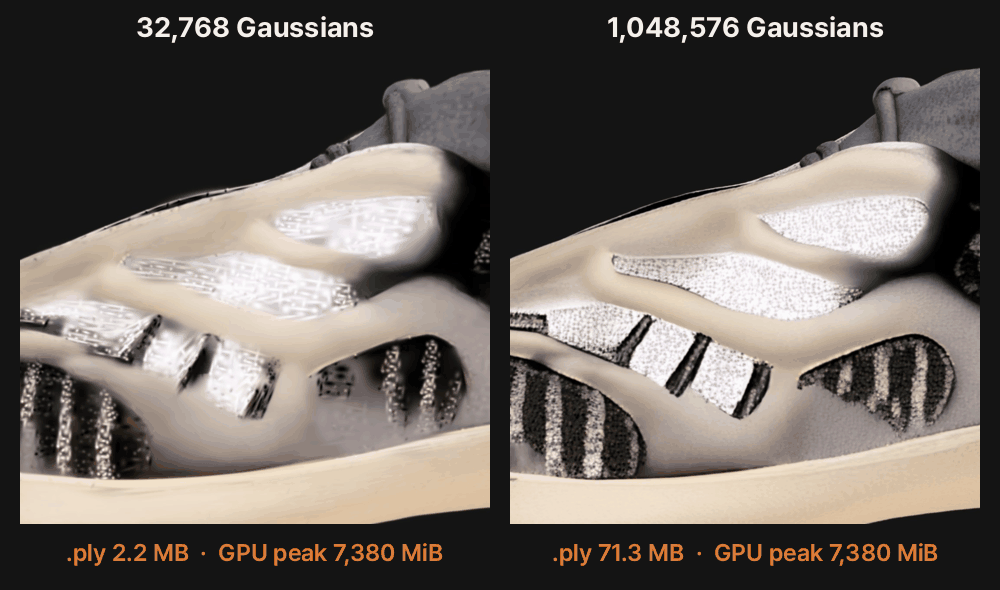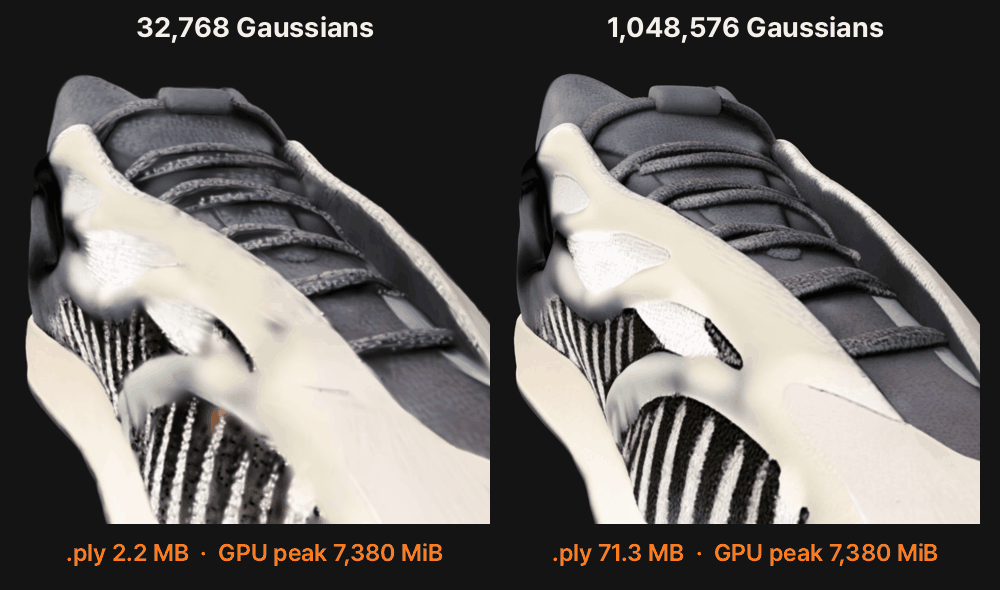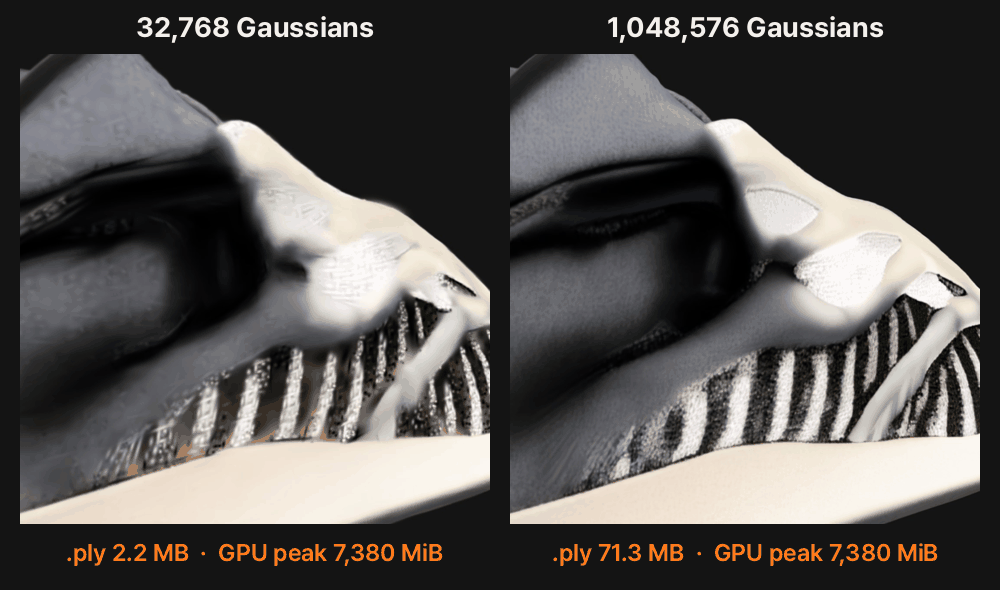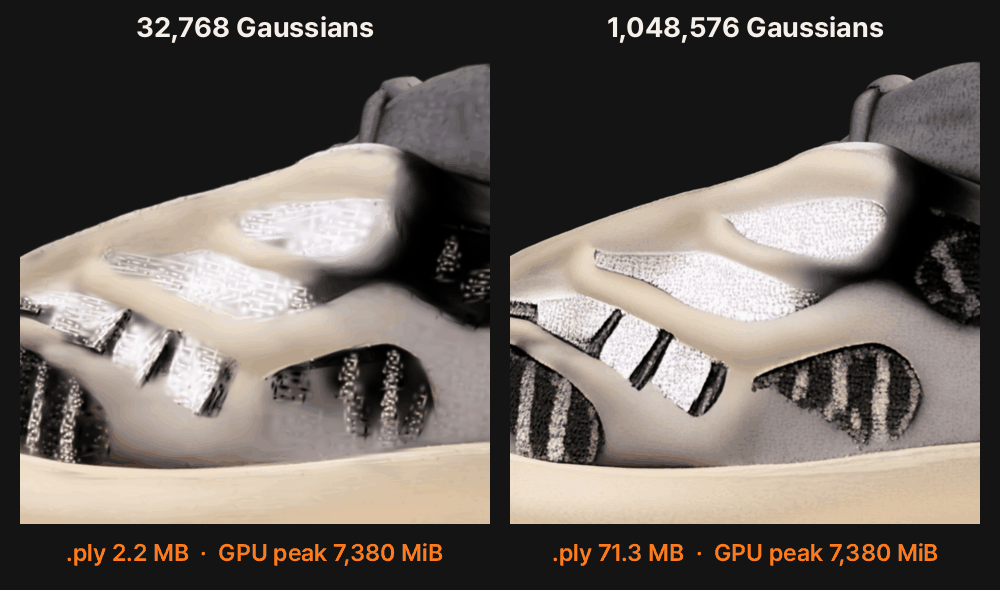
32,768개에서 1,048,576개로 32배 늘려도 신발의 nvidia-smi 최고치는 7,380MiB 그대로였습니다. .ply만 2.2MB에서 71.3MB로 커졌습니다. README 미리보기 이미지에서 allocated 최고치는 54MiB 늘었는데, PyTorch가 이미 잡아 둔 범위 안입니다. 코드를 보면 모델은 크기가 고정된 latent로 작업하고 Gaussian은 마지막 단계에서 배치합니다. 그래서 생성 중 GPU 메모리만 보면 가장 큰 설정에서도 최고치는 거의 늘지 않습니다. 100만 개짜리 파일을 볼 때 드는 메모리는 재지 않았습니다. 근접 화면은 100만 개 쪽이 선명해 보이지만 품질을 채점하지는 않았습니다.
시간은 조금 늘어납니다. 미리보기 이미지 기준 17.2초에서 18.0초가 됐습니다.
A100에서 걸린 시간
모두 A100 기준이라 8GB 카드의 속도를 직접 말해 주지는 않습니다.
- 17.4초. 모델이 로드되고 첫 요청이 지난 뒤 물체 하나를 만드는 시간입니다(물체 세 개에 걸친 요청 네 번의 중앙값). 물체별로는 신발 17.4초, 등불 17.5초, 용 17.3초이고 각각 요청 한두 번에서 나온 값입니다. README의 A100 수치는 16.3초입니다.
- 22.7초. 컴파일 캐시가 남은 상태로 새로 띄운 프로세스의 첫 요청입니다. 맨 처음 요청은 미리보기 이미지에서 34.9초였습니다. 차이는
torch.compile캐시 때문으로 보지만 따로 확인하지는 않았습니다. --no_optimize를 쓰면 미리보기 이미지에서 최고치는 같고 약 1.35배 느렸습니다(23.4초와 17.3초). 최적화를 꺼도 메모리는 줄지 않습니다.
README 표에서 가장 느린 소비자용 카드는 10GB RTX 3080으로 46.2초입니다. 8GB 카드는 표에 없습니다.
저희 예측
첫 실행 전에 적어 둔 예측입니다. 첫 실행에는 README 미리보기 이미지를 썼습니다.
| 예측 | 결과 | |
|---|---|---|
| P1 | allocated 최고치 5.0-7.2GiB, 7.2GB가 allocated나 reserved와 0.3GB 이내로 가까움 | 틀림. 4.997GiB, 미리보기 이미지에서는 어느 쪽도 가깝지 않음 |
| P2 | nvidia-smi가 reserved보다 0.4-1.2GiB 높음 | 맞음, 0.51GiB |
| P3 | 100만 개가 32,768개보다 allocated를 최대 1.0GiB 더 씀 | 맞음, 54MiB |
| P4 | --no_optimize는 최대 0.5GiB 낮고 1.3-2.2배 느림 | 맞음, 최고치 같고 1.35배 |
| P5 | .ply가 71.3MB와 2.2MB, 오차 0.1 안 | 맞음 |
| P6 | 7,700 제한에서 Gaussian 개수 세 가지는 끝나고 fp32는 메모리 부족 | 절반 틀림. fp32도 끝남 |
| P7 | 7,188 제한에서 하나 이상 메모리 부족 | 틀림. 전부 끝남 |
| P8 | 둘째 요청부터 13-20초, 첫 요청은 30초 이상 더 걸림 | 절반 틀림. 17.2초, 첫 요청은 17.7초 더 걸림 |
실제 사진에서는 P1의 reserved 조건이 7.19GB로 맞습니다. 이것은 결과를 본 뒤에 알게 된 사실입니다.
빠진 단계를 알아챈 뒤 예측을 두 번 더 적었습니다. 둘 다 사후 예측입니다. 첫 번째는 제한 없는 사진 최고치를 이미 본 뒤에 적었습니다. 그래서 bf16이 두 제한에서 끝나고 7,680MiB 아래에 머문다는 예측은 맞았지만 결과가 사실상 정해져 있었습니다. 제대로 된 검증은 fp32뿐이었습니다. 7,188 제한에서 메모리가 부족할 것이라고 적었는데 끝까지 돌았습니다. 두 번째는 제대로 된 검증이었습니다. 배경을 미리 지운 사진이 미리보기 이미지와 30MiB 안으로 돌아올 것이라고 적었고, 실제로 그랬습니다(nvidia-smi 6,616과 6,618, reserved 6,096과 6,096).
한계
- 실제 8GB 카드가 아닙니다. A100 카드 한 장에서 PyTorch가 8GB 카드만큼만 쓰도록 제한해 쟀습니다. 실제 8GB 카드는 CUDA 컨텍스트와 커널 크기가 다를 수 있고, 보고하는 총량이 8,192MiB보다 조금 적을 수도 있습니다.
- 300MiB는 넉넉하지 않습니다. 데스크톱 512MiB는 저희 가정입니다. 하드웨어 가속을 쓰는 브라우저나 두 번째 모니터가 있으면 더 쓸 수 있습니다. 다른 프로그램을 닫거나 모니터를 연결하지 않은 카드를 쓰는 편이 안전합니다.
- 입력이 적습니다. 신발, 등불, 생성한 용과 README 미리보기 이미지 네 장이 전부입니다. 각 이미지는 입력과 Idol이 만든 결과가 한 프레임에 나란히 있습니다. 같은 묶음 안에서는 최고치가 같았지만 다른 입력에서는 달라질 수 있습니다.
- 품질은 재지 않았습니다. 어떤 설정에서든 결과를 보여 줄 뿐 채점하지 않았습니다.
- 일부 시간 기록은 뺐습니다. 사진 실행 후반에 다른 작업이 같은 GPU를 함께 썼습니다. 메모리 수치는 프로세스별이라 영향이 없고, 시간은 GPU를 혼자 쓴 실행만 적었습니다.
다음 한 걸음
같은 카드에 GGUF 텍스트 모델을 llama-server로 올린다면 짧게 두 번 띄워 메모리를 가늠하는 방법을 써 보세요. LFM3 모델 네 개(텍스트, 비전, 오디오, 옴니)를 4·6·8GB 카드에 맞춰 본 내용은 LFM3 글에 있습니다.