LoRA를 19줄로 직접 만들기: PEFT와 숫자가 똑같았고, 메모리는 예상보다 덜 줄었습니다
PyTorch로 LoRA 층을 직접 만들어 Qwen2.5-0.5B에 끼우고 PEFT와 비교했습니다. 출력과 30스텝 학습이 비트 단위로 같았습니다. GPU 메모리는 fp32·길이 512에서 34% 줄었고, 저희가 예측한 절반에는 못 미쳤습니다.
LoRA를 19줄로 직접 만들기: PEFT와 숫자가 똑같았고, 메모리는 예상보다 덜 줄었습니다
실행하기 전에 저희는 예측 하나를 적어 두었습니다. Qwen2.5-0.5B를 fp32, 배치 4, 길이 512로 학습할 때 LoRA를 쓰면 피크 메모리가 전체 파인튜닝의 절반 아래로 내려간다는 예측이었습니다. 실제로는 66%였습니다. 전체 파인튜닝이 15.56GiB, LoRA가 10.31GiB였습니다. 함께 등록한 길이 4,096 조건은 80GB A100에서도 두 방식 모두 메모리가 모자라 돌지 못했습니다.
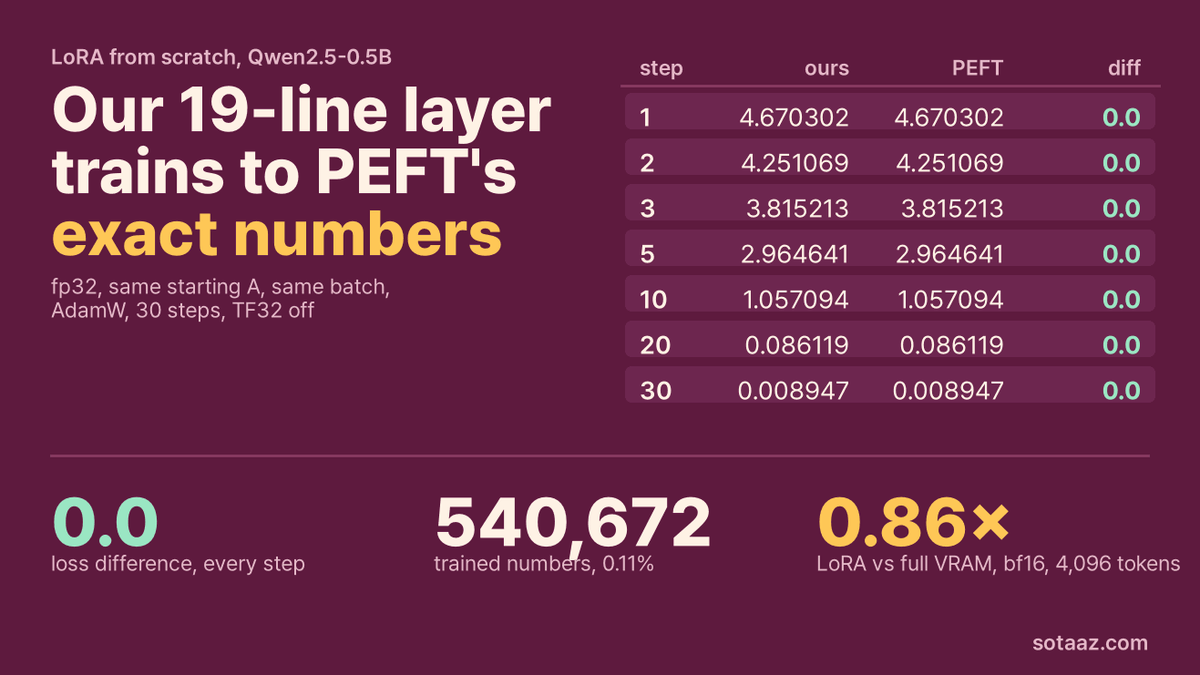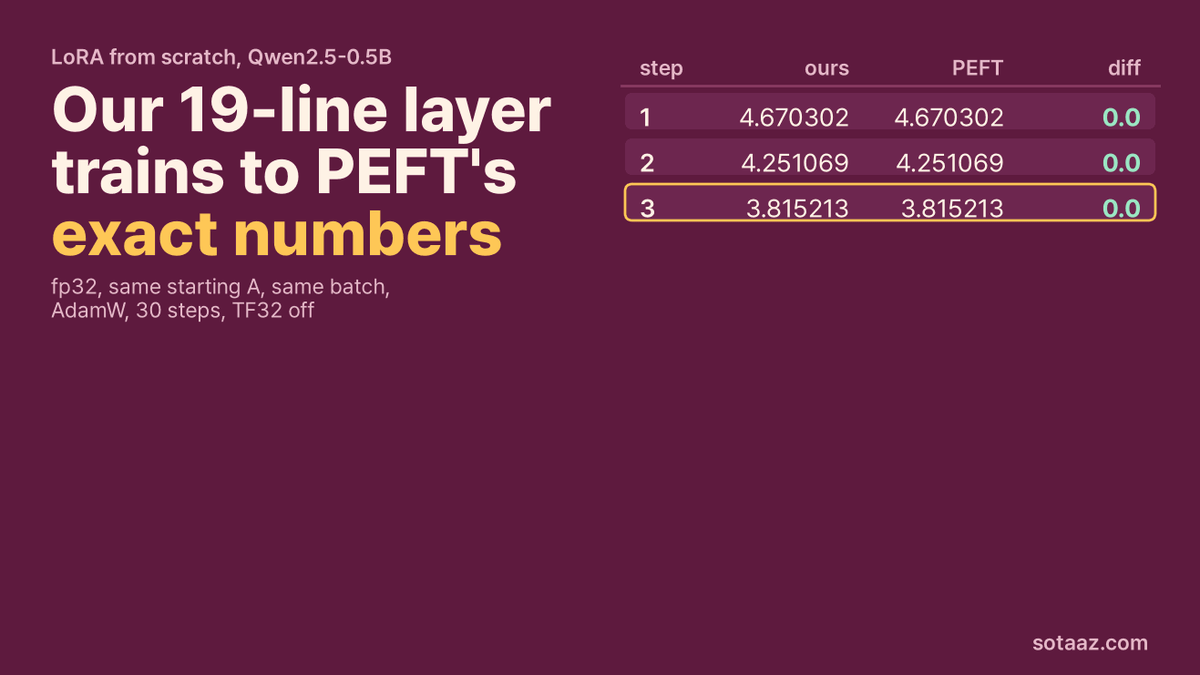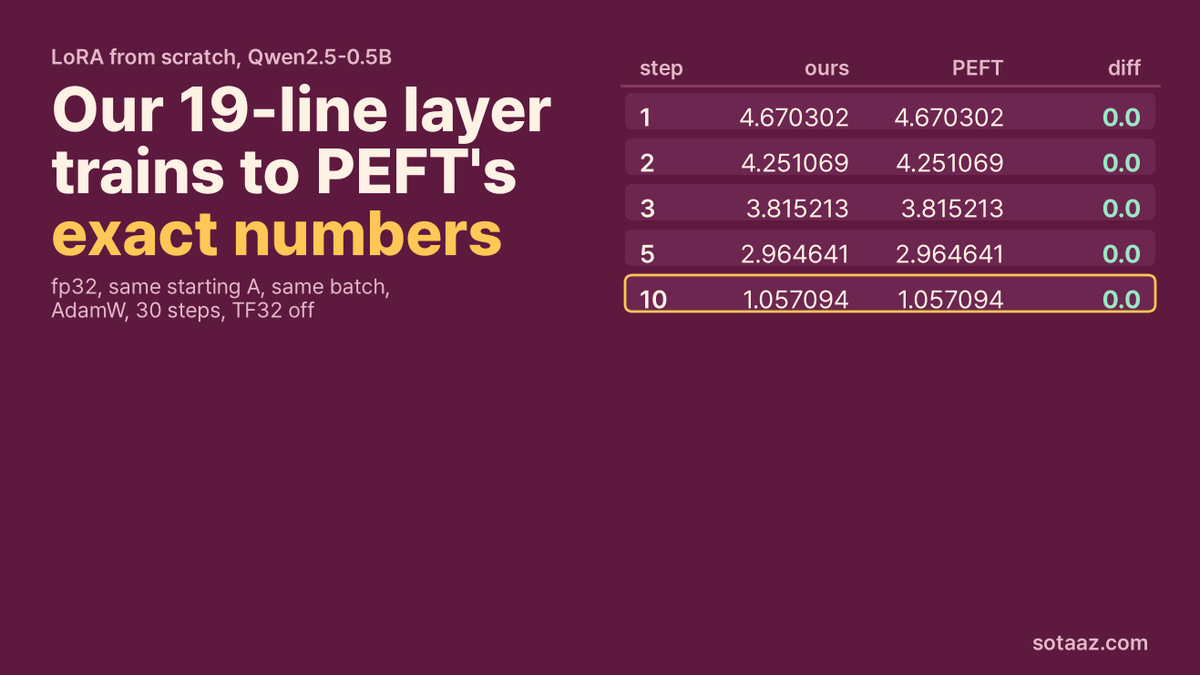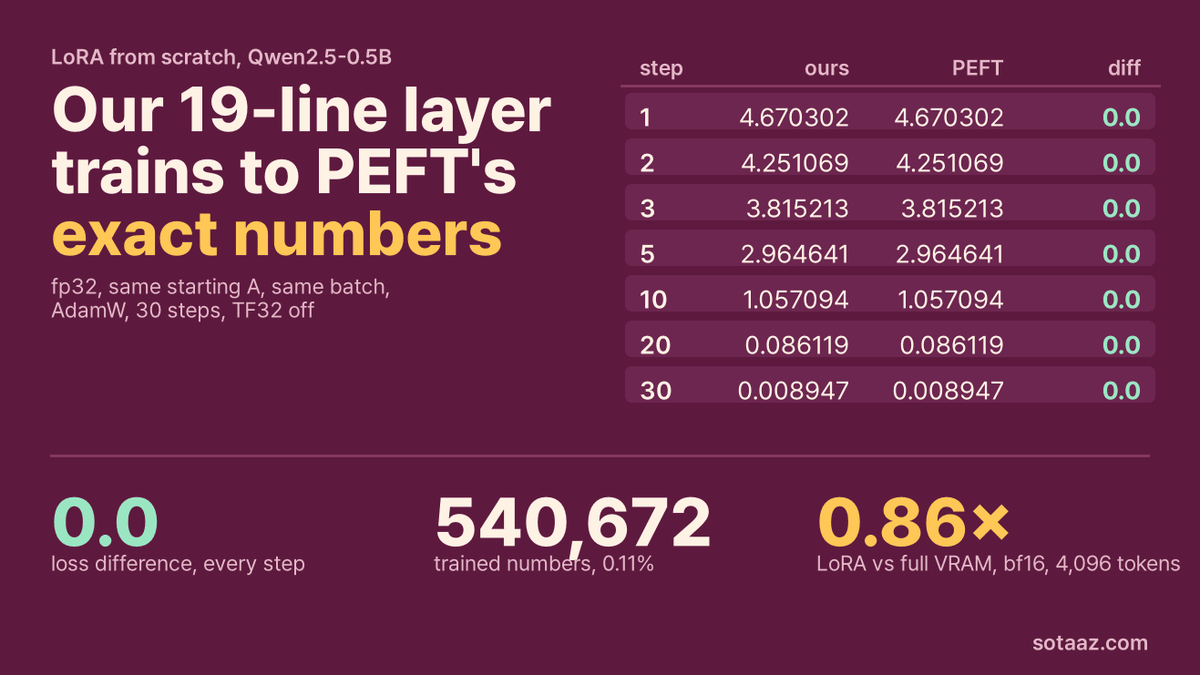
PEFT와 맞춰 보는 예측은 모두 맞았습니다. 저희가 19줄로 만든 LoRA 클래스는 PEFT 라이브러리와 logits가 완전히 같았고, 같은 배치로 30스텝을 학습시켰을 때도 loss가 마지막 비트까지 같았습니다. 학습한 어댑터를 가중치에 합치는 병합은 예측을 벗어났습니다. 다만 fp32에서는 1등 토큰이 하나도 바뀌지 않았습니다. bf16에서는 어댑터 모델과 병합 모델의 결과가 갈라졌는데, fp32 결과에서 더 멀어진 쪽은 병합 모델이 아니라 어댑터 모델이었습니다.
이 글은 따라 하는 튜토리얼입니다. 층을 만들고, 실제 모델에 끼우고, PEFT와 맞춰 보고, 병합한 뒤, GPU 메모리를 직접 잽니다. LoRA 변형 연재의 3편입니다. 2편에서는 변형 다섯 가지를 표 하나에 놓았습니다. LoRA가 처음이라면 1편부터 보시면 됩니다.
준비물
PyTorch 2.7.0, Transformers 5.20.2, PEFT 0.21.2를 A100 80GB 한 장에서 돌렸습니다. 모델은 Qwen/Qwen2.5-0.5B-Instruct입니다. 24층이고 hidden 크기는 896이며, key와 value 헤드가 64차원짜리 2개라서 v_proj는 숫자 896개를 128개로 바꿉니다. 1단계부터 4단계까지는 여유 메모리가 몇 GB만 있으면 어느 GPU에서나 됩니다. 5단계의 긴 입력만 큰 카드가 필요합니다.
1단계: 층 만들기
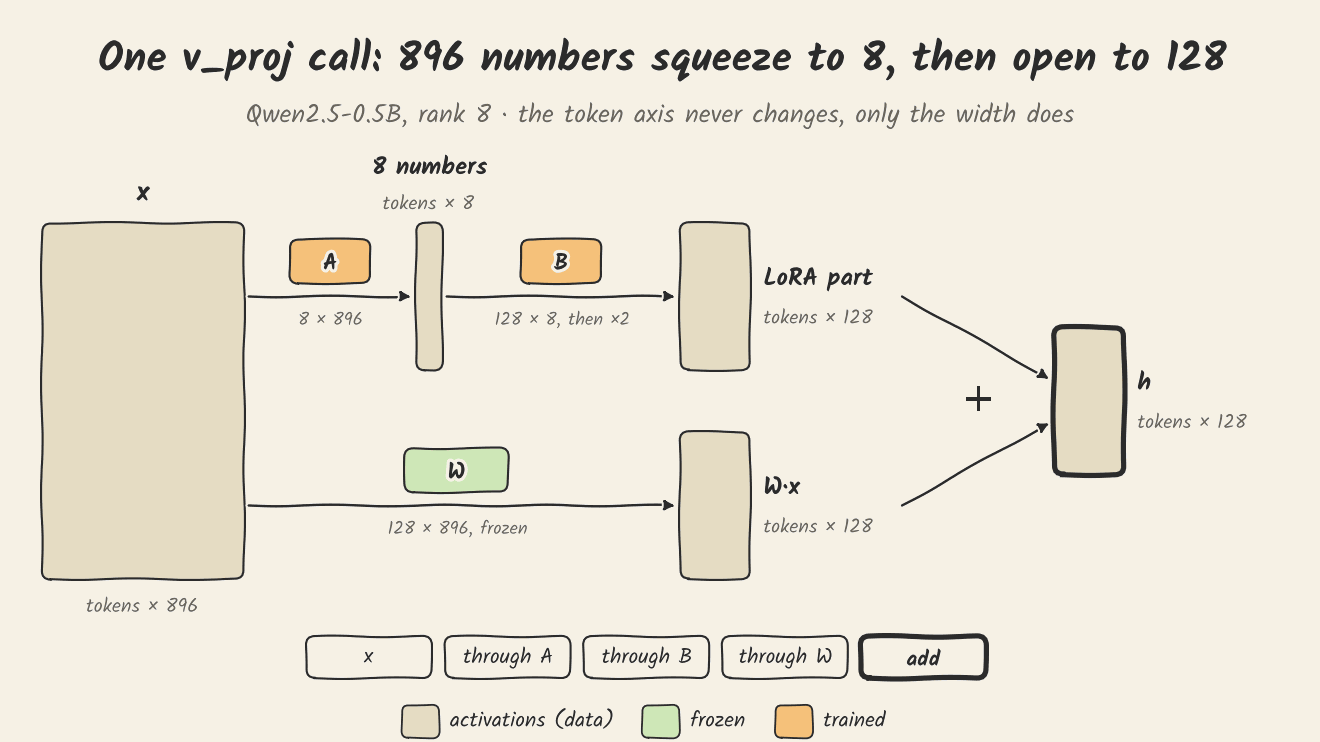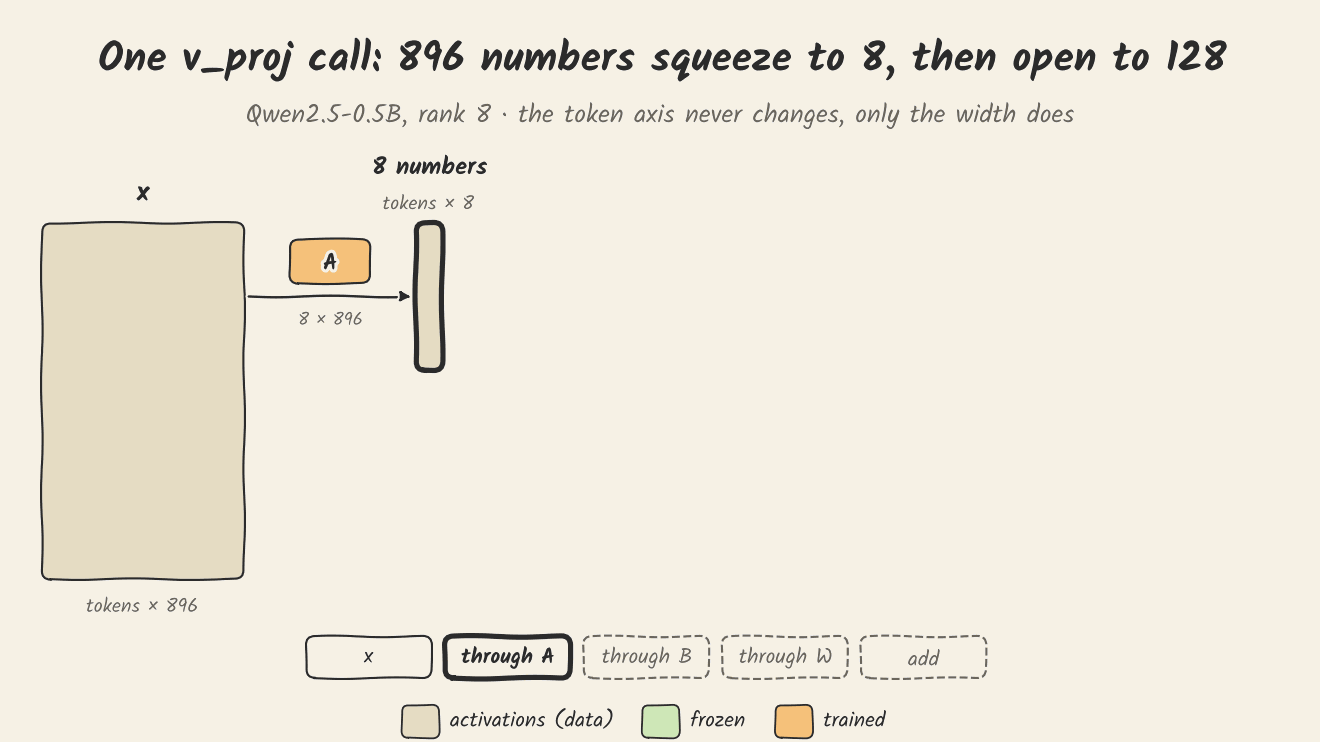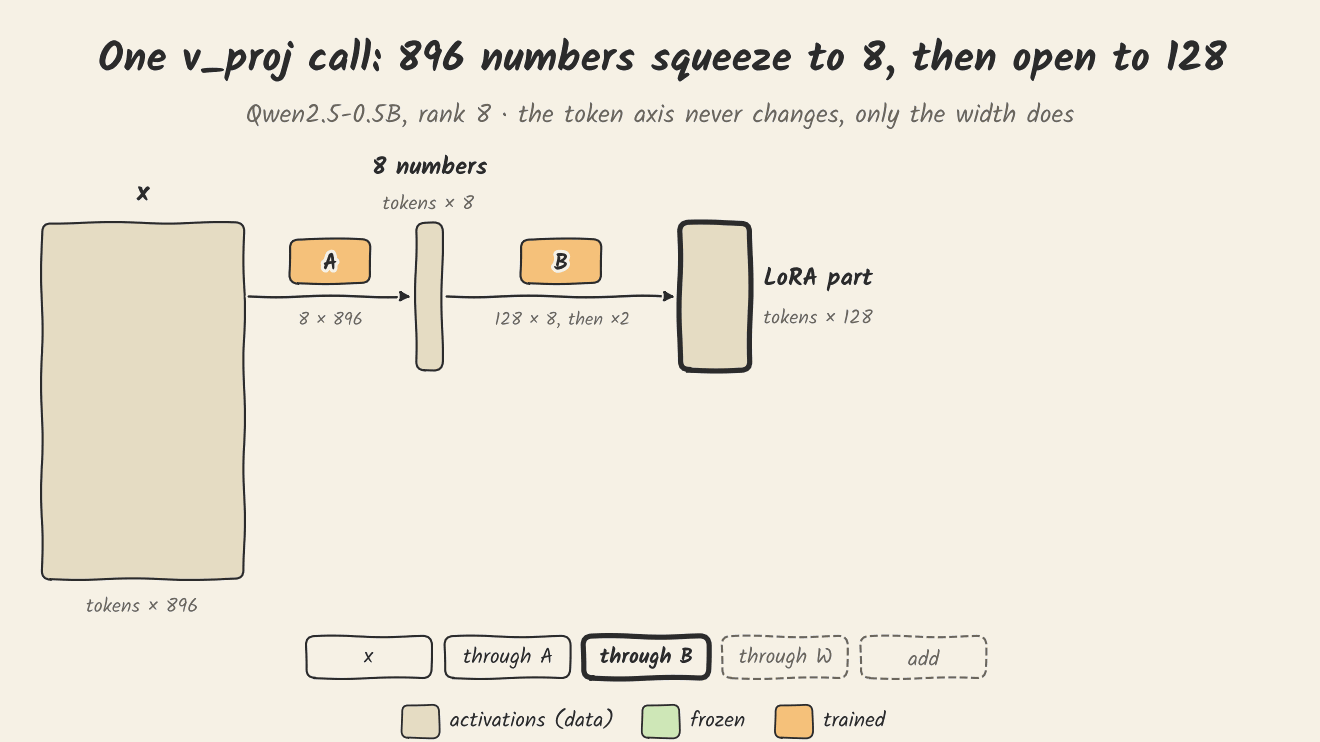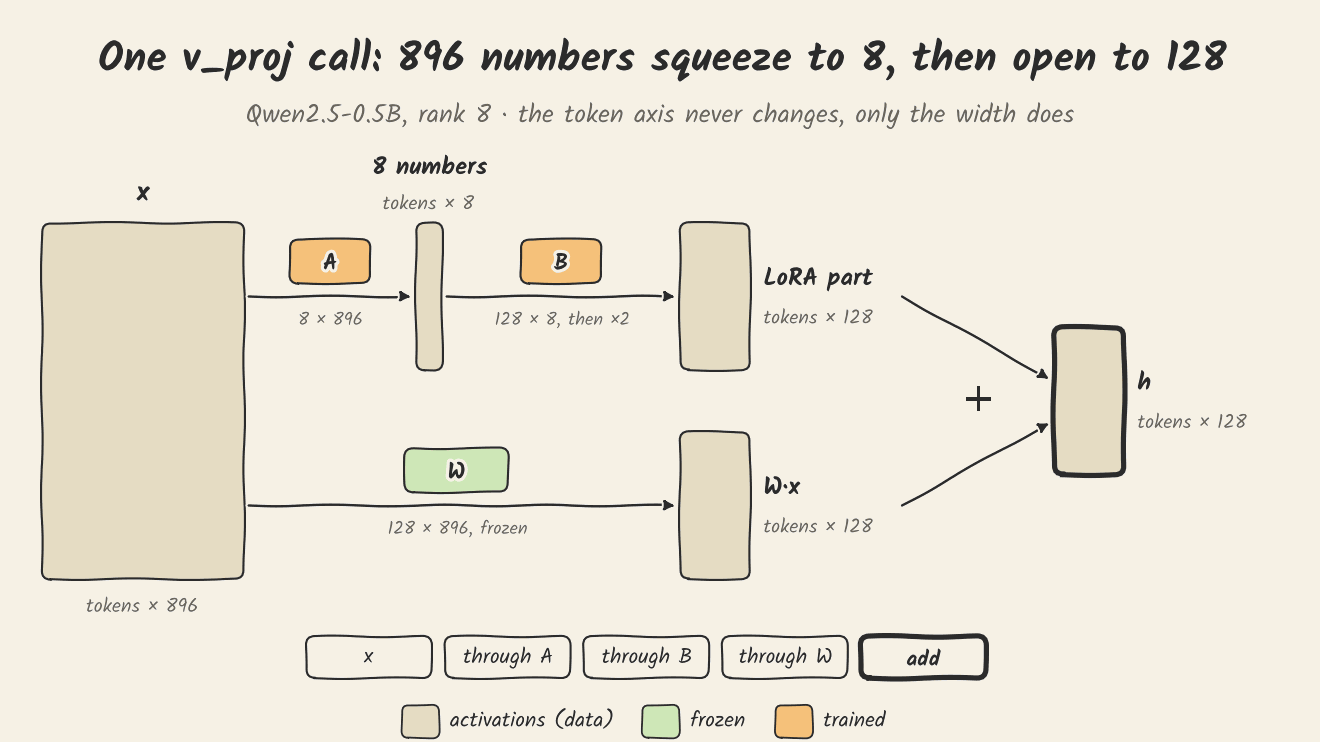
선형 층은 h = W x를 계산합니다. LoRA는 W를 얼려 두고 작은 경로를 하나 더합니다. h = W x + (α/r) · B A x입니다. A는 r × 입력 크기이고 무작위 값으로 시작합니다. B는 출력 × r 크기이고 0으로 시작합니다. 그래서 학습 전에는 원래 층과 출력이 똑같습니다.
import math
import torch
import torch.nn as nn

class LoRALinear(nn.Module):
    """h = W x + (alpha / r) * B A x ; W frozen, only A and B train."""
    def __init__(self, base: nn.Linear, r: int, alpha: float):
        super().__init__()
        self.base, self.scale = base, alpha / r
        for p in self.base.parameters():
            p.requires_grad_(False)
        w = base.weight   # A and B live on W's device and dtype
        self.A = nn.Parameter(torch.empty(r, base.in_features, device=w.device, dtype=w.dtype))
        self.B = nn.Parameter(torch.zeros(base.out_features, r, device=w.device, dtype=w.dtype))
        nn.init.kaiming_uniform_(self.A, a=math.sqrt(5))   # PEFT's default; the paper says Gaussian

    def forward(self, x):
        return self.base(x) + self.scale * ((x @ self.A.T) @ self.B.T)

    def merge(self) -> nn.Linear:
        with torch.no_grad():
            self.base.weight += (self.scale * (self.B @ self.A)).to(self.base.weight.dtype)
        return self.base
클래스는 19줄입니다. 이 안에서 눈여겨볼 선택이 세 가지 있고, 이유는 저마다 다릅니다.
- 배율
alpha / r때문에 출력이 PEFT와 같아집니다.r = 8,alpha = 16이면 2입니다. 배율이 다르면 층이 다른 값을 계산합니다. - A는 PEFT 기본값인 Kaiming-uniform(
a = sqrt(5))으로 초기화합니다. LoRA 논문은 가우시안 무작위 값을 썼습니다. 3단계에서는 어차피 A를 PEFT 쪽에 복사하므로 이 선택이 비교 결과를 정하지는 않습니다. 새로 만든 층이 PEFT 층과 같은 방식으로 출발하게 할 뿐입니다. - 곱하는 순서
(x @ A.T) @ B.T는 계산량 때문입니다. 토큰마다 숫자를 8개로 줄였다가 다시 늘립니다.B @ A를 먼저 계산하면 호출할 때마다출력 × 입력크기의 큰 행렬이 생깁니다. 저랭크 경로를 따로 두는 이유가 이 행렬을 만들지 않기 위해서입니다.
아래 GIF는 v_proj 한 번의 호출이 이 순서를 어떻게 지나가는지 보여 줍니다.
2단계: 모델에 끼우기
모델 전체를 얼린 다음, 고른 선형 층만 LoRALinear로 바꿔 끼웁니다. LoRA 논문의 주 실험처럼 q_proj와 v_proj에 붙였습니다.
def add_lora(model, r=8, alpha=16, targets=("q_proj", "v_proj")):
    for p in model.parameters():
        p.requires_grad_(False)
    for module in list(model.modules()):
        for t in targets:
            child = getattr(module, t, None)
            if isinstance(child, nn.Linear):
                setattr(module, t, LoRALinear(child, r, alpha))
    return model
이제 학습되는 숫자를 세어 봅니다. 층마다 A는 8 × 입력개, B는 출력 × 8개입니다.
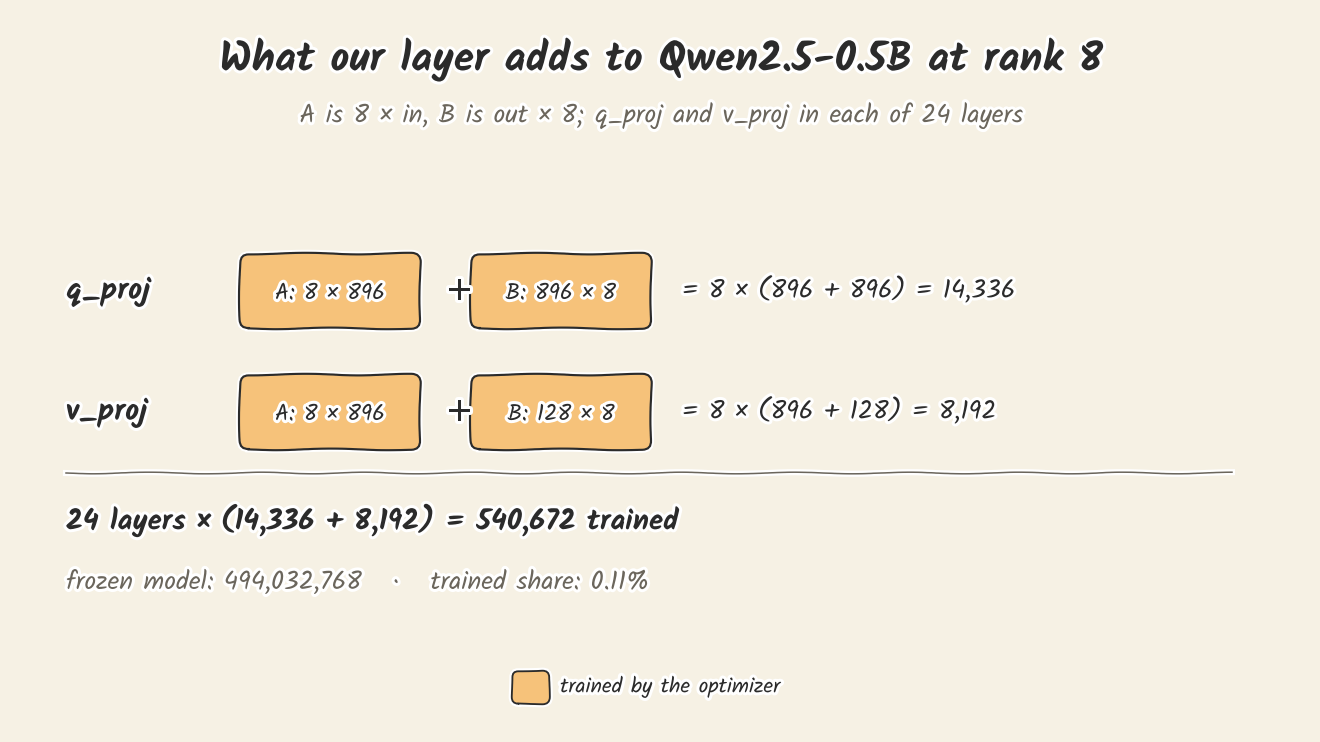
계산으로 540,672개가 나오고, 저희 모델과 PEFT 모델에서 requires_grad인 파라미터를 직접 세어도 540,672개입니다. 얼린 모델 494,032,768개의 0.11%입니다.
3단계: PEFT와 맞춰 보기
모델을 두 번 불러옵니다. 하나는 add_lora로 감싸고, 다른 하나는 PEFT의 LoraConfig(r=8, lora_alpha=16, lora_dropout=0.0, target_modules=["q_proj", "v_proj"])로 감쌉니다. 그다음 저희 A, B를 PEFT 쪽에 복사해서 같은 숫자로 출발하게 합니다.
peft_layers = dict(peft_model.base_model.model.named_modules())
with torch.no_grad():
    for name, ours in mine.named_modules():
        if isinstance(ours, LoRALinear):
            theirs = peft_layers[name]
            theirs.lora_A["default"].weight.copy_(ours.A)
            theirs.lora_B["default"].weight.copy_(ours.B)
두 모델 모두 평범한 fp32 행렬곱을 하도록 모델을 fp32로 불러오고 TF32를 껐습니다(torch.backends.cuda.matmul.allow_tf32 = False). attention은 eager 구현을 썼습니다. 이 설정 없이도 같게 나오는지는 시험하지 않았습니다.
B가 0이면 두 모델 모두 원래 모델과 같아서 아무것도 시험하지 못합니다. 그래서 B를 작은 무작위 값(표준편차 0.02, 시드 1)으로 채워 양쪽에 복사한 뒤, 영어 두 문장과 한국어 두 문장으로 logits를 비교했습니다. 가장 큰 차이는 0.0이었습니다. logits 값은 크게는 25.5까지 갔습니다.
이어서 B를 다시 0으로 돌리고, 각 모델에 학습률 1e-3인 AdamW를 따로 주어 같은 배치로 30스텝 학습했습니다.
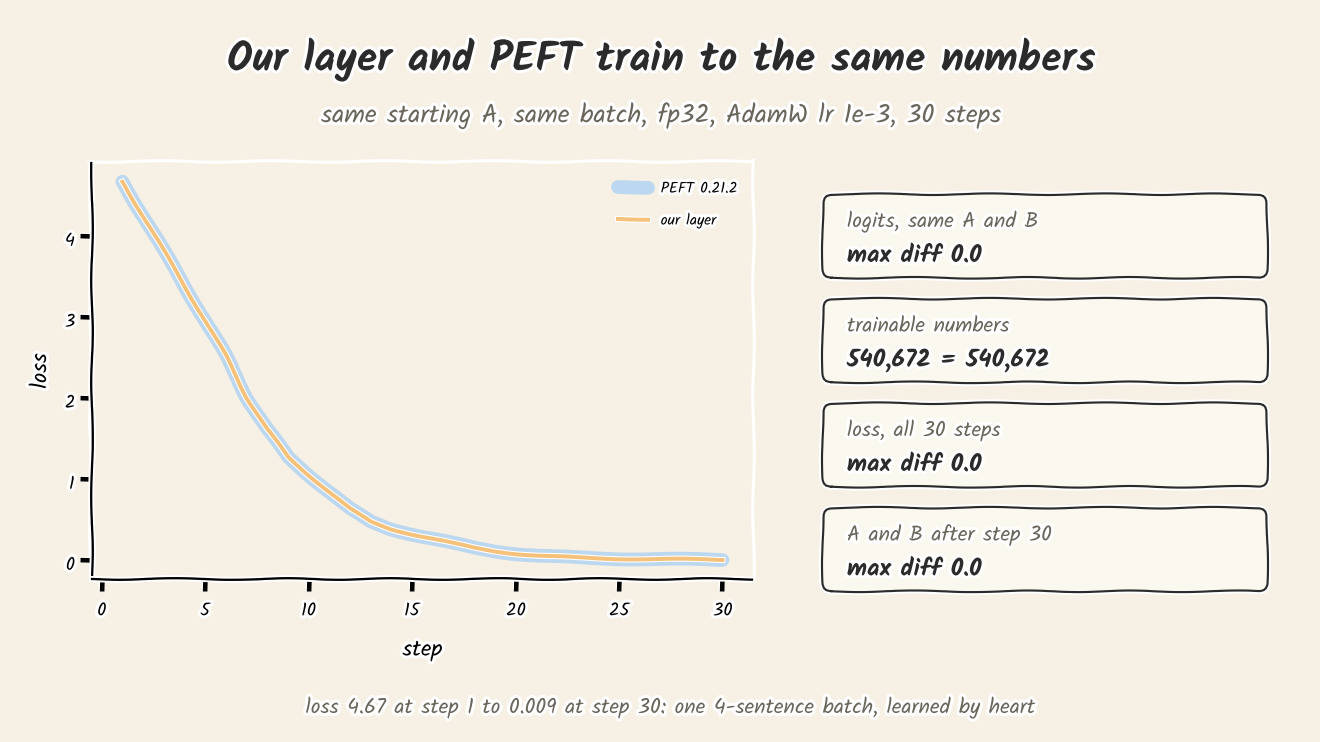
30스텝의 loss가 하나도 빠짐없이 같았고, 마지막 스텝 뒤의 A와 B도 같았습니다. loss가 0.009까지 내려간 것은 모델이 네 문장을 외웠다는 뜻일 뿐입니다. 이 확인은 두 구현이 같은 계산을 하는지 보는 것이고, 쓸모 있는 학습이 됐는지 보는 것은 아닙니다.
4단계: 어댑터를 W에 합치기
학습이 끝나면 어댑터를 가중치에 접어 넣을 수 있습니다. W' = W + (α/r) · B A로 바꾸고 A와 B는 버립니다. 모델 모양이 원래와 같아지므로 추론할 때 추가 계산이 없습니다.
def merge_lora(model):
    for module in list(model.modules()):
        for name, child in list(module.named_children()):
            if isinstance(child, LoRALinear):
                setattr(module, name, child.merge())
    return model
저희는 병합한 모델과 어댑터를 단 모델의 logits 차이가 1e-4 안쪽일 거라고 예측했습니다. 30스텝 학습 뒤 등록한 방식으로 잰 최대 차이는 7.3e-4로, 예측을 벗어났습니다. 이 값에는 패딩 위치가 들어 있습니다. 실제 토큰 82개 위치만 따로 재면(사후 추가) 1.1e-4로, 이것도 기준보다 큽니다. 수식으로는 둘이 같지만, 컴퓨터가 더하는 순서가 달라지면 반올림도 달라집니다. logits는 그만큼만 움직였습니다. 82개 위치 모두에서 1등 토큰이 같았고, loss는 양쪽 다 0.0079393이었습니다.
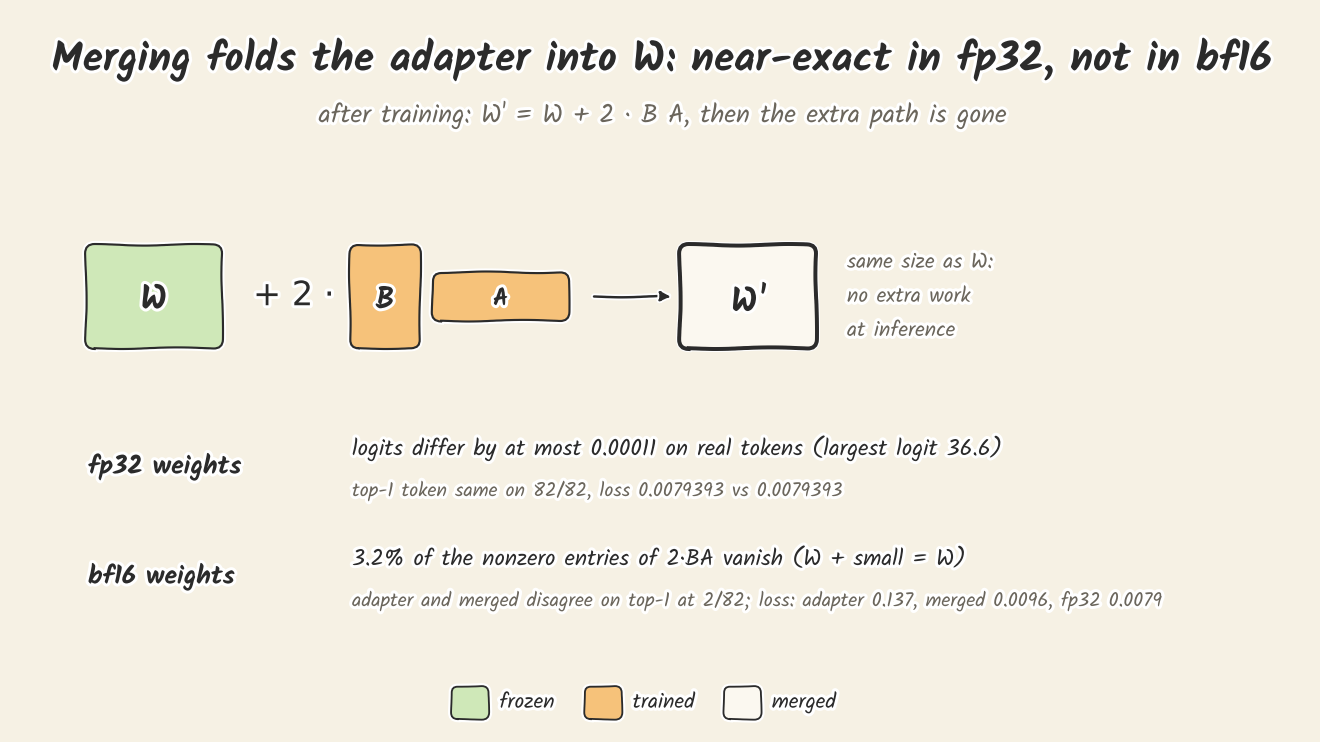
bf16 가중치에 병합하면 결과가 다릅니다. 이 부분은 예측을 적은 뒤에 추가로 시험했습니다. 같은 A, B를 bf16 모델에 붙여 병합했더니, 2 · B A의 0이 아닌 값 22,020,085개 중 3.2%가 사라졌습니다. bf16 가중치에 더하기에는 너무 작아서 가중치가 바뀌지 않은 것입니다. 그 결과 어댑터 모델과 병합 모델은 82개 위치 중 2곳에서 1등 토큰이 달랐고, 실제 토큰 위치에서 잰 logits 차이는 최대 15.1이었습니다. 이때 가장 큰 logit이 35.75였습니다.
둘 중 어느 쪽이 움직였는지 보려고 각각을 fp32 어댑터 모델과 비교했습니다. 더 멀리 간 쪽은 bf16 어댑터 모델이었습니다. logits가 최대 14.6 벌어졌고 loss는 0.137이었습니다. 병합 모델은 최대 5.2 차이에 loss 0.0096이었고, fp32는 0.0079입니다. 1등 토큰은 둘 다 82개 중 81곳에서 fp32와 같았습니다. bf16 모델 위에서 A, B와 저랭크 곱만 fp32로 계산해도 나아지지 않았습니다(최대 14.5 차이, loss 0.143). 그러니 이 차이는 A, B와 그 곱의 정밀도에서 오는 것이 아닙니다. 다만 이 비교에서도 마지막 덧셈은 bf16이었습니다. 어디서 오는지는 아직 찾지 못했고, 네 문장을 외운 배치 하나의 결과입니다.
5단계: 메모리 직접 재 보기
파인튜닝이 내 카드에 들어가는지는 피크 메모리가 정합니다. 저희가 쓴 루프는 아래와 같습니다. 한 번은 모든 가중치를 학습시키고, 한 번은 add_lora를 적용한 뒤 돌립니다. 모델은 attn_implementation="sdpa"와 재고 싶은 dtype으로 불러와 .to("cuda")로 GPU에 올립니다.
model.train()
opt = torch.optim.AdamW([p for p in model.parameters() if p.requires_grad], lr=1e-5)
ids = torch.randint(0, model.config.vocab_size, (4, 512), device="cuda")   # batch 4, 512 tokens
for step in range(3):
    torch.cuda.reset_peak_memory_stats()
    loss = model(input_ids=ids, labels=ids).loss
    loss.backward()
    opt.step(); opt.zero_grad(set_to_none=True)
    print(step, f"{torch.cuda.max_memory_allocated() / 2**30:.2f} GiB peak")
마지막 스텝 값을 읽습니다. AdamW는 첫 opt.step()에서 상태 텐서 2개를 만들기 때문에 첫 스텝에는 아직 그 몫이 없습니다.
메모리는 어디에 쓰였나
등록한 예측은 fp32, 배치 4, 길이 512에서 LoRA가 전체 파인튜닝의 절반 아래라는 것이었습니다.
| fp32 | 전체 | LoRA | LoRA / 전체 |
|---|---|---|---|
| 배치 4, 512토큰 | 15.56GiB | 10.31GiB | 0.66 |
| 배치 4, 1,024토큰(사후 추가) | 28.20GiB | 21.37GiB | 0.76 |
| 배치 4, 2,048토큰(사후 추가) | 61.35GiB | 51.39GiB | 0.84 |
| 배치 4, 4,096토큰 | 메모리 부족 | 메모리 부족 | |
| 배치 1, 4,096토큰(사후 추가) | 43.95GiB | 37.13GiB | 0.84 |
| 배치 2, 4,096토큰(사후 추가) | 메모리 부족 | 72.39GiB |
고정분은 계산대로 나왔습니다. backward가 끝난 시점에 전체 파인튜닝은 가중치, 기울기, Adam 상태 2개를 들고 있고 그 합이 7.40GiB였습니다. 미리 계산한 7.9GB(7.4GiB)와 가깝습니다. LoRA는 1.87GiB였고 거의 전부가 얼린 가중치입니다. 고정분의 차이 약 5.5GiB는 길이와 상관없이 같습니다. 그런데도 피크의 차이는 표의 앞 세 줄에서 5.26GiB, 6.83GiB, 9.96GiB로 커졌습니다. 토큰 수에 따라 늘어나는 몫 때문입니다.
P5가 틀린 것도 이 몫 때문입니다. 토큰마다 24층 각각이 backward를 위해 활성화를 남기고, 토큰마다 어휘 크기만큼인 151,936개의 logits가 나옵니다. 길이 512에서도 작지 않았습니다. 아래 bf16 분해(사후 추가)에서 배치 4 기준으로 24층이 2.02GiB, logits와 loss가 1.74GiB를 남겼습니다.
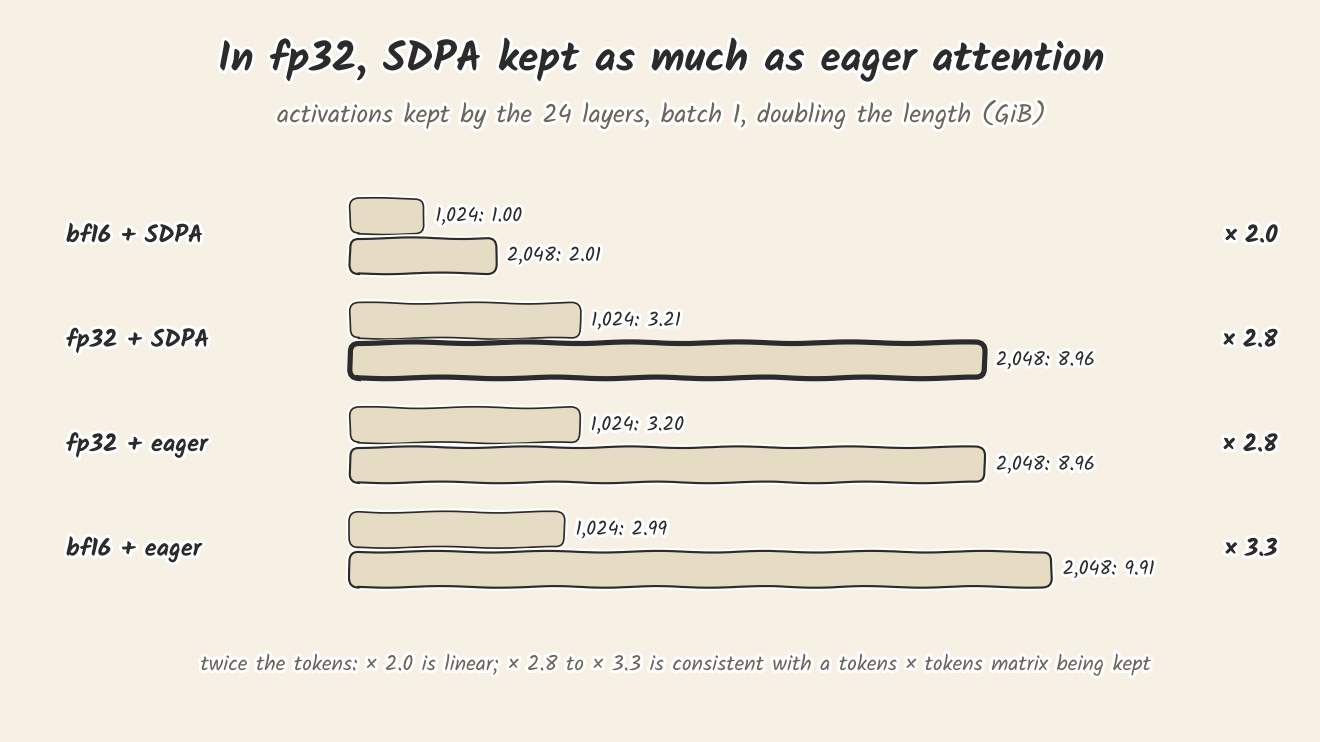
fp32에서는 비용이 하나 더 붙습니다. 1,024토큰과 2,048토큰에서 재 보니(사후 추가), 길이를 두 배로 늘렸을 때 fp32와 SDPA 조합에서 층의 활성화가 2.8배가 됐습니다. 토큰 × 토큰 attention 행렬을 통째로 남기는 eager와 같은 배율이고, bf16과 SDPA 조합은 2.0배였습니다. 실제로 어느 커널이 돌았는지는 확인하지 않았습니다. 그 행렬을 남긴다면 저희 계산으로 배치 4, 2,048토큰에서 약 21GiB, 4,096토큰에서 약 84GiB입니다. 4,096토큰에서는 이 행렬 하나만으로 카드 용량을 넘습니다.
bf16에서는
그래서 실제 학습을 계획할 때 쓸 bf16으로 다시 비교했습니다. 이 측정은 모두 사후에 추가한 것입니다.
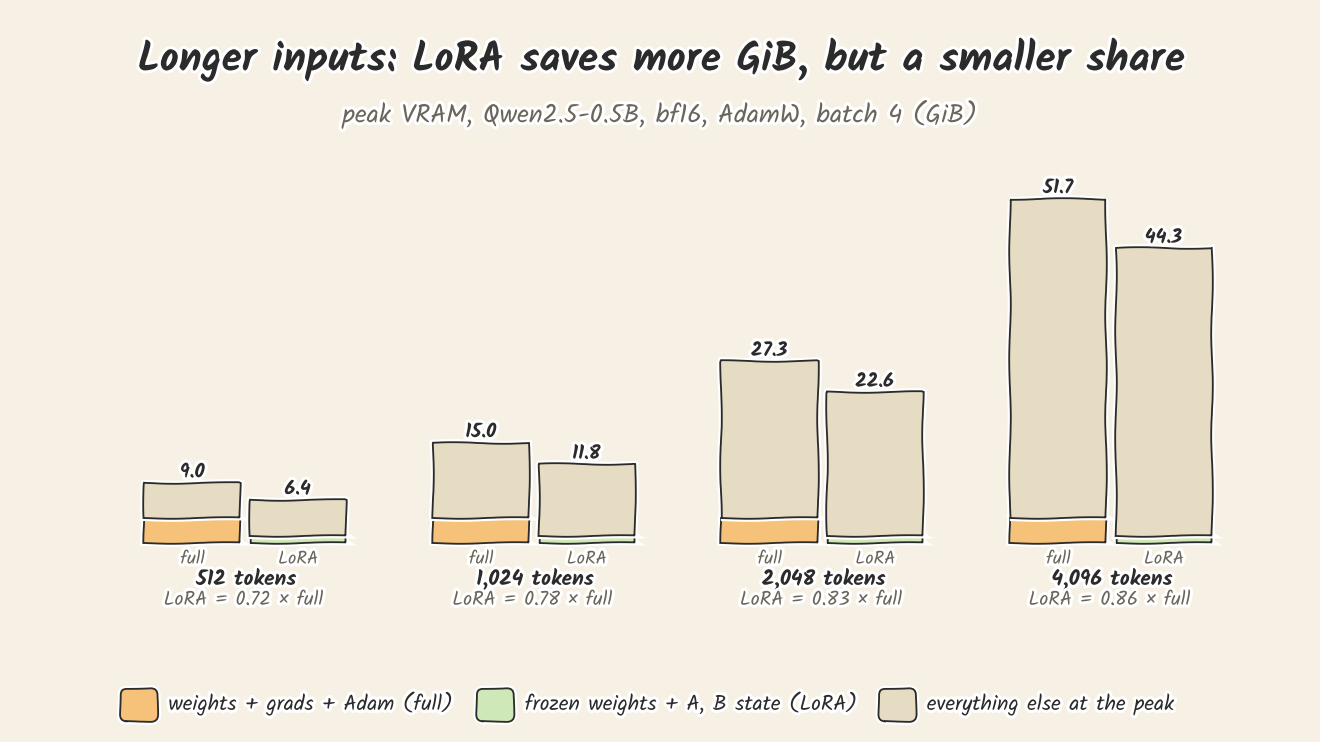
LoRA가 줄인 양은 512토큰에서 2.5GiB, 4,096토큰에서 7.5GiB였습니다. forward가 끝난 시점의 활성화 메모리는 저희가 잰 모든 길이에서 전체 파인튜닝보다 약 18% 적었습니다. 저희는 얼린 층은 가중치 기울기를 계산하지 않으니 입력을 남겨 둘 필요가 없기 때문이라고 봅니다. 그래도 전체 메모리가 이 절감보다 빨리 늘어서, LoRA가 줄이는 비율은 28%에서 14%로 작아졌습니다.
이 측정은 가중치, 기울기, Adam 상태를 모두 bf16으로 둔 순수 bf16 학습입니다. fp32 마스터 가중치를 따로 두는 혼합 정밀도 학습이라면 전체 파인튜닝이 더 무거워지고, LoRA가 줄이는 고정분도 더 커집니다.
bf16, 4,096토큰에서는 checkpointing이 LoRA보다 더 줄였습니다
LoRA를 써도 남는 메모리가 무엇인지 보려고, backward를 위해 남겨 두는 메모리를 transformer 24층 몫과 logits·loss 몫으로 나눠 쟀습니다(사후 추가). 그다음 gradient checkpointing을 켰습니다. 층의 활성화를 버렸다가 backward 때 다시 계산하는 방법입니다.
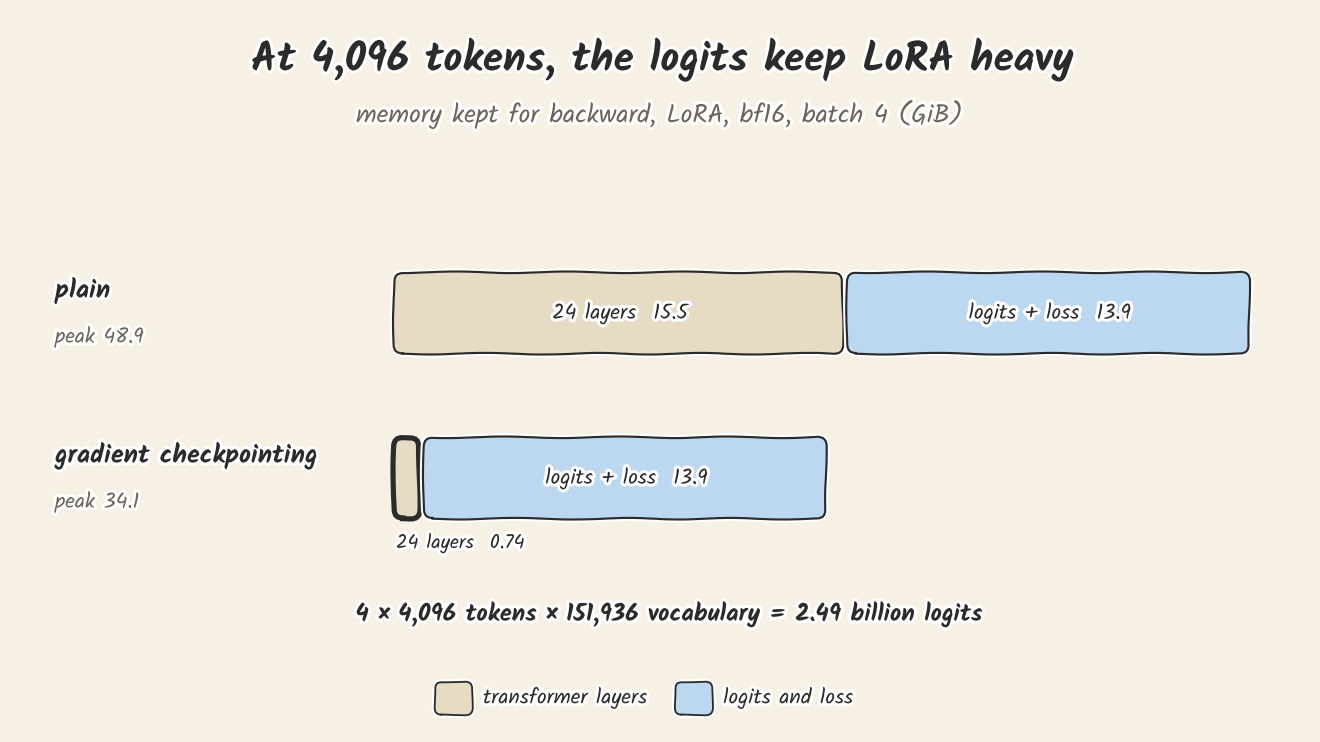
checkpointing으로 층 몫은 15.5GiB에서 0.74GiB로, 피크는 14.8GiB 줄었습니다. 같은 길이에서 LoRA가 전체 파인튜닝보다 줄인 양은 7.5GiB였습니다. logits 몫은 그대로였습니다. 4 × 4,096토큰이면 logits가 24.9억 개 나옵니다. bf16으로 4.64GiB이고, 저희 스크립트가 loss를 계산하려고 만드는 fp32 사본이 9.27GiB 더 듭니다. 이 13.9GiB는 LoRA도 checkpointing도 건드리지 않습니다.
이 분해는 loss를 직접 계산하는 별도 스크립트에서 나왔습니다. 그래서 피크(48.9GiB, 34.1GiB)가 위 그림의 44.3GiB와 조금 다르고, 두 절감량도 서로 다른 스크립트에서 잰 값입니다.
그래도 전체 파인튜닝은 들어가지 않고 LoRA는 들어간 경우가 하나 있었습니다. fp32, 4,096토큰, 배치 2에서 전체 파인튜닝은 80GB 카드에 들어가지 않았고 LoRA는 72.4GiB로 돌았습니다.
예측 채점
| # | 예측(실행 전에 커밋) | 결과 | |
|---|---|---|---|
| P1 | 같은 A, B에서 logits 차이 1e-5 이하 | 0.0 | 맞음 |
| P2 | 둘 다 학습 파라미터 540,672개 | 540,672와 540,672 | 맞음 |
| P3 | 30스텝 모두 loss 차이 1e-4 이하 | 모든 스텝 0.0 | 맞음 |
| P4 | 병합 모델과 어댑터 모델의 logits 차이 1e-4 이하 | 7.3e-4(실제 토큰만, 사후 추가: 1.1e-4) | 틀림 |
| P5 | fp32, 배치 4, 512토큰에서 LoRA 피크가 전체의 절반 미만 | 0.66 | 틀림 |
| P6 | 같은 조건 4,096토큰에서 LoRA가 전체의 60% 이상 | 둘 다 메모리 부족 | 판정 못 함 |
예측 파일에 적힌 층은 저희가 먼저 만든 판이고, 실제로 돌린 것은 그 뒤에 고친 판입니다. 고친 판은 A의 초기화를 1/√입력으로 나눈 가우시안에서 Kaiming-uniform으로 바꾸고, device·dtype 처리와 merge()를 더했습니다. P1부터 P3까지는 A를 PEFT 쪽에 복사하므로 이 변경이 결과를 바꿀 수 없습니다. 그래도 등록한 파일과 돌린 파일이 다르다는 점은 밝혀 둡니다. P6은 판정하지 못한 채로 둡니다. 위 표의 배치 1 측정은 다른 조건입니다.
확인하지 않은 것
- 모델 하나, rank 하나, 대상 층 두 개입니다. 모두 Qwen2.5-0.5B에 rank 8로
q_proj,v_proj에 붙인 결과입니다. 7B 모델은 고정분이 훨씬 커서 LoRA가 줄이는 비율도 더 클 것으로 보지만, 재 보지는 않았습니다. - 메모리는 PyTorch가 할당한 피크입니다.
nvidia-smi에 보이는 값은 CUDA 컨텍스트와 할당기 캐시가 더해져 이보다 큽니다. - 학습 비교는 네 문장짜리 배치 하나입니다. 두 구현이 같은 계산을 한다는 것만 보여 주고, 파인튜닝 품질에 대해서는 아무것도 말하지 않습니다.
- "사후 추가"로 표시한 측정은 등록한 결과를 설명하려고 고른 것입니다. fp32 추가 행, attention 측정, bf16 그림, 메모리 분해, 실제 토큰 기준 병합 지표, bf16 병합 비교 두 가지가 그렇습니다.
- loss를 조각으로 나눠 계산하는 방법은 시험하지 않았습니다. logits를 한 번에 일부씩만 만드는 방법으로, 위의 13.9GiB에 흔히 쓰는 해법입니다.
다음 글
다음 글에서는 이 층을 2편의 변형 네 가지로 바꿉니다. 각각 몇 줄만 다릅니다. LoRA-FA는 A를 얼리고, VeRA는 A와 B를 공유한 채 벡터 두 개만 학습하고, LoRA+는 B에 학습률을 따로 주고, Delta-LoRA는 B A의 변화량을 W에도 더합니다. 변형마다 학습되는 숫자를 세고, 5단계의 루프로 메모리를 잽니다. 아래 뉴스레터를 구독하시면 글이 나올 때 받아 보실 수 있습니다.