LoRA 변형 5종을 표 하나로: 초록만 읽으면 놓치는 설정과 조건
LoRA, LoRA-FA, VeRA, Delta-LoRA, LoRA+가 W, A, B 중 무엇을 학습하는지, 논문이 말하는 이득이 어디서 나오는지, 초록에는 없고 본문에만 있는 설정과 조건을 표 하나로 정리했습니다.
LoRA 변형 5종을 표 하나로: 초록만 읽으면 놓치는 설정과 조건
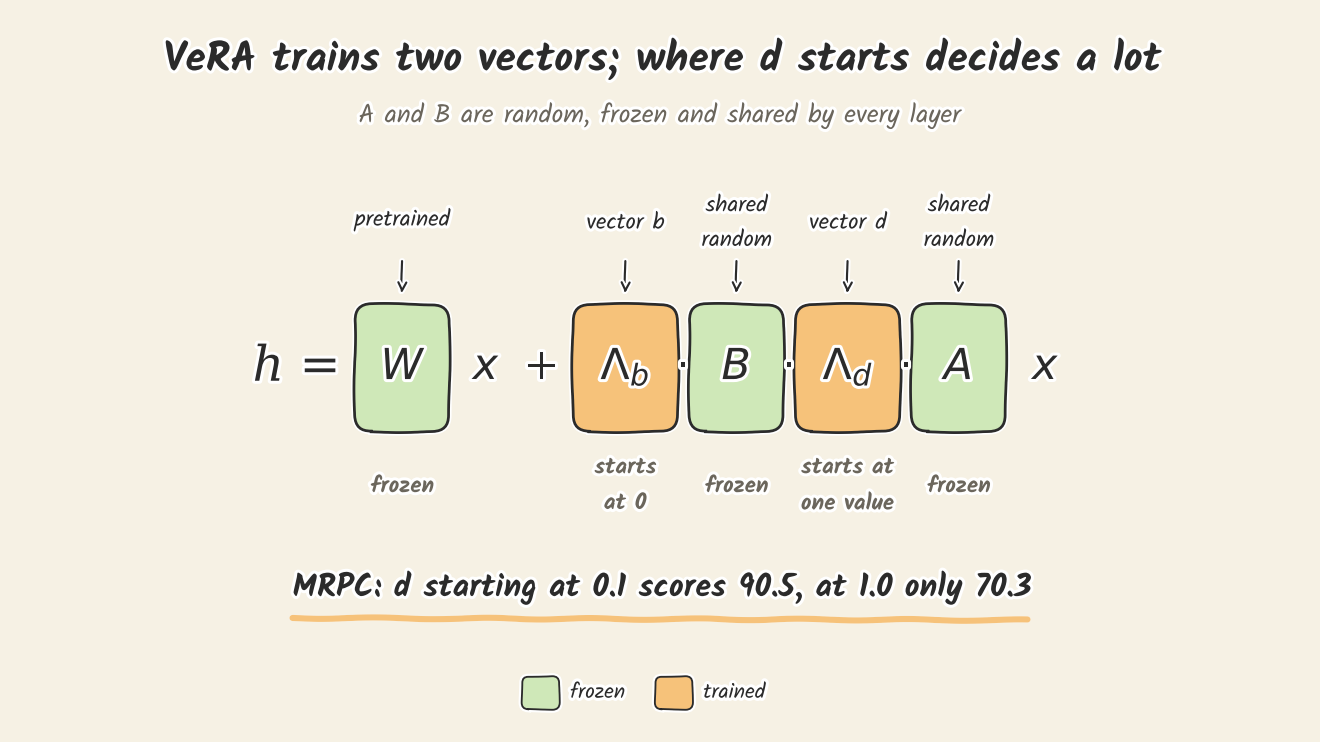
VeRA 논문의 그림은 학습하는 벡터 d를 1에서 시작하게 그려 놓았습니다. 그런데 같은 논문의 ablation에서 d를 1.0에서 시작한 경우가 시험한 값 중 가장 나빴습니다. MRPC 점수가 0.1에서 시작하면 90.5인데 1.0에서 시작하면 70.3입니다. 초록에는 d의 시작값 이야기가 아예 없습니다.
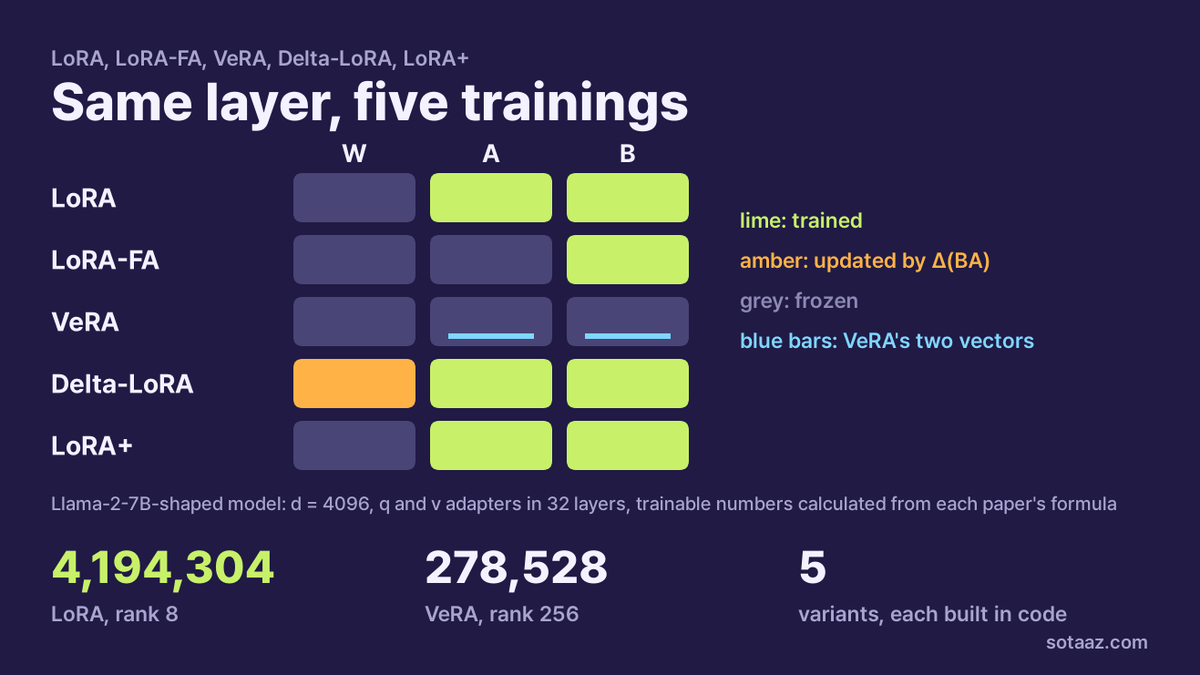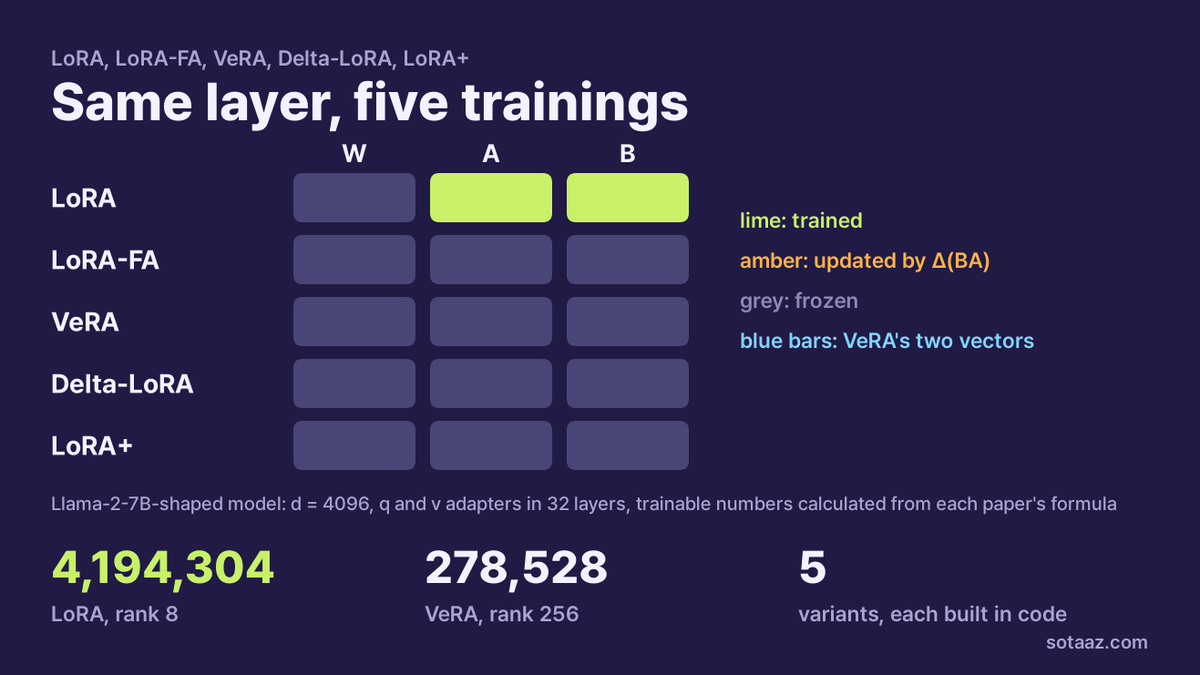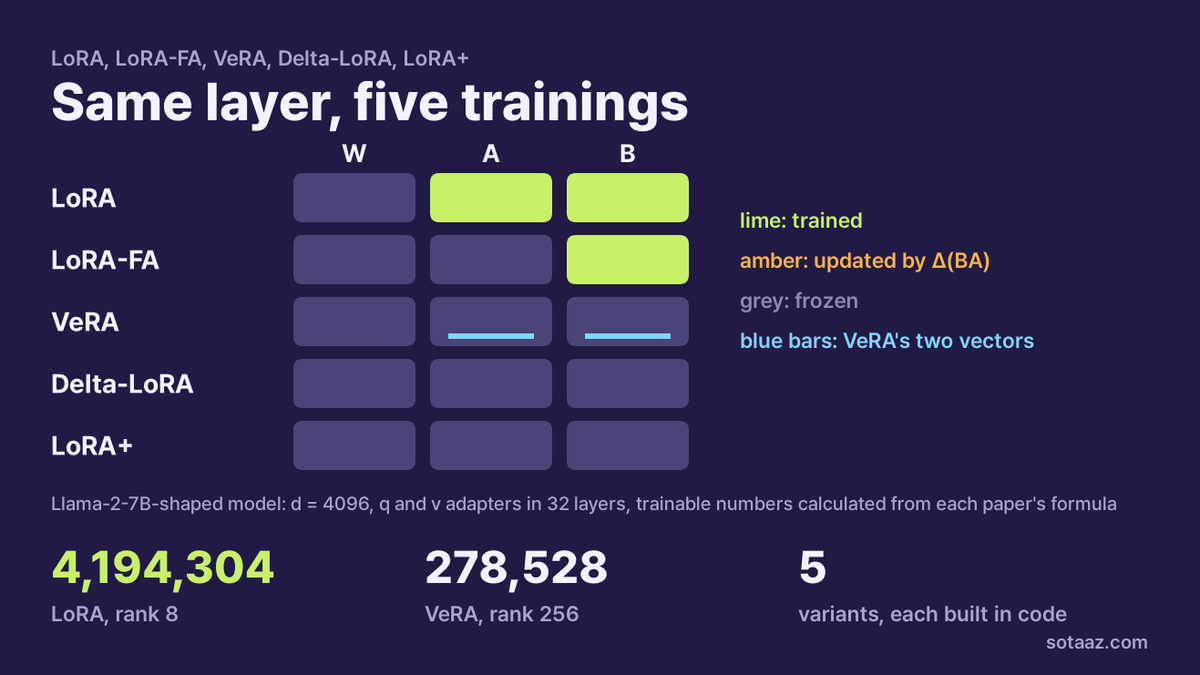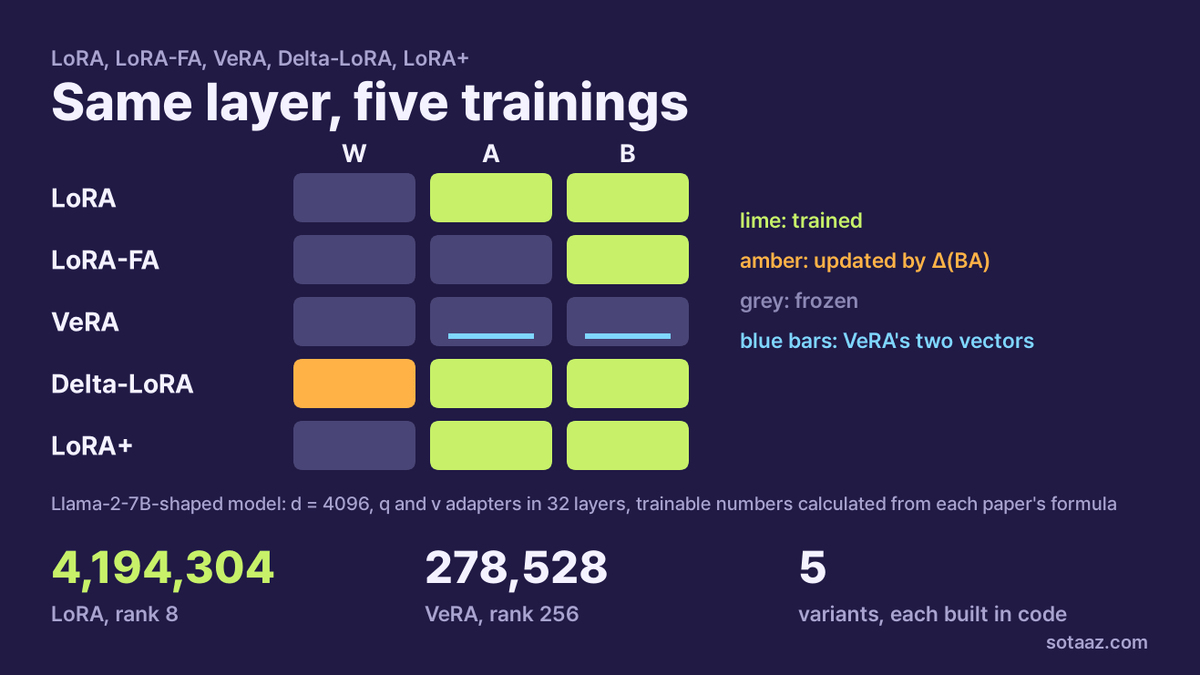
저희는 이 차이를 LoRA 변형 다섯 가지를 표 하나에 정리하다가 발견했습니다. 한 행에 변형 하나, 열은 층을 이루는 세 조각인 사전 학습 가중치 W와 작은 행렬 A, B입니다. 칸을 채우는 건 쉬웠습니다. 각 행을 논문과 대조하는 일은 그렇지 않았습니다. LoRA 다음의 네 변형 모두 초록을 지나 본문까지 읽어야 보이는 설정이나 조건이 하나씩 있었습니다. VeRA는 d의 시작값입니다. Delta-LoRA는 직접 정해야 하는 스텝 K가 지나야 W를 갱신하기 시작합니다. LoRA+의 초록은 학습률 비율을 "잘 골라야 한다"고만 하는데, 저자들이 찾은 최적값은 모델과 초기화에 따라 약 2에서 약 16까지 달라집니다. LoRA-FA가 내세우는 메모리 절감 수치는 모든 블록의 모든 선형 층에 어댑터를 단 경우를 전제합니다.
이 글은 지도입니다. 변형마다 무엇을 학습하는지, 논문이 말하는 이득이 어디서 나오는지, 직접 골라야 하는 설정이 무엇인지만 정리합니다. 실측은 하지 않았습니다. 이어지는 글에서 각 변형을 코드로 만들고, 마지막에 같은 조건에서 재 봅니다.
LoRA를 처음 쓴다면 LoRA 완전 정복 Part 1을 먼저 읽어 주세요. 이 글은 LoRA의 핵심을 한 줄로는 알고 있다고 가정합니다.
다섯 변형이 모두 출발하는 층
선형 층은 h = W x를 계산합니다. LoRA(Hu 외, arXiv:2106.09685)는 W를 얼려 두고 낮은 rank의 보정을 더합니다. 논문의 식 (3)과 스케일을 따르면 다음과 같습니다.
h = W x + (α/r) · B A x
A는 r × d_in 크기로 무작위로 시작하고, B는 d_out × r 크기로 0에서 시작합니다. 그래서 첫 스텝의 보정은 0입니다. 학습하는 것은 A와 B뿐이고, r이 d보다 훨씬 작으면 W보다 훨씬 적은 수만 학습합니다.
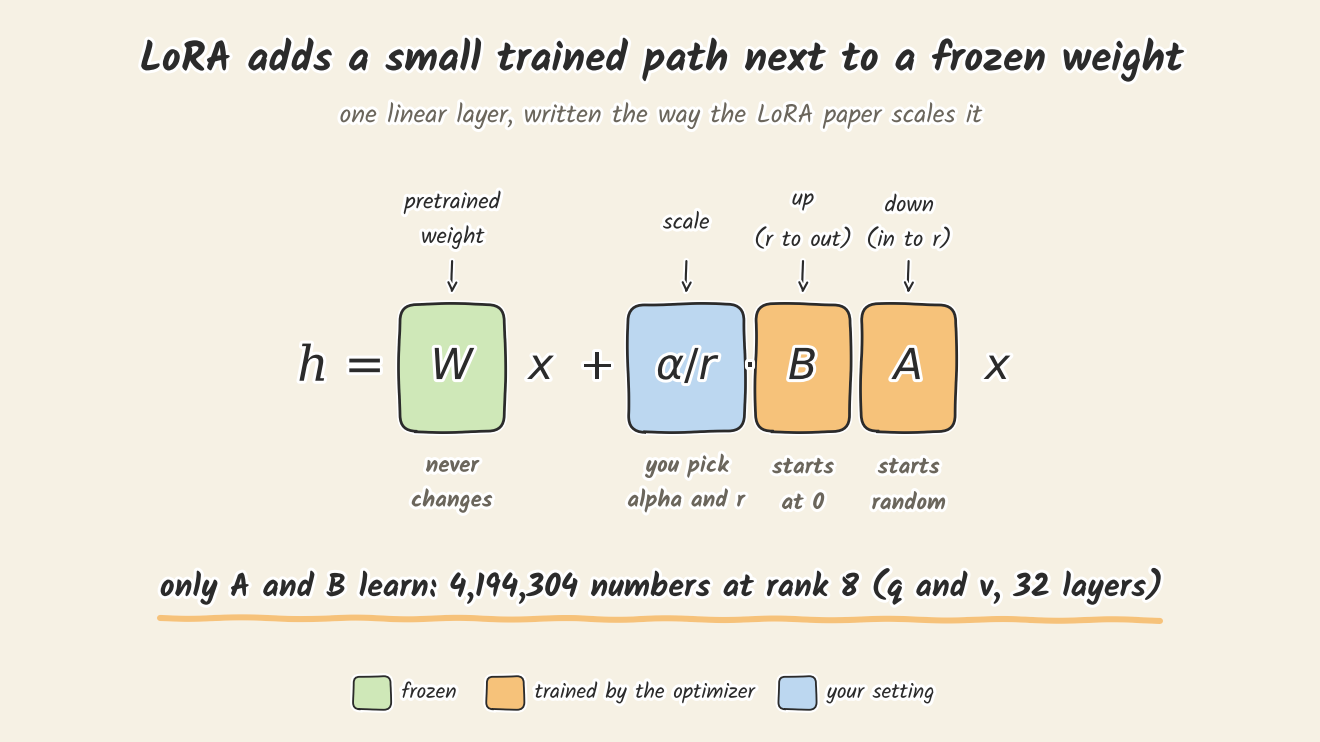
표를 보기 전에 표기 하나를 짚어 둡니다. Delta-LoRA 논문은 변화량을 ΔW = AB로 쓰고, A를 c × r, B를 r × d로 두고 B를 0에서 시작합니다. LoRA 논문은 B가 rank에서 출력으로 올라가는 쪽이고 그쪽이 0에서 시작하므로, 이름이 서로 반대입니다. 이 연재에서는 어디서나 LoRA 논문의 이름을 씁니다. "B"는 항상 rank r에서 출력 차원으로 올라가는 행렬입니다.
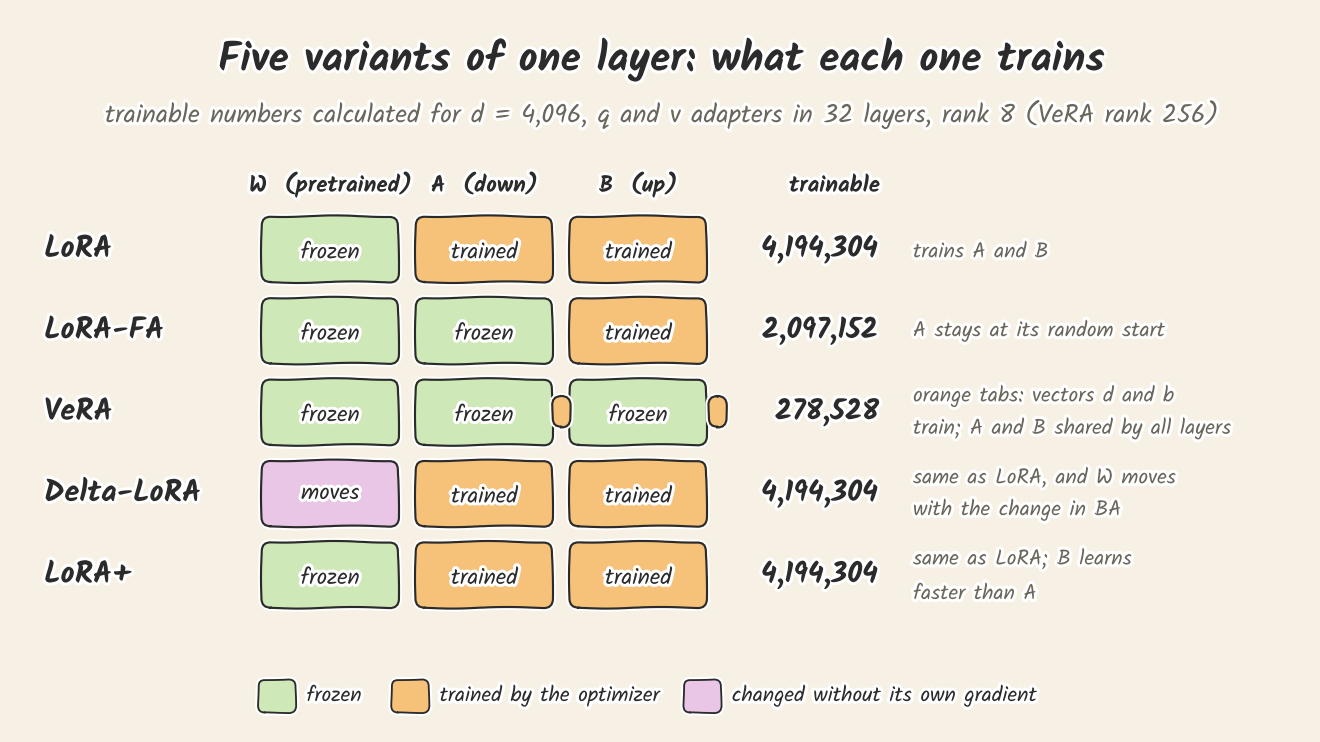
마지막 열의 수는 각 논문의 공식으로 계산한 값이고, 모양은 Llama-2-7B를 따랐습니다. d = 4096, 32층의 query와 value 투영에 어댑터를 달면 어댑터가 붙는 행렬은 64개입니다. rank 8의 LoRA는 2 × 64 × 4096 × 8 = 4,194,304개를 학습합니다. LoRA-FA는 B만 학습하므로 절반인 2,097,152개입니다. VeRA 논문의 식은 L_tuned × (d_model + r)이고, rank 256이면 64 × (4096 + 256) = 278,528입니다. 모두 계산한 값이지 돌아가는 모델에서 센 값이 아닙니다. 실제 학습 파라미터 수는 변형을 코드로 만드는 글에서 세겠습니다.
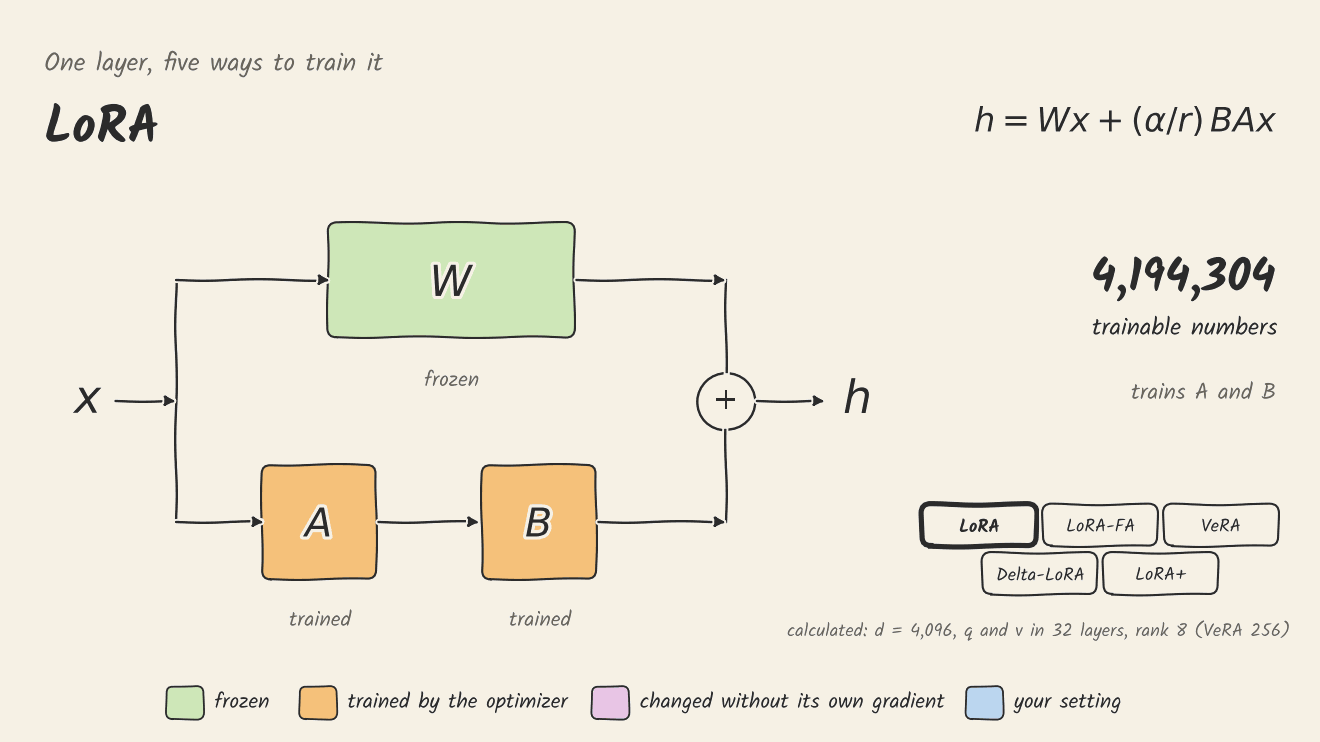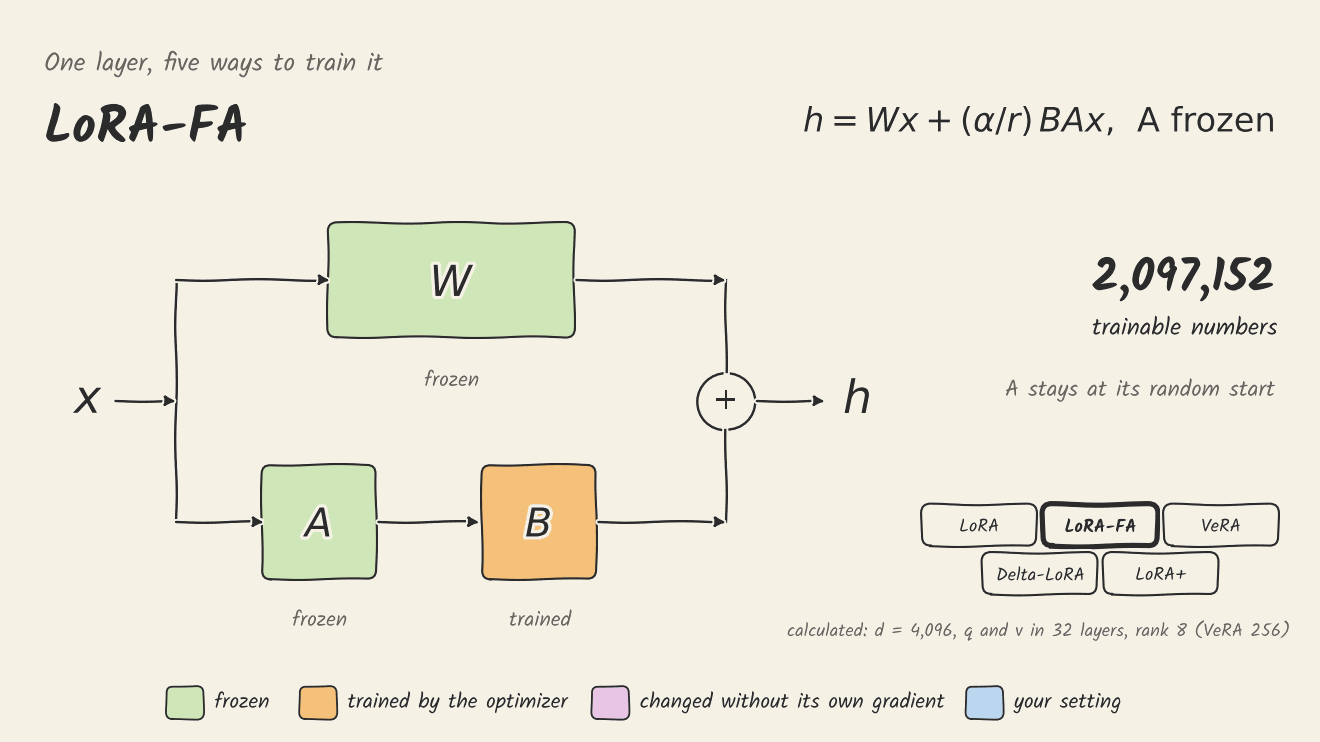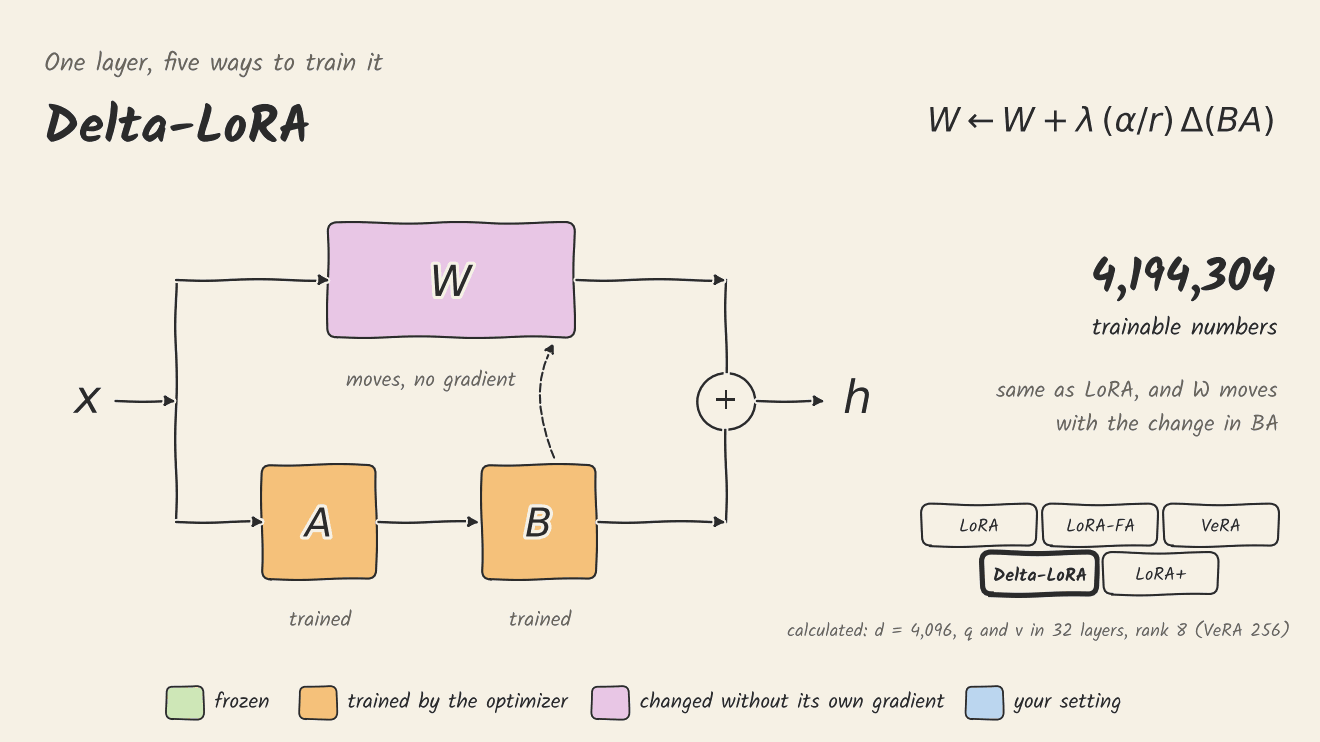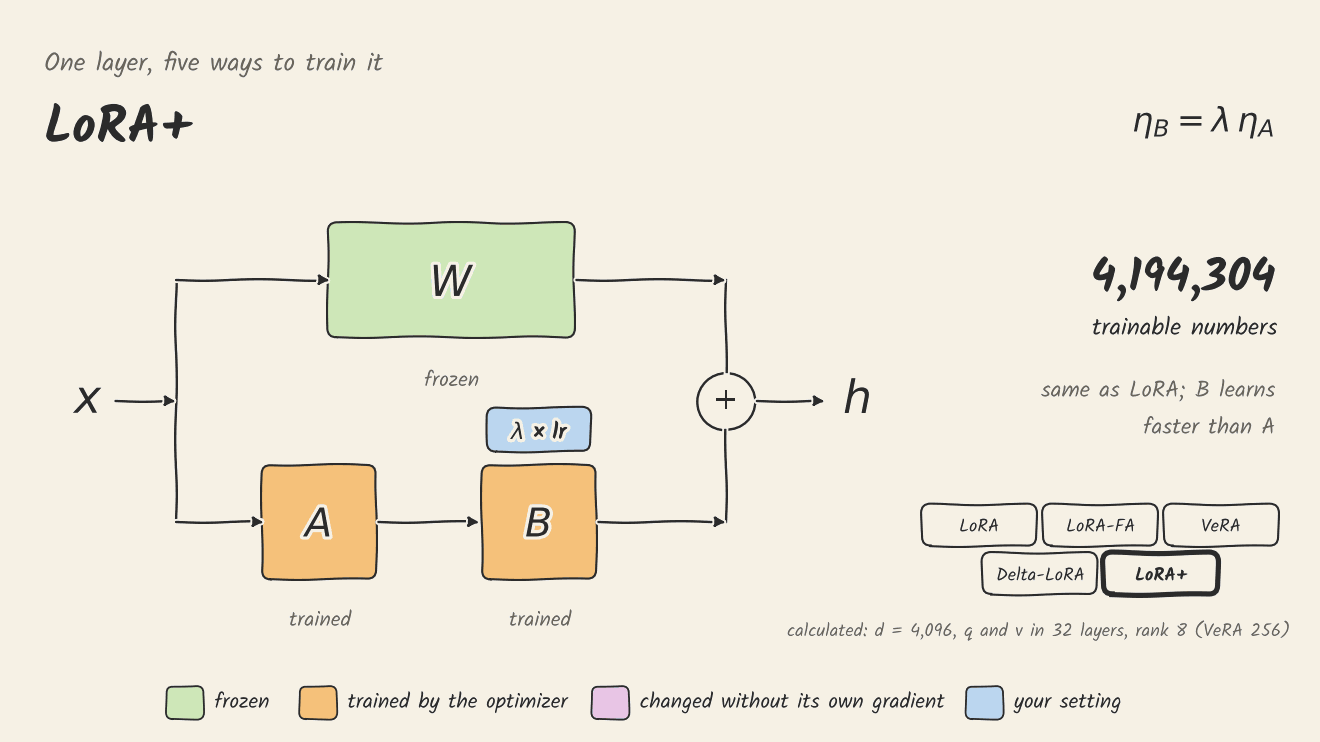
같은 층을 변형마다 한 번씩 그린 것이 아래 GIF입니다. 어느 블록의 색이 바뀌는지 보세요.
LoRA-FA: A를 얼려 활성화 메모리를 아끼는 방법
LoRA-FA(Zhang 외, arXiv:2308.03303)는 A를 무작위 초기값 그대로 얼리고 B만 학습합니다. 학습 파라미터는 절반이 되지만, 저자들이 앞세우는 이득은 그게 아닙니다. 초록은 LoRA-FA가 활성화 메모리 사용을 크게 줄인다고 말합니다.
이유는 논문 5절에 나옵니다. A를 학습하려면 A의 기울기를 구하기 위해 층의 입력 x를 저장해야 하고, 이것은 토큰마다 d개입니다. A를 얼리면 B의 기울기에는 A x만 있으면 되고, 이것은 토큰마다 r개입니다. 부록 C.3은 이를 Llama-2-7B에 적용해 층마다 18 · b · s · d 바이트를 덜 저장한다고 계산합니다. b는 배치 크기, s는 시퀀스 길이, d는 은닉 차원입니다.
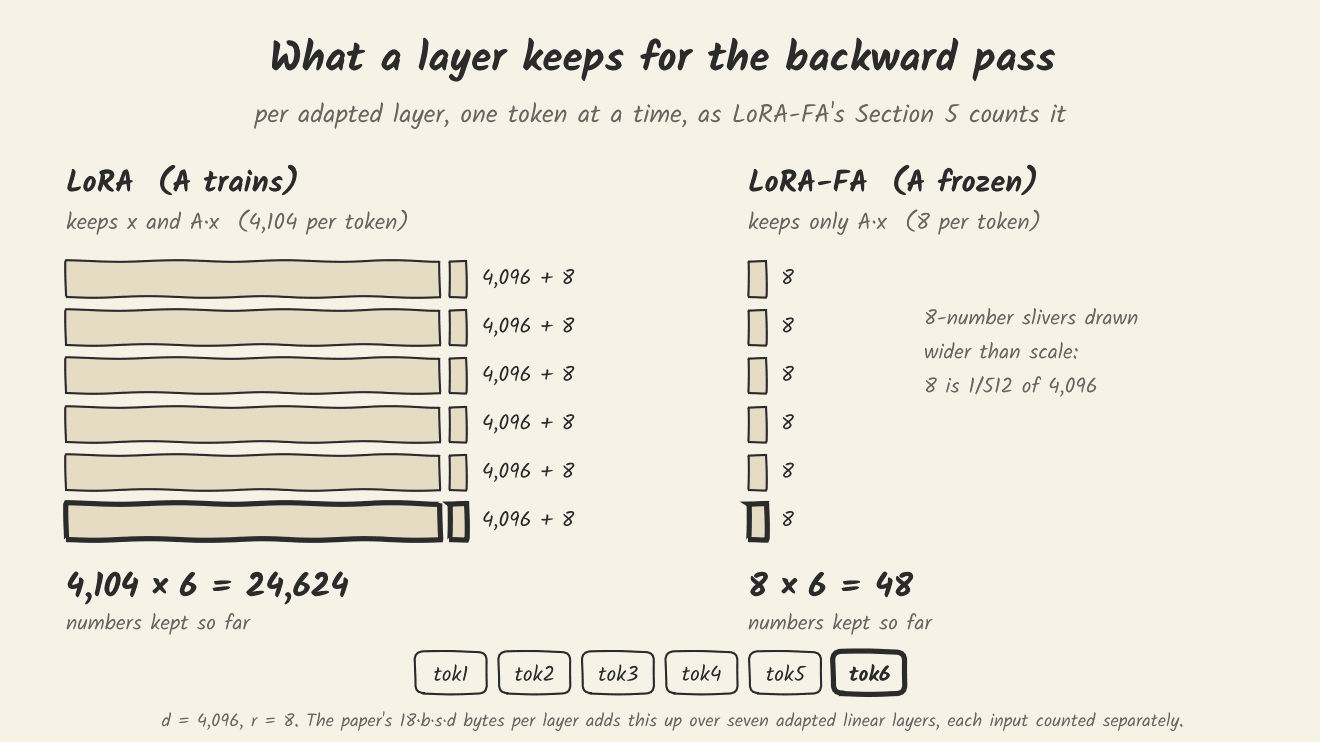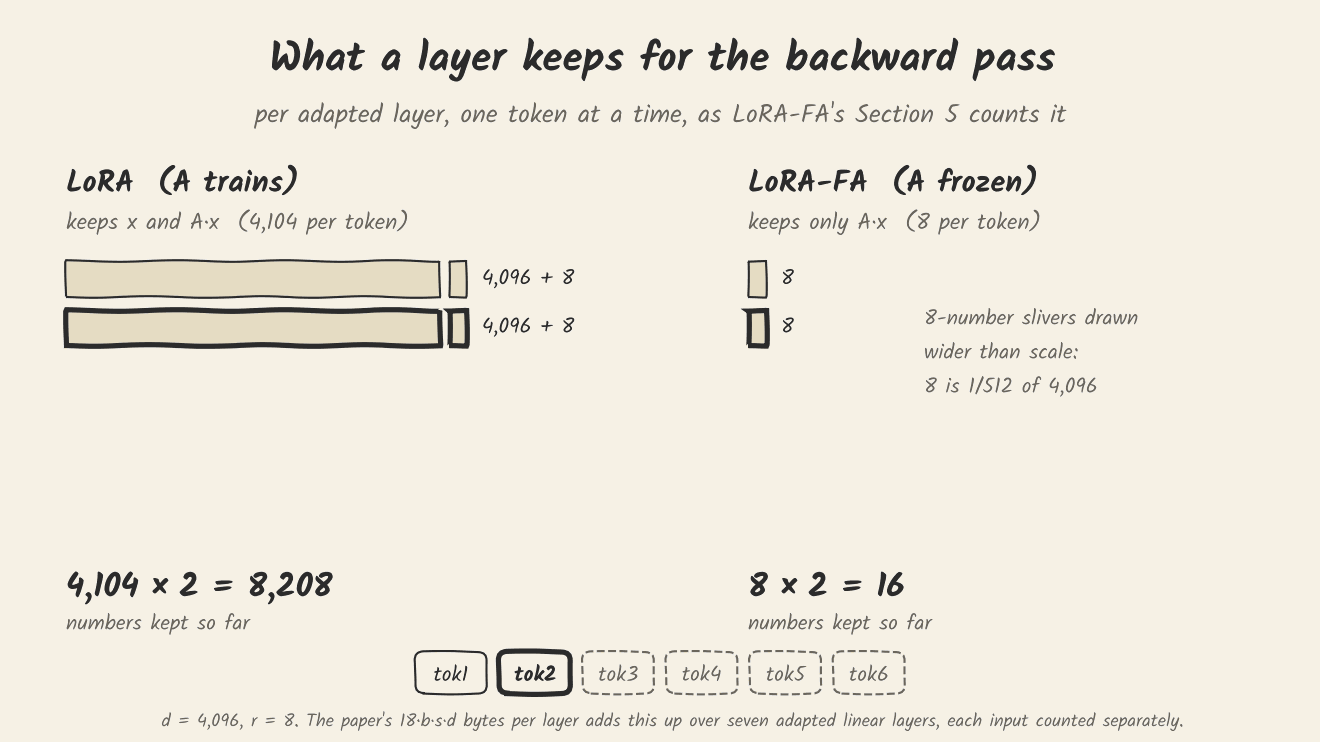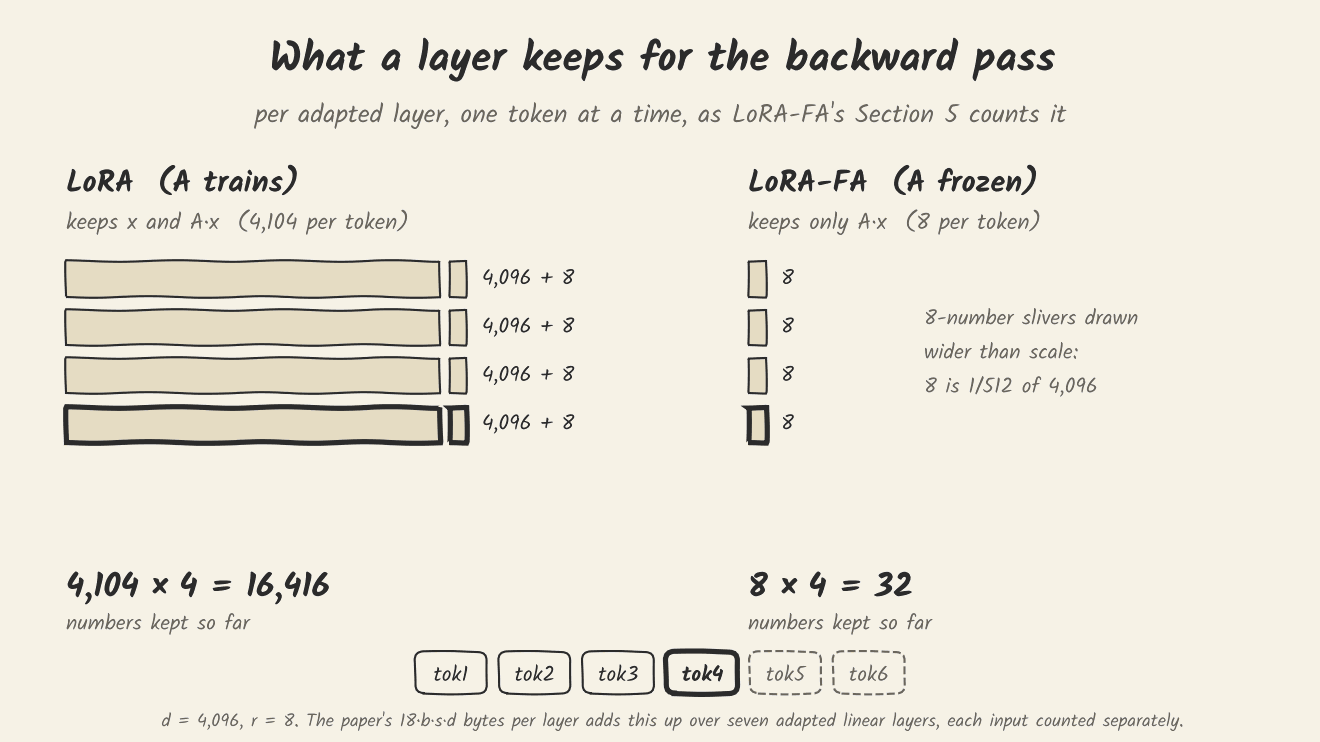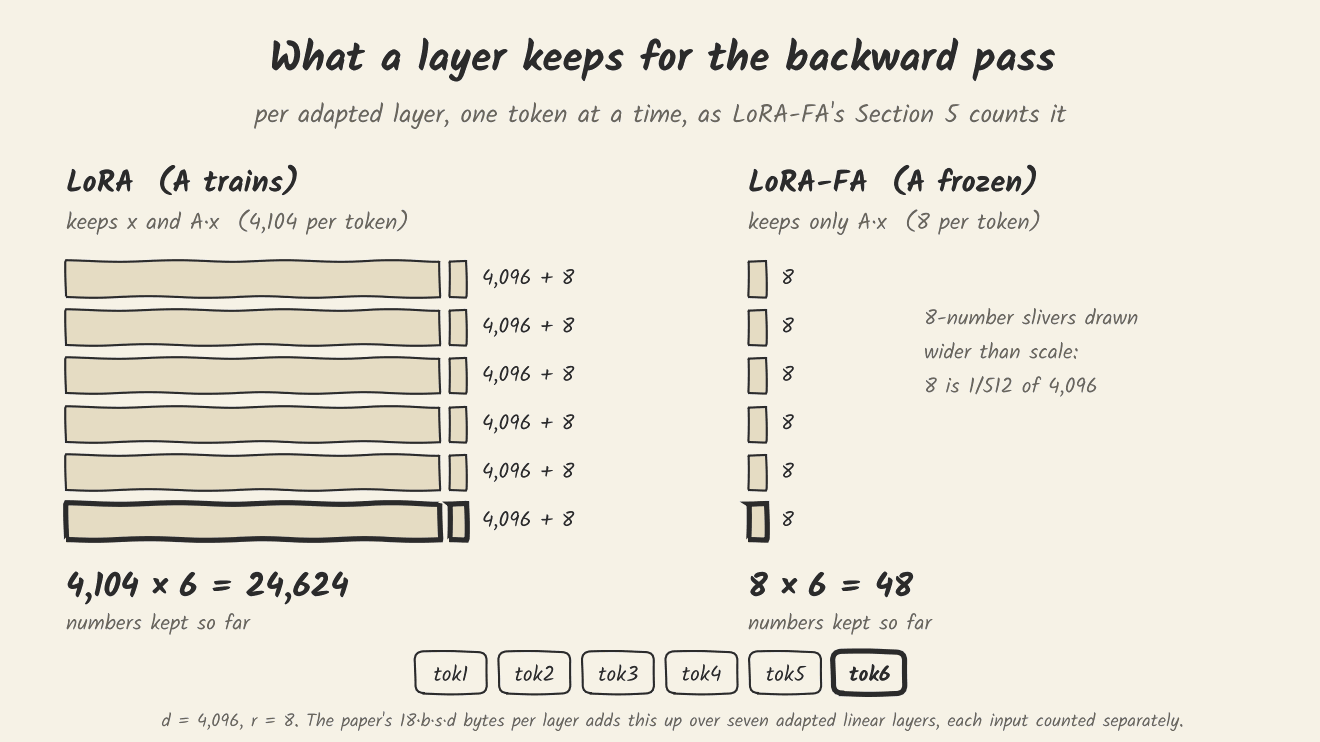
이 18은 블록마다 선형 층 일곱 개 모두에 어댑터를 단다고 놓은 값입니다. attention의 query, key, value, output과 MLP의 투영 세 개입니다. 이들 입력을 합하면 토큰마다 9d개이고, 한 개에 2바이트입니다. 이 계산은 단순화한 것입니다. 논문은 층마다 입력을 따로 세지만 query, key, value는 같은 x를 입력으로 받고, LoRA dropout이 0이면 PyTorch는 그 텐서를 한 번만 저장할 수 있습니다. 논문이 놓은 MLP 폭(3d)도 Llama-2-7B의 실제 크기 11,008과 다릅니다. 그래서 실측한 절감은 이보다 작게 나올 수 있습니다. 또 위 표에서 q와 v에만 어댑터를 달고 센 것과는 전제가 다릅니다. 배치 8, 시퀀스 1,024, d = 4096, 32층을 18 · b · s · d · L에 넣으면 19,327,352,832바이트입니다. 십진 단위로는 19.3 GB, 이진 단위로는 18.0 GiB이고, 논문의 "최소 18GB"는 이진 단위 쪽과 맞습니다(논문의 입력으로 저희가 다시 계산한 값입니다).
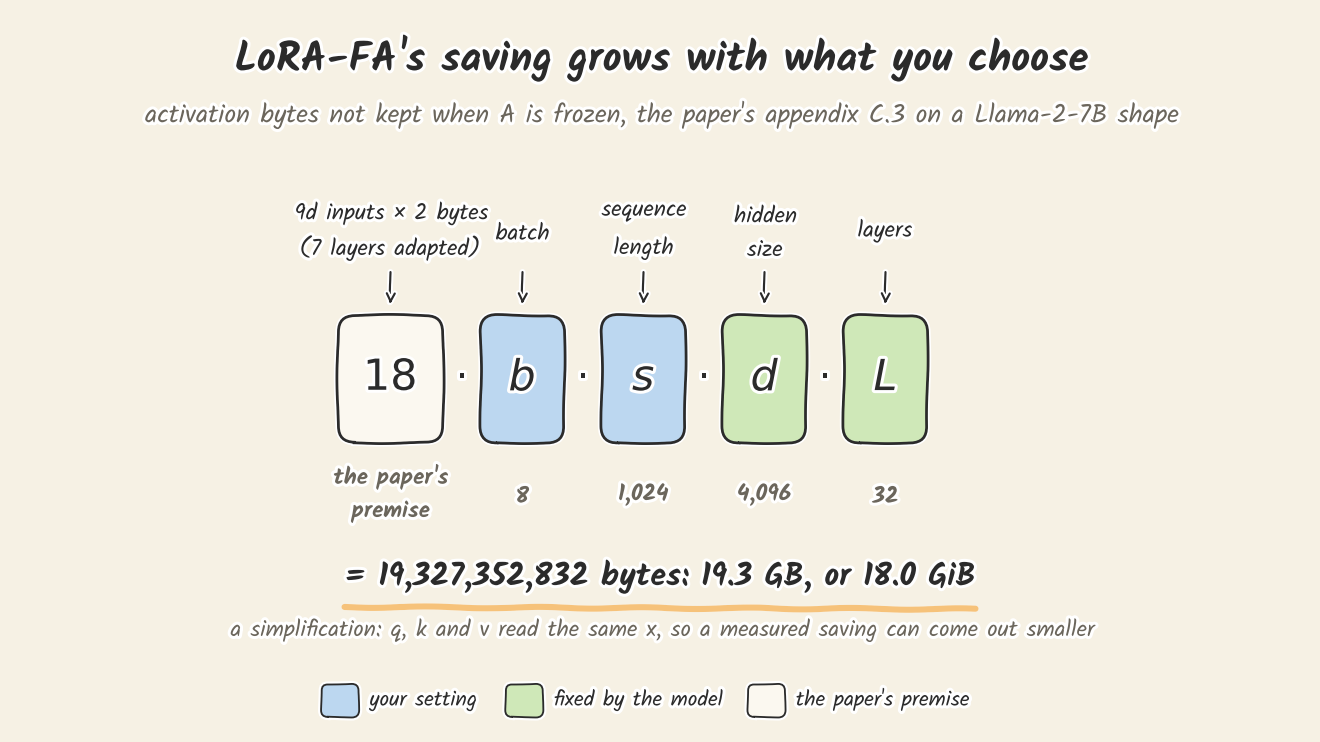
그러니 초록에 없는 조건은, 이 절감이 배치 크기, 시퀀스 길이, 어댑터를 단 층 수에 비례한다는 점입니다. 시퀀스가 짧거나 q와 v에만 어댑터를 달면 절감은 훨씬 작습니다. 한 장짜리 카드에서 긴 시퀀스와 씨름하고 있다면 이 변형이 겨냥한 상황입니다.
방법 안에도 설정이 하나 있습니다. 논문 최신 판은 A를 얼리는 데서 끝나지 않고, 초록에 B의 기울기를 닫힌 식으로 보정하는 단계를 더했습니다. 첫 판 초록에는 이 내용이 없었습니다. PEFT 0.21.2의 LoRA-FA 옵티마이저는 이 보정을 적용해서, Adam 스텝 전에 B의 기울기에 (r/α)²과 A Aᵀ의 의사역행렬(대각에 작은 값을 더한 것)을 곱합니다(소스 코드에서 확인했습니다). 그래서 단순히 A만 얼린 학습과 PEFT의 LoRA-FA는 같은 학습이 아닙니다. 논문의 품질 결과는 아직 확인하지 않았습니다.
VeRA: 공유한 A, B에 벡터 두 개만 학습하는 방법
VeRA(Kopiczko 외, arXiv:2310.11454)는 파라미터 수에서 반대로 갑니다. A와 B는 무작위이고 얼려 있으며 모든 층이 공유합니다. 학습하는 것은 층마다 벡터 두 개이고, 대각 행렬로 쓰면 h = W x + Λb · B · Λd · A x입니다. 벡터 d의 길이는 r로 rank 쪽을 조절하고, b의 길이는 d_out으로 출력 쪽을 조절합니다.
논문의 학습 파라미터 수는 VeRA가 L_tuned × (d_model + r), LoRA가 2 × L_tuned × d_model × r입니다. rank 1이면 VeRA가 약 절반이고, rank가 커질수록 차이가 크게 벌어집니다. 수에는 드러나지 않는 이득도 하나 있습니다. 공유하는 무작위 행렬은 시드만 있으면 다시 만들 수 있어서, 모델마다 저장할 것은 벡터와 시드 하나입니다.
설정은 맨 앞에서 본 초기화입니다. 논문은 b를 0에서 시작해서 층이 처음에는 변하지 않게 하고, d는 모든 원소를 0이 아닌 같은 값에서 시작하며 이 값을 새 하이퍼파라미터라고 부릅니다. 그림에서는 그 값을 1로 예시했지만 GLUE 실험에서는 0.1을 썼고, MRPC와 RTE ablation에서 1.0은 0.1이나 10^-7보다 훨씬 낮은 점수를 냈습니다. 그 실험에서 무작위 A와 B는 Kaiming uniform 초기화를 썼습니다. rank의 의미도 다릅니다. rank가 키우는 것은 벡터 d 하나뿐이어서 논문은 RoBERTa에 rank 256과 1,024를 쓰고, 위의 계산도 256을 썼습니다.
Delta-LoRA: 기울기 없이 W까지 고치는 방법
Delta-LoRA(Zi 외, arXiv:2309.02411)는 A와 B를 평소처럼 옵티마이저로 학습하고, W도 바꿉니다. 옵티마이저 스텝마다 곱의 변화량에 스케일을 곱해 더합니다. W ← W + λ · (α/r) · (BA_new − BA_old)입니다. W는 자기 기울기도 옵티마이저 상태도 갖지 않아서, 초록은 메모리가 LoRA와 비슷하다고 말합니다.
여기에는 설정이 세 개 따라오고, 초록은 그중 어느 것도 말하지 않습니다. 첫째, W 갱신은 스텝 K 이후에만 시작합니다. 둘째, λ가 갱신 크기를 조절합니다. 논문은 E2E 데이터-투-텍스트 실험에서 λ = 2, K = 500, 요약 과제에서 λ = 0.5, K = 1000을 쓰고, GLUE에서는 λ = 0.5에 K를 과제별 워밍업에 맞춥니다. 셋째, 논문은 low-rank 쪽의 dropout을 없앱니다. dropout이 있으면 W의 기울기와 AB의 기울기가 같지 않게 되는데, 이 방법은 둘이 같다는 데 기대기 때문입니다.
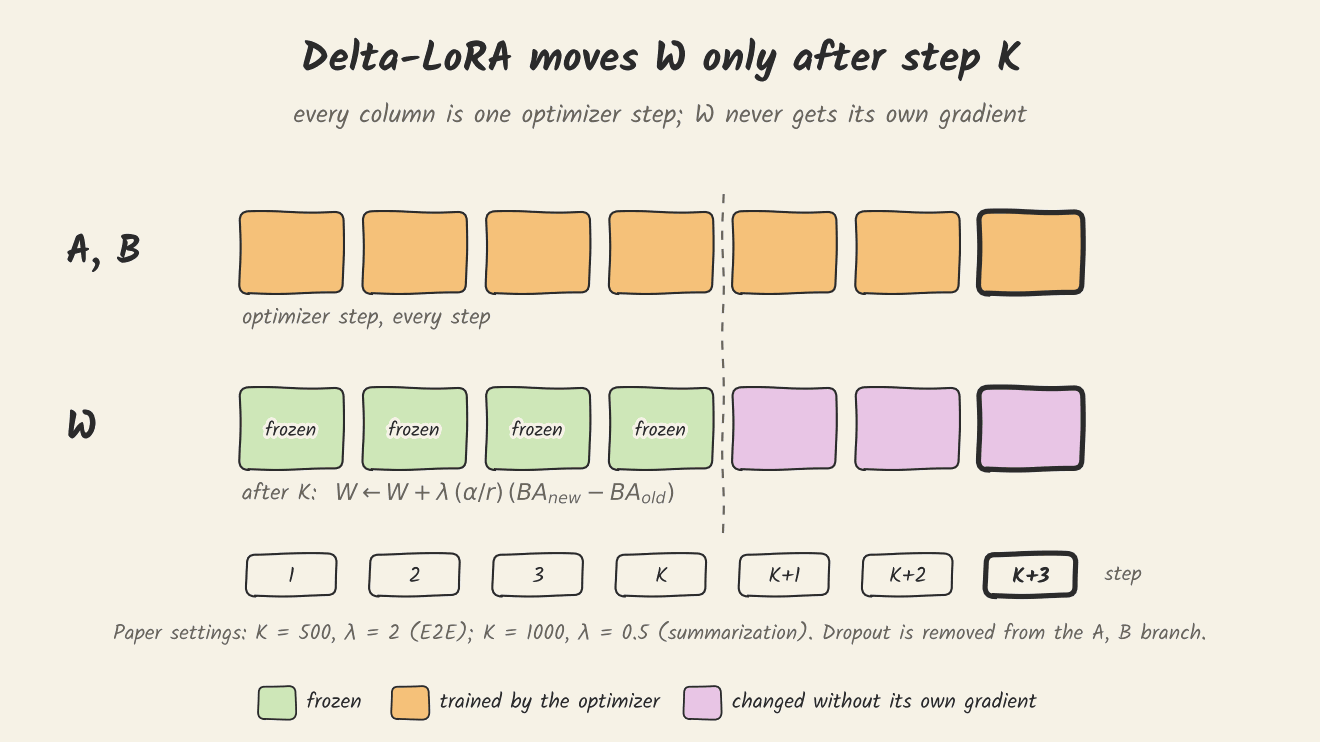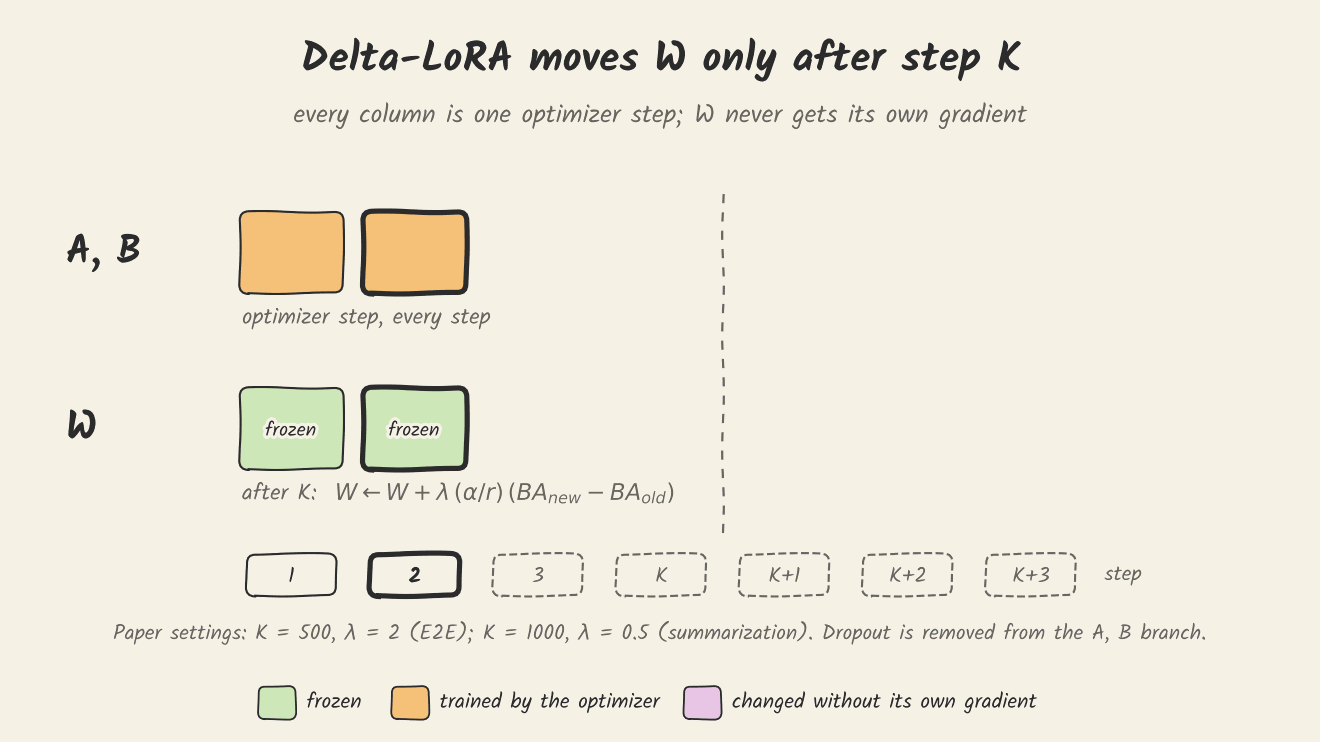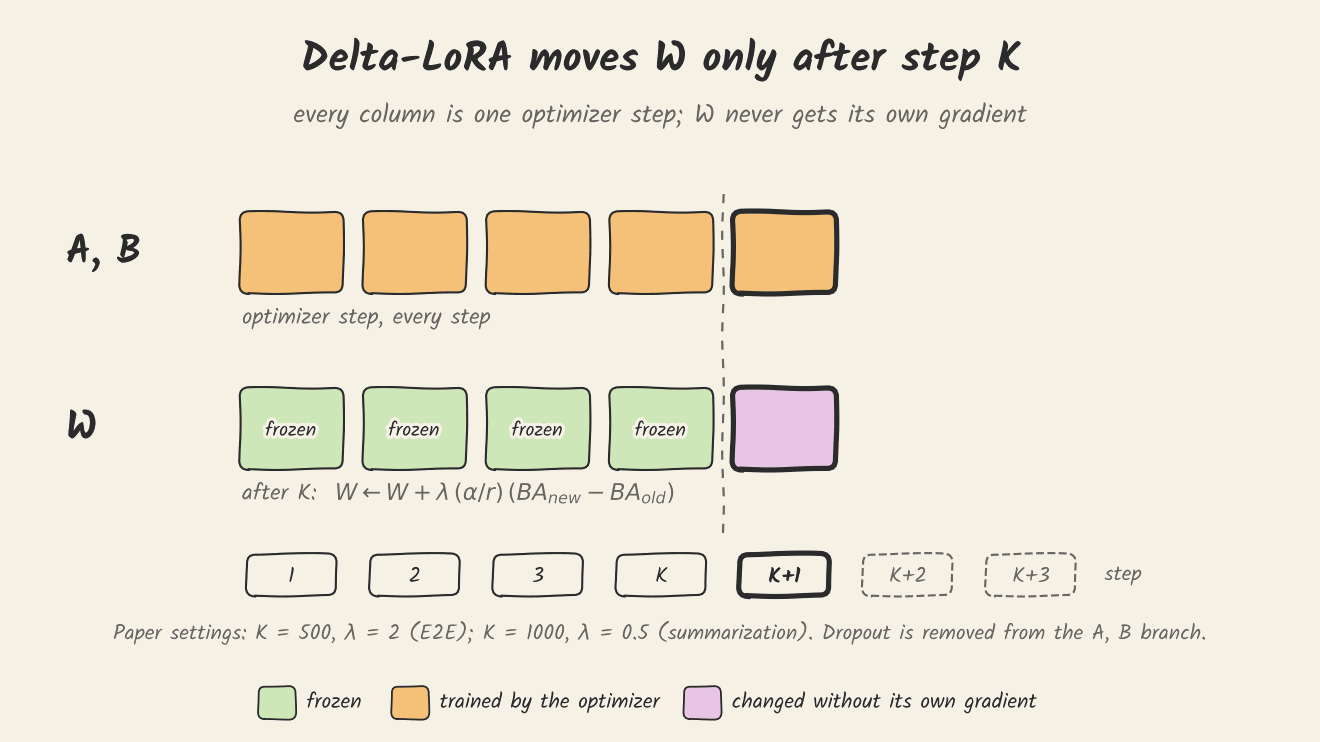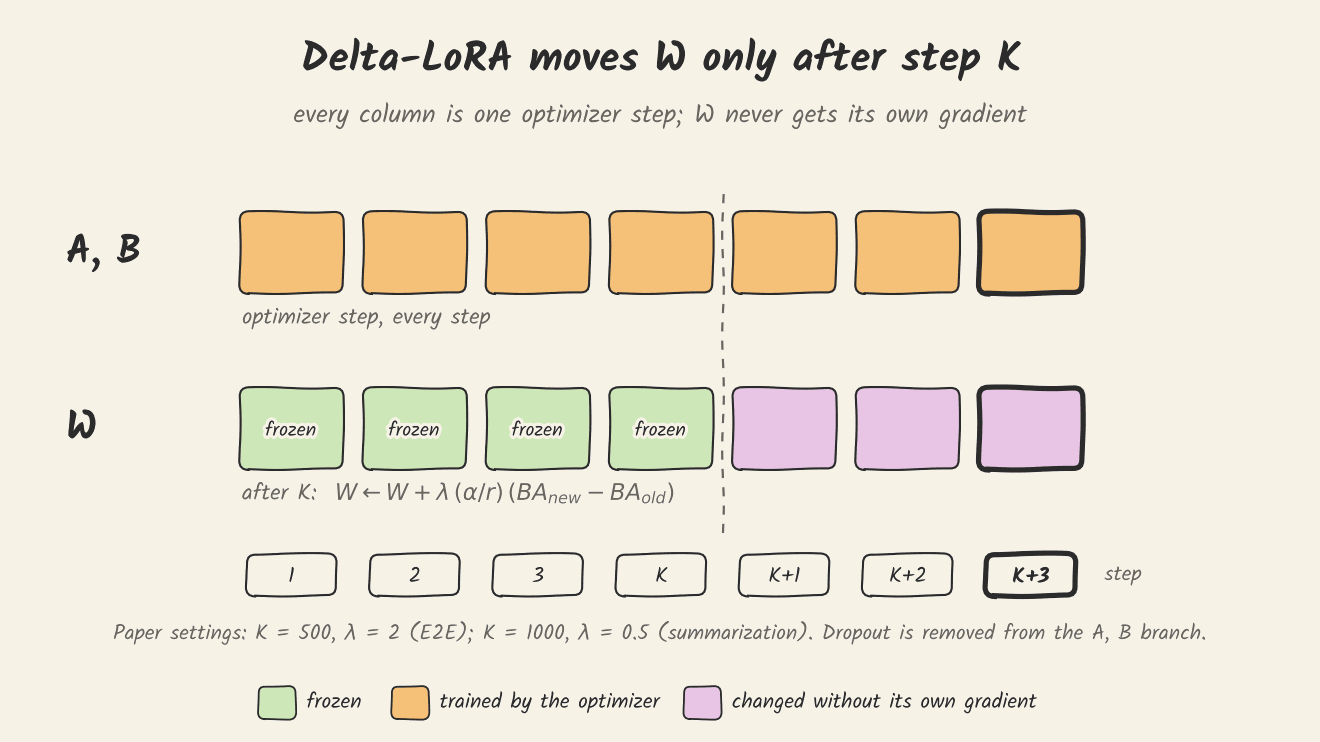
여기서 나오는 결론 두 가지는 논문의 문장이 아니라 저희의 해석입니다. 하나는, 학습 중에 W가 바뀌므로 A와 B 파일만으로는 결과를 재현할 수 없고 W도 함께 저장해야 한다는 점입니다. 다른 하나는, K 이후 매 스텝 W를 다시 쓰므로 기반 모델을 4비트로 얼려 두는 QLoRA 방식에는 그대로 얹을 수 없다는 점입니다. 논문은 두 가지 모두 다루지 않습니다. 첫째는 변형을 직접 만드는 글에서 확인하겠습니다.
LoRA+: 파라미터는 그대로, 학습률만 다르게 주는 방법
LoRA+(Hayou 외, arXiv:2402.12354)는 모델을 바꾸지 않습니다. B의 학습률을 A의 λ배로 주는데, λ는 1보다 훨씬 큰 값으로 고정합니다. 저자들의 설명은 이렇습니다. 폭(은닉 차원)이 넓은 층에서 A와 B에 같은 학습률을 주면 어댑터가 특징을 효율적으로 배우지 못한다는 것입니다. 초록은 성능이 1-2% 좋아지고 파인튜닝이 최대 약 2배 빨라지며, 계산 비용은 LoRA와 같다고 보고합니다.
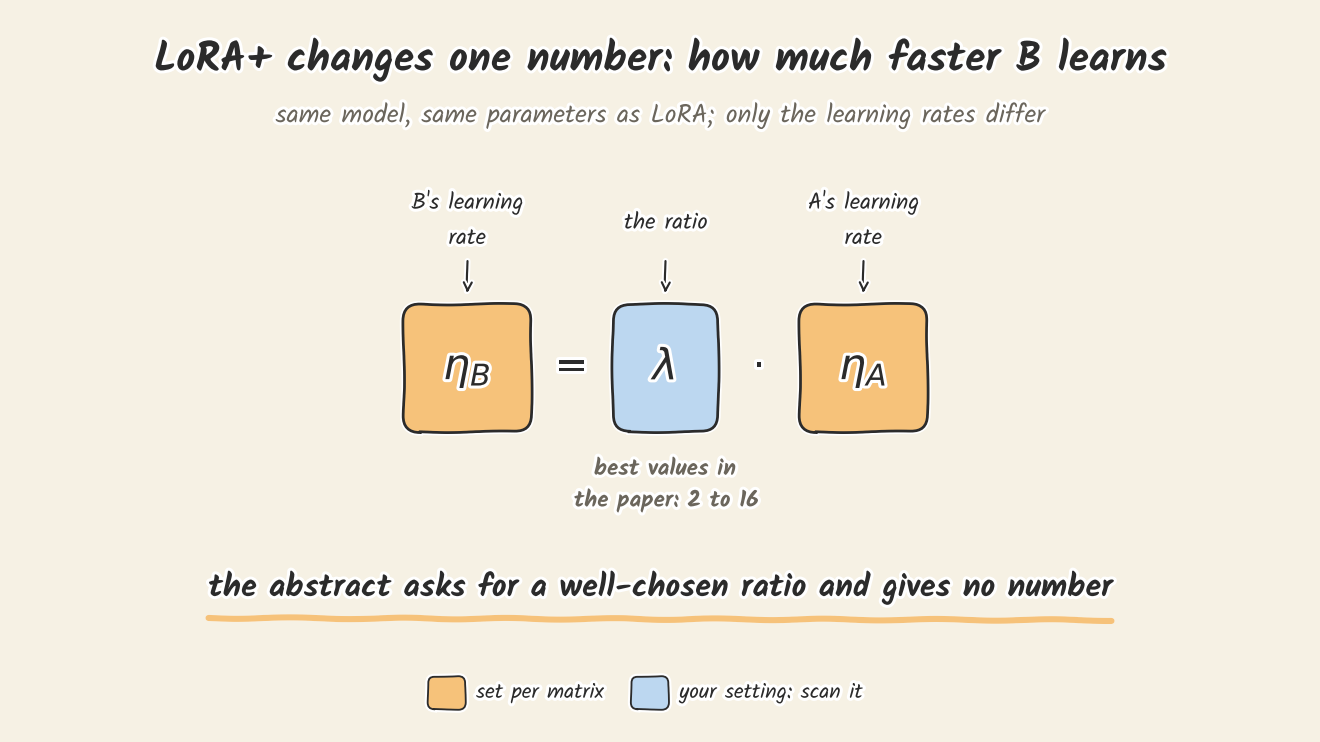
초록은 비율을 잘 골라야 한다고만 하고 그 값은 말하지 않습니다. 본문을 보면 값이 달라집니다. RoBERTa에서는 초기화 하나일 때 약 2^4(16)가, 다른 초기화일 때 2^2에서 2^3이 가장 좋았고, Llama 실험은 2^1에서 2^2였습니다. 그래서 "B의 학습률을 높게 주라"는 하나의 처방이 아닙니다. 직접 훑어봐야 하는 하이퍼파라미터이고, 비교 실측 글에서 저희도 훑어봅니다.
무엇부터 써 볼까
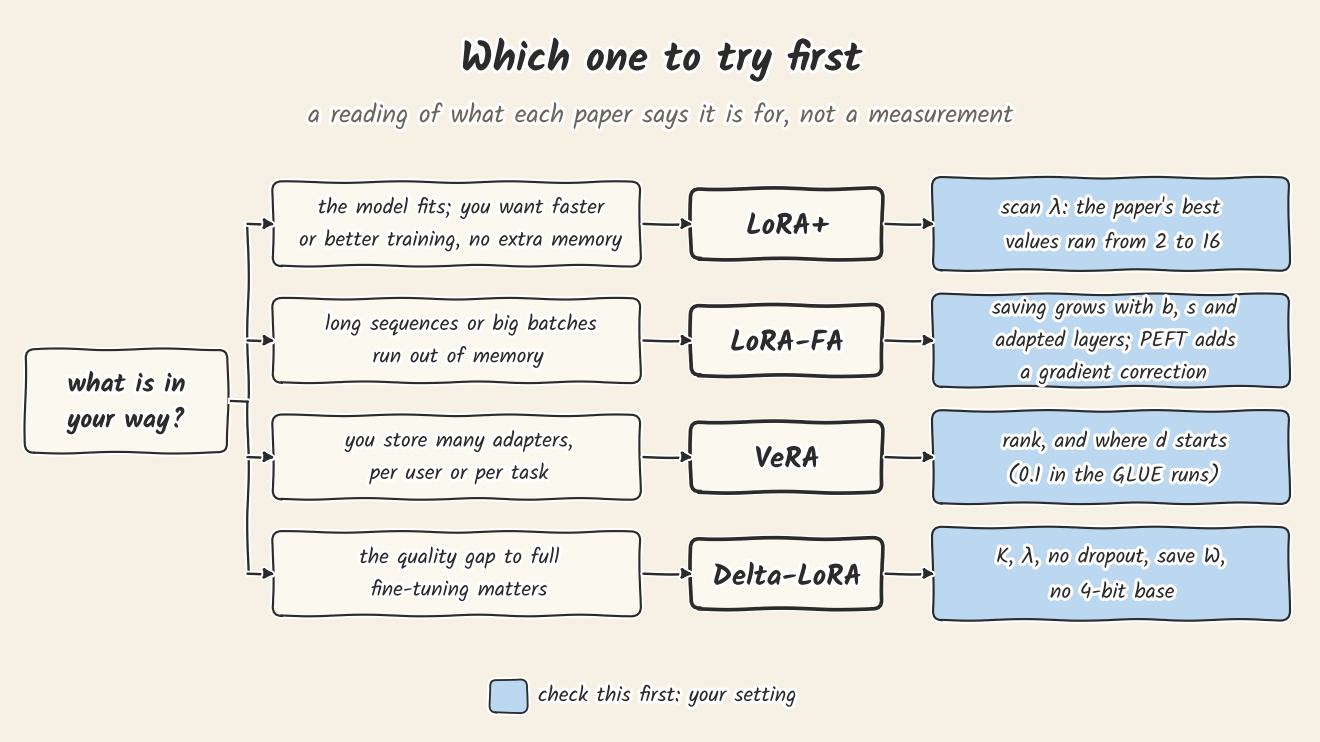
아래 표는 각 논문이 무엇을 위한 방법이라고 말하는지를 읽은 것이고, 측정이 아닙니다.
| 상황 | 논문이 겨냥한 변형 | 먼저 확인할 것 |
|---|---|---|
| 모델은 들어가는데, 메모리를 더 쓰지 않고 더 빠르거나 낫게 하고 싶을 때 | LoRA+ | λ 훑어보기. 논문의 최적값은 2에서 16까지 퍼졌습니다 |
| 긴 시퀀스나 큰 배치에서 메모리가 모자랄 때 | LoRA-FA | 절감은 배치, 시퀀스 길이, 어댑터 단 층 수에 비례. PEFT는 기울기 보정을 더함 |
| 사용자별, 과제별로 어댑터를 많이 저장할 때 | VeRA | rank와 d의 시작값(논문 GLUE 실험은 0.1) |
| LoRA와 전체 파인튜닝의 품질 차이가 신경 쓰일 때 | Delta-LoRA | K, λ, dropout 제거, W 저장, 4비트 기반 모델 불가 |
확인하지 않은 것
- 품질과 속도 주장은 저자들의 것입니다. 저희는 아직 이 중 어떤 것도 학습하지 않았습니다. 숫자가 논문에서 온 곳에는 어느 논문인지 적었습니다.
- 파라미터 수는 계산한 값입니다. 한 가지 모델 모양에 공식을 넣은 것이고, 돌아가는 모델에서 읽은 값이 아닙니다.
- LoRA-FA의 활성화 절감은 선형 층 일곱 개 모두에 어댑터를 단 Llama-2-7B에 대한 논문의 계산이고, 저희는 산수만 다시 확인했습니다. PyTorch와 PEFT에서 실제로 그만큼 줄어드는지는 이어지는 실측에서 보여 줘야 합니다.
- 읽은 논문의 판은 2026-10-21 기준 arXiv에 올라 있는 판입니다. LoRA-FA는 첫 판과 최신 판의 제목과 초록이 다르고, 기울기 보정은 최신 판 초록에만 있습니다.
다음 글
다음 글에서는 PyTorch 30줄 안팎으로 LoRA를 밑바닥부터 만들고, PEFT 라이브러리의 출력과 같은지 확인합니다. 그 뒤에 나머지 네 변형을 그 코드의 작은 변경으로 구현하고, 마지막으로 다섯 가지를 같은 조건에서 재면서 예측을 실행 전에 먼저 적어 둡니다. 아래 뉴스레터를 구독하면 새 글이 나올 때 알려 드립니다.