8GB, 12GB, 16GB, 24GB GPU에서 몇 B 모델까지 LoRA 학습이 될까: 직접 돌려 봤습니다
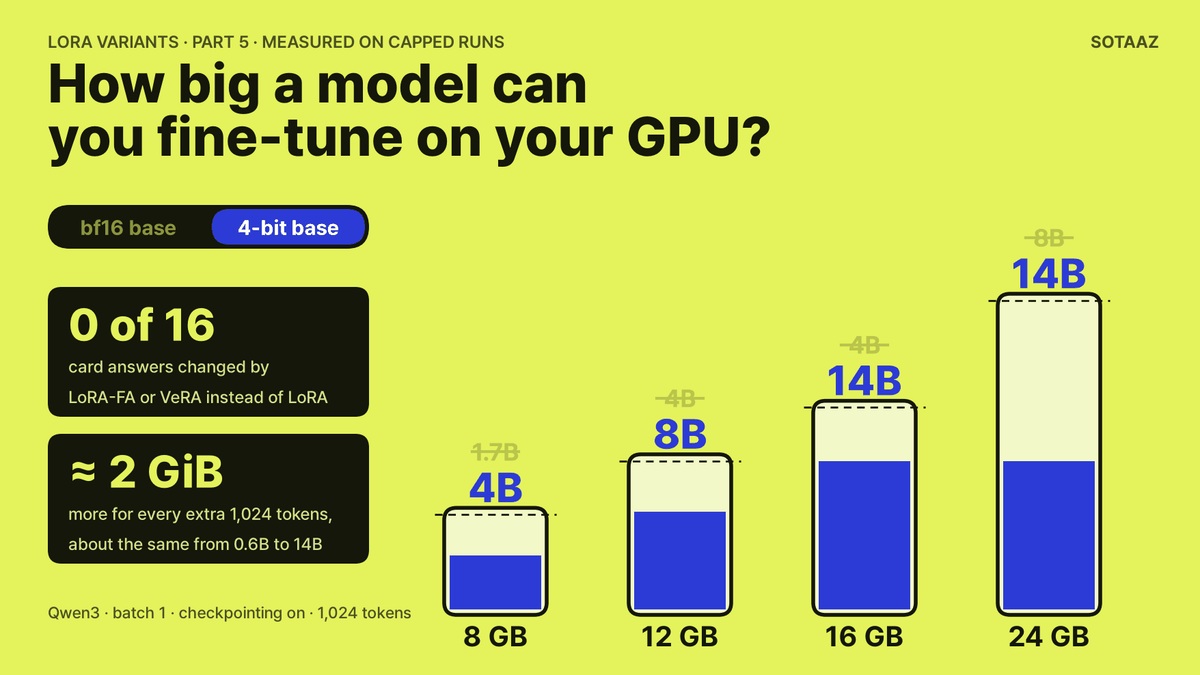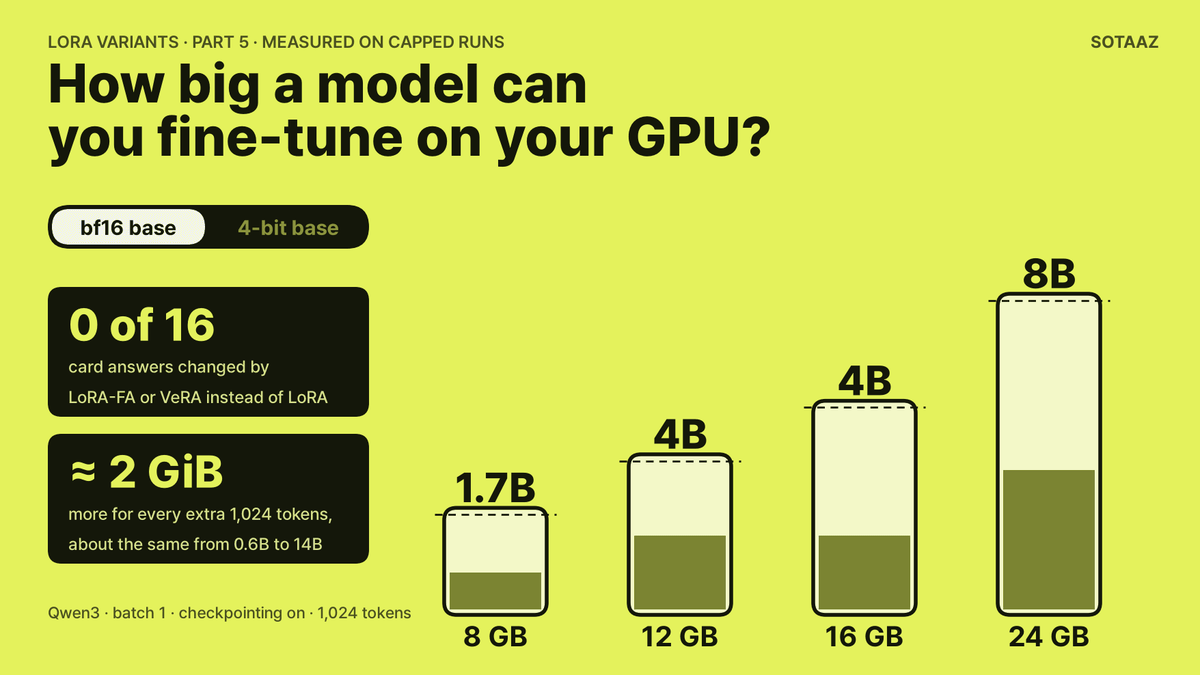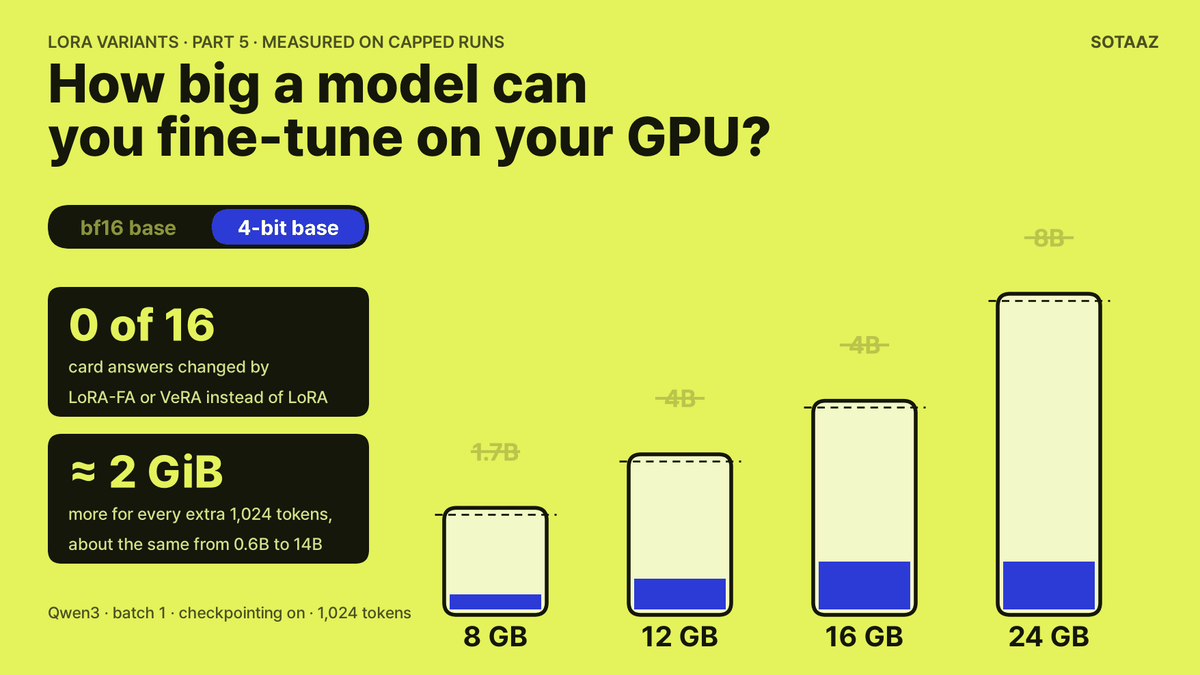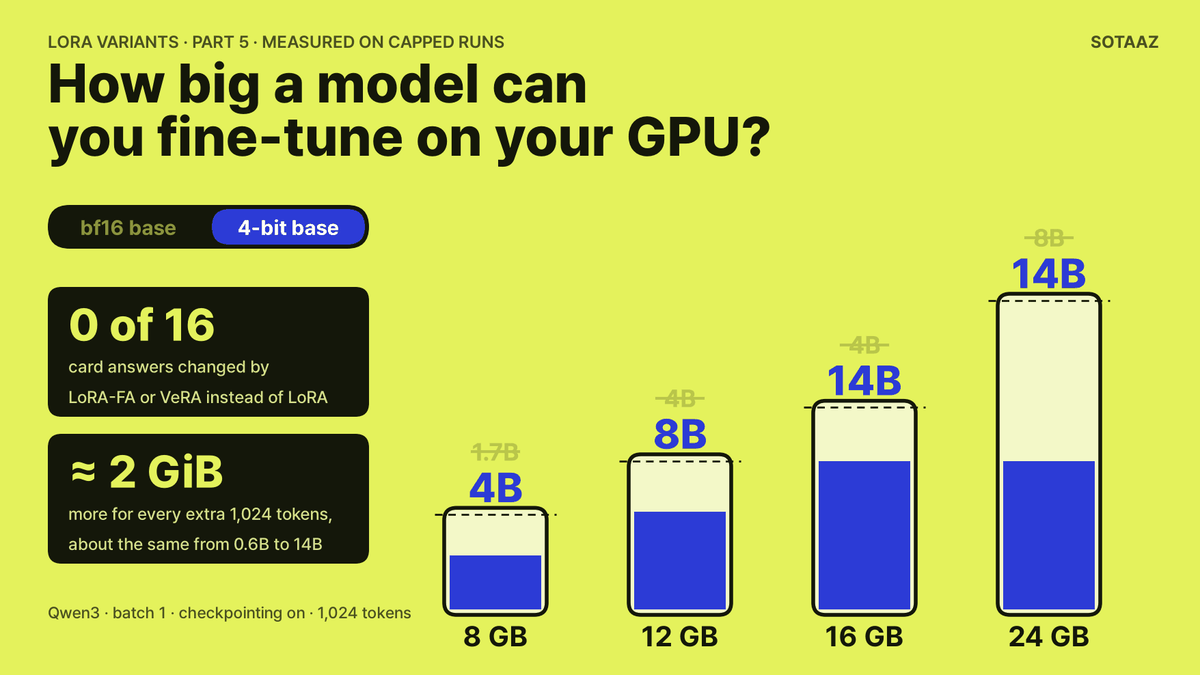
Qwen3 0.6B부터 14B까지 LoRA, LoRA-FA, VeRA로 직접 학습해 보고, 8GB, 12GB, 16GB, 24GB GPU에서 각각 몇 B 모델까지 되는지 정리했습니다. 모델을 bf16으로 올려 1,024토큰으로 학습하면 8GB에서 1.7B, 24GB에서 8B까지 되고, 4비트로 올리면 4B와 14B까지 됩니다. LoRA 변형을 바꿔서 답이 달라진 경우는 없었습니다.
8GB, 12GB, 16GB, 24GB GPU에서 몇 B 모델까지 LoRA 학습이 될까: 직접 돌려 봤습니다
4편에서 LoRA-FA는 LoRA보다 메모리를 1.5% 덜 썼고, VeRA는 1% 더 썼습니다. 그렇다면 GPU 메모리가 빠듯할 때 LoRA-FA를 고르면 한 단계 큰 모델을 학습할 수 있지 않을까요?
그래서 8GB, 12GB, 16GB, 24GB GPU 네 가지 환경에서 Qwen3 모델을 크기별로 학습해 보고, GPU 메모리 크기마다 학습이 끝까지 되는 가장 큰 모델을 찾았습니다. 결과부터 말하면, LoRA 변형을 바꿔도 GPU마다 학습할 수 있는 모델 크기는 한 번도 달라지지 않았습니다. 같은 조건에서 세 변형의 메모리 차이는 가장 큰 경우가 0.043GiB였습니다.
LoRA보다는 모델의 precision(정밀도, 가중치를 몇 비트로 GPU에 올리느냐)이 중요했습니다. 모델을 4비트로 줄여서 올리면 모든 GPU에서 한두 단계 큰 모델까지 학습됐습니다.
GPU별 결과
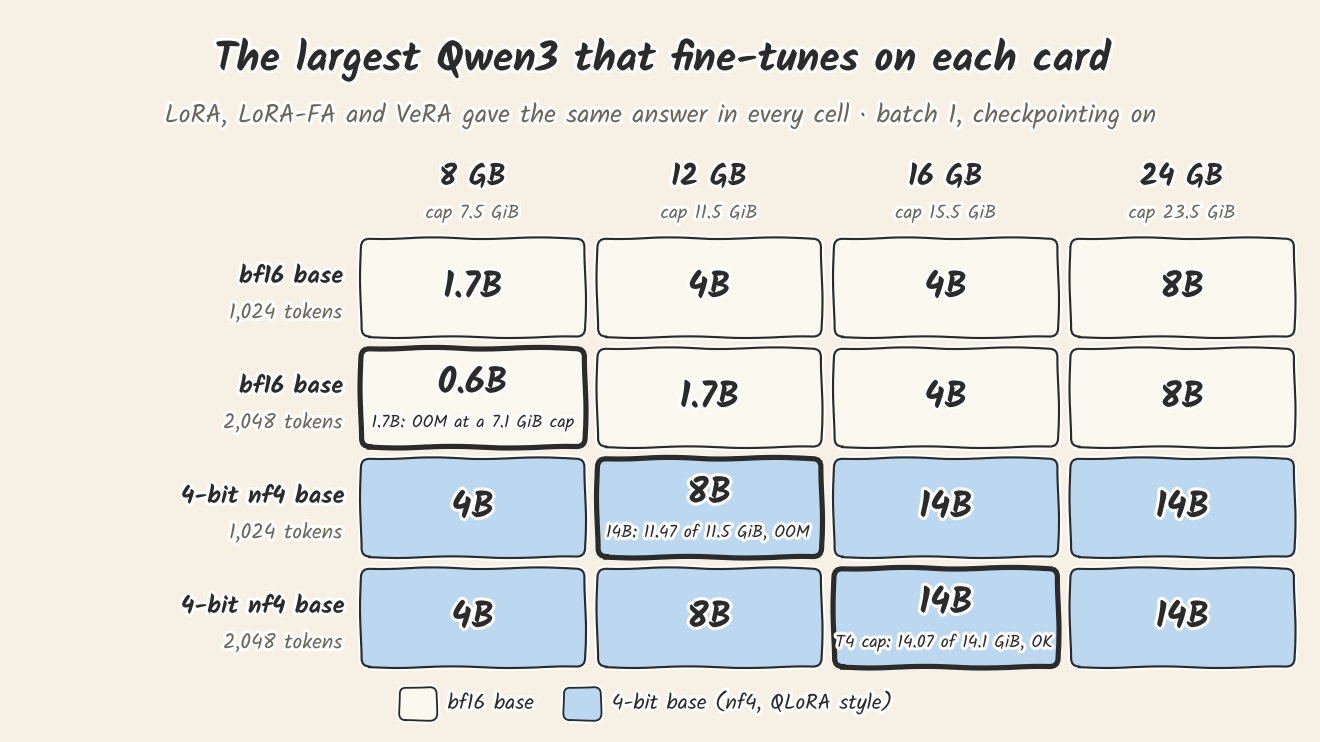
아래 표는 GPU 메모리(가로)와 학습 설정(세로)이 만나는 곳마다, 학습이 끝까지 된 가장 큰 Qwen3 모델을 적은 것입니다. 예를 들어 8GB GPU에서 모델을 bf16으로 올리고 1,024토큰짜리 문장으로 학습하면 1.7B까지 됩니다. 학습은 3스텝씩 돌렸고, 메모리가 모자라 도중에 멈추지 않으면 된다고 봤습니다.
| 모델 정밀도, 문장 길이 | 8GB | 12GB | 16GB | 24GB |
|---|---|---|---|---|
| bf16, 1,024토큰 | 1.7B | 4B | 4B | 8B |
| bf16, 2,048토큰 | 0.6B (1.7B는 GPU에 따라 다름) | 1.7B | 4B | 8B |
| 4비트(nf4), 1,024토큰 | 4B | 8B | 14B | 14B |
| 4비트(nf4), 2,048토큰 | 4B | 8B | 14B | 14B |
bf16은 모델을 원래 정밀도 그대로 올린 것이고, 4비트(nf4)는 QLoRA처럼 모델을 4비트로 줄여서 올린 것입니다. 어느 쪽이든 원래 모델은 얼려 두고, 옆에 붙인 작은 어댑터만 학습합니다.
저희가 실험한 모델 중 가장 큰 모델은 14B 파라미터 모델이었습니다. 그래서 표의 4비트 행은 16GB와 24GB가 둘 다 14B입니다. 24GB에서는 4비트 14B를 2,048토큰으로 학습하고도 메모리가 8.8GiB 남았습니다. 더 큰 모델도 들어갈 것 같지만 돌려 보지는 않았습니다. 반대로 표 bf16 행에 14B가 없는 것은 모델 가중치만 27.5GiB여서 24GB GPU에도 올라가지 않기 때문입니다.
메모리 한도를 걸고 돌린 실행은 대부분 LoRA로만 했습니다. LoRA-FA와 VeRA까지 한도를 걸고 돌린 것은 한도에 가장 가까웠던 세 경우입니다. 12GB와 16GB의 4비트 14B, 그리고 8GB의 bf16 1.7B(2,048토큰)입니다. 나머지 경우에도 세 변형의 답이 같다고 본 근거는 이렇습니다. 세 변형의 메모리 차이는 많아야 0.043GiB였고, 그 경우들은 한도까지 남은 메모리가 이보다 훨씬 많았습니다. 이 설명은 학습이 끝까지 된 실행에만 해당합니다. LoRA로만 돌려 메모리가 모자랐던 경우 중 한도에 가장 가까웠던 것은 12GB의 bf16 4B(2,048토큰)입니다. 이 경우 한도 없이 잰 allocated(텐서가 실제로 쓴 메모리)는 LoRA-FA와 VeRA가 LoRA보다 많아야 0.011GiB 적었고, 한도를 걸고 따로 돌리지는 않았습니다.
8GB GPU라고 8GB를 다 쓰지는 못합니다
제품 사양에 8GB라고 적힌 GPU도 학습에 실제로 쓸 수 있는 메모리는 그보다 적습니다. 이유는 두 가지입니다.
첫째, GPU가 스스로 알려 주는 용량부터 사양보다 조금 작습니다. 인터넷에 올라온 메모리 부족 오류 메시지를 찾아보면 8GB GPU는 7.75-8.00GiB, 12GB GPU는 11.77GiB, 24GB GPU는 23.65-23.99GiB로 나옵니다. 저희 A100 80GB도 79.25GiB로 나옵니다.
둘째, 학습을 시작하면 PyTorch가 모델을 올리기 전에 CUDA 드라이버와 cuBLAS 같은 라이브러리가 먼저 메모리를 가져갑니다. 이 양은 PyTorch가 보여 주는 메모리 사용량에 잡히지 않습니다. 저희 A100(CUDA 12.6)에서는 0.51-0.65GiB였습니다. 일반 소비자용 GPU에서는 재 보지 않았고, 비슷하다고 보고 계산했습니다.
저희는 A100 한 장으로 네 GPU를 흉내 냈습니다. 사양 숫자에서 0.5GiB씩 뺀 7.5, 11.5, 15.5, 23.5GiB까지만 PyTorch가 쓰도록 막고 돌렸습니다. 그런데 위의 두 가지를 모두 빼 보면 이 한도는 조금 넉넉합니다. 7.75GiB로 나오는 8GB GPU라면 0.65GiB를 빼고 7.1GiB만 남습니다. 16GB GPU 중 많이 쓰는 무료 Colab T4는 14.75GiB로 나오니, 빼고 나면 약 14.1GiB입니다.
그래서 이 차이 때문에 답이 바뀌는지 확인했습니다. 대부분은 걱정할 필요가 없었습니다. 8GB의 2,048토큰과 16GB를 뺀 나머지는 학습하는 동안에도 한도까지 0.85GiB 이상 남아 있었기 때문입니다. 8GB, 12GB, 24GB는 실제 GPU의 한도가 저희가 건 한도보다 많아야 0.5GiB 낮아서, 이만큼 남아 있으면 답이 바뀌지 않습니다. 반면 T4는 저희의 16GB 한도보다 1.4GiB 낮고, 8GB의 2,048토큰은 남은 메모리가 0.2GiB 정도뿐이었습니다. 그래서 이 두 곳은 한도를 낮춰 다시 돌렸습니다. 결과를 본 다음 날 추가한 시험이지만, 돌리기 전에 예측을 먼저 적어 두었습니다.
- 8GB, 2,048토큰 (한도 7.1GiB): 4비트 4B는 이번에도 끝까지 돌았습니다. bf16 1.7B는 세 변형 모두 메모리가 모자라 멈췄습니다. 그래서 표에는 0.6B로 적었습니다. 1.7B는 7.5GiB에서는 돌았으니, 메모리를 그만큼 쓸 수 있는 8GB GPU라면 될 수도 있습니다. 다만 위의 오류 메시지 중 가장 넉넉한 8GB GPU도 8.00 − 0.51 = 7.49GiB 정도여서 7.5GiB에 조금 못 미칩니다. 7.1과 7.5 사이의 한도는 시험하지 않았습니다.
- 16GB (한도 14.1GiB): 4비트 14B는 두 길이 모두, 세 변형 모두 끝까지 돌았습니다. 다만 2,048토큰에서는 PyTorch가 잡아 둔 메모리가 14.03-14.07GiB로, 한도와 0.07GiB도 차이 나지 않았습니다. bf16 4B는 14.1GiB에서도 1.89GiB 이상 남아서 다시 돌리지 않았습니다.
무엇을 돌렸나
- 모델: Qwen3 0.6B, 1.7B, 4B, 8B, 14B입니다. 다섯 모델 모두 vocab(모델이 아는 토큰 종류)이 151,936개로 같습니다.
- 어댑터: 3편과 4편에서 만든 코드를 그대로 써서
q_proj,v_proj에 붙였습니다. LoRA와 LoRA-FA는 rank 8, alpha 16이고, VeRA는 rank 256입니다. - 메모리를 아끼는 설정: 배치 1, gradient checkpointing, AdamW, SDPA attention입니다. 무작위 토큰으로 된 문장 하나로 3스텝씩 학습했고, 문장 길이는 1,024토큰과 2,048토큰 두 가지입니다.
- 모델 정밀도: bf16, 그리고 QLoRA처럼 bitsandbytes로 올린 4비트 nf4입니다(double quant, 계산은 bf16).
- 환경: PyTorch 2.7.1, Transformers 4.57.6, bitsandbytes 0.50.2, A100 80GB 한 장입니다. 실행 도중이나 나중의 재확인 때 다른 작업이 GPU에 올라온 적이 있습니다. 한도는 PyTorch 안에서 걸리므로 학습이 되는지 판정하는 데는 영향이 없습니다. 다만 그 실행들에서는 PyTorch 밖 메모리 값을 쓰지 않았습니다.
실행 한 번은 아래 코드와 같습니다. 모델, 변형, 문장 길이, 정밀도를 바꿔 가며 매번 새 프로세스로 하나씩 돌렸습니다.
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
from lora_layer import add_lora                      # 3편에서 만든 LoRA 층

GiB = 2**30
MODEL, BASE, SEQ = "Qwen/Qwen3-1.7B", "bf16", 2048   # BASE는 "bf16" 또는 "nf4"

quant = BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_quant_type="nf4",
                           bnb_4bit_use_double_quant=True,
                           bnb_4bit_compute_dtype=torch.bfloat16) if BASE == "nf4" else None
model = AutoModelForCausalLM.from_pretrained(
    MODEL, dtype=torch.bfloat16, attn_implementation="sdpa",
    quantization_config=quant, device_map={"": 0})
# nf4이면 이 줄 앞뒤로 손볼 곳이 있습니다(아래 설명)
add_lora(model, 8, 16, ("q_proj", "v_proj"))         # rank 8, alpha 16

model.gradient_checkpointing_enable(gradient_checkpointing_kwargs={"use_reentrant": False})
model.config.use_cache = False
model.train()                                        # checkpointing은 학습 모드에서만 동작
opt = torch.optim.AdamW([p for p in model.parameters() if p.requires_grad], lr=1e-5)
torch.cuda.reset_peak_memory_stats()                 # 모델을 올릴 때가 아니라 학습 피크만 잽니다

ids = torch.randint(0, model.config.vocab_size, (1, SEQ), device="cuda")   # 배치 1, 무작위 토큰
for _ in range(3):
    model(input_ids=ids, labels=ids).loss.backward()                        # 모든 토큰에 loss
    opt.step(); opt.zero_grad(set_to_none=True)
print(f"allocated {torch.cuda.max_memory_allocated() / GiB:.2f} GiB, "
      f"reserved {torch.cuda.max_memory_reserved() / GiB:.2f} GiB")
4비트로 올릴 때는 한 군데를 고쳐야 했습니다. 3편에서 만든 층은 어댑터 A와 B를 원래 가중치와 같은 dtype으로 만듭니다. 그런데 4비트 층의 가중치는 uint8이고, uint8 텐서는 기울기를 가질 수 없어서 add_lora가 오류를 내고 멈춥니다. 그래서 add_lora가 도는 동안에만 uint8 텐서 대신 bf16 텐서를 만들게 하고, 끝난 뒤 A와 B를 다시 초기화했습니다. 전체 코드는 재현 패키지의 part5_fit.py에 있습니다. PEFT 라이브러리를 쓰면 이 부분은 알아서 처리됩니다.
GPU 크기는 torch.cuda.set_per_process_memory_fraction으로 흉내 냈습니다. 이렇게 하면 PyTorch가 정한 한도보다 많이 쓰려 할 때 실제 GPU처럼 메모리 부족 오류가 납니다.
측정은 두 번 했습니다. 첫 번째에는 한도 없이 48가지 조합을 한 번씩 돌려 메모리 최대치(피크)를 쟀습니다. 이 값을 네 GPU의 한도와 비교하면 GPU마다 어느 모델이 아슬아슬한지 빨리 알 수 있습니다. 그런데 한도 없이 잰 피크는 한도를 걸었을 때 실제로 쓰는 양과 달랐습니다(아래에서 다룹니다). 그래서 두 번째에는 GPU와 설정마다 들어갈 것 같은 가장 큰 모델과 그보다 한 단계 큰 모델을, 실제로 한도를 걸고 돌렸습니다. 두 결과가 다르면 두 번째를 따랐습니다. 표의 답은 모두 한도를 걸고 돌린 실행에서 나왔습니다.
LoRA 변형을 바꿔도 답이 같은 이유
4편에서 변형마다 메모리가 달랐던 것은, 학습 중에 층마다 계산 결과를 얼마나 남겨 두느냐가 달랐기 때문입니다. LoRA-FA는 층의 입력을 남기지 않아서 덜 썼고, VeRA는 더 큰 중간 결과를 남겨서 더 썼습니다.
gradient checkpointing을 켜면 이 차이가 거의 사라집니다. 층마다 입력 하나만 남기고, 나머지는 필요할 때 한 층씩 다시 계산하기 때문입니다. 그러면 변형마다 더 남기거나 덜 남기는 양이 모든 층에서 쌓이지 않고, 다시 계산하는 한 층에서만 생깁니다. 첫 측정 48번에서 LoRA-FA나 VeRA와 LoRA의 피크 차이는 가장 큰 경우에도 0.043GiB였습니다(reserved 기준, allocated는 0.023GiB).
학습하는 파라미터 자체도 메모리를 거의 쓰지 않습니다. Qwen3-14B에 LoRA를 붙이면 학습하는 파라미터는 524만 개이고, 기울기와 AdamW 상태까지 합쳐도 0.1GiB가 안 됩니다.
메모리는 어디에 쓰이나: 모델 가중치, 그리고 1,024토큰마다 약 2GiB
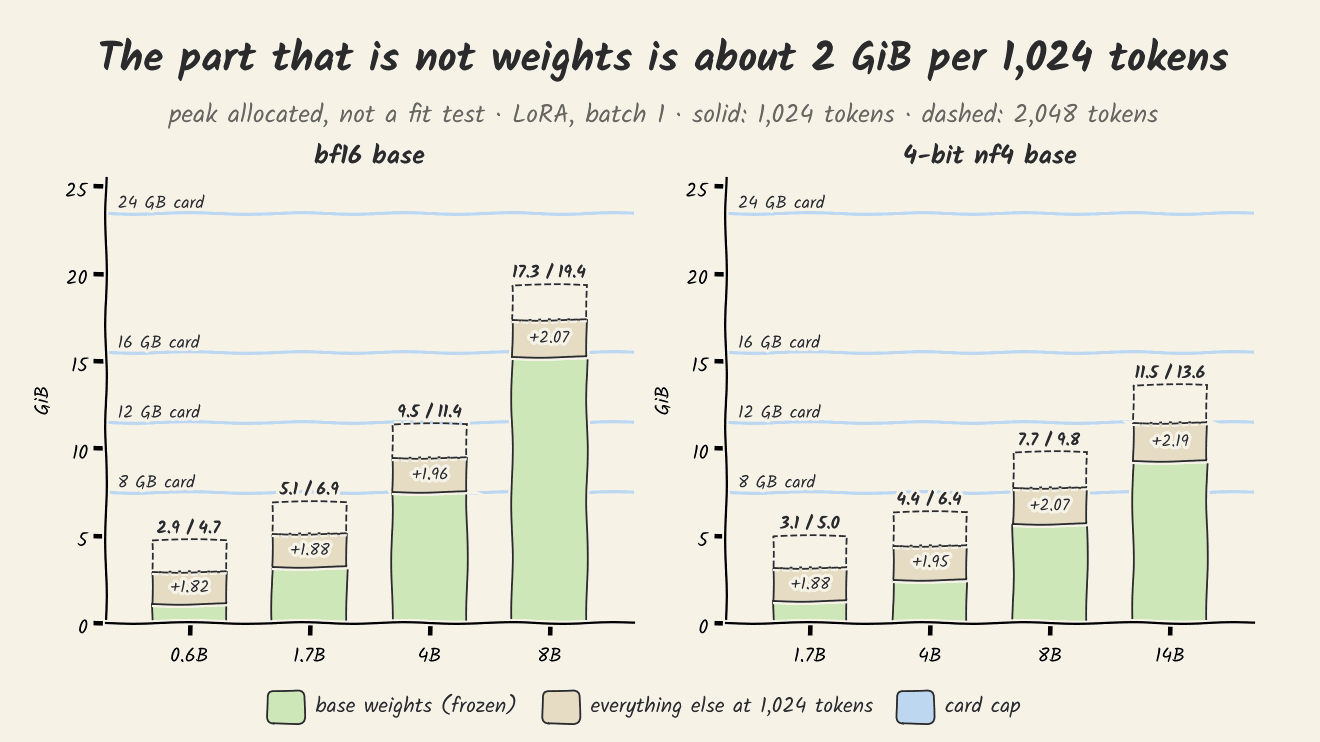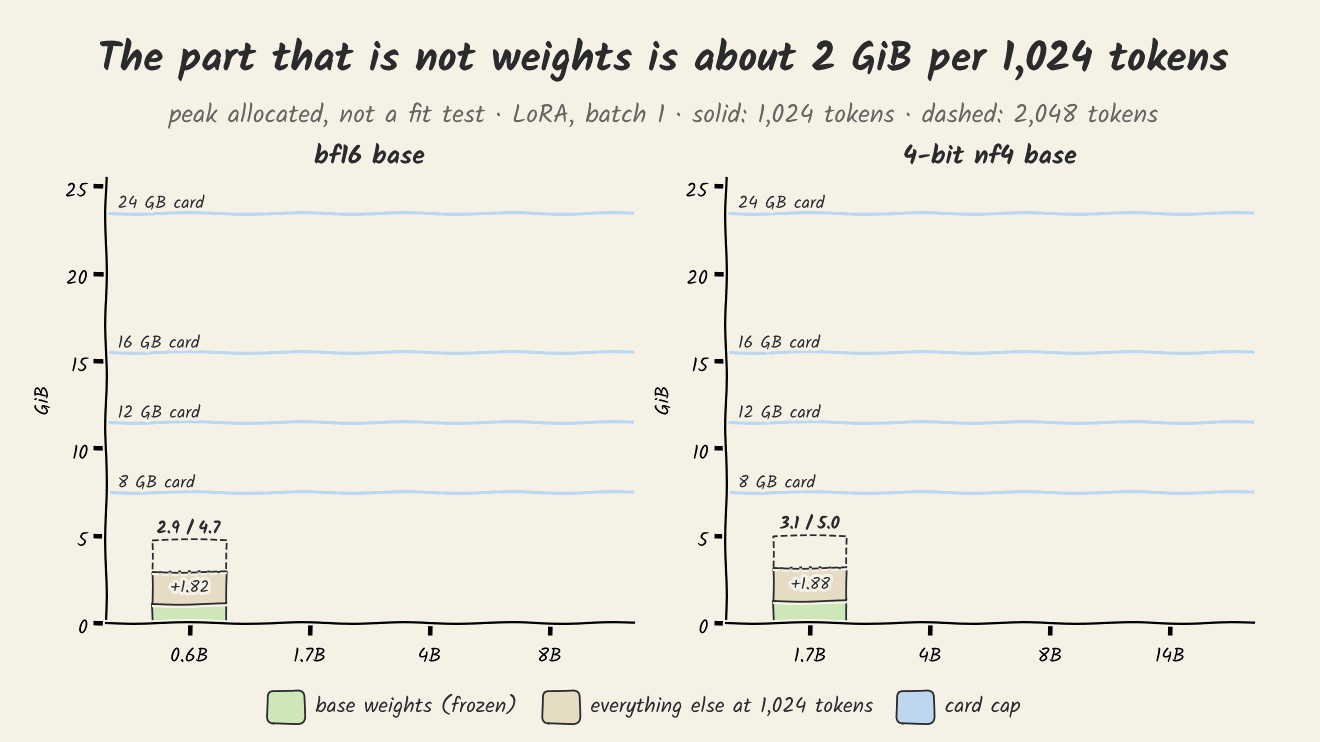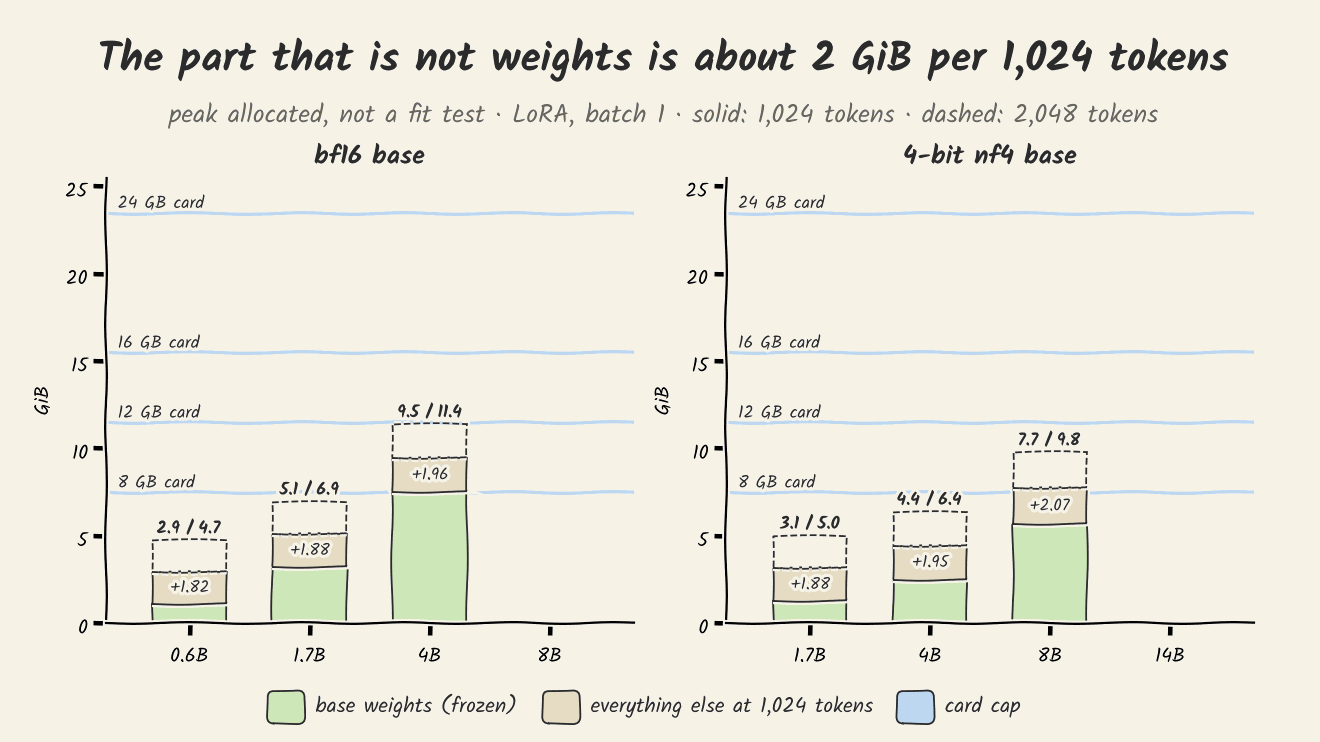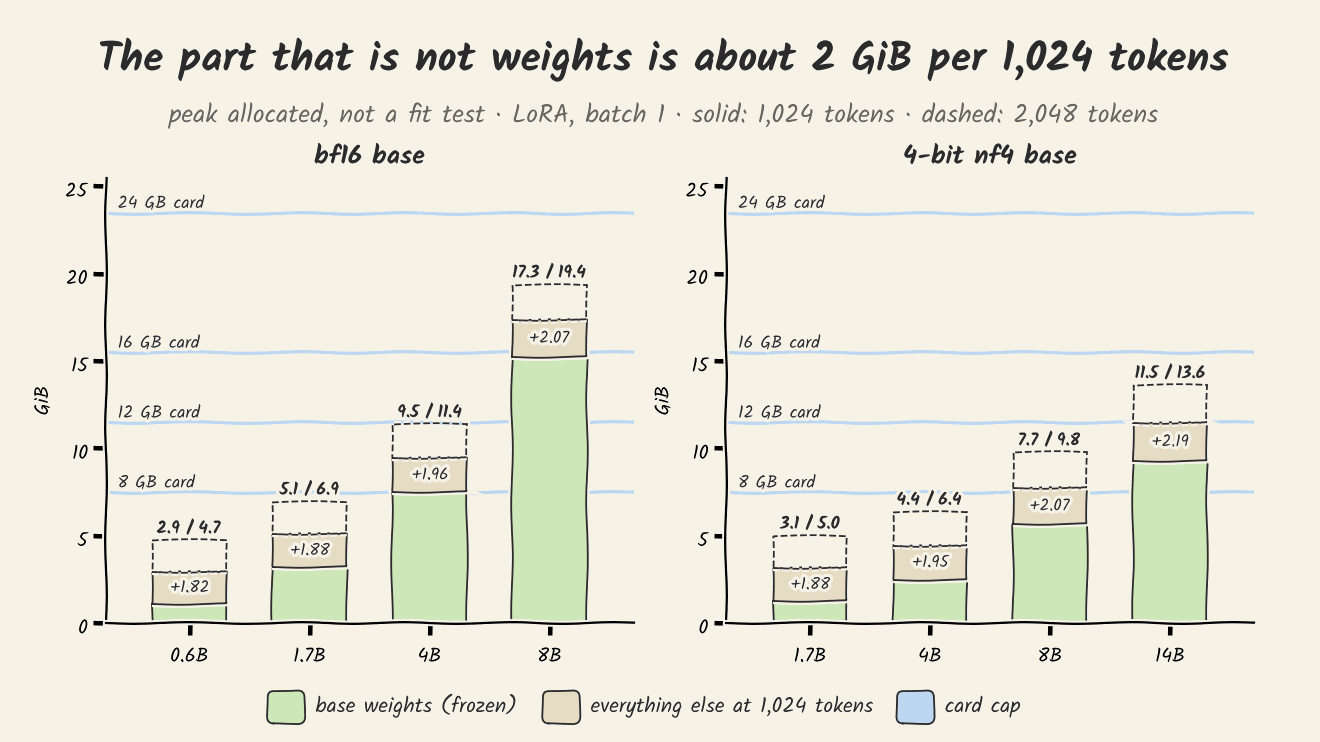
실행마다 피크 메모리에서 모델 가중치를 빼 보면, 남는 양이 모델 크기와 상관없이 비슷합니다. 1,024토큰에서 1.82-2.19GiB, 2,048토큰에서 3.62-4.34GiB입니다. 문장이 두 배로 길어지면 이 양도 거의 두 배가 됩니다. 반면 모델이 0.6B에서 14B로 커져도 이 양은 1,024토큰에서 0.37GiB, 2,048토큰에서 0.72GiB만 늘었습니다. bf16으로 올리든 4비트로 올리든 이 양은 거의 같았습니다.
결과를 보고 이 나머지를 나눠 보니, 대부분은 모델의 마지막 출력층에서 나왔습니다. 모델은 토큰마다 151,936개 토큰 전부에 점수를 매기고, loss를 계산하는 동안 이 점수를 여러 벌 들고 있습니다. 1,024토큰이면 모델 크기와 상관없이 약 1.7GiB입니다. 모델 크기를 따라 늘어나는 것은 gradient checkpointing이 남겨 두는 층 입력입니다. 3편의 식으로 계산하면 1,024토큰에서 0.6B는 0.06GiB, 14B는 0.44GiB입니다.
작은 GPU가 빠듯한 이유가 여기 있습니다. bf16 Qwen3-1.7B는 가중치가 3.21GiB인데, 2,048토큰으로 학습하면 나머지가 3.74GiB로 가중치보다 큽니다. 같은 모델에서 문장을 1,024토큰에서 2,048토큰으로 늘리기만 해도 1.86GiB가 더 듭니다.
4비트로 올리면 줄어드는 것은 가중치뿐입니다. Qwen3-8B의 가중치는 15.27GiB에서 5.66GiB로 줄고, 14B는 9.28GiB가 됩니다. 정확히 4분의 1이 되지 않는 것은 입력 임베딩과 출력층(lm_head), norm 층이 bf16으로 남기 때문입니다. 14B에서는 임베딩과 lm_head만 해도 약 2.9GiB입니다. 1,024토큰마다 드는 2GiB는 4비트에서도 그대로입니다.
그래서 4비트는 GPU 메모리 중 가중치가 차지하는 비중이 클 때 효과가 큽니다. 16GB에서는 4B가 14B로 올라가고, 12GB의 2,048토큰에서는 1.7B가 8B로 올라갑니다. 8GB에서는 1,024토큰이면 1.7B에서, 2,048토큰이면 0.6B에서 4B로 올라갑니다. 24GB에서는 8B에서 14B로 한 단계 올라가는데, 14B가 저희가 돌린 가장 큰 모델이었습니다.
정리하면, Qwen3처럼 vocab이 15만 개쯤인 모델을 배치 1과 gradient checkpointing으로 학습한다면 필요한 메모리는 이렇게 어림할 수 있습니다. 모델 가중치에 1,024토큰마다 2GiB를 더하고, CUDA 드라이버와 라이브러리 몫 0.65GiB, 그리고 다음 절에서 볼 여유분을 더합니다. 이 합을 사양에 적힌 숫자가 아니라 내 GPU가 알려 주는 용량과 비교하면 됩니다. vocab이 더 작은 모델은 토큰당 메모리가 더 적게 들 텐데, 저희가 재 보지는 않았습니다.
한도 없이 잰 피크만 보면 틀리는 이유
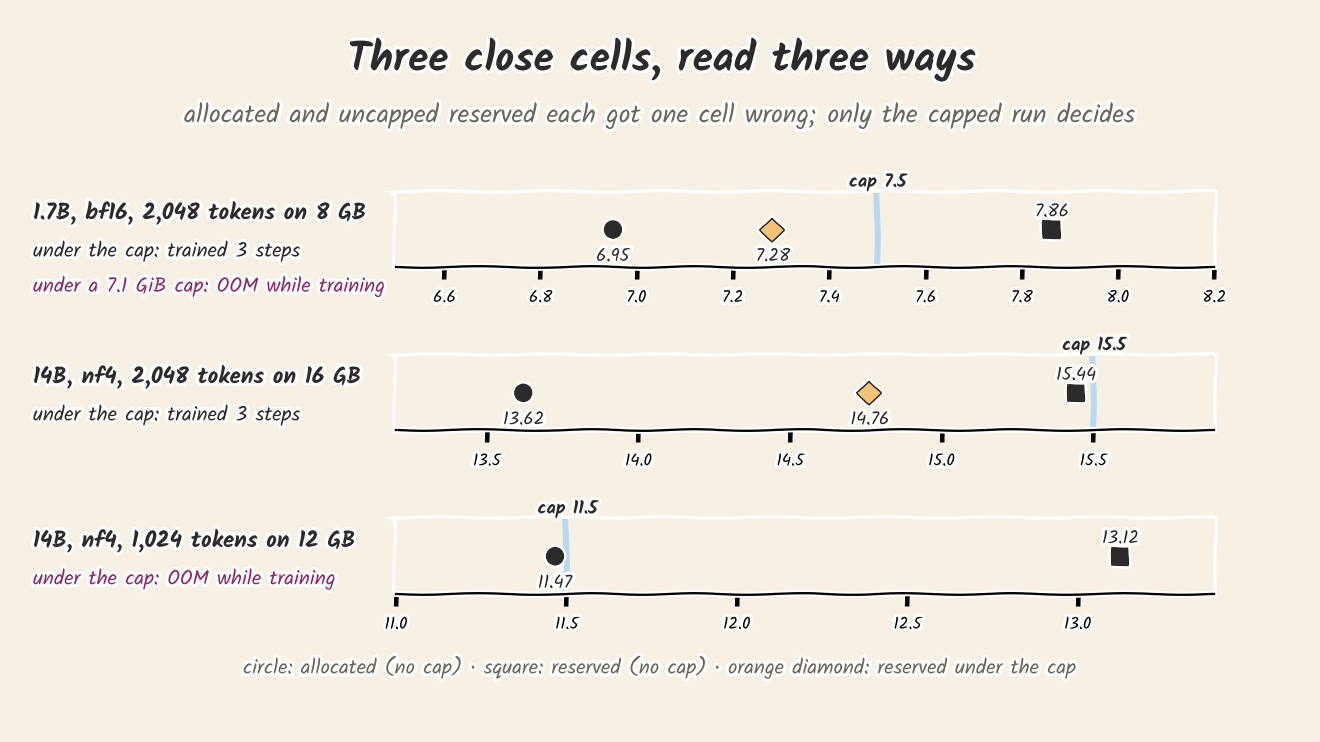
PyTorch가 알려 주는 피크 메모리는 두 가지입니다. allocated는 텐서가 실제로 쓴 양이고, reserved는 PyTorch가 GPU에서 받아 둔 양입니다. PyTorch는 다 쓴 공간을 바로 돌려주지 않고 다음에 다시 쓰려고 들고 있어서, reserved가 allocated보다 큽니다. 한도 없이 잰 값으로는 둘 중 어느 쪽을 봐도 모든 경우를 맞히지 못했습니다.
- 한도 없이 잰 reserved로 보면 너무 비관적이었습니다. bf16 Qwen3-1.7B를 2,048토큰으로 돌리면 한도가 없을 때 reserved가 7.86GiB여서, 8GB 한도 7.5GiB에는 안 들어갈 것처럼 보입니다. 그런데 한도를 걸자 7.28GiB만 쓰고 끝까지 돌았습니다. 한도에 닿자 들고 있던 빈 공간을 내놓고 다시 시도한 것으로 보이지만, 직접 추적하지는 않았습니다.
- allocated로 보면 너무 낙관적이었습니다. 4비트 Qwen3-14B를 1,024토큰으로 돌리면 allocated가 11.47GiB로 12GB 한도 11.5GiB보다 작습니다. 그런데 한도를 걸자 학습 도중 메모리가 모자랐습니다. 빈 공간이 있어도 다음에 필요한 크기와 맞지 않을 때가 있어서, 실제로 쓰는 양보다 공간이 더 필요합니다. 같은 모델을 16GB 한도에서 2,048토큰으로 돌렸을 때는 allocated가 13.62GiB, reserved가 14.76GiB로 1.14GiB를 더 잡았습니다.
그래서 표의 답은 모두 한도를 걸고 실제로 돌려서 정했습니다.
내 GPU에서 확인하는 법
내 GPU에서는 위의 코드를 그대로 돌려 보면 됩니다. 3스텝이 끝까지 돌면 학습이 되는 것입니다. 한도를 따로 걸 필요도 없습니다.
저희처럼 큰 GPU로 작은 GPU를 흉내 낼 때만, 모델을 올리기 전에 아래 줄을 넣습니다.
CAP = 7.1                                            # 7.75GiB로 나오는 8GB GPU에서 0.65를 뺀 값
total = torch.cuda.get_device_properties(0).total_memory
torch.cuda.set_per_process_memory_fraction(CAP * GiB / total)
torch.cuda.mem_get_info = lambda device=None: (
    int(CAP * GiB) - torch.cuda.memory_reserved(), int((CAP + 0.65) * GiB))
마지막 두 줄이 필요한 이유는 이렇습니다. set_per_process_memory_fraction만 넣으면 모델을 올리는 단계에서 멈출 수 있습니다. Transformers는 모델을 올리기 전에 메모리를 미리 한꺼번에 잡는데, 얼마나 잡을지를 torch.cuda.mem_get_info가 알려 주는 빈 메모리를 보고 정합니다(빈 메모리에서 1.2GiB를 뺀 값까지). 그런데 한도를 걸어도 이 함수는 GPU 전체의 빈 메모리를 알려 줍니다. A100은 78GiB쯤 비어 있다고 답했고, Transformers는 11.5GiB 한도 안에서 13GiB를 잡으려다 실패했습니다. 처음 한도를 걸고 돌린 30번 중 4번(12GB의 4비트 14B)이 이렇게 멈췄습니다. 고친 뒤 다시 돌려 보니 네 번 모두 학습 도중 메모리가 모자랐기 때문에, 표의 답이 바뀌지는 않았습니다. 마지막 두 줄은 이 함수가 한도를 기준으로 답하게 바꿉니다. 진짜 12GB GPU는 자기 빈 메모리를 답하니 이 문제가 없습니다.
미리 적어 둔 예측과 채점
아래 예측은 첫 실행 전에, 숫자를 낸 계산 코드와 함께 적어 두었습니다. 표 안의 네 모델은 차례대로 8GB, 12GB, 16GB, 24GB의 답입니다.
| # | 예측 | 결과 | 판정 |
|---|---|---|---|
| N1 | 같은 설정으로 다섯 번 돌려도(seed 세 가지) 차이가 0.01GiB 이하 | 다섯 번 모두 5.0891GiB | 맞음 |
| P1 | 모든 LoRA 실행에서 실측 피크가 계산값의 0.9-1.1배 | 16번 중 14번이 범위 안, 두 번은 0.893과 0.894 | 틀림 |
| P2 | bf16, 1,024토큰: 1.7B / 4B / 4B / 8B | 같음 | 맞음 |
| P3 | bf16, 2,048토큰: 0.6B / 1.7B / 4B / 8B | 8GB가 1.7B | 틀림 |
| P4 | 4비트, 1,024토큰: 4B / 8B / 14B / 14B | 같음 | 맞음 |
| P5 | 4비트, 2,048토큰: 4B / 8B / 14B / 14B | 같음 | 맞음 |
| P6 | 모든 실행에서 LoRA-FA, VeRA와 LoRA의 차이가 0.05GiB 이하 | allocated 0.023, reserved 0.043 | 맞음 |
| P7 | 변형 때문에 바뀌는 답이 없음 | 16곳 중 0곳 | 맞음 |
| P8 | PyTorch 밖에서 쓰는 메모리가 0.3-0.7GiB | 0.507-0.653 | 맞음(실행 도중 다른 작업이 GPU에 올라온 9번 제외) |
| P9 | 한도를 건 실행과 첫 측정의 판정이 모든 곳에서 같음 | 1곳이 다름 | 틀림 |
P1과 P3은 원인이 같다고 봅니다. 이것은 미리 예측한 것이 아니라 결과를 보고 한 해석입니다. 저희 계산은 모든 실행에서 실측보다 2-12% 컸고, 같은 모델이면 문장이 길수록 더 크게 빗나갔습니다. 문장 길이를 따라 늘어나는 부분을 너무 크게 잡았다는 뜻입니다. 저희는 출력층 몫을 토큰 하나, vocab 하나당 14바이트로 잡았습니다. 3편에서 Qwen2.5로 잰 값입니다. 결과를 보고 다시 나눠 보니 Qwen3에서는 약 12바이트였습니다. P9는 원인이 다릅니다. 앞에서 본 것처럼 한도 없이 잰 reserved가 너무 비관적이었기 때문입니다.
이 계산 차이 때문에 7.5GiB 한도에서 답이 바뀐 곳은 8GB의 bf16, 2,048토큰 하나입니다. 계산으로는 1.7B에 7.53GiB가 필요해서 한도를 넘으니 0.6B라고 예측했습니다. 그런데 7.5GiB 한도를 걸고 돌려 보니 1.7B가 끝까지 돌았습니다. 실제 8GB GPU에 더 가까운 7.1GiB 한도에서는 돌지 못했으니, 그 기준에서는 예측한 0.6B가 맞습니다. 계산값이 한도와 이만큼 붙어 있으면 계산만으로는 판정할 수 없고 직접 돌려 봐야 합니다.
확인하지 않은 것
- 진짜 GPU가 아니라 한도를 건 A100입니다. GPU가 알려 주는 용량과 드라이버 몫은 따져 봤지만, 실제 GPU는 화면 출력도 맡고 다른 프로그램이 메모리를 쓰고 있을 수도 있습니다. 이 몫은 재지 않았습니다. 모니터를 그 GPU에 꽂아 쓴다면 표보다 여유를 더 두시고, 특히 8GB의 2,048토큰과 16GB의 4비트 14B(2,048토큰)는 조심하셔야 합니다.
- 무작위 토큰으로 3스텝만 돌렸습니다. 메모리는 문장 내용이 아니라 길이로 정해지니, 같은 길이의 실제 데이터도 피크가 같을 것으로 봅니다. 실제 데이터로는 돌리지 않았습니다.
- 어댑터는
q_proj,v_proj에만 붙였습니다. 모든 linear 층에 붙이면 더 들 텐데, 얼마나 더 드는지는 재지 않았습니다. - 배치는 1만 봤습니다. 배치 2에 1,024토큰이면 배치 1에 2,048토큰과 비슷하게 들 것으로 보지만 확인하지 않았습니다.
- 모델은 Qwen3 하나뿐입니다. 다섯 모델 모두 vocab이 151,936개이고, 토큰마다 드는 메모리의 대부분이 여기서 나옵니다. vocab이 32,000개인 모델이면 훨씬 적게 들 것입니다.
- 결과를 보고 덧붙인 것: 12바이트 계산과 reserved에 대한 설명은 결과를 보고 한 해석이고, 미리 적어 둔 예측이 아닙니다. 7.1GiB와 14.1GiB 한도로 다시 돌린 것도 결과를 본 다음 날 추가한 시험입니다. 다만 두 재확인의 예측은 돌리기 전에 먼저 적어 두었습니다.
다음 편
6편으로 연재를 마칩니다. 아래 뉴스레터 양식에 이메일을 남기시면 나왔을 때 보내 드립니다.