LoRA 변형 네 가지를 몇 줄씩 고쳐 만들기: VeRA는 학습하는 숫자가 93% 적은데 메모리는 오히려 조금 더 썼습니다
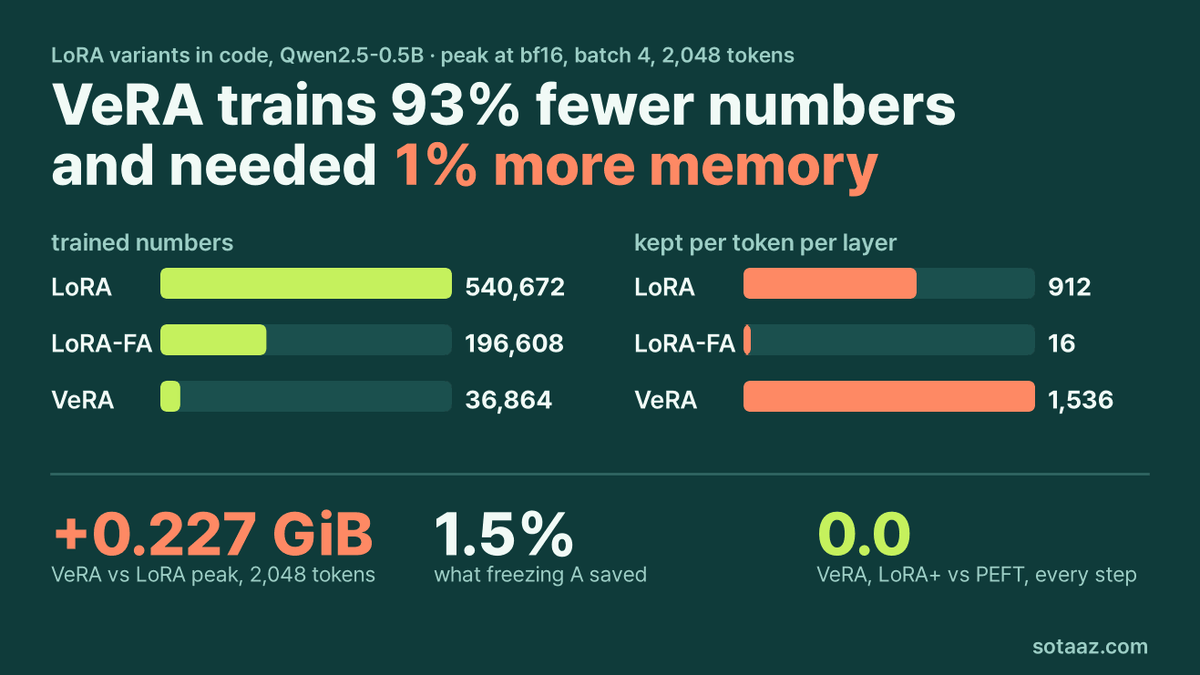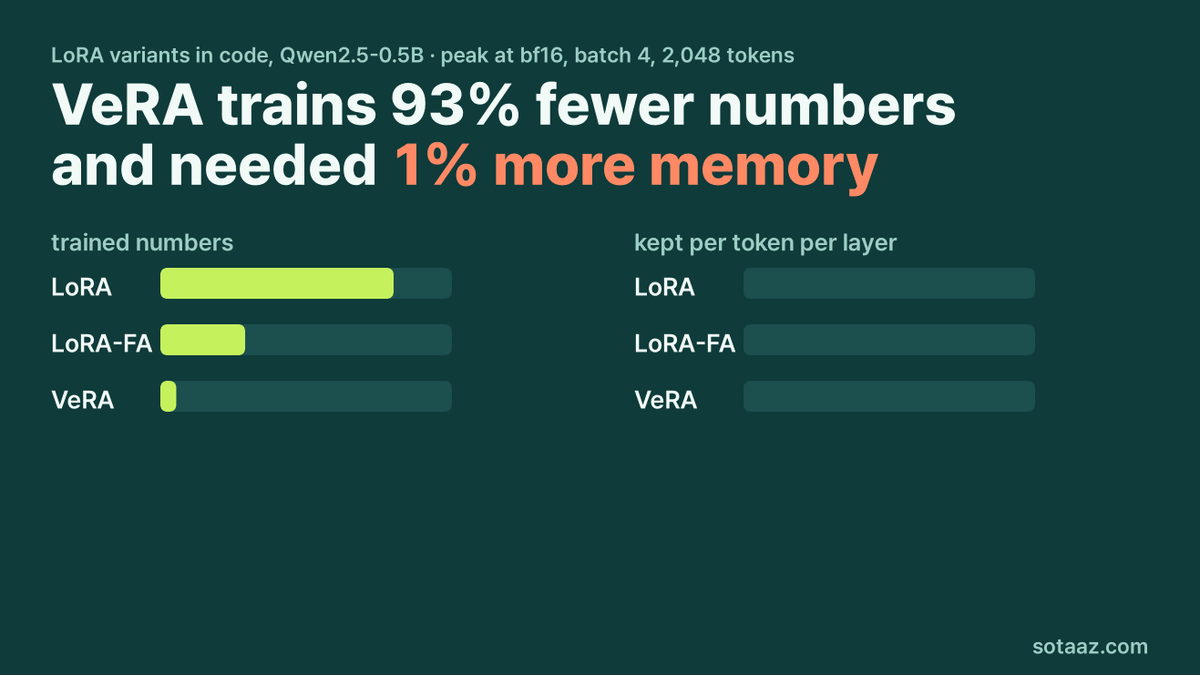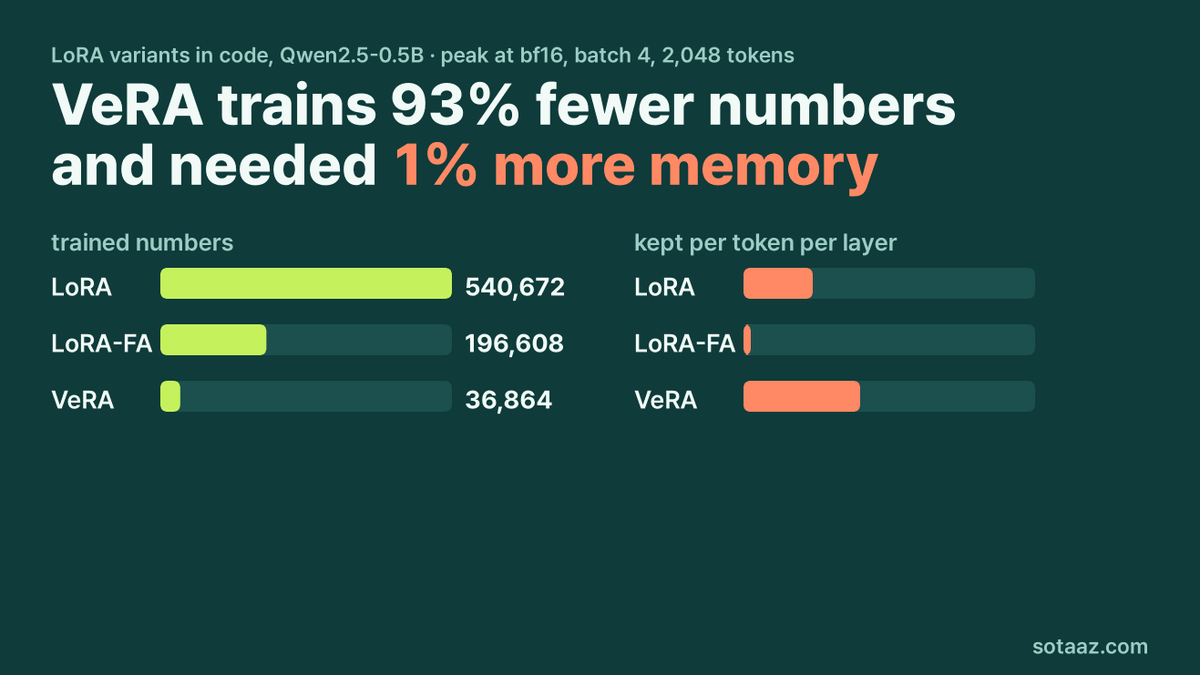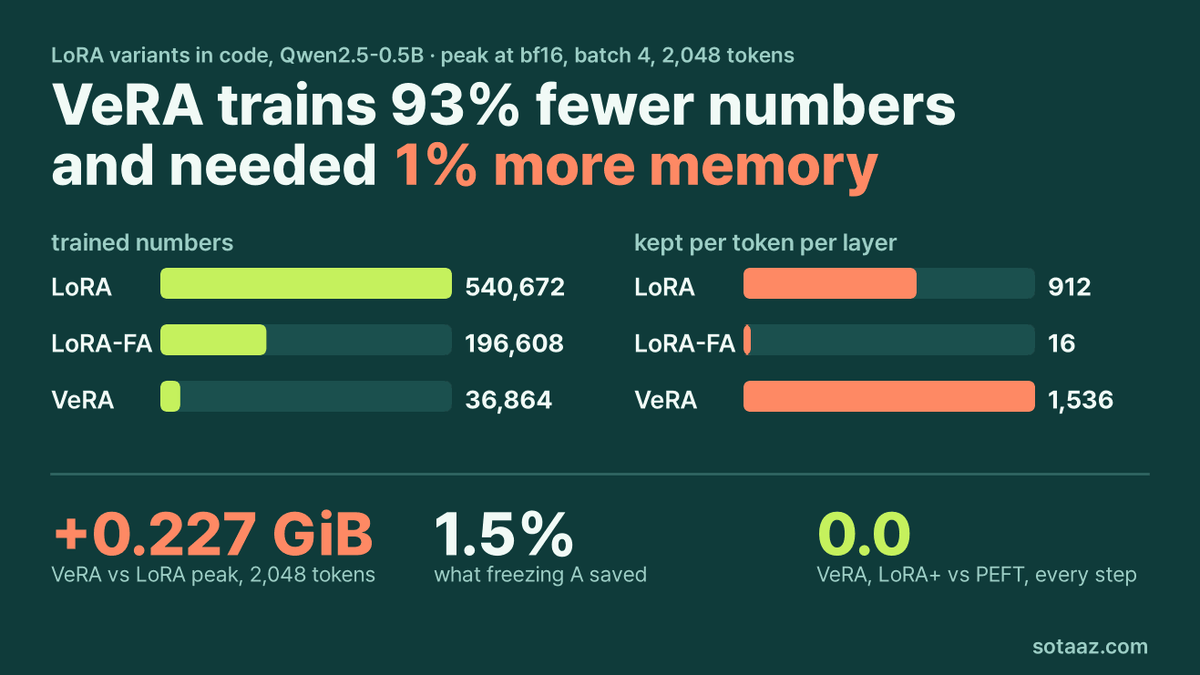
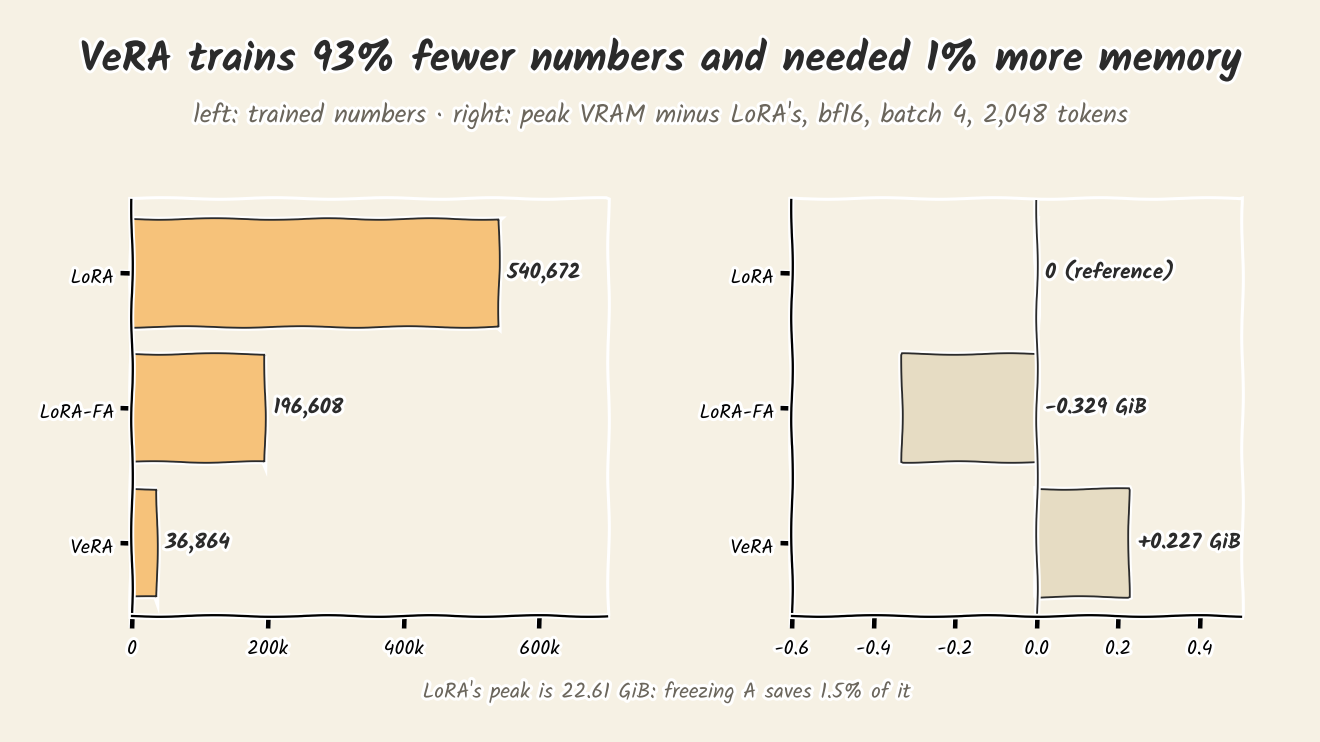
19줄 LoRA 층을 고쳐 LoRA-FA, LoRA+, VeRA, Delta-LoRA를 만들고, 그중 셋을 Qwen2.5-0.5B에서 PEFT와 맞춰 봤습니다. 변형마다 GPU에 무엇이 남는지도 쟀습니다. VeRA는 LoRA의 540,672개 대신 36,864개만 학습하는데도 활성화 메모리가 더 많이 들었습니다. 길이 2,048에서 0.227GiB, 피크의 약 1%입니다.
LoRA 변형 네 가지를 몇 줄씩 고쳐 만들기: VeRA는 학습하는 숫자가 93% 적은데 메모리는 오히려 조금 더 썼습니다
Qwen2.5-0.5B에서 VeRA가 학습하는 숫자는 36,864개입니다. 같은 두 projection에 LoRA를 붙이면 540,672개입니다. 그러면 학습할 때 VeRA가 더 가벼워야 할 것 같습니다. 실제로는 반대였습니다. bf16, 배치 4, 길이 2,048에서 VeRA의 피크 메모리가 LoRA보다 0.227GiB 높았습니다. 저희는 실험을 돌리기 전에 이 결과를 예측해 두었습니다. 층마다 backward를 위해 무엇을 남겨 두는지 세어 본 것입니다. 그 셈으로 낸 메모리 차이는 네 경우 중 셋에서 실제와 1% 안으로 맞았고, 나머지 하나는 15% 벗어났습니다.
이 글은 따라 하는 튜토리얼입니다. 2편에서는 LoRA 변형 다섯 가지를 표 하나에 놓았고, 3편에서는 LoRA를 19줄로 만들어 PEFT 라이브러리와 맞춰 봤습니다. 이번에는 그 층을 조금씩 고쳐서 나머지 네 가지를 만듭니다.
- LoRA-FA는 A를 얼립니다.
- LoRA+는 B의 학습률을 A보다 크게 줍니다.
- VeRA는 무작위로 만든 행렬 한 쌍을 모든 층이 나눠 쓰고, 층마다 벡터 두 개만 학습합니다.
- Delta-LoRA는 원래 얼려 두는 가중치 W도 움직입니다. 스텝마다
B A가 바뀐 만큼 W에 더합니다.
변형마다 GPU 메모리를 줄일 수 있는지 없는지 그 이유를 먼저 말하고, 코드를 보인 뒤, 맞는지 확인합니다. 넷 중 셋은 PEFT에 들어 있어서 3편과 같은 방법으로 PEFT와 비교합니다. Delta-LoRA는 PEFT에 없어서 그 갱신 규칙 자체로 확인합니다.
준비물
3편과 같습니다. PyTorch 2.7.0, Transformers 5.20.2, PEFT 0.21.2를 쓰고, 모델은 Qwen/Qwen2.5-0.5B-Instruct, 어댑터는 24층 전부의 q_proj와 v_proj에 붙입니다. 맞춰 보는 실험은 fp32, TF32 끔, eager attention으로 3편과 같은 4문장 배치를 AdamW(weight decay 0)로 30스텝 학습합니다. 메모리 측정은 bf16, SDPA attention, 배치 4로 3편 5단계의 루프를 그대로 쓰고, 길이 2,048에서 피크가 약 23GiB입니다.
3편의 LoRALinear와 add_lora도 필요합니다. 아래 코드는 모두 그 위에 얹습니다.
변형마다 optimizer가 무엇을 건드리는지 아래 그림으로 먼저 보겠습니다.
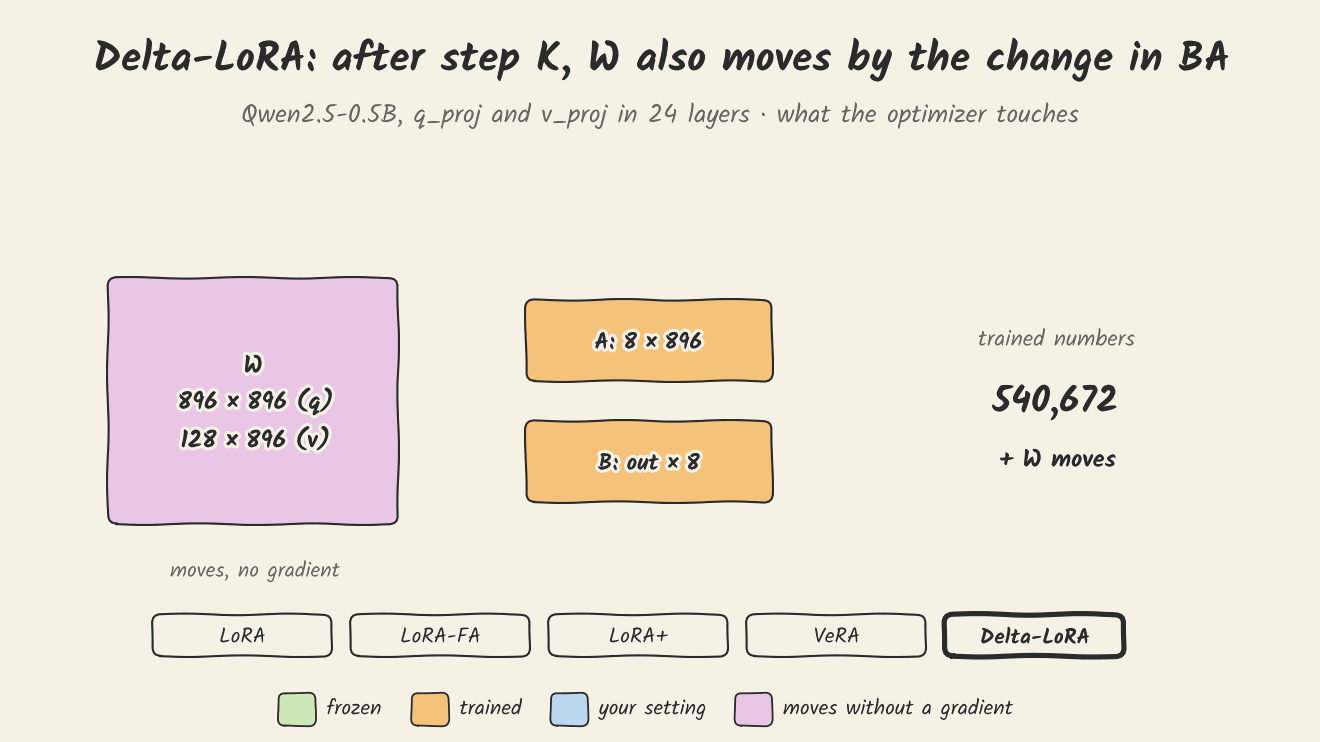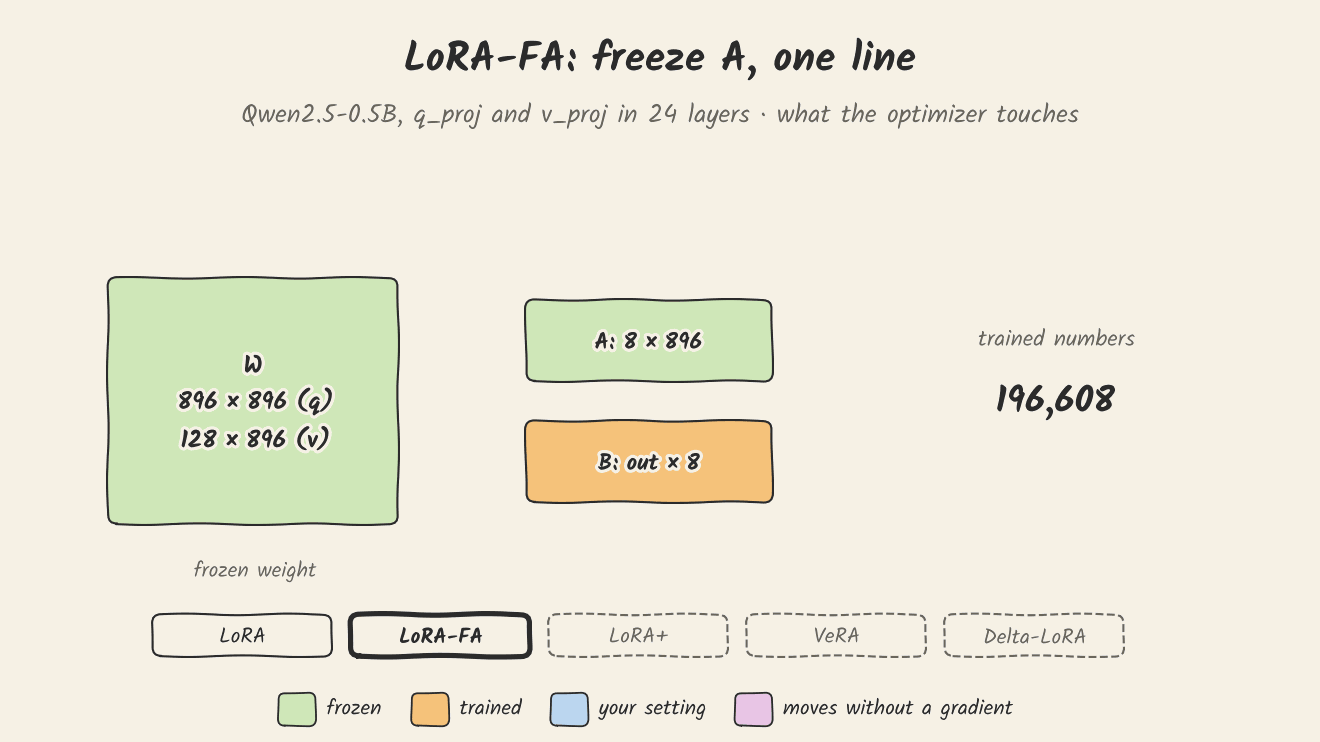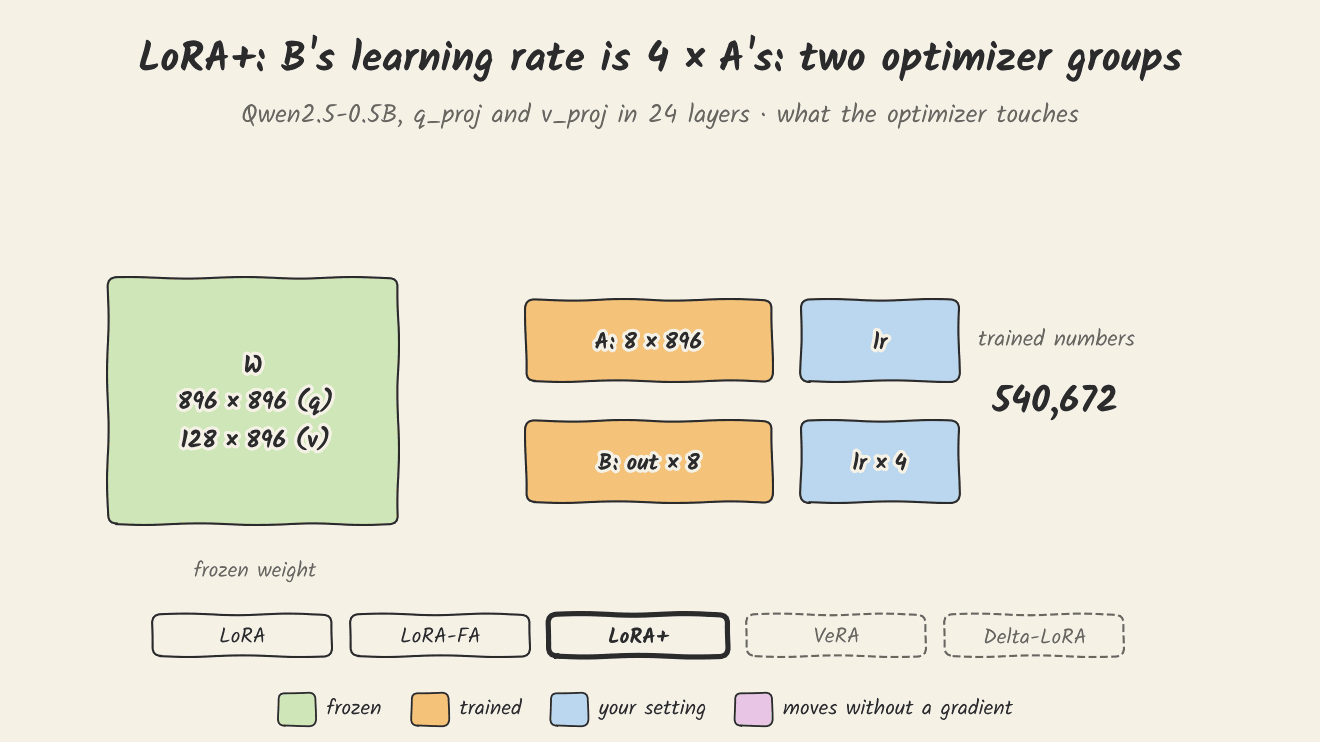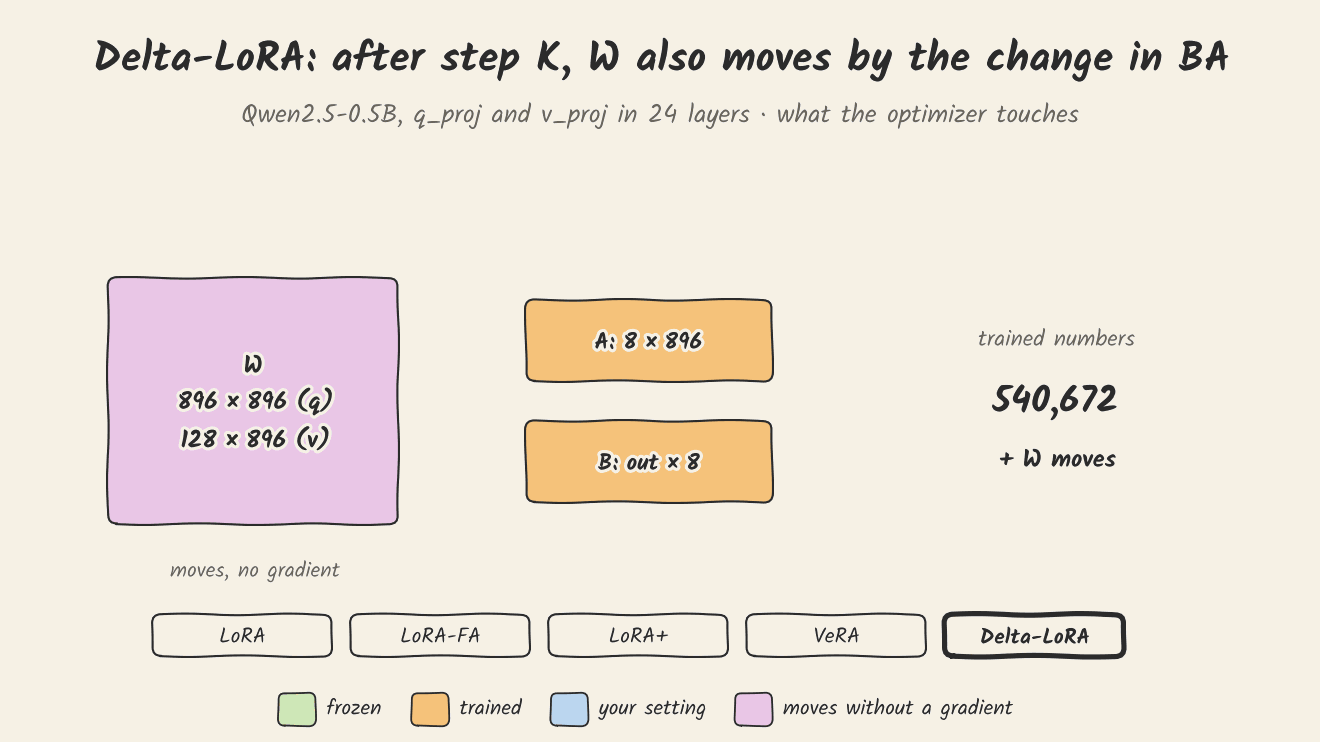
왜 어떤 버전은 메모리를 절약하고 다른 버전은 그렇지 못할까요?
학습 메모리는 두 부분으로 구성됩니다. 하나는 고정된 부분으로, 가중치에 더해 학습하는 숫자마다 기울기 하나와 Adam state 두 개가 붙습니다. 다른 하나는 토큰 수에 따라 늘어나는 부분입니다. 층마다 backward에서 기울기를 구하려고 forward 때 값을 남겨 두는데, 그 메모리 양입니다.
Adam state는 AdamW optimizer가 학습하는 숫자마다 따로 들고 다니는 값 두 개입니다. 하나는 지금까지 받은 기울기의 이동 평균이고, 다른 하나는 기울기 제곱의 이동 평균입니다. AdamW는 이 둘로 숫자마다 한 번에 얼마나 움직일지를 정합니다. 기울기가 꾸준히 같은 방향이면 크게, 들쭉날쭉하면 작게 움직입니다. 그래서 학습하는 숫자 하나에 기울기까지 세 개의 값이 더 붙습니다.
LoRA가 학습하는 숫자는 이미 모델의 0.11%뿐이라 그 기울기와 Adam state 값도 작습니다. 그보다 더 적게 학습하는 LoRA 구조를 써도 고정된 부분에서는 거의 줄지 않습니다. 줄일 여지가 남은 곳은 층마다 토큰당 남겨 두는 값뿐입니다.
그래서 LoRA 변형마다 무엇을 남겨 두는지만 보면 됩니다. LoRA는 A의 기울기를 구하려고 층의 입력 x(토큰당 896개)를 남기고, B의 기울기를 구하려고 A x(8개)를 남깁니다. q_proj와 v_proj는 같은 x를 받으므로 x는 층마다 한 번만 남습니다. 합치면 층마다 토큰당 896 + 8 + 8 = 912개입니다.
LoRA-FA: A를 얼립니다
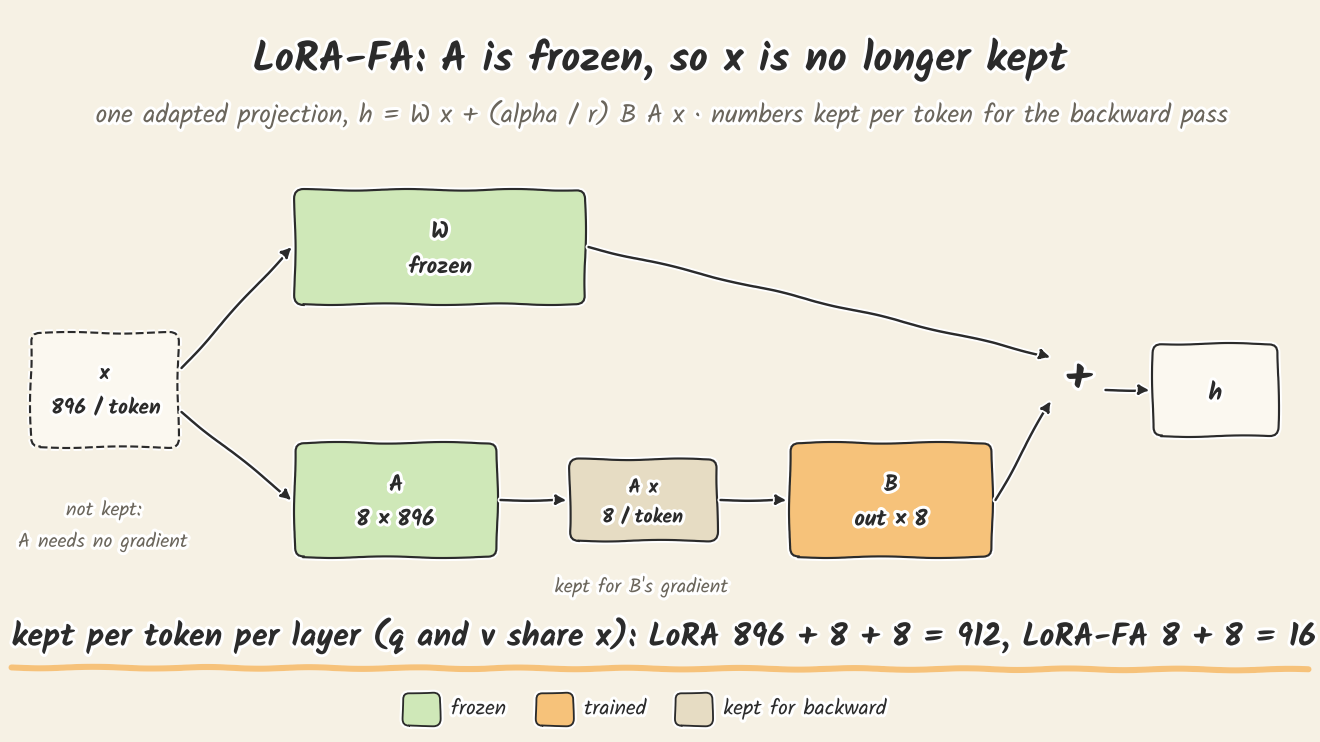
메모리를 줄일 수 있는 이유: A에 기울기가 필요 없으면 x를 남길 이유도 없습니다. 층마다 B를 위한 A x만 남으니 912개가 16개로 줄어듭니다.
코드는 add_lora 뒤에 반복문 하나를 붙이면 끝납니다.
def add_lora_fa(model, r=8, alpha=16, targets=("q_proj", "v_proj")):
    add_lora(model, r, alpha, targets)
    for m in model.modules():
        if isinstance(m, LoRALinear):
            m.A.requires_grad_(False)   # A stays at its random start
    return model
행렬 곱은 반대쪽에 기울기가 필요할 때만 입력을 남겨 둡니다. 그래서 A만 얼려도 x가 남지 않고, forward 코드는 바꿀 필요가 없습니다.
학습하는 숫자는 540,672개에서 196,608개로 줄어듭니다. B 행렬만 남은 수입니다. 저희 코드, PEFT, 계산식 24 × 8 × (896 + 128) 셋이 모두 같은 값을 냈습니다.
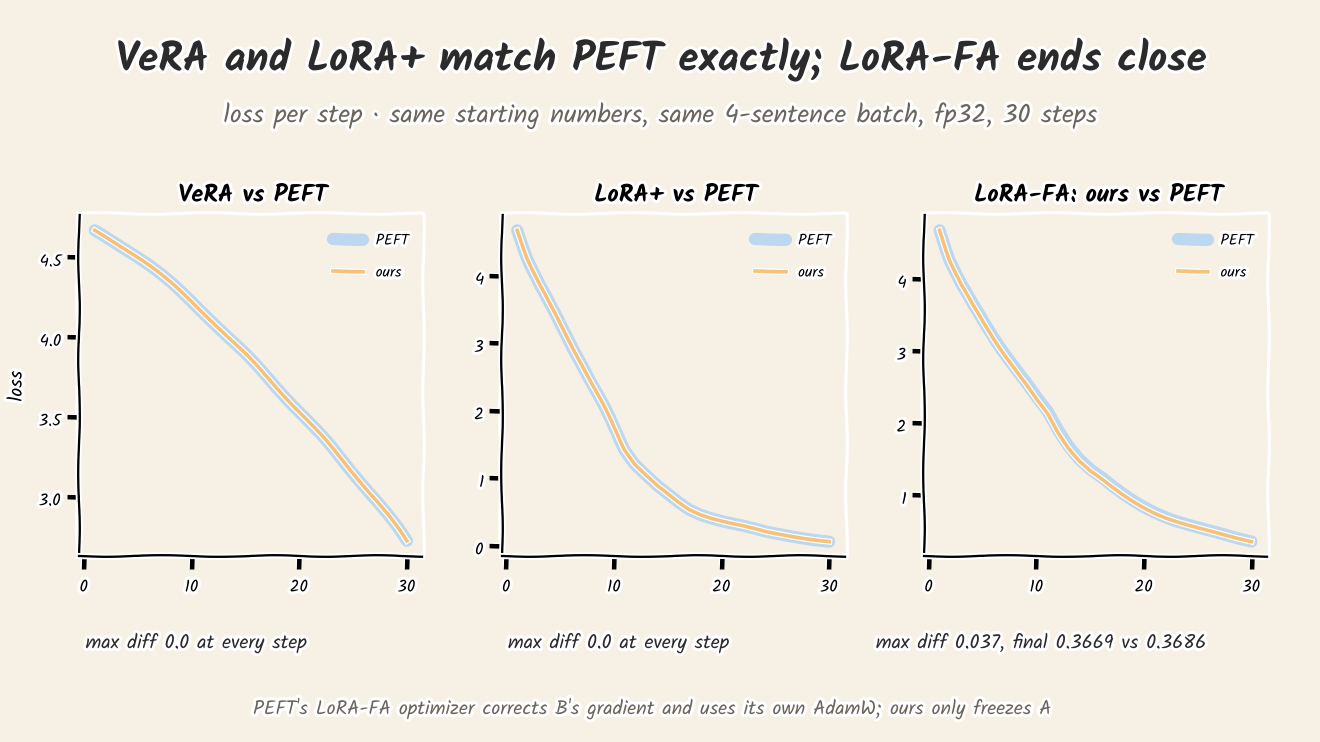
PEFT와 학습 결과가 같지 않았는데, 같지 않은 것이 맞습니다. PEFT의 create_lorafa_optimizer는 A를 얼리는 것에 그치지 않습니다. 얼린 A에 맞춰 B의 기울기를 보정하고, 자체 AdamW를 씁니다. 저희 코드는 A를 얼리고 보통의 torch.optim.AdamW를 씁니다. 저희는 두 결과가 어느 스텝에서든 1e-3보다 크게 벌어진다고 예측했습니다. 가장 크게 벌어진 차이는 0.037이었고, 마지막 loss는 저희 쪽이 0.3669, PEFT가 0.3686이었습니다. 30스텝 뒤에도 저희 쪽 A는 비트 하나 바뀌지 않았습니다.
PEFT optimizer가 저희와 다르게 하는 일은 세 가지입니다.
- B의 기울기를 보정합니다. A가 얼어 있으면 어댑터가 W에 더하는 변화는
B A꼴로만 움직일 수 있습니다. 그래서 전체 파인튜닝이었다면 W가 받았을 기울기와 가장 가까운 변화가 되도록 B의 기울기를 고칩니다. 식으로는 B의 기울기에(A Aᵀ)⁻¹을 곱하고(α/r)²로 나눕니다.A Aᵀ는 8×8 행렬이라 층마다 스텝마다 다시 계산해도 부담이 없습니다. - 이 보정을 bf16으로 계산합니다. GPU가 bf16을 지원하면 보정 곱셈을 bf16 autocast 안에서 하고, 결과를 다시 fp32로 돌립니다. 저희 비교는 fp32로 맞췄지만 이 부분만은 정밀도가 다릅니다.
- AdamW를 직접 구현했습니다. eps 기본값이 1e-6으로
torch.optim.AdamW의 1e-8과 다르고, eps를 더하는 위치도 다릅니다. 같은 기울기를 받아도 한 스텝에 움직이는 양이 조금 달라집니다.
0.037의 차이는 이 셋이 합쳐진 결과이고, 저희는 셋을 하나씩 떼어 재지 않았습니다. 현재 판 LoRA-FA 논문의 방법, 즉 PEFT optimizer가 구현한 방법을 쓰려면 PEFT의 optimizer를 쓰시면 됩니다. 메모리가 줄어드는 것은 A를 얼리는 데서 오고, 그건 두 구현이 똑같이 합니다. 보정에 드는 메모리는 층마다 8×8 행렬 몇 개라 셈으로는 무시할 만하지만, PEFT 쪽 메모리는 따로 재지 않았습니다.
LoRA+: B의 학습률을 키웁니다
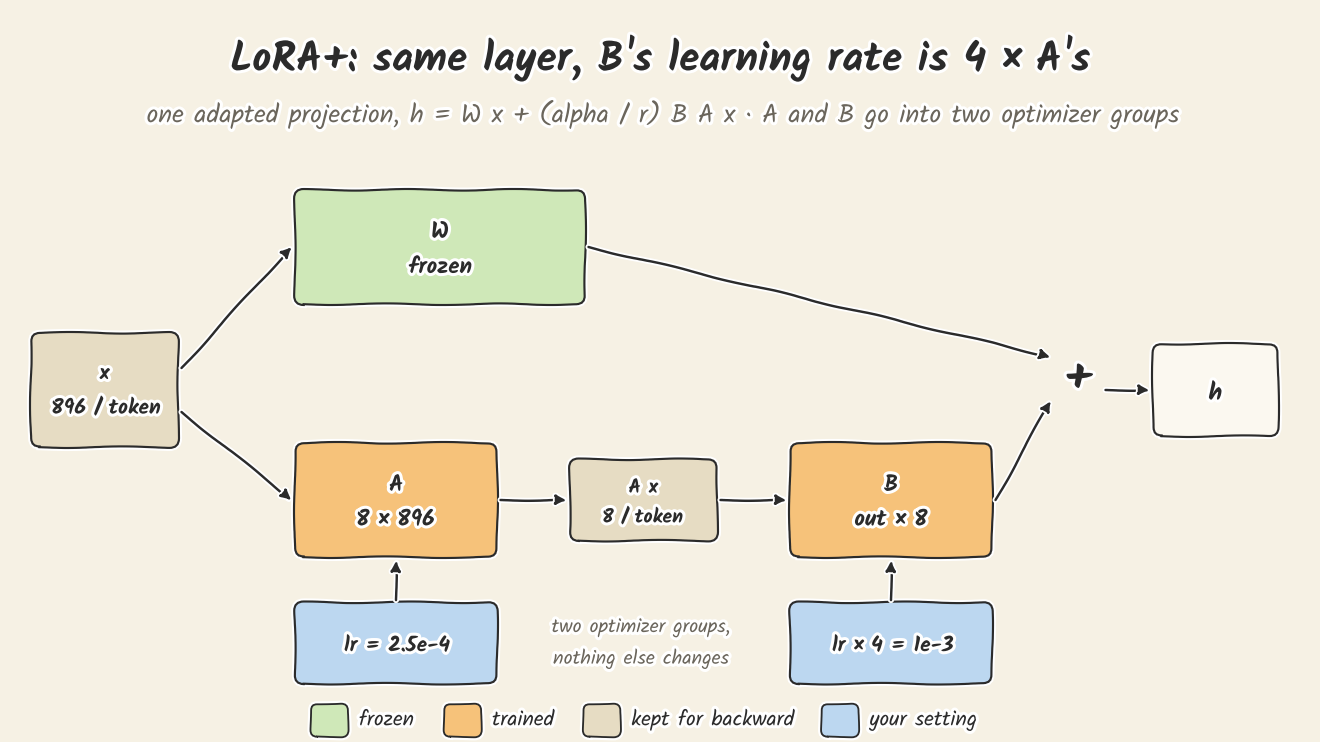
메모리를 줄일 수 없는 이유: LoRA와 같은 숫자를 학습하고 같은 값을 남깁니다. 바뀌는 것은 optimizer뿐입니다.
층은 손대지 않습니다. optimizer를 만들 때 파라미터 그룹을 두 개로 나눕니다.
def loraplus_optimizer(model, lr, ratio):
    layers = [m for m in model.modules() if isinstance(m, LoRALinear)]
    return torch.optim.AdamW([{"params": [m.A for m in layers], "lr": lr},
                              {"params": [m.B for m in layers], "lr": lr * ratio}], weight_decay=0.0)
A의 학습률은 2.5e-4, 비율은 4로 두었습니다. 그러면 B의 학습률이 1e-3이 되어, 3편의 3단계 'PEFT와 맞춰 보기'에서 LoRA에 준 학습률과 같아집니다.
PEFT의 create_loraplus_optimizer에 같은 학습률과 비율을 주면 파라미터 그룹을 네 개 만듭니다.
- A 그룹: A 행렬과, 아래 세 그룹에 들지 않는 나머지 학습 파라미터, 학습률 lr
- 임베딩 그룹: 임베딩 층에 붙인 LoRA, 학습률은 따로 정하며 기본값 1e-6
- B 그룹: B 행렬과 학습하는 벡터(1차원 파라미터), 학습률 lr × 비율
- weight decay를 안 거는 B 그룹: B 그룹에 들어갈 것 가운데 bias나 LayerNorm 파라미터, 학습률 lr × 비율
저희는 임베딩 층에 LoRA를 붙이지 않았고 bias나 LayerNorm을 학습하지도 않았으니, 임베딩 그룹과 마지막 그룹은 비어 있었습니다. 채워진 두 그룹은 저희 코드와 똑같았습니다. A 행렬 48개가 2.5e-4, B 행렬 48개가 1e-3입니다. 같은 A, B에서 출발해 30스텝을 학습시키자 모든 스텝에서 loss가 같았고, 차이는 0.0이었습니다.
실험이 끝난 뒤에 함정 하나를 찾았습니다. PEFT의 LoRA+ 함수는 weight_decay= 인자를 무시합니다. weight_decay=0.01을 넘겨도 모든 그룹이 0.0이었습니다. 이 함수는 bias와 LayerNorm 그룹은 늘 0으로 두고, 자기 인자인 loraplus_weight_decay 값 하나로 나머지 그룹의 weight decay를 정하고, 그 기본값이 0이기 때문입니다. loraplus_weight_decay=0.01을 넘기자 A와 B 그룹이 0.01이 됐습니다. 저희 실험은 weight decay를 0으로 두었으니 위의 비교 결과는 그대로입니다. 다만 평소 쓰던 인자 이름으로 weight decay를 주셨다면 optimizer의 그룹을 한 번 확인해 보세요.
VeRA: 나눠 쓰는 무작위 행렬과 학습하는 벡터 두 개
메모리가 오히려 늘어나는 이유: VeRA는 h = W x + b ⊙ (B (d ⊙ (A x)))를 계산합니다. A와 B는 무작위 값으로 얼려 두니 x는 남기지 않습니다. 대신 d의 기울기를 구하려면 A x를 남겨야 하는데, VeRA의 rank가 256이라 이것만 256개입니다. b의 기울기를 구하려면 B (d ⊙ A x)도 남겨야 하고, 이건 출력 수만큼입니다. q_proj는 256 + 896, v_proj는 256 + 128이라 층마다 토큰당 1,536개가 됩니다. LoRA는 912개였습니다.
A와 B는 어댑터를 붙이는 층 가운데 가장 큰 모양에 맞춰 한 번만 만들고, 층마다 필요한 만큼 잘라 씁니다. 시드로 만들기 때문에 VeRA 어댑터를 저장할 때는 시드와 벡터만 있으면 됩니다.
import torch.nn.functional as F

class VeRALinear(nn.Module):
    def __init__(self, base: nn.Linear, A, B, d_init=0.1):
        super().__init__()
        self.base, self.A, self.B = base, A, B        # plain tensors: shared, never trained
        for p in self.base.parameters():
            p.requires_grad_(False)
        w = base.weight
        self.d = nn.Parameter(torch.full((A.shape[0],), d_init, device=w.device, dtype=w.dtype))
        self.b = nn.Parameter(torch.zeros(base.out_features, device=w.device, dtype=w.dtype))

    def forward(self, x):
        A = self.A[:, : self.base.in_features]
        B = self.B[: self.base.out_features, :]
        return self.base(x) + self.b * F.linear(self.d * F.linear(x, A), B)


def add_vera(model, r=256, targets=("q_proj", "v_proj"), seed=0, d_init=0.1):
    for p in model.parameters():
        p.requires_grad_(False)
    found = [(module, t, getattr(module, t)) for module in list(model.modules()) for t in targets
             if isinstance(getattr(module, t, None), nn.Linear)]
    w = found[0][2].weight
    g = torch.Generator().manual_seed(seed)          # the seed is all you need to rebuild A and B
    A = torch.empty(r, max(c.in_features for _, _, c in found))
    B = torch.empty(max(c.out_features for _, _, c in found), r)
    nn.init.kaiming_uniform_(A, generator=g); nn.init.kaiming_uniform_(B, generator=g)
    A, B = A.to(w.device, w.dtype), B.to(w.device, w.dtype)
    for module, t, child in found:
        setattr(module, t, VeRALinear(child, A, B, d_init))
    return model
b는 LoRA의 B처럼 0으로 시작하므로, 학습 전 모델은 원래 모델과 같습니다. d는 0.1로 시작합니다. 이 시작값이 논문에서 왜 중요했는지는 2편에서 다뤘습니다.
학습하는 숫자는 24층 × ((256 + 896) + (256 + 128)) = 36,864개로, LoRA보다 93% 적습니다. PEFT의 VeraConfig(r=256, projection_prng_key=0)도 같은 수를 셉니다.
PEFT와 완전히 같았습니다. 같은 시드를 쓰면 PEFT와 같은 A, B가 나온다고 예측했고, 실제로 최대 차이가 0.0이었습니다. PEFT도 같은 방식으로, 그 시드를 넣은 CPU 생성기에서 A부터 만들기 때문입니다. 확인이 의미 있도록 b를 무작위 값으로 채운 상태에서 logits를 비교하자 차이가 0.0이었습니다. 이때 절댓값이 가장 큰 logits가 26.2였습니다. 학습률 4e-3으로 30스텝을 학습시켜도 loss가 4.670에서 2.722까지 모든 스텝에서 같았습니다.
같은 배치에서 LoRA는 30스텝 만에 0.009까지 내려갔습니다. VeRA는 그보다 훨씬 느립니다. 하지만 학습률이 다르고 학습하는 숫자도 훨씬 적으며, 이 배치로 하는 일은 네 문장을 외우는 것뿐입니다. 그래서 어느 쪽이 파인튜닝을 더 잘하는지는 이 결과로 말할 수 없습니다.
Delta-LoRA: W도 움직입니다
메모리가 달라지지 않을 이유: A와 B는 LoRA와 똑같이 학습하고, W에는 여전히 기울기도 Adam 상태도 없습니다. 스텝이 끝날 때마다 그 스텝에서 B A가 바뀐 만큼 W를 옮길 뿐입니다. 식으로는 W += λ · (α/r) · (바뀐 뒤 B A − 바뀌기 전 B A)입니다. 이때 B A를 잠깐 들고 있어야 하는데, bf16으로 전체 층을 합쳐 약 44MB이고, backward가 활성화를 이미 비운 뒤입니다.
Delta-LoRA는 PEFT에 없습니다. 그래서 optimizer의 step을 감싸서 만듭니다.
class DeltaLoRA:
    def __init__(self, model, optimizer, K, lam):
        self.layers = [m for m in model.modules() if isinstance(m, LoRALinear)]
        self.opt, self.K, self.lam, self.t = optimizer, K, lam, 0

    @torch.no_grad()
    def step(self):
        self.t += 1
        if self.t <= self.K:              # the first K steps are plain LoRA
            self.opt.step()
            return
        before = [m.B @ m.A for m in self.layers]
        self.opt.step()
        for m, ba in zip(self.layers, before):
m.base.weight += self.lam * m.scale * (m.B @ m.A - ba)opt.step()을 부르던 자리에서 delta.step()을 부르면 됩니다. Delta-LoRA 논문은 두 행렬의 이름을 반대로 붙입니다. 이 글에서는 LoRA의 이름을 그대로 써서, 0으로 시작하는 쪽이 B입니다.
K는 10, λ는 2로 두었습니다. λ는 논문의 data-to-text 실험 설정을 따랐습니다. 출발점은 보통 LoRA 실험과 같은 A, B입니다.
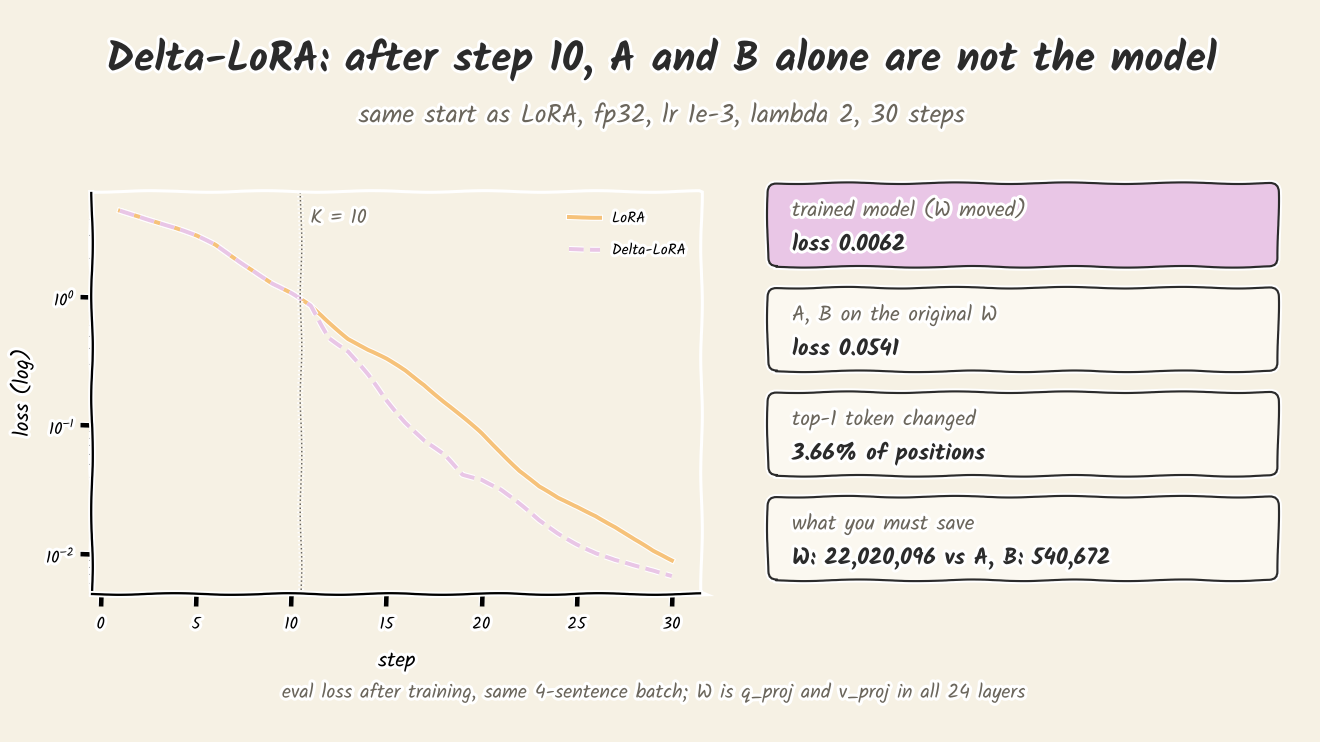
확인 방법은 갱신 규칙 그 자체입니다. K 이후 매 스텝 B A의 변화량을 더했다면, 그 변화량들을 다 더한 값은 처음과 끝의 차이와 같아야 합니다. 그러니 30스텝 뒤의 W는 원래 W에 λ · (α/r) · (30스텝의 B A − 10스텝의 B A)를 더한 값이어야 합니다. 실제로 그랬고, 가장 큰 오차가 2.8e-7이었습니다. W는 원소 하나가 최대 0.019 움직였습니다.
loss는 처음 10스텝 동안 보통 LoRA와 똑같았고(그래야 맞습니다), 그 뒤로는 더 빨리 내려갔습니다. 30스텝에서 0.0068 대 0.0089였습니다.
달라지는 것은 저장해야 할 파일입니다. LoRA는 A와 B만 저장했다가 원래 모델에 얹으면 됩니다. Delta-LoRA는 그렇게 해서는 학습한 모델이 돌아오지 않습니다. 학습을 마친 모델의 loss를 먼저 재고, 그 A와 B만 원래 W에 얹어 다시 쟀습니다. loss가 0.0062에서 0.0541로 올랐고, logits가 최대 14.7 달라졌으며, 위치의 3.66%에서 1등 토큰이 바뀌었습니다. 학습한 모델을 그대로 남기려면 어댑터를 붙인 projection마다 W를 저장해야 합니다. 숫자로 22,020,096개이고, A와 B의 540,672개보다 약 41배 많습니다.
메모리를 재 보니
다섯 가지 모두 bf16, 배치 4에서 3편의 루프로 세 번째 스텝의 피크 메모리를 쟀습니다.
| bf16, 배치 4 | 길이 1,024 | LoRA 대비 | 길이 2,048 | LoRA 대비 |
|---|---|---|---|---|
| LoRA | 11.778GiB | 22.609GiB | ||
| LoRA-FA | 11.613GiB | −0.165 | 22.280GiB | −0.329 |
| LoRA+ | 11.778GiB | 0 | 22.609GiB | 0 |
| VeRA | 11.910GiB | +0.132 | 22.836GiB | +0.227 |
| Delta-LoRA (K = 0) | 11.778GiB | 0 | 22.609GiB | 0 |
Delta-LoRA는 첫 스텝부터 W가 움직이도록 K를 0으로 두었습니다. LoRA+와 Delta-LoRA는 두 길이 모두 피크가 LoRA와 정확히 같았습니다. 44MB짜리 B A는 피크에 닿지 않았다는 뜻입니다.
LoRA-FA와 VeRA는 그 차이가 셈으로 낸 값과 가까웠습니다. 피크의 차이는 forward가 끝난 시점에 들고 있던 메모리의 차이와 정확히 같았습니다. 남겨 둔 값이 바로 그 시점에 쌓여 있기 때문입니다.
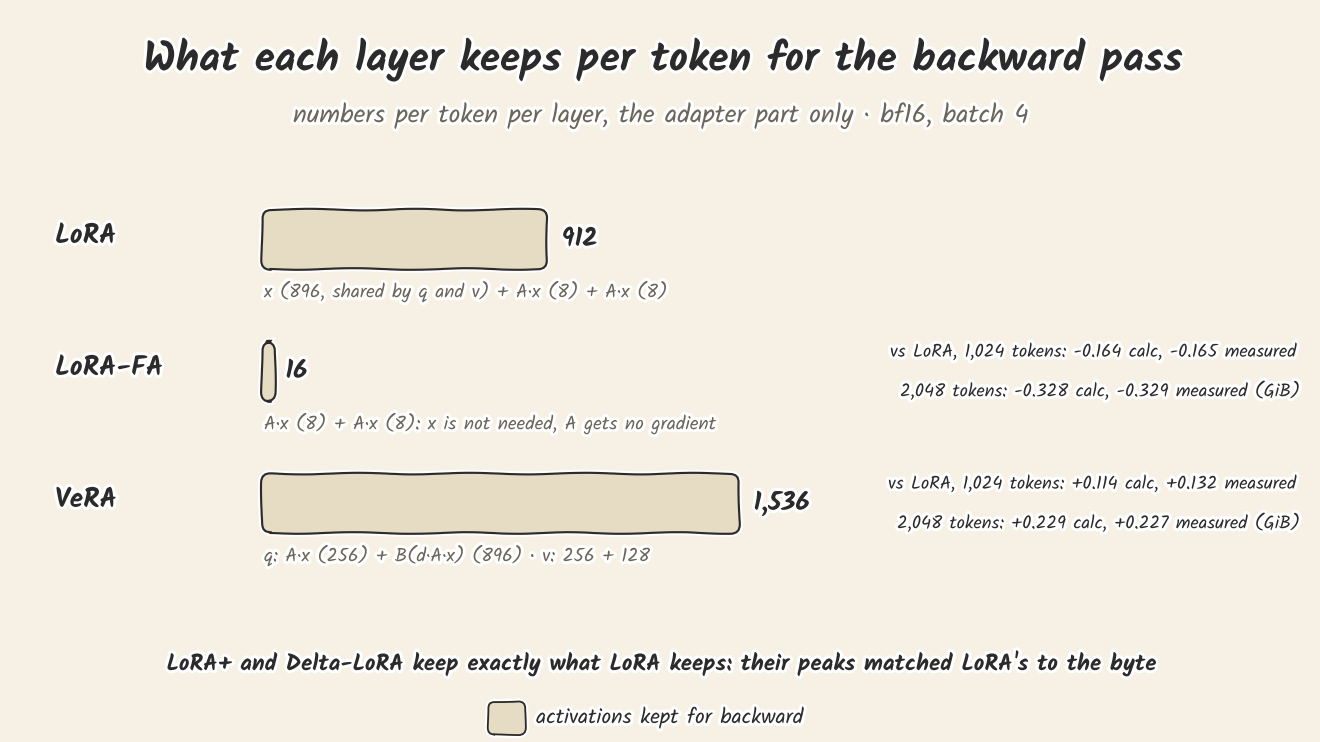
계산은 남기는 숫자의 차이에 시퀀스 4개, 길이, 2바이트, 24층을 곱한 값입니다. LoRA-FA는 두 길이 모두 측정값과 1% 안으로 맞았습니다. VeRA는 길이 2,048에서 1% 안으로 맞았지만, 1,024에서는 측정값이 계산보다 15% 컸습니다. 이 0.017GiB가 어디서 왔는지는 아직 찾지 못했습니다. (사후 추가) 나머지 1%는 한쪽만 학습하는 숫자의 Adam 상태입니다. LoRA-FA는 A의 Adam 상태(bf16으로 1,376,256바이트)를 더하면 두 길이 모두 계산이 측정값과 바이트까지 같습니다. VeRA는 길이 2,048에서 53,248바이트가 남습니다. 길이 1,024의 VeRA는 이것으로도 설명되지 않습니다.
A를 얼려서 줄어든 양은 LoRA 피크의 1.4%(길이 1,024)와 1.5%(길이 2,048)였습니다. 이렇게 작은 것은 이 모델에서 LoRA 어댑터가 피크 메모리의 작은 부분이기 때문입니다. 3편에서 봤듯이 피크의 대부분은 24층의 다른 활성화와 logits입니다. LoRA-FA로 줄어드는 양은 어댑터를 붙이는 projection의 수가 아니라 서로 다른 입력의 수와 그 입력의 크기를 따라 커집니다. k_proj는 q, v와 같은 x를 받으니 더 붙여도 줄어드는 양은 그대로입니다. o_proj, MLP 입력(gate_proj와 up_proj가 같이 받음), down_proj는 각자 다른 입력을 받습니다. 이번에는 0.5B 모델의 projection 두 개에만 붙였습니다.
예측 채점
아래 예측은 위의 코드와 함께, 아무것도 돌리기 전에 커밋해 두었습니다.
| # | 예측 | 결과 | |
|---|---|---|---|
| Q1 | 학습하는 숫자가 저희 = PEFT = 계산식: LoRA 540,672, LoRA-FA 196,608, VeRA 36,864 | 세 변형 모두 세 값이 같음 | 맞음 |
| Q2a | VeRA: 같은 시드면 PEFT와 같은 A, B | 최대 차이 0.0 | 맞음 |
| Q2b | VeRA: logits 차이 1e-5 이하 | 0.0 | 맞음 |
| Q2c | VeRA: 30스텝 모두 loss 차이 1e-4 이하 | 모든 스텝 0.0 | 맞음 |
| Q3 | LoRA+: 스텝마다 loss 차이 1e-4 이하 | 모든 스텝 0.0 | 맞음 |
| Q4 | LoRA-FA: 저희와 PEFT가 어느 스텝에서든 1e-3 넘게 벌어지고, 저희 A는 그대로 | 0.037, A 그대로 | 맞음 |
| Q5a | Delta-LoRA: W가 움직인 양 = λ·(α/r)·(30스텝 B A − 10스텝 B A), 오차 1e-5 이하 | 2.8e-7 | 맞음 |
| Q5b | Delta-LoRA: A, B만 원래 W에 얹으면 학습한 모델과 logits가 1.0 넘게 다름 | 14.7 | 맞음 |
| Q6 | LoRA+ 피크가 LoRA와 0.01GiB 안 | 같음 | 맞음 |
| Q7 | Delta-LoRA 피크가 LoRA와 0.05GiB 안 | 같음 | 맞음 |
| Q8 | forward 직후 LoRA-FA가 들고 있는 메모리가 길이 1,024에서 0.08-0.25GiB, 2,048에서 0.16-0.49GiB 적음 | 0.165, 0.329 | 맞음 |
| Q9 | LoRA-FA가 줄이는 양이 LoRA 피크의 3% 미만 | 1.40%, 1.46% | 맞음 |
| Q10 | forward 직후 VeRA가 들고 있는 메모리가 1,024에서 0.06-0.17GiB, 2,048에서 0.11-0.34GiB 많음 | 0.132, 0.227 | 맞음 |
Q8과 Q10의 범위는 계산값의 0.5배에서 1.5배로 잡았습니다. 계산이 꽤 빗나가도 맞음이 나올 만큼 넓은 범위입니다. 더 엄격한 시험은 앞에서 본 비교입니다. 네 칸 중 셋은 1% 안으로 맞았고, 나머지 하나는 15% 벗어났습니다.
확인하지 않은 것
- 작은 모델 하나, projection 두 개, 배치 하나입니다. 모두 Qwen2.5-0.5B의
q_proj와v_proj에서 잰 값입니다. 학습 비교에는 3편의 네 문장을 외우는 배치를 썼습니다. 그래서 두 구현이 같은 계산을 한다는 것까지만 보여 주고, 어느 변형이 파인튜닝을 더 잘하는지는 보여 주지 않습니다. - 학습률은 저희가 정했습니다. VeRA 4e-3, LoRA+ 2.5e-4와 비율 4, Delta-LoRA의 K = 10은 이 확인용으로 정한 값이고 튜닝하지 않았습니다.
- 저희 LoRA-FA를 논문의 방법과 비교하지는 않았습니다. PEFT와만 비교했고, 그 둘은 원래 다르게 동작합니다.
- 메모리는 PyTorch가 할당한 피크 메모리입니다. 순수 bf16에서 두 길이만 쟀고,
nvidia-smi에 보이는 값과는 다릅니다. - Delta-LoRA는 fp32에서만 확인했습니다. bf16 가중치에서는 작은 W 갱신이 반올림으로 사라질 수 있습니다. 3편에서 병합할 때 본 것과 같은 문제입니다.
- VeRA의 A와 B는 일반 속성이라
.to()를 따라가지 않습니다.add_vera를 부르기 전에 모델의 device와 dtype을 먼저 맞춰 두세요. - 예측 뒤에 추가한 것: LoRA+ weight decay 확인, 나머지 1%를 Adam 상태로 설명한 분석, 그리고 실행이 끝난 뒤 기록한 버전 정보입니다.
다음 글
5편에서는 이 변형들을 0.5B 모델에서 꺼내, 실제로 학습을 돌릴 때 궁금한 질문으로 가져갑니다. 8, 12, 16, 24GB 카드에서 LoRA, LoRA-FA, VeRA로 몇 B 모델까지 파인튜닝할 수 있을까요? 아래 뉴스레터를 구독하시면 나왔을 때 보내 드립니다.