내 GPU에는 어떤 로컬 코딩 모델을 써야 할까? 8·12·16·24GB 비교(Python 과제 4개): Qwen3.5-9B, gpt-oss-20b, Flint, Qwen3.5-27B
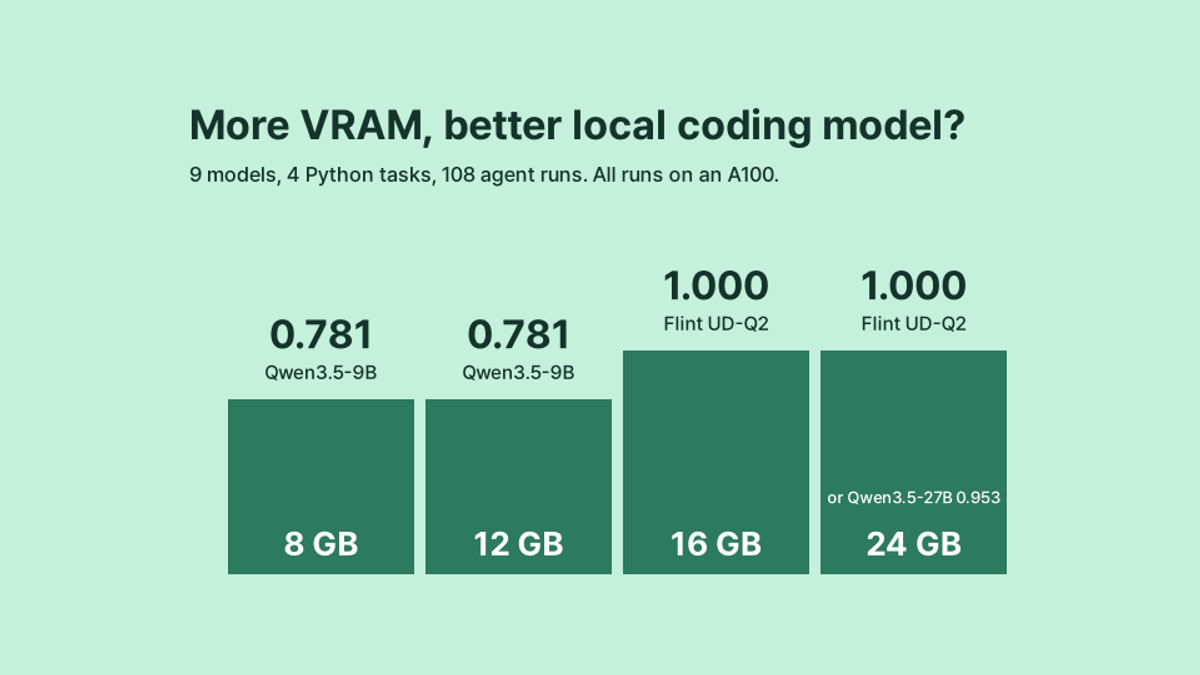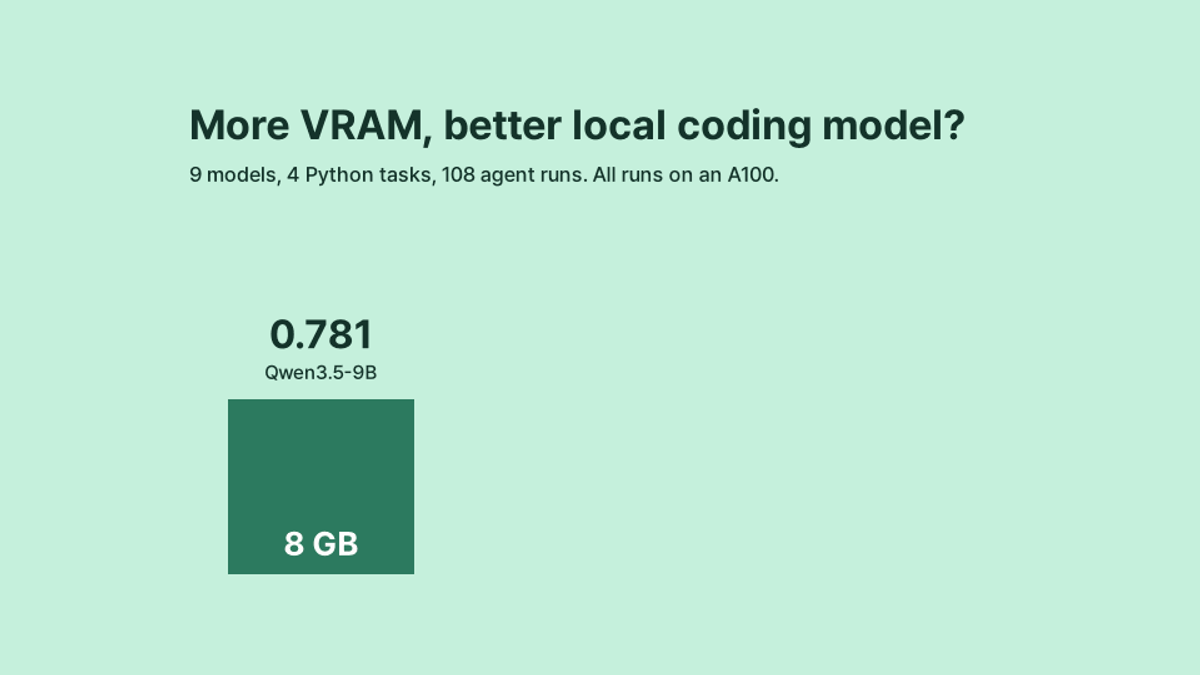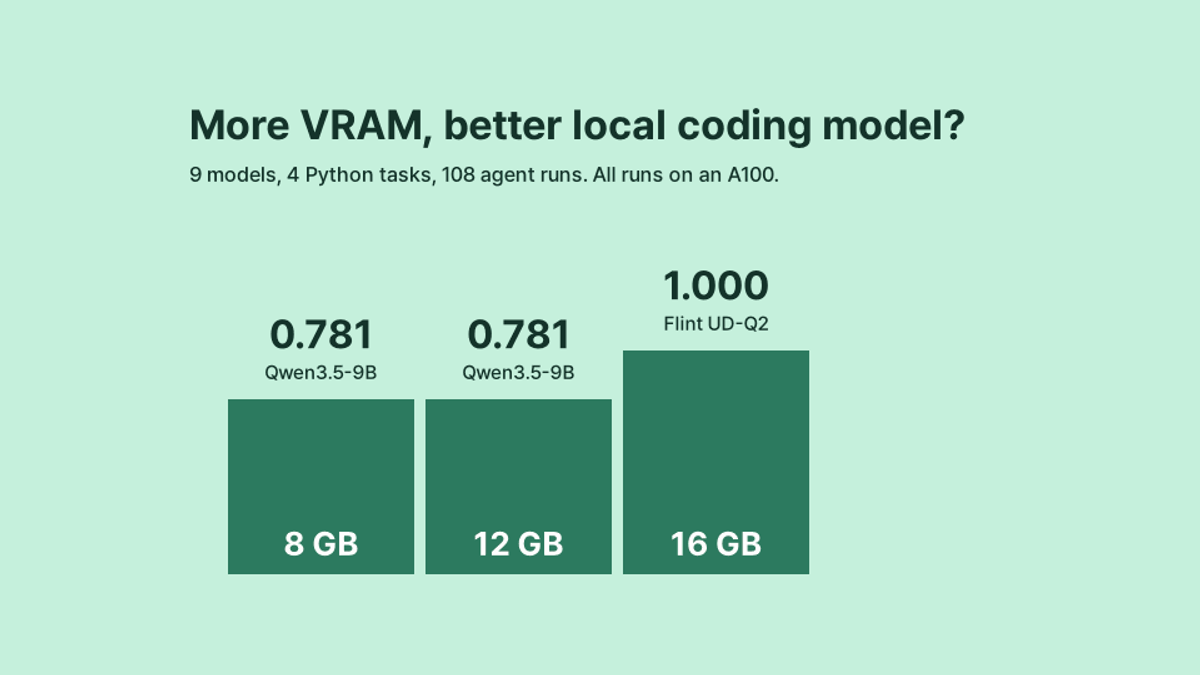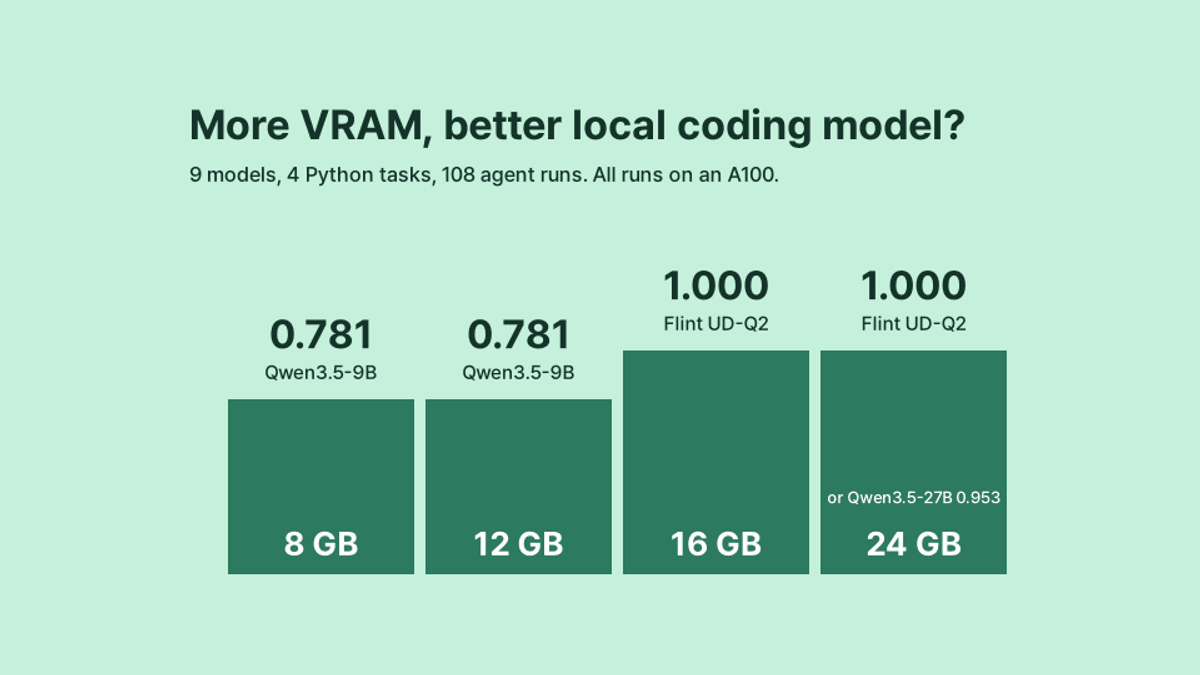
Python 과제 4개로 비교하면 8·12GB는 Qwen3.5-9B, 16GB는 Flint이고(에이전트를 이 모델로 만들었다는 단서가 붙습니다), 24GB는 Flint와 Qwen3.5-27B가 구분되지 않았습니다. A100에서 측정해 RTX 4060, 3060 12GB, 4070 Ti Super, 4090과 같은 용량에 맞춰 비교했습니다.
내 GPU에는 어떤 로컬 코딩 모델을 써야 할까? 8·12·16·24GB 비교(Python 과제 4개): Qwen3.5-9B, gpt-oss-20b, Flint, Qwen3.5-27B
8, 12, 16, 24GB 카드에서 코딩 에이전트를 돌린다면 어떤 로컬 모델을 써야 할까요? 모델 9개에 코딩 과제 4개를 3번씩, 모두 108번 돌려 확인했습니다. 점수는 모델에게 보여 주지 않은 테스트를 코드가 얼마나 통과하는지로 매겼습니다. 전부 통과하면 1.0, 하나도 통과하지 못하면 0입니다. 일부 테스트는 원래 코드로도 통과하므로, 아무것도 고치지 않아도 0.115는 나옵니다. 실행과 메모리 측정은 모두 A100에서 했고, 각 카드의 용량을 가정해 비교했습니다. 8GB는 RTX 4060, 12GB는 RTX 3060 12GB, 16GB는 RTX 4070 Ti Super, 24GB는 RTX 4090과 같은 용량입니다.
결론
아래 답은 작은 Python 과제 4개, 컨텍스트 16K, 전부 GPU에 올린 경우에 대한 것입니다. Flint를 뺀 모델은 양자화 Q4_K_M만 시험했습니다.
- 8GB와 12GB: Qwen3.5-9B Q4_K_M을 쓰면 됩니다. 8GB에서 12GB로 올려도 이 모델보다 뚜렷하게 나은 모델은 없었습니다. 12GB가 있어야 들어가는 Qwen3-14B는 0.485였습니다. gpt-oss-20b(0.750)는 3번씩 돈 이번 실행으로는 9B와 구분되지 않고, 메모리도 46MiB만 남습니다. 12GB에 들어갈 9B의 더 높은 양자화는 재지 않았습니다.
- 16GB: Flint UD-Q2_K_XL이 1.000으로 맨 위입니다. 다만 저희 에이전트와 과제 하나를 이 모델로 만들었으니 다른 모델과 똑같은 조건은 아닙니다. Flint를 빼면 9B와 gpt-oss-20b가 구분되지 않고, 16GB에는 둘 다 넉넉히 들어갑니다.
- 24GB: Flint와 Qwen3.5-27B(0.953) 중 어느 쪽이든 됩니다. 이번 과제로는 둘의 우열을 가릴 수 없었습니다. Flint에는 16GB와 같은 단서가 붙으므로, 그 단서 없이 고르려면 27B입니다.
- Qwen3-8B는 이 에이전트에 쓰지 마십시오. 8GB에 들어가더라도 코드 수정 179번 중 128번이 실패했습니다.
카드별로 정리하면 이렇습니다. 남는 메모리는 카드 용량에서 데스크톱 몫 512MiB와 여유 16MiB를 뺀 예산에서, 에이전트 실행 중 최대 사용량을 뺀 값입니다.
| 카드 예산 | 시험한 모델 중 맨 위 | 점수(숨긴 테스트) | 최대 사용량 기준 남는 메모리 |
|---|---|---|---|
| 8GB | Qwen3.5-9B | 0.781 | 1,612MiB |
| 12GB | Qwen3.5-9B, gpt-oss-20b(0.750)와 동률 | 0.781 | 5,708MiB(gpt-oss-20b는 46MiB) |
| 16GB | Flint UD-Q2_K_XL | 1.000 | 1,914MiB |
| 24GB | Flint UD-Q2_K_XL, Qwen3.5-27B(0.953)와는 구분되지 않음 | 1.000 | 10,106MiB(27B는 6,932MiB) |
모델이 스스로 멈추고도 점수가 0.5 아래였던 11번은 모두 Qwen3-8B와 Qwen3-14B였습니다. 다른 모델을 쓰더라도 바뀐 코드는 직접 확인하는 편이 안전합니다.
어떻게 시험했나
모델은 llama-server(build 1137)에서 다음 명령으로, 전부 GPU에 올려 돌렸습니다.
llama-server -m MODEL.gguf -c 16384 -ngl 99 -fa on --parallel 1 --jinja에이전트는 로컬 에이전트 연재 3편의 agent.py를 그대로 썼습니다. temperature는 0.6, 모델 턴 제한은 30번, 시간 제한은 30분입니다. 권한 질문에는 모두 yes로 답했고, 판단 모델은 함께 띄우지 않았습니다. 컨텍스트는 모든 모델에 16K로 같게 주었습니다. 그래야 점수 차이가 컨텍스트가 아니라 모델 차이로 읽힙니다.
과제는 작은 Python 프로젝트 네 개입니다. 과제마다 모델이 볼 수 있는 테스트와 숨긴 테스트가 따로 있습니다.
- T1: 할 일 앱에 마감일 추가(숨긴 테스트 6개). 보이는 테스트는 처음부터 통과합니다
- T2: traceback이 엉뚱한 곳을 가리키는 버그 고치기(8개)
- T3: 파일 두 개에 걸쳐 재고 예약 기능 추가. 보이는 테스트는 손대기 전부터 통과합니다(8개)
- T4: 명세를 보고 버전 번호 파서 작성(10개)
실행 한 번의 점수는 실행이 끝났을 때 파일 상태로 숨긴 테스트를 돌려 통과한 비율입니다. 모델 점수는 12번 실행의 평균입니다.
108번 중 4번은 끝났을 때 코드를 불러올 수 없어 0점으로 셌습니다(Qwen3-8B 2번, Qwen3-14B 1번, gpt-oss-20b 1번, 모두 30턴 제한에 걸린 실행). Qwen3-14B의 한 번은 Python 3.12부터 허용되는 문법 때문이었고, 채점은 3.11.4로 했습니다. 나머지 세 번은 원인을 확인하지 않았습니다.
어떤 카드에 무엇이 들어가나
메모리는 모델을 띄운 뒤 nvidia-smi에서 프로세스 사용량을 읽고, 에이전트가 도는 동안의 최댓값도 기록했습니다. 카드 용량은 1GB=1,024MiB로 계산했습니다. 8GB 카드는 8,192MiB이고, 데스크톱 몫과 여유를 빼면 예산은 7,664MiB입니다.
아래 그림은 가로줄이 모델, 세로줄이 카드 예산입니다. 칸마다 "no" 또는 에이전트 최대 사용량 기준으로 남는 MiB를 적었습니다.
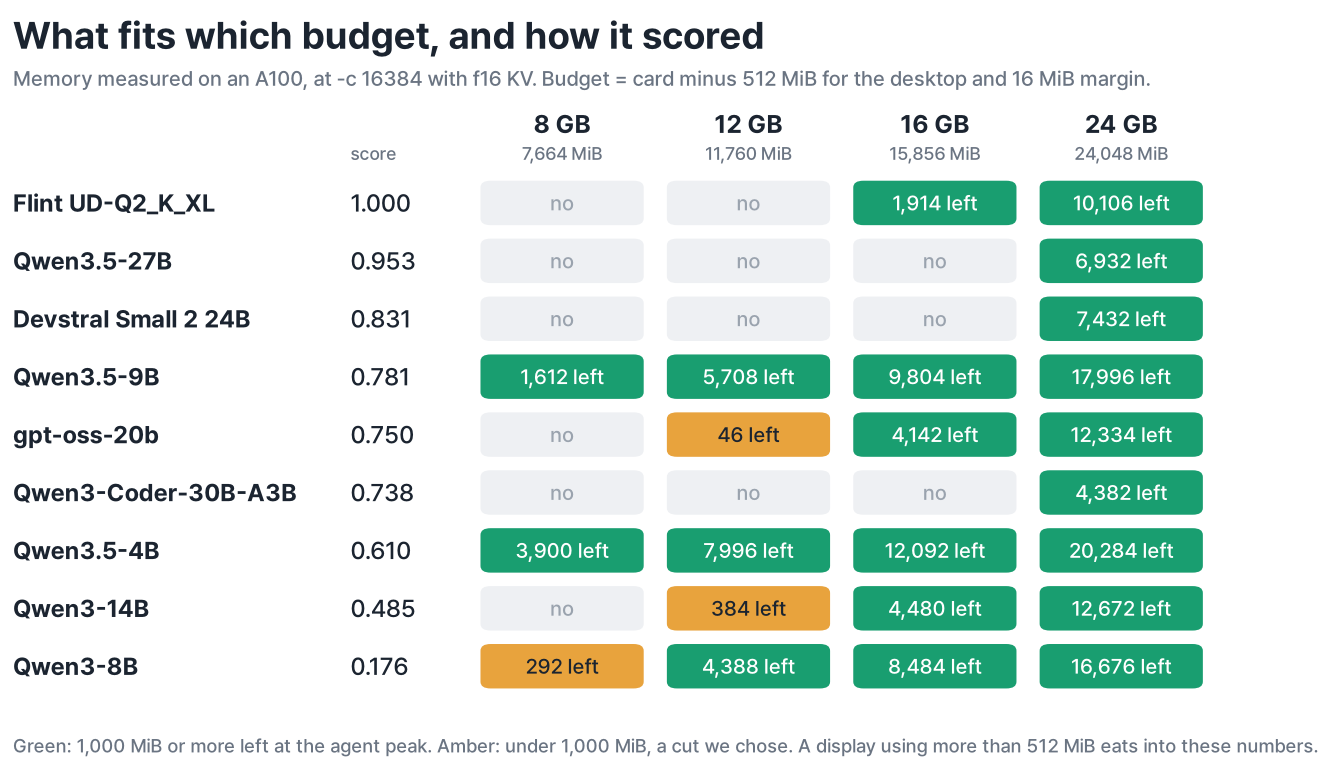
호박색 칸은 들어간다고 단정하지 말아 주십시오. 1,000MiB라는 선은 저희가 임의로 정했습니다. 데스크톱이 512MiB보다 많이 쓸 수 있고, 이 GPU 연재 1편에서 어느 로그에도 나오지 않던 약 480MiB도(CUDA 몫으로 보이지만 직접 재지는 않았습니다) 다른 카드에서는 달라질 수 있습니다.
이번 예산은 그 글의 예산보다 넉넉하기도 합니다. 그 글은 8GB 카드를 8×10⁹바이트로 세고 512MiB를 빼 7,117MiB로 잡았습니다. 그 기준을 쓰면 호박색 세 칸이 정확히 빠집니다. 8GB의 Qwen3-8B, 12GB의 Qwen3-14B와 gpt-oss-20b입니다. 다만 세 모델 모두 맨 위가 아니어서 카드별 1위는 바뀌지 않습니다. 직접 쓰는 카드의 숫자는 nvidia-smi --query-gpu=memory.free --format=csv로 확인할 수 있습니다.
16GB 예산을 조금 넘은 모델이 둘 있습니다. 최대 사용량 기준으로 Devstral Small 2 24B는 760MiB, Qwen3.5-27B는 1,260MiB 초과입니다. Devstral은 8비트 KV 캐시(--cache-type-k q8_0 --cache-type-v q8_0)로 띄우면 띄운 직후 기준 15,394MiB까지 줄어듭니다. 이번 예산에서도 462MiB만 남고, 위의 더 엄격한 기준에는 들어가지 않습니다. 그 설정으로는 에이전트를 돌리지 않아 16GB 순위에 넣지 않았습니다.
점수
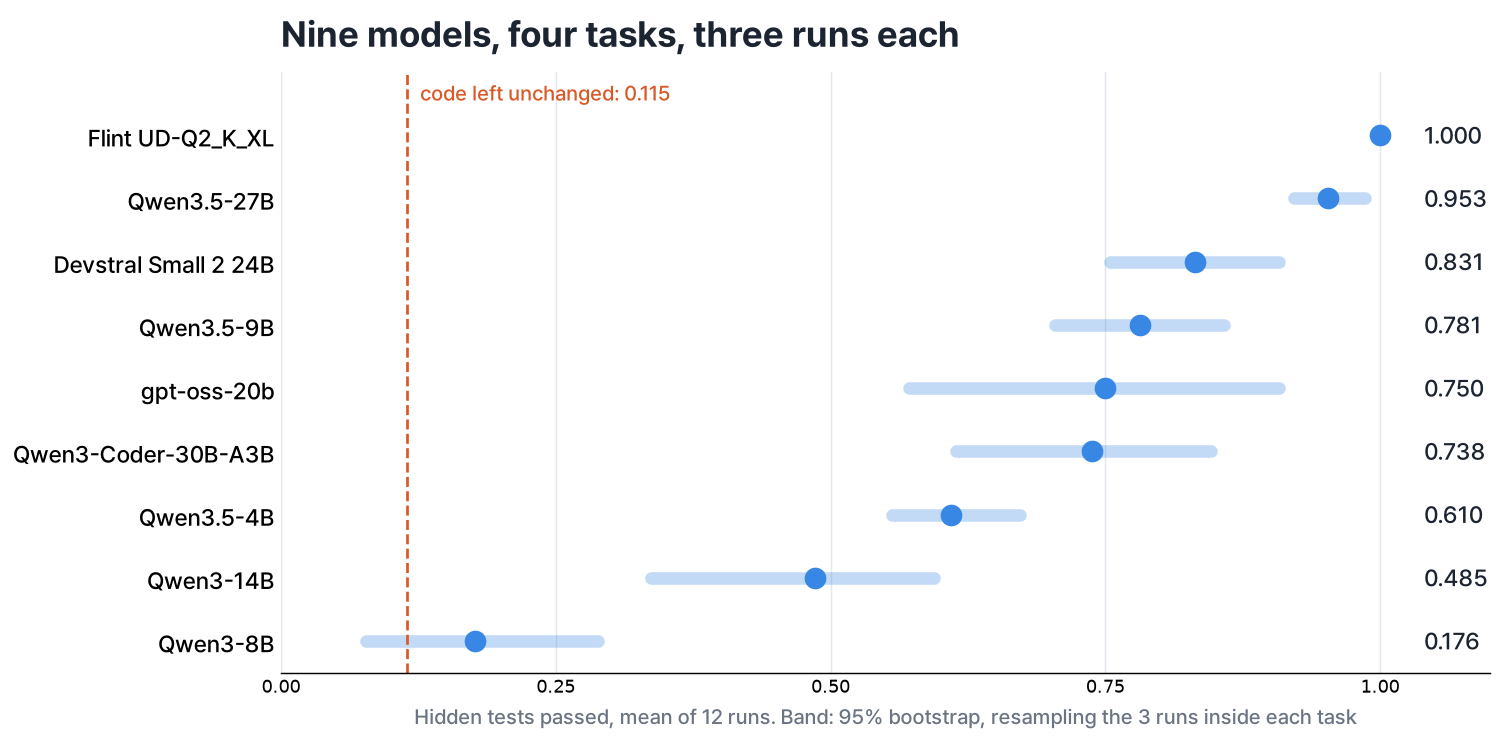
T1부터 T4는 과제별 점수이고, T1 제외는 Flint로 만든 과제 T1을 뺀 점수입니다.
| 모델 | 점수 | T1 | T2 | T3 | T4 | T1 제외 | A100 디코드 tok/s |
|---|---|---|---|---|---|---|---|
| Flint UD-Q2_K_XL | 1.000 | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 108 |
| Qwen3.5-27B | 0.953 | 0.94 | 1.00 | 1.00 | 0.87 | 0.956 | 47 |
| Devstral Small 2 24B | 0.831 | 0.83 | 0.92 | 0.88 | 0.70 | 0.831 | 55 |
| Qwen3.5-9B | 0.781 | 0.83 | 0.92 | 0.88 | 0.50 | 0.764 | 125 |
| gpt-oss-20b | 0.750 | 0.67 | 0.92 | 0.92 | 0.50 | 0.778 | 156 |
| Qwen3-Coder-30B-A3B | 0.738 | 0.67 | 0.92 | 1.00 | 0.37 | 0.761 | 156 |
| Qwen3.5-4B | 0.610 | 0.89 | 0.75 | 0.50 | 0.30 | 0.517 | 156 |
| Qwen3-14B | 0.485 | 0.33 | 0.75 | 0.62 | 0.23 | 0.536 | 82 |
| Qwen3-8B | 0.176 | 0.22 | 0.29 | 0.12 | 0.07 | 0.161 | 128 |
속도는 다른 작업과 함께 쓰는 A100에서 모델별 실행의 중앙값입니다. 여러분 카드에서 나올 속도가 아닙니다.
과제마다 3번은 적은 횟수입니다. 그래서 과제 안에서 실행을 다시 뽑는 일을 2만 번 반복해, 한 모델이 다른 모델 위에 머무는 비율을 봤습니다.
- 뚜렷하게 갈린 쌍: 9B와 4B, Flint와 9B, Flint와 gpt-oss-20b, 27B와 9B입니다. 앞쪽 모델이 거의 언제나 위였습니다.
- 동률로 볼 쌍: 9B가 gpt-oss-20b 위에 머문 비율은 61%뿐입니다. T1을 빼면 둘의 순서가 뒤집힙니다.
- 판단할 수 없는 쌍: Flint와 27B입니다. Flint가 전부 통과해서 다시 뽑아도 점수가 움직이지 않고, 실행 결과의 모델 이름을 과제 안에서 섞어 봐도 이만한 차이가 10% 나옵니다(단측 순열 검정 p = 0.10). 3번씩 돌린 이 데이터로는 이보다 작은 값이 나올 수 없습니다. 이 과제로는 점수가 높은 모델끼리 더 가려낼 수 없었습니다.
Flint 줄에는 따로 주의가 필요합니다. 저희는 로컬 에이전트 연재에서 T1과 agent.py를 Flint로 만들었습니다. 처음부터 다른 모델과 같은 조건이 아니었고, 그래서 참고용으로 넣는다고 미리 적어 두었습니다. 채팅 템플릿이 턴 사이에 reasoning을 보존한다고 서버 로그에 찍힌 모델도 Flint뿐입니다. 이것이 점수에 어떤 영향을 주는지는 재지 않았습니다. 이 글의 "Flint"는 언제나 UD-Q2_K_XL 파일 하나를 가리킵니다. Flint의 Q4 결과는 없고, 16GB에 들어갈 만한 27B의 낮은 양자화도 재지 않았습니다.
가장 어려운 과제는 명세를 보고 파서를 쓰는 T4로, 평균이 0.504였습니다. 저희 예상은 T3이었습니다.
Qwen3-8B에 무슨 일이 있었나
저희는 실행 전에 모델마다 점수를 예상해 적어 두었습니다. 8GB 카드에 간신히 들어가는 이전 세대 모델 Qwen3-8B는 0.45, 즉 테스트를 절반 가까이 통과한다고 봤습니다. 실제로는 0.176으로, 아무것도 고치지 않았을 때의 0.115와 별 차이가 없었습니다.
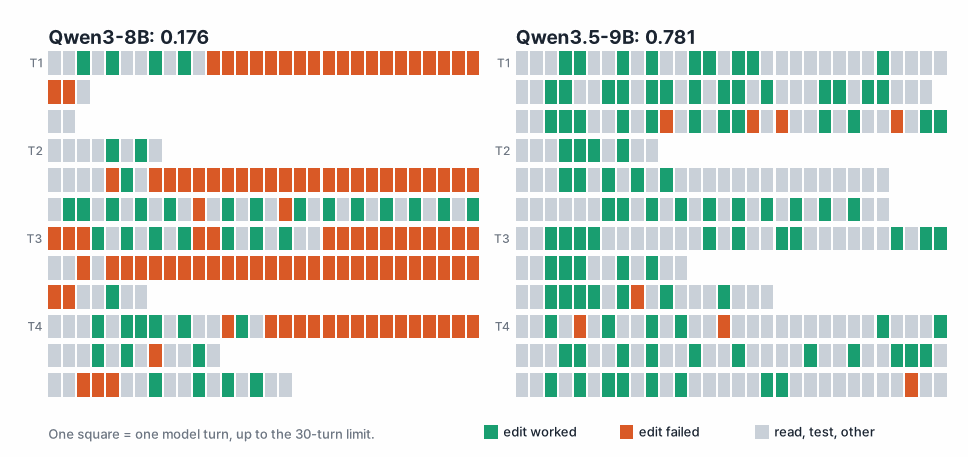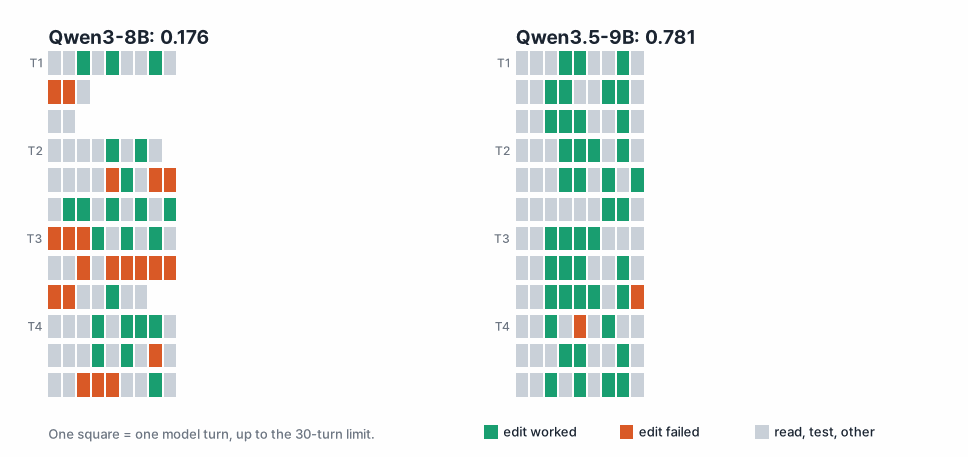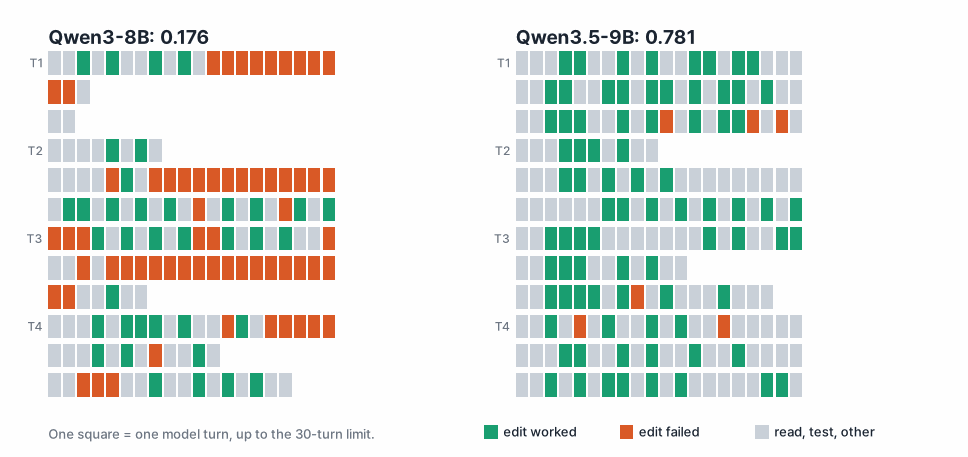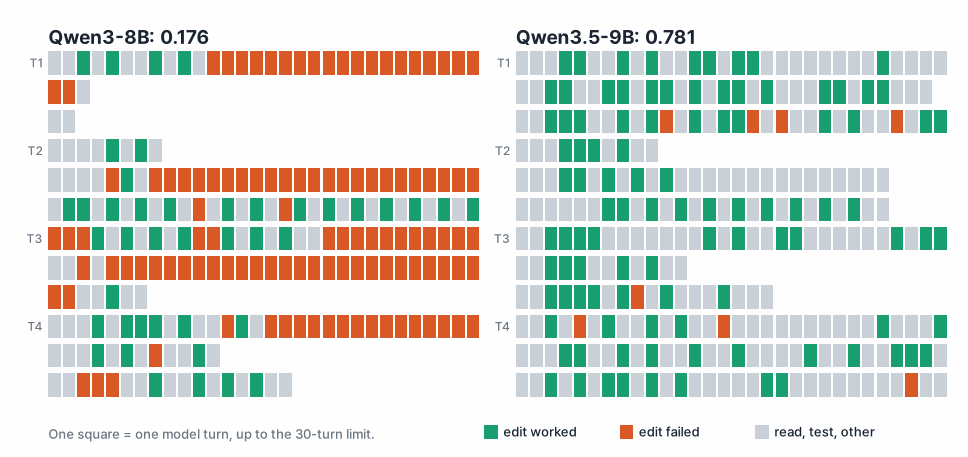
코드를 고치려는 시도 대부분이 실패했고, 그 횟수도 다른 모델보다 훨씬 많았습니다. 어떤 실행에서는 27번 연속으로 실패했습니다.
아래 그림에서 네모 하나는 모델의 턴 하나이고, 가로줄 하나가 실행 한 번입니다.
| 모델 | 수정 횟수 | 실패 | 최장 연속 실패 | 5번 이상 연속 실패한 실행 |
|---|---|---|---|---|
| Qwen3-8B | 179 | 128 | 27 | 12번 중 7번 |
| gpt-oss-20b | 144 | 38 | 13 | 12번 중 3번 |
| Devstral Small 2 24B | 124 | 16 | 6 | 12번 중 1번 |
| Qwen3.5-9B | 110 | 8 | 2 | 0번 |
수정 횟수에는 write_file도 포함합니다. 한 턴에 실패한 수정이 여러 개일 수 있어, 5번 연속 실패한 실행도 주황색 네모는 몇 개뿐일 수 있습니다.
agent.py의 수정은 옛 문자열을 새 문자열로 바꾸는 방식이고, 옛 문자열은 파일에 정확히 한 번 있어야 합니다. 모델이 무엇을 보냈는지 보려고 나중에 T2와 T3을 도구 인자 전체를 기록하며 다시 돌렸습니다. 이 6번은 점수에 넣지 않았습니다. 숨긴 테스트 통과 수는 48개 중 19개로, 채점한 실행의 같은 과제 10개보다 많습니다. 항상 이렇게 되는 것은 아니어서 T2 재실행 3번 중 2번은 8개 중 6개까지 갔습니다. 나머지 한 번에서는 수정 25번이 모두 실패했고, 그중 23번은 직전 시도와 똑같은 문자열을 보냈습니다. 그 문자열은 이렇게 시작합니다.
def parse_line(line):
    if line.strip().startswith('#') or not line.strip():
실제 함수에는 둘째 줄 같은 코드가 없고, 이 실행은 read_file로 orders.py를 연 적이 없습니다. 파일 목록을 보고 README와 report.py를 읽은 뒤 pytest를 돌리고 바로 수정을 시도했습니다. 에이전트는 매번 old appears 0 times in orders.py, it must appear exactly once라고 답했고, 모델은 30번째 턴까지 같은 문자열을 다시 보냈습니다.
왜 이러는지는 모릅니다. 채팅 템플릿일 수도 있고 모델이 추론하는 방식이나 모델 자체일 수도 있는데, reasoning은 기록하지 않았습니다. agent.py는 컨텍스트가 절반을 넘으면 오래된 도구 출력을 지우지만, 이것만으로 설명하기는 어렵습니다. 실제로 지운 횟수는 9B가 54번으로 Qwen3-8B의 40번보다 많습니다. 이 결과는 이 GGUF가 이 에이전트의 수정 도구와 잘 맞지 않았다는 뜻일 뿐, 다른 에이전트 도구에서 Qwen3-8B가 어떨지는 말해 주지 않습니다.
다 했다고 말한 모델
로컬 에이전트 연재 3편에서는 아무도 고치지 않은 코드를 두고 성공했다고 보고하는 에이전트를 다뤘습니다. 여기서도 같은 일이 있었는데, 이번에는 답이 잘리지 않았고 모델이 직접 그렇게 썼습니다. Qwen3-14B는 T1 세 번 모두 수정 없이 pytest만 한 번 돌리고 멈췄습니다. T1의 보이는 테스트는 원래부터 통과하기 때문입니다. 첫 번째 실행에서는 이렇게 썼습니다.
All tests passed with pytest, confirming the implementation is correct.같은 요약에는 test_todo.py에 테스트를 추가했다는 줄도 있었지만, 추가하지 않았습니다. 세 실행 모두 점수는 6개 중 2개로, 고치지 않은 코드와 같습니다.
모델이 스스로 멈췄고 보이는 테스트가 통과한 실행은 58번이고, 그중 11번이 0.5 아래였습니다. 11번 모두 Qwen3-8B 아니면 Qwen3-14B였고, 4번은 수정이 전혀 없었습니다. 마지막에 pytest가 통과했더라도 실제로 바뀐 코드가 있는지부터 확인해야 합니다.
나머지 50번은 30턴 제한에 걸렸습니다. 평균은 0.594로 스스로 멈춘 실행의 0.796보다 낮지만, 제한에 걸렸다고 실패는 아닙니다. 그중 12번은 제한에 닿았을 때 이미 숨긴 테스트를 전부 통과한 상태였습니다.
저희 예측은 어땠나
| 예측 | 결과 | |
|---|---|---|
| P1 | 모델과 카드 조합 36개 중 33개 이상 맞힘 | 맞음. 정확히 33개. 12GB의 gpt-oss-20b, 8GB의 Qwen3-8B, 12GB의 Qwen3-14B가 들어간다는 것을 놓침 |
| P2 | 8비트 캐시로 세 모델이 한 단계 작은 카드에 들어감 | 틀림. Devstral만 옮겨 갔고 둘은 이미 들어감 |
| P3 | 16K 메모리가 4K·8K로 그은 직선에서 300MiB 안 | 맞음. 9개 모두 차이 0MiB |
| P4 | 최대 사용량이 로드 직후보다 64MiB 이내로 많음 | 맞음. 최대 58MiB |
| P5 | 모델 점수가 예상에서 0.15 안 | 틀림. 9개 중 2개. 대체로 낮게 잡음 |
| P6 | 맨 위 모델: 9B, 9B, Flint, 27B | 4개 중 3개. 24GB도 Flint(점수 기준. 27B와 구분되지는 않음) |
| P7 | T3이 가장 어려움 | 틀림. T4 |
| P8 | 끝낸 실행의 5분의 1이 0.5 아래, T3에 가장 많음 | 틀림. 0.19이고 T1과 T4가 5번씩, T3은 1번 |
8GB와 12GB의 맨 위가 9B라는 것은 저희도 예측했습니다. 가장 크게 빗나간 것은 Flint(0.60, 실제 1.000), Qwen3-8B(0.45, 실제 0.176), 4B(0.35, 실제 0.610)입니다.
8GB에서 맨 위였던 모델 돌려 보기
hf download unsloth/Qwen3.5-9B-GGUF Qwen3.5-9B-Q4_K_M.gguf --revision 3885219 --local-dir models
llama-server -m models/Qwen3.5-9B-Q4_K_M.gguf -c 16384 -ngl 99 -fa on --parallel 1 --jinja --port 8080
이 서버에 붙는 에이전트는 로컬 에이전트 연재 1편에서 만듭니다. 작은 카드에서는 실제 작업을 돌리면서 nvidia-smi로 프로세스 메모리를 직접 확인해 주십시오.
이 결과의 한계
- 메모리 수치. A100에서 잰 값을 각 카드 용량과 비교했으므로, 쓰시는 카드에서는 조금 달라질 수 있습니다. 46MiB만 남는 gpt-oss-20b처럼 여유가 적은 조합은 직접 띄워 확인해 주십시오.
- Flint 말고는 Q4_K_M만 쟀고, 이름도 정확하지 않습니다. 12GB에는 9B의 더 높은 양자화도 들어갈 수 있지만 재지 않았습니다. 그러니 위 결론은 시험한 파일 안에서만 맞습니다. gpt-oss-20b 파일은 이름과 달리 양자화된 텐서 대부분이 MXFP4와 Q5_0이고, Flint의 "Q2"에도 Q5_K가 섞여 있습니다.
- 작은 Python 과제 4개입니다. 순위는 이 과제에 대한 것입니다. 더 어려운 과제에서는 순서가 바뀔 수 있습니다.
- 모델과 과제 조합마다 3번입니다. 과제별 숫자는 실행 한 번 단위로 움직입니다.
- 전부 GPU에 올린 경우만 쟀습니다. 큰 모델을 작은 카드에서 돌릴 때 많이 쓰는 CPU 오프로드는 시험하지 않았습니다.
- 컨텍스트는 모두 16K입니다. 더 길면 점수와 메모리가 달라질 수 있는데 재지 않았습니다.
- 제한은 도구 호출이 아니라 턴으로 셉니다. 한 턴에 호출을 여러 개 보내는 모델이 유리합니다. Flint는 그런 턴이 29개이고, gpt-oss-20b와 Qwen3-Coder-30B는 없습니다.
- 템플릿과 thinking은 기본값입니다. 모델별로 조정하면 점수가 달라질 수 있습니다.
다음 단계
더 내려받기 전에 모델이 카드에 맞는지 보려면 짧게 두 번 띄워 직선을 긋는 방법을 쓰면 됩니다. 이번 9개 모델에서는 이 방법의 값이 16K 실측과 정확히 같았습니다.
사진 한 장을 3D 모델로 만드는 Idol이 8GB 카드에 들어가는지도 쟀습니다. 8GB로 제한한 A100에서 최고치는 7,380MiB였습니다. 8GB GPU로 사진 한 장을 3D 모델로 만들 수 있을까요?에서 볼 수 있습니다.