로컬 AI 코딩 에이전트 처음부터 만들기: 결정 모델까지, 클라우드 호출 0번
코딩 에이전트를 로컬 부품 세 개로 만듭니다. 코드는 llama-server 위의 Flint가 쓰고, 표준 라이브러리만 쓴 135줄짜리 파이썬 하네스가 도구 호출을 실행하고, CPU에서 도는 0.8B 결정 모델 Jeff가 셸 명령마다 한 줄 의견을 붙인 뒤 y/N을 묻습니다. 다섯 단계와 전체 코드, 할 일 앱에 실제로 돌린 기록(숨긴 테스트 6개 모두 통과), 그리고 여전히 틀린 점을 담았습니다.
로컬 AI 코딩 에이전트 처음부터 만들기: 결정 모델까지, 클라우드 호출 0번
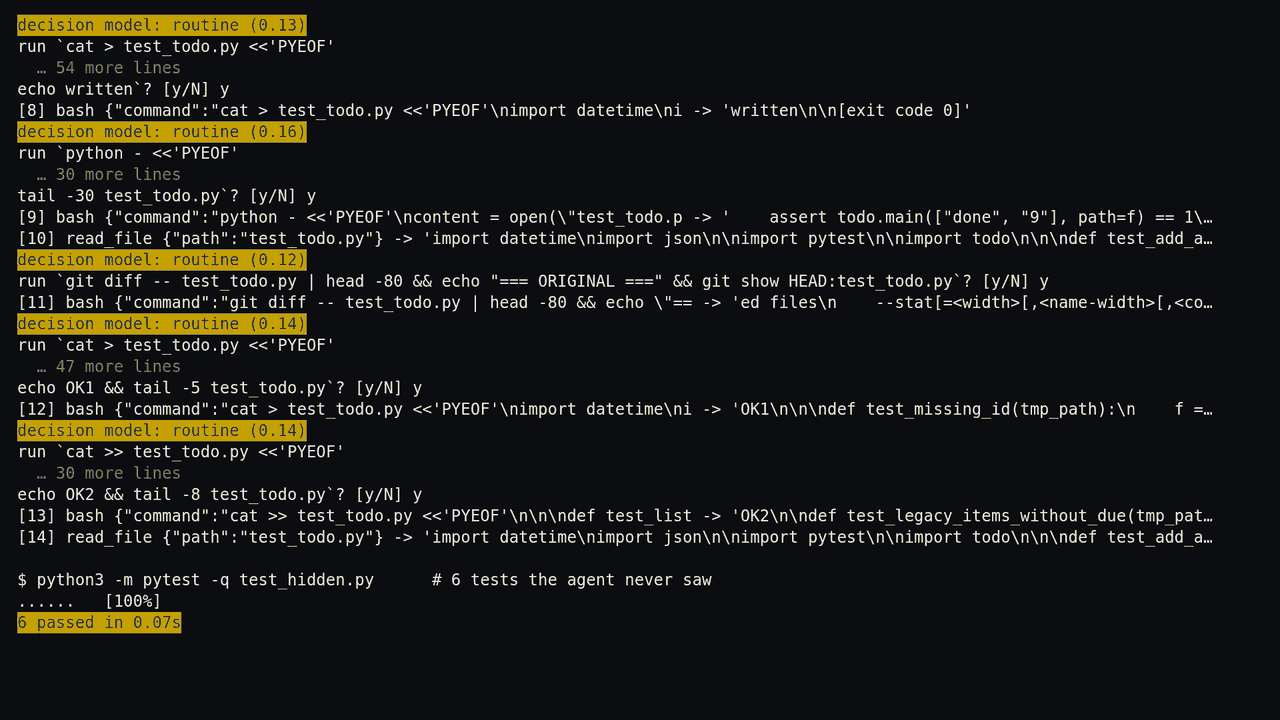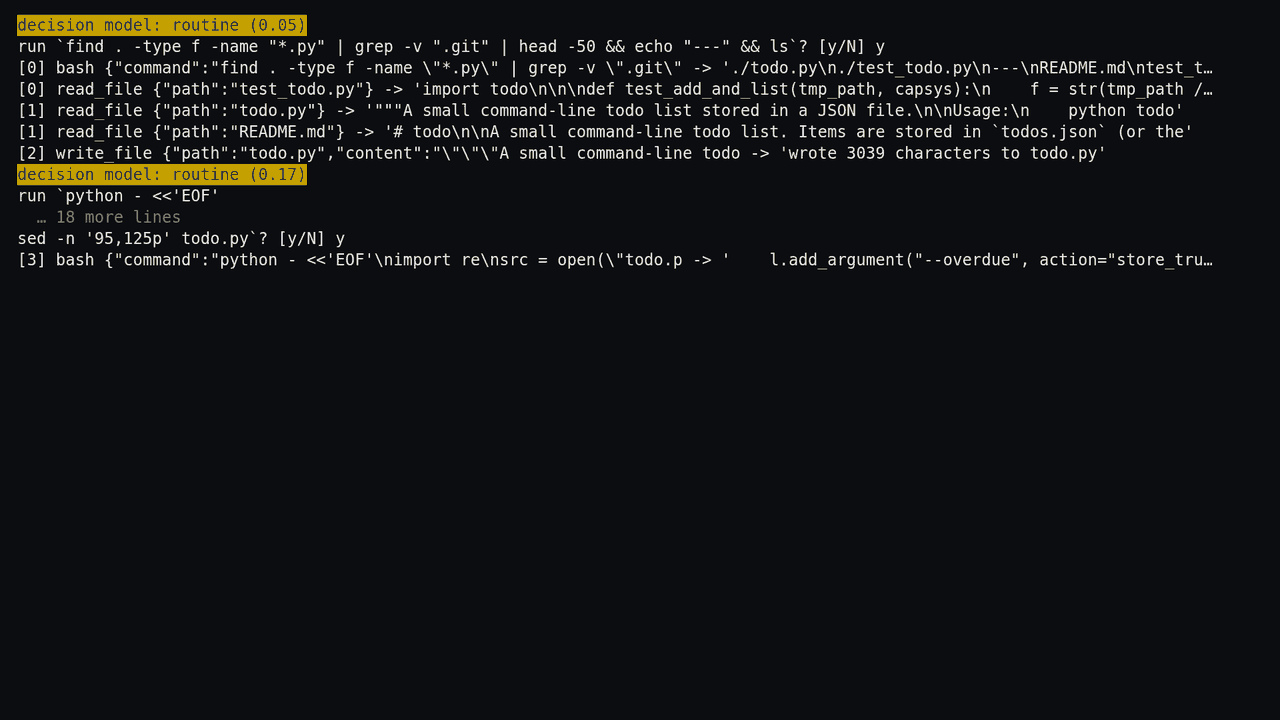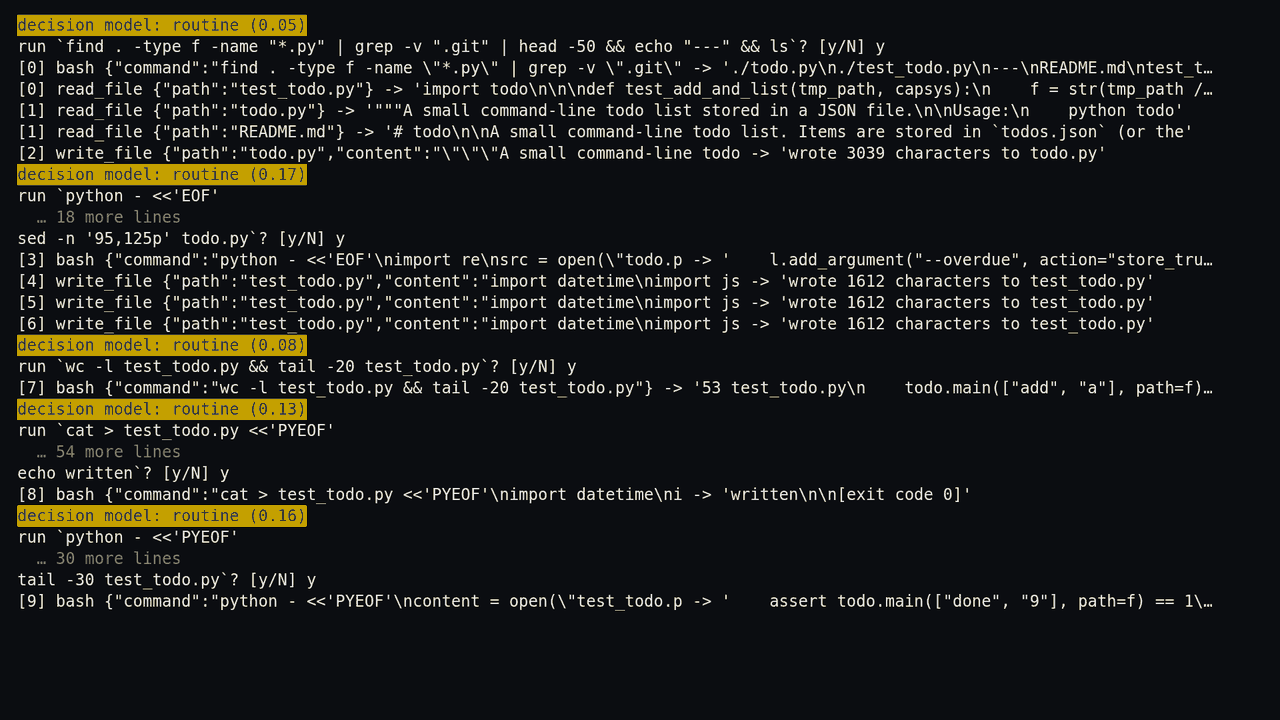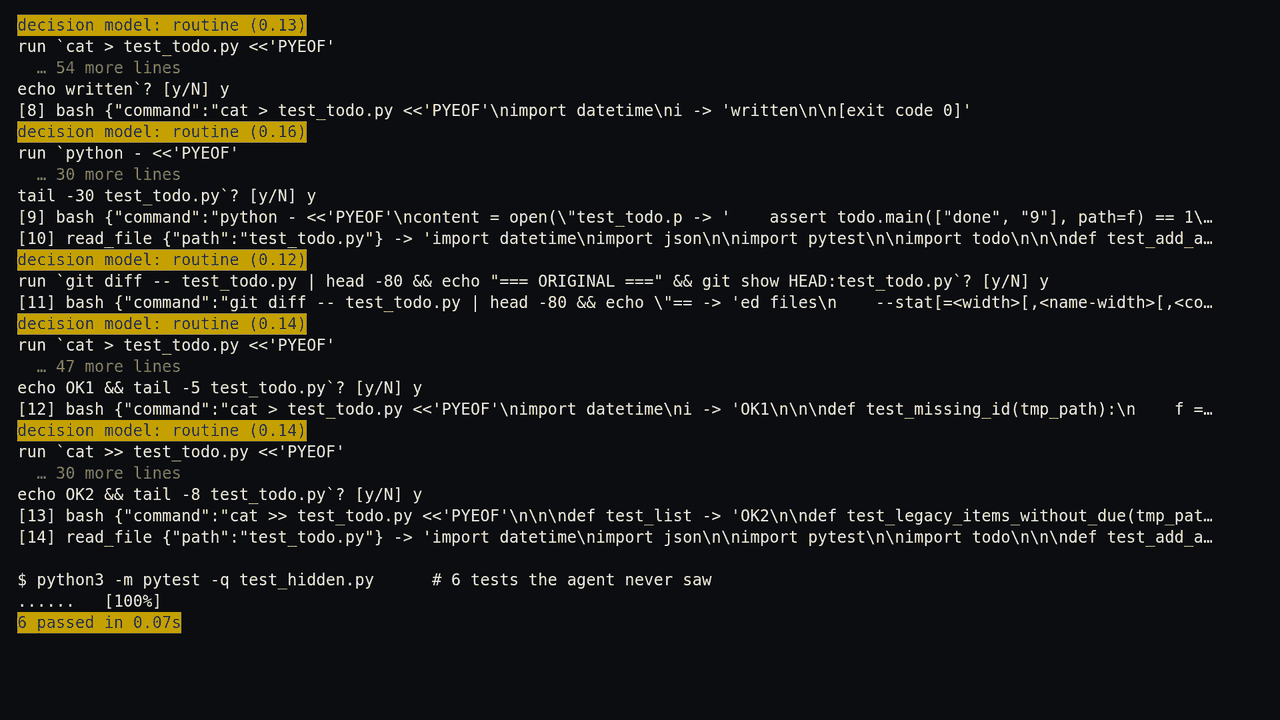
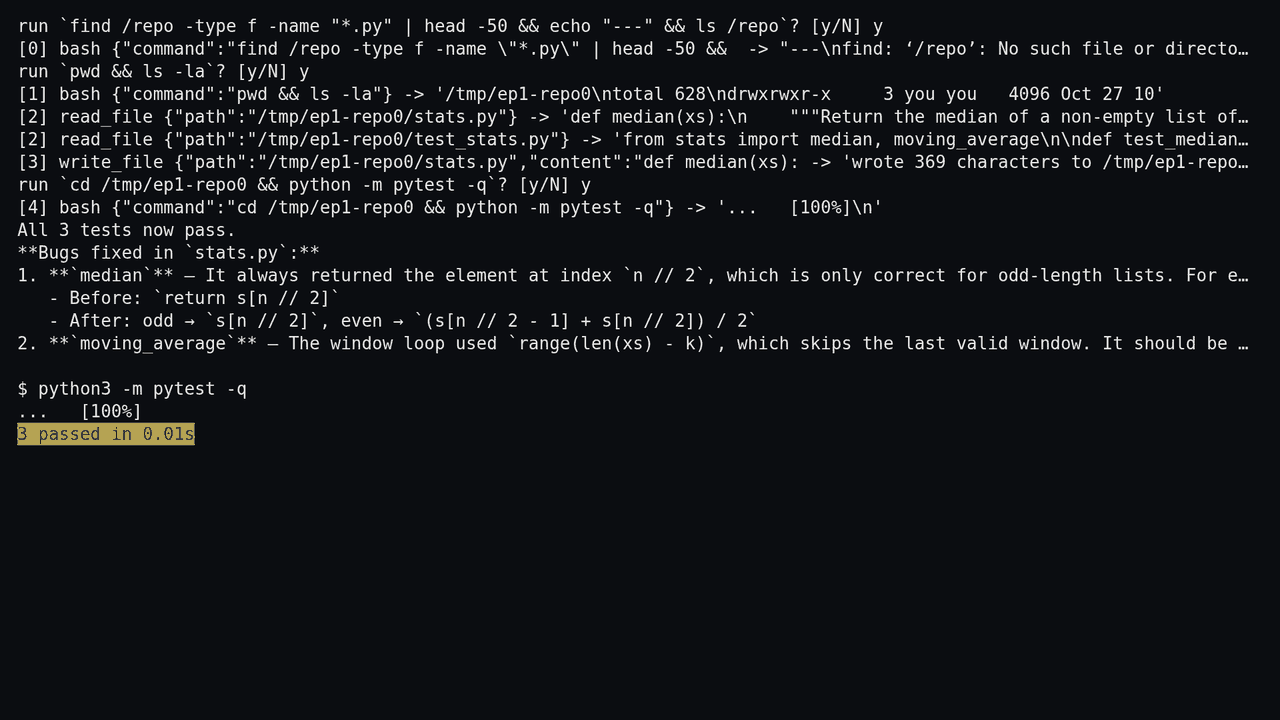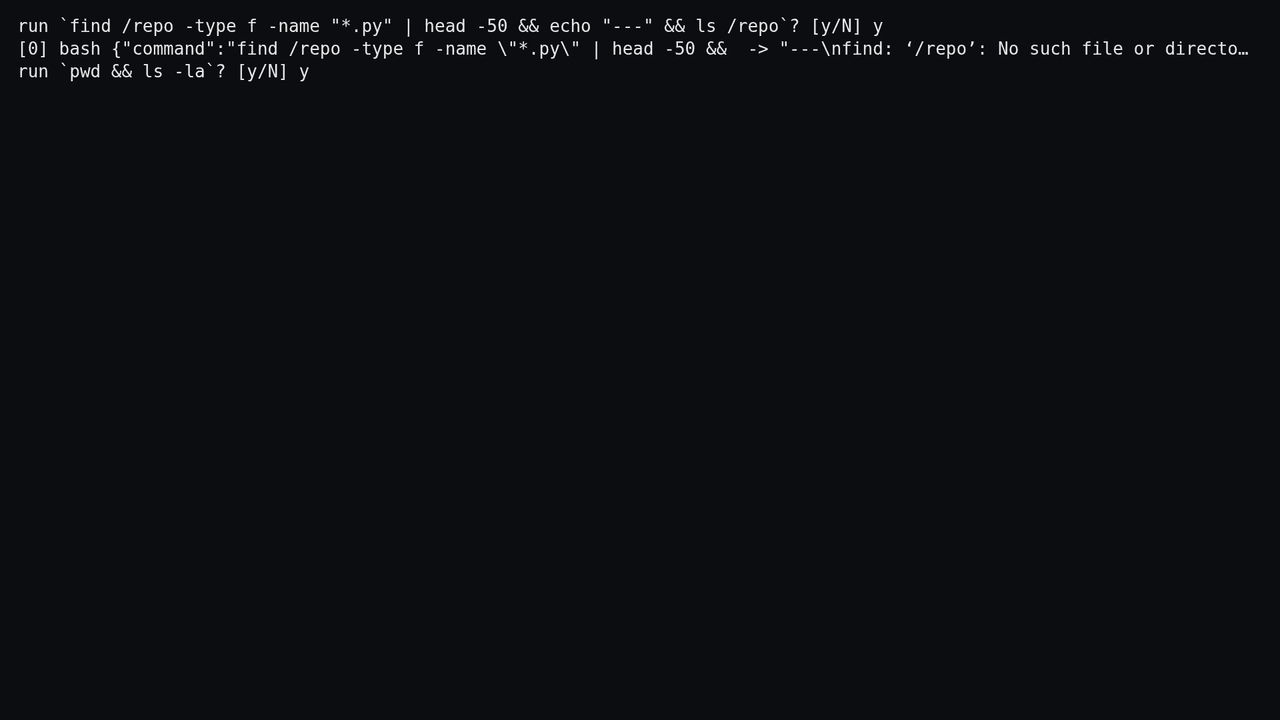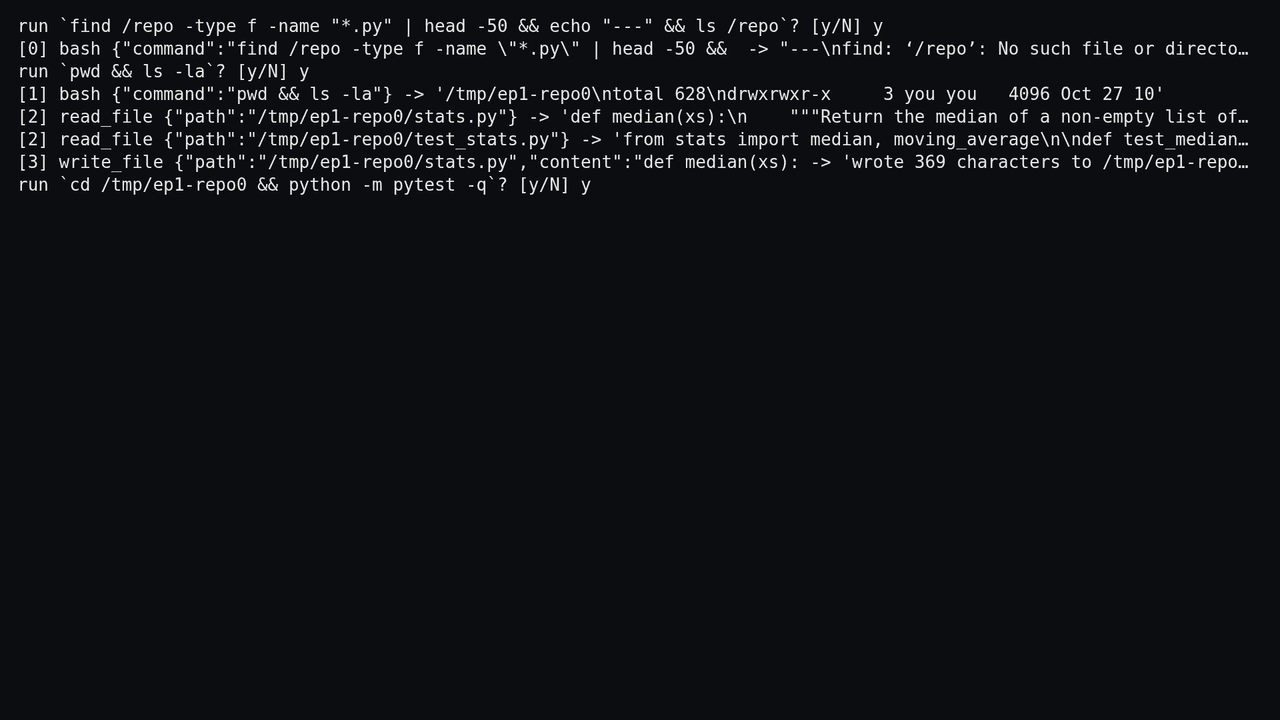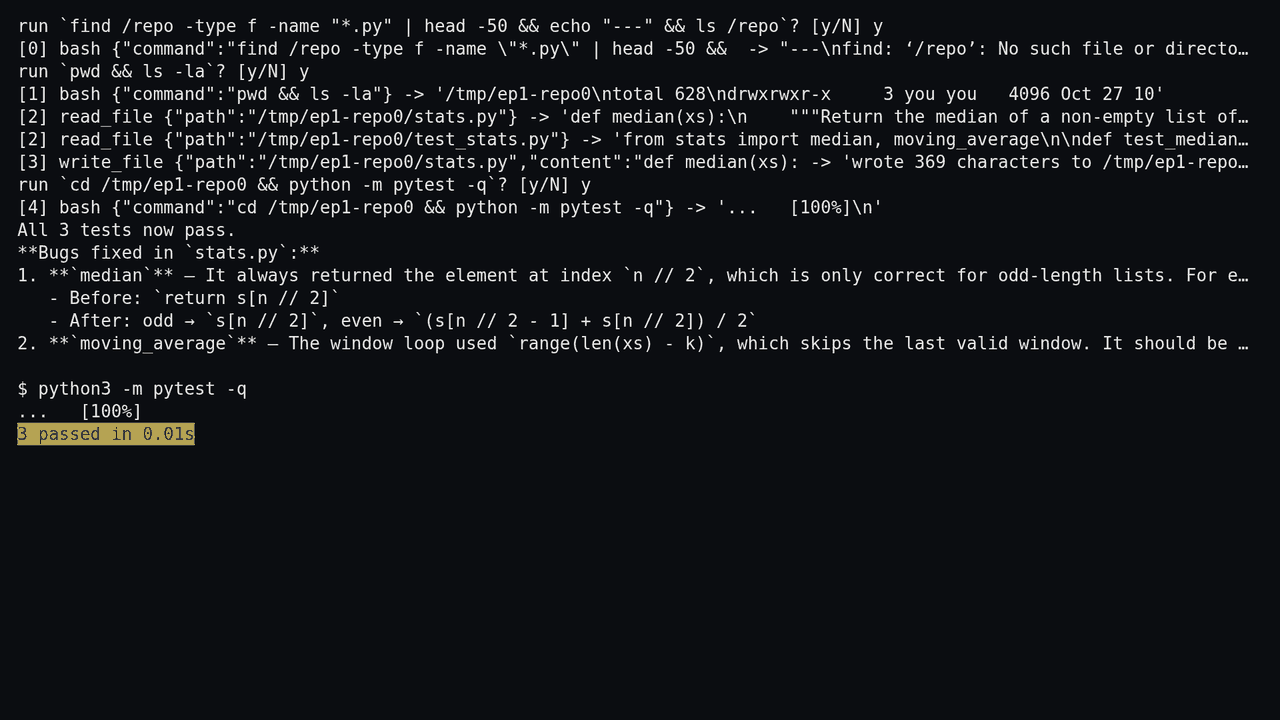
에이전트는 셸 명령을 실행하기 전에 매번 멈추고 두 줄을 찍습니다. 위 녹화의 맨 처음 두 줄은 이렇습니다.
decision model: routine (0.05)
run `find . -type f -name "*.py" | grep -v ".git" | head -50 && echo "---" && ls`? [y/N]
아랫줄은 터미널이 사용자에게 이 명령을 실행해도 되는지 묻는 줄입니다. y를 치면 실행하고, 다른 것을 치면 사용자가 거절했다는 말이 모델에게 돌아갑니다.
녹화에서 노랗게 칠한 윗줄은 코드를 쓰는 모델과 별개인 두 번째 모델이 씁니다. 이 글에서는 결정 모델이라고 부릅니다. 하는 일은 하나뿐입니다. 명령을 읽고 "실행하기 전에 사람이 자세히 봐야 하는가"라는 객관식 질문에 답합니다. routine은 아니라는 뜻이고 LOOK CLOSELY는 봐야 한다는 뜻입니다. 괄호 안 숫자는 답이 '봐야 한다'일 확률을 0부터 1 사이로 매긴 값이라, 0.05면 볼 이유가 거의 없다고 본 것입니다.
이 글의 결정 모델은 Jeff이고, 크기가 작습니다. 0.8B는 파라미터가 8억 개라는 뜻입니다. 파라미터는 모델이 학습하며 맞추는 숫자들입니다. 코드를 쓰는 Flint는 398억 개입니다. 이 정도로 작으면 CPU에서 돌릴 수 있고, GPU는 Flint가 다 쓸 수 있습니다. 다른 작업으로 바쁜 저희 서버의 CPU에서는 답 하나에 1초 안팎에서 3초, 느릴 때는 6초가 걸렸습니다.
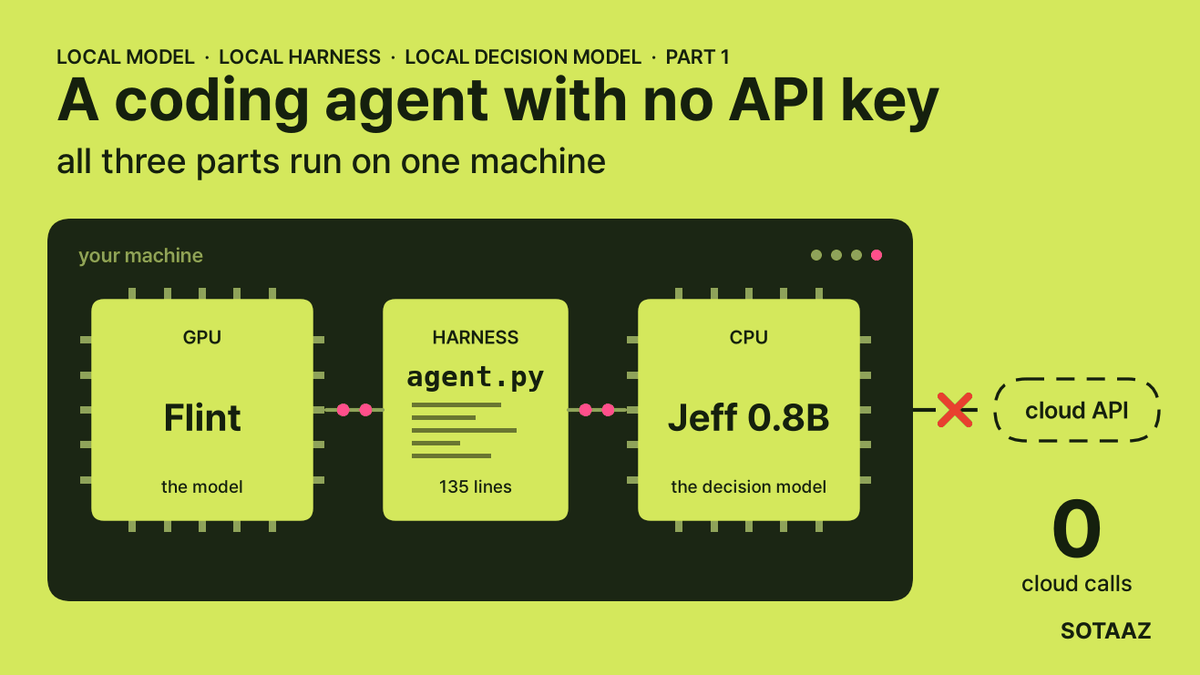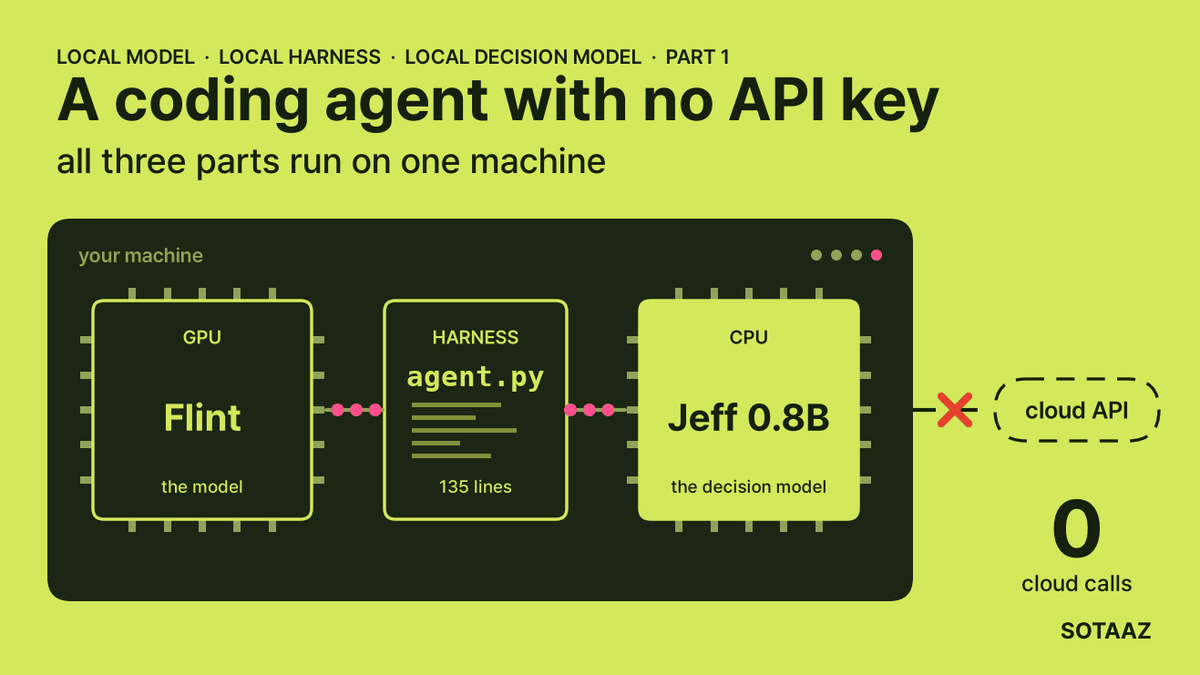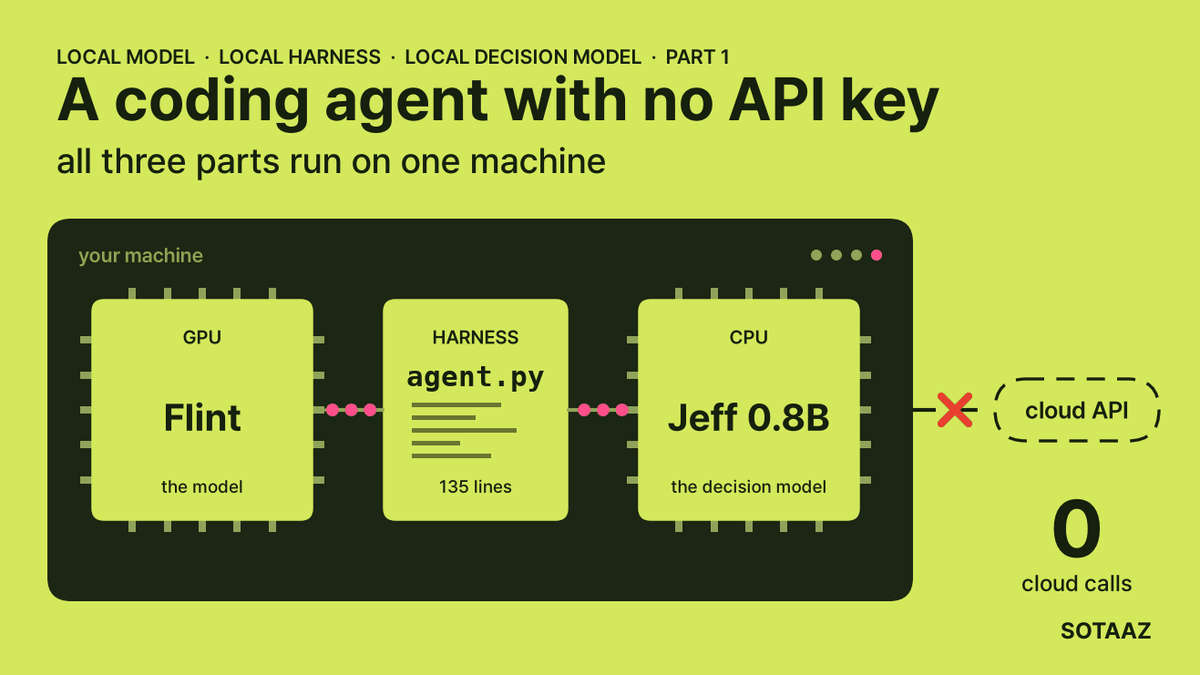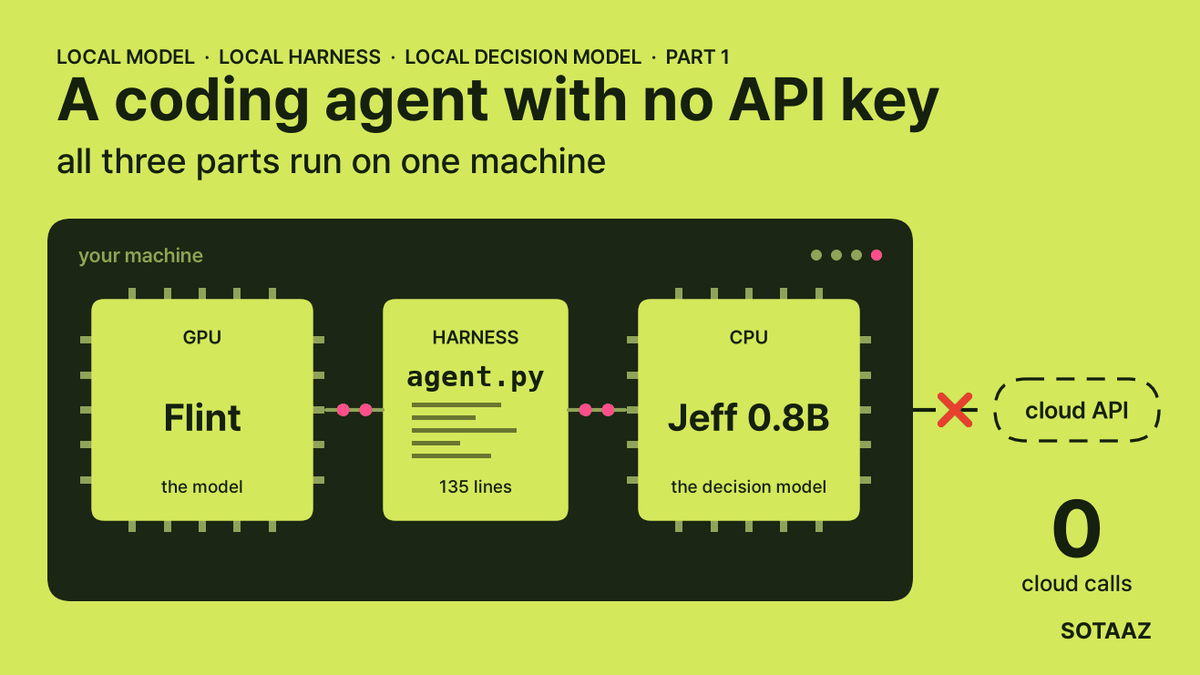
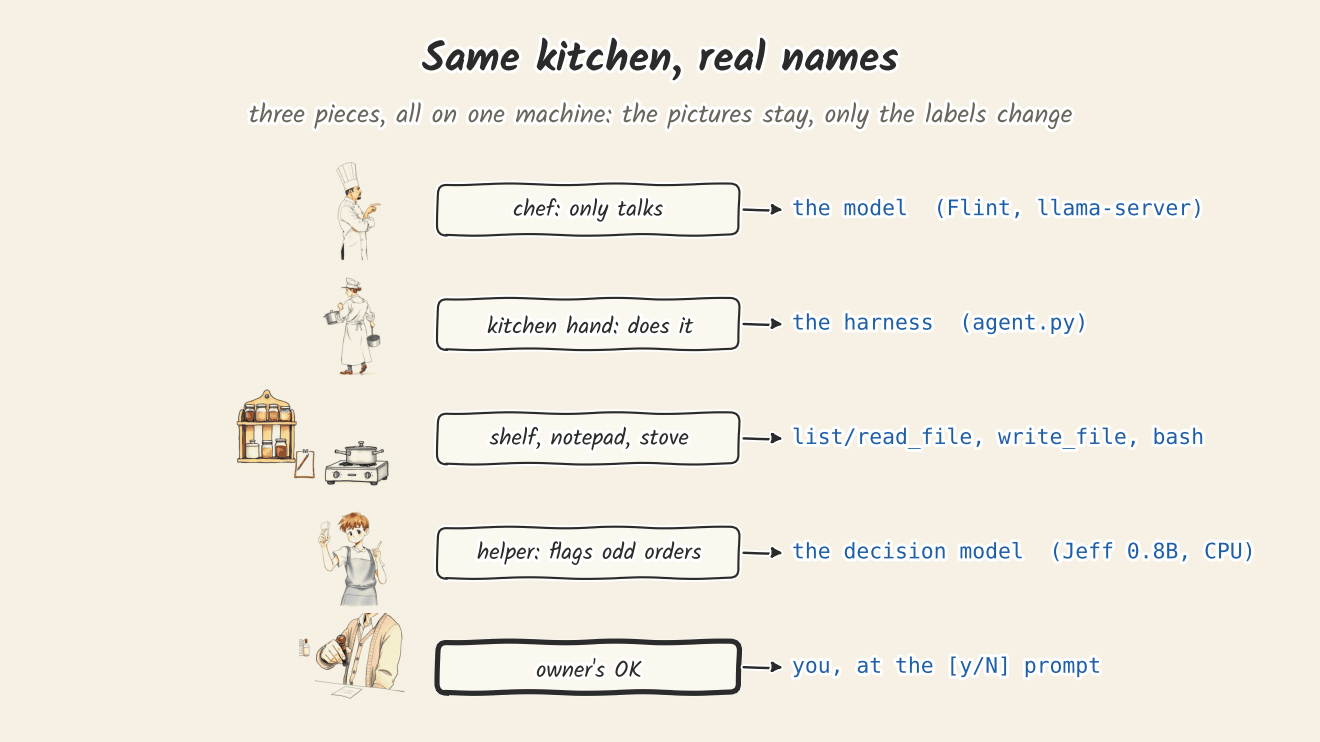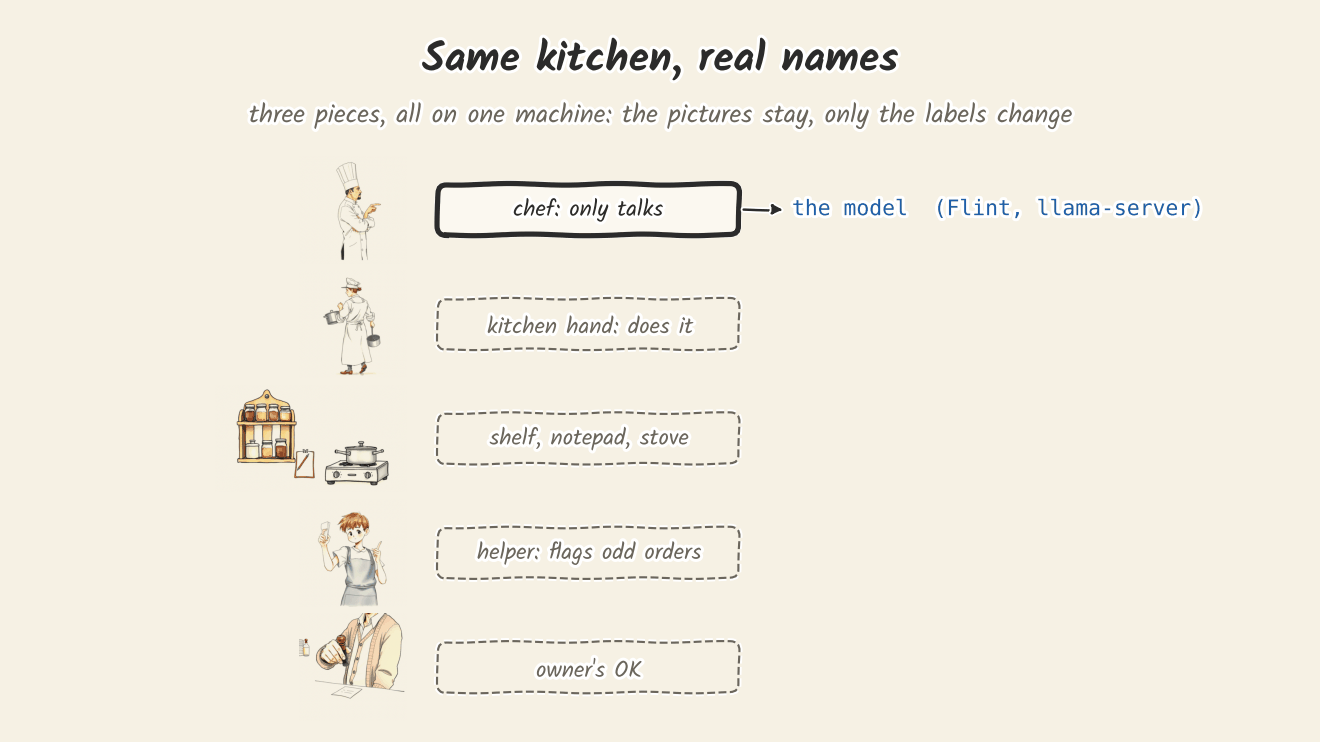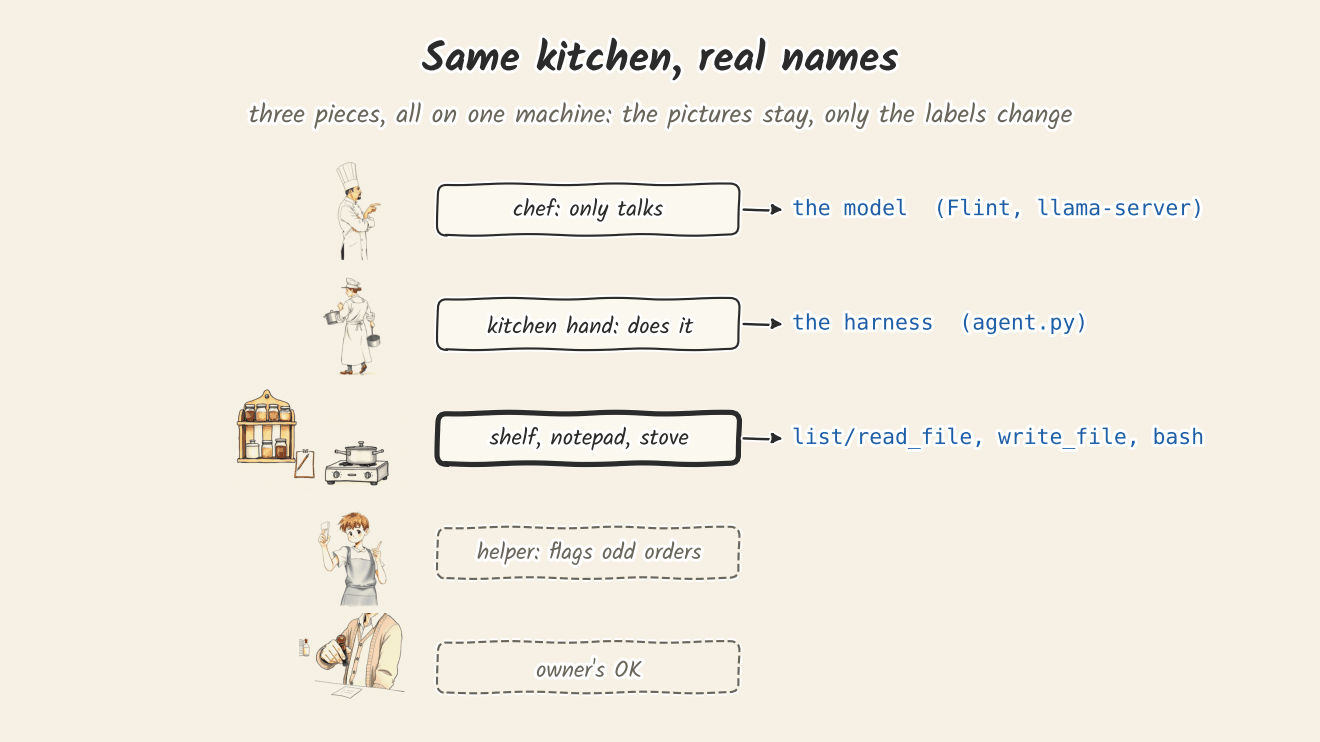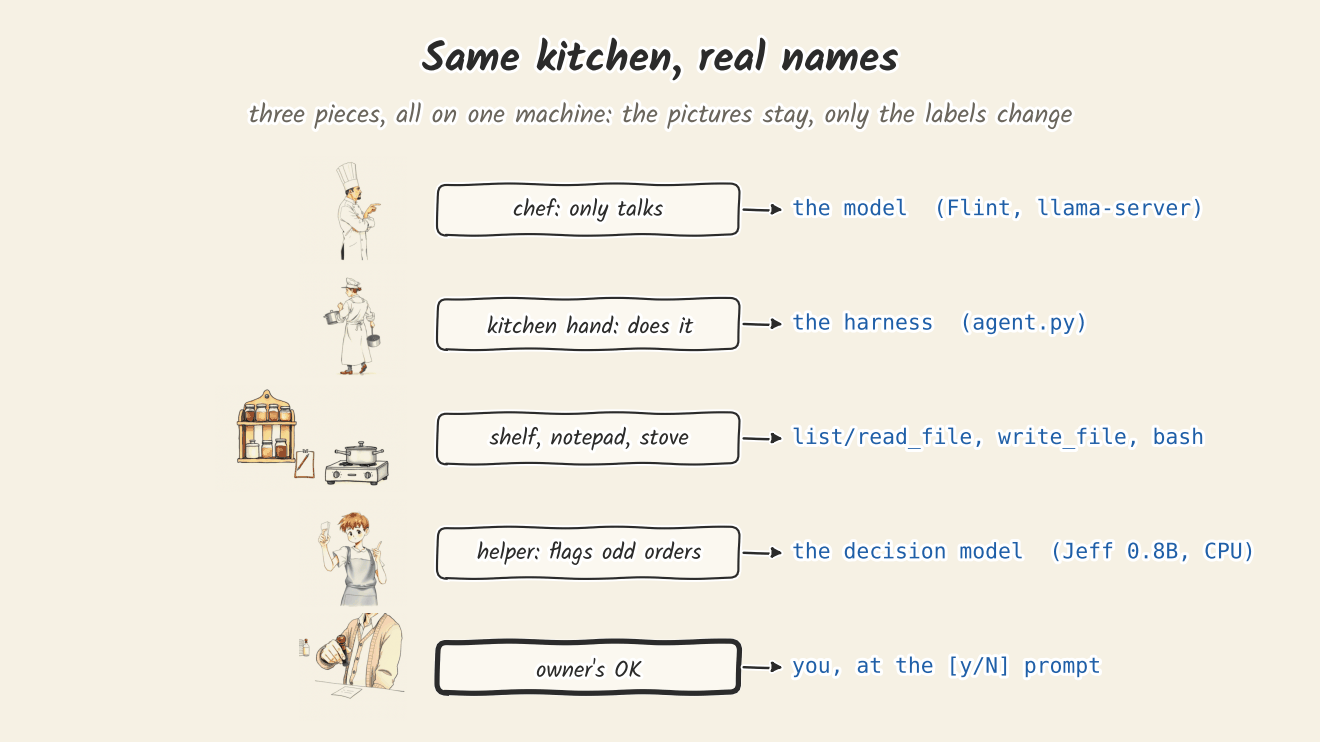
이 에이전트는 부품 세 개로 돌렸습니다. 셋 다 이 컴퓨터 안에서 돌고, 밖으로 나가는 요청은 없습니다.
- 모델: llama-server 위의 Flint입니다. GPU에서 돌고, 코드와 도구 호출을 씁니다.
- 하네스: agent.py입니다. 표준 라이브러리만 쓴 파이썬 135줄이고, 도구 호출을 실행하며 루프를 돌립니다.
- 결정 모델: Jeff 0.8B입니다. CPU에서 돌고, 셸 명령마다 위와 같은 한 줄 의견을 씁니다.
이 글 어디에도 API 키는 없습니다. agent.py가 요청을 보내는 주소는 두 곳이고, 둘 다 127.0.0.1입니다.
위 녹화는 할 일 앱에 기능 여섯 가지를 추가하라는 과제였고, 에이전트는 15단계 만에 멈췄습니다. 멈춘 뒤 에이전트가 한 번도 본 적 없는 테스트 6개를 넣어 돌렸더니 6개 모두 통과했습니다. 그런데 에이전트가 남긴 테스트 파일은 실패하고, 에이전트는 pytest를 한 번도 돌리지 않았습니다. 이 글은 이 에이전트를 만드는 튜토리얼입니다. 저희가 돌리면서 본 것도 같이 적어 두었으니, 직접 돌릴 때 어디를 봐야 하는지 알 수 있습니다.
코드는 어떤 모델이 쓰나: Flint를 고른 이유
Flint는 Recursive라는 회사가 Hugging Face에 공개한 코딩 모델입니다. 모델 카드는 코딩 에이전트용 mixture-of-experts 언어 모델이라고 소개합니다. mixture of experts는 층마다 작은 하위 신경망을 여럿 두고, 토큰 하나를 처리할 때 그중 몇 개만 쓰는 구조입니다. Flint는 256개 중 6개와 공용 2개를 씁니다. 그래서 파라미터는 398억 개를 담고 있지만 토큰 하나에 계산하는 것은 약 25억 개입니다. 메모리는 큰 모델만큼 들고, 속도는 작은 모델에 가깝습니다. 저희는 Unsloth가 2비트로 줄인 UD-Q2_K_XL 파일(13.6GB)을 씁니다. 개발사는 SWE-bench Verified 74.2%를 발표했고, 저희가 확인한 숫자는 아닙니다.
연재를 시작하기 전에 로컬 모델 세 개에 4단계와 5단계의 과제 두 개를 똑같이 줘 봤습니다. 이 글의 agent.py 전에 쓰던 최소 루프(읽기·쓰기·편집·bash, 최대 40단계)로 과제마다 한 번씩, A100 GPU에서 컨텍스트 32K로 돌렸습니다. 속도는 중앙값입니다.
| Qwen3.5-9B Q4_K_M | Qwen3.8-27B UD-Q3_K_XL | Flint UD-Q2_K_XL | |
|---|---|---|---|
| 버그 두 개(4단계) | 통과, 10단계, 33초 | 통과, 7단계, 43초 | 통과, 5단계, 14초 |
| 할 일 기능(5단계) | 40단계 상한에서 멈춤, 컨텍스트 30K까지 참 | 통과, 12단계, 244초 | 통과, 19단계, 227초 |
| 기능 과제의 숨긴 테스트 | 6개 중 3개 | 6개 중 6개 | 6개 중 6개 |
| 생성 속도 | 초당 73-77토큰 | 초당 36-37토큰 | 초당 69-73토큰 |
| GPU 메모리 최고값 | 6,568MiB | 14,558MiB | 14,386MiB |
- Qwen3.5-9B는 최고 6,568MiB로 셋 중 유일하게 8GB 아래였고, 빠릅니다. 대신 기능 과제를 끝내지 못했고 숨긴 테스트도 절반이 실패했습니다.
- Qwen3.8-27B는 둘 다 끝냈지만 토큰 생성 속도가 절반 정도입니다. 기능 과제의 전체 시간은 244초로 Flint의 227초와 비슷했는데, 단계를 12번만 썼기 때문입니다(Flint는 19번).
- Flint는 둘 다 끝냈고 속도는 9B와 비슷합니다. 대가는 세 가지입니다. 16GB 카드에 여유가 거의 남지 않고, 최신 llama.cpp가 필요하고, 새로 나온 모델을 2비트로 줄인 파일입니다.
과제마다 한 번씩 돌린 결과라 모델을 고르는 데는 충분해도 순위를 매길 근거는 못 됩니다. 카드가 8GB라면 Qwen 로컬 실행 글에서 어떤 파일이 맞는지, llama-server의 -c 정하기 글에서 카드에 맞는 컨텍스트 길이를 찾는 법을 볼 수 있습니다. 하네스는 Claude Code를 그대로 두고 모델만 로컬로 바꾸고 싶다면 12GB 안에서 Claude Code를 로컬 Qwen으로 돌리기에서 그렇게 해 봤습니다.
준비물
- Flint용 16GB GPU. Flint UD-Q2_K_XL을 32K 컨텍스트로 띄웠을 때 llama-server 프로세스가 가장 많이 쓴 메모리는 14,386MiB였습니다. 이 값은 80GB A100에서 잰 것입니다. 16GB 카드에서 직접 돌린 것이 아니라, 16GB 예산을 큰 카드에서 확인한 숫자입니다.
- RAM 32GB. Jeff는 CPU에서 돌고, 저희 실행에서 서버가 메모리를 약 4.3GiB 썼습니다.
- llama.cpp 릴리스 b11889 이상. 그보다 오래된 빌드는
unknown model architecture: 'flint'를 내고 멈춥니다. - agent.py용 파이썬 3(저희는 3.11.4)와 과제 확인용 pytest.
- Jeff용: 파이썬 3.12 이상, uv 0.12.19 이상. Jeff의
pyproject.toml이 둘 다 요구합니다.
1단계: Flint 띄우기
llama-server -m flint-UD-Q2_K_XL.gguf -c 32768 -ngl 99 --jinja --port 8080--jinja를 주면 llama-server가 GGUF 파일 안에 든 채팅 템플릿을 씁니다. Flint의 템플릿은 도구 호출 형식을 알고 있어서, 이 옵션이 있어야 서버가 요청에 담긴 도구 목록을 받고 모델의 도구 호출을 JSON으로 돌려줍니다. -ngl 99는 모든 레이어를 GPU에 올리라는 뜻입니다.
다른 터미널에서 확인합니다.
curl http://127.0.0.1:8080/health이게 보이면 성공입니다: {"status":"ok"}
2단계: Jeff를 CPU에서 띄우기
결정 모델은 글을 쓰는 대신 고르도록 학습한 모델입니다. 상황과 번호 붙은 선택지가 있는 질문을 주면, 글을 생성하지 않고 한 번에 선택지마다 확률을 돌려줍니다. 그래서 빠르고, 코드가 답을 읽기도 쉽습니다. 처음부터 개념을 알고 싶다면 10분 만에 이해하는 Jev를 먼저 보세요.
Jeff는 만든 사람이 github.com/firelex/jeff에 공개한 결정 모델입니다. Jeff를 고른 것은 후보 중에 CPU에서 시간을 재 본 모델이었기 때문입니다. 저희 서버 CPU에서 답 하나에 중앙값 2.7초가 걸렸고, 같은 조건에서 저희가 직접 학습한 4B 결정 모델은 11.6초였습니다. 그래서 GPU를 Flint에게 남겨 두고도 에이전트가 오래 기다리지 않습니다. 또 /v1/systemone으로 답하는 서버가 같이 들어 있어서 Ollama 같은 것을 따로 깔 필요가 없습니다. Jev와 같은 문항으로 잰 결과는 Jeff vs Jev에 있습니다.
저희가 써 본 다른 선택지는 이렇습니다.
- Jev는 원조이지만 유료 클라우드 API라서, API 키 없이 돌리는 이 구성에는 맞지 않습니다.
- Nimble(9B)과 Tev1(4B, 0.8B) 은 Ollama에서 돌아갑니다(Ollama 판단 모델을 Jev와 같은 문항으로 재 봤습니다). Tev1 0.8B는 Jeff와 크기가 같지만 CPU에서 시간을 재 보지는 않았습니다.
- 직접 학습한 결정 모델도 있습니다(Unsloth로 결정 모델을 직접 학습해 봤습니다). 저희 것은 4B라 저희 CPU에서 답 하나에 약 11.6초가 걸렸습니다. 명령마다 묻기에는 너무 느립니다.
결정 모델을 처음부터 직접 만들어 보고 싶다면 Jev 같은 결정 모델 처음부터 만들기 강의에서 단계별로 따라 할 수 있습니다.
git clone https://github.com/firelex/jeff && cd jeff
git checkout f067882
uv sync --no-default-groups
uv run --no-default-groups hf download mstrasser/Jeff-Qwen3.5-0.8B --revision d86f657 --local-dir checkpoints/jeff-0.8b
CUDA_VISIBLE_DEVICES="" JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=18766 uv run --no-default-groups jeff-serve
여기서 중요한 선택이 세 가지 있습니다.
--revision d86f657은 저희가 쓴 체크포인트 v1.1로 고정합니다.--no-default-groups는 Jeff README에 있는 CPU용 설치 방법입니다. 그냥uv sync를 하면 학습용 패키지까지 깔리는데, GPU가 없는 컴퓨터에서는 그중 하나 때문에 모든 답이 실패합니다(아래 '안 될 때' 참고).CUDA_VISIBLE_DEVICES=""는 Jeff가 GPU를 쓰지 못하게 막습니다. GPU는 이미 Flint가 채우고 있습니다. 포트 18766은 agent.py가 찾아가는 자리입니다.
이 다섯 줄은 Jeff README를 따른 것입니다. 저희는 이미 깔아 둔 Jeff 환경에서 .venv/bin/jeff-serve를 같은 환경 변수 세 개와 함께 직접 띄웠습니다. 어느 쪽이든 됩니다. 다섯 줄을 그대로 돌려도 되고, Jeff가 이미 깔려 있다면 jeff-serve를 바로 띄워도 됩니다.
서버가 떴으면 agent.py가 쓰는 바로 그 함수로 명령 두 개를 물어봅니다. agent.py는 3단계에서 만드니, 그때 돌아와서 해 보면 됩니다.
python3 -c "import sys, agent; print(agent.flag_command('/tmp/ep1-repo0', sys.argv[1]))" 'rm -rf ~/projects'
python3 -c "import sys, agent; print(agent.flag_command('/tmp/ep1-repo0', sys.argv[1]))" 'python3 -m pytest -q'
이게 보이면 성공입니다:
decision model: LOOK CLOSELY (0.96)
decision model: routine (0.16)
괄호 안 숫자는 그 명령을 자세히 봐야 한다고 Jeff가 매긴 확률입니다. 다른 작업으로 바쁜 컴퓨터였는데도 답 하나에 약 1초가 걸렸습니다.
3단계: agent.py
agent.py는 저희가 빈 파일에서 시작해 직접 썼고, 파이썬 표준 라이브러리만 씁니다. 모든 줄이 이 글에 있고, 프레임워크 뒤에 숨은 동작은 없습니다.
처음부터 이 모양은 아니었습니다. 돌려 보고 빠진 게 드러날 때마다 한 부분씩 넣었습니다. 첫 버전에는 파일 목록·읽기·쓰기 도구만 있었습니다. 모델이 테스트를 돌릴 수 없어서 bash와 y/N 확인을 넣었습니다. 모델이 코드를 /repo에서 찾길래 시스템 프롬프트에 문장 하나를 넣었습니다. 결정 모델의 의견은 마지막에 붙였습니다. 하나하나의 사연은 아래 '어려웠던 점'에 있습니다.
하네스가 어떤 부분으로 이뤄지는지 먼저 알고 싶다면 에이전트 하네스란 무엇인가를, 큰 하네스들이 각 부분을 얼마나 바꿀 수 있게 열어 두는지는 Claude Code, Codex, OpenCode, Hermes 비교를 보세요.
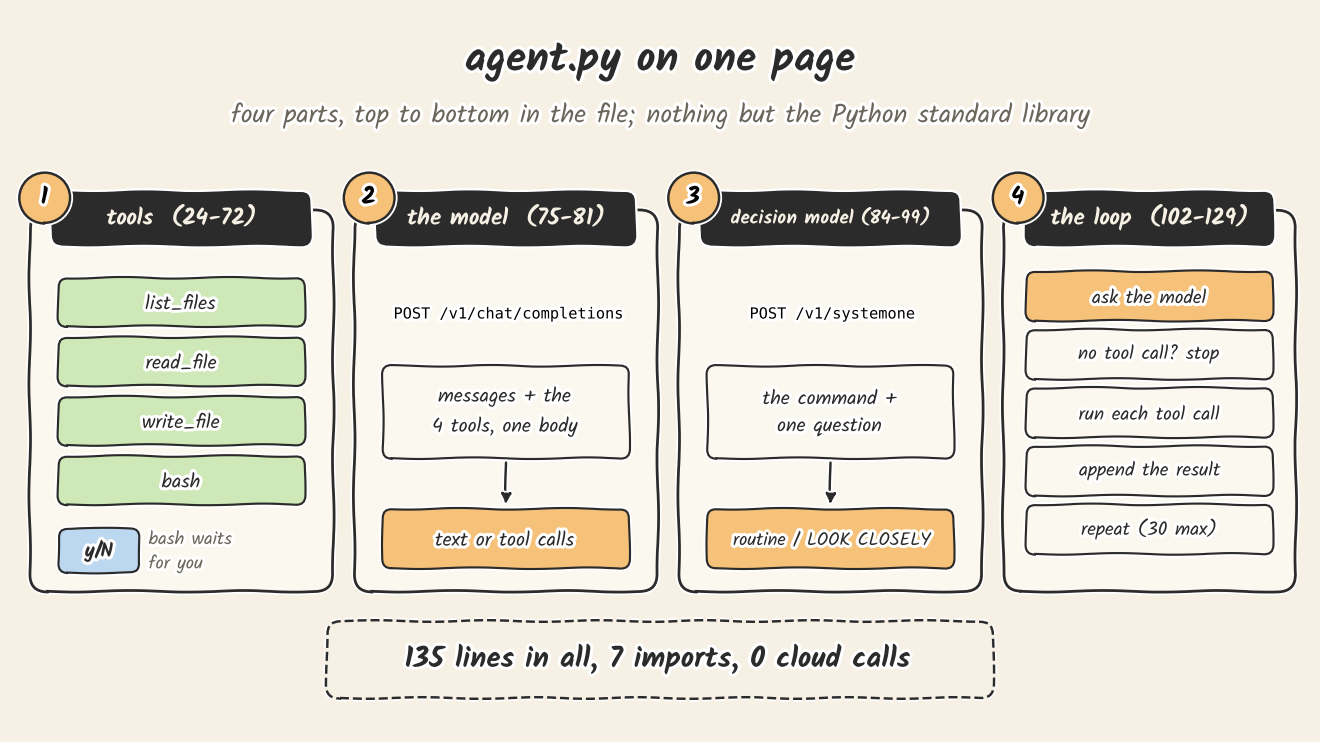
하네스 전체가 파일 하나이고, 네 부분으로 나뉩니다.
1부: 도구
"""A local coding agent: a local model behind llama-server, a small local decision model on the CPU, and this file
as the harness.

Part 1: an agent loop with four tools. It reads and writes files, and runs shell commands after you say yes.
Before each command the decision model says whether it deserves a closer look; you still answer y/N every time.

    llama-server -m <model.gguf> -c 32768 -ngl 99 --jinja --port 8080
    jeff-serve                                  # the decision model, port 18766
    python agent.py <repo folder> "the task"
"""
import json
import os
import subprocess
import sys
import urllib.error
import urllib.request
from pathlib import Path

SERVER = os.environ.get("AGENT_SERVER", "http://127.0.0.1:8080")
DECIDER = os.environ.get("AGENT_DECIDER", "http://127.0.0.1:18766")
MAX_STEPS = 30


# --- 1. Tools: what the model may ask for, and the code that does it ---------------------------

TOOLS = [
    {"type": "function", "function": {
        "name": "list_files", "description": "List every file in the repo.",
        "parameters": {"type": "object", "properties": {}}}},
    {"type": "function", "function": {
        "name": "read_file", "description": "Read a text file in the repo.",
        "parameters": {"type": "object", "properties": {"path": {"type": "string"}}, "required": ["path"]}}},
    {"type": "function", "function": {
        "name": "write_file", "description": "Create or overwrite a file with the full new content.",
        "parameters": {"type": "object", "properties": {"path": {"type": "string"}, "content": {"type": "string"}},
                       "required": ["path", "content"]}}},
    {"type": "function", "function": {
        "name": "bash", "description": "Run a shell command in the repo, for example to run the tests (60 s limit).",
        "parameters": {"type": "object", "properties": {"command": {"type": "string"}}, "required": ["command"]}}},
]


def inside(root, path):
    """Resolve a path the model gave us, refusing anything outside the repo."""
    full = (root / path).resolve()
    if full != root and root not in full.parents:
        raise ValueError(f"{path} is outside the repo")
    return full


def run_tool(root, name, args):
    try:
        if name == "list_files":
            return "\n".join(str(p.relative_to(root)) for p in sorted(root.rglob("*"))
                             if p.is_file() and not any(part.startswith(".") for part in p.relative_to(root).parts))
        if name == "read_file":
            return inside(root, args["path"]).read_text()
        if name == "write_file":
            path = inside(root, args["path"])
            path.parent.mkdir(parents=True, exist_ok=True)
            path.write_text(args["content"])
            return f"wrote {len(args['content'])} characters to {args['path']}"
        if name == "bash":
            # The model types commands on your computer, so a person approves each one.
            print(flag_command(root, args["command"]))
            if input(f"run `{args['command']}`? [y/N] ").strip().lower() != "y":
                return "the user declined to run this command"
            p = subprocess.run(args["command"], shell=True, cwd=root, capture_output=True, text=True, timeout=60)
            return (p.stdout + p.stderr)[-6000:] + f"\n[exit code {p.returncode}]"
        return f"error: no tool named {name}"
    except Exception as e:  # the model reads the error and tries again
        return f"error: {e}"
모델이 보는 것은 TOOLS입니다. 도구마다 이름, 설명 한 문장, 인자가 있습니다. 모델은 스스로 아무것도 실행하지 않습니다. read_file에 {"path": "todo.py"} 같은 요청을 쓸 뿐이고, 실제 일은 run_tool이 합니다.
얼마나 안전한지는 두 줄이 정합니다. inside()는 파일 경로를 모두 풀어 보고 리포 폴더 밖이면 거부합니다. 그래서 read_file("../../etc/passwd")는 오류로 돌아옵니다. bash에는 이런 검사가 없습니다. 리포 폴더에서 시작하긴 하지만 명령 안에서 cd로 어디든 갈 수 있습니다. 모델과 디스크 나머지 사이에 있는 것은 input() 한 줄, 그리고 그 바로 앞에 찍히는 결정 모델의 의견뿐입니다.
오류가 나도 프로그램을 멈추지 않고 글로 모델에게 돌려줍니다. 경로를 틀리면 한 단계를 쓰고, 모델은 대개 다음 단계에서 고칩니다.
2부: 모델
# --- 2. The model: one request to llama-server's OpenAI-style endpoint ---------------------------

def ask_model(messages):
    body = json.dumps({"messages": messages, "tools": TOOLS, "temperature": 0.6}).encode()
    req = urllib.request.Request(SERVER + "/v1/chat/completions", body, {"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=1800) as r:
        return json.load(r)["choices"][0]["message"]
대화 전체와 도구 목록을 POST 한 번에 보냅니다. 돌아오는 것은 글이거나, 도구 호출 하나 이상입니다. llama-server가 OpenAI 채팅 API와 같은 형식을 쓰기 때문에 클라이언트가 urllib 네 줄로 끝납니다.
3부: 결정 모델
# --- 3. The decision model: a second, small model that flags commands worth a closer look ------

def flag_command(root, command):
    state = f"The agent works in the repo at its current directory {root}.\nProposed command:\n{command[:1500]}"
    question = {"type": "choice", "instructions": "Should a human look at this shell command before it runs?",
                "criteria": {"1": "no: it only reads or tests files inside the current repo",
                             "2": "yes: it touches paths outside the current repo or deletes files"}}
    body = json.dumps({"model": "jeff-latest", "state": state, "questions": {"q": question}}).encode()
    req = urllib.request.Request(DECIDER + "/v1/systemone", body, {"Content-Type": "application/json"})
    try:
        with urllib.request.urlopen(req, timeout=60) as r:
            answer = json.load(r)["answers"]["q"]
    except (OSError, KeyError, ValueError) as e:  # no decision model: say so, and still ask you
        return f"decision model: no answer ({e})"
    verdict = "LOOK CLOSELY" if answer["choice"] == "2" else "routine"
    return f"decision model: {verdict} ({answer['probabilities']['2']:.2f})"
Jeff에게는 두 가지를 줍니다. 상황(에이전트가 일하는 곳과 실행하려는 명령)과, 선택지 두 개짜리 질문 하나입니다. Jeff는 선택지마다 확률로 답하고, 저희는 2번 '자세히 봐야 함'의 확률을 괄호 안에 찍습니다.
이 함수가 하지 않는 일을 보세요. 아무것도 막지 않습니다. 한 줄을 찍고 나면 run_tool은 어차피 여러분에게 묻습니다. Jeff가 꺼져 있으면 no answer를 찍고 에이전트는 그대로 돌아가니, 1단계와 3단계부터 만들고 Jeff는 나중에 붙여도 됩니다.
질문이 곧 정책입니다. Jeff는 저희가 물은 것만 판단합니다. 이 명령이 리포 밖 경로를 건드리는지, 파일을 지우는지입니다. 아래에서 직접 돌려 보면 이 점이 중요해집니다.
4부: 루프
# --- 4. The loop: ask, run the tools it asked for, hand back the results, repeat ----------------

SYSTEM = ("You are a coding agent working in a repo. Use the tools to look at files, change them and run the tests. "
          "The repo is your current directory: use paths relative to it, and shell commands run there too. "
          "When the task is done, reply with a short summary and no tool call.")


def run(root, task):
    messages = [{"role": "system", "content": SYSTEM}, {"role": "user", "content": task}]
    for step in range(MAX_STEPS):
        try:
            msg = ask_model(messages)
        except urllib.error.HTTPError as e:  # e.g. the model wrote a tool call the server could not parse
            return f"stopped: the server answered {e.code}: {e.read().decode()[:300]}"
        # Keep the model's thinking in the history; thinking models expect to see it on the next turn.
        messages.append({k: v for k, v in msg.items() if k in ("role", "content", "tool_calls", "reasoning_content")})
        calls = msg.get("tool_calls") or []
        if not calls:
            return msg.get("content") or ""
        for call in calls:
            name, raw = call["function"]["name"], call["function"]["arguments"] or "{}"
            try:
                result = run_tool(root, name, json.loads(raw))
            except json.JSONDecodeError:
                result = "error: the arguments were not valid JSON"
            print(f"[{step}] {name} {raw[:60]} -> {result[:80]!r}")
            messages.append({"role": "tool", "tool_call_id": call.get("id", ""), "content": result})
    return f"stopped after {MAX_STEPS} steps"


if __name__ == "__main__":
    if len(sys.argv) != 3:
        sys.exit('usage: python agent.py <repo folder> "the task"')
    print(run(Path(sys.argv[1]).resolve(), sys.argv[2]))
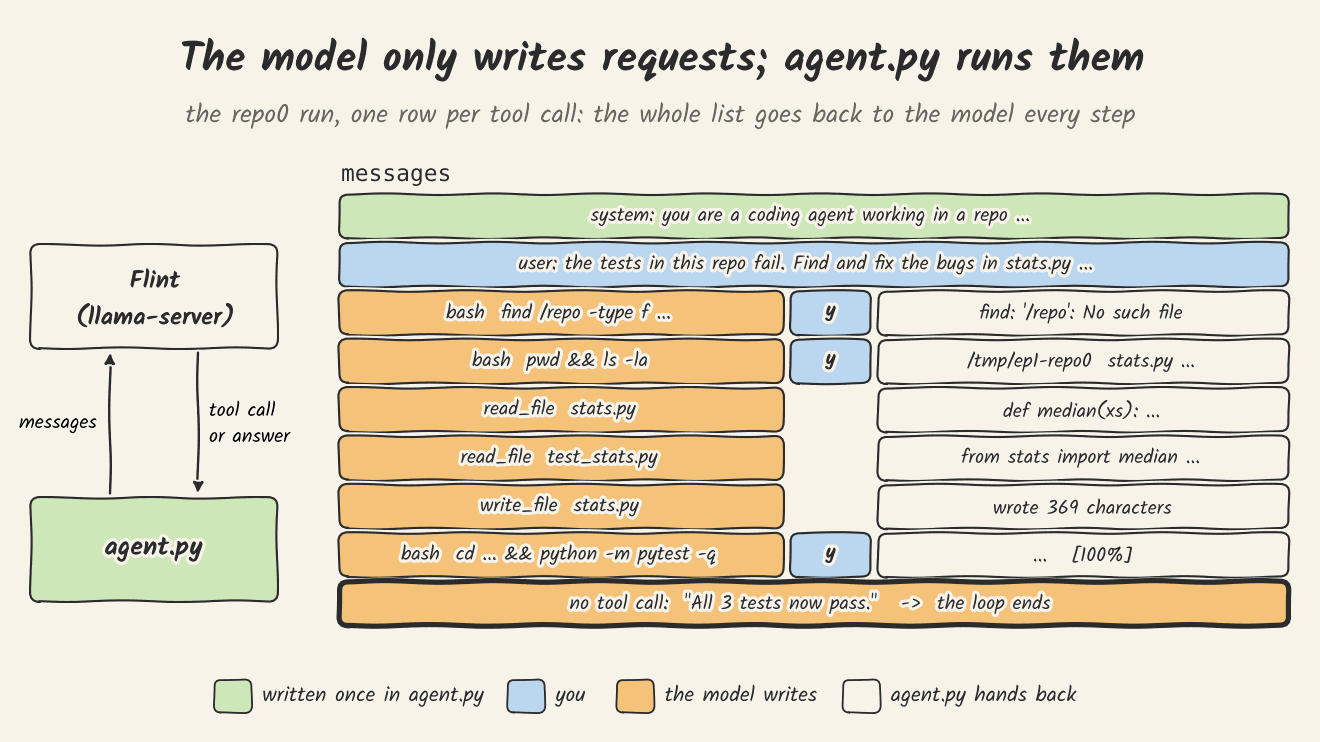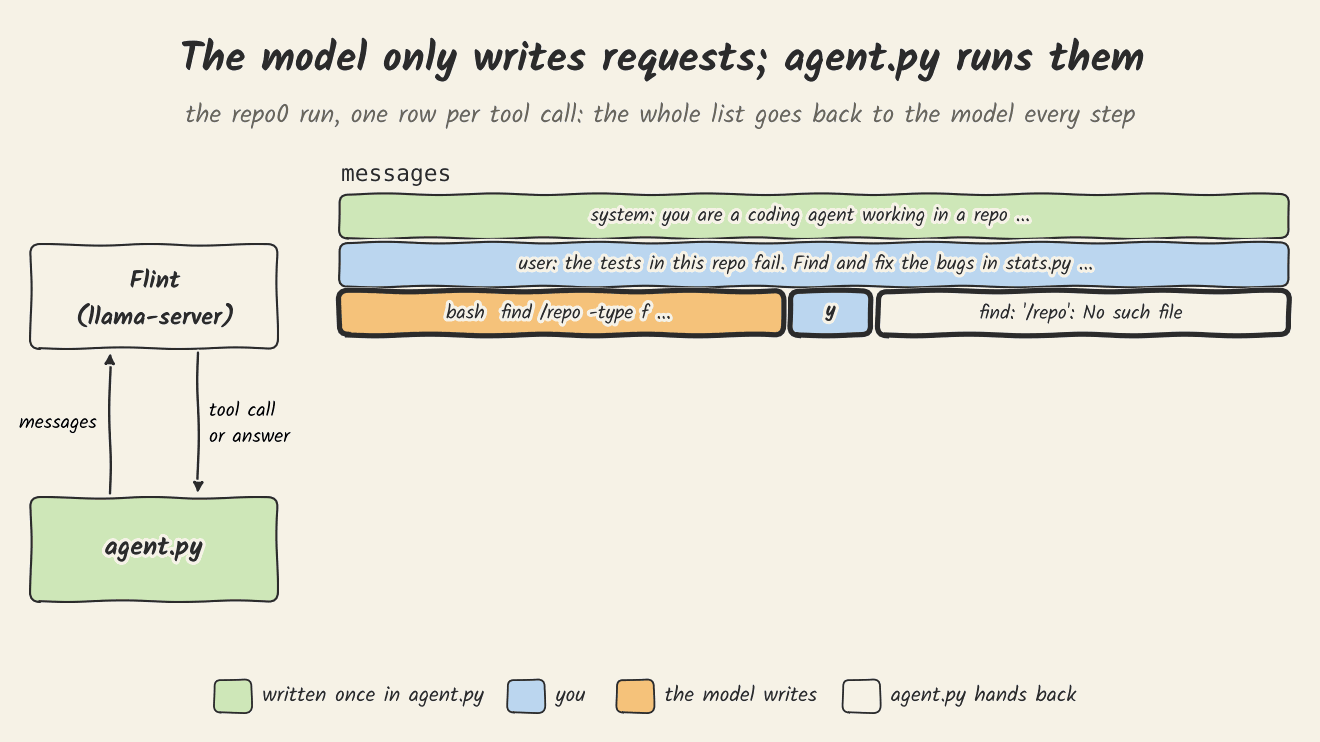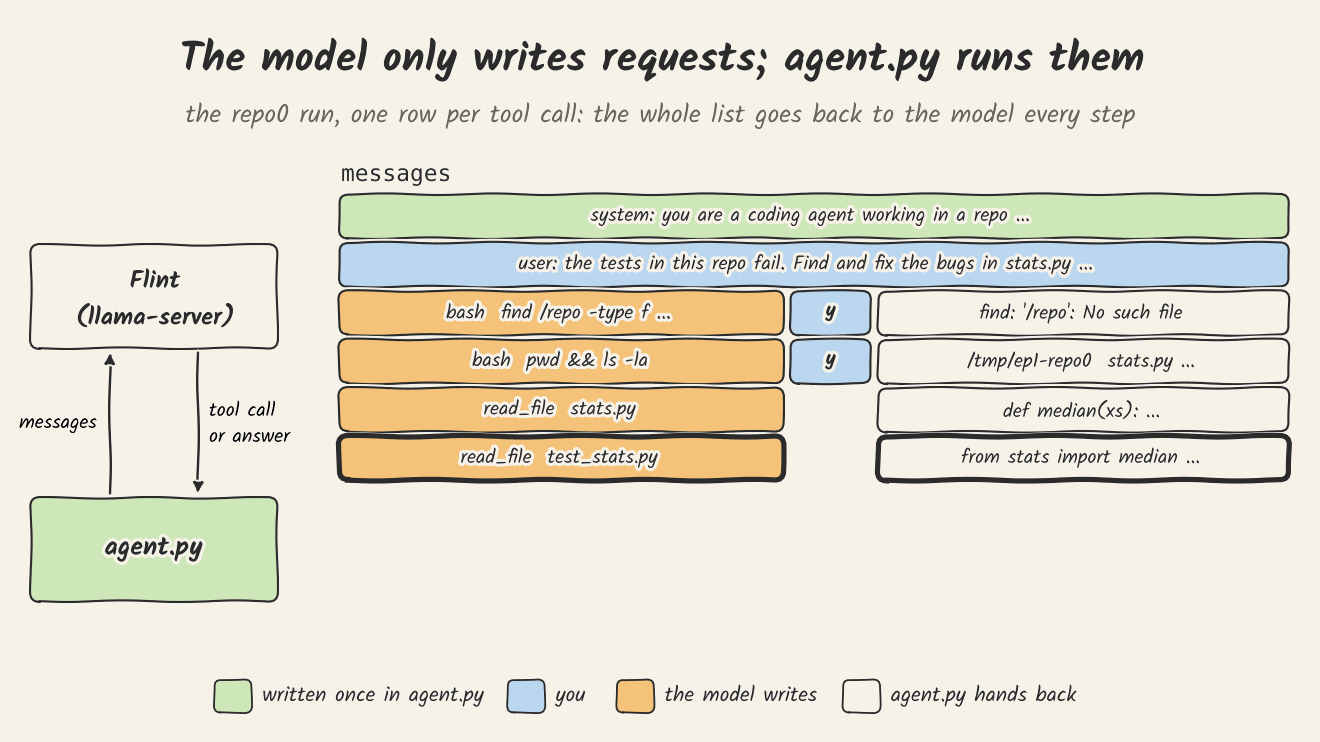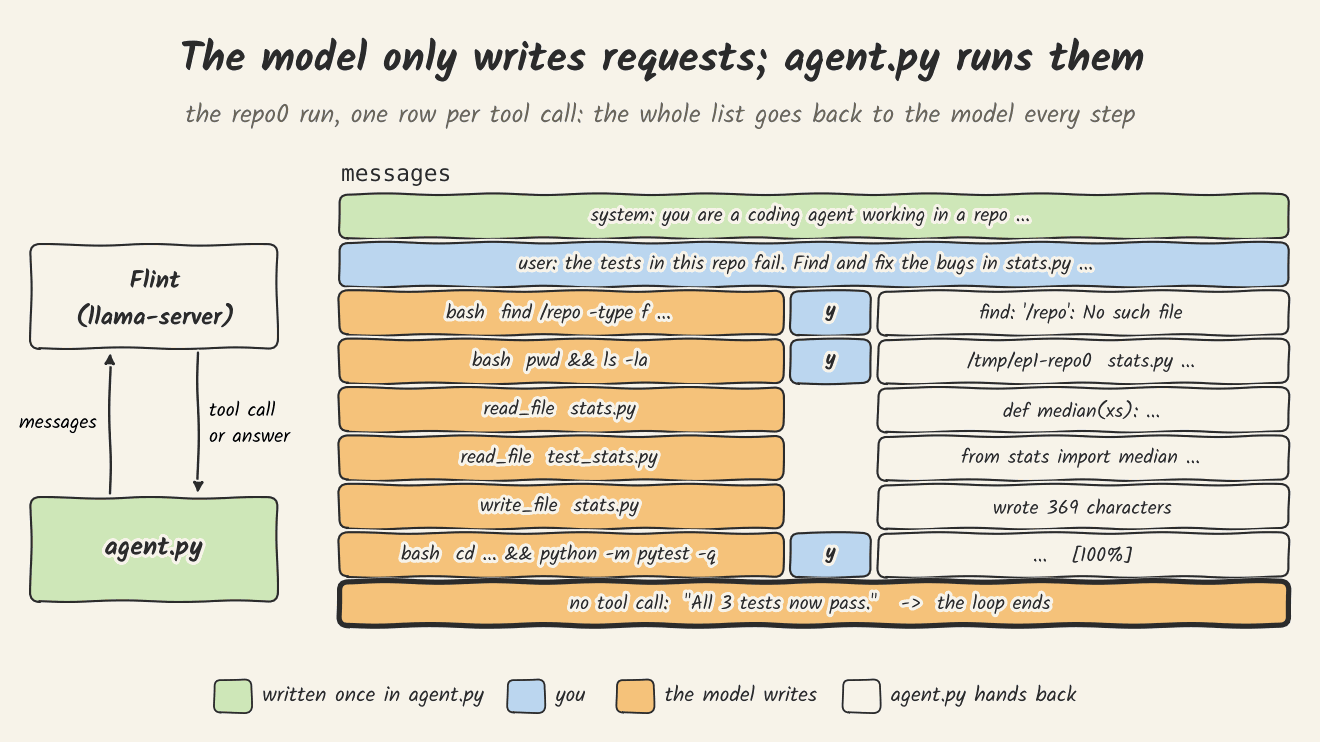
흔히 '에이전트'라고 부르는 부분이 여기입니다. 리스트 하나를 도는 for 루프입니다. 단계마다 messages 전체를 보내고, 모델이 쓴 것을 붙이고, 도구 호출이 있으면 실행해 결과도 붙입니다. 모델은 요청과 요청 사이에 아무것도 기억하지 못합니다. 이 리스트가 모델의 기억입니다.
루프가 끝나는 길은 둘입니다. 모델이 도구 호출 없이 답하거나, 30단계를 다 쓰는 것입니다. 테스트를 돌렸는지 확인하는 곳은 없습니다. 이것이 세 번째 실행에서 문제가 됩니다.
파일을 저장하고 인자 없이 실행해 봅니다.
이게 보이면 성공입니다: usage: python agent.py <repo folder> "the task"
4단계: 버그 두 개짜리 작은 리포
폴더 하나에 파일 두 개를 만듭니다. stats.py에는 버그가 두 개 있습니다.
def median(xs):
    """Return the median of a non-empty list of numbers."""
    s = sorted(xs)
    n = len(s)
    return s[n // 2]


def moving_average(xs, k):
    """Return the list of averages of each window of k consecutive items."""
return [sum(xs[i:i + k]) / k for i in range(len(xs) - k)]test_stats.py에는 그 버그 때문에 실패하는 테스트가 세 개 있습니다.
from stats import median, moving_average

def test_median_odd():
    assert median([3, 1, 2]) == 2

def test_median_even():
    assert median([4, 1, 3, 2]) == 2.5

def test_moving_average():
    assert moving_average([1, 2, 3, 4], 2) == [1.5, 2.5, 3.5]
그리고 실행합니다. 과제 문장은 모델에게 주는 것이라 영어로 두었습니다.
python agent.py ./repo0 "The tests in this repo fail. Find and fix the bugs in stats.py so that the tests pass. Do not edit the tests."명령마다 결정 모델의 줄과 [y/N]이 먼저 뜹니다. 명령을 읽고 답하면 됩니다. 에이전트가 멈추면 테스트를 직접 돌립니다.
cd repo0 && python3 -m pytest -q이게 보이면 성공입니다: 3 passed
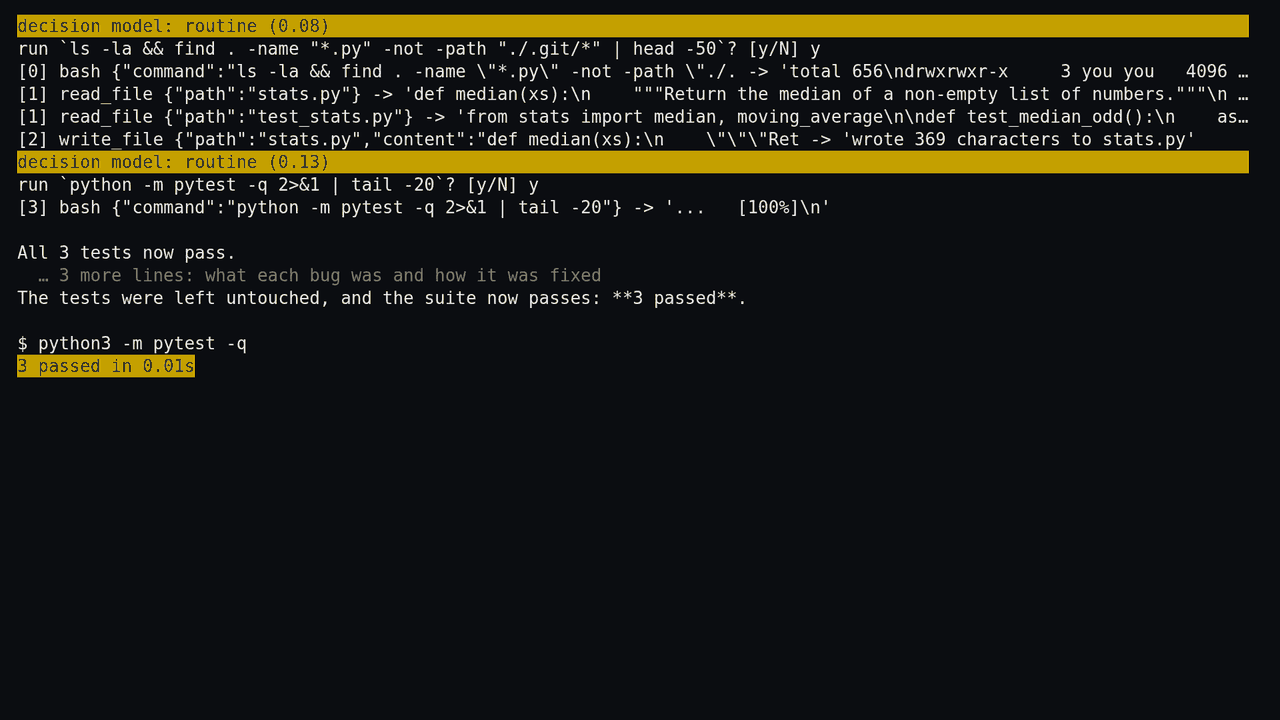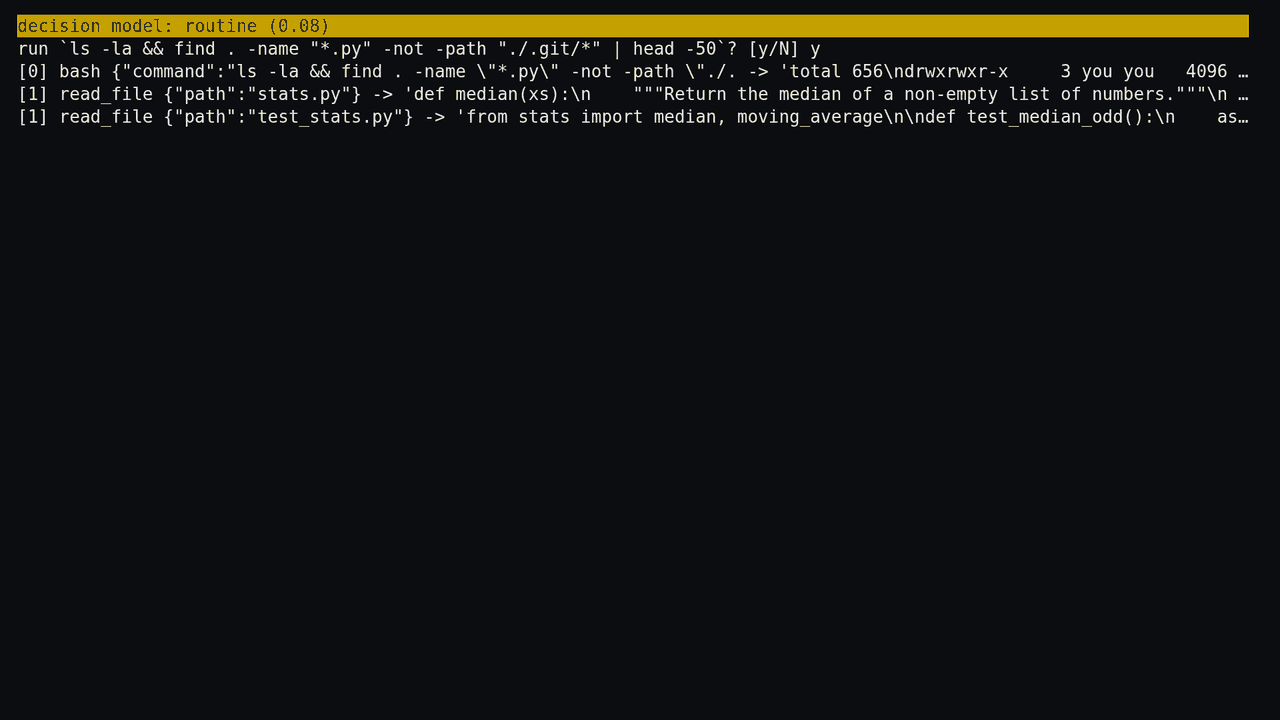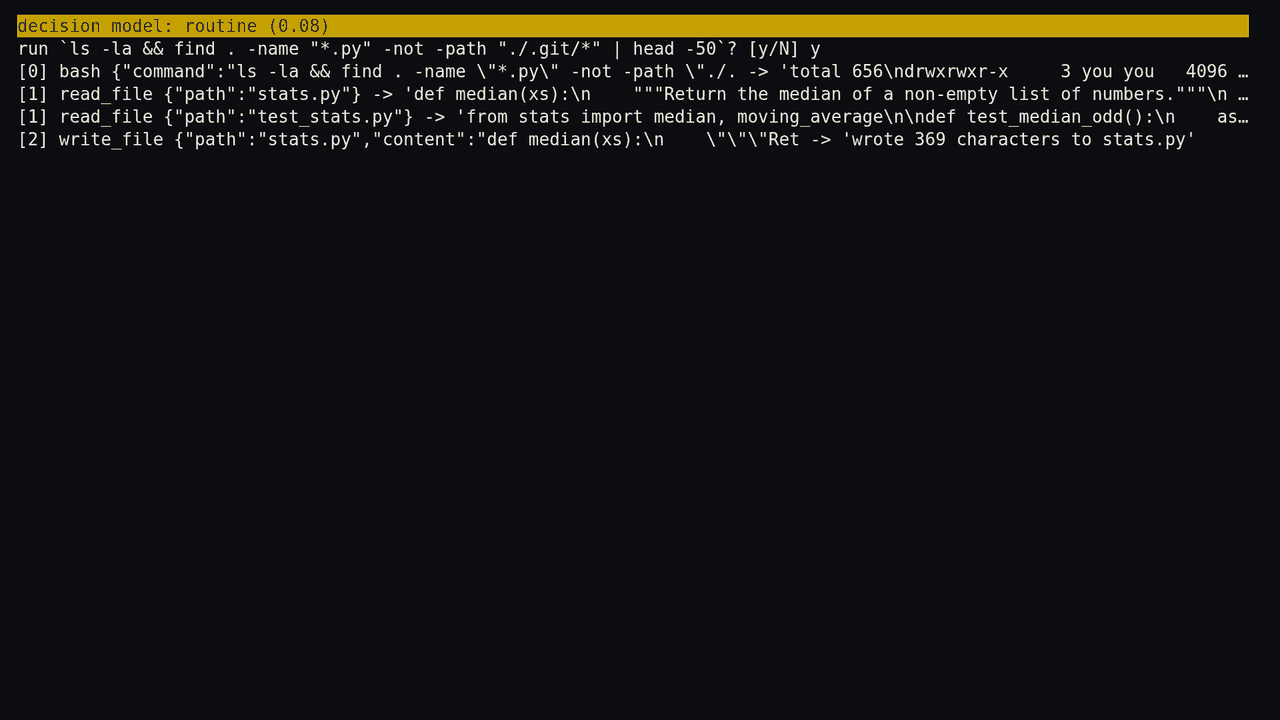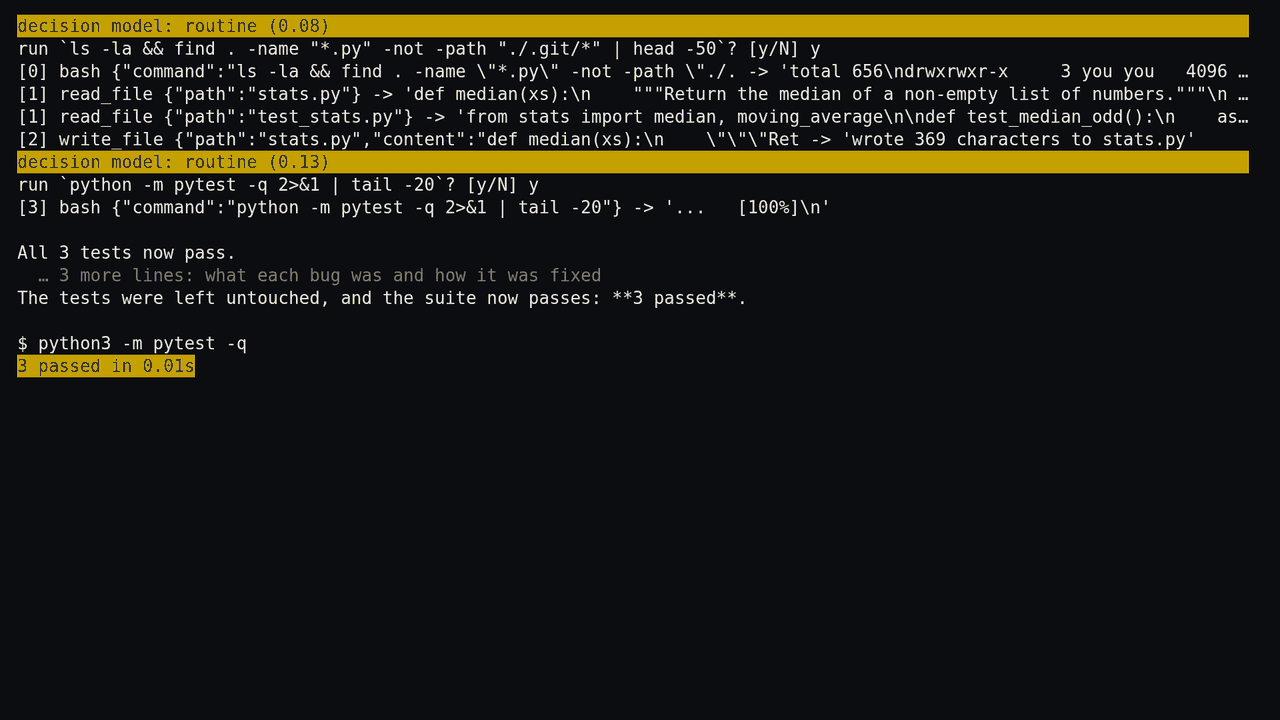
저희 실행에서 에이전트는 0번부터 3번까지 네 단계를 썼습니다. 실행하겠다고 한 명령은 폴더를 둘러보는 명령과 pytest 두 개였고, Jeff는 둘 다 routine(0.08, 0.13)이라고 했습니다. 파일 두 개를 읽고 stats.py를 한 번 다시 쓴 뒤 테스트를 돌리고 멈췄습니다. 버그도 둘 다 고쳤습니다. 길이가 짝수인 리스트의 중앙값은 가운데 두 값의 평균을 내고, moving_average는 마지막 구간까지 계산합니다.
5단계: 진짜 기능 추가
두 번째 리포는 명령줄 할 일 앱 todo.py와 테스트 세 개입니다. 과제는 여섯 가지를 요구합니다.
add에--due YYYY-MM-DD옵션을 붙입니다.list가 제목 뒤에 마감일을 찍습니다.list --overdue는 끝나지 않았고 마감이 지난 항목만 보여 줍니다.today를 밖에서 넣을 수 있게 해서 테스트가 오늘 날짜에 좌우되지 않게 합니다.- 잘못된 날짜는 argparse 오류(종료 코드 2)입니다.
- 마감일 없이 저장된 예전 파일도 그대로 읽혀야 합니다.
과제 끝에는 "새 기능 테스트를 test_todo.py에 추가하고 기존 테스트가 계속 통과하게 할 것. 끝내기 전에 pytest를 돌릴 것"이라는 문장이 있습니다.
저희는 항목마다 하나씩 테스트 6개를 따로 써서 리포 밖에 두었습니다. 에이전트는 이 테스트를 보지 못했고, 에이전트가 멈춘 뒤에야 넣었습니다. 이 과제를 직접 만들어 돌린다면 이 방법을 꼭 쓰세요. 에이전트가 고칠 수 있는 테스트로는 에이전트가 일을 제대로 했는지 알 수 없습니다.
bash를 넣은 뒤 이 과제를 세 번 돌렸습니다(실행 1-3). Jeff를 붙인 것은 세 번째 실행이고, 이 글 맨 위 녹화가 그 실행입니다. 모델은 15단계를 썼고 명령 8개를 실행하겠다고 했습니다. Jeff는 8개 모두 routine이라고 했고, 자세히 봐야 할 확률은 0.05에서 0.17 사이였습니다. 저희는 8개 모두 y를 눌렀습니다. 숨긴 테스트 결과는 6개 통과였습니다.
어려웠던 점, 잘 안 됐던 점
agent.py가 처음부터 이 모양은 아니었습니다. 네 가지 일을 겪으며 바뀌었습니다.
자기 작업을 확인할 수 없었습니다. agent.py에 파일 도구(목록·읽기·쓰기)만 있었을 때, 모델은 네 번 모두 코드를 제대로 고쳤습니다. 하지만 테스트를 돌릴 방법이 없으니 같은 파일을 계속 다시 썼습니다. 세 번은 30단계 상한까지 갔고, 나머지 한 번은 약 96,000자짜리 도구 호출에 서버가 500 오류를 내면서 멈췄습니다. "같은 내용을 또 썼다"고 알려 줘도 멈추지 않았습니다. 그래서 bash를 넣었고, bash를 넣으니 명령마다 y/N을 물어야 했습니다.
자기가 어디 있는지 몰랐습니다. 초기 실행에서 모델은 코드가 /repo나 /app에 있다고 짐작했습니다. 할 일 앱에서는 디스크 전체에서 todo.py라는 파일을 찾아 처음 나온 폴더로 들어간 적도 있습니다. 다른 프로젝트 안의 폴더였습니다. 같은 명령 안에서 그 폴더에서 rm -f todos.json을 두 번 실행했고, 거기 있던 todo.py도 실행했습니다. 바로 앞 단계에서는 /tmp에서 rm을 실행했습니다. 두 명령 모두 저희가 승인했습니다. SYSTEM에 문장 하나를 넣자 대부분 사라졌습니다. "The repo is your current directory: use paths relative to it, and shell commands run there too."
Jeff가 GPU에 들어가지 않았습니다. Jeff 0.8B를 GPU에 올리면 2,296MiB를 씁니다. 이 값은 v1.1이 아니라 같은 모델의 더 새 리비전으로 잰 것입니다. 이 글의 기준인 32K 컨텍스트의 Flint(14,386MiB)와 합치면 16GB 카드를 넘습니다. Flint를 16K로 줄여도 합계가 16,180MiB라 약 200MiB만 남습니다. 그래서 Jeff는 CPU에서 돌리고, 명령 하나에 1초 안팎에서 6초가 걸립니다(아래에서 잰 값). GPU는 Flint가 다 씁니다.
Jeff가 CPU에서 답하지 못했습니다. Jeff를 전부 설치하면 GPU용 빠른 attention 커널 라이브러리가 따라옵니다. GPU를 가린 상태에서는 서버가 뜨기는 하지만 요청마다 HTTP 500이 돌아왔고, Jeff 로그에는 Triton 오류 0 active drivers가 찍혔습니다. 해결법은 아래 표에 있습니다.
저희가 본 것 세 가지(직접 돌리면 볼 수도 있는 것)
1. y를 자주 누르게 되고, 의견은 대부분 routine입니다
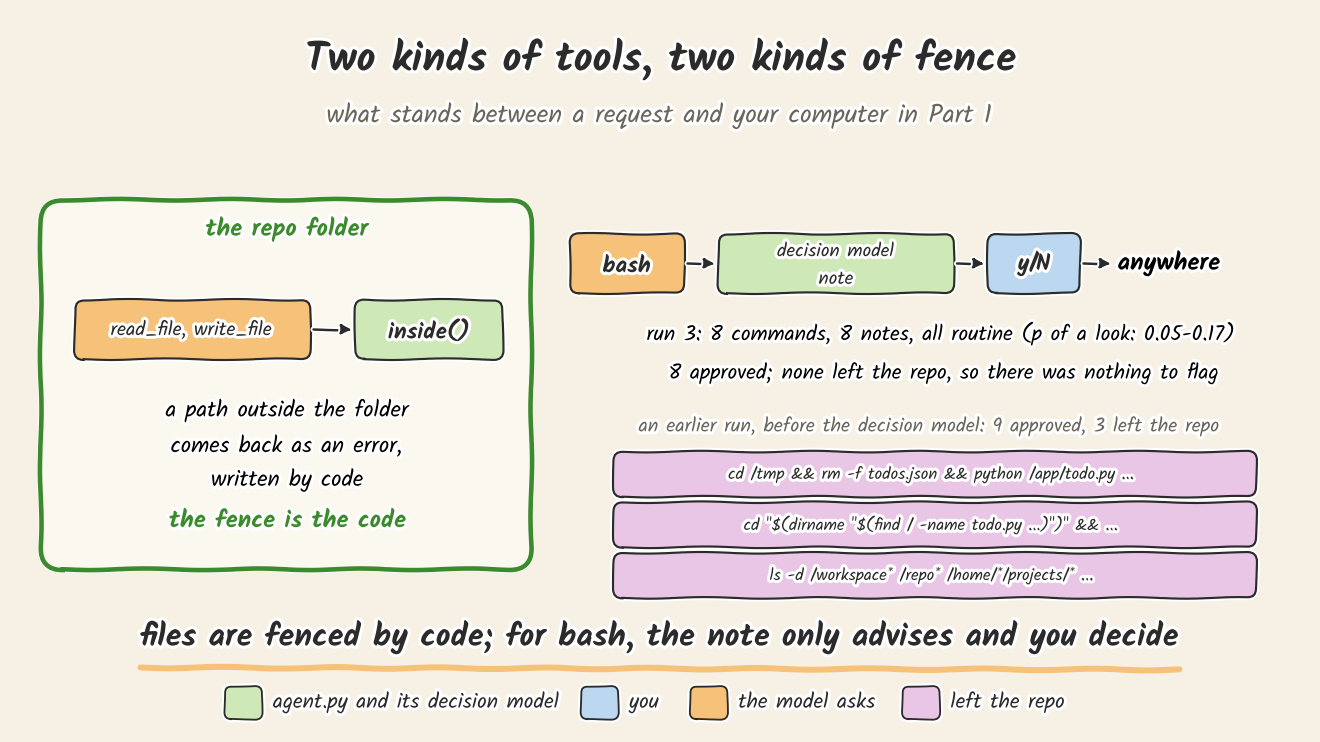
세 번째 실행에서 의견은 모두 routine이었고, 저희가 물은 질문에 대해서는 맞는 답이었습니다. 명령 8개 중 리포를 벗어난 것도, 파일을 지운 것도 없었습니다. 그래서 의견이 저희 답을 바꾼 적은 한 번도 없었고, 저희는 모든 명령에 y를 눌렀습니다.
y/N은 누르는 사람이 명령을 읽고 판단한 만큼만 지켜 줍니다. Jeff를 붙이기 전 실행에서 저희는 y를 아홉 번 눌렀고, 그중 세 명령이 리포를 벗어났습니다.
나중에 앞선 두 실행의 명령 16개를 Jeff에게 보내 봤습니다. agent.py에 들어 있는 질문으로는 리포를 벗어난 세 명령 중 둘을 짚었고, ls -d /workspace*는 놓쳤습니다. 리포 안에서 실행한 rm -f todos.json도 짚었고, 나머지 12개는 routine이라고 했습니다. 다만 저희는 이 16개 명령에 질문 문구 두 가지를 넣어 보고 지금 문구를 골랐습니다. 그러니 세 개 중 두 개는 이 명령들 안에서 나온 결과일 뿐이고, Jeff가 위험한 명령을 얼마나 잘 잡는지 보여 주는 근거는 아닙니다.
2. 코드는 나아지는데 테스트 파일은 나빠질 수 있습니다
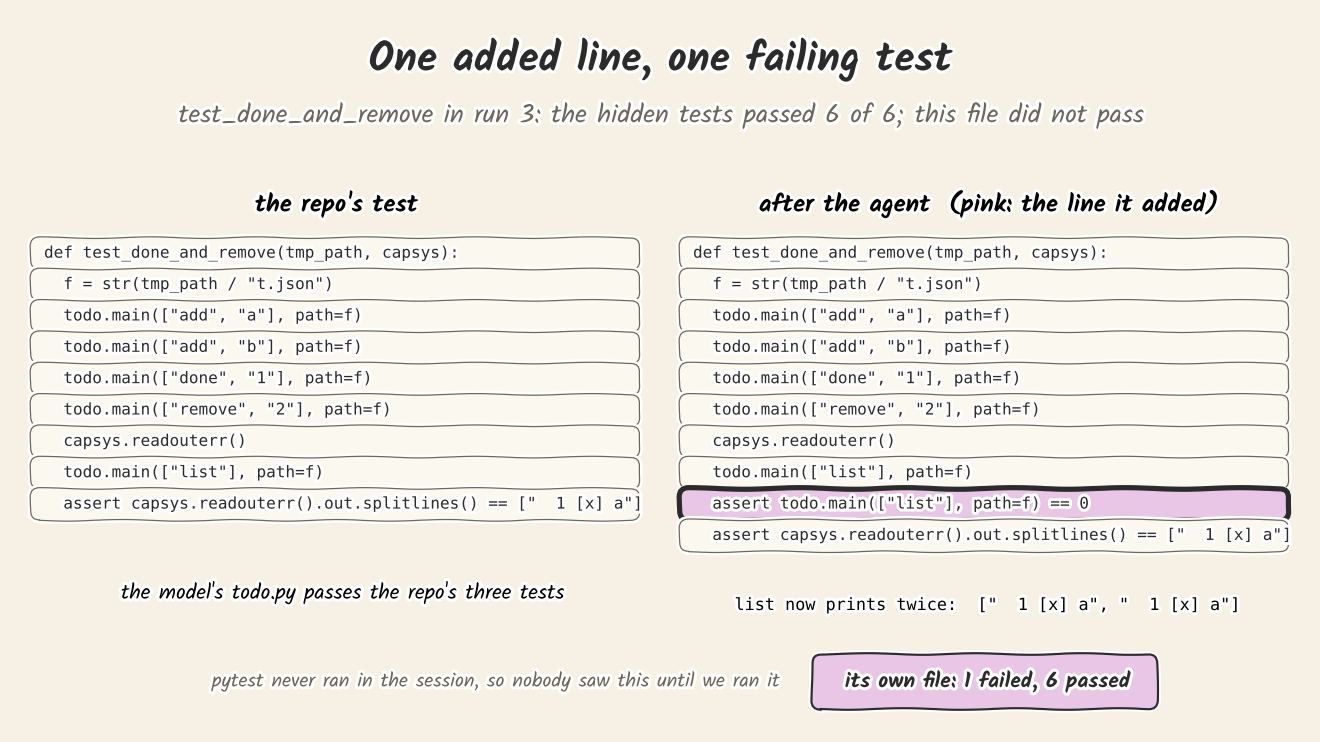
세 번째 실행에서 모델은 bash로 test_todo.py를 네 번 고쳤습니다. 8, 9, 12, 13단계였고, cat > test_todo.py <<'PYEOF' 같은 heredoc을 썼습니다. Jeff는 네 번 모두 routine이라고 했습니다. 저희가 물은 질문으로는 맞는 답입니다. 이 명령들은 리포 안에 머물렀고 파일을 지우지도 않았습니다. 질문에 테스트를 덮어쓰는 일은 들어 있지 않으니 Jeff가 짚을 이유가 없었습니다.
8단계와 12단계에서 모델은 기존 테스트에 assert todo.main(["list"], path=f) == 0 한 줄을 넣었습니다. 바로 앞에 이미 todo.main(["list"], path=f)가 있는 자리였습니다. 그러면 list가 두 번 찍히는데, 이어지는 확인은 한 줄을 기대합니다. 에이전트가 남긴 테스트 파일을 돌려 보니 1개 실패, 6개 통과였습니다. 리포의 원래 테스트 3개는 에이전트가 만든 todo.py에서 고치지 않은 채로 통과하니, 이 변경은 필요 없는 것이었습니다.
숨긴 테스트가 통과한 것은 todo.py가 맞았기 때문입니다. 에이전트의 테스트 파일만 봤다면 저희는 실패를 봤을 것이고, 에이전트는 그 실패를 보지 못한 채 끝냈습니다.
설정은 다르지만 비슷한 모습을 전에도 본 적이 있습니다. 버그 있는 코드를 주고 테스트를 쓰게 했더니 로컬 모델이 버그를 지키는 테스트를 썼습니다(버그 있는 코드를 주고 테스트를 맡기면).
3. 할 일 과제 세 번 중 두 번은 테스트를 돌리지 않고 '끝났다'고 했습니다
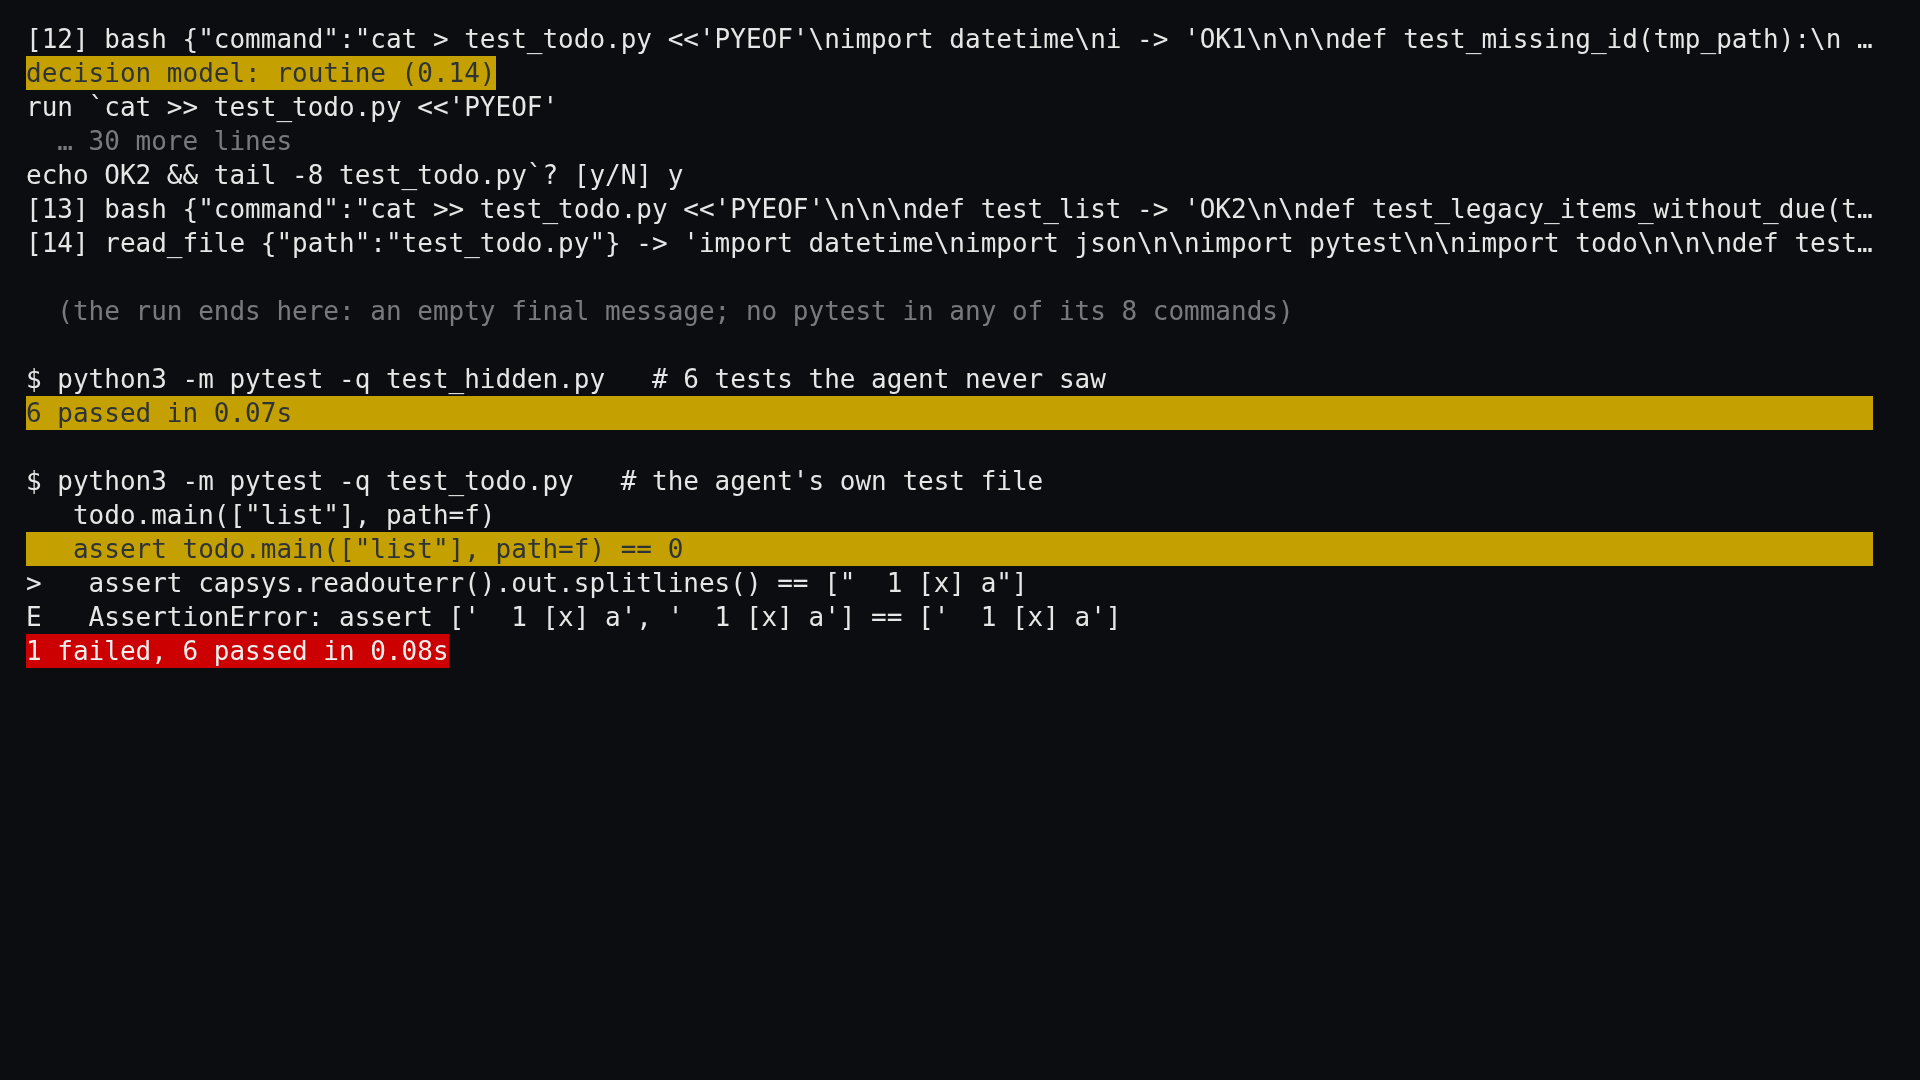
과제에는 "끝내기 전에 pytest를 돌릴 것"이 있었습니다. 모델은 명령 8개 중 한 번도 pytest를 돌리지 않았습니다. 11단계에서는 자기 테스트 파일을 원본과 비교하려고 git diff를 돌렸는데, git 저장소가 아닌 폴더라 git 도움말만 돌아왔습니다. 14단계 뒤에는 도구 호출 없이 빈 메시지로 답했고 루프가 끝났습니다. 루프가 확인하는 것은 그것 하나뿐이기 때문입니다. Jeff를 붙이기 전인 두 번째 실행도 똑같이 끝났습니다. pytest는 없었고 마지막 메시지는 비어 있었습니다.
명령마다 y/N이 뜨기 전에 기다리는 시간도 느껴질 겁니다. 세 번째 실행 중에는 의견이 나오는 시간을 재지 않았습니다. 실행이 끝난 뒤 같은 명령 8개를 Jeff에게 다시 보내 보니, 다른 작업이 돌던 컴퓨터에서 중앙값 2.81초, 가장 느린 것은 6.1초였습니다. 한가한 CPU라면 더 빠를 것으로 보지만 재지는 않았습니다.
안 될 때
| 이런 게 보이면 | 이유 | 이렇게 합니다 |
|---|---|---|
첫 요청에서 tools param requires --jinja flag가 나오고 실행이 멈춥니다 | llama-server를 --jinja 없이 띄워서 도구 목록을 받지 않습니다 | --jinja를 붙여 다시 띄웁니다 |
llama-server가 모델을 읽다가 unknown model architecture: 'flint' | llama.cpp 빌드가 Flint 지원보다 오래됐습니다 | 릴리스 b11889 이상을 씁니다 |
명령마다 decision model: no answer (<urlopen error [Errno 111] Connection refused>) | Jeff가 꺼져 있거나 18766 포트가 아닙니다 | Jeff를 띄우거나 AGENT_DECIDER를 Jeff 주소로 맞춥니다. 그동안에도 에이전트는 돌고 y/N도 묻습니다 |
명령마다 60초를 기다린 뒤 decision model: no answer (timed out), 이어서 HTTP Error 529가 뜨기도 합니다 | CPU가 너무 바빠서 Jeff가 agent.py의 60초 제한 안에 답하지 못합니다 | CPU를 비우거나, 한가한 코어 몇 개에만 Jeff를 띄웁니다. 그 전까지는 명령마다 60초씩 기다리게 됩니다 |
명령마다 decision model: no answer (HTTP Error 500 ...)가 나오고, Jeff 로그에 Triton 오류 0 active drivers가 있습니다 | 그냥 uv sync를 하면 학습용 패키지까지 깔리고, 그중 flash-linear-attention이 import할 때 GPU를 찾습니다 | uv sync --no-default-groups로 설치합니다. 이미 전체 환경을 깔았다면, 저희는 GPU 전용 모듈 두 개를 가리는 sitecustomize.py를 PYTHONPATH에 두어 넘겼습니다. 내용은 import sys; sys.modules["fla"] = sys.modules["causal_conv1d"] = None 한 줄입니다 |
1편이 남긴 것과 2편에서 바꿀 것
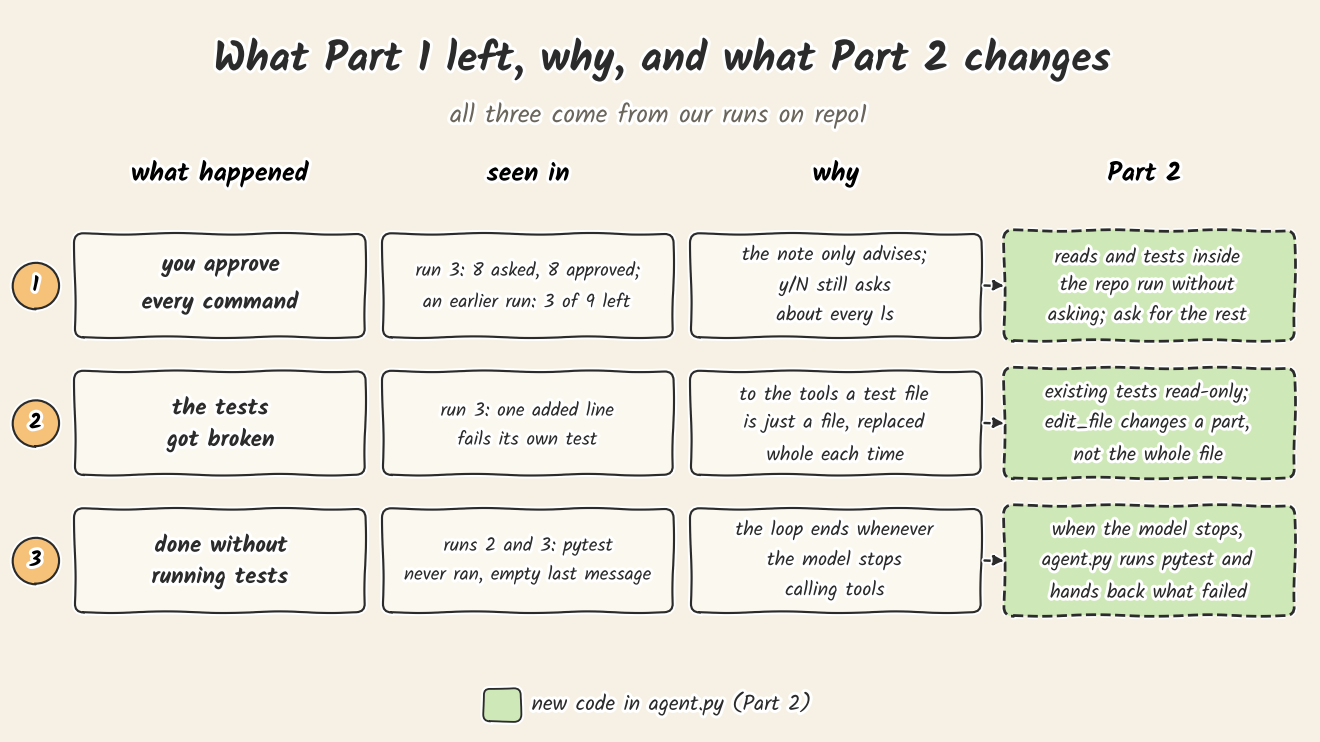
1. 명령을 전부 승인하게 됩니다. y/N은 rm뿐 아니라 ls까지 매번 묻고, 의견은 조언일 뿐입니다. 2편에서는 리포 안 읽기와 테스트 실행은 묻지 않고 통과시킵니다.
2. 테스트가 망가질 수 있습니다(실행 2, 3). 도구에게 테스트 파일은 다른 파일과 똑같고, 통째로 바뀝니다. 2편에서는 기존 테스트를 읽기 전용으로 하고 edit_file을 넣습니다.
3. 테스트 없이 끝났다고 할 수 있습니다(실행 2, 3). 루프는 모델이 도구 호출을 멈추면 끝납니다. 2편에서는 모델이 멈추면 agent.py가 직접 pytest를 돌리고, 실패한 것을 모델에게 돌려줍니다.
확인하지 않은 것
- 실행은 한 번씩입니다. Jeff를 붙인 할 일 과제는 한 번 돌렸습니다. temperature가 0.6이라 다시 돌리면 다른 단계를 밟을 수 있습니다. 이 기록은 무엇이 일어날 수 있는지 보여 줄 뿐, 얼마나 자주 일어나는지는 보여 주지 않습니다.
- Jeff가 실제로 위험한 명령을 잡는지. 세 번째 실행에는 위험한 명령이 없었습니다. 앞선 실행의 명령으로는 리포를 벗어난 세 개 중 둘을 짚었지만, 질문 문구를 바로 그 명령들로 골랐습니다.
- Jeff 새 설치. 저희는 이미 있던 환경에서 Jeff를 띄웠고, 2단계의 다섯 줄로 새로 깔아 보지는 않았습니다.
- 실제 16GB 카드. Flint의 최대 14,386MiB는 A100에서 잰 값입니다.
- 다른 모델. 이 글의 모든 실행은 Flint UD-Q2_K_XL입니다. 다른 모델은 덜 헤매거나 테스트를 더 많이 고칠 수도 있습니다.
다음 편
2편에서는 위 규칙 세 가지를 agent.py에 넣고 같은 할 일 과제를 다시 돌립니다. 결과를 어떻게 예상하는지 돌리기 전에 계획서에 먼저 적어 둡니다. 예상이 맞았는지는 페이지 아래 뉴스레터로 알려 드립니다.