Ollama 판단 모델을 Jev와 같은 문항으로 재 봤습니다: Nimble과 Tev1
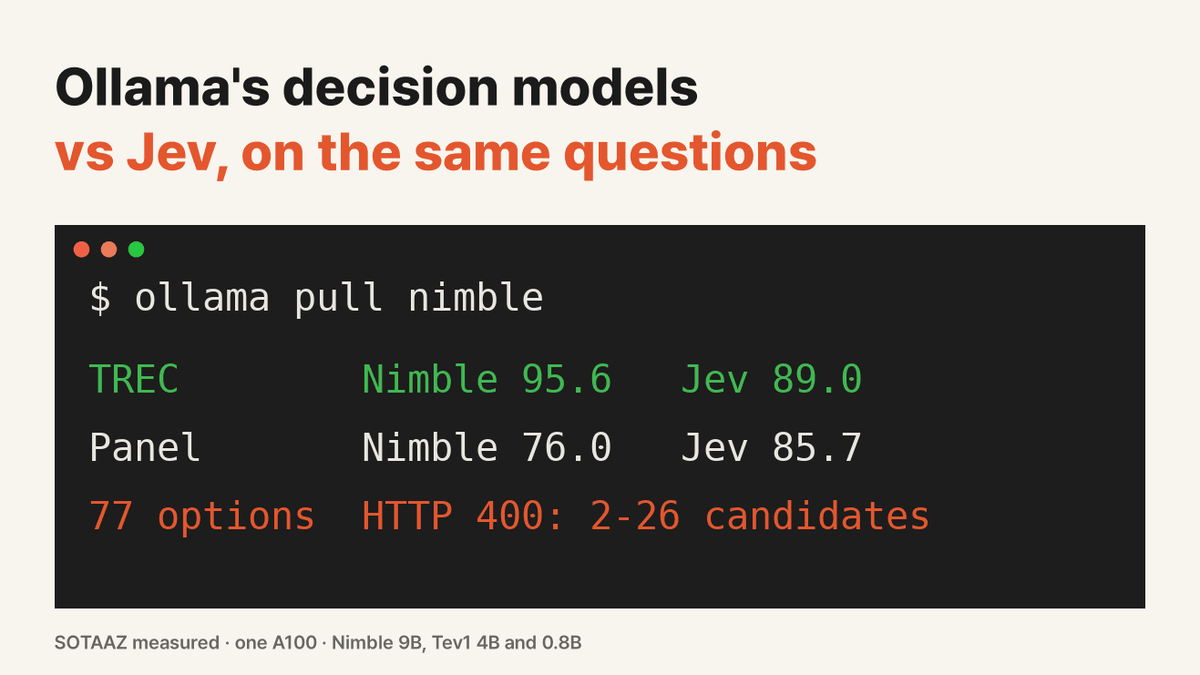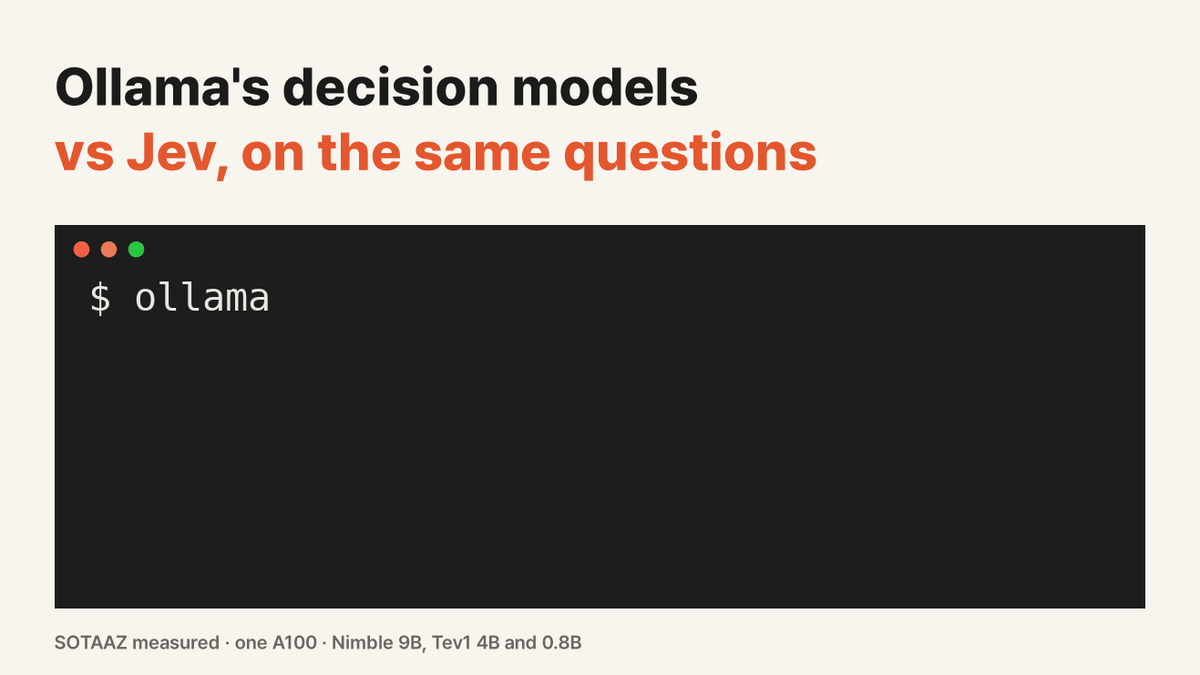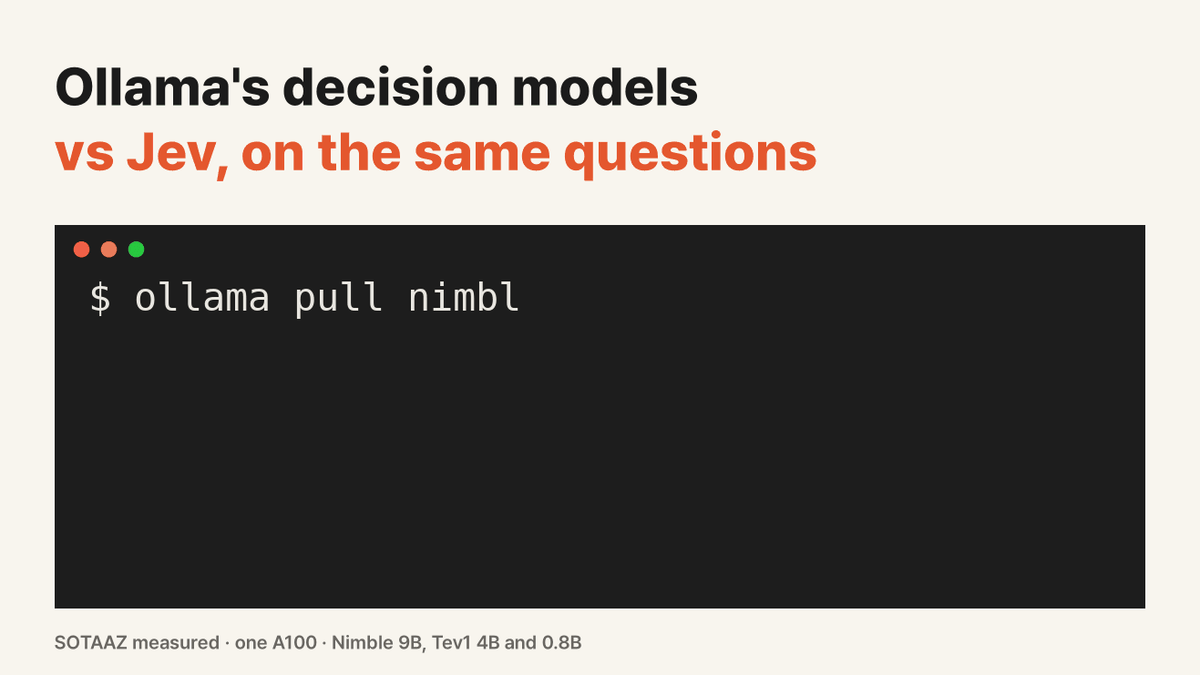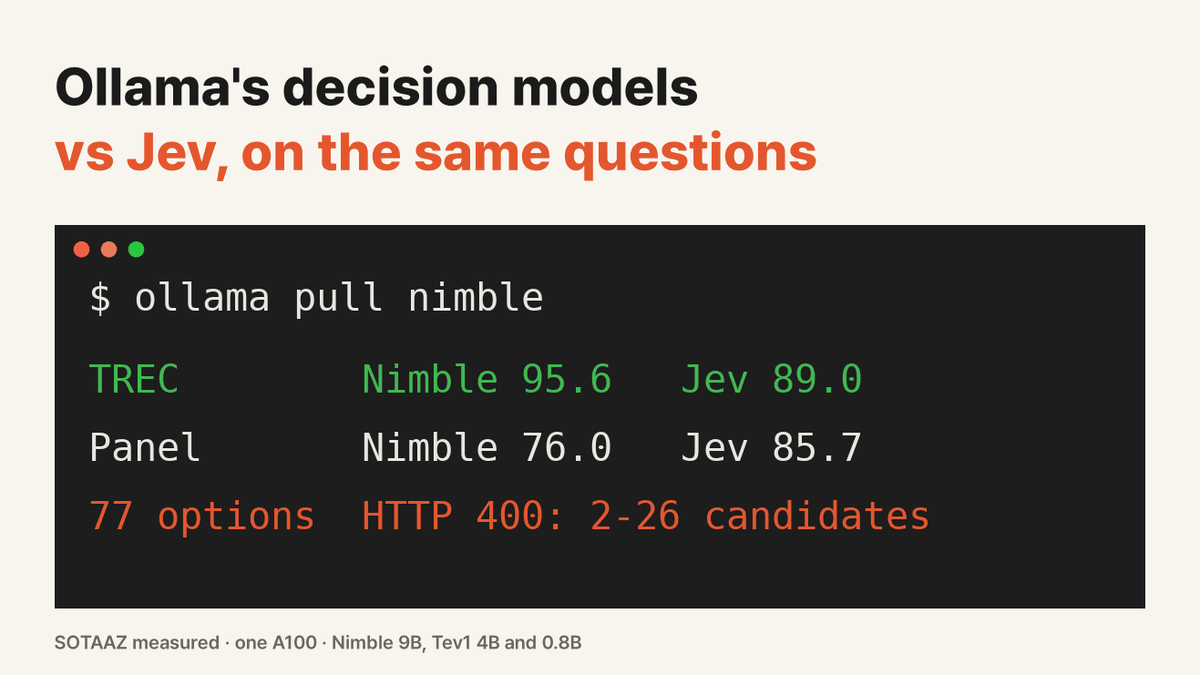
Ollama 0.35가 Jev식 판단 모델을 로컬에서 돌립니다. 같은 문항에서 Nimble 9B는 TREC 95.6%로 Jev(89.0%)를 앞섰고, 추론 위주 4,599문항에서는 76.0 대 85.7로 뒤졌습니다. 선택지가 26개를 넘는 질문은 Ollama 엔드포인트가 세 모델 모두 거절했습니다.
Ollama 판단 모델을 Jev와 같은 문항으로 재 봤습니다: Nimble과 Tev1
9월 28일에 나온 Ollama 0.35에 /v1/systemone 엔드포인트가 생겼습니다. Jev의 API를 그대로 따릅니다. 상태와 유형이 정해진 질문을 보내면, 로컬 모델이 글 대신 선택지마다 확률을 돌려줍니다. 함께 나온 모델은 셋입니다. Bespoke Labs의 Nimble(9B)과 Together AI의 Tev1(4B, 0.8B)이고, 모두 Qwen3.5를 파인튜닝했습니다.
Jev, Kev, Jeff는 이미 같은 문장으로 재 둔 상태였습니다. 그래서 같은 측정 도구의 주소만 Ollama로 바꿔 세 모델을 돌렸습니다. 앞선 글들의 분류 조건 다섯 개와, Jeff vs Jev에서 쓴 4,599문항 패널입니다.
요약
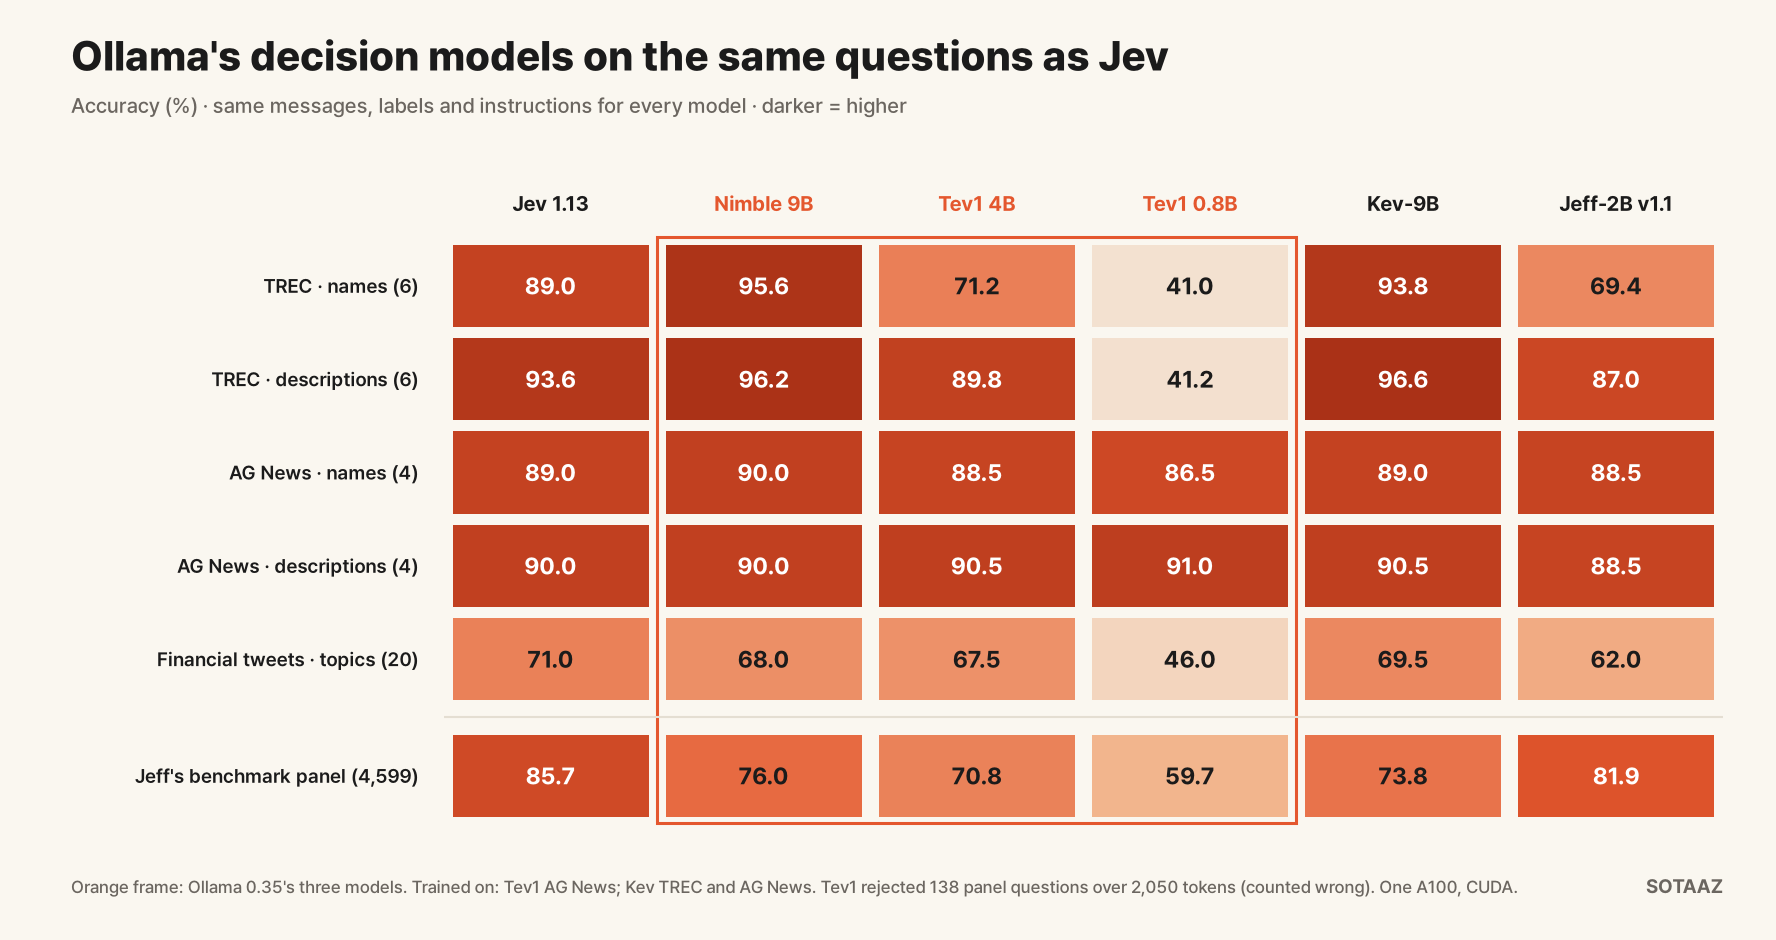
- 짧은 분류 과제에서는 Nimble이 Jev와 같거나 앞섰습니다. TREC은 95.6% 대 89.0%(p < 0.001)였고, AG News와 금융 뉴스 트윗은 어느 쪽으로든 3점 이내라 통계적 차이가 없었습니다.
- 추론 위주 패널에서는 Jev가 크게 앞섰습니다. 85.7 대 76.0이었고, WinoGrande와 BBH에서 차이가 가장 컸습니다.
- Ollama 엔드포인트는 선택지가 26개를 넘는 질문을 세 모델 모두 거절했습니다. 틀린 답을 내는 대신 분명한 오류를 돌려줍니다. 의도 77개짜리 BANKING77은 질문 하나로 보낼 수 없습니다.
- Tev1 0.8B는 TREC과 패널 종합에서 크게 낮았습니다(41%, 59.7). 다만 AG News 설명 추가 조건에서는 여섯 모델 중 가장 높았습니다. Tev1은 두 크기 모두 약 2,050토큰이 넘는 입력을 거절합니다.
Ollama에서 돌리기
Ollama에는 Jev 자체가 들어 있지 않습니다. Jev는 TypeSafe가 운영하는 API이고, Ollama 라이브러리에는 jev 모델이 없습니다(10월 4일 확인). Ollama 0.35가 추가한 것은 Jev와 요청·응답 형식이 같은 /v1/systemone 엔드포인트와, 거기에 답하는 로컬 모델 세 개입니다. 이미 Jev를 쓰고 있다면 주소와 모델 이름을 바꾸고 API 키 헤더를 빼면 됩니다.
먼저 모델을 받고, 서버 버전이 0.35 이상인지 확인합니다.
ollama pull nimble        # 9.5GB. tev1:4b는 4.5GB, tev1:0.8b는 0.8GB
curl -s http://localhost:11434/api/version
그다음 상태와 질문을 보냅니다. 아래는 선택지 설명을 붙인 TREC 측정에서 하네스가 첫 번째 시험 문항에 실제로 보낸 요청 그대로입니다. 문항 문장은 데이터셋에 적힌 모양 그대로 두었습니다.
curl -s http://localhost:11434/v1/systemone -H 'Content-Type: application/json' -d '{
  "model": "nimble",
  "state": "How far is it from Denver to Aspen ?",
  "questions": {
    "intent": {
      "type": "choice",
      "instructions": "What kind of answer does this question ask for?",
      "criteria": {
        "abbreviation": "an abbreviation or what it stands for",
        "entity": "a thing, such as an animal, product, color, event, substance or term",
        "description": "a definition, explanation, reason or manner",
        "human": "a person, a group of people or an organization",
        "location": "a place, such as a city, country, mountain or state",
        "numeric": "a number, such as a date, count, distance, price or percentage"
      }
    }
  }
}'
Nimble의 응답입니다.
{"model": "nimble", "answers": {"intent": {"type": "choice", "choice": "numeric", "probabilities": {"abbreviation": 0.000131805257339387, "entity": 0.0002858253588729726, "description": 0.00029337022364426277, "human": 0.00015459642361178205, "location": 0.0005109321678204479, "numeric": 0.9986234705687111}, "confidence": 0.9930231414363588}}, "usage": {"input_tokens": 268, "output_tokens": 1}}10월 1일 측정에서 이 문항에 기록된 확률, confidence와 같은 값입니다. 요청과 응답은 drafts/jev-bench/results/ollama-systemone-example-2026-10-04.json에 저장해 두었습니다.
이 위에 무언가를 만들기 전에 알아 둘 것이 네 가지 있습니다.
criteria에는 선택지를 2개에서 26개까지 넣을 수 있습니다. 더 넣으면 아래에서 설명하는 대로 HTTP 400으로 거절됩니다. 후보를 먼저 줄여서 보내야 합니다.- 선택지 설명은 빼도 되지만 결과가 달라집니다.
criteria의 값은null이어도 됩니다. 다만 선택지마다 한 줄 설명을 붙이자 Tev1 4B의 TREC 정확도가 71.2%에서 89.8%로 올랐습니다. confidence는 가장 높은 확률과 다른 값입니다. 위 응답에서confidence는 0.993인데numeric의 확률은 0.9986입니다. 이 글의 보정 수치는probabilities로 계산했습니다.- Ollama가 어느 GPU 백엔드를 골랐는지 확인하세요. 이 서버에서 Ollama는 A100을 Vulkan과 CUDA 두 장치로 인식했고, 기본으로 Vulkan을 골랐습니다.
OLLAMA_LLM_LIBRARY=cuda_v13으로 CUDA를 쓰게 했고, 정확도는 어느 쪽이든 같았습니다. Ollama 0.35에서 NVIDIA 그래픽카드가 유난히 느리다면 서버 로그에서 어떤 백엔드를 골랐는지 볼 수 있습니다.
각 모델이 학습한 것
아래 숫자를 읽는 방법이 여기서 정해지니 먼저 적습니다.
Nimble은 학습 데이터를 공개했습니다. 상거래, 여행, 소프트웨어 같은 10개 분야의 합성 예시 2,676건이고, 이름이 붙은 공개 데이터셋은 없습니다. 제 시험 문장을 대조해 보니 TREC 500문항, AG News 200건, 금융 트윗 200건 중 하나도 들어 있지 않았고, 데이터셋 이름도 나오지 않았습니다. 파인튜닝 데이터 기준으로는 여기 나온 Nimble 결과가 모두 처음 보는 과제입니다. 다만 그 전에 기반 모델 Qwen3.5-9B가 무엇을 봤는지는 공개되지 않았습니다.
Tev1은 학습 출처를 밝혔고, 그중 둘이 제가 쓴 데이터와 겹칩니다. AG News 1,500건과 BANKING77 3,000건이 MultiNLI, BoolQ, SST-5와 함께 들어 있습니다. 그러니 Tev1에게 AG News는 익숙한 과제이고, TREC과 금융 트윗은 처음 보는 과제입니다.
Jev는 학습 데이터를 공개하지 않아서 어느 쪽인지 말할 수 없습니다.
짧은 분류: Nimble이 Jev와 같거나 앞섰습니다
| Jev 1.13 | Nimble 9B | Tev1 4B | Tev1 0.8B | Kev-9B | Jeff-2B v1.1 | |
|---|---|---|---|---|---|---|
| TREC, 라벨 이름만 (500) | 89.0 | 95.6 | 71.2 | 41.0 | 93.8 | 69.4 |
| TREC, 설명 추가 (500) | 93.6 | 96.2 | 89.8 | 41.2 | 96.6 | 87.0 |
| AG News, 라벨 이름만 (200) | 89.0 | 90.0 | 88.5 | 86.5 | 89.0 | 88.5 |
| AG News, 설명 추가 (200) | 90.0 | 90.0 | 90.5 | 91.0 | 90.5 | 88.5 |
| 금융 트윗, 주제 20개 (200) | 71.0 | 68.0 | 67.5 | 46.0 | 69.5 | 62.0 |
문장마다 짝지어 보면, TREC에서 Jev만 틀리고 Nimble이 맞힌 문항이 38개, 반대가 5개였습니다(p < 0.001). 설명을 붙인 조건에서는 17 대 4였습니다(p = 0.007). AG News와 금융 트윗은 몇 문항 차이라 통계적으로 의미가 없었습니다(p ≥ 0.34). TREC을 학습한 Kev-9B와 TREC을 학습하지 않은 Nimble의 점수가 비슷했습니다.
Tev1 4B는 라벨마다 한 줄 설명을 붙이자 TREC에서 19점 올라, 여기서 가장 크게 올랐습니다. 학습한 AG News에서는 다른 모델들과 비슷했습니다. Tev1 0.8B는 설명이 있든 없든 TREC에서 41%에 머물렀습니다.
추론 위주 패널: Jev가 크게 앞섰습니다
Jeff가 공개한 패널입니다. BBH, Financial PhraseBank, JudgeBench, RAGTruth, WinoGrande 다섯 벤치마크 4,599문항이고, 어느 것도 Nimble 학습 데이터에 없습니다.
| Jev 1.13 | Nimble 9B | 한쪽만 맞힌 문항 (Nimble / Jev) | |
|---|---|---|---|
| BBH (750) | 90.5 | 70.3 | 21 / 173, p < 0.001 |
| Financial PhraseBank (999) | 85.3 | 84.5 | 58 / 66, p = 0.53 |
| JudgeBench (350) | 79.4 | 64.3 | 21 / 74, p < 0.001 |
| RAGTruth (1,500) | 81.8 | 78.9 | 191 / 235, p = 0.037 |
| WinoGrande (1,000) | 90.6 | 71.8 | 20 / 208, p < 0.001 |
| 전체 4,599 | 85.7 | 76.0 | 311 / 756, p < 0.001 |
Nimble은 금융 감성 분류에서 Jev와 비겼고, 추론이 필요한 곳에서는 모두 뒤졌습니다. Nimble의 패널 합계 76.0은 Kev-9B(73.8)와 Jeff-2B v1.1(81.9) 사이입니다. Ollama 모델 가운데 금융 감성은 Tev1이 가장 잘했습니다. Financial PhraseBank에서 Tev1 4B는 93.9, Tev1 0.8B는 89.7로 둘 다 Jev(85.3)보다 높았습니다(103 대 17, p < 0.001; 137 대 93, p = 0.004). Tev1 학습 데이터에는 감성 데이터셋 SST-5가 들어 있습니다. Tev1은 4B가 70.8, 0.8B가 59.7인데, 이 합계에는 거절된 138문항이 오답으로 들어 있습니다. 아래에서 설명합니다.
쓰다 보면 부딪히는 한도 두 가지
선택지가 26개를 넘으면 거절합니다. 의도 77개를 모두 넣은 BANKING77을 보내자 Ollama 0.35의 /v1/systemone이 세 모델 모두에 HTTP 400: question "intent": criteria must contain 2–26 candidates를 돌려줬고, CLINC150과 MASSIVE도 같았습니다. 모델과 관계없이 같은 문구라, 엔드포인트가 요청을 검사하는 단계에서 막는 것으로 보입니다. 안전한 쪽의 동작입니다. Jeff v1.0은 이런 목록을 받고도 27번째 뒤 선택지를 조용히 한 번도 고르지 않았기 때문입니다(v1.1에서 고쳐짐). 다만 77개짜리 의도 분류라면, Ollama에 보내기 전에 코드에서 후보를 먼저 추려야 합니다. Tev1 README는 학습한 범위인 선택지 2~24개를 권합니다.
Tev1은 긴 입력을 거절합니다. 패널에서 138문항이 prompt 0 has 3429 tokens; expected 1–2050 (input is never truncated) 같은 오류로 돌아왔습니다. JudgeBench 350문항 중 116개, RAGTruth 1,500문항 중 22개입니다. 몰래 잘라 쓰는 것보다는 낫지만, 보낼 수 있는 길이가 정해져 있다는 뜻입니다. Tev1 4B는 답을 낸 JudgeBench 문항에서 63.2%를 맞혔습니다. Nimble은 이 패널에서 거절한 문항이 없었습니다.
확률: TREC에서는 정확하고, 추론에서는 확신이 지나쳤습니다
Ollama는 Jev API처럼 확률을 소수 둘째 자리로 반올림하지 않고 그대로 돌려줍니다. 그래서 임계값을 세밀하게 잡을 수 있습니다. 모델이 말한 확률과 실제 정확도의 차이는 과제에 따라 달랐습니다.
| 평균 최고 확률 − 정확도 (%p) | Jev 1.13 | Nimble 9B | Tev1 4B |
|---|---|---|---|
| TREC, 라벨 이름만 | −0.1 | +1.0 | +6.4 |
| AG News, 라벨 이름만 | +6.7 | +4.9 | +1.6 |
| 금융 트윗 | +15.8 | +17.2 | +9.1 |
| JudgeBench (패널) | +0.4 | +21.1 | |
| WinoGrande (패널) | +2.7 | +21.0 |
TREC에서 Nimble의 확률은 거의 정확했고, 받아들인 답의 정확도를 95%로 지키면서 500문항 전부를 자동으로 받아들일 수 있었습니다. 반면 JudgeBench와 WinoGrande에서는 실제보다 약 21점 더 확신했습니다. Nimble 모델 카드는 학습 뒤에 온도 보정을 따로 하지 않았다고 밝혔고, Tev1 README는 확률이 "보정된 확신이 아니라 모델의 선호"라고 적었습니다. 둘 다 이 점을 숨기지 않았으니, 실제로는 과제마다 내가 라벨을 단 데이터로 임계값을 정하면 됩니다.
속도
다른 작업이 없는 A100 한 장에서, 로컬 HTTP로 한 번에 한 요청씩 보낸 TREC 문항당 중앙값은 Nimble 192ms, Tev1 4B 158ms, Tev1 0.8B 53ms였습니다. 같은 서버에서 Kev-9B는 29ms, Jeff는 약 45ms였으니 Ollama 쪽이 느렸습니다. 이유는 조사하지 않았습니다. 한국에서 부른 Jev API는 약 220ms였고, 서버 처리 시간은 9월 29일 BANKING77 요청 30건에서 잰 값으로 약 53ms였습니다.
어느 쪽을 쓸까
- 데이터를 밖으로 내보내지 않는 짧은 로컬 분류라면 Nimble입니다. TREC에서 여기 모델 중 가장 높은 수준이었고, AG News와 금융 트윗에서 Jev와 비슷했으며, TREC에서는 확률도 잘 맞았습니다.
- 금융 감성 분류라면 Ollama 모델 중에서는 Tev1 4B가 Financial PhraseBank에서 가장 높았습니다(93.9, Jev 85.3).
- 답변 판정, 여러 단계 추론, 대명사 해석이라면 Jev가 같은 문항에서 15~20점 앞섰습니다.
- 선택지가 26개를 넘는다면 어떤 Ollama 모델이든 먼저 후보를 추리세요.
- Tev1 0.8B는 직접 재 본 과제에만 쓰세요. 학습한 AG News에서는 잘했고, 학습하지 않은 TREC에서는 못했습니다.
이 결과의 한계
짧은 문장 분류 조건 다섯 개와 패널 하나이고, 모두 영어입니다. 모델마다 한 버전(Ollama의 Q8_0 빌드)과 Jev 1.13만 쟀습니다. Nimble의 TREC 우세는 파인튜닝 데이터 기준으로 처음 보는 과제의 결과지만, 기반 모델의 사전학습 데이터는 알 수 없고 Jev의 학습 데이터도 마찬가지입니다. 임계값은 채점한 표본에서 그대로 찾았습니다. 속도는 A100에서 로컬 HTTP로 잰 값이라 Mac이나 일반 그래픽카드에서는 다를 수 있습니다.
이 글의 건별 결과는 이후 다른 결정 모델들의 결과와 함께 다시 읽어, 여러 모델이 같이 틀리는 문장을 유형별로 모았습니다. 결정 모델은 이런 문장에서 틀립니다
2026년 10월 4일 업데이트: 「Ollama에서 돌리기」 절을 더했습니다. 하네스가 실제로 보낸 요청을 그대로 실었고, Vulkan 설명은 속도 절에서 이 절로 옮겼습니다.
실험 설정: Ollama 0.35.0(Linux amd64 릴리스 tarball, CUDA 13 라이브러리, OLLAMA_LLM_LIBRARY=cuda_v13), /v1/systemone을 127.0.0.1에서, A100 80GB PCIe 한 장. 모델은 Ollama 라이브러리의 nimble:latest(blob bbf1d6fc03bb, 9.53GB, Q8_0), tev1:4b(35f9281a3df5, 4.48GB), tev1:0.8b(fa9732e3924d, 0.81GB). 요청 본문, 데이터 파일, 라벨 이름, 설명, 지시문은 Kev vs Jev, Jeff vs Jev 글과 같고, Jev·Kev·Jeff 행은 그 결과 파일에서 읽었습니다. 패널은 Jeff의 jeff-panel 출력 4,599행입니다. Nimble 학습 데이터는 bespokelabsai/nimble의 data/train.jsonl(62076b4)이고, 시험 문장 전체와 패널 문항 가운데 80자를 소문자로 바꾸고 문장부호를 지운 뒤 그대로 들어 있는지 대조했고, 네 묶음 모두 0건이었습니다(scripts/jev-bench/check_nimble_overlap.py). 거절된 요청은 합계에서 오답으로 셌습니다. 확률 차이는 평균 최고 확률에서 정확도를 뺀 값이고, McNemar 검정은 양측 정확 검정입니다. 정확도 측정은 다른 작업과 GPU를 나눠 쓰는 동안 돌렸고, 속도는 그 뒤 GPU가 빈 상태에서 따로 쟀으며 두 실행의 답은 같았습니다. 측정일 2026-10-01.
이 블로그의 텍스트 분류 실측을 쓰는 순서대로 한 페이지에 엮었습니다: 분류기, LLM, 판단 모델 중 무엇을 쓸까.
Nimble과 Tev1은 이후 라우팅 시스템의 2단계로도 써 봤습니다. 분류기가 고른 상위 후보 중에서 고르게 해 선택지 26개 한계를 피했습니다: 어떤 문의를 사람에게 넘겨야 할까