판단 모델의 확신을 믿어도 될까: 반복 응답과 확률 실측
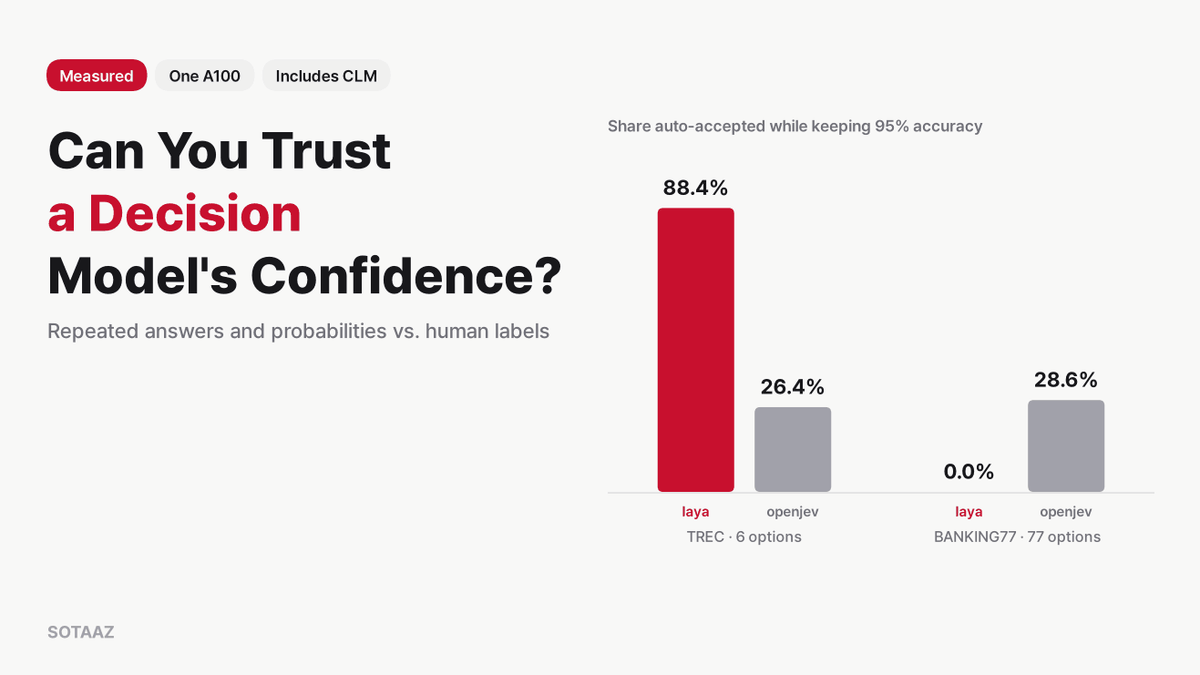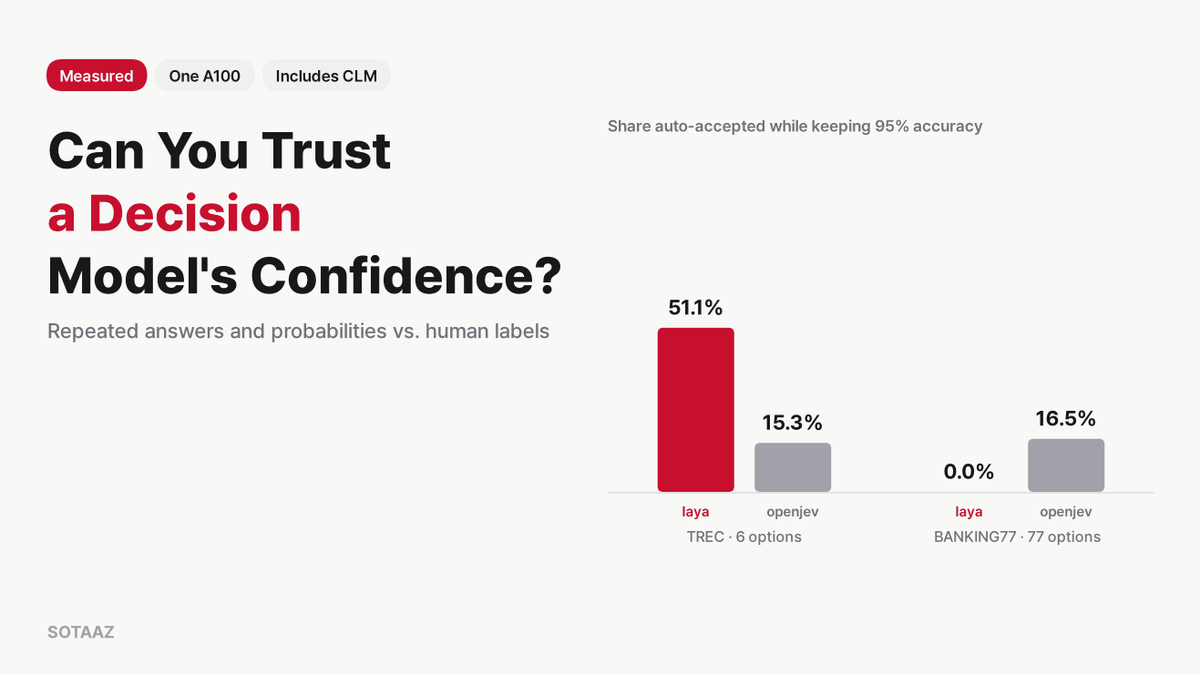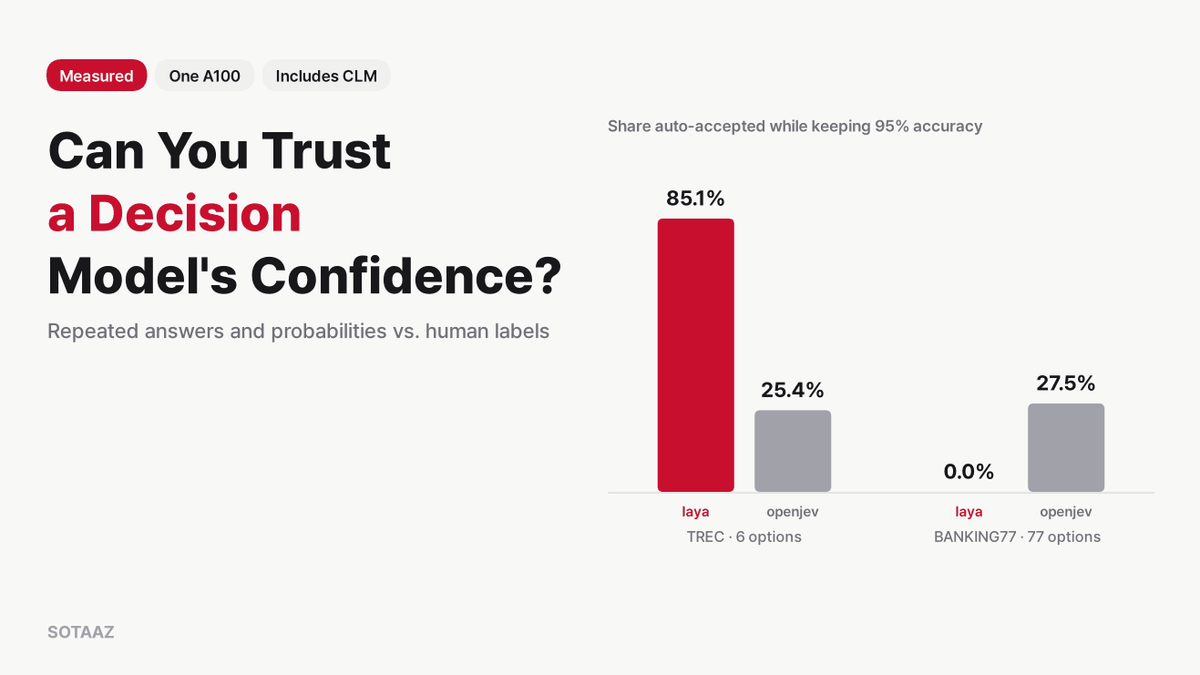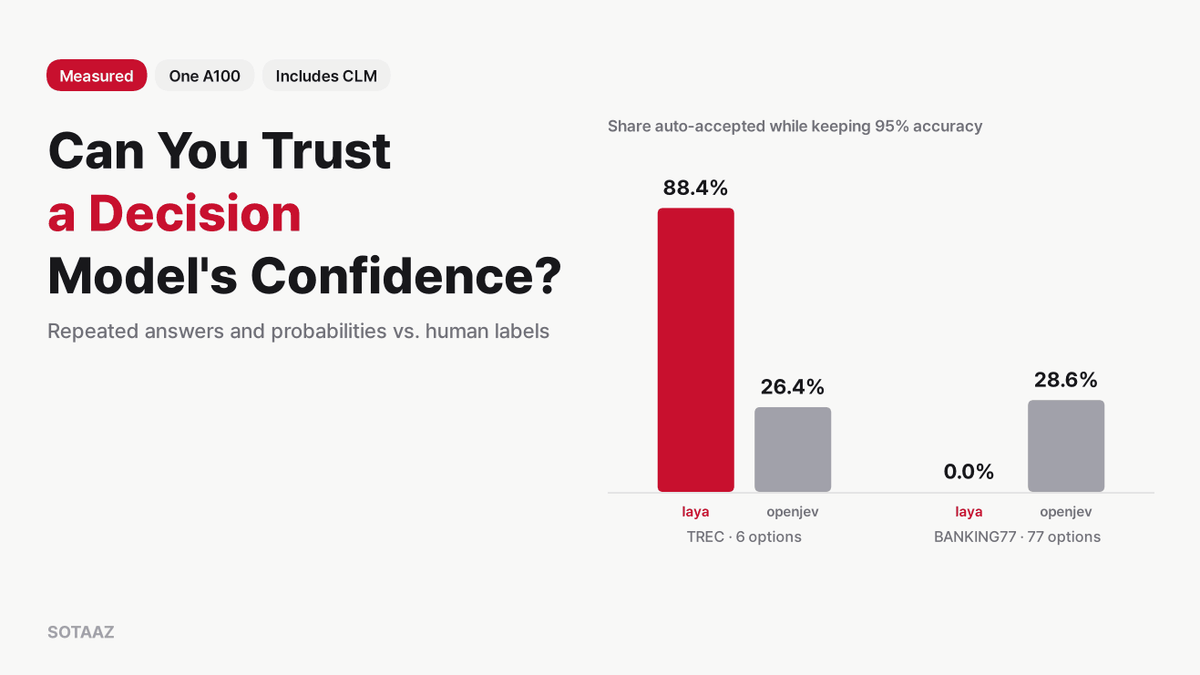
판단 모델은 답마다 확률을 붙여 줘서, 확실한 건 바로 처리하고 나머지만 넘길 수 있다고 합니다. 그 '확실함'을 판단하는 두 방법을 사람이 붙인 정답 라벨로 평가했습니다. openjev가 틀린 답의 77~80%는 8번 뽑아도 모두 같은 답이었습니다. 확률은 그보다 나았지만 유용성이 과제에 따라 크게 달랐습니다. laya는 정확도 95%를 지키며 TREC의 88%를 자동 통과시켰고 BANKING77은 0%였습니다. 새로 나온 CLM-8B는 라벨 이름만 주면 세 데이터셋 모두 우연 수준이었습니다.
판단 모델의 확신을 믿어도 될까: 반복 응답과 확률 실측
Jev 같은 빠른 판단 모델이 내세우는 장점은 속도만이 아닙니다. 답마다 확률이 붙어 있으니, 모델이 확신하는 답은 바로 처리하고 확신이 낮은 것만 큰 모델이나 사람에게 넘길 수 있다는 것입니다. 이 구조는 "확신"이 실제로 뜻이 있어야 성립합니다.
확신을 판단하는 방법은 흔히 두 가지입니다. 같은 질문을 여러 번 해서 답이 일치하면 믿는 방법, 그리고 확률을 읽어 문턱값을 두는 방법입니다. 앞 글의 비교에서 쓴 과제로 두 방법을 모두 사람이 붙인 정답 라벨로 평가했고, 이번 주에 나온 판단 모델 CLM도 함께 쟀습니다.
반복 추출: 틀린 답의 대부분은 만장일치였습니다
openjev는 무작위 노이즈에서 출발해 DiffusionGemma로 디노이즈를 한 번 한 뒤 답을 읽습니다. 노이즈가 다르면 답도 달라질 수 있어서, 서버는 여러 번 읽어 평균을 낼 수 있습니다. 저는 메시지마다 openjev가 쓰는 방식 그대로 노이즈 시드를 8개로 바꿔 가며 8번 묻고, 답을 전부 기록했습니다.
| openjev, 노이즈 추출 8회 | BANKING77 (선택지 77개, 154건) | TREC, 설명 포함 (선택지 6개, 500건) |
|---|---|---|
| 8번 모두 같은 답 | 141건 중 98건 정답 | 442건 중 371건 정답 |
| 8번 중 6~7번 같은 답 | 7건 중 2건 정답 | 44건 중 29건 정답 |
| 5번 이하 | 6건 모두 오답 | 14건 중 8건 정답 |
| 틀린 답 가운데 만장일치 | 54건 중 43건 (80%) | 92건 중 71건 (77%) |
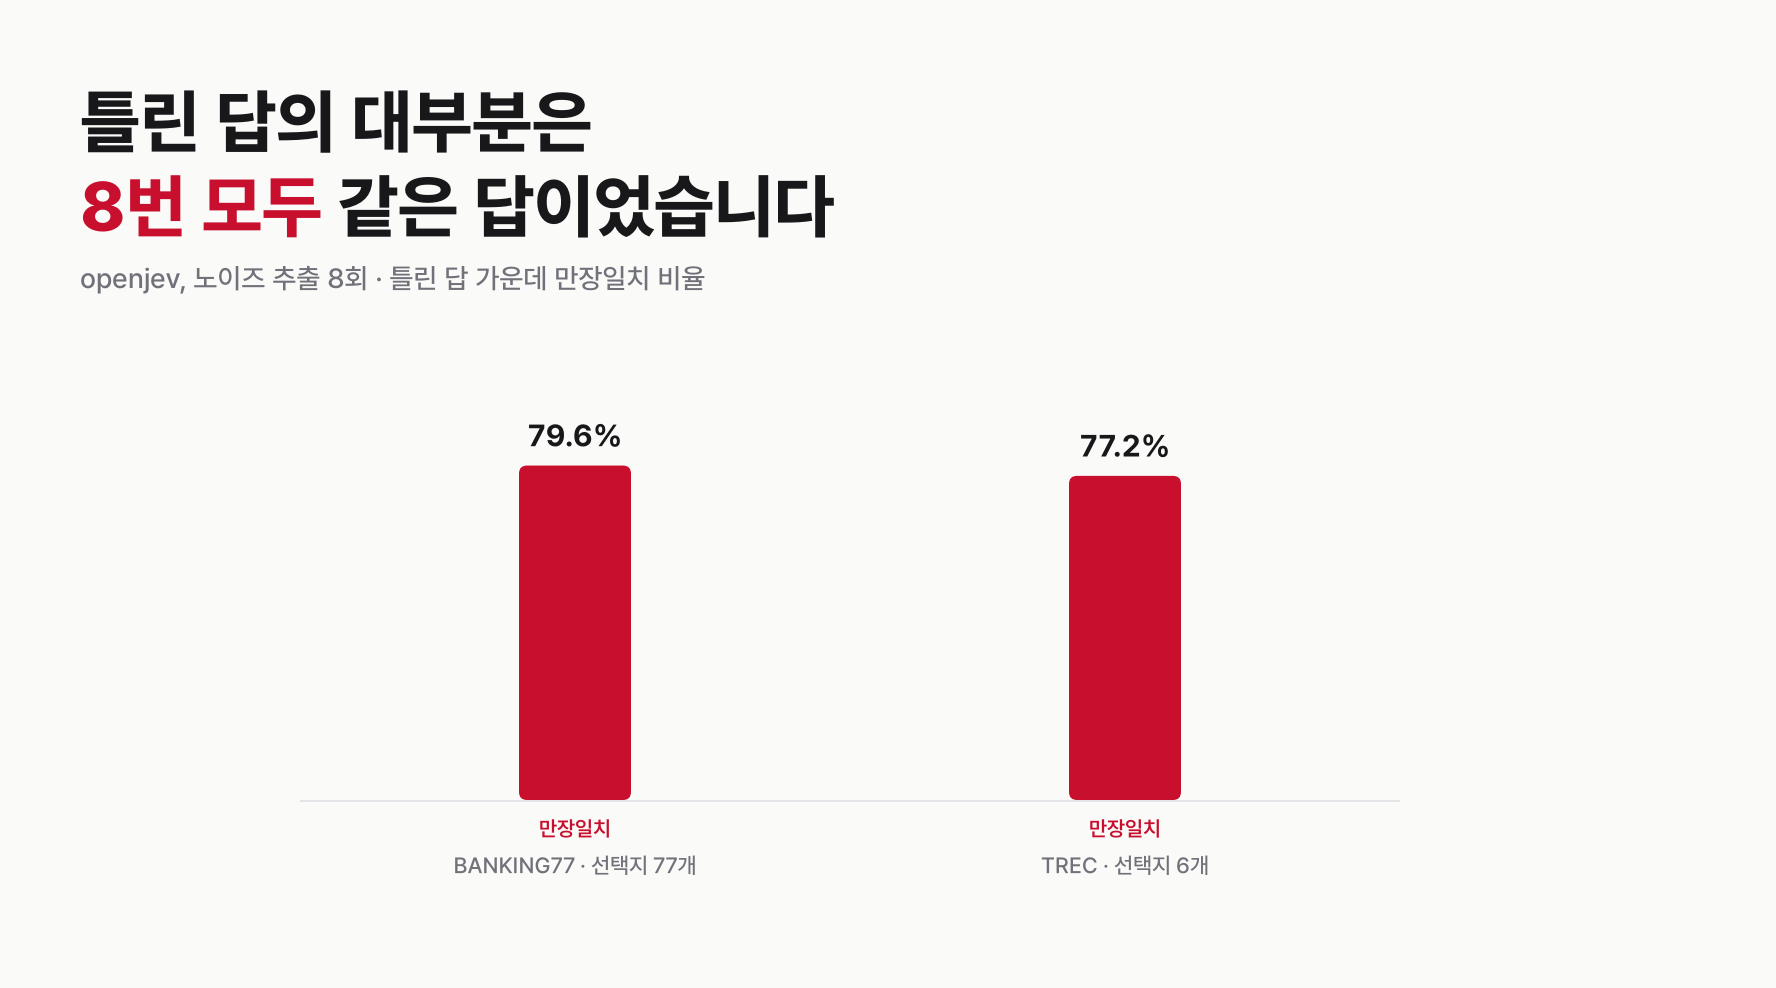
답이 갈리는 것은 분명한 경고 신호입니다. 추출이 갈린 건은 정답률이 낮았습니다. BANKING77에서는 13건 중 2건, TREC에서는 58건 중 37건만 맞았고, 만장일치일 때는 각각 70%와 84%였습니다. 문제는 답이 거의 갈리지 않는다는 것입니다. openjev는 틀릴 때도 대부분 매번 같은 방식으로 틀렸고, 그래서 일치만으로는 정확도 95%를 만족하는 답을 골라내지 못했습니다(아래 표). 정답을 가려내는 힘을 AUROC로 재면 일치도는 BANKING77에서 0.59, TREC에서 0.57이었습니다. 0.5가 동전 던지기입니다. 첫 추출의 확률은 0.72와 0.73으로 그보다 나았습니다.
다수결의 효과는 과제마다 달랐습니다. 첫 추출 대신 8번의 다수결을 쓰면 BANKING77에서는 차이가 없었고(102건 대 100건, p = 0.5), TREC에서는 조금 나아졌습니다(400건 대 408건, 한쪽만 맞힌 질문 1건 대 9건, p = 0.02).
그래도 일치도가 쓸모 있는 곳이 있습니다. 언제 그만 뽑을지 정할 때입니다. 두 번 뽑아 같으면 멈추고, 다르면 8번까지 뽑아 다수결을 하는 규칙은 메시지당 평균 BANKING77에서 2.27번, TREC에서 2.24번만 읽었습니다. 이번 표본에서는 두 응답이 같을 때 추가 추출을 생략해도 8회 다수결과 정답 수가 거의 같았습니다(BANKING77 100건 대 100건, TREC 406건 대 408건). 추출 비용은 아껴 줍니다. 어느 답을 믿을지는 알려 주지 않습니다.
최근 논문 Stable Answers, Unfinished Reasoning도 다른 설정에서 비슷한 결론을 냈습니다. 추론 모델이 생각하는 도중에 답을 여러 번 물어 일치하면 멈추는 규칙을 시험했는데, 일치는 "정해진 방식으로 물었을 때 지금의 답이 유지된다"는 것만 보여 줄 뿐 추론이 끝났다는 뜻이 아니라고 결론지었습니다. 이번 실험에 옮기면, 일치는 답이 노이즈를 바꿔도 유지된다는 것만 보여 줄 뿐 그 답이 맞다는 뜻이 아닙니다. 다만 설정은 다릅니다. 논문은 진행 중인 추론을 일치 신호로 끊는 위험을 다뤘고, 이번 실험은 이미 끝난 한 번 읽기를 몇 번 더 반복할지를 정한 것입니다. 위에서 추출을 줄여도 된다고 한 것은 이 두 번째 경우, 그리고 이 표본에 한한 이야기입니다.
확률: 유용성이 과제에 따라 크게 달랐습니다
확신도로 나눠 처리할 때 실제로 궁금한 것은, 오류를 너무 많이 흘리지 않으면서 얼마나 자동으로 넘길 수 있느냐입니다. 그래서 모델마다 "확률이 문턱값 이상인 답만 통과시킬 때, 통과한 답의 정확도를 95% 이상으로 지키며 통과시킬 수 있는 최대 비율"을 구했습니다. 아래 수치는 같은 평가 표본에서 문턱값을 찾아 얻은 최대 통과 비율입니다. 새 데이터에서도 정확도 95%가 유지되는지는 따로 검증해야 합니다.
| 정확도 95%로 자동 통과시킬 수 있는 비율 | TREC (선택지 6개) | BANKING77 (선택지 77개) |
|---|---|---|
| laya | 88.4% (설명 포함, 500건 중 442건), 80.4% (이름만, 402건) | 0% |
| openjev, 첫 추출의 확률 | 26.4% | 28.6% |
| openjev, 8회 각 추출의 최고 확률을 평균 | 0% | 14.9% |
| openjev, 8회 응답의 일치 횟수만 | 0% | 0% |
| CLM | 0~2% (최대 10건) | 0.6% (154건 중 1건) |
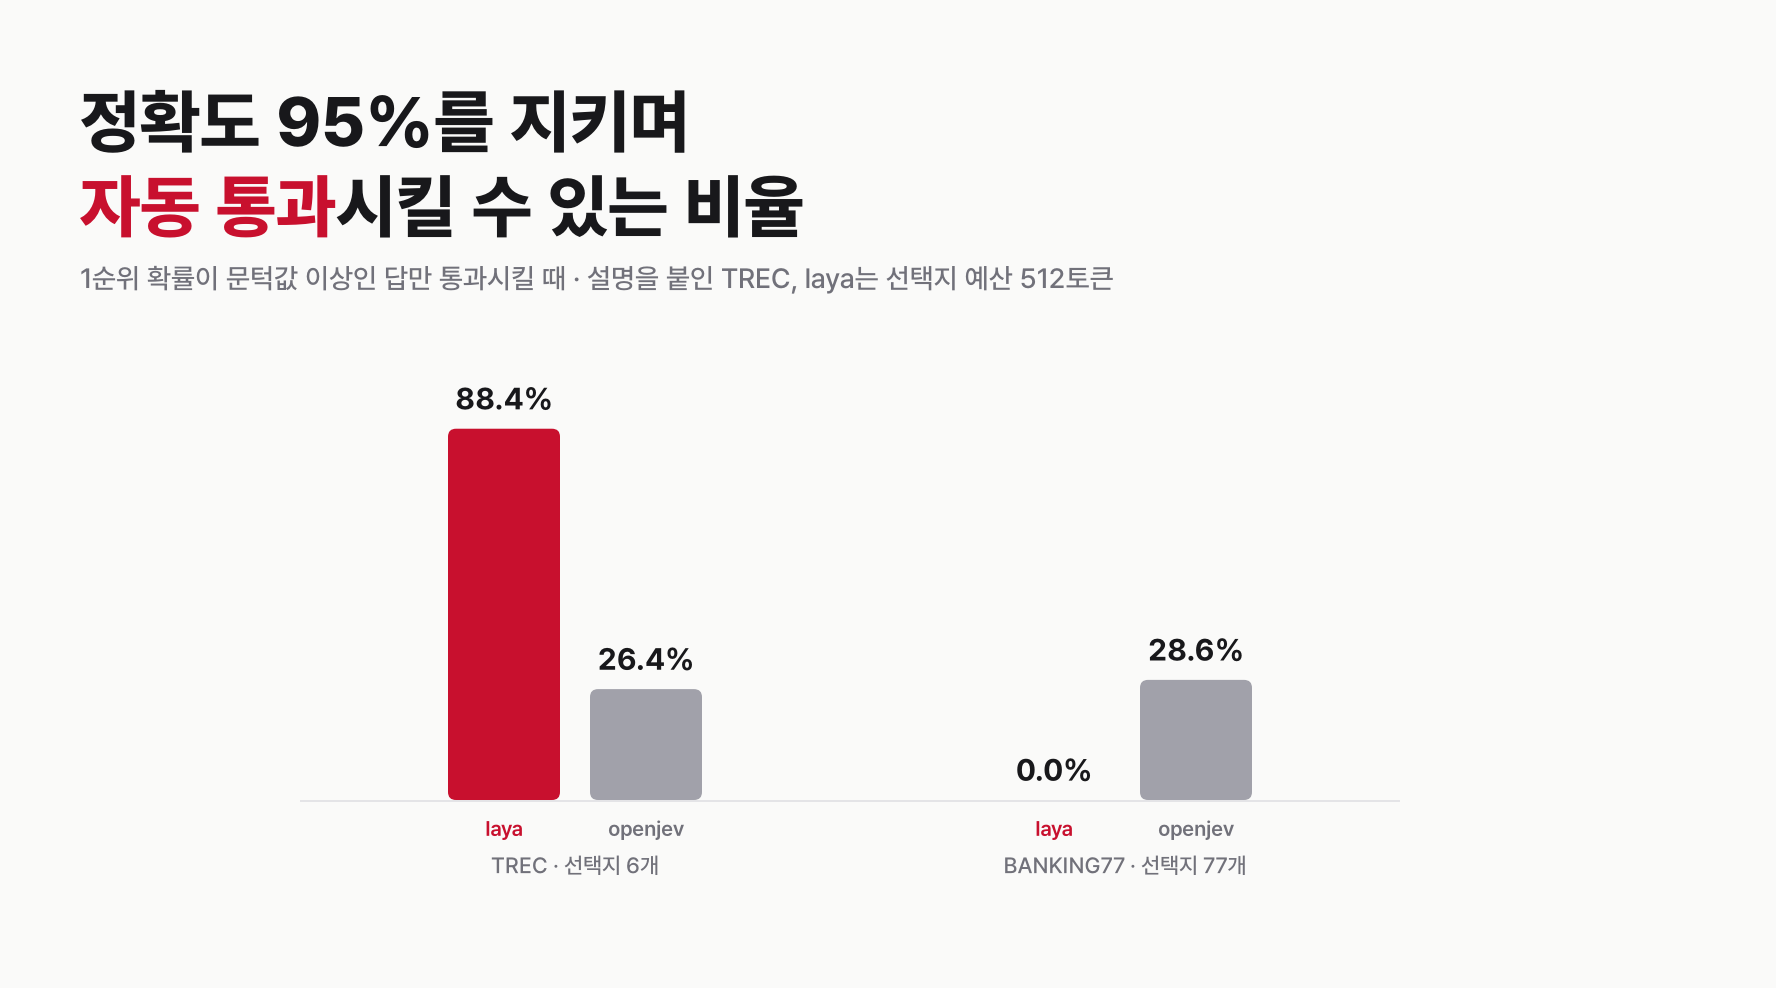
TREC에서 laya의 확률은 거의 정확했습니다. 확률 90% 이상으로 낸 답 314건 중 305건이 정답이었고, 보정 오차(ECE)는 0.02였습니다. 확신도로 나눠 처리한다는 약속이 여기서는 그대로 지켜졌습니다.
그런데 BANKING77에서는 같은 모델이 대부분 틀리면서도 확신은 똑같이 높았습니다. 확률 90% 이상으로 낸 답이 108건인데 그중 48건만 정답이었고, 어떤 문턱값을 써도 통과한 답의 정확도가 95%에 닿지 않았습니다. 이것은 기본 설정 기준입니다. 문서가 선택지가 많을 때 권하는 512토큰 예산에서도 107건 중 60건만 맞았고, 역시 자동 통과시킬 수 있는 답은 없었습니다.
openjev는 두 과제 모두 그 중간이었습니다. "8회 평균" 행은 각 추출에서 가장 높은 확률을 평균하고, 정오는 8회 중 가장 많이 나온 응답으로 매긴 값입니다. 추출마다 고른 선택지가 다르면 서로 다른 선택지의 확률을 평균하게 되므로, 선택지별 분포를 평균한 뒤 답을 고르는 방식과는 다릅니다. 이 방식에서는 자동 통과 비율이 첫 추출보다 낮았습니다(BANKING77 28.6%→14.9%, TREC 26.4%→0%). 만장일치로 틀린 답들의 확률도 높게 나왔기 때문입니다. 다만 비교하는 두 행은 답을 고르는 방식도 다르므로, "확률을 평균하면 나빠진다"로 일반화할 수는 없습니다.
CLM: 빠르지만 라벨 이름만으로는 우연 수준이었습니다
CLM(Contrastive Language Model)은 이번 주에 공개된 System One 모델입니다. 컴퓨터 사용, 게임, 도구 호출 과제에서 Jev와 비슷한 성능을 내면서 "지연은 최대 9배 짧다"고 소개합니다. 구조는 이렇습니다. 상태와 선택지를 각각 Qwen3-8B로 임베딩하고, 대조 학습으로 훈련한 20M 파라미터 헤드를 거친 뒤, 상태와 가장 가까운 선택지를 고릅니다. 공개된 헤드(CLM-v0.1-8B)를 다른 모델과 같은 세 데이터셋, 같은 라벨, 같은 지시문으로 돌렸습니다.
| CLM-8B | 무작위로 고를 때 | 라벨 이름만 | 이름 + 한 줄 설명 | 선택지 임베딩 캐시 후 지연 중앙값 |
|---|---|---|---|---|
| BANKING77 (선택지 77개) | 1.3% | 3.2% | — | 23ms |
| TREC (선택지 6개) | 16.7% | 23.2% | 28.4% | 20ms |
| AG News (선택지 4개) | 25% | 26.5% | 60.5% | 24ms |
라벨 이름만 준 조건은 무작위로 고르는 수준에 가깝습니다. AG News에서는 기사 200건 중 188건을 "Sports"로 골랐고, 설명을 붙인 TREC에서는 질문 500건 중 420건을 "description"으로 골랐습니다. 설명을 붙이면 나아집니다. CLM은 상태를 선택지의 텍스트와 비교하는데, 한 단어짜리 라벨이 아니라 답 문장으로 학습했기 때문입니다. 그래도 AG News 60.5%는 laya(94.5%, 다만 AG News는 laya의 학습 데이터에 들어 있습니다)나 openjev(85.0%)보다 한참 낮습니다.
이 결과를 믿기 전에 제 설치부터 확인했습니다. 제 vLLM 서버의 Qwen3-8B 임베딩은 transformers로 직접 계산한 값과 거의 일치했고(시험 문장에서 코사인 0.9999), CLM의 순위 예제도 README와 비슷하게 나왔습니다(0.993 대 0.997). 다만 README의 질문 예제는 그대로 재현되지 않았습니다. "Is this urgent?"에 README는 0.41을 적었는데 저는 0.84가 나왔습니다. 저장소가 새로 공개돼 제가 확인했을 때 이슈 보고가 없었기 때문에, 헤드나 버전이 제 쪽에서 어긋났을 가능성은 배제할 수 없습니다. 말할 수 있는 것은, 공개된 헤드를 문서대로 띄웠을 때 텍스트 분류는 잘하지 못했다는 것까지입니다. CLM이 내세우는 것은 에이전트의 행동 선택이고, 그쪽은 재지 않았습니다.
그래서 어떻게 쓸까
- 확신도로 나누기 전에, 내 데이터에서 자동 통과 비율부터 재 봅니다. 같은 모델이 공개 데이터셋 두 개 사이에서 88%와 0%로 갈렸습니다.
- 반복 추출의 일치는 비용을 아끼는 데 쓰고, 믿을지 말지를 정하는 데는 쓰지 않습니다. 두 번 뽑아 같으면 더 뽑지 않을 이유는 됩니다. 그 답을 믿을 이유는 되지 않습니다.
- 높은 확률도 정답을 보장하지 않습니다. laya 문서는 기본 상태에서 확신이 과하게 나오니 내 데이터로 온도를 맞추라고 권합니다. 이번에는 한 과제에서는 잘 맞았고 다른 과제에서는 크게 과했습니다.
이 결과로 말할 수 없는 것
반복 추출 시험은 과제 두 개, DiffusionGemma 기반 서버 하나, 8회 추출로 한 것입니다. 문턱값을 같은 표본에서 정하고 같은 표본으로 채점했으므로, 자동 통과 비율은 이 표본의 설명이지 새 데이터에서의 약속이 아닙니다. CLM은 공개 첫 주에 참조 헤드로 돌렸고, 다른 헤드나 설정에서는 결과가 달라질 수 있습니다.
측정 환경: A100 80GB 한 장, 드라이버 580.178.04. openjev 0.4.0 엔진을 프로세스 안에서 직접 불렀고, vLLM 1b3b88e가 google/diffusiongemma-26B-A4B-it bf16을 서빙했습니다(--async-scheduling, 캔버스 64). 메시지마다 추출 시드는 openjev의 samples 옵션과 같이 기준값 + k × 7919(k = 0~7)입니다. laya 0.3.7. CLM 저장소 cca045f, 헤드 Contrastive-LM/CLM-v0.1-8B 리비전 87655cb, Qwen3-8B는 같은 vLLM에서 --runner pooling으로 서빙했습니다. 표본은 앞 글들과 같습니다. BANKING77 154건(시드 20260918), TREC 테스트셋 500건, AG News 200건. AUROC와 보정은 각 모델의 1순위 확률로 계산했고, McNemar 검정은 양측 정확 검정입니다. 측정일 2026-09-24.
이메일로 받아보기
관련 포스트
10분 만에 이해하는 Jev: 빠른 판단 모델은 언제 쓸모 있나
Jev는 글로 답하지 않고 선택지마다 확률을 매겨 돌려주는 모델입니다. 이런 모델이 왜 필요한지, 오픈소스는 같은 일을 어떻게 하는지, 그리고 세 번에 걸쳐 직접 재 본 결과를 정리했습니다. 선택지가 몇 개뿐이면 421M 모델이 23ms에 86.6%를 맞혔고, 77개면 CPU에서 도는 작은 분류기가 90%로 여전히 앞섰습니다.
오픈소스 Jev 대안 셋을 같은 데이터로 재 보니: laya·openjev·NanoJev 실측
laya, openjev, NanoJev를 A100 한 장에서 BANKING77(의도 77개), TREC(질문 유형 6개), AG News로 쟀습니다. 선택지가 6개면 421M짜리 laya가 TREC 86.6%를 23ms에 냈고, 77개면 DiffusionGemma 기반 openjev가 66.9%로 앞섰습니다. 다만 77개에서는 CPU에서 도는 로지스틱 회귀가 90%로 전부를 이겼습니다.
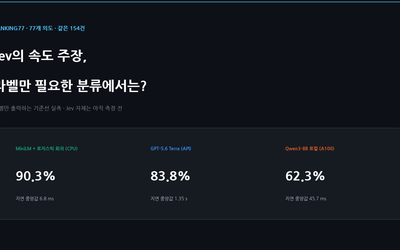
Jev의 속도 주장, 라벨만 필요한 분류에도 적용될까? BANKING77 기준선 실측
BANKING77 테스트셋에서 라벨만 출력하는 네 가지 분류 방식을 같은 메시지 154건으로 비교했습니다. MiniLM 임베딩과 로지스틱 회귀는 CPU에서 정확도 90.3%, 지연 중앙값 6.8ms를 기록했습니다. Jev 자체는 아직 측정하지 않았습니다.