Kev와 MoJev 실측: 오픈소스 Jev 대안 두 개의 정확도와 확률
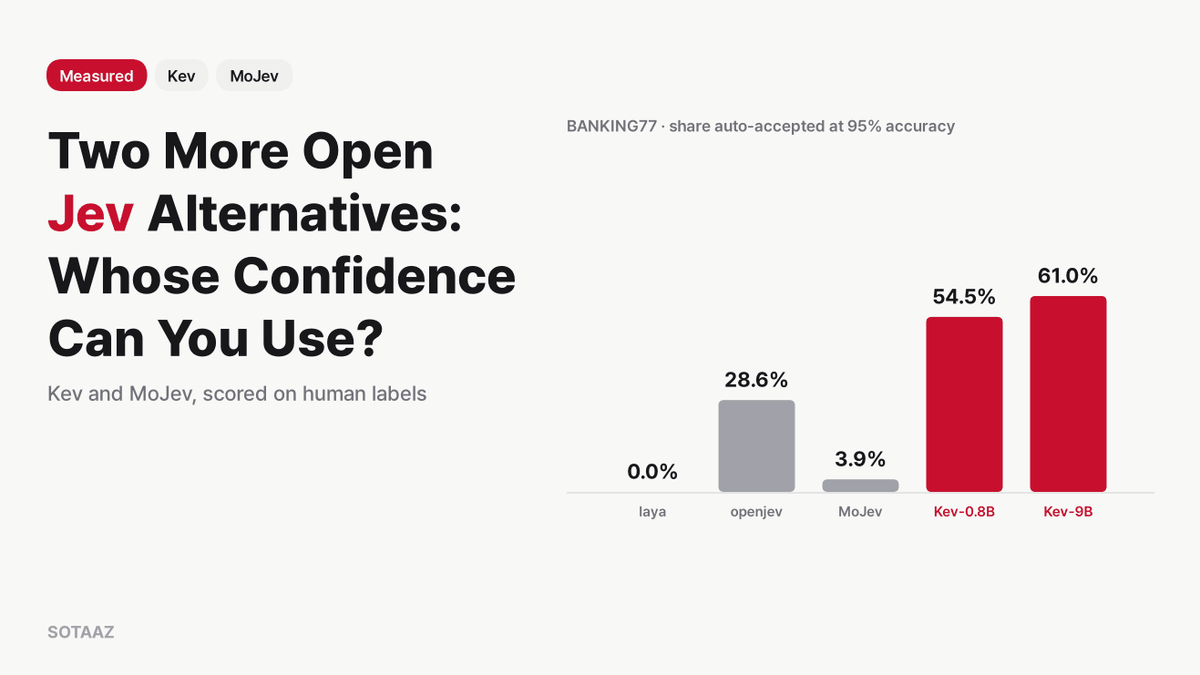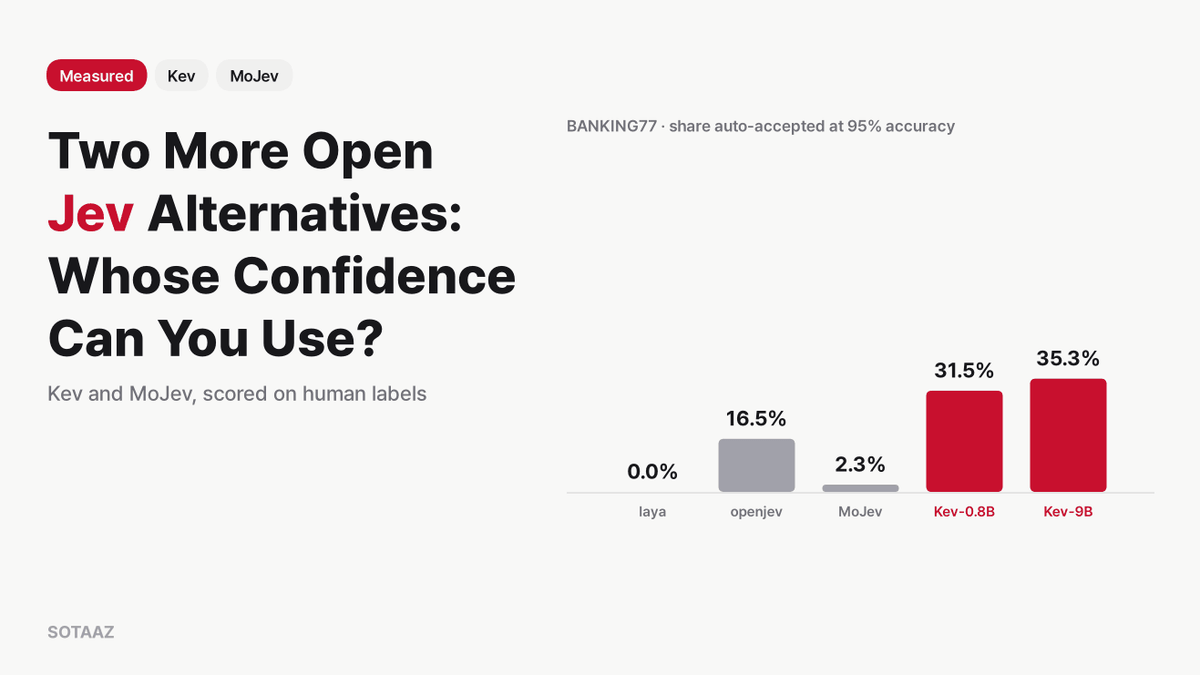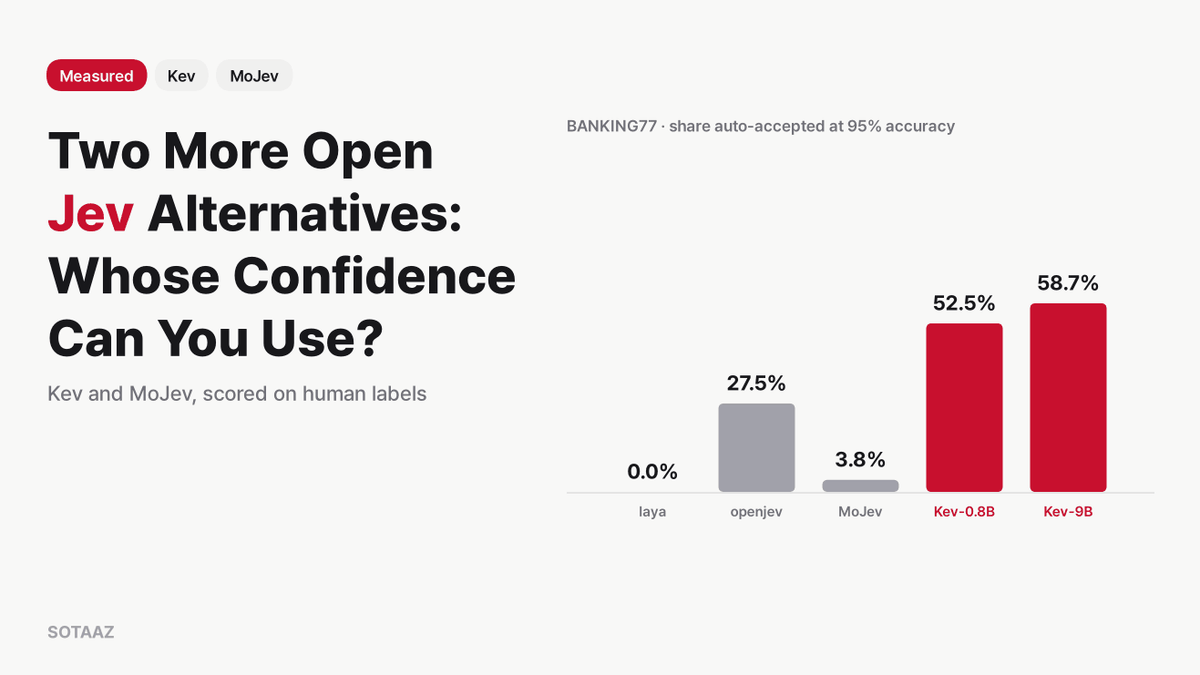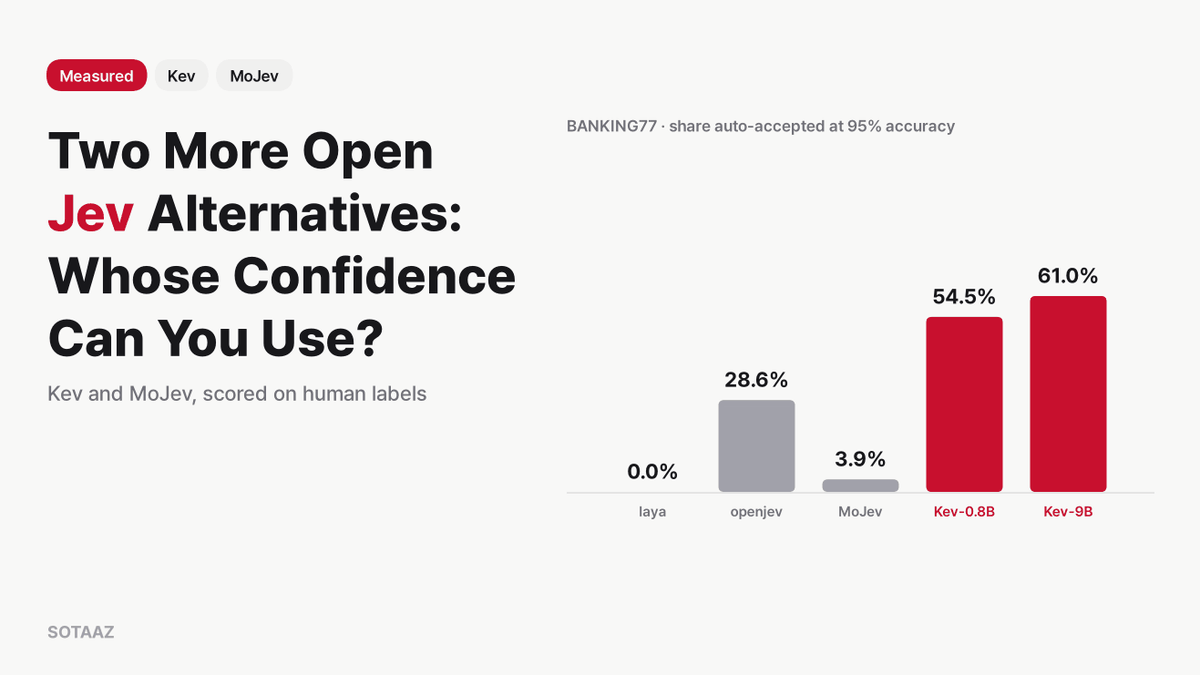
Jev와 같은 API를 쓰는 Kev(0.8B~9B)와 MoJev(0.85B)를 BANKING77·TREC·AG News에서 사람 라벨로 채점했습니다. Kev의 확률은 쓸 만했습니다. 정확도 95%를 지키며 BANKING77의 53~61%를 자동 통과시켰고, 같은 조건에서 laya는 0%였습니다. 다만 Kev는 이 세 데이터셋으로 학습된 모델이고, 같은 데이터로 학습한 작은 분류기가 BANKING77에서는 여전히 앞섰습니다. MoJev는 보정 오차 0.79%를 발표했지만 여기서는 6~22%였고, 확률이 실제보다 낮게 나왔습니다.
Kev와 MoJev 실측: 오픈소스 Jev 대안 두 개의 정확도와 확률
지난 비교 이후 Jev처럼 유형이 정해진 질문에 답하는 오픈소스 모델이 두 개 더 나왔습니다.
Kev는 Qwen3.5와 Qwen3.8 위에 LoRA 어댑터를 얹은 모델군입니다. 크기는 0.8B, 4B, 9B, 27B 네 가지이고, 체크포인트마다 온도 값을 맞춰 두어서 따로 보정하지 않아도 확률이 맞도록 했다고 설명합니다. MoJev는 0.85B 모델 하나로, 선택지 전체를 한 번의 순전파로 채점합니다. 정확도 93.23%, 보정 오차 0.79%를 발표했습니다. 두 모델 모두 Jev의 System One API와 같은 형식으로 요청을 받습니다.
측정 조건은 앞선 비교와 확신 실측에서 쓴 것과 같습니다. BANKING77(메시지 154개, 선택지 77개), TREC(질문 500개, 선택지 6개), AG News(기사 200개, 선택지 4개)를 사람이 단 라벨로 채점했고, 라벨 이름과 지시문, 한 줄 설명도 그대로 썼습니다.
아래 결과를 읽을 때 먼저 알아야 할 사실이 하나 있습니다. Kev는 세 데이터셋의 train 분할로 학습된 모델입니다. Kev README는 BANKING77, TREC, AG News를 "학습에 쓴 출처(trained sources)"로 분류하고, 데이터 코드도 각 데이터셋의 train 분할에서 학습 예제를 뽑습니다. 제 표본은 test 분할에서 뽑았으므로 Kev가 학습 중에 본 문항은 아닙니다. 그렇지만 Kev에게는 가장 익숙한 과제입니다. 그러니 Kev와 견줄 상대는 이 과제로 학습하지 않은 laya나 openjev가 아니라, 같은 train 분할로 학습한 작은 분류기입니다. 첫 글에서 만든 MiniLM 임베딩과 로지스틱 회귀 분류기가 그 역할을 합니다.
정확도
| BANKING77 | TREC 이름만 / 설명 포함 | AG News 이름만 / 설명 포함 | 지연 중앙값 | |
|---|---|---|---|---|
| Kev-0.8B | 73.4% | 94.6% / 96.4% | 87.0% / 88.0% | 14~25ms |
| Kev-4B | 81.2% | 90.0% / 95.4% | 88.5% / 89.0% | 27~54ms |
| Kev-9B | 82.5% | 93.8% / 96.6% | 89.0% / 90.5% | 29~65ms |
| MoJev-0.85B | 44.2% | 48.0% / 36.4% | 82.5% / 72.5% | 55~87ms |
| MiniLM + 로지스틱 회귀(학습) | 89.6% | 90.4% | 88.5% | GPU 5ms, CPU 6~11ms |
지연 시간은 A100 한 장에서 요청을 하나씩 로컬 HTTP로 보냈을 때의 중앙값입니다. 범위의 큰 쪽은 선택지 77개를 보내는 BANKING77입니다. 학습한 분류기는 라벨 이름이나 설명을 쓰지 않으므로 데이터셋마다 값이 하나입니다.
학습한 분류기와 비교하면 결과가 과제마다 갈립니다. BANKING77에서는 Kev가 세 크기 모두 졌습니다. 분류기가 154개 중 138개, Kev-9B가 127개를 맞혔고, 둘 중 한쪽만 맞힌 메시지는 18개 대 7개였습니다(p = 0.04). TREC에서는 이름만 준 4B를 빼면 Kev가 앞섰습니다. 설명을 붙인 Kev-9B가 500개 중 483개, 분류기가 452개를 맞혔습니다(한쪽만 맞힌 문항 37개 대 6개, p < 0.001). AG News에서는 차이가 기사 네 개 이내로, 사실상 같았습니다(p ≥ 0.45).
데이터가 겹치는 곳이 한 군데 더 있어서 따로 확인했습니다. Kev는 development 분할로 체크포인트를 고르고 calibration 분할로 온도를 맞추는데, 두 분할 모두 원래 데이터셋의 test 분할에서 뽑았습니다. 문장을 대조해 보니 제 표본 가운데 TREC 500개 중 80개, BANKING77 154개 중 6개, AG News 200개 중 1개가 이 분할에 들어 있었습니다. 학습에 쓰이지는 않았지만 모델을 고르는 데에는 쓰인 문항입니다. 이 문항을 빼고 다시 계산해도 결론은 거의 같습니다. 남은 TREC 420개에서 설명을 붙인 Kev-9B는 96.9%, 분류기는 91.0%였습니다(p < 0.001). 이름만 준 Kev-9B의 우위는 여기서 유의하지 않게 됩니다(93.8% 대 91.0%, p = 0.10). 겹친 문항에서 Kev의 정답률이 다른 문항보다 높지도 않았습니다.
모델 크기는 BANKING77에서만 뚜렷하게 효과가 있었습니다. 0.8B에서 9B로 가면서 BANKING77 정답은 113개에서 127개로 늘었지만(p = 0.004), AG News는 174개에서 178개로 거의 그대로였습니다(p = 0.34). BANKING77에서 4B와 9B는 125개와 127개로 차이가 없었습니다(p = 0.79). 눈에 띄는 예외는 이름만 준 TREC의 4B입니다. 450개로 0.8B의 473개보다 적었는데(p < 0.001), 설명을 붙이자 477개로 올라왔습니다.
MoJev는 선택지가 네 개보다 많은 두 과제에서 크게 뒤처졌습니다. 그리고 이 표에서 설명을 붙였을 때 오히려 나빠진 모델은 MoJev뿐이었습니다. TREC은 240개에서 182개로, AG News는 165개에서 145개로 줄었습니다(둘 다 p < 0.001).
확률: Kev는 쓸 만했고 MoJev는 너무 낮았습니다
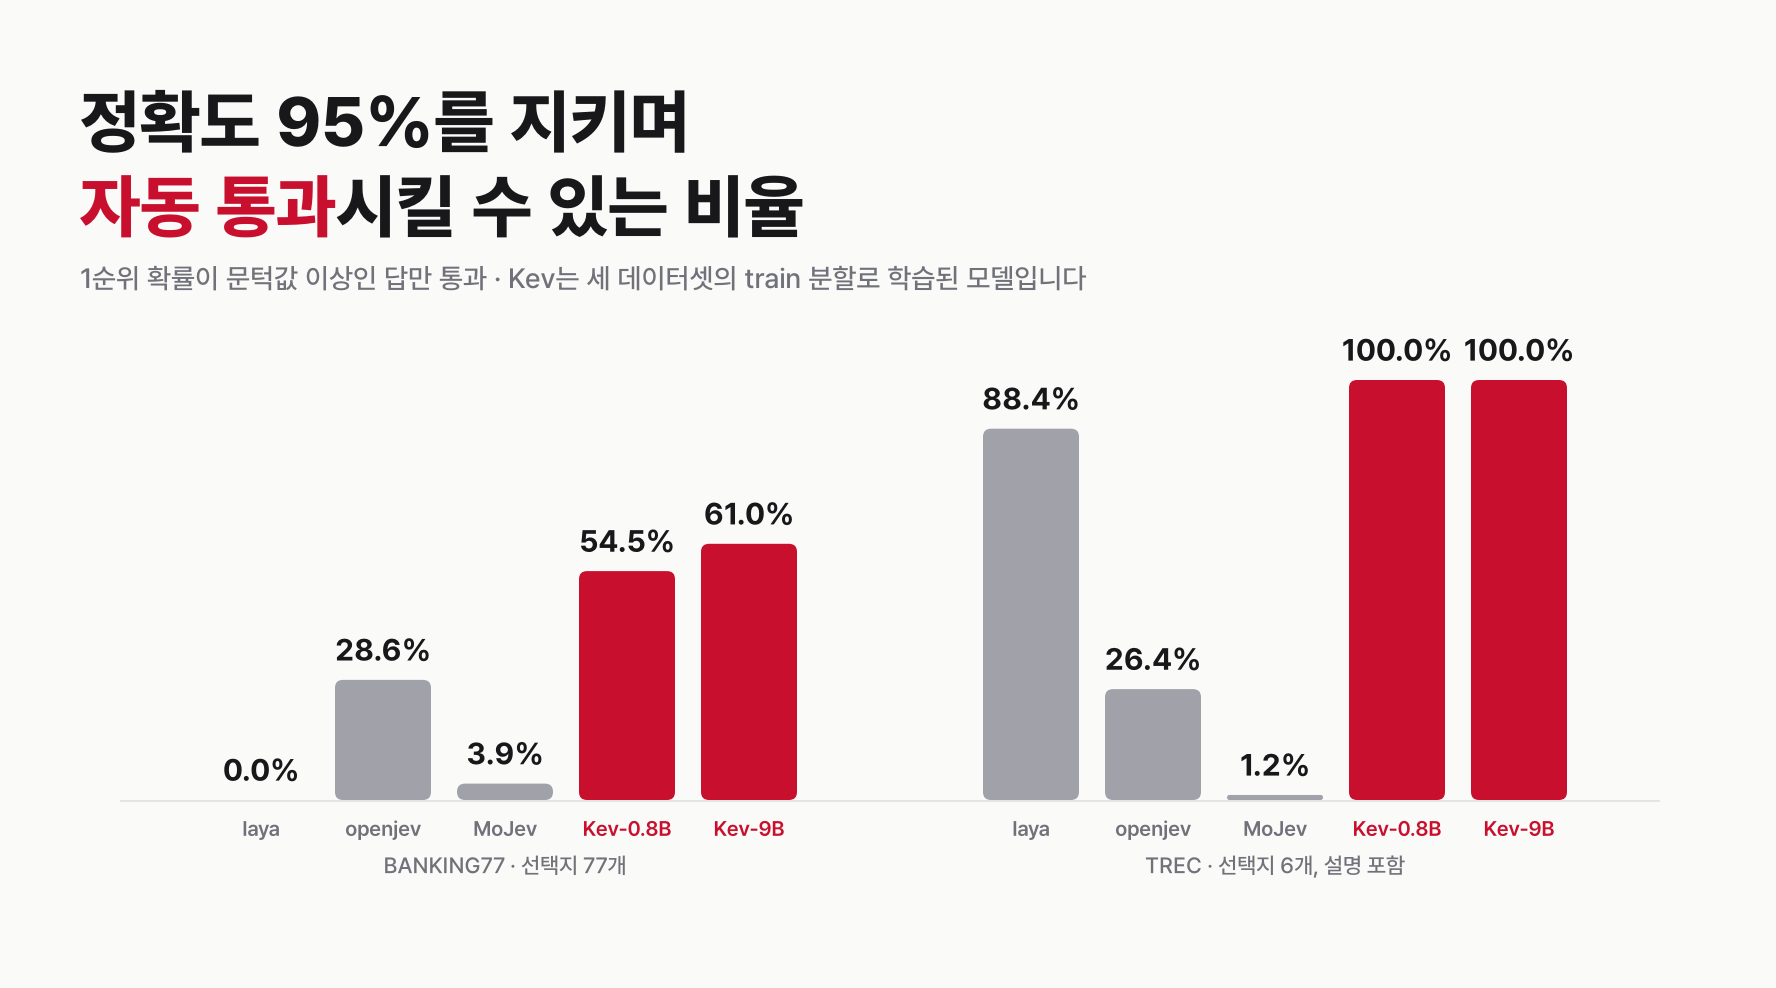
확신 실측 때와 같은 질문을 던졌습니다. 통과시킨 답의 정확도를 95% 이상으로 지키면서 몇 퍼센트까지 사람 확인 없이 넘길 수 있는지입니다. 문턱값은 채점에 쓴 표본에서 직접 찾았으므로, 아래 비율은 이 표본에 대한 기술일 뿐 새 데이터에서도 그대로 나온다는 보장은 아닙니다.
| 정확도 95%에서 자동 통과 비율 | BANKING77 | TREC 이름만 / 설명 포함 | AG News 이름만 / 설명 포함 |
|---|---|---|---|
| Kev-0.8B | 54.5% | 99.2% / 100% | 73.5% / 84.5% |
| Kev-4B | 52.6% | 58.6% / 100% | 80.5% / 84.5% |
| Kev-9B | 61.0% | 98.0% / 100% | 84.0% / 90.0% |
| MoJev | 3.9% | 0% / 1.2% | 22.5% / 11.5% |
차이가 드러나는 곳은 BANKING77입니다. 같은 선택지 77개에서 laya의 확률로는 어떤 문턱값을 잡아도 정확도 95%를 넘기지 못했고, openjev의 첫 추출 확률로는 28.6%까지 넘길 수 있었습니다. Kev-0.8B는 154개 중 84개를 넘길 수 있었고, 확률 90% 이상으로 낸 답 47개는 모두 정답이었습니다. 설명을 붙인 TREC의 100%는 보이는 것만큼 대단한 값이 아닙니다. Kev의 전체 정확도가 이미 96.4~96.6%라서 전부 통과시켜도 95%를 넘기 때문입니다.
Kev의 보정 오차(모델이 말한 확률과 실제 정답률의 차이)는 15개 측정에서 2~12%였습니다. 가장 컸던 것은 이름만 준 TREC의 Kev-4B(12%)로, 정확도가 떨어졌던 바로 그 조건입니다. 이때 자동 통과 비율도 58.6%로 내려갔습니다. Kev에 들어 있는 온도 값은 이 세 데이터셋이 포함된 분할에서 맞춘 값입니다. 따라서 보정 역시 Kev에게 가장 유리한 조건에서 잰 셈입니다.
MoJev의 확률은 일관되게 실제보다 낮았습니다. BANKING77에서 1순위 확률의 평균은 0.23인데 정확도는 0.44였고, BANKING77과 TREC에서는 확률 90% 이상인 답이 하나도 없었습니다. 보정 오차는 6~22%로, 발표한 0.79%와 거리가 멉니다. 데이터 차이가 일부 원인일 수 있습니다. MoJev의 수치는 자체 학습·평가 데이터 12,000건에서 잰 값이고, 이런 공개 벤치마크에서 잰 값이 아닙니다.
확률이 낮게 나오는 쪽은 그나마 안전한 실패입니다. 틀린 답을 자동으로 통과시키지는 않기 때문입니다. 대신 통과시키는 답도 거의 없습니다. BANKING77에서는 확률이 정답을 오답보다 높게 놓는 경우가 꽤 있었습니다(AUROC 0.74, 0.5가 무작위). 그러니 직접 가진 라벨로 온도를 다시 맞추면 확률이 실제 정답률에 가까워질 수도 있습니다. 반면 이름만 준 TREC에서는 이 값이 0.53으로 신호가 거의 없었습니다. 온도를 다시 맞추는 실험은 하지 않았습니다.
MoJev를 돌리려면 코드 한 줄을 고쳐야 했습니다. torch 2.14에서 어텐션 마스크는 float32인데 인코더는 bf16으로 돌아서, PyTorch 어텐션 커널이 자료형 불일치로 실행을 거부했습니다. 마스크를 bf16으로 바꾸고, 가려야 할 위치는 음의 무한대로 반올림되지 않도록 bf16이 표현할 수 있는 가장 작은 유한값으로 두었습니다. 가려지는 위치 자체는 바뀌지 않아야 하지만 제가 고친 부분이므로 밝혀 둡니다. 수정 내역은 결과 폴더에 있습니다.
실무에서는
- 과제가 Kev가 학습한 종류와 비슷하다면 Kev-0.8B부터 써 보세요. 14~25ms로, TREC과 AG News에서는 9B와 3%p 안쪽이었습니다(BANKING77에서는 9%p 뒤졌습니다). 확률도 선택지 77개짜리 과제의 절반 이상을 자동으로 넘길 만큼 믿을 만했습니다. Kev README는 학습하지 않은 출처에서 정확도가 더 낮다고 밝히고 있고, 그 조건은 제가 재지 않았습니다.
- 판단 모델을 고르기 전에 가진 라벨로 작은 분류기부터 학습해 보세요. BANKING77에서는 GPU에서 약 5ms(CPU에서 약 7ms)에 도는 MiniLM과 로지스틱 회귀가 이 글의 판단 모델을 모두 이겼습니다. 판단 모델이 제값을 하는 때는 라벨이 적거나 선택지가 자주 바뀌는 경우이고, 라벨 달린 예제가 이미 수천 개 있다면 사정이 다릅니다.
- 발표된 보정 오차는 직접 가진 데이터로 다시 확인하세요. MoJev의 0.79%는 공개 벤치마크에서 6~22%가 되었습니다.
- 설명은 붙인 경우와 뺀 경우를 둘 다 재 보세요. Kev-4B는 TREC에서 설명 덕분에 450개에서 477개로 올랐고, MoJev는 두 과제 모두에서 설명 때문에 떨어졌습니다.
측정 범위
세 데이터셋 모두 Kev가 학습한 출처입니다. 그러니 이 결과는 Kev에게 가장 유리한 경우이고, 처음 보는 과제에서 어떤지는 알려 주지 않습니다. Kev-27B는 돌리지 않았습니다. 과제마다 표본이 하나이고, 자동 통과 문턱값은 같은 표본에서 찾았으며, 지연 시간은 GPU 한 장에서 요청을 하나씩 보내 쟀습니다.
실험 환경: A100 80GB PCIe 한 장, 드라이버 580.178.04. Kev 저장소 09ff745, 어댑터 jaredpalmer/kev-0.8b 9a45d25, kev-4b 139fdd9, kev-9b 2629c06, Qwen3.5 베이스 리비전 dc7cdfe, 1001bb4, 68c46c4. python -m kev.serve로 bf16 서빙(torch 2.8.0, transformers 5.17.0, peft 0.21.0). MoJev 저장소 a74d58c, 체크포인트 MoLeMo-Lab/mojev 0c8695b, torch 2.14.0에서 mojev serve로 서빙했고 위에 적은 마스크 한 줄 수정을 적용했습니다. 두 모델 모두 같은 클라이언트로 System One 엔드포인트를 호출했습니다. 표본은 앞선 글과 같습니다(BANKING77 154개 시드 20260918, TREC test 500개, AG News 200개). 학습한 분류기는 all-MiniLM-L6-v2와 로지스틱 회귀이며, BANKING77 10,003개, TREC 5,452개, AG News 4,000개 학습 예제로 학습했습니다. 짝 비교용 문항별 결과를 남기려고 BANKING77은 GPU에서 다시 돌렸고, 138/154로 첫 글의 139/154보다 한 개 적었습니다. Kev의 development·calibration 분할과의 겹침은 소문자로 바꾸고 문장부호를 지운 뒤 문장이 그대로 일치하는지로 찾았습니다. 보정 오차는 1순위 확률 기준 10구간 ECE입니다. Kev의 경우 응답의 probabilities 중 가장 큰 값을 썼고, confidence 필드는 쓰지 않았습니다. 이 필드는 그 값을 선택지 수에 맞춰 다시 늘린 값((p − 1/K) / (1 − 1/K))이라 확률이 아닙니다. 분류기의 지연은 BANKING77이 GPU에서 4.6ms, TREC과 AG News가 CPU에서 5.7ms와 10.8ms입니다. McNemar 검정은 정확 검정, 양측입니다. 2026-09-25 측정.
이 글과 이어지는 강좌
SOTAAZ 강좌강좌는 하나씩 살 수 있습니다. 13개 전체가 필요하면 $199 평생 번들도 있습니다.
이메일로 받아보기
관련 포스트
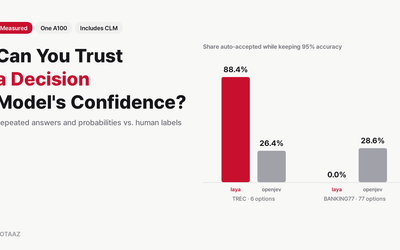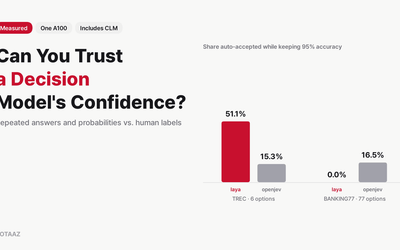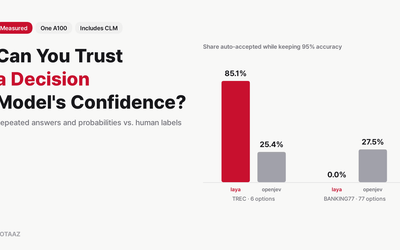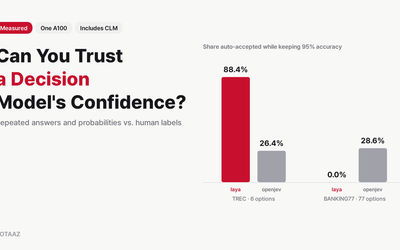
판단 모델의 확신을 믿어도 될까: 반복 응답과 확률 실측
판단 모델은 답마다 확률을 붙여 줘서, 확실한 건 바로 처리하고 나머지만 넘길 수 있다고 합니다. 그 '확실함'을 판단하는 두 방법을 사람이 붙인 정답 라벨로 평가했습니다. openjev가 틀린 답의 77~80%는 8번 뽑아도 모두 같은 답이었습니다. 확률은 그보다 나았지만 유용성이 과제에 따라 크게 달랐습니다. laya는 정확도 95%를 지키며 TREC의 88%를 자동 통과시켰고 BANKING77은 0%였습니다. 새로 나온 CLM-8B는 라벨 이름만 주면 세 데이터셋 모두 우연 수준이었습니다.
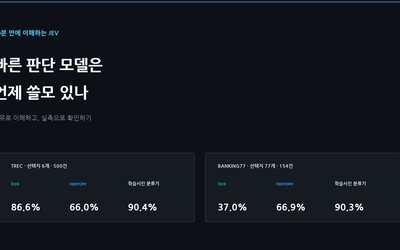
10분 만에 이해하는 Jev: 빠른 판단 모델은 언제 쓸모 있나
Jev는 글로 답하지 않고 선택지마다 확률을 매겨 돌려주는 모델입니다. 이런 모델이 왜 필요한지, 오픈소스는 같은 일을 어떻게 하는지, 그리고 세 번에 걸쳐 직접 재 본 결과를 정리했습니다. 선택지가 몇 개뿐이면 421M 모델이 23ms에 86.6%를 맞혔고, 77개면 CPU에서 도는 작은 분류기가 90%로 여전히 앞섰습니다.
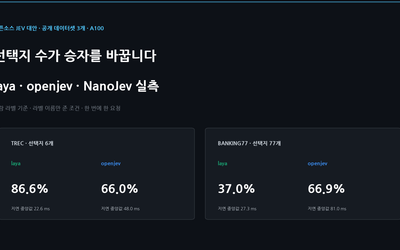
오픈소스 Jev 대안 셋을 같은 데이터로 재 보니: laya·openjev·NanoJev 실측
laya, openjev, NanoJev를 A100 한 장에서 BANKING77(의도 77개), TREC(질문 유형 6개), AG News로 쟀습니다. 선택지가 6개면 421M짜리 laya가 TREC 86.6%를 23ms에 냈고, 77개면 DiffusionGemma 기반 openjev가 66.9%로 앞섰습니다. 다만 77개에서는 CPU에서 도는 로지스틱 회귀가 90%로 전부를 이겼습니다.