판단 모델은 라벨 몇 개의 값어치일까: Kev가 처음 보는 과제 세 개 실측
Kev가 학습하지 않은 CLINC150, MASSIVE, 금융 뉴스 트윗에서 Kev-9B의 정확도는 클래스마다 라벨 2~20개로 학습한 작은 분류기와 비슷했습니다. 확률은 실제 정답률보다 10~17%p 낮게 나왔고(보정 오차 11~17%, 익숙한 데이터에서는 2~9%), 정확도 95% 기준으로 자동 통과시킬 수 있는 비율은 23~58%였습니다. 선택지에 없는 질문에는 낮은 확률을 붙여서 100개 중 5개만 그 기준을 넘었습니다. 0.8B 모델은 금융 트윗 200개 중 152개를 'Financials'로 답했습니다.
판단 모델은 라벨 몇 개의 값어치일까: Kev가 처음 보는 과제 세 개 실측
지난 글에서 Kev는 좋은 성적을 냈습니다. 확률이 잘 맞았고, 선택지 77개짜리 과제에서도 절반 넘게 정확도 95%를 지키며 자동으로 넘길 수 있었습니다. 하지만 그때 쓴 데이터셋 세 개는 모두 Kev가 학습한 것이었고, 글에서도 이 점을 가장 큰 한계로 적었습니다. 판단 모델을 쓸지 정할 때 정말 궁금한 것은 내 과제, 곧 모델이 처음 보는 과제에서 어떤가입니다.
그래서 이번에는 Kev의 학습 데이터 어디에도 없는 과제 세 개를 골라 사람이 단 라벨로 채점했습니다.
- CLINC150: 가상 비서에게 하는 요청을 의도 150개로 나눈 데이터입니다. 어느 의도에도 속하지 않는 질문(범위 밖 질문)도 섞여 있습니다. Kev 저자들은 이 데이터를 평가에만 쓰고 학습에는 쓰지 않았습니다.
- MASSIVE 영어: 음성 비서 요청을 의도 60개로 나눈 데이터입니다. Kev 저장소에 아예 나오지 않습니다.
- 금융 뉴스 트윗: Earnings, Fed | Central Banks, M&A | Investments 같은 주제 20개입니다. 역시 Kev 저장소에 없습니다. 금융 쪽에서 CFPB 민원 데이터는 Kev가 학습했기 때문에 뺐습니다.
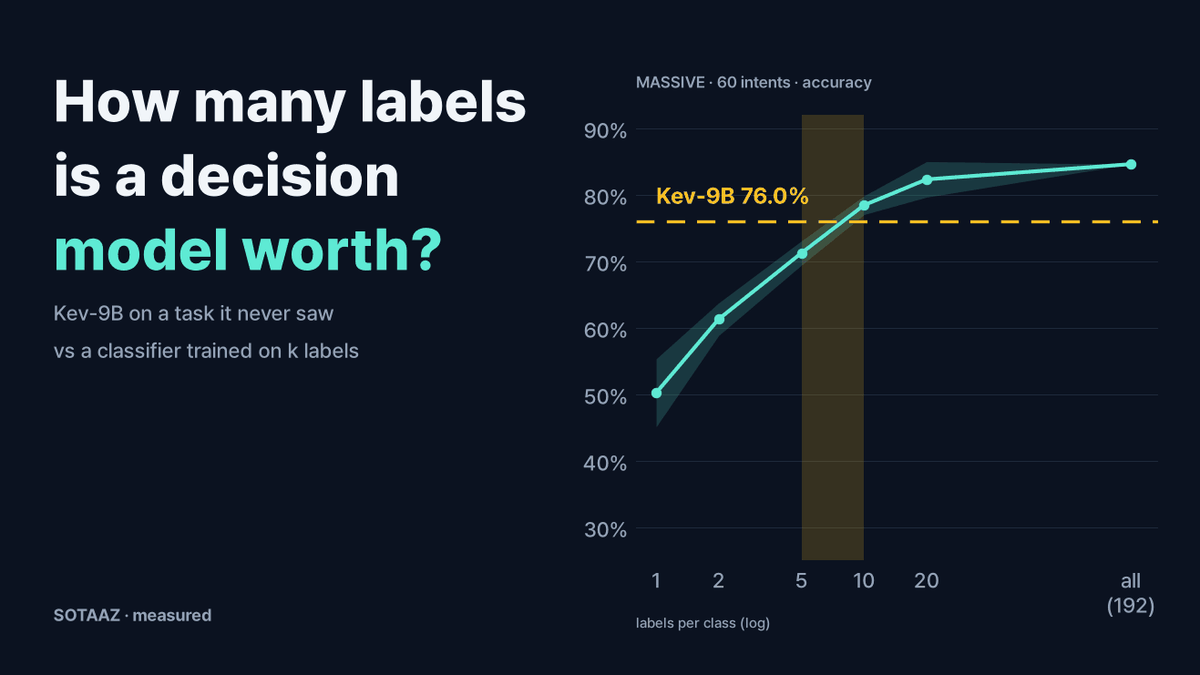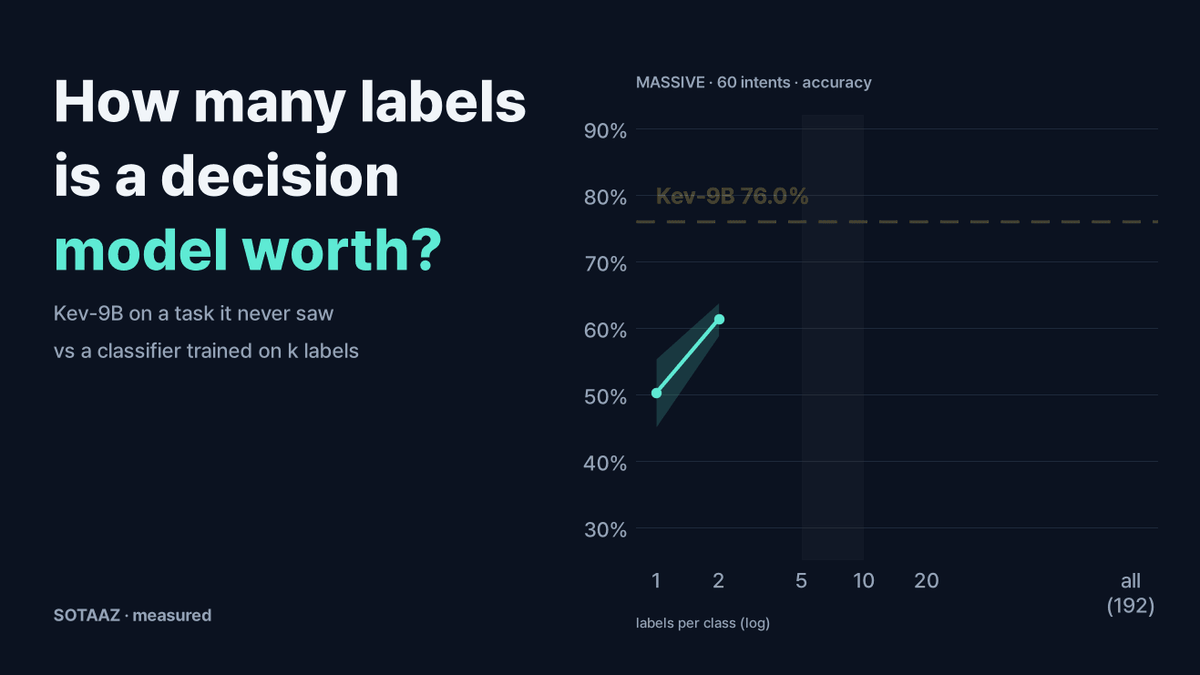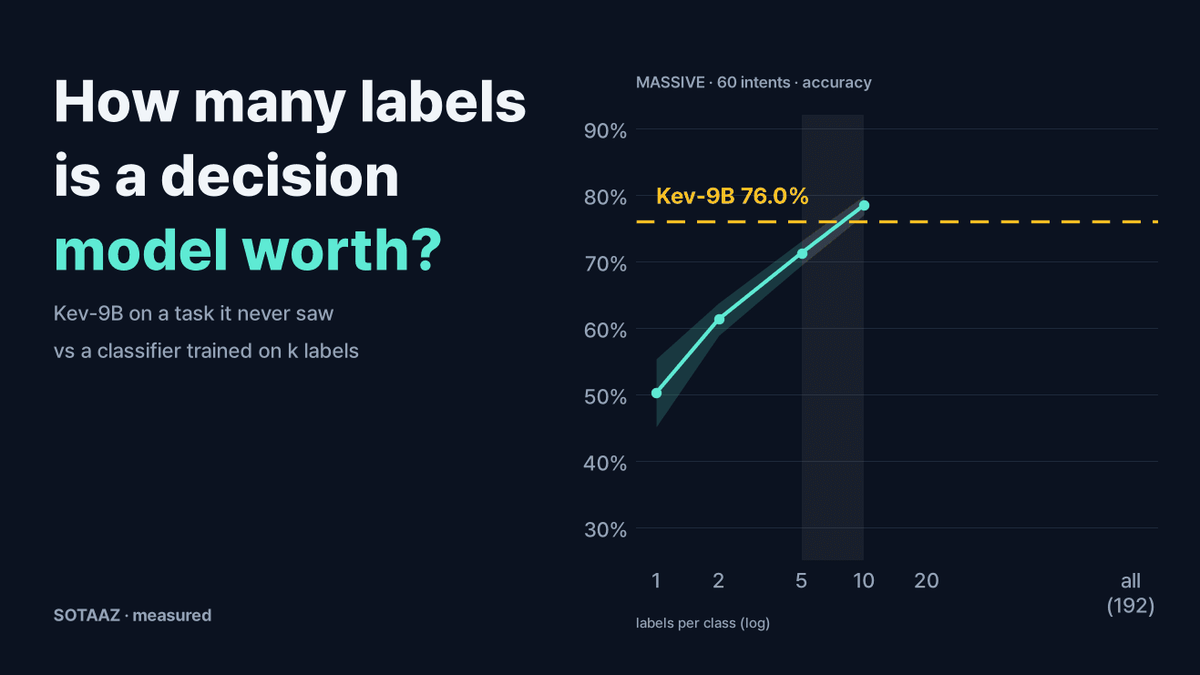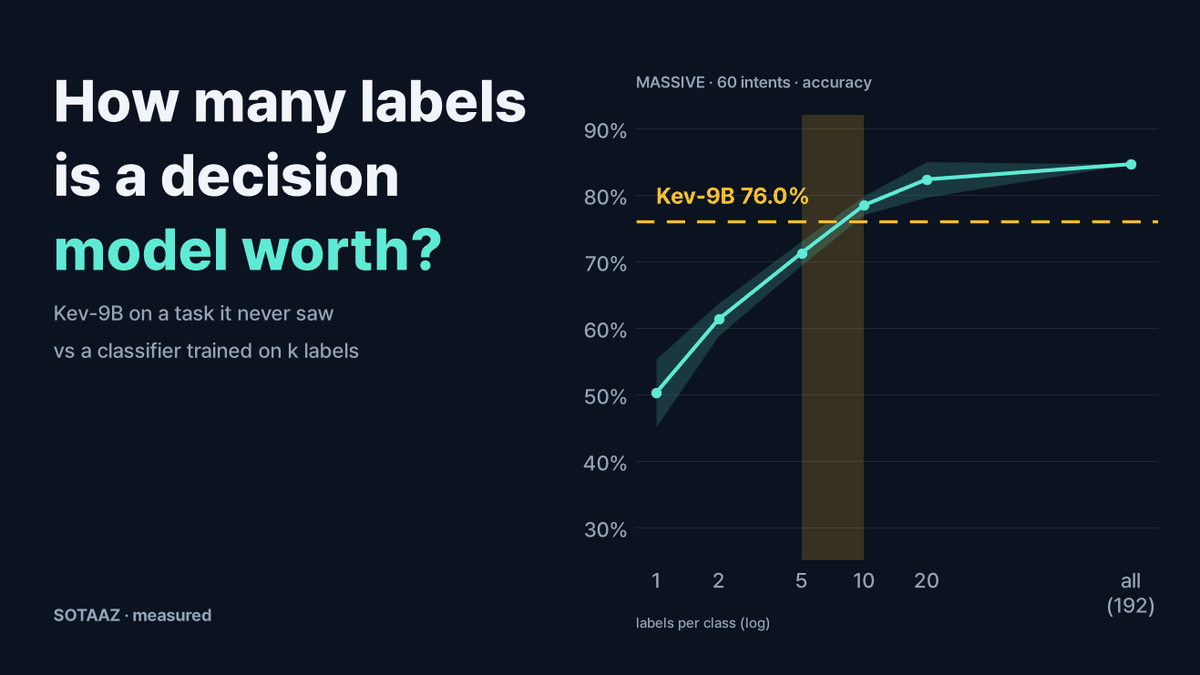
비교 상대도 바꿨습니다. 지난 글은 "라벨이 수천 개 있으면 작은 분류기가 이긴다"에서 멈췄습니다. 이번에는 거기서 한 걸음 더 들어가 작은 분류기가 판단 모델을 따라잡으려면 클래스마다 라벨이 몇 개 필요한가를 쟀습니다. MiniLM 임베딩과 로지스틱 회귀를 클래스마다 라벨 1, 2, 5, 10, 20개와 전체 학습 데이터로 학습했고, 라벨을 적게 쓰는 조건은 뽑기를 다섯 번 반복했습니다.
정확도: Kev-9B는 라벨 몇 개 정도의 값어치였습니다
| CLINC150 (150개 + 범위 밖, 상한 75%) | MASSIVE (60개) | 금융 트윗 (20개) | |
|---|---|---|---|
| Kev-0.8B | 50.0% | 70.3% | 22.5% |
| Kev-4B | 60.3% | 77.1% | 66.0% |
| Kev-9B | 62.0% | 76.0% | 69.5% |
| MoJev-0.85B | 29.3% | 36.6% | 40.5% |
| laya (선택지 예산 512토큰) | 37.3% | 27.4% | 42.0% |
| 분류기, 클래스당 라벨 1개 | 48.5% | 50.2% | 35.2% |
| 분류기, 클래스당 라벨 5개 | 64.8% | 71.2% | 54.9% |
| 분류기, 클래스당 라벨 20개 | 69.8% | 82.3% | 66.9% |
| 분류기, 전체 라벨 | 72.5% | 84.6% | 75.0% |
CLINC의 범위 밖 질문 100개에는 맞는 선택지가 없어서 어떤 모델이든 틀립니다. 그래서 정확도 상한이 75%입니다. 범위 안 질문 300개만 보면 Kev-9B의 정확도는 82.7%였습니다. 라벨을 적게 쓴 분류기 줄은 다섯 번 뽑은 결과의 평균이고, 뽑기 사이의 표준편차는 1~5%p였습니다.
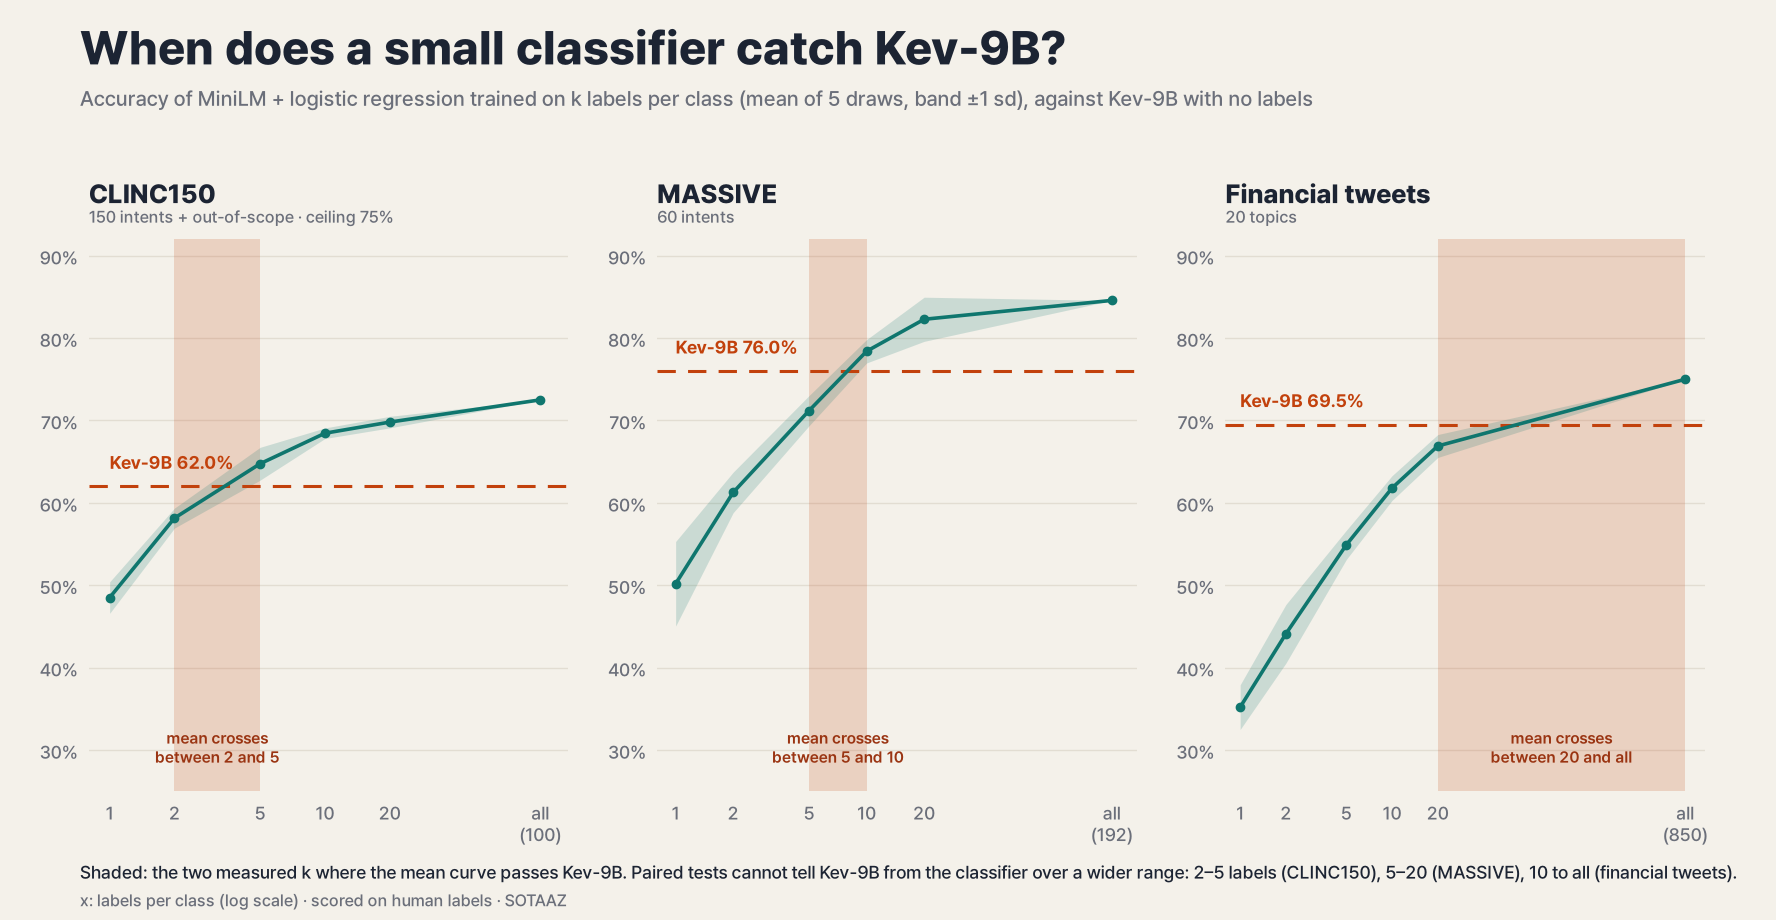
Kev-9B가 정확히 어디쯤인지는 과제마다 달랐습니다. 분류기의 첫 번째 뽑기와 문항 단위로 비교했습니다. 괄호 안은 Kev만 맞힌 문항 수와 분류기만 맞힌 문항 수입니다.
- CLINC150: 라벨 2개(45 대 32, p = 0.17), 5개(28 대 39, p = 0.22)와 통계적으로 구별되지 않았습니다. 라벨 10개부터는 분류기가 앞섰습니다(14 대 42, p < 0.001).
- MASSIVE: 라벨 2개보다는 앞섰고(41 대 15, p < 0.001), 5개·10개·20개와는 구별되지 않았습니다(p ≥ 0.52). 전체 데이터로 학습한 분류기만 앞섰습니다(13 대 28, p = 0.03).
- 금융 트윗: 라벨 5개보다는 앞섰고(58 대 24, p < 0.001), 10개·20개는 물론 학습 트윗 16,990개 전체로 학습한 분류기와도 구별되지 않았습니다(27 대 38, p = 0.22).
정리하면 처음 보는 과제에서 Kev-9B는 클래스마다 라벨 2~20개 정도의 값어치였습니다. Kev README도 학습하지 않은 출처에서는 정확도가 더 낮다고 밝히고 있어서, 이 결과와 어긋나지 않습니다. 익숙한 데이터를 쓴 지난 글에서는 BANKING77에서 Kev를 이기는 데 학습 예제 수천 개가 필요했고, 그렇게 학습한 분류기도 TREC에서는 Kev에게 졌습니다.
모델 크기는 익숙한 데이터에서보다 더 중요했습니다. Kev-4B와 Kev-9B는 세 과제 모두에서 통계적으로 구별되지 않았습니다(p ≥ 0.32). 반면 Kev-0.8B는 금융 트윗에서 무너졌습니다. 트윗 200개 중 152개를 주제 이름 가운데 가장 일반적인 "Financials"로 답했고, 정확도는 22.5%였습니다. 지난 글의 익숙한 과제에서는 이 모델이 9B와 3%p 안쪽이었던 과제가 두 개였습니다.
확률: 처음 보는 과제에서는 실제보다 낮게 불렀습니다
| 정확도 95%에서 자동 통과 비율 | CLINC150 | MASSIVE | 금융 트윗 |
|---|---|---|---|
| Kev-0.8B | 10.7% | 34.9% | 0% |
| Kev-4B | 46.3% | 42.3% | 13.5% |
| Kev-9B | 42.7% | 57.7% | 23.0% |
| 분류기, 클래스당 라벨 5개 | 50.6% | 41.8% | 16.1% |
| 분류기, 클래스당 라벨 20개 | 67.5% | 65.7% | 33.8% |
| 분류기, 전체 라벨 | 70.8% | 76.6% | 41.0% |
이번에도 문턱값은 채점에 쓴 표본에서 직접 찾았습니다. 그래서 위 비율은 이 표본에 대한 기술이지, 새 데이터에서도 그대로 나온다는 보장은 아닙니다.
Kev-9B의 보정 오차(모델이 말한 확률과 실제 정답률의 차이)는 이번 과제들에서 11~17%였습니다. 같은 모델이 학습한 과제에서는 2~9%였습니다. 중요한 것은 방향입니다. 세 과제 모두에서 1순위 확률의 평균이 실제 정답률보다 10~17%p 낮았습니다. 처음 보는 과제에서 Kev는 확신이 지나친 것이 아니라 오히려 모자랐습니다.
이 차이가 위 표의 자동 통과 비율을 바꾸지는 않습니다. 표의 비율은 라벨 달린 표본에서 문턱값을 직접 찾은 값이라, 확률이 정답을 오답보다 얼마나 잘 위에 두는지에만 달려 있기 때문입니다. 문제는 모델이 말한 확률을 그대로 믿을 때 생깁니다. "Kev가 95%라고 하면 통과"처럼 규칙을 정하면, 안전하게 통과시킬 수 있는 답보다 훨씬 적게 통과시키게 됩니다.
4B는 같은 방향으로 더 크게 어긋났습니다(실제보다 17~28%p 낮음). 정답을 오답보다 위에 두는 정도도 조금 떨어졌습니다(AUROC 0.74~0.90, 9B는 0.76~0.91). 정확도는 9B와 비슷했지만 두 과제에서 자동 통과 비율이 9B보다 낮았습니다. 예외는 금융 트윗의 Kev-0.8B 하나로, 확률이 실제보다 31%p 높았습니다. 거의 모든 트윗을 "Financials"로 답한 바로 그 실행입니다.
분류기 쪽은 라벨 수에 따라 크게 갈렸습니다. 전체 데이터로 학습한 분류기는 이 글에 나온 모든 모델 중 보정이 가장 잘 맞았습니다(4~7%). 반면 라벨 5개로 학습한 분류기는 확률이 실제 정답률보다 31~37%p 낮았습니다. 예제 몇 개로 학습한 모델이 말하는 확률도 액면 그대로 받아들이면 안 된다는 뜻입니다.
맞는 선택지가 없는 질문
CLINC의 범위 밖 질문 100개는 실제 운영에서 흔히 생기는 경우입니다. 사용자가 준비된 선택지 어디에도 해당하지 않는 것을 물으면, 판단 모델에는 "해당 없음"이라는 선택지가 없어서 무엇이든 하나를 고르게 됩니다.
Kev-9B도 의도 하나를 골랐지만, 낮은 확률을 붙였습니다. 1순위 확률의 평균이 범위 밖 질문에서는 0.20, 범위 안 질문에서는 0.62였습니다. 이 확률만으로 두 집단을 꽤 잘 가를 수 있었습니다(AUROC 0.88, 0.5가 무작위). 통과시킨 답의 정확도를 95%로 지키는 문턱값에서, 범위 밖 질문은 100개 중 5개만 통과했습니다. Kev-4B는 3개, Kev-0.8B는 1개가 통과했지만, 두 모델은 전체적으로 통과시킨 답 자체가 더 적었습니다.
그러니 "해당 없음" 선택지가 없어도, 낮은 확률을 사람에게 넘기는 신호로 쓸 수는 있습니다. 다만 그 선택지를 완전히 대신하지는 못합니다. 100개 중 5개는 여전히 빠져나갔습니다.
MoJev와 laya
두 모델 모두 세 과제에서 크게 뒤처졌습니다. MoJev는 이번에도 확률이 실제보다 낮았습니다. CLINC150의 범위 안 질문에서 1순위 확률 평균이 0.07이었는데, 정확도는 39%였습니다. 확률이 실제보다 높게 나온 모델은 laya뿐이었습니다(34~65%p 높음).
laya는 선택지 150개인 CLINC150을 기본 설정으로는 아예 돌리지 못했습니다. 선택지가 예산을 넘었기 때문입니다. 그래서 표의 laya 줄은 문서가 선택지가 많을 때 권하는 512토큰 예산으로 잰 값입니다. laya는 자체 벤치마크에서 MASSIVE 영어를 선택지 20개로 물어 78.3%를 발표했습니다. 이번에 의도 60개를 모두 선택지로 주자 설정에 따라 27~34%였습니다. 두 실험은 선택지 수 말고도 다른 점이 있지만, 선택지가 세 배로 늘어난 것이 가장 먼저 의심되는 원인입니다.
실무에서는
- 모델을 고르기 전에 가진 라벨 수부터 세 보세요. 클래스마다 라벨이 20개쯤 있으면, 작은 분류기가 세 과제 모두에서 정확도로 Kev-9B와 같거나 앞섰고 95% 기준 자동 통과 비율도 더 높았습니다. 전체 데이터로 학습하면 보정도 훨씬 잘 맞았습니다. 반대로 라벨이 1~2개뿐이면 Kev-9B가 앞서거나 비슷했습니다.
- 처음 보는 과제에는 0.8B 말고 4B나 9B를 쓰세요. 가장 작은 모델은 처음 보는 과제에서 한 라벨로 쏠렸습니다.
- 문턱값은 모델이 말한 확률이 아니라 가진 라벨로 정하세요. Kev에 들어 있는 온도 값은 익숙한 과제에서는 잘 맞았지만, 처음 보는 과제에서는 확률을 10~17%p 낮게 불렀습니다. 그래서 "95%면 95%"로 믿는 규칙은 사람에게 너무 많이 넘깁니다. 표처럼 라벨 달린 표본에서 문턱값을 고르면 이 문제를 피할 수 있습니다. 가진 데이터로 온도를 다시 맞추면 말하는 확률 자체가 정직해지겠지만, 이번에 시험하지는 않았습니다.
- 범위 밖 질문은 낮은 확률로 걸러 내되, 표본을 사람이 확인하세요. 정확도 95% 기준에서 맞는 선택지가 없는 질문 100개 중 95개를 걸러 냈습니다. 대신 같은 문턱값에서 자동 통과한 것은 CLINC 400개 중 171개였고, 나머지는 사람에게 갔습니다.
측정 범위
과제는 세 개이고, 모두 짧은 영어 문장에 의도나 주제 라벨을 붙이는 일입니다. 과제마다 표본은 하나이고, 짝 비교는 분류기의 다섯 번 뽑기 중 첫 번째와만 했습니다. 분류기는 임베딩 모델 하나에 정규화 값 하나로만 학습했습니다. 이번 실행 동안 GPU를 다른 작업과 나눠 써서 지연 시간은 재지 않았습니다. Kev-27B도 돌리지 않았습니다.
실험 환경: A100 80GB PCIe 한 장, 드라이버 580.178.04. Kev 저장소 09ff745, 어댑터 jaredpalmer/kev-0.8b 9a45d25, kev-4b 139fdd9, kev-9b 2629c06, python -m kev.serve로 bf16 서빙. MoJev a74d58c에 지난 글의 마스크 한 줄 수정을 적용했고, laya는 0.3.7에 head_max_len 512입니다. 표본: CLINC150(clinc/clinc_oos, "plus", CC-BY-3.0) test 분할에서 의도마다 2개와 범위 밖 질문 100개, MASSIVE 영어(mteb/amazon_massive_intent, CC-BY-4.0) test 분할에서 의도마다 3개를 뽑아 의도 59개에서 175개입니다(general_greet는 1개, cooking_query는 test 분할에 없음). 선택지로는 의도 60개를 모두 줬습니다. 금융 뉴스 트윗(zeroshot/twitter-financial-news-topic, MIT)은 validation 분할에서 주제마다 10개를 뽑았고, 시드는 20260926입니다. 라벨 이름은 각 데이터셋의 원래 이름을 썼습니다. 세 데이터셋 모두 Kev의 학습 출처에 없습니다. CLINC150은 Kev의 평가 전용 스위트에 있는데, 그 개발용 분할은 CLINC의 validation 분할에서 뽑았고 이번 표본은 test 분할에서 뽑았습니다. 로컬에 있는 Kev 데이터 파일과 문장을 그대로 대조했을 때는 "what is the weather" 같은 짧은 문장 세 개만 관련 없는 스위트에서 나왔습니다. 분류기는 all-MiniLM-L6-v2와 로지스틱 회귀(C = 10)이고, 각 데이터셋의 train 분할에서 클래스마다 k개를 다섯 번 뽑아 학습했습니다. 보정 오차는 1순위 확률 기준 10구간 ECE이고, McNemar 검정은 정확 검정, 양측입니다. 2026-09-26 측정.
이 글과 이어지는 강좌
SOTAAZ 강좌강좌는 하나씩 살 수 있습니다. 13개 전체가 필요하면 $199 평생 번들도 있습니다.
이메일로 받아보기
관련 포스트
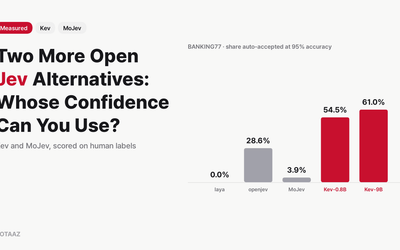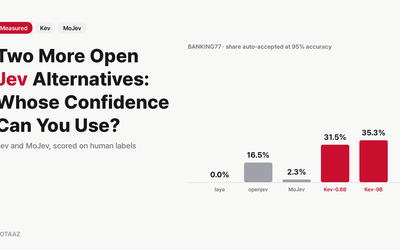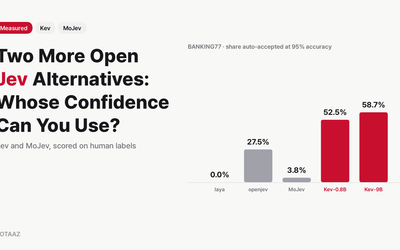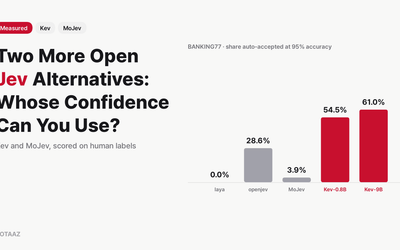
Kev와 MoJev 실측: 오픈소스 Jev 대안 두 개의 정확도와 확률
Jev와 같은 API를 쓰는 Kev(0.8B~9B)와 MoJev(0.85B)를 BANKING77·TREC·AG News에서 사람 라벨로 채점했습니다. Kev의 확률은 쓸 만했습니다. 정확도 95%를 지키며 BANKING77의 53~61%를 자동 통과시켰고, 같은 조건에서 laya는 0%였습니다. 다만 Kev는 이 세 데이터셋으로 학습된 모델이고, 같은 데이터로 학습한 작은 분류기가 BANKING77에서는 여전히 앞섰습니다. MoJev는 보정 오차 0.79%를 발표했지만 여기서는 6~22%였고, 확률이 실제보다 낮게 나왔습니다.
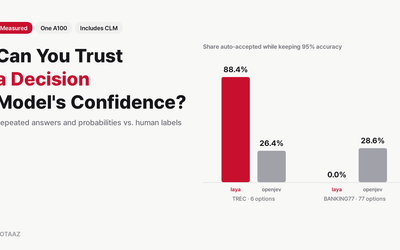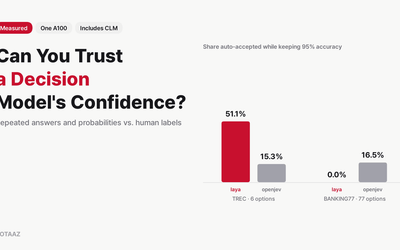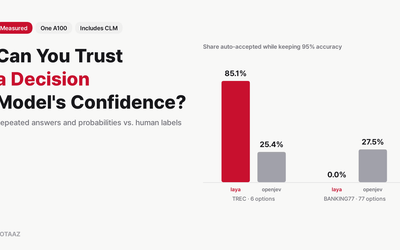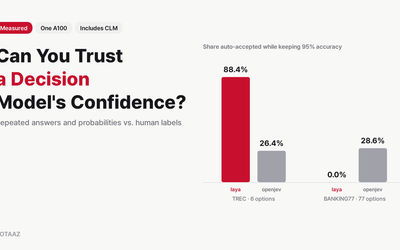
판단 모델의 확신을 믿어도 될까: 반복 응답과 확률 실측
판단 모델은 답마다 확률을 붙여 줘서, 확실한 건 바로 처리하고 나머지만 넘길 수 있다고 합니다. 그 '확실함'을 판단하는 두 방법을 사람이 붙인 정답 라벨로 평가했습니다. openjev가 틀린 답의 77~80%는 8번 뽑아도 모두 같은 답이었습니다. 확률은 그보다 나았지만 유용성이 과제에 따라 크게 달랐습니다. laya는 정확도 95%를 지키며 TREC의 88%를 자동 통과시켰고 BANKING77은 0%였습니다. 새로 나온 CLM-8B는 라벨 이름만 주면 세 데이터셋 모두 우연 수준이었습니다.
10분 만에 이해하는 Jev: 빠른 판단 모델은 언제 쓸모 있나
Jev는 글로 답하지 않고 선택지마다 확률을 매겨 돌려주는 모델입니다. 이런 모델이 왜 필요한지, 오픈소스는 같은 일을 어떻게 하는지, 그리고 세 번에 걸쳐 직접 재 본 결과를 정리했습니다. 선택지가 몇 개뿐이면 421M 모델이 23ms에 86.6%를 맞혔고, 77개면 CPU에서 도는 작은 분류기가 90%로 여전히 앞섰습니다.