Kev vs Jev: Kev 0.8B~9B와 Jev의 정확도·확률 보정 비교
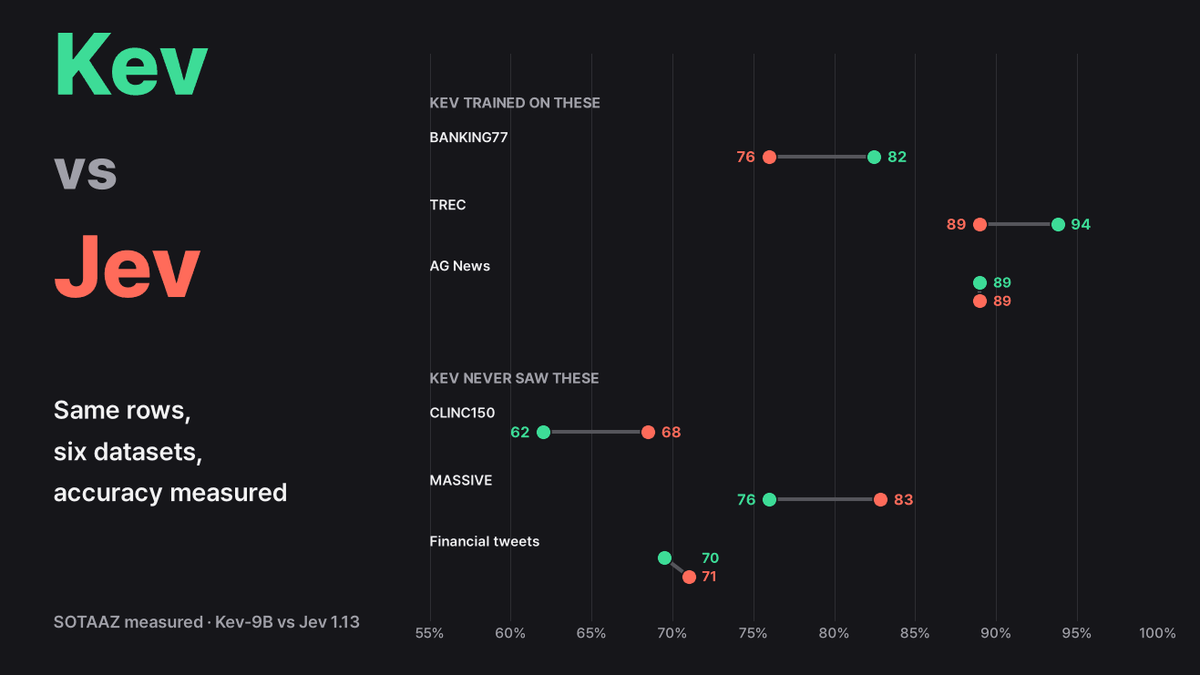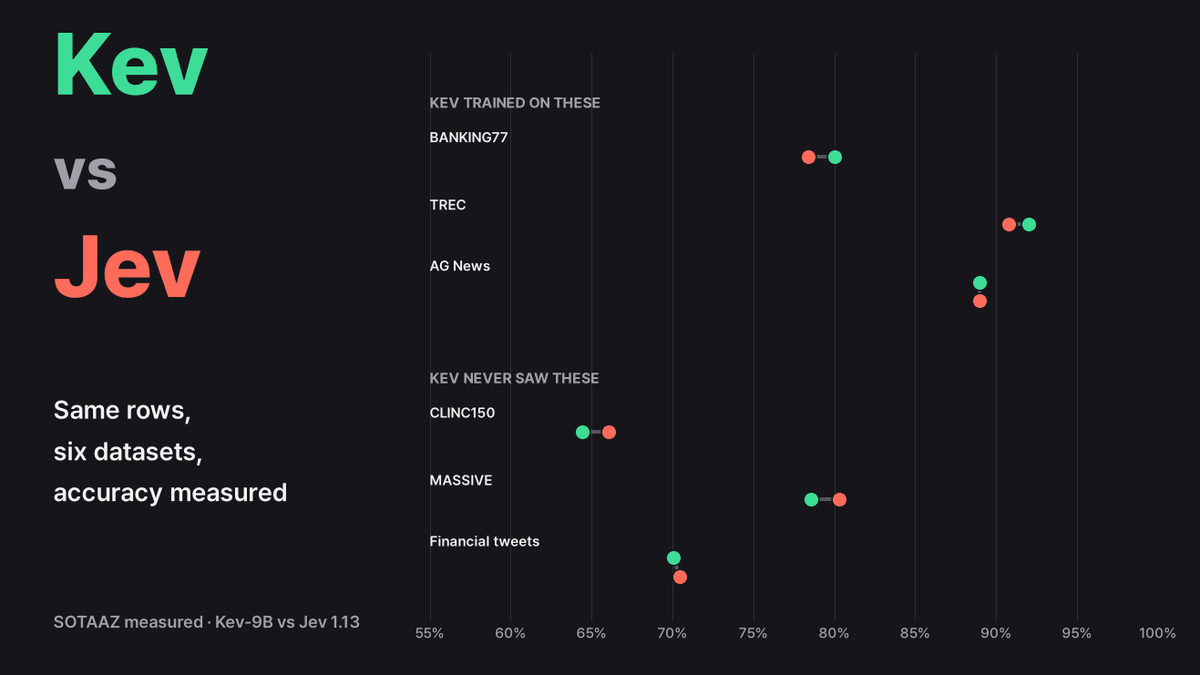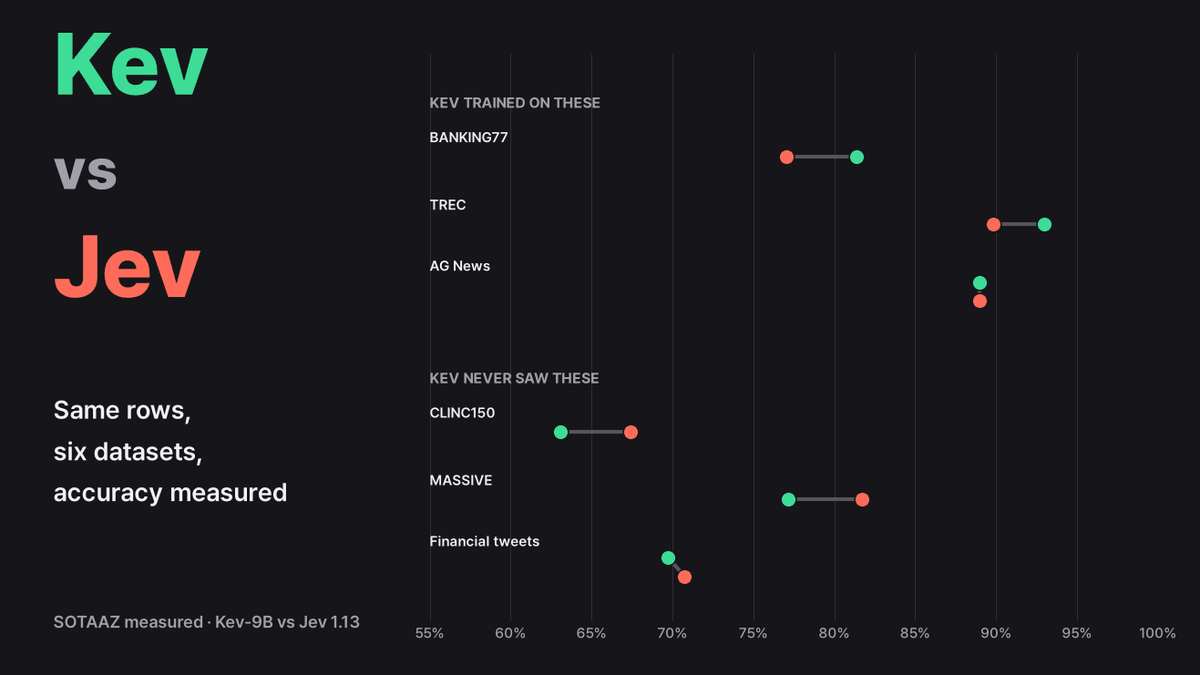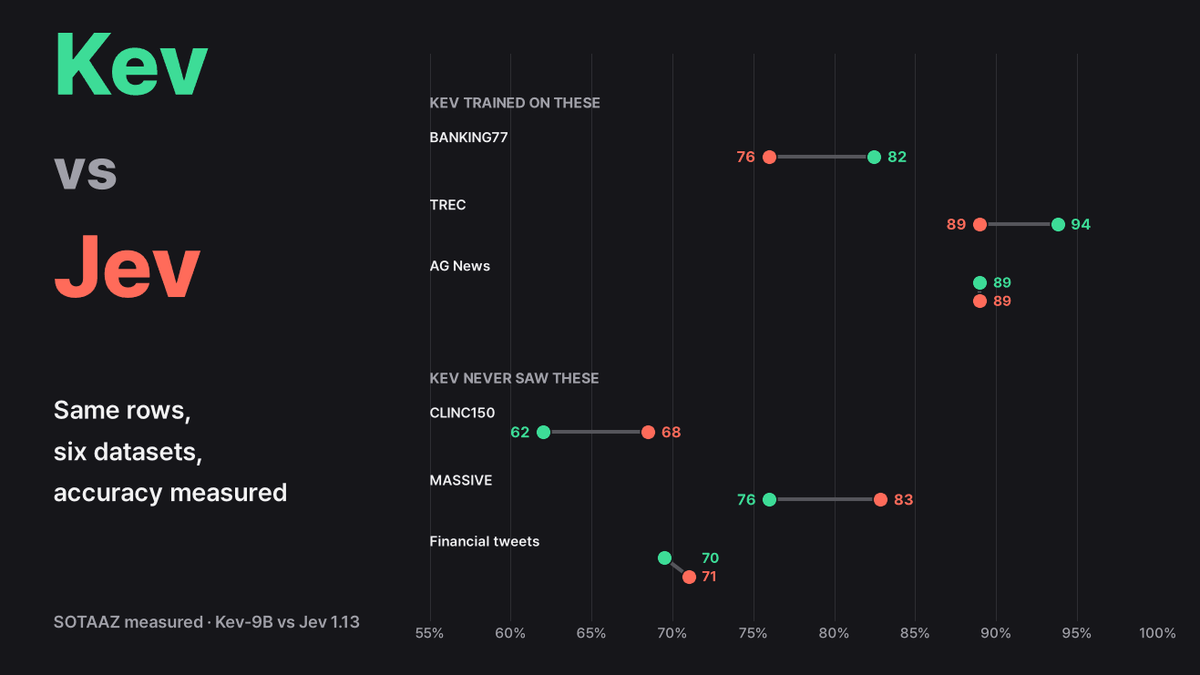
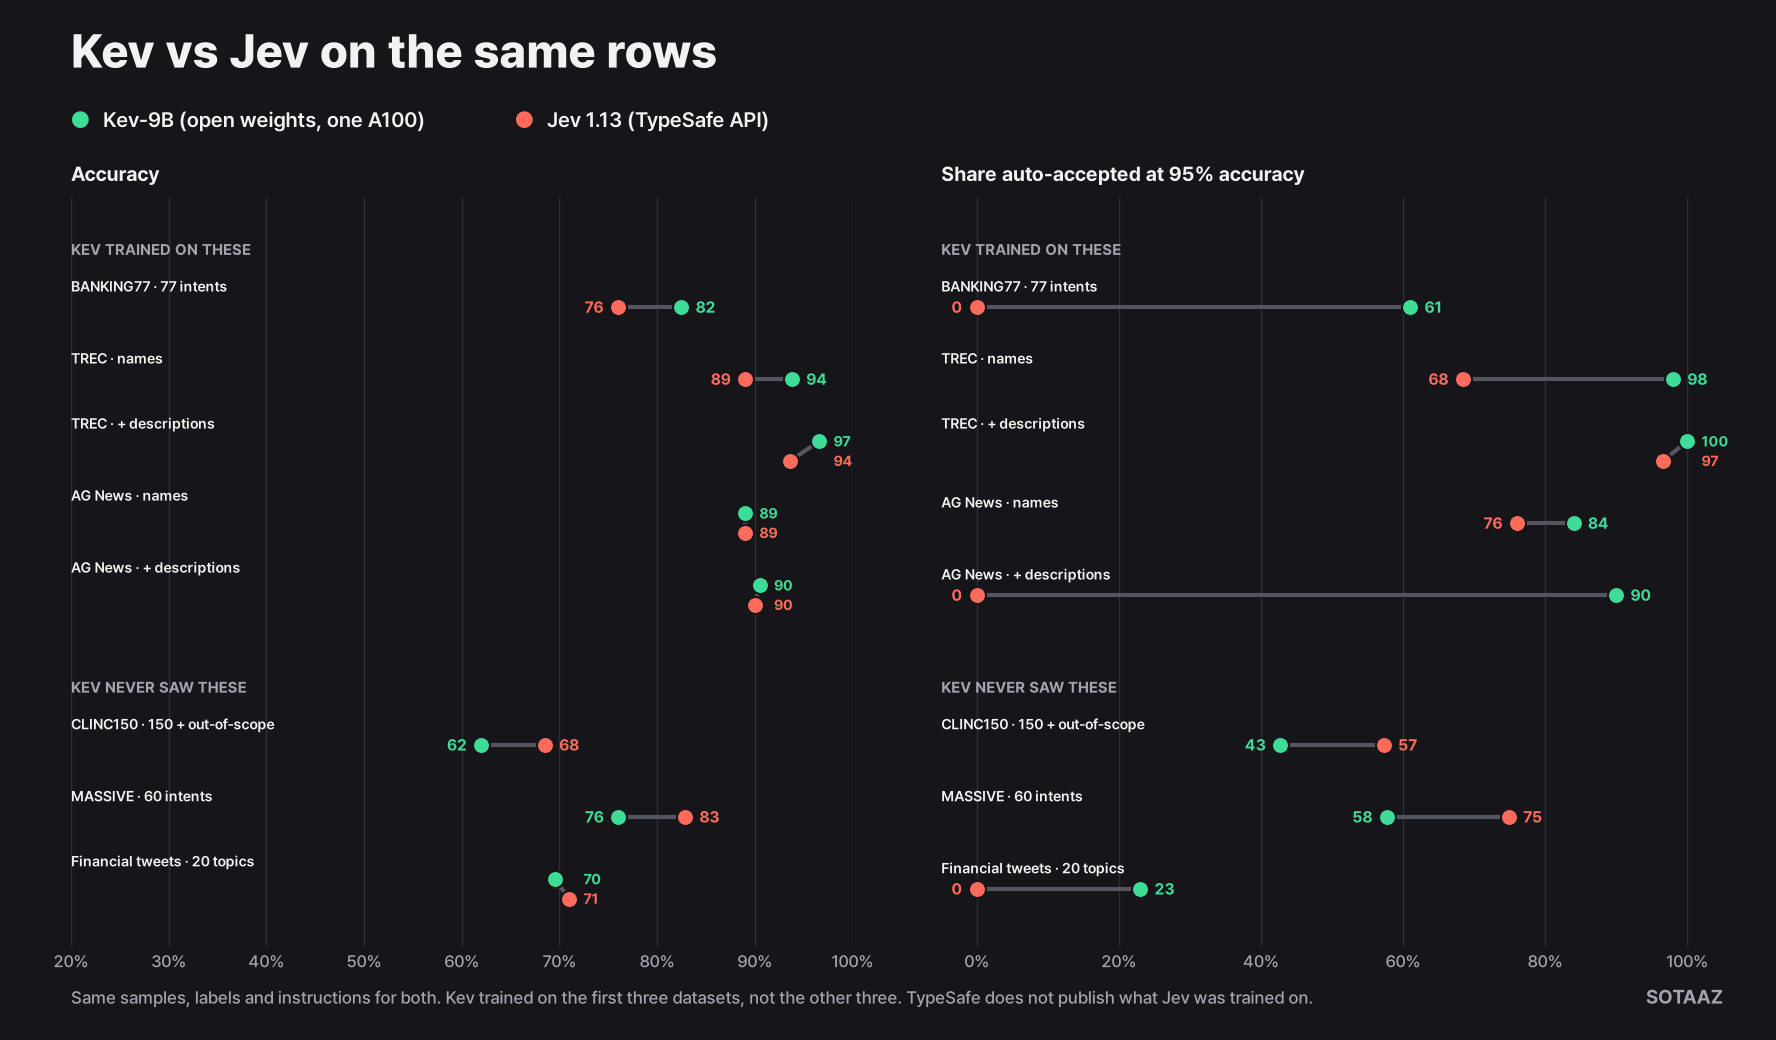
같은 문장 1,629개(요청 2,329건)에 Kev(0.8B, 4B, 9B)와 Jev 1.13을 돌렸습니다. Kev가 학습한 데이터셋 세 개에서는 Kev-9B가 같거나 앞섰고(TREC 93.8% 대 89.0%), 처음 보는 세 개 중 두 개에서는 Jev가 앞섰습니다(CLINC150 68.5% 대 62.0%, MASSIVE 82.9% 대 76.0%). Jev 확률은 실제 정확도보다 높게 나오고 소수 둘째 자리로 반올림돼 있어서, BANKING77에서는 정확도 95%를 지키는 임계값이 없었습니다.
Kev vs Jev: Kev 0.8B~9B와 Jev의 정확도·확률 보정 비교
Jev는 TypeSafe가 API로 제공하는 판단 모델입니다. 문장과 함께 "이 중 무엇인가"를 묻는 질문을 보내면 답 하나와 선택지별 확률을 돌려줍니다. Kev는 같은 요청 형식을 받는 오픈 가중치 모델이라 내 GPU에서 돌릴 수 있습니다.
앞선 두 글에서 Kev를 학습한 데이터셋 세 개와 처음 보는 데이터셋 세 개로 쟀습니다. 이번에는 같은 문장으로 Jev 1.13(jev-1.13.0)을 쟀습니다. 문장, 라벨 이름, 한 줄 설명, 지시문, 사람이 붙인 정답까지 모두 같아서, 아래 비교는 전부 문장 하나하나를 짝지어 본 결과입니다.
요약
- Kev가 학습한 데이터셋에서는 Kev-9B가 Jev와 같거나 더 정확했습니다. TREC에서는 앞섰고 AG News에서는 비겼습니다. BANKING77에서는 10개를 더 맞혔지만 통계적으로 확실한 차이는 아닙니다.
- Kev가 처음 보는 데이터셋에서는 셋 중 둘에서 Jev가 더 정확했습니다. CLINC150은 68.5% 대 62.0%, MASSIVE는 82.9% 대 76.0%였고 금융 뉴스 트윗은 비겼습니다.
- Jev는 확률을 실제보다 높게, Kev는 새 과제에서 낮게 말했습니다. 게다가 Jev 확률은 소수 둘째 자리로 반올림돼 오고, 1.00으로 온 답 1,021개 중 43개가 틀렸습니다. 그래서 BANKING77에서는 자동으로 받아들인 답의 정확도를 95%로 지키는 임계값이 하나도 없었습니다.
Kev가 학습한 데이터셋
Kev의 학습 데이터에는 BANKING77, TREC, AG News의 학습 분할이 들어 있습니다. 제 표본은 시험 분할에서 뽑았으니 Kev가 이 문장 자체를 본 적은 없지만, Kev가 가장 잘 아는 과제인 것은 분명합니다. Jev는 무엇으로 학습했는지 TypeSafe가 공개하지 않아서, 이 공개 데이터셋을 봤는지는 알 수 없습니다.
| Kev-9B | Jev 1.13 | 한쪽만 맞힌 문장 (Kev / Jev) | |
|---|---|---|---|
| BANKING77, 의도 77개 (154) | 127 (82.5%) | 117 (76.0%) | 17 / 7, p = 0.06 |
| TREC, 라벨 이름만 (500) | 469 (93.8%) | 445 (89.0%) | 33 / 9, p < 0.001 |
| TREC, 설명 추가 (500) | 483 (96.6%) | 468 (93.6%) | 18 / 3, p = 0.001 |
| AG News, 라벨 이름만 (200) | 178 (89.0%) | 178 (89.0%) | 7 / 7, p = 1 |
| AG News, 설명 추가 (200) | 181 (90.5%) | 180 (90.0%) | 6 / 5, p = 1 |
p값은 둘 중 한쪽만 맞힌 문장으로 계산한 정확 McNemar 검정입니다. BANKING77에서 Jev가 받은 76.0%는 nibzard 벤치마크의 76.3%(의도 77개 전체, 다른 표본)와 가깝습니다.
첫 글에서 쓴 작은 분류기(MiniLM 임베딩에 로지스틱 회귀, 각 데이터셋 학습 분할로 학습)는 BANKING77에서 여전히 둘 다 이겼습니다. 154개 중 138개를 맞혔고, Jev와 짝지어 보면 24 대 3입니다(p < 0.001). 반대로 TREC 설명 추가 조건에서는 Jev가 분류기를 이겼고(468 대 452, 36 대 20, p = 0.04), AG News에서는 셋의 차이가 기사 네 건 이내였습니다.
Kev가 처음 보는 데이터셋
지난 글에서 Kev 학습 데이터에 전혀 없는 것을 골라 쓴 세 과제입니다. 여러분의 과제에서 어떤 결과가 나올지 가늠하기에는 이쪽이 더 공정합니다.
| Kev-9B | Jev 1.13 | 한쪽만 맞힌 문장 (Kev / Jev) | |
|---|---|---|---|
| CLINC150, 의도 150개 + 범위 밖 (400) | 248 (62.0%) | 274 (68.5%) | 5 / 31, p < 0.001 |
| MASSIVE, 의도 60개 (175) | 133 (76.0%) | 145 (82.9%) | 5 / 17, p = 0.02 |
| 금융 뉴스 트윗, 주제 20개 (200) | 139 (69.5%) | 142 (71.0%) | 11 / 14, p = 0.69 |
CLINC150의 범위 밖 질문 100개는 맞는 선택지가 없어서 최대치가 75%입니다. 범위 안 질문 300개만 보면 Jev는 91.3%, Kev-9B는 82.7%를 맞혔습니다.
지난 글에서 Kev-9B는 이 과제들에서 클래스당 라벨 2~20개로 학습한 분류기와 비슷했습니다. Jev 정확도는 그 범위의 위쪽 끝에 해당합니다. 클래스당 20개로 학습한 분류기는 다섯 번 뽑은 평균이 69.8%, 82.3%, 66.9%였고 Jev는 68.5%, 82.9%, 71.0%였습니다. 이번에는 분류기와 짝지은 검정을 하지 않았으니 "비슷하다" 정도로만 읽어 주세요.
Kev 크기별로 Jev와 비교
Kev는 0.8B, 4B, 9B 세 크기가 같은 서버로 돌아갑니다. 그러니 어느 크기를 쓸지도 궁금한 부분입니다. 같은 문장에 대한 정확도입니다.
| Kev-0.8B | Kev-4B | Kev-9B | Jev 1.13 | |
|---|---|---|---|---|
| BANKING77 | 73.4% | 81.2% | 82.5% | 76.0% |
| TREC, 라벨 이름만 | 94.6% | 90.0% | 93.8% | 89.0% |
| TREC, 설명 추가 | 96.4% | 95.4% | 96.6% | 93.6% |
| AG News, 라벨 이름만 | 87.0% | 88.5% | 89.0% | 89.0% |
| AG News, 설명 추가 | 88.0% | 89.0% | 90.5% | 90.0% |
| CLINC150 (Kev가 처음 봄) | 50.0% | 60.3% | 62.0% | 68.5% |
| MASSIVE (처음 봄) | 70.3% | 77.1% | 76.0% | 82.9% |
| 금융 뉴스 트윗 (처음 봄) | 22.5% | 66.0% | 69.5% | 71.0% |
가장 작은 0.8B가 TREC에서는 Jev를 이겼습니다. 라벨 이름만 줬을 때 94.6% 대 89.0%였고(한쪽만 맞힌 질문 39 대 11, p < 0.001), 설명을 붙였을 때 96.4% 대 93.6%였습니다(p = 0.02). 그런데 처음 보는 과제에서는 크게 무너졌습니다. 트윗 200개 중 152개에 "Financials"라고 답했고, CLINC150과 MASSIVE에서도 Jev에 크게 뒤졌습니다(각각 p < 0.001). Kev-4B는 TREC 라벨 이름만 조건을 빼면 9B와 가까웠습니다. 처음 보는 과제에서 Jev와 비교하면 4B가 확실히 뒤진 것은 CLINC150뿐이었고(p < 0.001), MASSIVE(p = 0.06)와 트윗(p = 0.15)은 통계적으로 차이가 없었습니다.
확률: Jev는 높게, Kev는 낮게
두 모델 모두 선택지마다 확률을 줍니다. 이 확률의 쓸모는 사람이 확인하지 않아도 되는 답을 골라내는 데 있습니다. 그래서 두 가지를 쟀습니다. 모델이 말한 확률이 실제 정확도와 얼마나 떨어져 있는지, 그리고 임계값 하나로 답을 자동 수락할 때 정확도 95%를 지키면서 몇 %까지 받아들일 수 있는지입니다.
| 평균 최고 확률 − 정확도 (Kev-9B / Jev) | 정확도 95%에서 자동 수락 비율 (Kev-9B / Jev) | |
|---|---|---|
| BANKING77 | −9.3 / +13.9%p | 61.0% / 0% |
| TREC, 라벨 이름만 | −3.8 / −0.1 | 98.0% / 68.4% |
| TREC, 설명 추가 | −0.3 / +0.9 | 100% / 96.6% |
| AG News, 라벨 이름만 | +1.3 / +6.7 | 84.0% / 76.0% |
| AG News, 설명 추가 | +1.3 / +7.1 | 90.0% / 0% |
| CLINC150 | −10.3 / +15.2 | 42.7% / 57.3% |
| MASSIVE | −16.7 / +6.4 | 57.7% / 74.9% |
| 금융 뉴스 트윗 | −16.6 / +15.8 | 23.0% / 0% |
이 표는 모두 선택지 확률의 최댓값을 기준으로 했습니다. Jev 응답에는 이와 별도로 confidence 필드가 있고, TypeSafe 문서는 이를 확률 분포가 얼마나 한쪽에 몰렸는지를 나타내는 값으로 설명합니다. 이 값은 BANKING77 154건 중 67건, CLINC150 400건 중 190건에서 확률 최댓값과 달랐습니다. 이름이 confidence이니 이 값으로 임계값을 잡는 독자가 많을 것 같아 다시 계산했습니다. CLINC150은 60.0%, MASSIVE는 80.0%, TREC 라벨 이름만은 67.2%였고, 위의 세 과제는 이 값도 소수 둘째 자리로 반올림돼 있어서 그대로 0%였습니다. 결론은 달라지지 않습니다.
양수는 모델이 실제보다 더 확신했다는 뜻입니다. Jev는 여덟 조건 중 여섯에서 확신이 지나쳤고, TREC에서는 거의 정확했습니다. Kev-9B는 아는 데이터셋에서는 거의 맞았고, 새 데이터셋에서는 지난 글과 같이 확신이 모자랐습니다. 임계값은 채점하는 표본과 같은 표본에서 찾았으니, 수락 비율은 이 표본에 대한 값입니다.
Jev의 0%는 따로 설명이 필요합니다. 그 과제들에서 Jev 정확도가 낮았던 것이 아니기 때문입니다. Jev가 돌려준 확률은 전부 소수 둘째 자리로 반올림돼 있었고, 상당수가 정확히 1.00이었습니다. BANKING77에서는 1.00으로 온 답이 64개였는데 그중 맞은 것은 58개, 90.6%였습니다. 1.00보다 높은 값은 없으니 이 묶음은 더 쪼갤 수 없습니다. 임계값을 낮추면 0.99, 0.98인 답이 더해지지만, 어떤 임계값에서도 받아들인 답의 정확도가 91.6%(0.95일 때)를 넘지 않았습니다. 그래서 0%입니다. AG News 설명 추가(1.00이 154개, 94.2% 정답, 더 낮은 임계값도 이보다 낫지 않음)와 금융 트윗(1.00이 70개, 90.0% 정답, 최고 90.0%)도 같은 경우입니다. Kev는 반올림하지 않은 확률을 주고, 가장 확신한 답이 더 자주 맞았습니다.
반대로 Jev의 확신이 맞아떨어진 새 과제 두 개에서는 Jev가 더 많이 받아들였습니다. CLINC150은 57.3% 대 42.7%, MASSIVE는 74.9% 대 57.7%입니다. 이 두 과제에서는 맞은 답을 틀린 답보다 높게 줄 세우는 능력도 Jev가 조금 나았습니다(AUROC 0.92, 0.90 대 Kev-9B 0.91, 0.88). Kev가 학습한 데이터셋에서는 모두 Kev가 나았습니다.
정리하면 새 과제에서는 두 모델 모두 말한 확률을 그대로 믿으면 안 됩니다. Kev는 10~17%p 낮게 말하니 "95%면 수락" 같은 규칙이 너무 적게 받아들이고, Jev는 대부분 6~16%p 높게 말하니 같은 규칙이 너무 많이 받아들입니다. 둘 다 피하는 방법은 내가 라벨을 단 표본으로 임계값을 정하는 것뿐입니다.
어느 선택지에도 맞지 않는 질문
CLINC150의 범위 밖 질문은 라우터가 사람에게 넘겨야 하는 경우입니다. Jev는 이 질문들에 평균 최고 확률 0.55를 줬고 범위 안 질문에는 0.93을 줬습니다. 확률만으로도 두 묶음이 잘 갈렸습니다(AUROC 0.94, Kev-9B는 0.88). 수락한 답의 정확도를 95%로 지키는 임계값에서 범위 밖 질문 100개 중 Jev는 3개, Kev-9B는 5개를 통과시켰습니다. 이때 Jev는 400개 중 229개를 받아들였고 Kev는 171개였습니다.
속도와 비용
한국에 있는 서버에서 잰 Jev 요청 시간의 중앙값은 219~227ms였습니다. 대부분은 거리 때문입니다. 응답 헤더에 서버 쪽 처리 시간(x-envoy-upstream-service-time)이 들어 있는데, 선택지 77개짜리 BANKING77 요청 30개에서 중앙값이 53ms였습니다(36~192ms). 같은 서버의 A100 한 장에서 Kev-9B는 첫 글 기준 요청당 29~65ms였고, 느린 쪽이 BANKING77입니다.
Jev 요금은 입력 토큰 100만 개당 $0.042이고 출력은 무료입니다. 선택지 77개짜리 BANKING77 요청이 약 1,000토큰이니 1,000건에 4센트 정도입니다. 이번 비교 전체(요청 2,329건, 149만 토큰)에 든 비용은 $0.06이었습니다. Kev는 가중치가 무료지만 GPU가 필요하고, 여기서는 9B를 A100에서 돌렸습니다.
어느 쪽을 쓸까
- 내 과제가 Kev 학습 데이터와 비슷하다면 Kev-9B가 최소한 같은 정확도였고 확률도 더 쓸 만했습니다. Kev README에 학습 출처 목록이 있으니 먼저 확인하세요.
- 새로운 과제라면 처음 보는 데이터셋 셋 중 둘에서 Jev가 더 정확했고, 확실히 뒤진 경우는 없었습니다. 어느 쪽이든 내 문장 수백 개에 라벨을 달아 먼저 재 보세요.
- 확신 높은 답을 자동 수락할 계획이라면 임계값은 내 라벨로 정하세요. 특히 Jev에서 1.00으로 온 답이 내 데이터에서 95% 이상 맞지 않으면 어떤 임계값으로도 95%에 못 갑니다. 그 묶음부터 확인하세요.
- 데이터가 밖으로 나가면 안 된다면 Kev는 로컬에서 돌고 Jev는 API입니다.
이 결과의 한계
Jev는 한 버전(jev-1.13.0)만 쟀습니다. 바뀔 수 있는 jev-latest 대신 버전을 고정했습니다. 확률 보정과 짝지은 검정은 주로 Kev-9B로 했고, 조건은 영어 데이터셋 6개에서 나온 8개로 모두 짧은 문장에 의도나 주제 라벨을 붙이는 과제입니다. Jev 학습 데이터는 공개되지 않았으니 "학습한/처음 보는" 구분은 Kev에만 해당합니다. 속도에는 한국에서 가는 네트워크 경로가 포함돼 있습니다. TREC 요청 하나가 처음에 503 오류로 실패해 한 번 다시 보냈고, 그 밖에 실패한 요청은 없었습니다.
실험 설정: Jev는 POST https://api.typesafe.ai/v1/systemone에 model: "jev-1.13.0"으로 한 번에 한 요청씩 보냈습니다(응답에도 같은 ID). 한국 서버, 2026-09-29. 요청 본문은 Kev와 같습니다. 문장을 state에 넣고, choice 질문 하나에 데이터셋별 지시문과 라벨마다 기준(설명 또는 null)을 넣었습니다. Kev-9B, Kev-4B, Kev-0.8B, 분류기 결과는 첫 글과 두 번째 글의 결과 파일을 그대로 읽었고, 행 순서로 짝지은 뒤 정답 라벨이 같은지 확인했습니다. 표본: BANKING77 154개(시드 20260918), TREC 시험셋 500개, AG News 200개, CLINC150 400개(범위 안 300, 범위 밖 100), MASSIVE 영어 175개, 금융 뉴스 트윗 200개(시드 20260926). 보정과 수락 비율은 Jev의 confidence 필드가 아니라 선택지 확률의 최댓값으로 계산했고, confidence로 다시 계산한 수락 비율은 본문에 적었습니다. 확률 차이 열은 평균 최고 확률에서 정확도를 뺀 값입니다. 95% 수락 비율은 임계값 하나로 받아들인 답이 95% 이상 맞는 경우 중 가장 큰 비율입니다. McNemar 검정은 양측 정확 검정입니다. 서버 처리 시간은 BANKING77 첫 30개 요청의 x-envoy-upstream-service-time 헤더, 비용은 응답의 usage.input_tokens와 TypeSafe 모델 페이지 요금으로 계산했습니다. 503으로 재시도한 TREC 요청 하나는 결과 파일에 표시해 두었습니다.
이 글과 이어지는 강좌
SOTAAZ 강좌강좌는 하나씩 살 수 있습니다. 13개 전체가 필요하면 $199 평생 번들도 있습니다.
이메일로 받아보기
관련 포스트
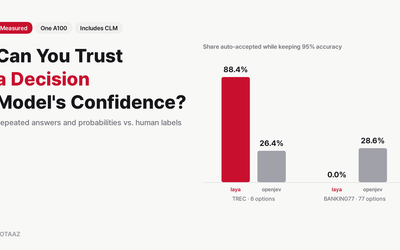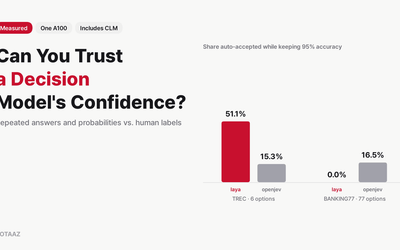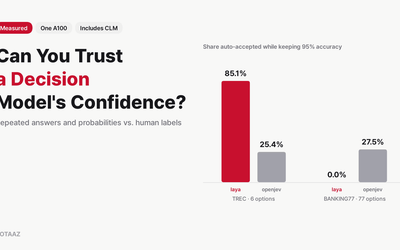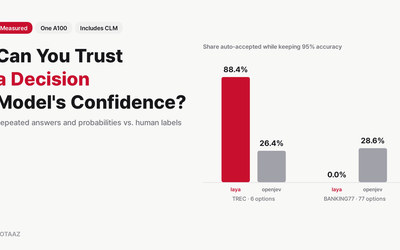
판단 모델의 확신을 믿어도 될까: 반복 응답과 확률 실측
판단 모델은 답마다 확률을 붙여 줘서, 확실한 건 바로 처리하고 나머지만 넘길 수 있다고 합니다. 그 '확실함'을 판단하는 두 방법을 사람이 붙인 정답 라벨로 평가했습니다. openjev가 틀린 답의 77~80%는 8번 뽑아도 모두 같은 답이었습니다. 확률은 그보다 나았지만 유용성이 과제에 따라 크게 달랐습니다. laya는 정확도 95%를 지키며 TREC의 88%를 자동 통과시켰고 BANKING77은 0%였습니다. 새로 나온 CLM-8B는 라벨 이름만 주면 세 데이터셋 모두 우연 수준이었습니다.
10분 만에 이해하는 Jev: 빠른 판단 모델은 언제 쓸모 있나
Jev는 글로 답하지 않고 선택지마다 확률을 매겨 돌려주는 모델입니다. 이런 모델이 왜 필요한지, 오픈소스는 같은 일을 어떻게 하는지, 그리고 세 번에 걸쳐 직접 재 본 결과를 정리했습니다. 선택지가 몇 개뿐이면 421M 모델이 23ms에 86.6%를 맞혔고, 77개면 CPU에서 도는 작은 분류기가 90%로 여전히 앞섰습니다.
오픈소스 Jev 대안 셋을 같은 데이터로 재 보니: laya·openjev·NanoJev 실측
laya, openjev, NanoJev를 A100 한 장에서 BANKING77(의도 77개), TREC(질문 유형 6개), AG News로 쟀습니다. 선택지가 6개면 421M짜리 laya가 TREC 86.6%를 23ms에 냈고, 77개면 DiffusionGemma 기반 openjev가 66.9%로 앞섰습니다. 다만 77개에서는 CPU에서 도는 로지스틱 회귀가 90%로 전부를 이겼습니다.